

En bref
Subvocal est une paire de lunettes conçue par une startup de Y Combinator qui transforme les mots que vous articulez en silence en texte, destinée aux personnes qui dictent à des outils d'IA mais ne peuvent pas parler à voix haute au travail. Un acompte remboursable de 199 $ permet de réserver une paire à 499 $ dont l'expédition est prévue au premier trimestre 2027. La promesse est réelle, mais les preuves ne sont pas encore là : aucun chiffre de précision, aucune caractéristique technique, uniquement dans le cloud, uniquement en anglais. Réservez-la si vous voulez être aux premières loges et pouvez attendre. Si votre véritable frein est la rédaction des réponses du support, un collègue IA comme eesel, qui les rédige pour vous, vous fera gagner davantage de temps.
Qu'est-ce que Subvocal ?
Subvocal est un appareil portable de reconnaissance de la parole silencieuse, un nouveau type d'entrée pour l'IA multimodale, conçu par The Subvocal Company, une startup de trois personnes basée à San Francisco et membre de la promotion d'automne 2026 de Y Combinator. Vous portez les lunettes, articulez des mots sans émettre de son, et le texte apparaît sur votre ordinateur. Son slogan sur la page de l'entreprise chez YC est "Talk to your computer without talking."
Le lancement a fait du bruit. L'annonce sur X du PDG Aarush Yadav, le 30 octobre, a recueilli 26,277 mentions J'aime et environ 12 million de vues, et le fil Show HN, quelques jours plus tard, a atteint environ 497 points et 270 commentaires. Dans la même publication, Yadav a déclaré que l'entreprise avait levé 1,3 M$ auprès de YC et d'Afore Capital.
Les deux fondateurs sont Aarush Yadav (PDG) et Arnav Kumar (directeur technique), tous deux étudiants en informatique à Georgia Tech. Un portrait publié par le programme d'excellence de Georgia Tech indique que Yadav a commencé à travailler sur le projet après le hackathon TreeHacks de Stanford en février 2026 et a levé ses premiers $500k auprès d'Afore en quelques semaines.
Je travaille sur le produit chez eesel, alors je lis les pages de lancement comme je lirais un cahier des charges : ce qui est garanti, ce qui est un objectif et ce qui relève de la démo. Subvocal distingue honnêtement les trois, à condition de lire les petits caractères. La publication de lancement sur YC dit clairement que "the hardware currently looks a lot worse than the product we intend to ship."
Un détail à connaître : le produit a rapidement changé de forme. Ce portrait de Georgia Tech d'avril 2026 décrit "a wearable that sits behind your ear", avec un prototype qui reconnaît les lettres à 30 mots par minute. Six mois plus tard, ce sont des lunettes qui annoncent 200+ mots par minute. C'est normal pour une startup matérielle à un stade aussi précoce, et c'est aussi pourquoi le produit final pourrait encore être différent.
Comment fonctionne Subvocal ?
Subvocal lit les muscles que vous utilisez pour parler, pas votre voix ni votre visage filmé par une caméra. Selon la publication de lancement sur YC, "We send low-power radio waves through the face and measure how they change as your muscles move. Our models then decode those signals directly into text."
Le fondateur a donné davantage de détails sur Hacker News :
"They emit radio waves, similar to Bluetooth, that pass through your face. As they cross the tongue, lips and soft palate, they're modulated by silent mouthing. We train foundation models on this data to decode these perturbations to text."

Quelques faits tirés des propres pages de Subvocal donnent une idée de ce que serait son utilisation :
- Pas de caméras. La FAQ de la page d'accueil indique "There's no video or camera-based lip reading."
- Il faut le faire volontairement. L'appareil "only decodes words you intentionally articulate", il ne lit donc pas vos pensées et n'est pas actif en permanence.
- Un étalonnage préalable. La configuration comprend "a short personal calibration process." Dans la vidéo de démonstration avec Dave de YC, cela consistait à lire 20 phrases.
- Le cloud est indispensable. Interrogé sur son fonctionnement hors ligne, le fondateur a répondu sur Hacker News : "Yes, it requires internet access."
- Uniquement en anglais. D'autres langues sont prévues "after shipping", selon une autre réponse du fondateur.
Pourquoi des ondes radio et pas une caméra ? La réponse du fondateur est l'explication technique la plus utile de tout le lancement : "Speech has 40 phonemes, but only about 12 to 15 visemes," ce qui signifie que de nombreux sons se ressemblent vus de l'extérieur (P et B, par exemple). Comme l'a expliqué le fondateur, la lecture labiale par caméra atteint un taux d'erreur "too high to be product ready but just low enough to make for a good demo." Lire les mouvements de la langue et du voile du palais de l'intérieur, c'est le pari pour contourner cette limite.
Le matériel exact n'est pas public. L'offre d'emploi de responsable de la détection de Subvocal cite la détection RF, l'EMG, l'EEG et les ondes millimétriques comme pistes de conception et précise : "For competitive and IP reasons, we are not publicly disclosing the exact architecture of our current system yet." Les propres pages de Subvocal n'emploient jamais le mot radar. Elles parlent de "RF sensing" et de "radio waves."
Quelle est la vitesse réelle de Subvocal ?
Subvocal annonce 200+ mots par minute. La page d'accueil indique que l'appareil "decodes almost-invisible subtle, silent mouthing into text at 200+ WPM," et c'est le chiffre repris dans tous les titres.
Pour donner un point de comparaison, le fondateur a mis en parallèle la frappe et la parole sur Hacker News : "Most people type at 40-50 WPM. Developers can often type at 70-100 WPM. Meanwhile, most people can talk at 120-200 WPM."
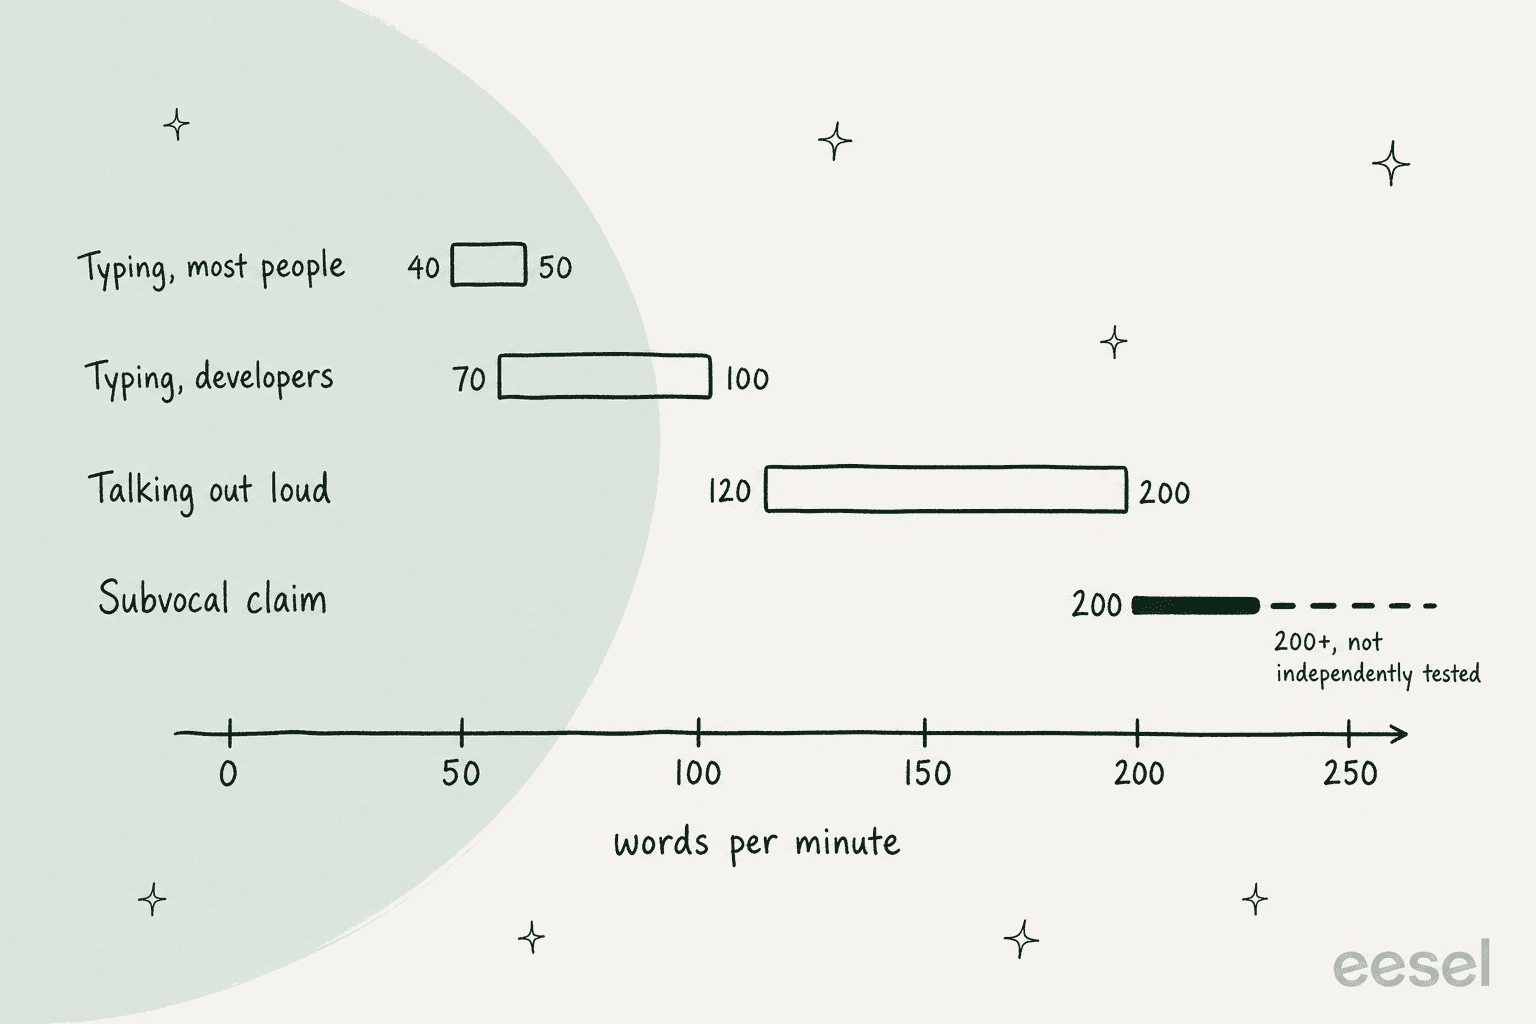
Présentée ainsi, la promesse est que l'articulation silencieuse atteint le haut de la plage de vitesse de la parole normale, ce qui est ambitieux pour un prototype. La vitesse ne veut pas non plus dire grand-chose sans précision, et c'est là qu'il manque quelque chose. Subvocal n'a publié aucun taux d'erreur. La page d'accueil indique "it can occasionally get something wrong," et la publication de lancement parle de "a reasonably low error rate even at a small dataset scale." Le seul chiffre qui circule vient d'une personne ayant regardé la vidéo de démonstration :
"I am so glad to see an unpolished early look and an honest evaluation of about five percent error rate in the YouTube video."
Il s'agit de l'estimation d'une personne à partir d'une seule démo, alors considérez-la comme une impression approximative plutôt que comme un résultat de test. Comparez cela aux modèles de transcription vocale comme Nemotron 3.5 Transcribe ou Voxtral 3, qui disposent de taux d'erreur sur les mots publics et vérifiables.
La plus grande sous-discussion sur Hacker News ne portait pas du tout sur la précision. Elle demandait si parler était vraiment plus rapide pour tout le monde :
"Do most people talk faster than they can type? It's the opposite for me - I also read aloud slower than I can read in my head."
Mon avis : si vous dictez déjà beaucoup avec Wispr Flow ou le mode vocal de ChatGPT, vous savez si la parole est plus rapide pour vous. Sinon, Subvocal ne vous convertira probablement pas.
Combien coûte Subvocal ?
Subvocal coûte $499 la paire au tarif Early Bird, avec une réservation par acompte remboursable de $199. La page de précommande affiche $499 à côté d'un prix barré de $699, et la publication de lancement sur YC parle de "a special $200 early bird discount on the final price."
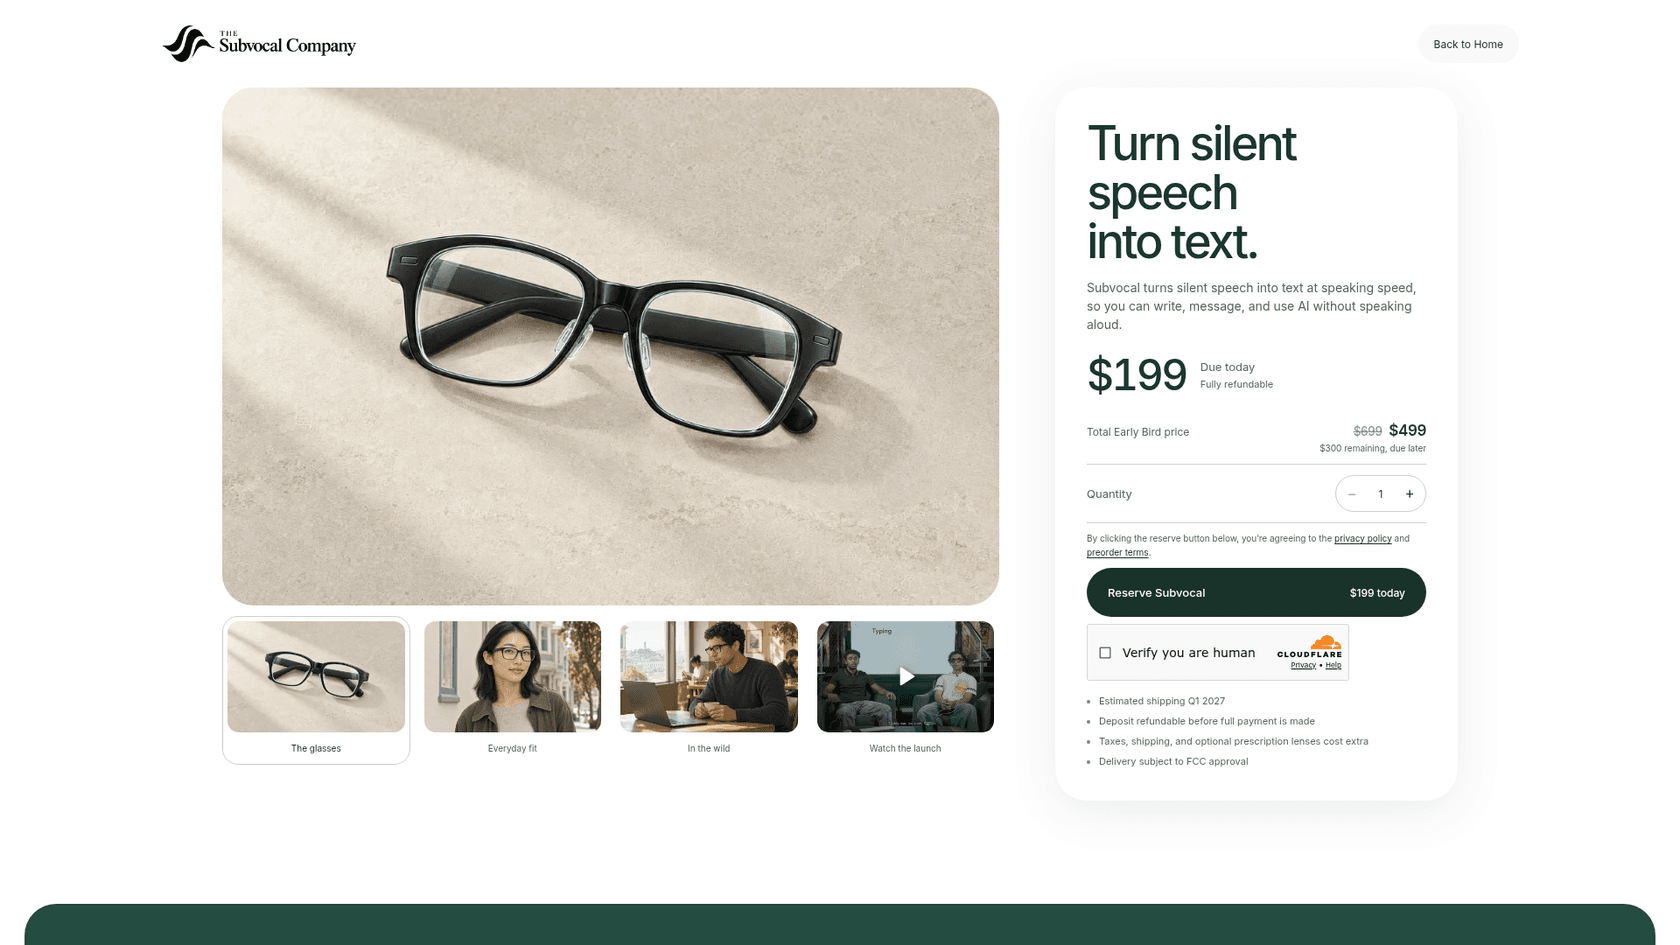
Voici l'ensemble des engagements pris dans les conditions de précommande :
| Élément | Ce que dit Subvocal |
|---|---|
| Acompte aujourd'hui | $199 par paire, intégralement remboursable avant le paiement final |
| Tarif Early Bird | $499 par paire ($699 affiché barré) |
| Solde à régler plus tard | $300 par paire |
| Comment le solde est prélevé | Jamais automatiquement. Vous recevez un e-mail et avez 30 jours pour payer |
| Non inclus | Taxes, livraison, verres correcteurs, accessoires facultatifs |
| Remboursements | À tout moment avant le paiement final, sans frais d'annulation, traitement lancé sous 7 jours ouvrés |
| Crédit de parrainage | $100 de réduction sur votre solde si 3 personnes réservent via votre lien |
| Estimation d'expédition | Premier trimestre 2027, "not a guaranteed delivery date", sous réserve d'approbation de la FCC |
| Qui peut commander | Adresses de livraison aux États-Unis uniquement, acheteurs de 18+ ans |
| Caractéristiques techniques | Non publiées. "Final specifications are still being developed" |
| Politique de retour et garantie | Pas encore publiées, communiquées avant le paiement final |
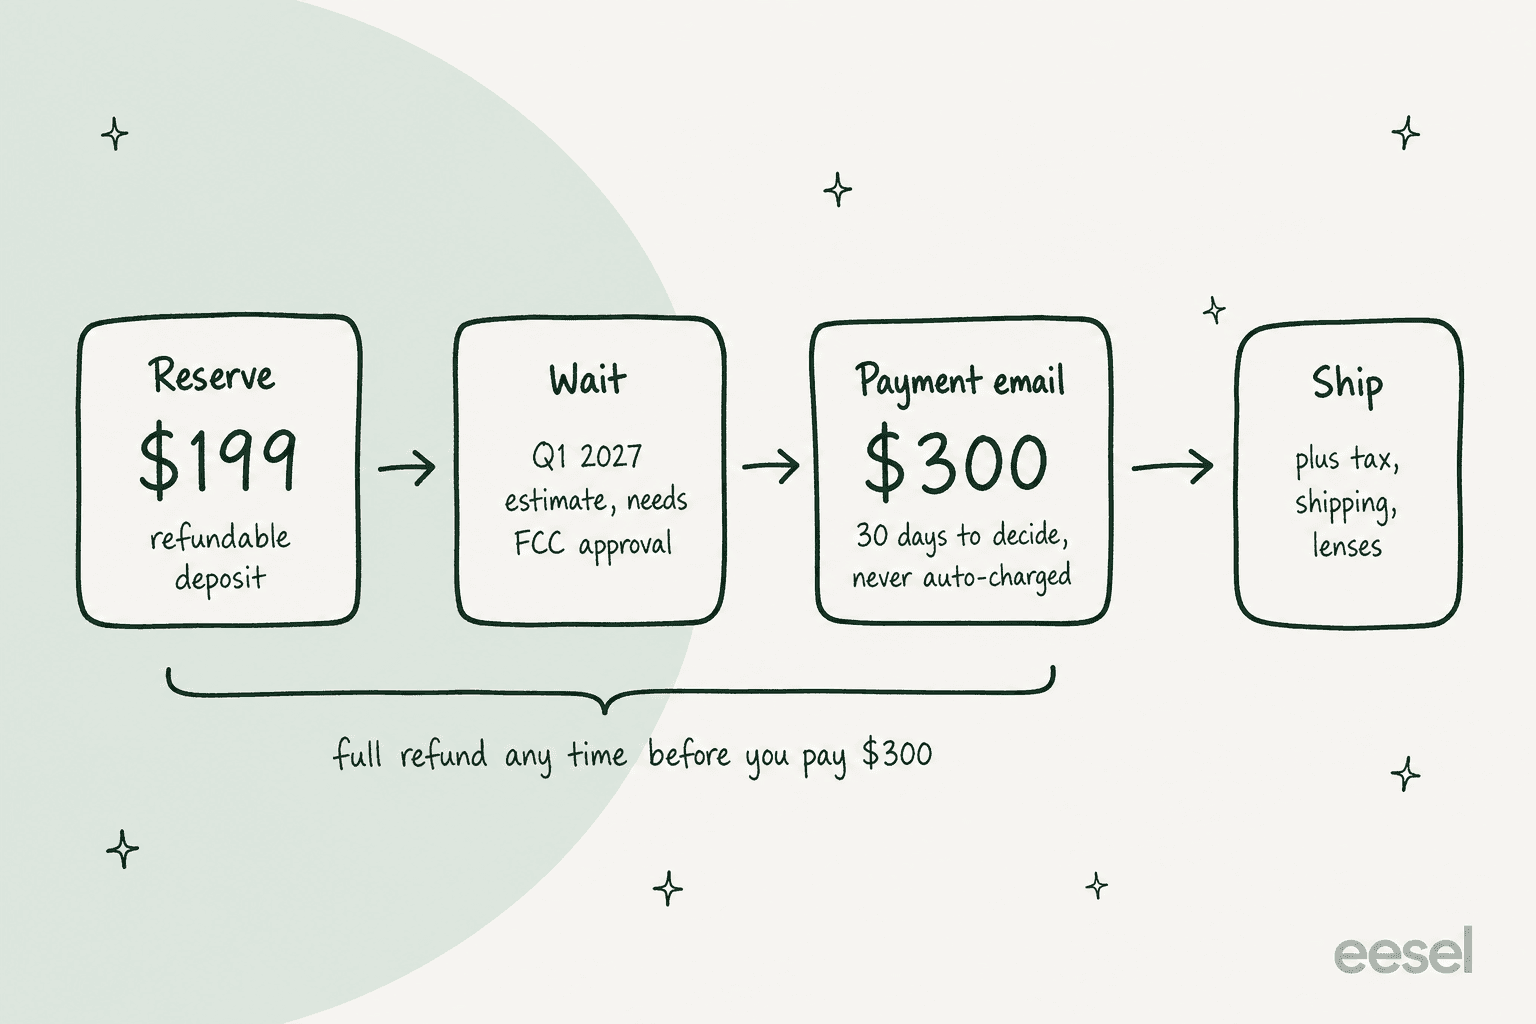
Les conditions sont plus favorables à l'acheteur que celles de la plupart des précommandes de matériel que j'ai lues. Rien n'est prélevé sans que vous choisissiez de payer, et si Subvocal modifie sensiblement le produit, vous pouvez annuler et récupérer votre acompte. Le véritable coût de la réservation, c'est que vos $199 restent chez une startup pendant quelques mois, et que vous pariez sur un produit final conforme à la démo.
Ce qui manque sur la page compte tout autant : aucune autonomie, aucun poids, aucune liste de compatibilité. La FAQ dit que le produit est conçu pour "ChatGPT, Claude, Cursor, Slack, email, documents, messaging, and anywhere else you'd normally type," mais il s'agit d'un objectif plutôt que d'une liste testée.
En quoi Subvocal diffère-t-il d'AlterEgo, d'EchoSpeech et du Neural Band de Meta ?
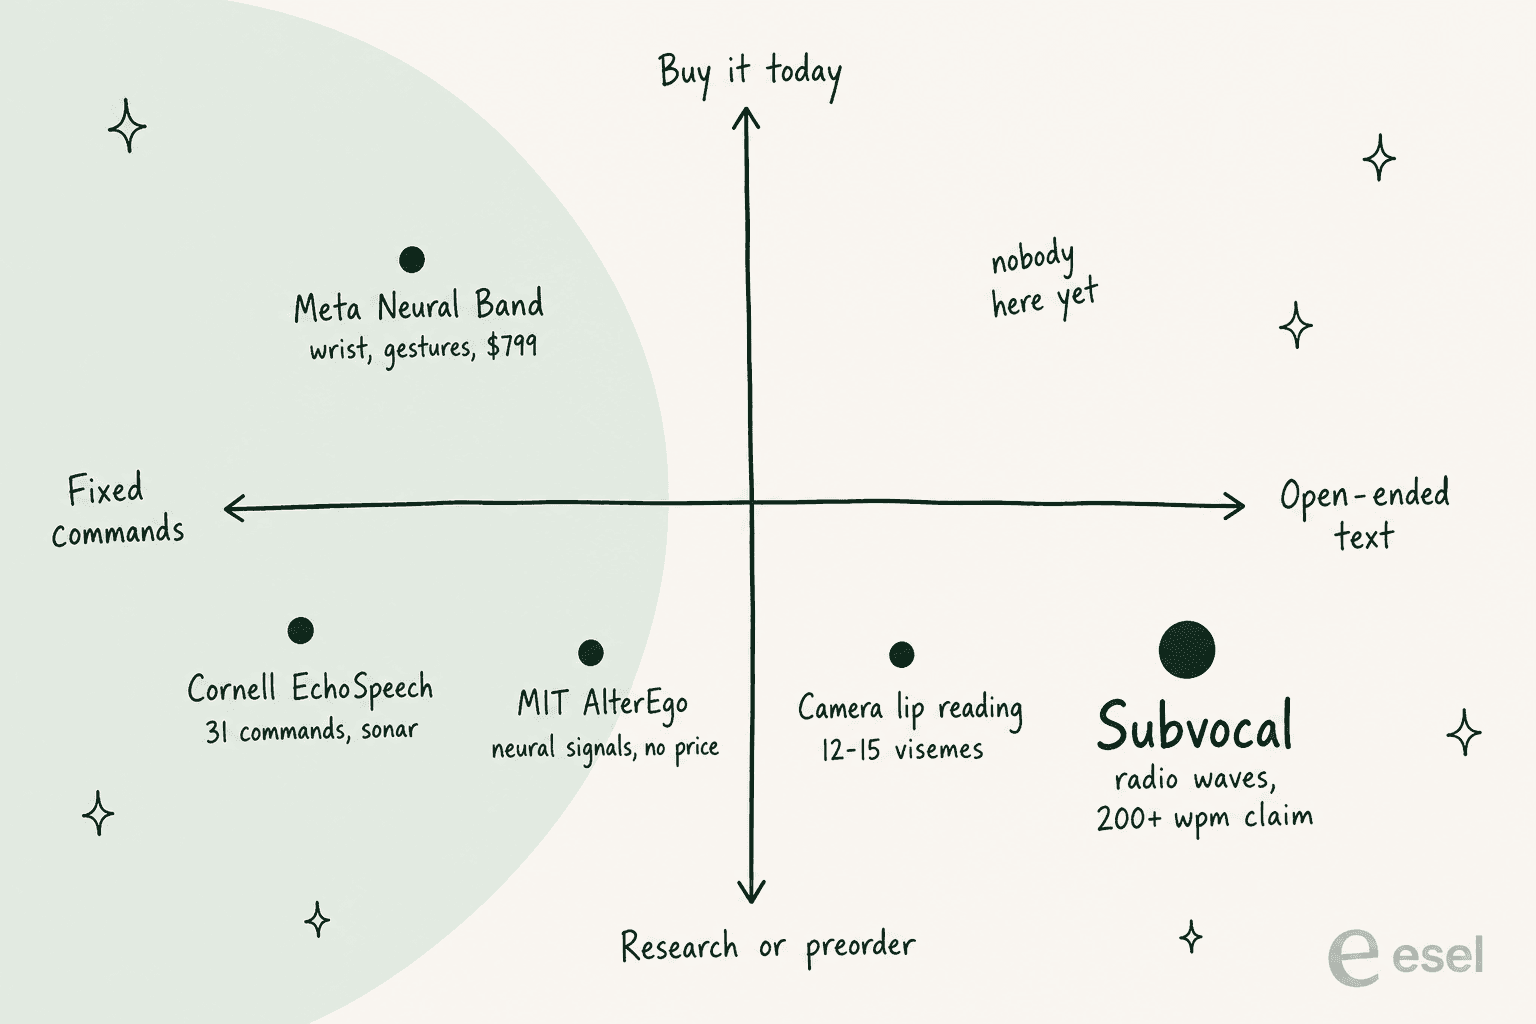
Subvocal n'est pas le premier dispositif de saisie silencieuse, et les réponses du type « ça existe déjà » n'ont pas tardé. La différence, c'est qu'il vise la saisie de texte libre avec une paire de lunettes d'apparence normale, ce qu'aucun des autres ne vend aujourd'hui.
| Produit | Mode de détection | Résultat produit | Peut-on l'acheter ? |
|---|---|---|---|
| Subvocal | Ondes radio traversant le visage, émises par les lunettes | Texte libre, 200+ mots par minute annoncés | Précommande, $499, estimation au premier trimestre 2027 |
| MIT AlterEgo | Signaux neuronaux issus de l'articulation interne | Parole silencieuse, sans mouvement visible selon les annonces | Non. Devenu une entreprise indépendante début 2025, alterego.io propose uniquement une inscription |
| Cornell EchoSpeech | Sonar utilisant de minuscules haut-parleurs et micros sur les lunettes | Jusqu'à 31 commandes avec environ 95 % de précision | Non. Prototype de recherche de 2023 |
| Meta Ray-Ban Display + Neural Band | Bracelet EMG qui lit les muscles des doigts | Gestes, avec la reconnaissance de l'écriture manuscrite annoncée pour plus tard | Oui, à partir de $799 au lancement |
Le plus proche parent est EchoSpeech de Cornell, qui tient lui aussi dans une monture de lunettes et se passe également de caméra. Ses limites constituent le point de comparaison : il reconnaissait un ensemble fixe de 31 commandes, mais fonctionnait sur votre téléphone sans cloud et offrait environ 10 heures d'autonomie.
AlterEgo va plus loin en matière de discrétion, annonçant une absence totale de mouvement visible de l'extérieur, tandis que la propre FAQ de Subvocal indique qu'une personne à proximité "may notice slight movement." Le bracelet de Meta est le seul que vous puissiez acheter, mais il lit vos doigts, pas votre bouche. Il s'inscrit dans une offensive plus large des produits d'IA de Meta vers les appareils portables. Le véritable concurrent de Subvocal aujourd'hui n'est donc pas un autre dispositif de parole silencieuse. Ce sont les logiciels de dictée et votre clavier.
Que dit-on de Subvocal ?
Les réactions se sont réparties en trois camps : l'enthousiasme des personnes qui dictent à l'IA toute la journée, les doutes sur la réalité du produit et la gêne à l'idée de le porter en public.
Le camp enthousiaste regroupe surtout des personnes qui parlent déjà à des agents de programmation comme Claude Code et Codex, et se heurtent au même obstacle que décrit la page d'accueil de Subvocal, "control your coding agents without annoying your coworker" :
"I already dictate a lot of my agent instructions. The problem is that you can't do that in an office or on a plane. This could fix it."
Les sceptiques avaient deux arguments. Le premier était que les visuels du produit semblaient générés, et un modérateur est intervenu pour distinguer les deux questions :
"They're taking pre-orders. Obviously the product doesn't exist yet. The tech is real."
Le second était que le produit serait facile à copier. Une publication de Joe Blau affirmant "I recreated subvocal in 9 minutes with one prompt for AirPods Pro 3" a reçu 10,199 mentions J'aime. Dans une réponse du fondateur sur Hacker News, Yadav a déclaré que de telles approches ne permettent d'obtenir que quelque chose comme "a 5 word classifier", ce qui correspond aussi à peu près au stade des recherches d'EchoSpeech sur les commandes fixes.
Puis vient l'aspect humain. Articuler en silence semble simple jusqu'à ce qu'on essaie :
"For the ones thinking this is great, have you actually tried to talk without making sounds? I don't think it is an intuitive action at all and I became self-conscious about not making a sound rather than talking like I normally would."
La confidentialité a également été évoquée, surtout parce que le décodage s'effectue dans le cloud :
"Can this be made to work offline, without a cloud server? I wouldn't want my words to be passed through an API"
Et la discussion la plus porteuse d'espoir concernait l'accessibilité, avec des témoignages de personnes qui ne peuvent pas taper ou parler confortablement :
"This is also neat thing to have with people struggling with typing (RSI, injuries, disabilities)... people find they're hurting their vocal chords pretty quickly."
Je pense que c'est pour ce dernier groupe que Subvocal pourrait avoir le plus d'importance, et c'est aussi celui qui a le plus besoin d'un chiffre de précision publié avant de dépenser $499.
Faut-il précommander Subvocal ?
Précommandez Subvocal si vous dictez à des outils d'IA tous les jours, travaillez dans un endroit où vous ne pouvez pas parler à voix haute et acceptez d'attendre au moins jusqu'au premier trimestre 2027. Les $199 sont remboursables jusqu'à ce que vous choisissiez de payer le reste, donc ce que vous risquez de perdre, c'est du temps, pas de l'argent.
Passez votre tour pour le moment si :
- Vous avez besoin que cela fonctionne dès le premier jour. Aucune caractéristique technique, aucune condition de garantie et aucun chiffre de précision ne sont encore publics.
- Vous vivez hors des États-Unis. Les précommandes payantes sont réservées aux États-Unis.
- Vous traitez des textes sensibles. Le cloud est indispensable, et la notice de confidentialité relative aux données des capteurs n'a pas été publiée. La politique de confidentialité actuelle couvre uniquement le site web et les précommandes.
- Vous ne dictez pas aujourd'hui. Essayez d'abord la dictée gratuite ou Wispr Flow. Si parler à voix haute ne vous fait pas gagner de temps, parler en silence ne le fera pas non plus.
Pour du matériel conçu par une équipe de trois personnes, le chemin entre la démo et la mise en rayon est long, comme l'ont montré de précédents gadgets d'IA tels que le Rabbit R1. Au moins, les conditions de Subvocal sont rédigées de façon à ce que, si ce chemin s'allonge, vous puissiez vous retirer avec votre acompte.
La vitesse de frappe compte-t-elle pour les équipes de support ?
Moins que vous ne le pensez. Subvocal est un moyen plus rapide de saisir des mots sur un ordinateur, et les fondateurs le présentent dans le contexte du passage aux agents IA, où "our job moves upstream, to structured and detailed prompting." C'est de l'ingénierie des prompts sous un autre nom. C'est une lecture juste de l'évolution du travail intellectuel. Pour un agent de support, cependant, la frappe n'est pas la partie lente d'une réponse. Ce qui prend du temps, c'est de retrouver la commande, la politique applicable et la dernière conversation, et c'est ce qui fait augmenter la durée moyenne de traitement.
C'est ce manque que comble un collègue IA pour le support. Il fonctionne comme une assistance aux agents poussée un cran plus loin, en effectuant les recherches et en rédigeant le brouillon avant qu'une personne n'ouvre le ticket. Lesson Pro, un groupe de marques de cours particuliers utilisant Zendesk, emploie eesel de cette façon : en un mois, il a travaillé sur environ 1,900 tickets, laissé environ 1,700 notes internes avec le contexte et les prochaines étapes, et rédigé environ 560 réponses à faire approuver et envoyer par une personne. Personne dans cette équipe n'a besoin de taper à 200 mots par minute, parce que le premier brouillon est déjà rédigé.
Le même schéma se retrouve en dehors du support. SamCart utilise un agent eesel pour les tickets Freshdesk et un autre pour le chat de son site web, chacun répondant à partir des 280 articles de son centre d'aide. Si l'idée plus générale vous intéresse, voici en quoi les collègues IA diffèrent des outils que vous devez piloter vous-même, et ce qu'un employé IA fait concrètement au quotidien.
Et si vous aimez la vision de Subvocal consistant à parler à des agents de programmation, eesel dispose d'une CLI conçue précisément pour ce type d'utilisateur. Elle place le même collègue eesel dans votre terminal : vous pouvez discuter avec lui, connecter votre outil de support, importer des connaissances, configurer des automatisations et approuver des actions en attente sans ouvrir le tableau de bord. Chaque commande affiche du JSON, ce qui permet à un agent de programmation comme Claude Code, Cursor ou Codex d'effectuer toute la configuration pour vous, et tout ce qui y est configuré apparaît aussi dans le tableau de bord. Que vous tapiez l'instruction, la prononciez ou l'articuliez un jour en silence, le travail revient à un collègue qui connaît déjà votre centre d'aide.
Essayez eesel
Subvocal accélère la rédaction. eesel réduit la quantité de texte que votre équipe doit rédiger. Son collègue IA pour le support rejoint Zendesk, Freshdesk et d'autres outils de support, apprend à partir de vos anciens tickets et de votre centre d'aide, et rédige ou envoie des réponses selon le degré de confiance que vous lui accordez. Vous pouvez simuler son fonctionnement sur votre propre historique de tickets avant qu'il n'interagisse avec un vrai client. Essayez eesel gratuitement et découvrez combien de vos réponses il aurait rédigées.

Comment fonctionne Subvocal ?