

Ce que « automatiser le support en ligne de commande » signifie vraiment
Je construis le produit et les agents IA chez eesel, donc je passe beaucoup de temps dans des API de helpdesk et dans les terminaux d'autres personnes. Quand une équipe de support à profil technique dit « je veux automatiser ça depuis la ligne de commande », elle ne demande presque jamais un unique binaire magique qui tape support resolve #4821 et ferme un ticket avec une réponse correcte. Cet outil n'existe pas, et autant le dire d'emblée.
Ce qu'elles veulent en réalité, c'est une échelle d'autonomie : arrêter de cliquer dans une interface, et laisser des scripts faire le travail répétitif, d'abord à la demande, puis selon un planning, puis automatiquement sur événements. C'est le même instinct derrière les recherches d'une CLI de support client. Cet instinct est parfaitement juste, et pour la moitié mécanique du support, il paie tout de suite. Le piège est de supposer que le terminal vous donne aussi la moitié difficile, la réponse elle-même. Ce n'est pas le cas, et après des années à mettre des agents IA sur des files en production, je sais exactement où se situe cette limite.
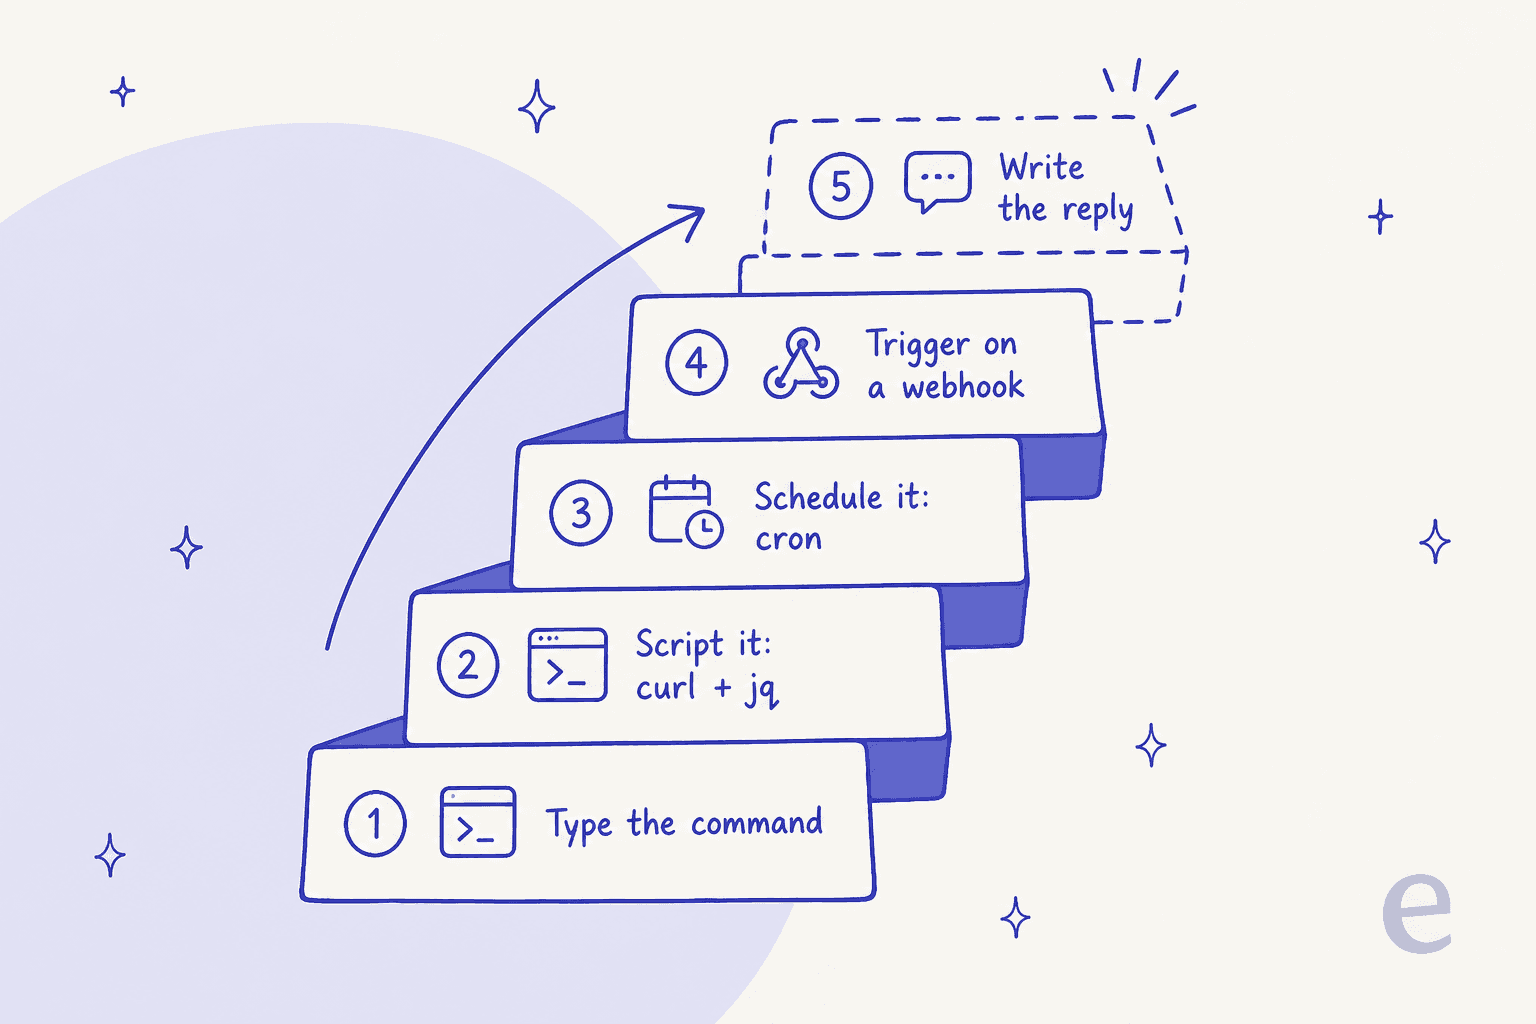
Chaque barreau sous celui en pointillés est réel, réalisable dès aujourd'hui, et le reste de cet article les gravit un par un.
Barreaux 1 et 2 : scripter le travail mécanique
Chaque grand helpdesk expose une API REST, donc bash, curl et jq peuvent déjà piloter une part surprenante du quotidien. C'est là que la ligne de commande gagne sa place, car elle transforme un après-midi de clics en une seule boucle.
Triage et routage en masse. Réaffectez tous les tickets d'une vue, ajoutez un tag sur tout un segment, ou augmentez la priorité d'un backlog. C'est le même travail que le routage automatisé de tickets, simplement piloté depuis un shell plutôt qu'un générateur de règles. Si vous utilisez Zendesk en particulier, cela recoupe fortement l'automatisation des tickets Zendesk :
# Tag every unassigned ticket in a view, using the helpdesk REST API
curl -s -u "$AUTH" "$HELPDESK/api/v2/views/$VIEW/tickets.json" \
  | jq -r '.tickets[].id' \
  | while read -r id; do
      curl -s -u "$AUTH" -X PUT "$HELPDESK/api/v2/tickets/$id.json" \
        -H 'Content-Type: application/json' \
        -d '{"ticket":{"tags":["needs-review"]}}'
    done
Exports et analyse. Extrayez un mois de conversations en JSON et injectez-les dans un tableur, un notebook, ou un rapide comptage de fréquence de mots sur ce dont les clients se plaignent vraiment. Ce type d'analyse de tickets est bien plus simple depuis le terminal que depuis n'importe quel onglet de reporting.
Synchronisation des connaissances. Poussez votre centre d'aide, vos macros ou votre documentation dans une base de connaissances pour que les réponses restent à jour. C'est le tissu conjonctif derrière tout vrai workflow d'IA de helpdesk, que vous utilisiez Freshdesk, Gorgias ou Help Scout, et l'API de base de connaissances Freshdesk est un bon exemple de ce que ces endpoints exposent.
Tout ceci est scriptable, répétable et vérifiable. Le hic, c'est que tout cela déplace des données. Rien de tout cela ne décide ce qu'il faut dire.
Barreau 3 : planifier avec cron
Dès qu'un script existe, enveloppez-le dans une ligne cron et il tourne tout seul. C'est le premier barreau où le support tourne sans surveillance, sans qu'aucun humain ne déclenche quoi que ce soit.
# Every night at 2am, run the stale-ticket sweep and log the result
0 2 * * * /opt/support/close-stale.sh >> /var/log/support-cron.log 2>&1
Un job nocturne qui ferme les tickets obsolètes, un export hebdomadaire, une synchronisation des connaissances toutes les heures, une vérification de SLA qui alerte Slack quand un ticket est sur le point d'être en dépassement, aucun de ces cas n'a besoin d'une personne dans la boucle. C'est le schéma derrière la plupart de l'automatisation légère des tickets de support : vous n'avez pas besoin d'une plateforme, vous avez besoin d'un script et d'un planning. Si vous voulez un angle SLA concret, la même idée s'applique parfaitement à un workflow de gestion des SLA.
Voici un exemple petit mais utile, une alerte de dépassement de SLA qui tourne toutes les 15 minutes :
# Alert on tickets within 30 min of an SLA breach (cron: */15 * * * *)
curl -s -u "$AUTH" "$HELPDESK/api/v2/search.json?query=type:ticket+status<solved" \
  | jq -r '.results[] | select(.sla_minutes_left < 30) | .id' \
  | while read -r id; do
      curl -s -X POST "$SLACK_WEBHOOK" \
        -d "{\"text\":\"Ticket $id is about to breach SLA\"}"
    done
Ça, c'est de la vraie automatisation. Elle lit un état, applique une règle et effectue une action, tout ça sans vous. Elle ne répond toujours à rien.
Barreau 4 : déclencher via un webhook
Cron tourne selon une horloge. Le barreau scriptable le plus haut tourne selon des événements. Au lieu de faire du polling toutes les 15 minutes, vous enregistrez un webhook pour que votre helpdesk envoie un POST vers votre endpoint à l'instant où un ticket est créé, tagué ou mis à jour, et votre script réagit en temps réel.
C'est ainsi que vous passez d'un tagging automatisé qui tourne selon un planning à un tagging qui se déclenche à l'instant où un ticket arrive, et c'est la rampe d'accès vers une vraie classification de tickets. Un tout petit handler suffit :
# Minimal webhook handler: classify and route a new ticket on arrival
# (Ticket payload arrives as JSON on POST from the helpdesk)
read -r payload
id=$(echo "$payload" | jq -r '.ticket.id')
subject=$(echo "$payload" | jq -r '.ticket.subject')
case "$subject" in
  *refund*|*charge*) queue="billing" ;;
  *bug*|*error*)     queue="engineering" ;;
  *)                 queue="general" ;;
esac
curl -s -u "$AUTH" -X PUT "$HELPDESK/api/v2/tickets/$id.json" \
  -d "{\"ticket\":{\"group_id\":\"$queue\"}}"
Un routage par mots-clés comme celui-ci est basé sur des règles, pas de l'IA, et c'est très bien ainsi, une bonne partie du routage n'est vraiment que de la correspondance de mots-clés. Mais observez ce qui se passe si vous poussez plus loin : plus vous voulez que le handler comprenne le ticket au lieu de simplement faire du pattern-matching sur sa ligne d'objet, plus vous avez discrètement quitté le domaine des instructions case pour entrer dans celui d'un véritable système d'IA.
Le barreau que vous ne pouvez pas scripter : la réponse
Voici la limite honnête. Vous pouvez scripter le ticket, mais vous ne pouvez pas scripter la réponse. Dès qu'une tâche exige de lire le problème d'un client, trouver la bonne connaissance et décider d'une réponse, curl et jq atteignent leurs limites, et vous construisez un système d'IA, pas une fonction bash.
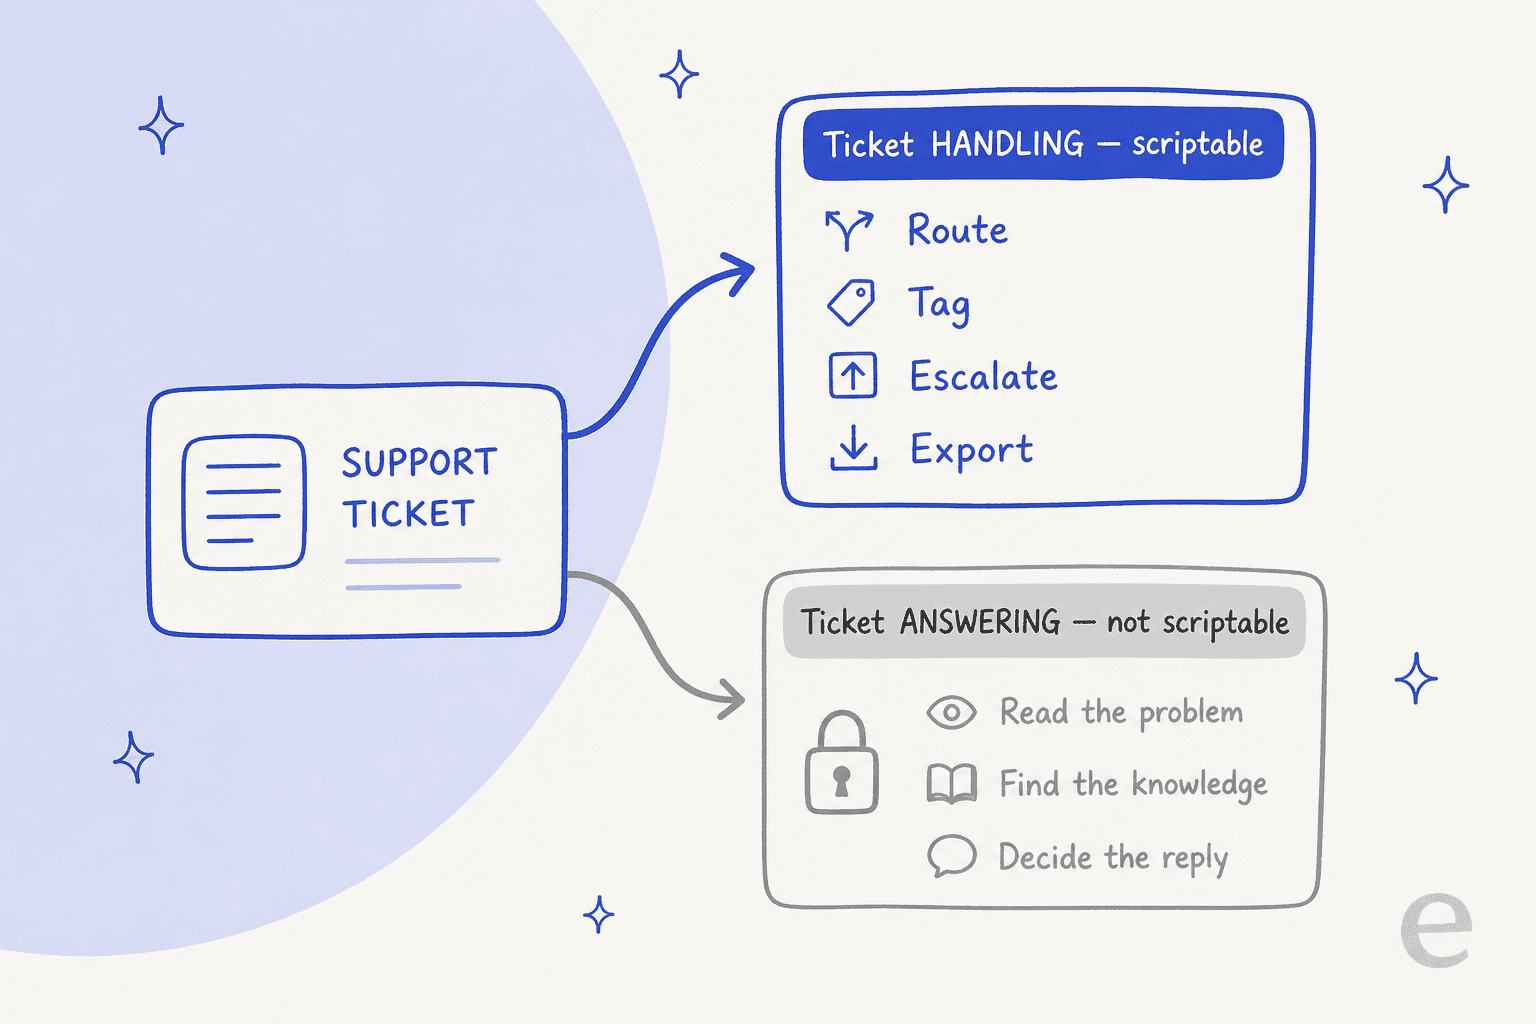
Demandez à quiconque en a réellement livré un. La seule recherche de connaissances est déjà une stack complète, pas un simple appel de recherche :
"So few developers realize that you need more than just vector search for RAG, so I still spend many of my talks emphasizing the FULL retrieval stack for RAG."

Et dès que le modèle peut à la fois décider et agir sur un ticket, vous avez hérité d'un problème de contrôle qu'une ligne cron ne résout pas :
"The failure mode I keep seeing isn't hallucination per se... it's blurred responsibility between intent and execution. Once a model can both decide and act, you've already lost determinism."
Le coût réel d'un agent de support automatisé n'est donc pas l'endpoint. Il réside dans la synchronisation et la recherche de connaissances, l'état de la conversation à travers les échanges, les actions d'outils contre le helpdesk, les règles d'escalade, les garde-fous, et un moyen de tester tout cela. C'est le même iceberg que rencontre toute équipe qui construit une configuration de support headless : la pointe, votre terminal et votre canal, n'a jamais été la partie difficile. Le corps en dessous l'est, et c'est exactement ce qu'une API IA de helpdesk doit porter.
Testez l'automatisation avant qu'elle ne réponde à un ticket en production
S'il y a une habitude qui mérite d'être volée au monde du logiciel, c'est bien celle-ci, et c'est l'étape que les configurations scriptées sautent. Vous ne livreriez jamais du code sans tests. Une automatisation qui parle à vos clients mérite le même niveau d'exigence, et l'instinct terminal de « rendre ça reproductible » est exactement ce qui rend le test possible.
Le problème, c'est que la plupart des équipes allument simplement un agent et espèrent. La communauté du support tourne sans cesse autour de la même inquiétude :
"How do you test that an AI agent won't do something catastrophic? Do people actually red-team their agents before they go live?"

Vous avez déjà la suite de tests : votre historique de tickets. L'idée est de rejouer des milliers de vos vrais tickets passés contre l'agent et de voir ce qu'il aurait dit, où il aurait escaladé, et où il serait resté silencieux, le tout avant qu'un seul client ne soit impliqué. C'est ce que fait la simulation d'eesel, et elle transforme « déployer et espérer » en « déployer avec des chiffres ». C'est ce qui se rapproche le plus d'un pytest pour le support, et c'est pourquoi je simule chaque déploiement contre des tickets historiques en premier.
Ce que coûte l'automatisation de la réponse
Le coût est l'endroit où l'instinct du « faites-le vous-même » rencontre la réalité, et les deux chemins facturent de manières très différentes.
Si vous scriptez un agent sur une API de modèle brute, vous payez par token à chaque message, chaque nouvelle tentative, chaque fragment récupéré, que le ticket soit résolu ou non. Une équipe de notre dossier a brûlé 200 appels API en une seule journée de test et s'est inquiétée de la facture face à ses 9 000 interactions attendues par mois. Et ce, avant même de compter le temps d'ingénierie nécessaire pour construire et maintenir la recherche de connaissances, l'état et les garde-fous.
Voici comment les options terminal-first se comparent réellement :
| Approche | Niveau d'autonomie | Vous maintenez | Forme de facturation | Idéal pour |
|---|---|---|---|---|
| Scripts curl + jq | À la demande | Chaque script | Inclus dans le plan | Modifications en masse, exports, routage |
| Jobs cron | Planifié, sans surveillance | Scripts + planning | Inclus dans le plan | Balayages nocturnes, synchronisations, alertes SLA |
| Handlers webhook | Piloté par événements | Endpoint + scripts | Inclus dans le plan | Routage et tagging en temps réel |
| API de modèle + MCP | Autonome, DIY | Toute la stack IA | Par token, résolu ou non | Contrôle total, si vous avez l'équipe |
| Coéquipier déjà prêt | Autonome, géré | Rien | Par ticket résolu (~0,40 $) | Tickets résolus sans construire le moteur |
La dernière ligne mérite un second regard si votre objectif est des tickets résolus plutôt qu'un projet de maintenance. Vous conservez tout de même une surface programmable contre laquelle scripter avec curl et cron, vous ne reconstruisez simplement pas l'intelligence de résolution en dessous.
Automatiser la réponse avec eesel
Si vous êtes arrivé ici en voulant automatiser le support client en ligne de commande, vous faites partie des équipes qui veulent une surface programmable, pas un dashboard verrouillé. C'est exactement le juste milieu pour lequel eesel est conçu.
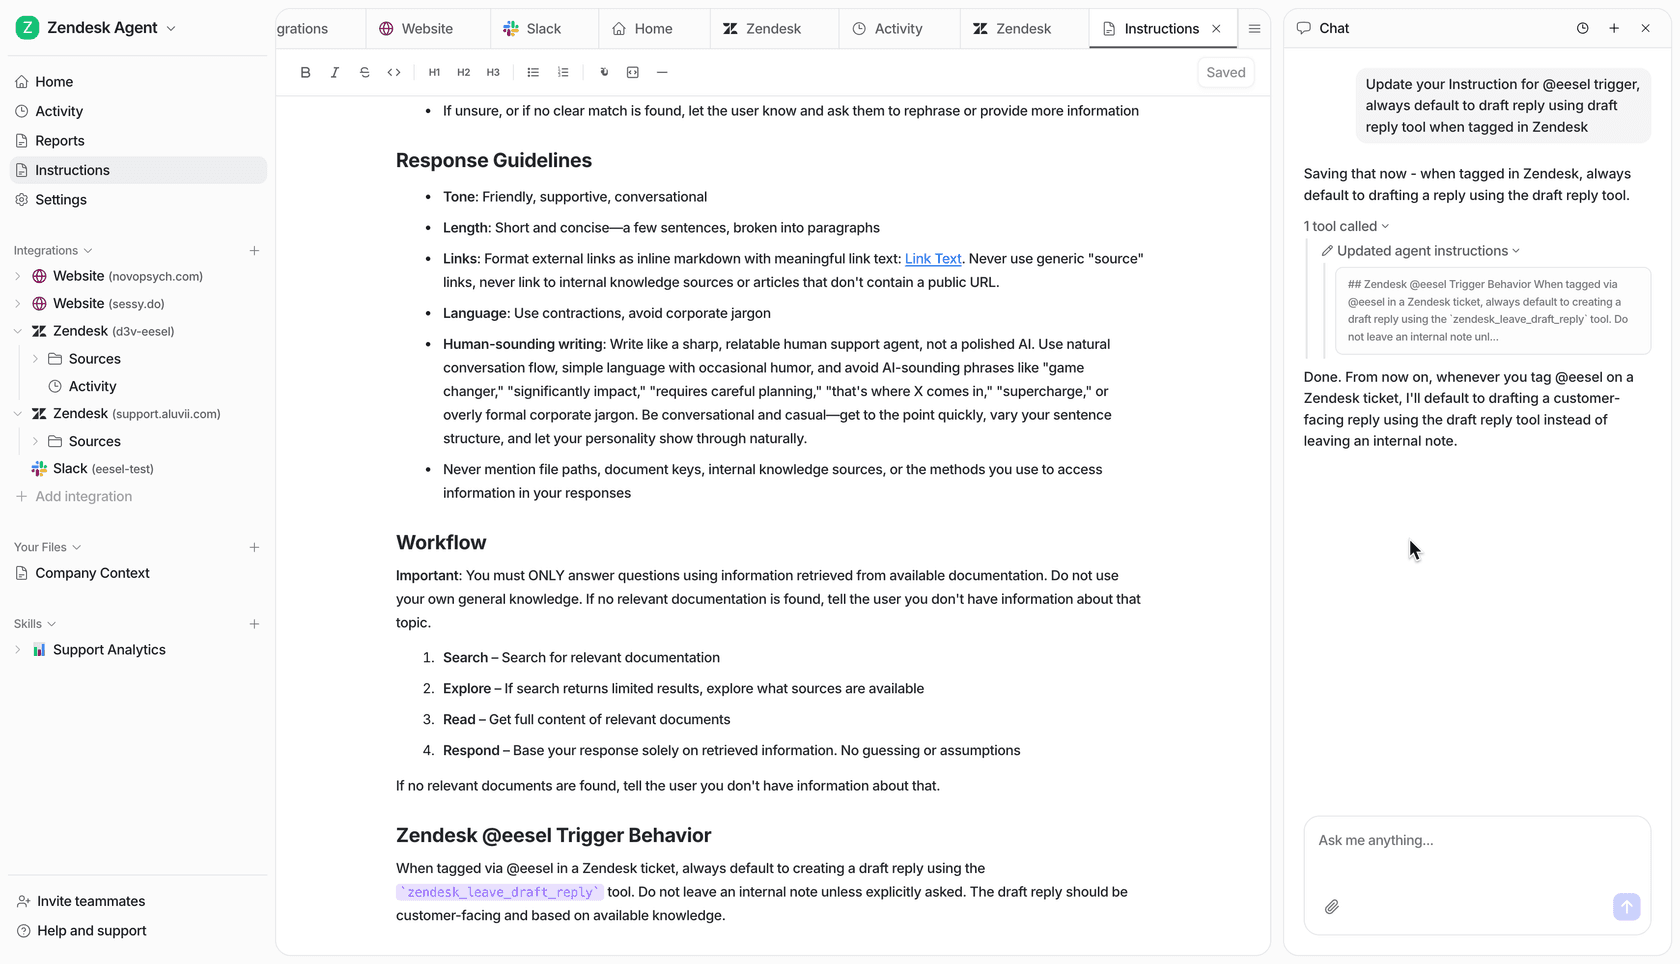
eesel est un coéquipier IA qui se connecte au helpdesk que vous utilisez déjà, Zendesk, Freshdesk, Gorgias, Front, Help Scout, et il arrive en sachant déjà synchroniser vos connaissances, consulter des commandes, taguer des tickets, et rédiger ou envoyer des réponses. Il apporte tout le moteur de résolution, vous n'avez donc pas à reconstruire la recherche de connaissances, l'état et les garde-fous depuis zéro, et il conserve la surface programmable pour laquelle vous êtes venu : une API pour les actions, des webhooks, et des skills personnalisées que vous pouvez piloter depuis un shell. Puis la partie la plus importante : il simule sur des tickets passés avant sa mise en production, si bien que vous déployez avec des chiffres plutôt qu'avec de l'espoir. Il est gratuit à l'essai, sans carte bancaire et sans appel commercial, et la facturation se fait par ticket résolu plutôt que par token ou par siège.
Gardez vos scripts curl et vos jobs cron pour le traitement des tickets, où ils excellent. Laissez un coéquipier prendre en charge le seul barreau que la ligne de commande ne peut pas atteindre.
Questions fréquentes
Quelles tâches de support puis-je vraiment scripter depuis le terminal ?
Puis-je exécuter des automatisations de support planifiées avec cron ?
En quoi l'automatisation par webhook diffère-t-elle de cron ?
Un script peut-il vraiment résoudre un ticket, pas seulement le déplacer ?
Comment tester une automatisation de support avant sa mise en production ?
Combien coûte un support IA automatisé par rapport à le scripter soi-même ?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.



Comment automatiser le support client en ligne de commande ?