Ce que les gens veulent vraiment dire par « une CLI pour le support client »
Je passe la majeure partie de ma semaine dans des API de helpdesks et dans les terminaux d'autres personnes. La demande que j'entends le plus de la part des équipes de support à tendance technique est une variante de « je veux juste faire tourner ça depuis la ligne de commande ». Généralement, ils imaginent un binaire propre : support resolve #4821, et le ticket se ferme avec une réponse correcte.
Ce binaire n'existe pas, mais le désir sous-jacent mérite d'être pris au sérieux. Quand un ingénieur demande une CLI, il demande rarement une esthétique de terminal. Il demande les choses qu'implique une bonne ligne de commande : l'automatisation plutôt que le clic manuel, la reproductibilité plutôt que « ce que Steve a bien pu faire dans l'interface mardi dernier », et la possibilité de mettre la logique de support dans un fichier que l'on peut relire, tester et annuler.
On voit ça tout le temps. Un client mid-market qui est parti l'a dit sans détour en franchissant la porte :
« Nous sommes passés à un système qui fonctionne bien pour moitié moins cher. Mais à long terme, nous allons simplement construire le nôtre, ce qui est tellement possible maintenant avec l'IA. »
Un client mid-market qui a résilié pour un outil moins cher après une intégration cassée, disant qu'il serait resté si le support avait été plus rapide et meilleur
Cet instinct, « on va simplement le construire nous-mêmes maintenant que l'IA le rend possible », est exactement l'énergie derrière une recherche « CLI pour le support client ». Il est réel, et pour la moitié mécanique du travail, il est totalement juste. Le piège est de supposer que le terminal vous donne aussi la moitié difficile. Ce n'est pas le cas, et nous avons passé assez d'années à mettre des agents d'IA sur des files d'attente en production pour savoir exactement où se situe cette limite.
Le vrai changement : traiter le support comme du code
Le recadrage le plus utile consiste à arrêter de chercher un binaire de support magique et à commencer à traiter les automatisations de support comme vous traitez déjà le code applicatif. C'est l'idée derrière le « support as code », et c'est la même discipline que vous appliquez à l'infrastructure : si c'est important, ça vit dans un dépôt, ça se teste, et ça tourne selon un planning plutôt que selon la mémoire de quelqu'un.
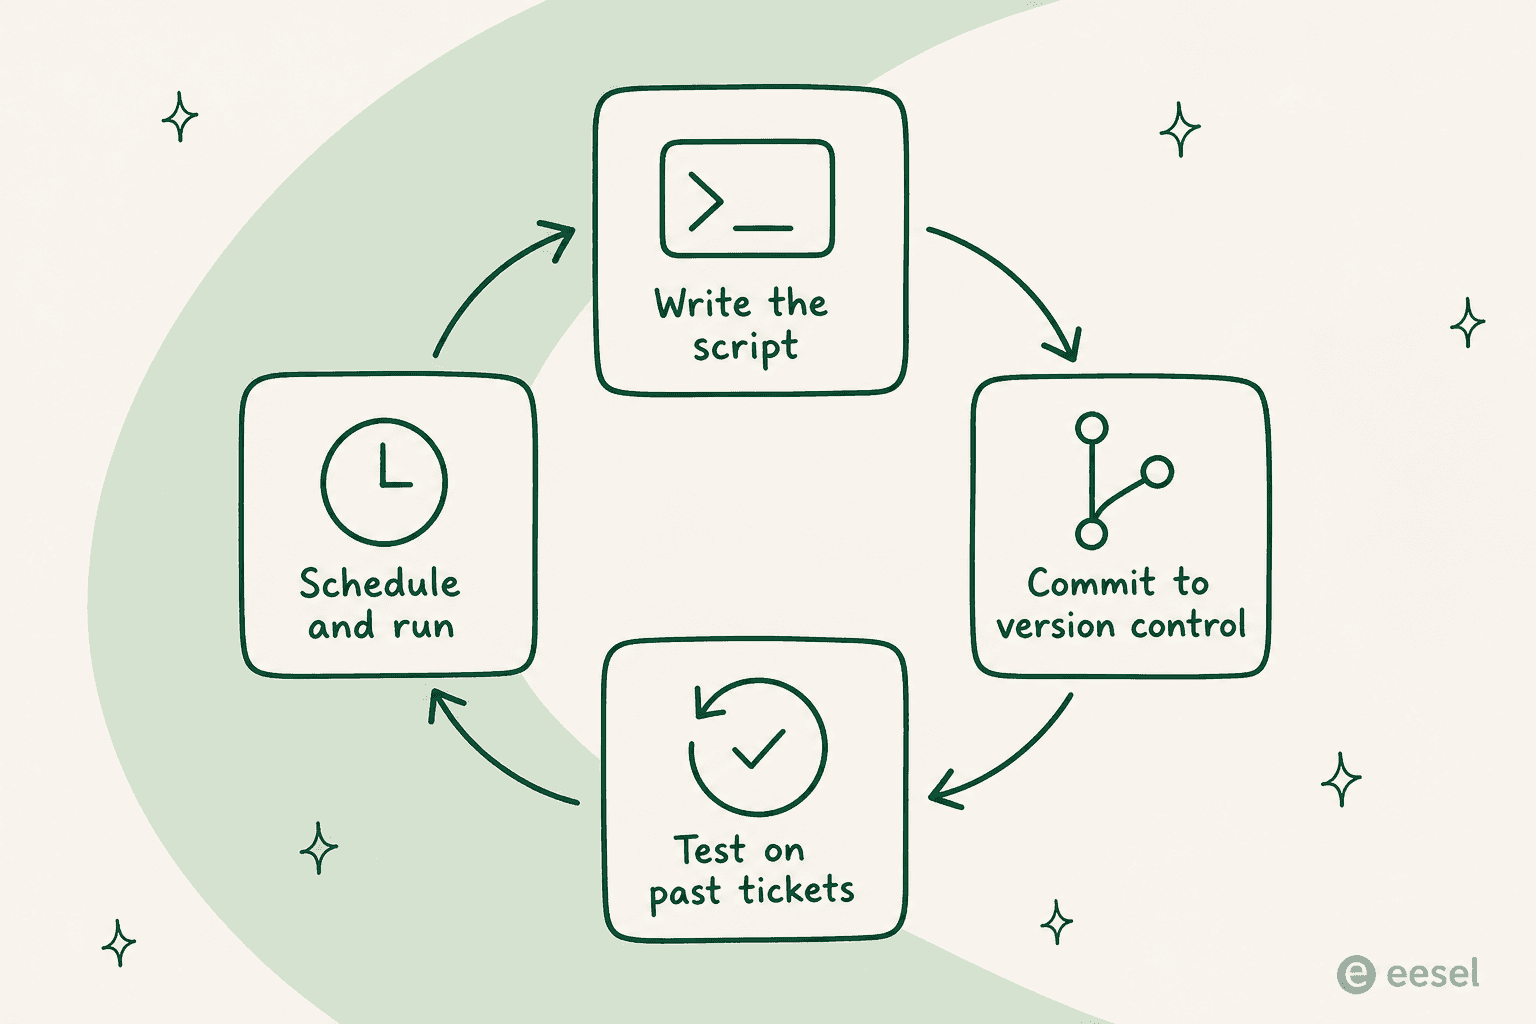
La boucle est simple, et c'est la raison pour laquelle le cadrage « CLI » vaut quelque chose. Vous écrivez une automatisation sous forme de script, vous la committez pour qu'il y ait un historique et un relecteur, vous la testez contre de vrais tickets passés avant qu'elle ne touche un client, et vous la planifiez pour qu'elle tourne toute seule. Une macro que vous avez configurée dans un tableau de bord n'a rien de tout cela : pas de diff, pas de test, pas de retour arrière, pas de propriétaire. Dès l'instant où votre logique de support est du texte dans un fichier, tout cela vient gratuitement, et c'est le vrai gain d'une approche terminal-first.
Ce que vous pouvez scripter depuis le terminal dès aujourd'hui
Chaque grand helpdesk expose une API REST, donc bash, curl et jq peuvent déjà piloter une part surprenante du quotidien. C'est la partie où la ligne de commande fait vraiment ses preuves.
Quelques exemples qui conviennent bien à un script, pas à un tableau de bord :
Modifications en masse et tri. Réassigner tous les tickets d'une file, ajouter un tag sur un segment, ou remonter la priorité d'un arriéré. Une seule boucle fait ce qu'un après-midi de clics ferait :
# Tag every unassigned ticket in a view, using the helpdesk REST API
curl -s -u "$AUTH" "$HELPDESK/api/v2/views/$VIEW/tickets.json" \
  | jq -r '.tickets[].id' \
  | while read -r id; do
      curl -s -u "$AUTH" -X PUT "$HELPDESK/api/v2/tickets/$id.json" \
        -H 'Content-Type: application/json' \
        -d '{"ticket":{"tags":["needs-review"]}}'
    done
Exports et analyse. Extrayez un mois de conversations en JSON et injectez-le où vous voulez : un tableur, un notebook, un rapide comptage de fréquence des mots sur ce dont les clients se plaignent réellement. C'est bien plus simple depuis le terminal que depuis n'importe quel onglet de reporting.
Synchronisation des connaissances. Poussez votre centre d'aide, vos macros ou vos documents vers une base de connaissances selon un planning pour que les réponses restent à jour. C'est le tissu conjonctif derrière tout vrai workflow de helpdesk avec IA, que vous utilisiez Freshdesk, Gorgias ou Help Scout.
Tâches planifiées. Enveloppez n'importe lequel des éléments ci-dessus dans une ligne cron et il tourne tout seul. Une tâche nocturne qui ferme les tickets stagnants, un export hebdomadaire, une synchronisation horaire, aucun n'a besoin d'un humain dans la boucle :
# Every night at 2am, run the stale-ticket sweep and log the result
0 2 * * * /opt/support/close-stale.sh >> /var/log/support-cron.log 2>&1
C'est la couche où « CLI pour le support client » n'est pas seulement réelle mais tout simplement meilleure que l'interface. C'est scriptable, reproductible et relisible. Le hic, c'est que tout ce qui précède ne fait que déplacer des données. Rien de tout cela ne décide ce qu'il faut dire à un client.
La seule chose qu'une CLI ne peut pas vous donner
Voici où se situe la limite honnête. Vous pouvez scripter le ticket, mais vous ne pouvez pas scripter la réponse. À l'instant où une tâche nécessite de lire le problème d'un client, trouver la bonne connaissance et décider d'une réponse, vous avez quitté le domaine de curl pour entrer dans celui d'un véritable système d'IA. Et ce système est bien plus qu'un simple appel de modèle.
Demandez à quiconque en a vraiment livré un. La récupération à elle seule est une stack complète, pas un simple appel de recherche :
« Si peu de développeurs réalisent qu'il faut plus qu'une simple recherche vectorielle pour du RAG, donc je passe encore beaucoup de mes conférences à insister sur la stack de récupération COMPLÈTE pour le RAG. »

Et dès que le modèle peut à la fois décider et agir sur un ticket, vous avez hérité d'un problème de contrôle qu'un script ne résout pas pour vous :
« Le mode de défaillance que je vois sans cesse n'est pas l'hallucination en soi... c'est la responsabilité floue entre l'intention et l'exécution. Dès qu'un modèle peut à la fois décider et agir, vous avez déjà perdu le déterminisme. »
Donc le vrai coût d'un agent de support scripté, ce n'est pas le endpoint. Ce sont la synchronisation et la récupération des connaissances, l'état de la conversation entre les tours, les actions d'outils contre le helpdesk, les règles d'escalade, les garde-fous, et un moyen de tester tout cela. C'est le même iceberg sur lequel bute chaque équipe dans cette conversation sur le support client headless : la tête (votre terminal, votre canal) n'a jamais été la partie difficile. Le corps en dessous, si.
Tester le support comme du code est le geste qui compte
S'il y a une idée du « support as code » qui mérite d'être volée, c'est celle-ci, et c'est celle que les configurations scriptées sautent. Vous ne livreriez jamais du code applicatif sans tests. La logique de support qui parle à vos clients mérite la même exigence, et l'instinct terminal, « rendez-le reproductible », est exactement ce qui rend les tests possibles.
Le problème, c'est que la plupart des gens se contentent d'activer un agent d'IA et d'espérer. La communauté du support tourne sans cesse autour de la même inquiétude :
« Comment teste-t-on qu'un agent d'IA ne fera rien de catastrophique ? Les gens font-ils vraiment du red teaming sur leurs agents avant leur mise en production ? »

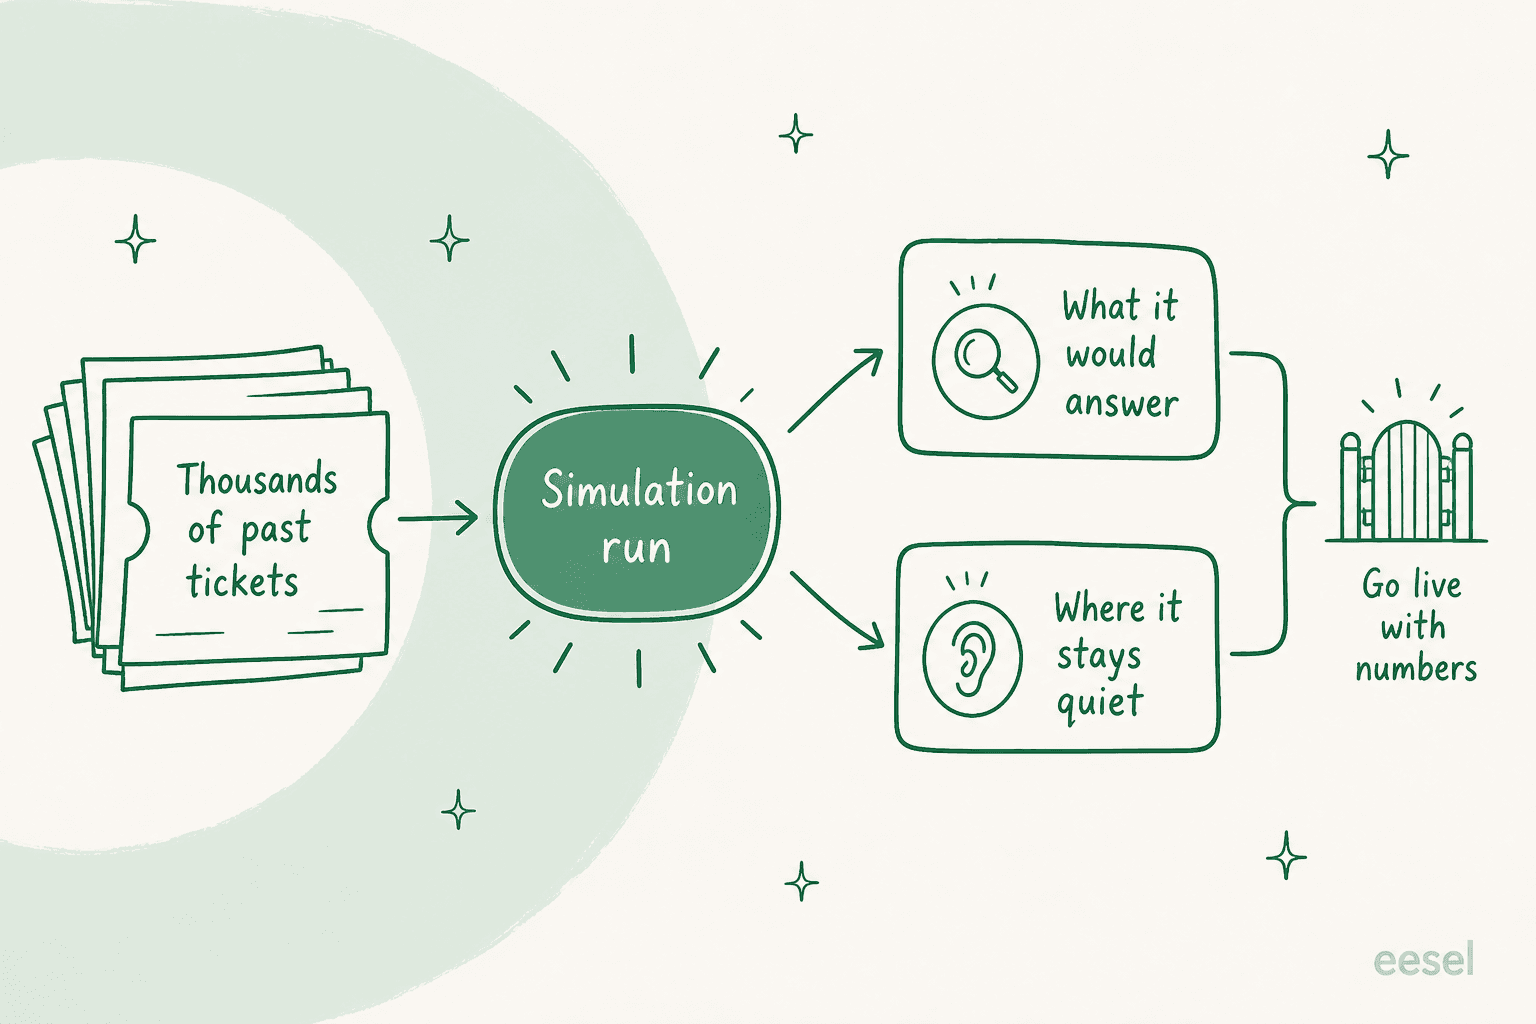
Vous avez déjà la suite de tests. C'est votre historique de tickets. La réponse « support as code » consiste à rejouer des milliers de vos vrais tickets passés contre l'agent et à voir ce qu'il aurait dit, où il aurait escaladé, et où il serait resté silencieux, tout cela avant qu'un seul client ne soit impliqué. C'est exactement ce que fait la simulation d'eesel, et elle transforme « mettre en production et espérer » en « mettre en production avec des chiffres ». C'est ce qui se rapproche le plus de pytest pour le support, et c'est pourquoi nous simulons chaque déploiement contre des tickets historiques en premier.
Ce que ça coûte vraiment
Le coût est l'endroit où l'instinct de construire soi-même rencontre la réalité, et les deux chemins facturent de façons très différentes.
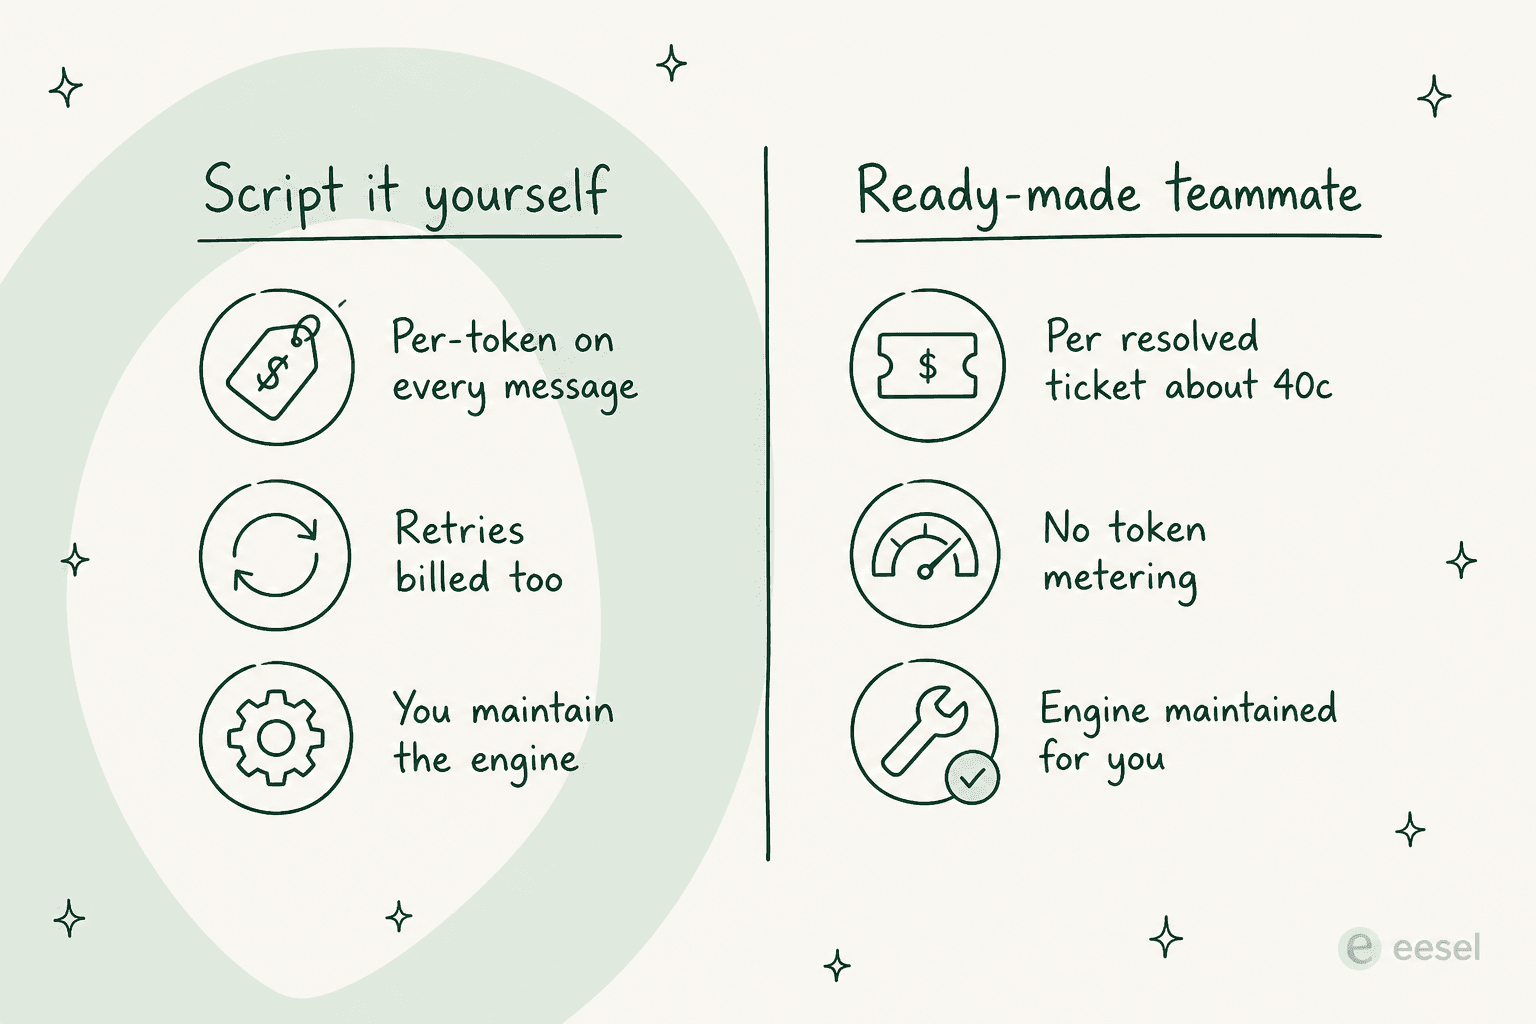
Si vous scriptez un agent sur une API de modèle brute, vous payez par jeton à chaque message, chaque nouvelle tentative, chaque fragment récupéré, que le ticket finisse par être résolu ou non. Une équipe du dossier a brûlé 200 appels API en une seule journée de test et s'est inquiétée de la facture face à ses 9 000 interactions attendues par mois. Et ça, c'est avant de compter le temps d'ingénierie pour construire et maintenir la récupération, l'état, les garde-fous et les évaluations.
Voici comment les options terminal-first se comparent réellement :
| Approche | Avec quoi vous l'exécutez | Vous maintenez | Forme de facturation | Idéal pour |
|---|---|---|---|---|
CLI développeur du helpdesk (par ex. zcli) | La CLI de l'éditeur | Le code de l'app/du thème | Outil gratuit, coût du plan | Construire des apps et connecteurs, pas répondre aux tickets |
| API REST + curl/jq | Scripts bash, cron | Chaque script | Généralement inclus dans le plan | Modifications en masse, exports, configuration, synchronisation |
| API de modèle + MCP | Votre propre code d'agent | Toute la stack d'IA | Par jeton, résolu ou non | Contrôle total, si vous avez l'équipe pour ça |
| Coéquipier prêt à l'emploi | Tableau de bord + surface d'API | Rien | Par ticket résolu (~0,40 $) | Tickets résolus sans construire le moteur |
La dernière ligne mérite un second regard si votre objectif est d'avoir des tickets résolus plutôt qu'un projet de maintenance. Vous conservez malgré tout une surface programmable à scripter, vous n'avez juste pas à construire l'intelligence de résolution en dessous.
Essayez eesel pour un support adapté au terminal
Si vous êtes arrivé ici en cherchant une « CLI pour le support client », vous faites probablement partie des équipes qui veulent une surface programmable, pas un tableau de bord verrouillé. C'est exactement le juste milieu pour lequel eesel est conçu.
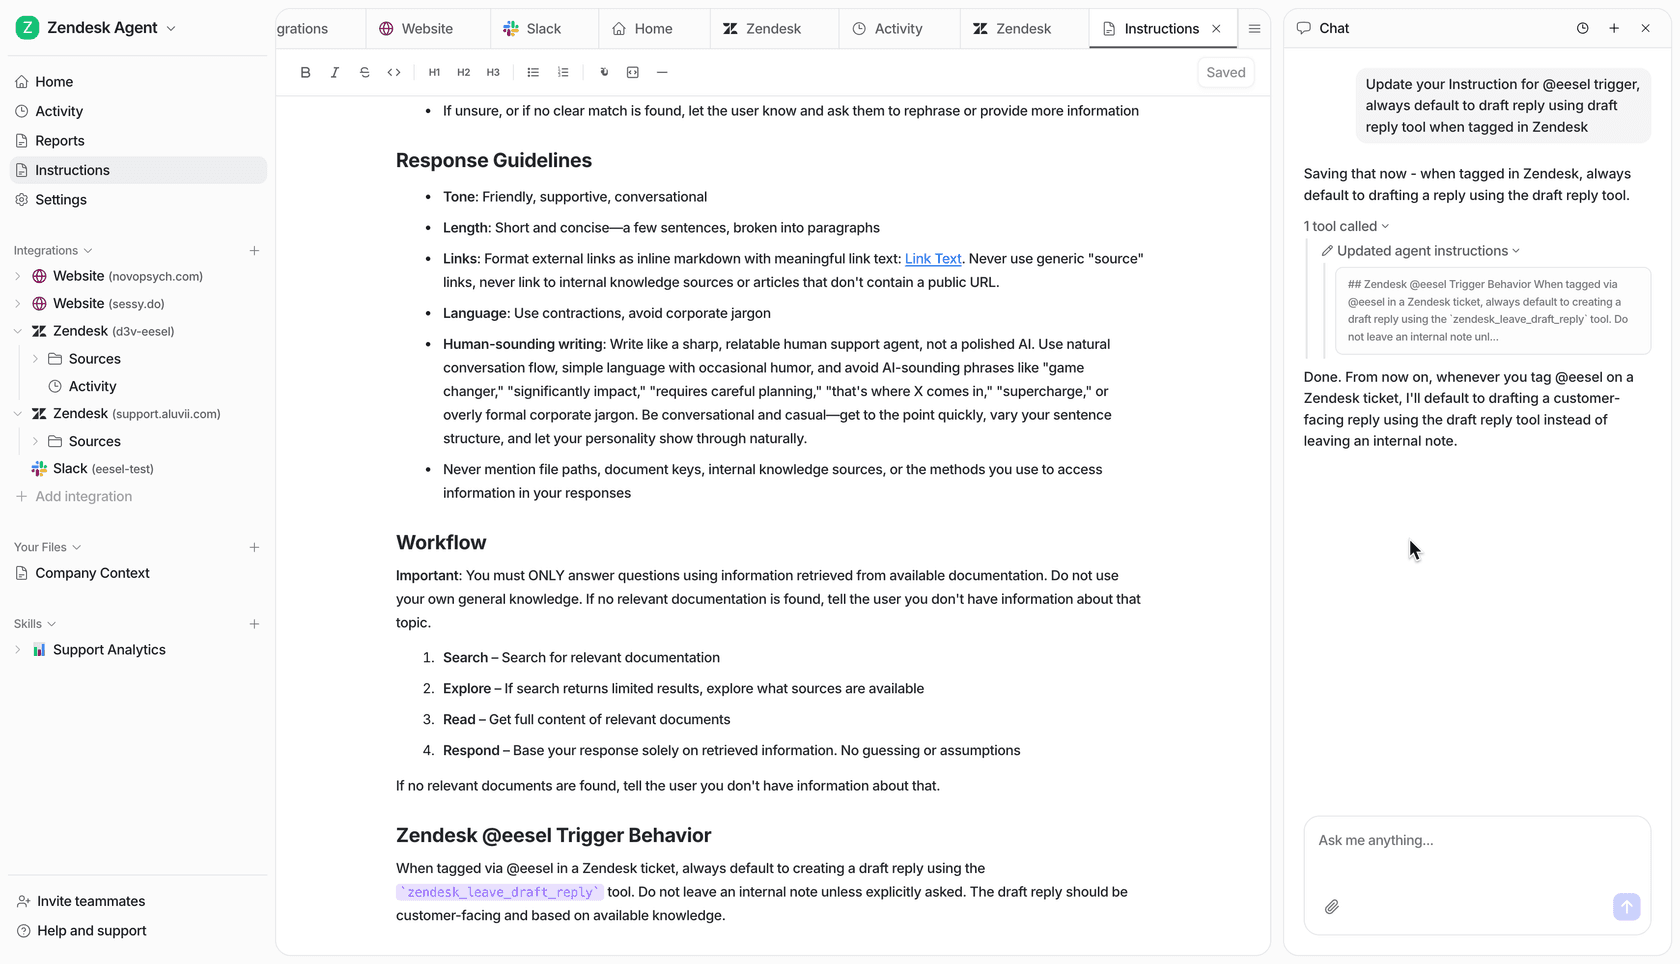
eesel est un coéquipier IA qui se branche sur le helpdesk que vous utilisez déjà, Zendesk, Freshdesk, Gorgias, Front, Help Scout, et arrive en sachant déjà synchroniser vos connaissances, consulter des commandes, taguer des tickets, et rédiger ou envoyer des réponses. Il livre tout le moteur de résolution pour que vous n'ayez pas à reconstruire la récupération, l'état et les garde-fous à partir de zéro, et il conserve la surface programmable pour laquelle vous êtes venu : une API REST pour les actions, des webhooks et des compétences personnalisées que vous pouvez scripter depuis un shell. Puis vient la partie la plus importante : il simule sur des tickets passés avant la mise en production, donc vous déployez avec des chiffres plutôt qu'avec de l'espoir. C'est gratuit à essayer, sans carte bancaire et sans appel commercial, et la facturation se fait par ticket résolu plutôt que par jeton ou par siège.
Questions Fréquentes
Existe-t-il une seule CLI pour le support client qui résout les tickets ?
support resolve #4821 qui comprenne le ticket et le ferme correctement à la fois. Ce qui existe, c'est la CLI développeur propre à un helpdesk (pour construire des apps, pas pour répondre aux tickets), l'API REST que vous pouvez piloter avec curl et jq, et des serveurs MCP qui permettent à un agent d'IA dans votre terminal d'agir sur les tickets. L'intelligence de résolution doit encore venir de quelque part, et c'est là qu'un coéquipier prêt à l'emploi comme eesel trouve sa place.Qu'est-ce que je peux réellement automatiser en ligne de commande pour le support client ?
En quoi le 'support as code' diffère-t-il du simple usage de l'API du helpdesk ?
Combien coûte une configuration de support client scriptée par rapport à une solution prête à l'emploi ?
Puis-je tester un agent de support IA avant sa mise en production depuis le terminal ?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.