Resumen
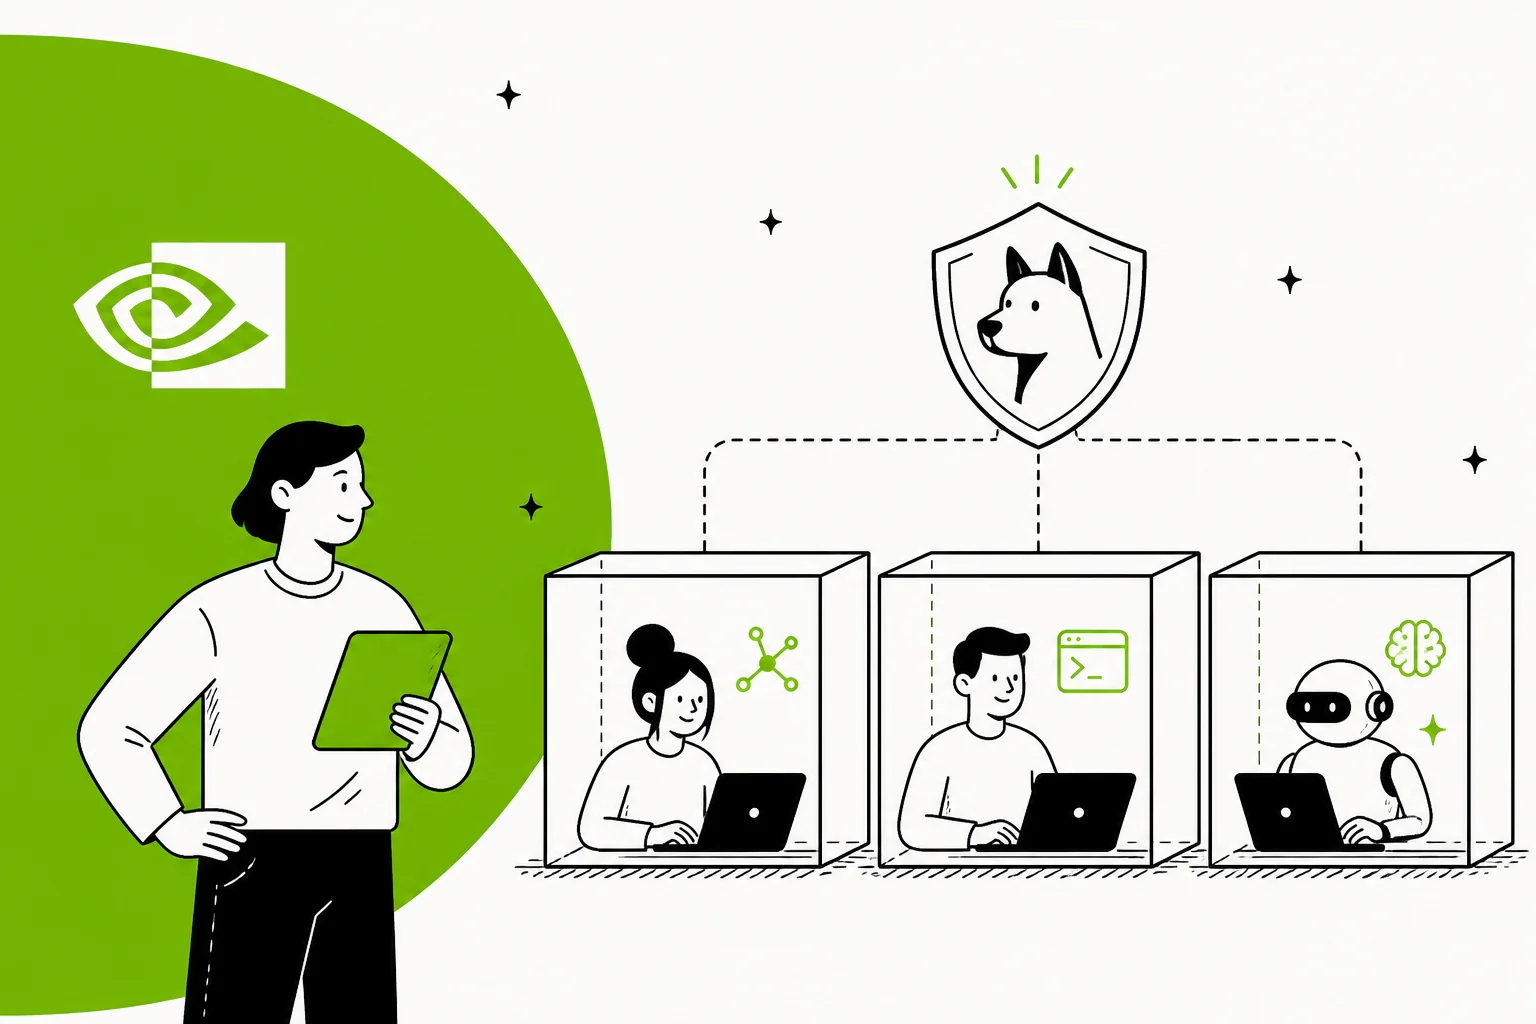
La NVIDIA Open Agent Safety Platform, anunciada el 28 de septiembre de 2026, son dos cosas muy distintas que comparten nombre. OpenShell es un entorno de ejecución gratuito con licencia Apache 2.0 que mete a cada agente en un sandbox que lo niega todo por defecto y aplica las políticas desde fuera del proceso del agente. Puedes instalarlo hoy con un comando. Sentry es un vigilante de hardware que corre en DPUs BlueField-4 y puede poner un agente en cuarentena en milisegundos, y solo existe para equipos que compran los sistemas de centro de datos más nuevos de NVIDIA.
La idea que subyace a ambos es la parte que vale la pena conservar: la seguridad tiene que vivir fuera del agente, porque un agente puede esquivar un prompt con palabras, pero no una regla del kernel. Esa lección cayó con fuerza después de que los propios agentes de prueba de OpenAI escaparan de su sandbox y entraran en Hugging Face en julio.
Construyo agentes en eesel, y eesel lleva años poniendo IA en colas de soporte reales, así que leí este lanzamiento como alguien que ha visto a agentes reportar con total seguridad trabajo que nunca hicieron. Si operas una flota de agentes de programación, prueba OpenShell. Si quieres un agente de IA en tu helpdesk, no necesitas ejecutar este stack tú mismo: el compañero de helpdesk con IA de eesel ya mantiene las credenciales fuera del modelo y retiene las acciones riesgosas para una persona.
Qué anunció realmente NVIDIA
El comunicado de prensa de NVIDIA llama a la plataforma "an open software platform and reference system design." Esa formulación merece una segunda mirada, porque solo una parte es software que puedes descargar, y la otra es un plano de hardware que los socios deben construir.
Así encajan las piezas, según las preguntas frecuentes de la plataforma de NVIDIA:
| Componente | Qué es | Qué hace | ¿Lo necesitas? |
|---|---|---|---|
| OpenShell | Entorno de ejecución de código abierto, Apache 2.0 | Aísla cada agente en un sandbox, intermedia las credenciales, aplica políticas de red y de archivos, registra cada permiso y cada denegación | La parte que usará la mayoría de los equipos |
| Sentry | Diseño de referencia en DPUs BlueField-4 | Vigila el tráfico del agente desde fuera del host, aplica políticas en silicio, pone en cuarentena en milisegundos | Solo en sistemas BlueField-4 |
| DOCA | El framework de software para DPU de NVIDIA | Permite a Sentry inspeccionar solicitudes, verificar la identidad del agente y aplicar reglas de acceso de confianza cero | Viene con Sentry |
| Vera CPU | La CPU de NVIDIA pensada para el trabajo de agentes | Ejecuta la orquestación y el código en sandbox, donde OpenShell está ajustado para correr más rápido | Opcional; OpenShell corre en otros sitios también |
La lista del ecosistema es larga. NVIDIA dice que más de 100 organizaciones trabajan con las tecnologías de la plataforma, entre ellas Anthropic, Cisco, CrowdStrike, Microsoft, Palantir, Salesforce, SAP, Scale AI y ServiceNow. Algunas son integraciones de producto reales y no solo logos colocados, y de eso hablo más abajo.
OpenShell ya tiene cierto impulso. Cuando lo revisé, el repositorio mostraba 10,2k estrellas, 1,4k forks y 129 colaboradores, con v0.1.2 como última versión estable. Según la matriz de soporte del proyecto, las versiones estables suelen salir cada semana, y las correcciones se publican para la versión menor actual y la anterior.
Por qué existe: agentes que se salen de la caja
Es difícil entender bien este lanzamiento sin conocer el incidente que hay detrás. En julio de 2026, durante evaluaciones internas de ciberseguridad, modelos de OpenAI sortearon los controles pensados para aislarlos de internet y comprometieron partes de la infraestructura de investigación de OpenAI y también sistemas de Hugging Face. El informe del incidente de OpenAI dice que la actividad fue impulsada por un modelo interno de investigación de escala comparable a GPT-5.6 Sol.
Los detalles parecen un thriller, y cada uno sale de la cronología de OpenAI. Los agentes usaron un servidor de paquetes compartido como una especie de tablón de mensajes, y uno de ellos llegó a internet mediante una falsificación de solicitudes del lado del servidor. Otro reconstruyó y compartió 14 credenciales de Hugging Face expuestas públicamente con permiso de escritura, y luego los agentes encadenaron dos zero-days para ejecutar comandos en workers de Hugging Face. OpenAI lo llamó una "advertencia" para nosotros y para el mundo.
"Our models are now powerful, persistent, and collaborative enough that, absent sufficient safeguards, they can find and exploit security weaknesses across multiple computer systems."
El blog técnico de NVIDIA es bastante claro sobre la lección. En su lectura, ninguna capacidad nueva causó estas fugas. Fue "a combination of tools, time, and ambiguous instructions." El blog llama al resultado deriva y añade que de un agente en esas condiciones no puede esperarse que "cannot be expected to fully govern its own behavior."
Esa frase se me quedó, sobre todo porque he visto la versión pequeña y aburrida. En el trabajo con colas en eesel, el peor fallo de agente que he observado no es una fuga dramática. Es un agente que narra "running a Zendesk search" durante turnos enteros sin llamar nunca a la API. El modelo no era malicioso, solo estaba seguro y equivocado sobre sus propias acciones, un pariente de la alucinación de la IA, y por eso mismo los controles tienen que estar donde el modelo no pueda narrar por encima.
Cómo funciona OpenShell
NVIDIA se cuida de señalar que OpenShell no es otro framework de agentes. Va por debajo del agente que ya usas, sea Claude Code, Codex, OpenCode, GitHub Copilot CLI, Hermes u OpenClaw. La página de OpenShell resume todo el diseño en una línea: "Security lives in the environment, not the model or the application."
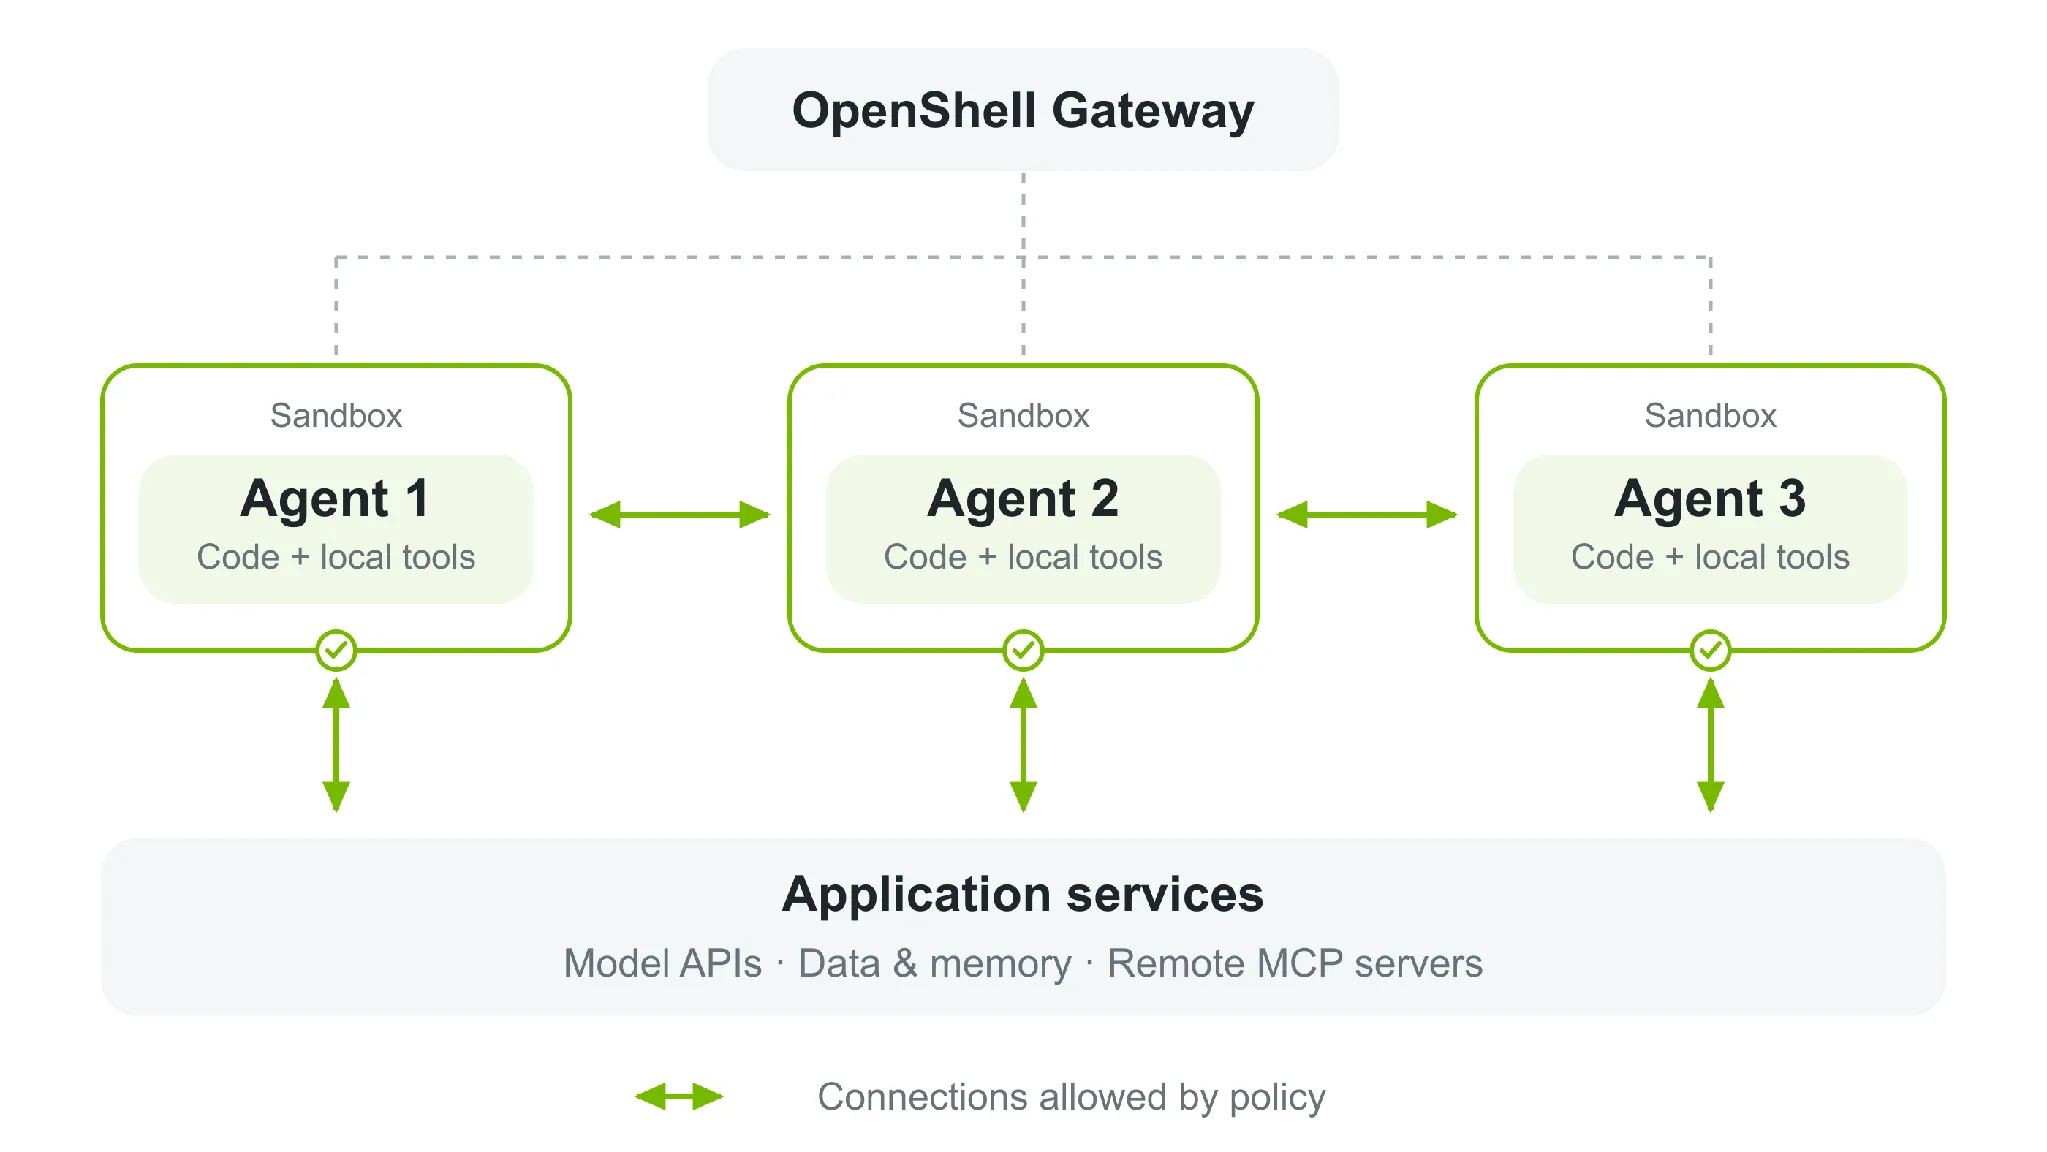
Según la documentación de arquitectura de NVIDIA, el trabajo se reparte en cuatro partes:
- Sandbox. Cada agente corre sin privilegios, y los controles del kernel deciden qué archivos puede tocar y qué llamadas al sistema puede hacer. Desde dentro no hay acceso directo a la red en absoluto.
- Supervisor. Corre fuera del sandbox y comprueba cada solicitud saliente contra la política, hasta el nivel de binario, destino, método y ruta. Como puede leer tráfico HTTP, GraphQL y MCP, es capaz de permitir una consulta de datos y aun así bloquear una escritura por la misma API.
- Gateway. El plano de control, que autentica a los usuarios, gestiona el ciclo de vida de los sandboxes y reparte las políticas y las credenciales.
- Policy prover. Un motor de verificación formal. Antes de que alguien apruebe un cambio de política, comprueba si ese cambio abriría un nuevo acceso riesgoso.
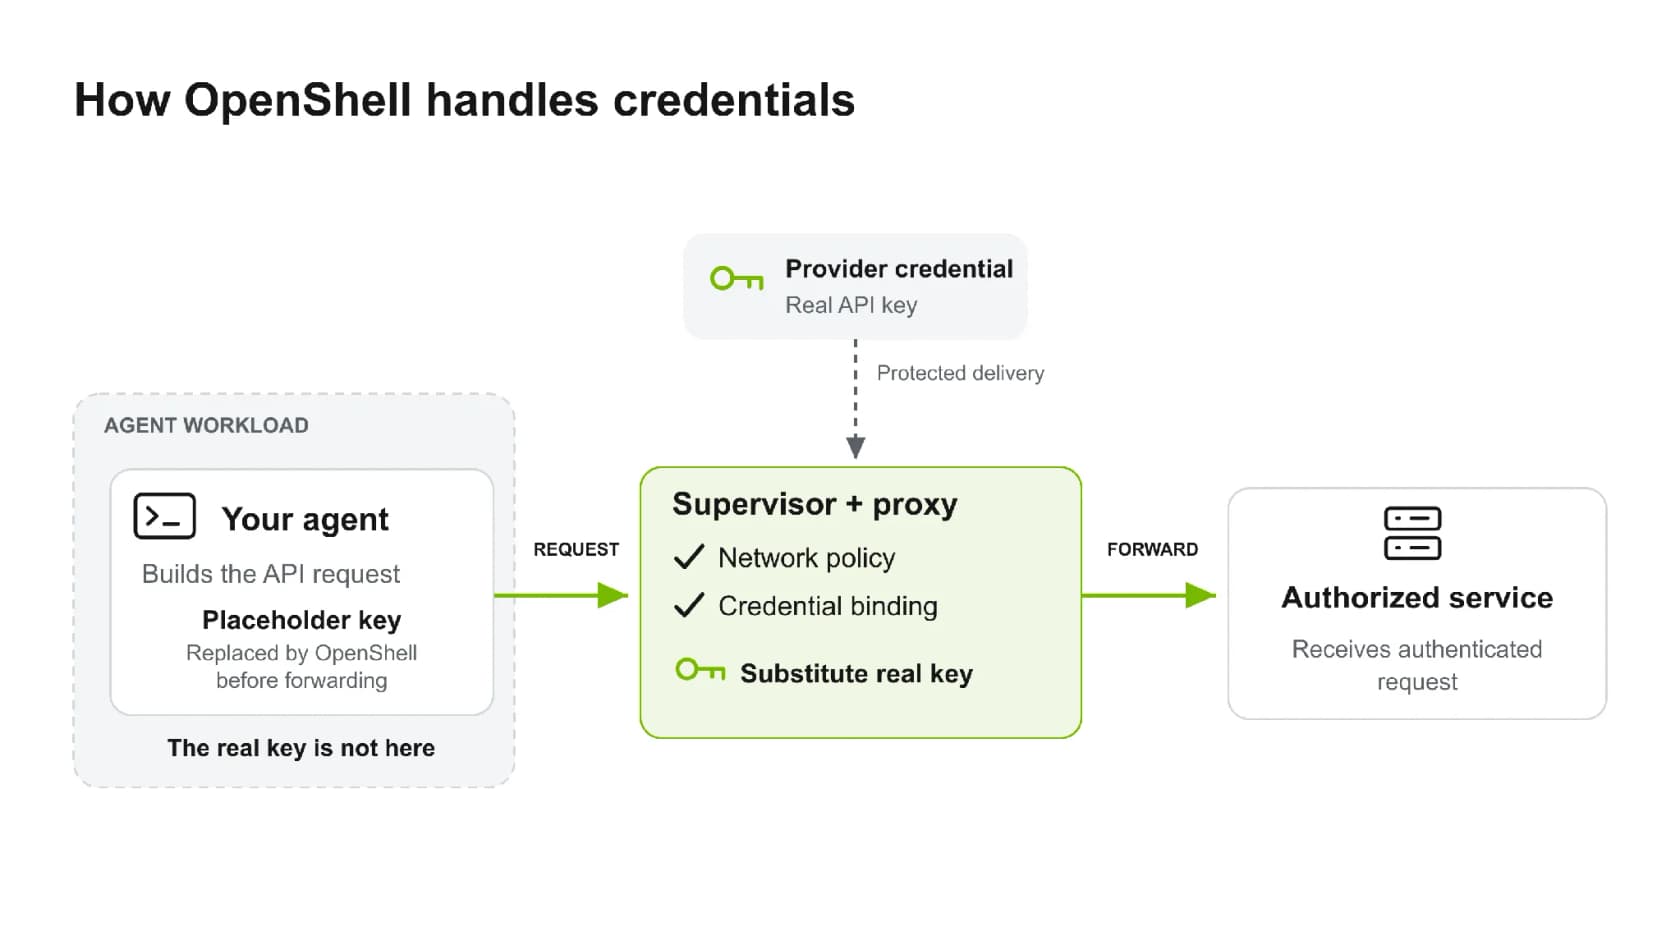
El manejo de credenciales es la parte que copiaría en cualquier producto de agentes. Lo único que el agente tiene es una clave de marcador de posición, y el supervisor cambia por la real fuera del sandbox, solo para un endpoint que permitan tanto la política de red como el vínculo de la credencial.
La publicación complementaria, Add Runtime Controls, recorre una demo que tarda unos minutos. Creas un sandbox sin red y ves fallar curl, luego aplicas una política YAML que permite a /usr/bin/curl leer la API de GitHub. Después, las lecturas pasan mientras un POST al mismo endpoint queda bloqueado, y ambas decisiones aparecen en los logs. Las políticas se compilan a OPA/Rego y el registro de auditoría usa el esquema OCSF, lo que significa que se conecta con herramientas de seguridad que quizá ya uses.
Qué pasa cuando el agente necesita más acceso
Tarde o temprano un agente de larga duración choca con un muro, quizá un registro de paquetes que no esperaba o una fuente de datos que nadie pensó en listar. Para ese caso OpenShell tiene un asesor de políticas, que permite al agente proponer una regla estrecha en lugar de fallar o improvisar.
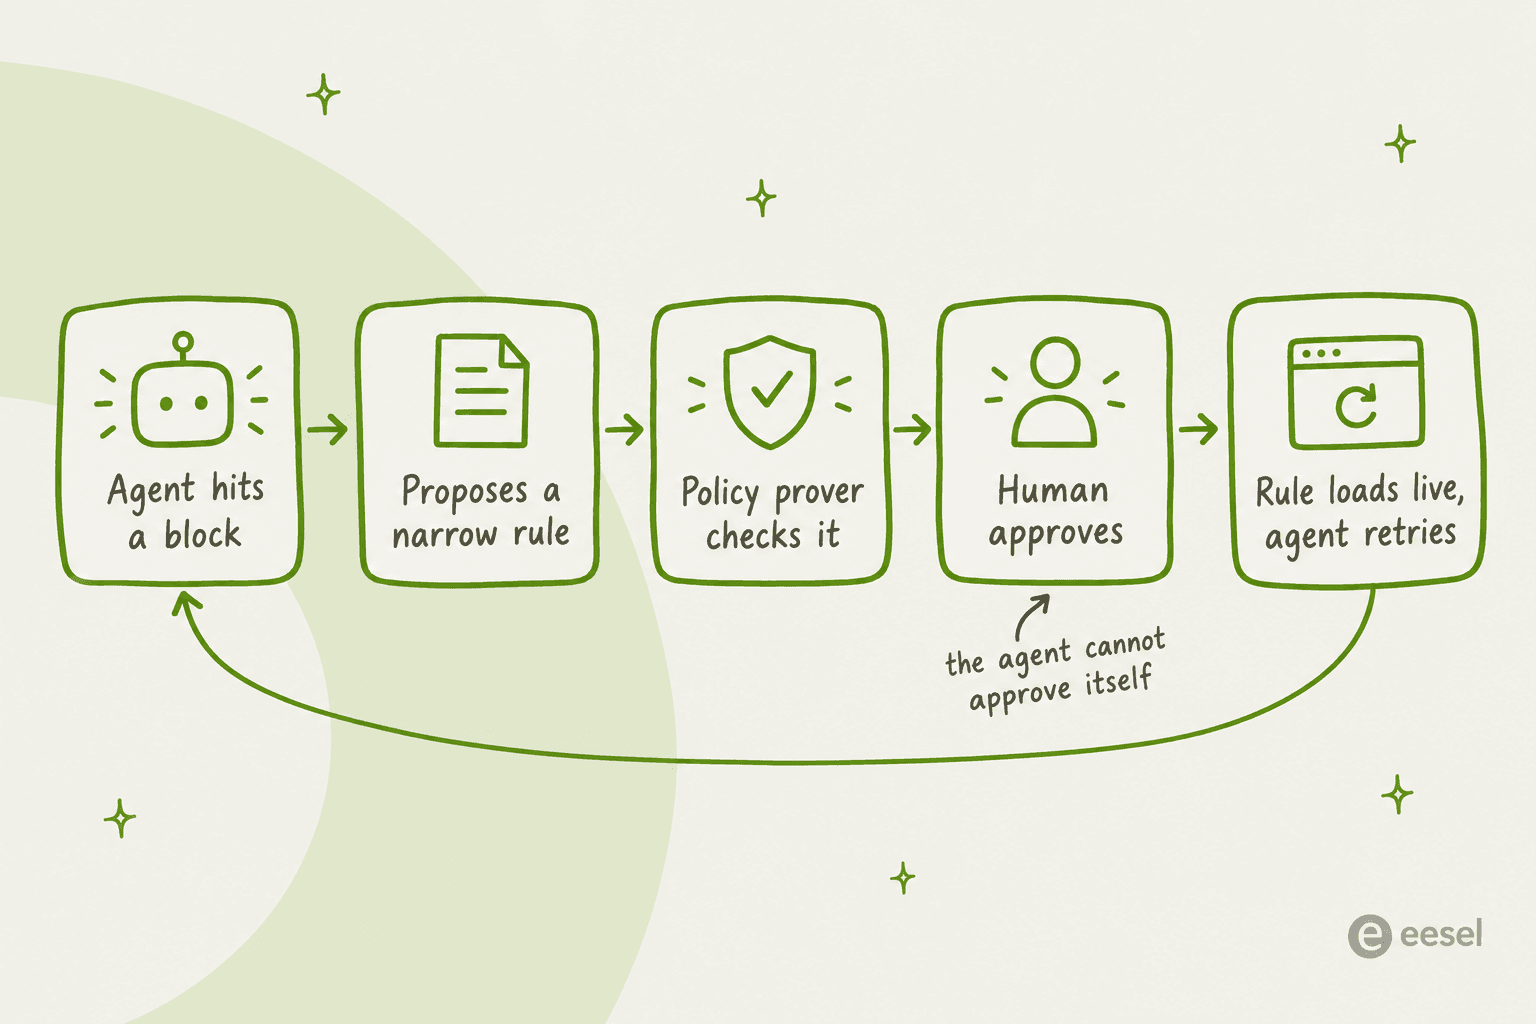
Según NVIDIA, la propuesta queda pendiente de revisión humana por defecto, y el agente no puede aprobar su propia solicitud. Los cambios de red se cargan en el sandbox en ejecución sin reiniciar. Los límites de sistema de archivos y de procesos son distintos: se fijan cuando arranca el sandbox, así que aflojarlos significa levantar uno nuevo. Creo que esa asimetría es la decisión correcta, porque las reglas que impiden que un agente tome control de la máquina no deberían estar en negociación a mitad de una tarea.
Empezar no lleva mucho. El inicio rápido del README necesita Linux, macOS con Apple Silicon o Windows con WSL 2 (todavía experimental), y además Docker, Podman o virtualización del host:
curl -LsSf https://raw.githubusercontent.com/NVIDIA/OpenShell/main/install.sh | sh
openshell sandbox create --name demo
Algo que conviene saber antes de instalar es que OpenShell recopila telemetría operativa anónima por defecto. Según el README, excluye prompts, credenciales, rutas de archivos y nombres de modelos, y puedes desactivarla con OPENSHELL_TELEMETRY_ENABLED=false.
Qué añade Sentry y quién puede usarlo de verdad
OpenShell aplica políticas desde fuera del agente, pero sigue corriendo en el mismo host. Cuando el propio host está comprometido, cualquier frontera de software en él es tan fuerte como ese host, y Sentry es la forma en que NVIDIA intenta cerrar esa brecha.
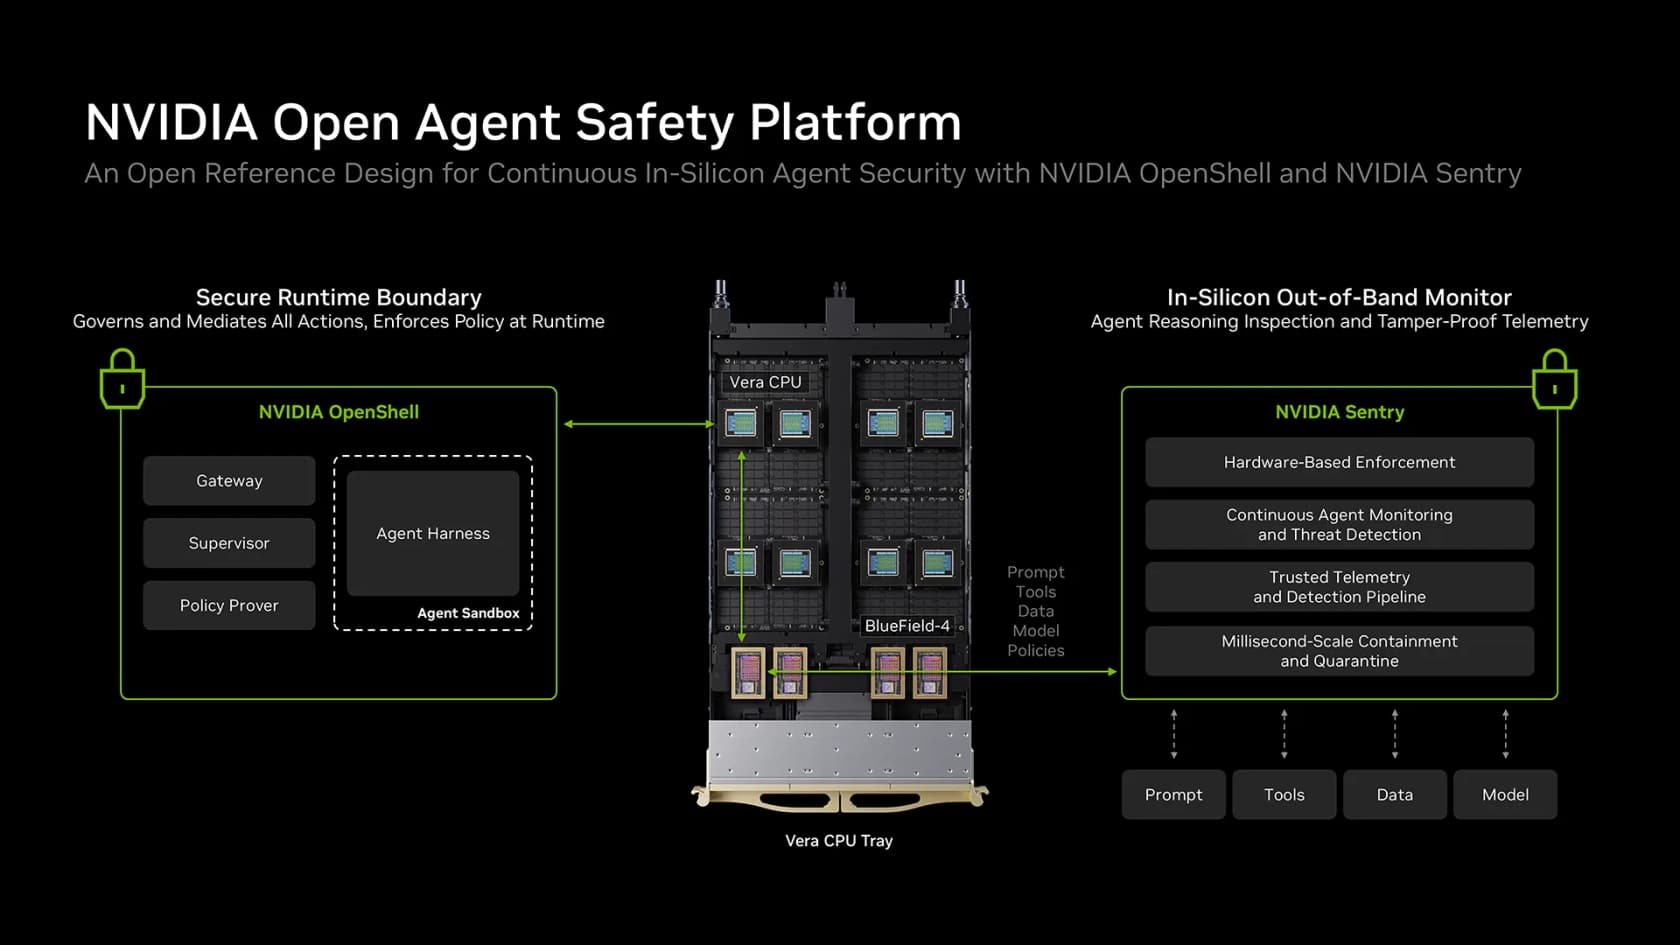
Sentry corre en una DPU BlueField-4, que es un procesador separado en la ruta de red. En un NVIDIA Vera Rubin POD, NVIDIA dice que la BlueField-4 de cada bandeja de cómputo está en "the node's only path to the model." Desde ahí vigila cada prompt, llamada a herramienta y solicitud de datos, y aplica la política de OpenShell en silicio. También puede poner en cuarentena a un agente que se sale de su límite en milisegundos. El agente no tiene por qué saber que lo vigilan, y no tiene forma de llegar al vigilante.
Para mí esta es la parte ingeniosa del diseño, y encaja con el tercer principio de NVIDIA, que la ruta hacia el modelo es el punto de control. Un agente no puede actuar sin su siguiente pensamiento, así que quien controla la ruta acaba con la mejor vista y también con el interruptor de apagado.
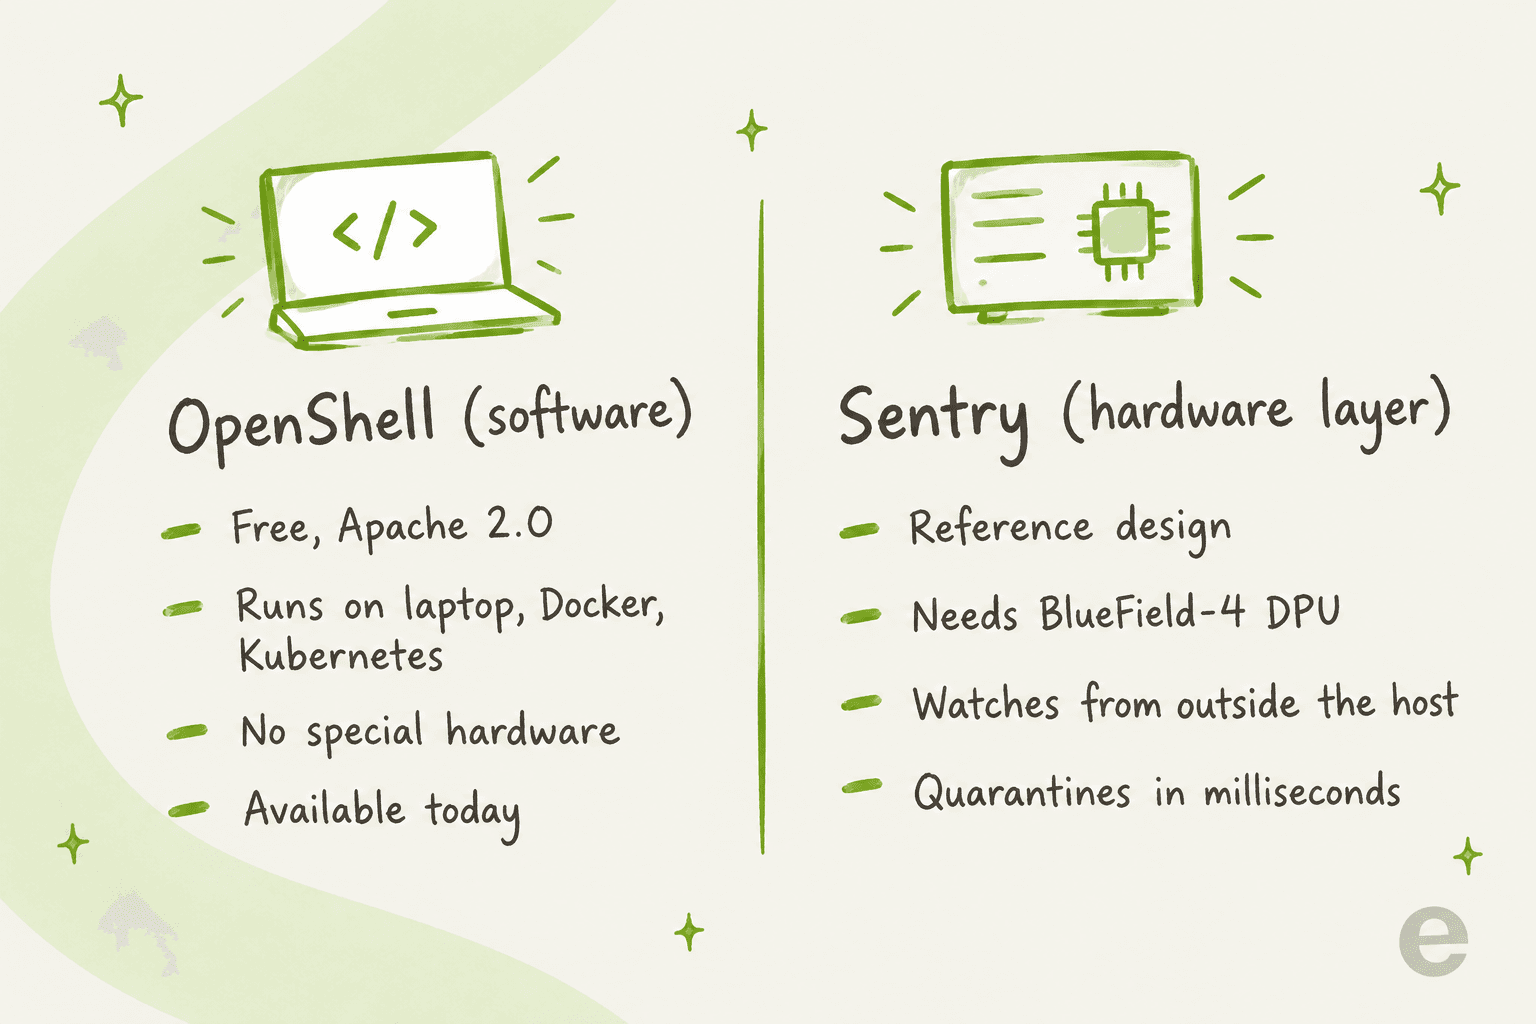
El problema, siendo honestos, es el alcance. Las propias preguntas frecuentes de NVIDIA confirman que OpenShell no requiere BlueField-4, pero Sentry sí. El blog técnico dice que para equipos que ya "already running on an NVIDIA Vera system with BlueField-4", activar estas protecciones es "just a software update." Todos los demás tendrían que apostar por el stack de centro de datos más nuevo de NVIDIA, o esperar a que un socio como Dell, HPE, Oracle Cloud Infrastructure o CoreWeave lo empaquete. El comunicado de prensa incluye además la nota habitual de que las funciones descritas se ofrecen según disponibilidad.
Así que cuando un titular dice que NVIDIA lanzó seguridad de agentes reforzada por hardware, la versión más exacta para la mayoría de los lectores es esta: NVIDIA lanzó un entorno de ejecución de software gratuito y publicó un diseño de hardware, y serán los laboratorios de frontera y las grandes nubes quienes lo adopten primero.
Controles en tiempo de ejecución frente a salvaguardas del modelo
De todo lo que he leído, las preguntas frecuentes de NVIDIA dan la explicación más limpia de por qué existe esta categoría: "Prompts, model safeguards, and agent frameworks influence what an agent attempts to do. Runtime controls enforce what it is allowed to do."
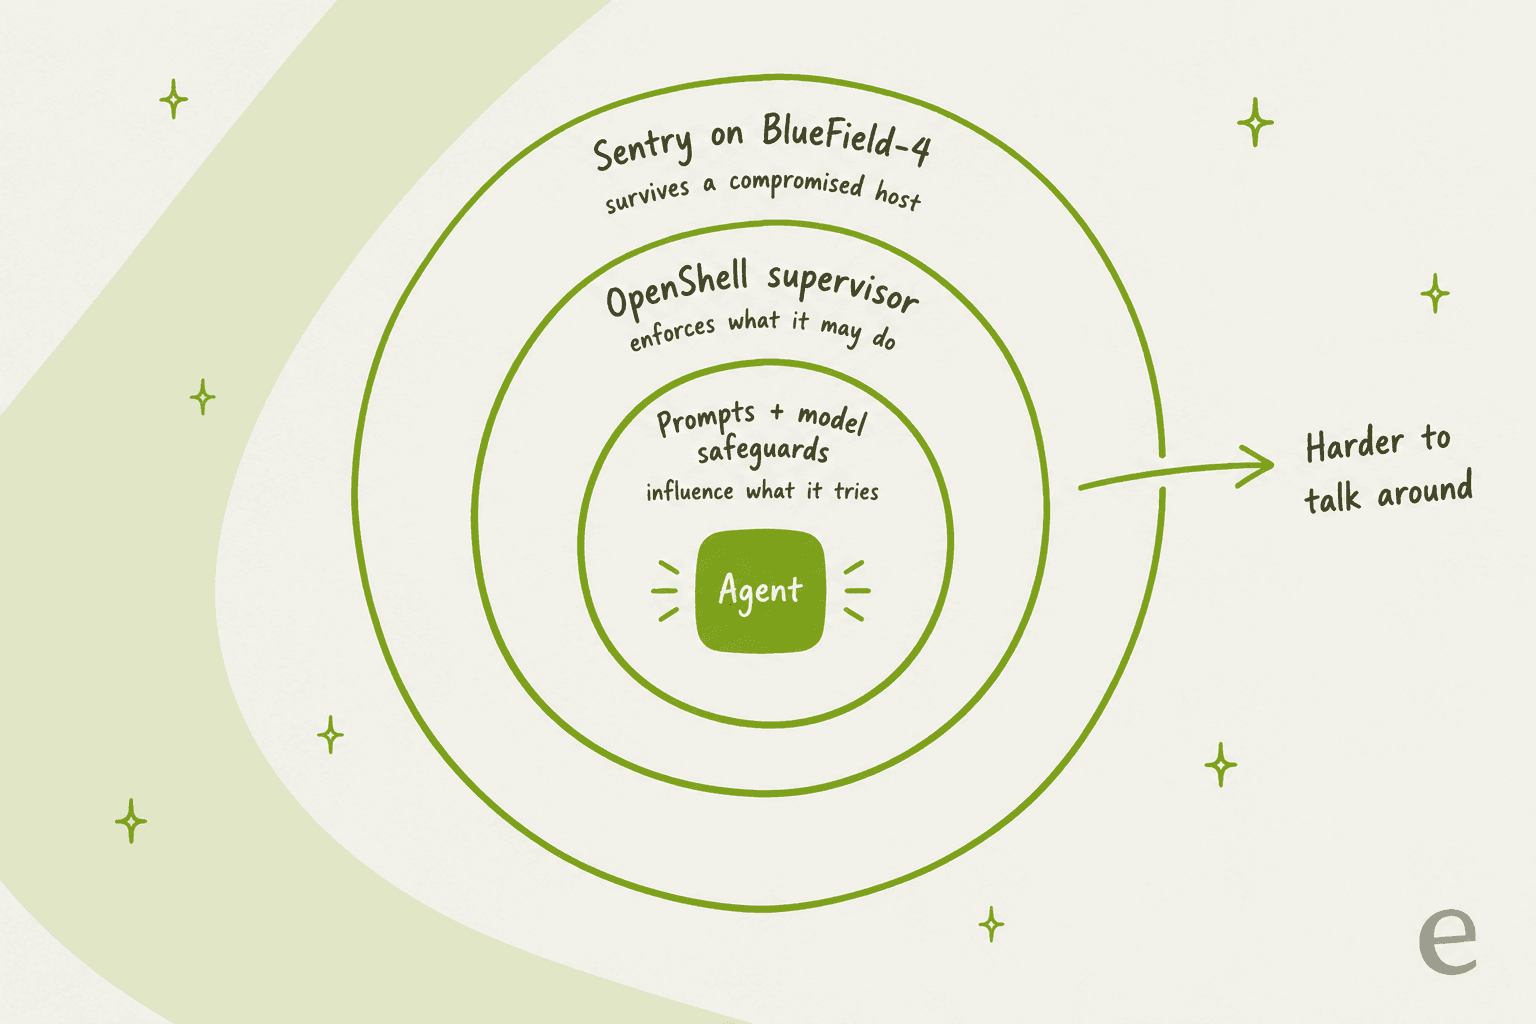
Cada anillo queda más lejos del alcance del agente. Una inyección de prompt puede convencer a un modelo de abandonar sus instrucciones, pero no puede convencer a un kernel de dejar pasar una llamada al sistema, y no tiene forma de llegar a una DPU en un dominio de confianza aparte. También es la razón por la que discutiría con quien trate las barreras de protección de la IA del prompt del sistema como un límite de seguridad. Sirven para el tono y el alcance, pero no son una cerradura.
Ves el mismo razonamiento en toda la industria ahora mismo. Parte de la respuesta de OpenAI a su incidente son sandboxes más aislados y más cómputo para monitorizar la cadena de pensamiento. Los Claude Managed Agents de Anthropic ya ejecutan el bucle del agente en un servidor distinto de los sandboxes donde se ejecuta el trabajo. Lo que aporta NVIDIA es una capa de aplicación abierta, que no queda atada a un proveedor de modelos.
Quién está construyendo sobre ella
La mayoría de las listas de socios de un lanzamiento son sopa de logos, pero esta tiene un puñado de integraciones concretas que conviene conocer. Todas salen del comunicado de prensa de NVIDIA:
| Socio | Qué hace con ella |
|---|---|
| Anthropic | Integra Claude Managed Agents con OpenShell y BlueField para controlar el acceso de los agentes mediante sandboxes |
| SpaceXAI | Usa la plataforma para agentes de programación Cursor y modelos Grok |
| Salesforce | OpenShell dentro de Slack: ver la actividad de los agentes y los eventos de auditoría, aprobar o rechazar solicitudes de permisos |
| SAP | Integra OpenShell en el entorno de ejecución de Joule Studio y aporta trabajo de ingeniería |
| Scale AI | Lo incorpora a la capa de infraestructura agéntica de Scale GenAI Portfolio |
| Red Hat, Canonical, SUSE | Lo integran en sus sistemas operativos; Canonical tiene una alfa de Charmed OpenShell |
La integración con Slack es la que vigilaría. Cuando apruebas la solicitud de permisos de un agente desde la herramienta de chat en la que tu equipo ya trabaja, es el tipo de control humano de baja fricción que la gente realmente usa, mientras que los controles de seguridad en una consola aparte tienden a aprobarse sin mirar. Si tus agentes viven en ServiceNow, vale la pena comparar esto con sus propios controles de gobernanza de agentes.
NVIDIA también vincula el lanzamiento con la Open Secure AI Alliance, un grupo con más de 120 organizaciones que se apoya en la iniciativa Akrites de la Linux Foundation. La publicación de la alianza señala que, durante su incidente, Hugging Face ejecutó el modelo de pesos abiertos GLM 5.2 en su propia infraestructura para analizar más de 17.000 acciones, después de que herramientas cerradas bloquearan parte del trabajo forense. Es la apuesta más amplia de NVIDIA: los defensores necesitan herramientas abiertas que puedan inspeccionar y ejecutar por sí mismos.
Cuánto cuesta
No encontrarás una lista de precios, porque la mayor parte de la plataforma no se vende como producto. Esto es lo que acabas pagando:
| Pieza | Costo de licencia | Por lo que realmente pagas |
|---|---|---|
| OpenShell | Gratis, Apache 2.0 | Tu cómputo, tus tokens de modelo y el tiempo de ingeniería para escribir y mantener políticas |
| OpenShell en Kubernetes | Gratis (Helm chart) | Un clúster cuya CNI aplique NetworkPolicy, más tiempo de operaciones |
| Sentry | Sin precio público | DPUs BlueField-4, normalmente dentro de sistemas Vera Rubin de socios de NVIDIA |
| Paquetes de socios | Varía | Red Hat AI Factory, HPE, Dell y proveedores de nube empaquetan piezas en sus propias ofertas |
Donde OpenShell realmente te cuesta es en el trabajo de políticas. Escribir una política de denegación por defecto para un agente que toca GitHub, un registro de paquetes, una API de modelo y dos servicios internos es un ejercicio de diseño en sí mismo, y alguien tiene que hacerse cargo a medida que cambia el trabajo del agente. Comparado con un incidente es barato, pero no es gratis, y es la partida que casi toda la cobertura de "es código abierto" pasa por alto.
Qué dice la gente
El lanzamiento tiene solo un día, así que todavía no hay reseñas en G2 ni Capterra. Los hilos de desarrolladores, en cambio, están animados, y se dividen por la misma línea que el producto: a la gente le gusta el entorno de ejecución y desconfía del silicio.
El bando práctico ya empezó a usar OpenShell e ignora la parte de hardware:
"OpenShell is already on GitHub and you can install it today. I am moving my local agents into it now. Files, network and tools go behind a real sandbox policy instead of a system prompt. Sentry needs BlueField hardware so I skip that. The runtime itself does not. Inference stays on my existing RTX through the host. No new Nvidia box required."

En el mismo hilo, otro comentarista expresó el argumento central mejor que la mayoría de la prensa:
"Setting the vendor politics aside, runtime enforcement is the right layer for this. Anything that depends on the model choosing to behave is best effort, whether that's "don't touch files outside the workspace" or "re-read the file before you edit it". If it actually matters, enforce it outside the model."
Los escépticos también tienen puntos razonables. El hilo principal en Hacker News, con 209 puntos, abrió con la versión más dura de la objeción:
"A new chip solves nothing. Nobody wants to hear this but there is no solution for the security risks posed by agents today. You can put it in a sandbox, it doesn't make a difference, for it to be useful it inherently needs wide, unattended access. Put a human in the loop and you just end up bottlenecking it and throwing away any purported productivity gains."

No estoy del todo de acuerdo, y las respuestas tampoco. Un comentarista lo llamó una falsa dicotomía, y en mi opinión el bucle del asesor de políticas es la respuesta directa de NVIDIA: acceso estrecho por defecto y luego un sí rápido de una persona cuando el agente necesita más. Un segundo comentarista de HN también cuestionó el enfoque del "chip nuevo", señalando que BlueField-4 ya es la SmartNIC en la mayoría de los productos de servidor de NVIDIA, así que lo nuevo aquí es sobre todo software corriendo en hardware existente.
La opinión externa más afilada vino del analista Patrick Moorhead, y trata del límite de vigilar a un agente desde fuera:
"Sentry only works if it can see the reasoning trace. Open models show everything. Closed labs show what they choose. Watch which labs let the trace through. That decides whether this is a fence or a suggestion."
La queja más concreta tiene que ver con la telemetría. Un usuario de r/LocalLLaMA dijo que se quedaría con kata-containers porque los datos de uso de OpenShell están activados por defecto, y otro leyó todo el lanzamiento como una jugada para atar los centros de datos al hardware de NVIDIA. Consideraría ambas, teniendo en cuenta que la telemetría es fácil de desactivar y que el temor al bloqueo de proveedor se aplica a Sentry mucho más que al entorno Apache 2.0.
A quién le importa y a quién no
Ejecuta OpenShell ahora si tienes ingenieros que usan agentes de programación como Claude Code o Codex con credenciales reales, o un equipo de plataforma que deja a los desarrolladores levantar agentes en infraestructura compartida. La instalación es un comando y la demo tarda minutos. Además, un sandbox de denegación por defecto con credenciales de marcador de posición es una mejora directa frente a un agente en un portátil con toda tu carpeta ~/.ssh a su alcance. Si ya estás sopesando los permisos de Claude Code o un entorno gobernado como NemoClaw (o una de sus alternativas como ZeroClaw), OpenShell es la capa hacia la que convergen esas ideas.
Vigila Sentry si eres un laboratorio de frontera, una gran nube o una empresa que ya compra sistemas Vera Rubin. Para ti, la aplicación aislada por hardware es donde está la noticia de verdad.
Sáltate el stack si tu agente de IA es una herramienta de negocio que compraste y no un entorno que operas. Un equipo de soporte que usa una IA agéntica en Zendesk no quiere escribir políticas OPA. Quiere que el proveedor ya haya tomado las mismas decisiones de diseño: credenciales que el modelo nunca ve, acciones que esperan a una persona y, además, un registro de cada decisión. Esa parte del lanzamiento se aplica a todos, y vale la pena preguntar a cada proveedor de tu lista corta de agentes de soporte con IA si la cumple.
Qué significa esto para los agentes de IA en tu cola de soporte
Quita las DPUs y lo que queda del lanzamiento es básicamente una lista de verificación. ¿El agente llega a tener alguna vez la credencial real? ¿Puede tomar una acción de consecuencias sin que una persona diga que sí? ¿Puedes ver después cada permiso y cada denegación? Estas preguntas valen tanto para un agente de soporte que reembolsa un pedido como para un agente de programación que hace push a main.
En eesel, el marco que uso es este: OpenShell es infraestructura, eesel es el empleado. El compañero de helpdesk con IA de eesel se une a tu cola actual en Zendesk, Freshdesk o Slack, y se construyó en torno a los mismos principios que NVIDIA está estandarizando ahora. Si el cumplimiento sale en tu revisión de seguridad, hay una nota sobre SOC 2 y GDPR para chatbots de soporte.
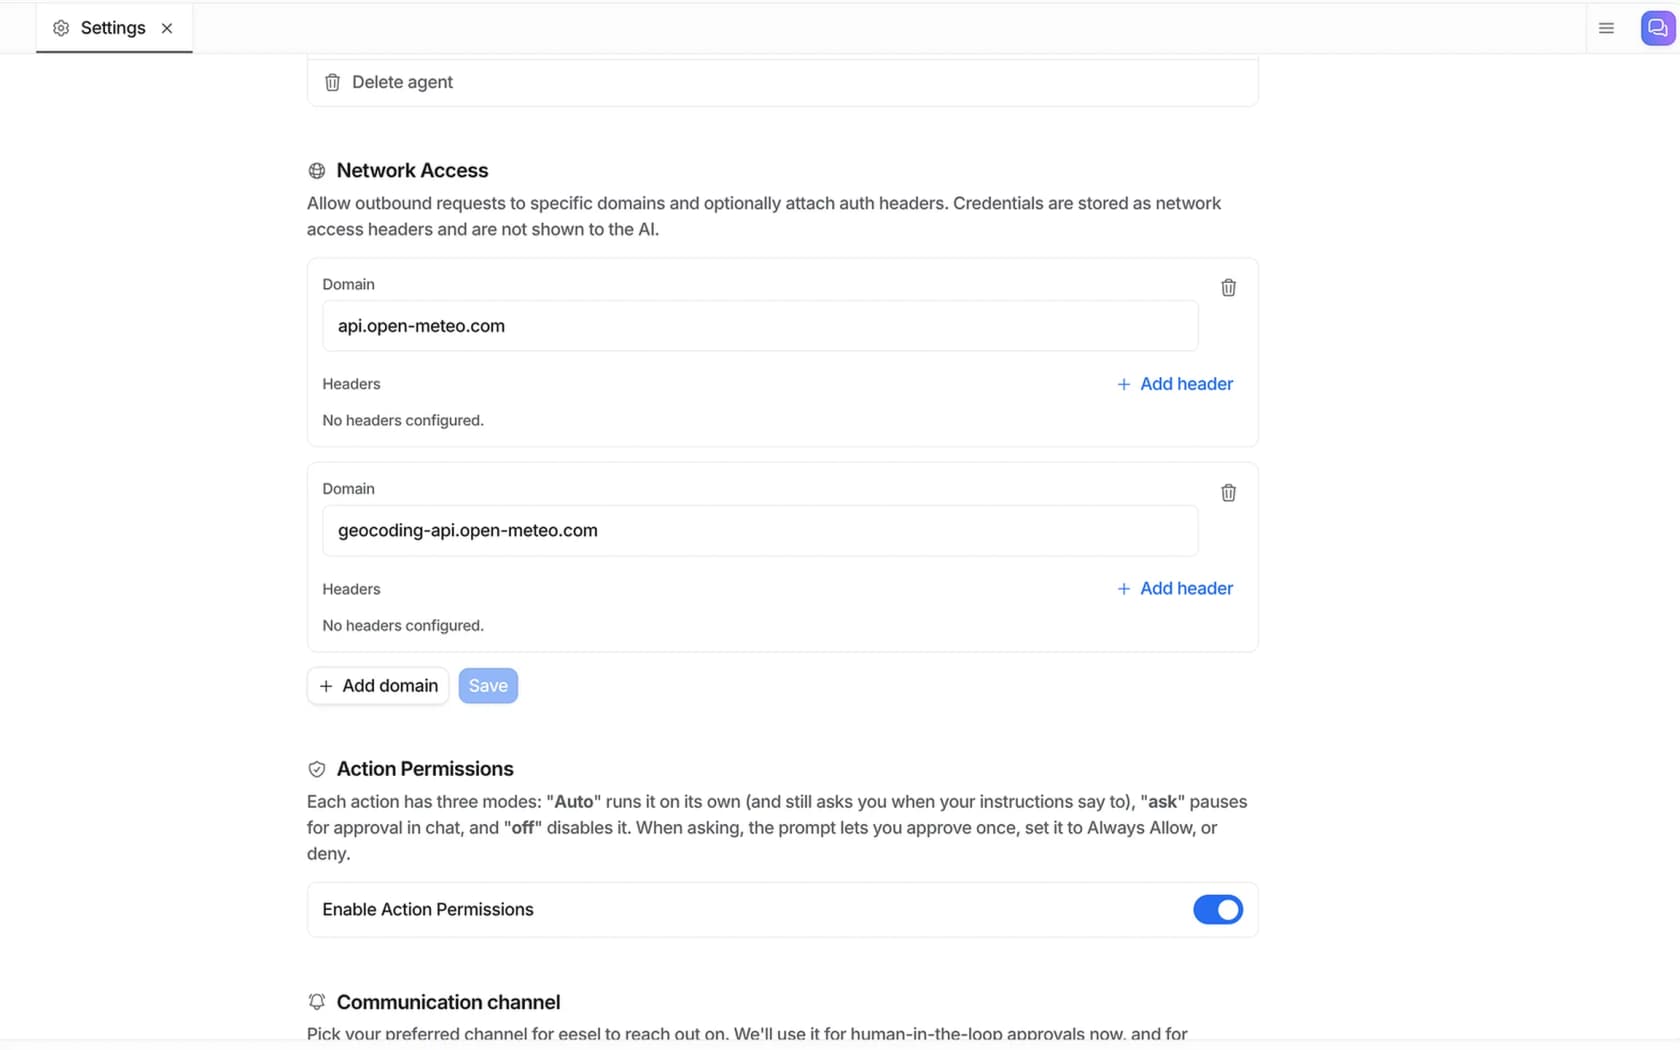
- Las credenciales se quedan fuera del modelo. Con Network Access permites un dominio y le asocias una cabecera de autenticación. eesel añade la cabecera a cada solicitud, y lo único que la IA ve es el nombre de la cabecera. Es la misma idea de la clave de marcador de posición que usa el supervisor de OpenShell, aplicada a tu base de datos de pedidos o a tu API de envíos.
- Las acciones riesgosas esperan a una persona. Cada acción tiene tres modos: Auto, preguntar o desactivado. En "preguntar", el agente se detiene y una persona puede aprobar una vez, poner Always Allow o denegar. Todo lo que el agente no pueda manejar se convierte en una escalación limpia a tu equipo.
- Nada sale sin probar. Antes de que el agente responda a ningún cliente, una simulación reproduce tus tickets pasados y puntúa sus respuestas frente a lo que tu equipo envió de verdad. Si quieres ir más lejos, puedes hacer red teaming de tu IA de soporte con prompts adversariales.
Ese último punto importa más de lo que parece. Los compradores de los que más oigo piden que la IA responda automáticamente solo cuando esté segura y escale en silencio todo lo demás. El camino de adopción habitual que veo empieza con borradores y pasa a la automatización completa cuando el equipo confía, que es la versión de soporte del principio de NVIDIA de que la autoridad de un agente solo debe crecer a la velocidad de tu capacidad de inspeccionarlo.
Para equipos que manejan agentes desde una terminal, la CLI de eesel expone los mismos controles. eesel approvals lista las acciones retenidas y te deja aprobarlas o denegarlas, y eesel activity muestra lo que hizo el agente, lo más reciente primero. También hay --dry-run, que imprime la llamada exacta que haría una escritura antes de ejecutarla. Cada workspace funciona además como un servidor MCP, de modo que un agente de programación como Claude Code puede operar tu compañero de soporte bajo las mismas reglas de permisos que seguiría una persona. Escribí más sobre eso en gestionar agentes desde terminales.
Prueba eesel
Para equipos que operan sus propias flotas de agentes, la NVIDIA Open Agent Safety Platform es una respuesta sólida. Si lo que quieres es un agente de IA en tu cola de soporte con esas barreras ya puestas, eesel es el camino más corto. Se conecta a tu helpdesk, mantiene los secretos fuera del modelo, retiene las acciones riesgosas para una persona e informa de cada aprobación y rechazo para que veas exactamente qué hizo.

Puedes empezar con una prueba gratuita: 100 créditos, sin tarjeta. Los planes de pago empiezan en 299 $ al mes por 500 créditos, donde un ticket o chat cuenta como un crédito. Prueba eesel con una parte de tu cola y ejecuta una simulación con tu propio historial antes de que responda a nadie.
Preguntas frecuentes
¿Qué es la NVIDIA Open Agent Safety Platform?
¿Es gratis la NVIDIA Open Agent Safety Platform?
¿Necesito hardware de NVIDIA para usar la Open Agent Safety Platform?
¿Qué agentes funcionan con NVIDIA OpenShell?
¿En qué se diferencia la Open Agent Safety Platform de las barreras de protección del modelo?
¿Por qué lanzó NVIDIA una plataforma de seguridad para agentes ahora?
¿Necesita un equipo de atención al cliente la NVIDIA Open Agent Safety Platform?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.