Resumen
Planté 5 errores de seguridad en una pequeña app de tickets en Flask y ejecuté el escáner Codex Security de OpenAI, el mismo que impulsa Codex Security Cloud. Encontró los 5, sin falsos positivos, y escribió un informe de 55 KB con un modelo de amenazas y una corrección para cada uno. El análisis fue mejor que el de la mayoría de los escáneres estáticos que he usado.
Los peros son el coste y la fricción. Esa app de 60 líneas tardó casi 9 minutos y costó entre 3,75 y 6,77 dólares en tokens de API, y mi primer intento falló durante la configuración después de gastar cerca de un dólar. El acceso por plan también es confuso. El anuncio de lanzamiento de OpenAI dice Pro, Business, Enterprise y Edu, mientras que su propia matriz de precios dice solo Enterprise y Edu.
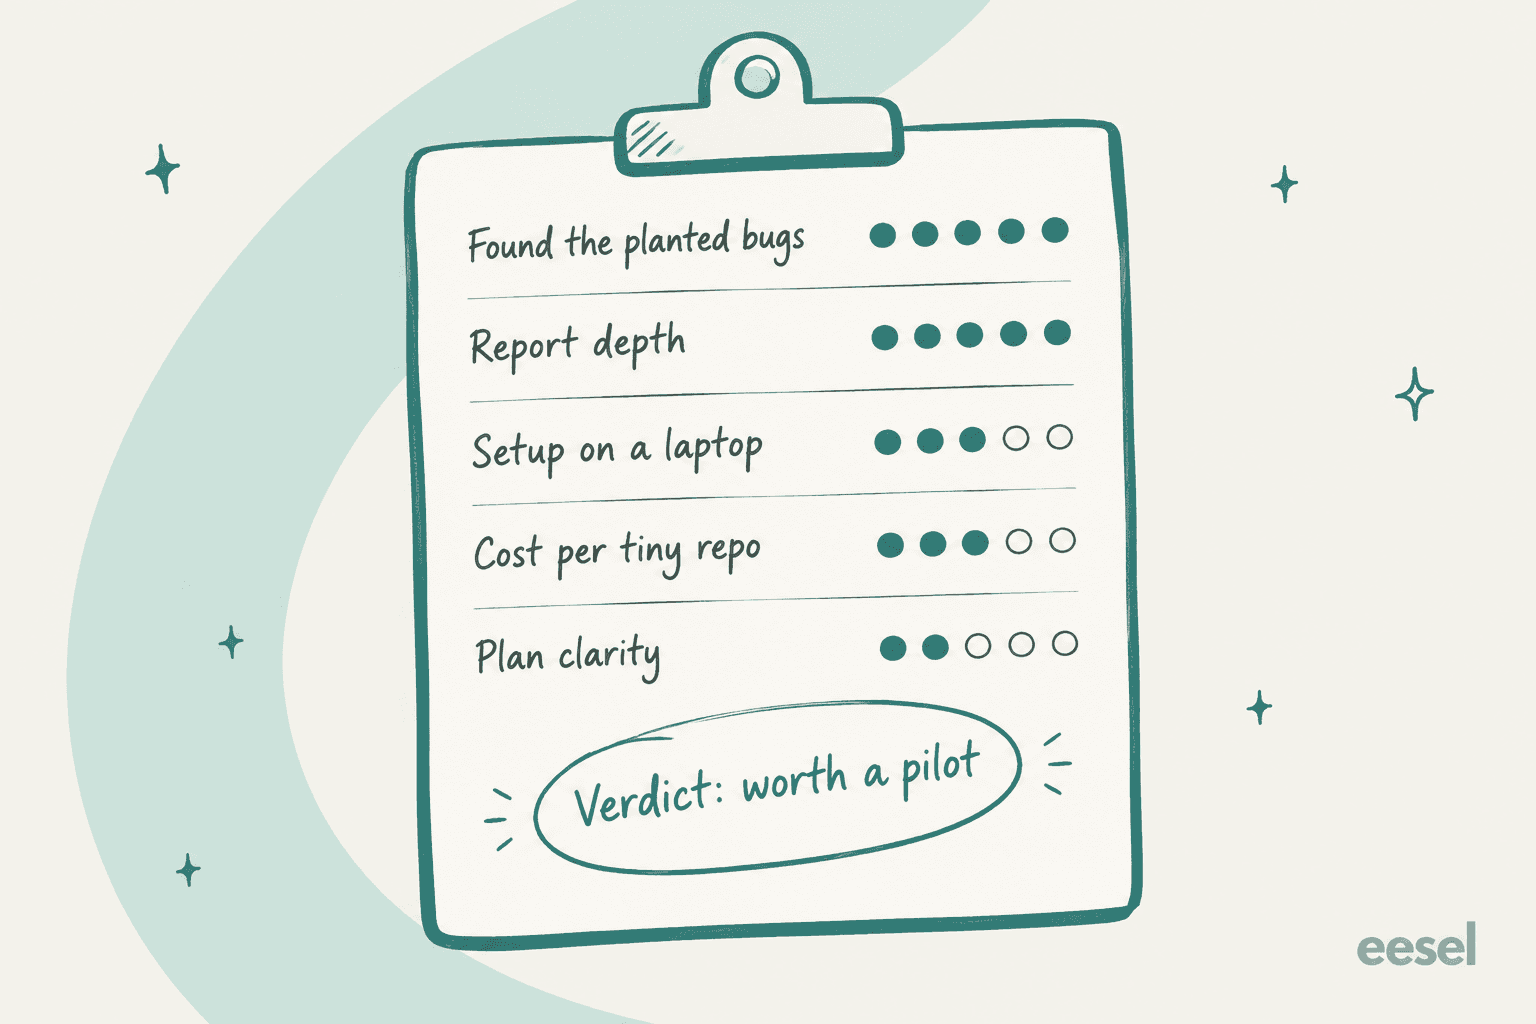
Mi veredicto es 3,5 sobre 5. Vale la pena un piloto en un repositorio importante si ya pagas ChatGPT Pro, Business o Enterprise, pero no dejes que reemplace a tu escáner basado en reglas. En eesel construyo integraciones, y llevamos más de tres años poniendo agentes de IA en colas de soporte reales; la lección se aplica aquí. Prueba al agente con trabajo pasado antes de confiarle trabajo nuevo.
¿Qué es Codex Security Cloud?
Codex Security es el agente de seguridad de aplicaciones de OpenAI dentro de OpenAI Codex. Lee tu código y construye un modelo de amenazas, busca vulnerabilidades, comprueba cada una y además propone una corrección. La versión Cloud se lanzó en el DevDay el 29 de septiembre de 2026 como un plugin que se ejecuta en Codex cloud contra repositorios de GitHub conectados. Según el resumen del DevDay de OpenAI, puede escanear repositorios completos "on demand or on a schedule, with ongoing checks of new commits," incluso con tu portátil cerrado, lo cual es práctico.
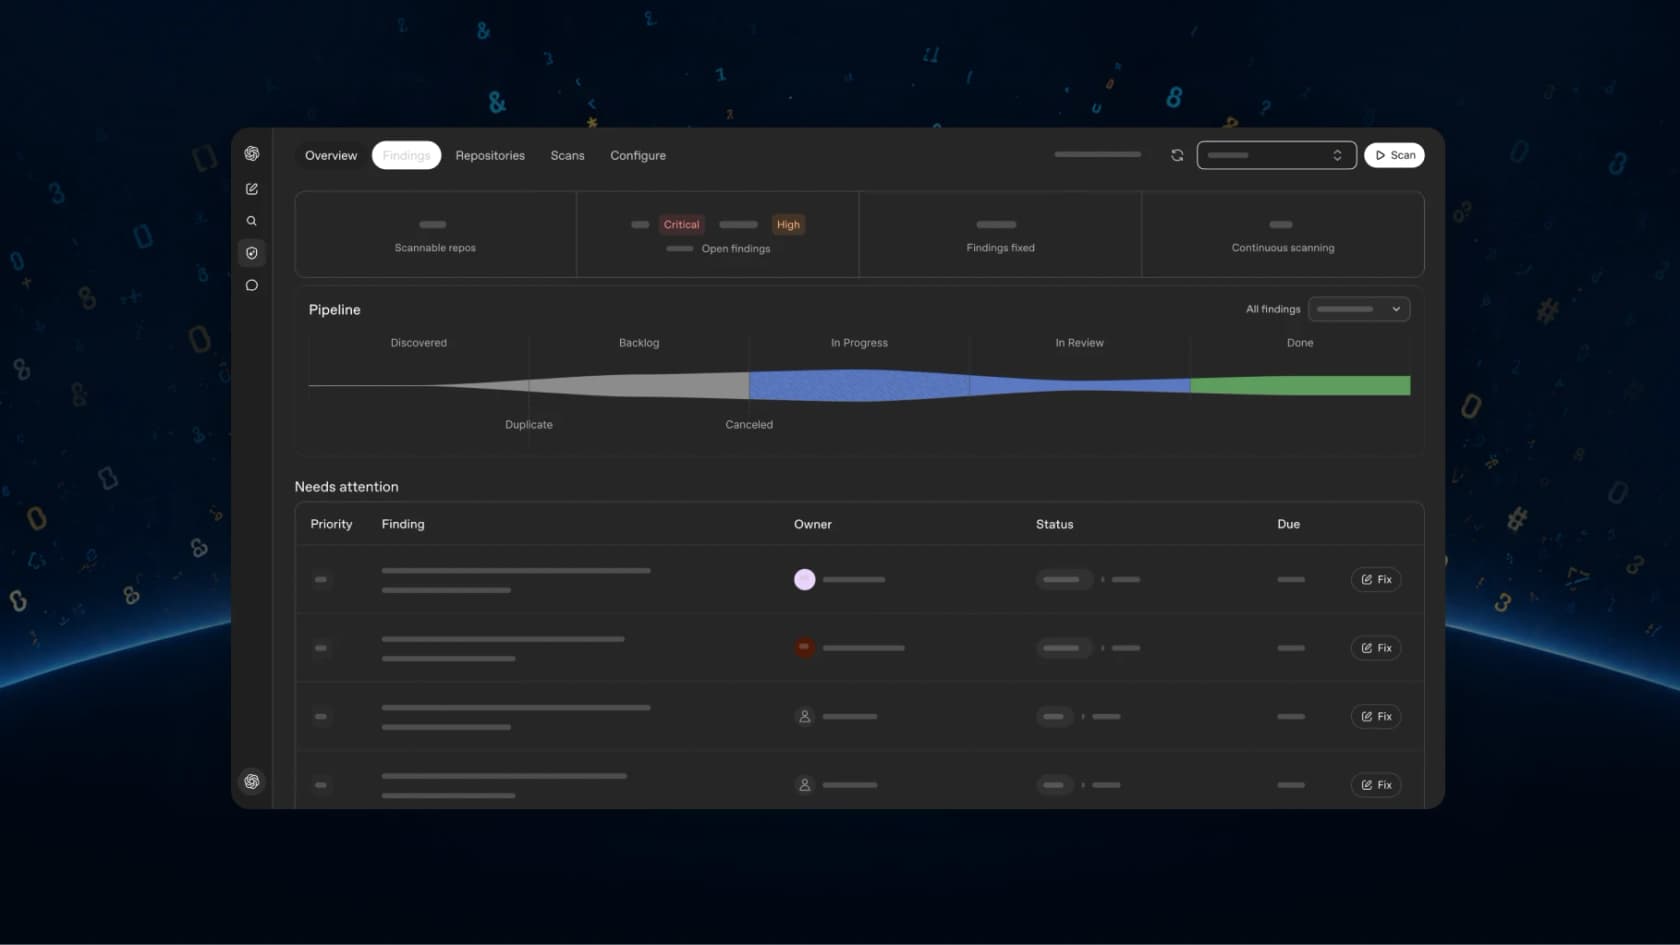
La mejora principal es el acceso a Daybreak Blue, el modelo de OpenAI con menos rechazos para trabajo de seguridad defensiva, "without a separate Daybreak application." Eso importa porque, de lo que la gente se quejaba antes de Cloud, la queja más común no eran los malos hallazgos. Eran escaneos que corrían media hora y luego eran rechazados. Mi artículo sobre GPT-5.6-Cyber explica cómo funcionan los niveles Blue y Red.
Si quieres el recorrido completo de funciones, mi explicación de Codex Security Cloud repasa la configuración, las cuatro superficies y la historia desde Aardvark. Este artículo es el veredicto.
Cómo lo probé
No tengo un espacio de trabajo de equipo con el plugin de Cloud activado, así que usé lo más parecido. Es la CLI de Codex Security de código abierto, que incluye el mismo plugin de Codex Security y ejecuta el mismo pipeline desde tu terminal. Usé la versión 0.1.31 con sus valores por defecto: modelo gpt-5.6-sol con esfuerzo de razonamiento xhigh en modo de escaneo estándar, autenticado con una clave de API de OpenAI.
El objetivo de la prueba era una API interna de tickets diminuta que escribí para esto. Es un único archivo Flask de unas 60 líneas, más un README de una línea que dice que corre en una red de empresa. Planté cinco errores clásicos:
- Inyección SQL en una búsqueda de tickets que concatena el correo del cliente en la consulta.
- Path traversal en la descarga de adjuntos, que une un nombre de archivo proporcionado por el usuario a una carpeta.
- Inyección de comandos en una ruta de exportación de administrador que pasa un valor
formatal shell. - Falta de autorización en una ruta de borrado, con un comentario
# TODO: only admins should do this. - Modo debug en todas las interfaces, con
app.run(host="0.0.0.0", debug=True).
Son errores fáciles, y ese es el objetivo de la prueba. Si un agente de seguridad se pierde errores de manual en 60 líneas, nada más importa. Si los detecta, la pregunta interesante pasa a ser qué tan bien los explica y cuánto cuesta llegar ahí.
Sobre mi prueba, conviene señalar dos límites antes de los resultados. Primero, una clave de API no da acceso a Daybreak Blue, así que ejecuté con las salvaguardas estándar, un ajuste más duro en cuanto a rechazos que el de Cloud. Segundo, el escaneo estándar de la CLI validó los hallazgos rastreando el código fuente, y su informe dice "no runtime query was executed." La documentación de Cloud describe reproducir los hallazgos en un contenedor aislado, algo que aquí no pude probar.
Qué encontró Codex Security
La segunda ejecución terminó en 8m 56s con cobertura completa. Este es el resumen que imprimió:
FINDINGS  5 (5 confirmed this scan; 0 previously found; 2 high, 2 medium, 1 low)
COVERAGE  complete
ELAPSED   8m 56s
TOKENS    18,684 uncached input, 3,357,854 cache reads, 173,804 cache writes, 73,204 output, 3,623,546 total
COST      $3.7509776–$6.7699152 (standard, context unknown)
Y así encajan sus hallazgos con lo que planté:
| Lo que planté | ¿Lo encontró? | Gravedad asignada | Su razonamiento |
|---|---|---|---|
Inyección de comandos en /admin/export | Sí | Alta | Una sola solicitud sin autenticar da ejecución de comandos; no llega a crítica porque la app es interna |
| Falta de autenticación en el borrado | Sí, ampliado a todas las rutas | Alta | Ninguna ruta comprueba la identidad, así que cualquier cliente de la red puede leer, modificar y borrar tickets |
| Path traversal en adjuntos | Sí | Media | El escape de ruta es directo, pero el impacto depende de qué archivos pueda leer la cuenta de servicio |
| Inyección SQL en la búsqueda | Sí | Media | El SQLite de Python ejecuta una sentencia a la vez, así que no hay escrituras apiladas, solo lectura de datos |
debug=True en 0.0.0.0 | Sí | Baja | Expone páginas de error de depuración, y la consola aún requiere un PIN para desbloquearse |
Cinco de cinco, todos con confianza alta y nada inventado. En una app de juguete eso es el mínimo, no un trofeo. Lo que más me impresionó fue el razonamiento de gravedad. La mayoría de los escáneres marcarían la inyección SQL como crítica por reflejo, que es el hábito habitual. Este notó que sqlite3 de Python no ejecuta sentencias apiladas, así que el daño se queda en leer datos, y la calificó como media con una nota sobre qué la subiría. Es el tipo de decisión que tomaría un buen revisor humano.
Tampoco se detuvo en mi comentario TODO. Encontró que la ruta de actualización de estado tenía la misma comprobación ausente, y juntó ambas en un hallazgo más amplio: la app no tiene autenticación alguna. Es un encuadre más útil, ya que corregir una sola ruta dejaría el resto abierto.
Cómo es el informe
La carpeta de salida contenía un report.md, un findings.json, un coverage.json y una exportación SARIF que puedes subir a la vista de code scanning de GitHub. El informe ocupa 55 KB para una app de 60 líneas, así que no es una herramienta que escatime en detalle.
Antes de cualquier hallazgo, escribe un modelo de amenazas de tu app. Enumera los activos (la base de datos de tickets, la carpeta de adjuntos, el acceso al shell del proceso), las fronteras de confianza y lo que puede hacer un atacante realista. Incluso señaló lo que no podía ver. Mi ruta de exportación llama a un export.py que no existe en el repositorio, y el informe lo dice en lugar de adivinar.
Cada hallazgo recibe luego una justificación de gravedad, la evidencia trazada línea por línea, la "contraevidencia" que reduciría el riesgo y una sección de remediación con pruebas por escribir. Para la inyección de comandos, la corrección dice:
"Require administrator authorization, remove
shell=True, invoke a fixed interpreter and script with an argument vector, and allowlist the supported export formats."
Es correcto y además específico. También sugirió dos pruebas: una que comprueba que los metacaracteres de shell en format nunca inician un segundo proceso, y otra que comprueba que quienes no son administradores no pueden llegar a la ruta. No pasé --patch, así que no escribió código. En Cloud, el equivalente es el botón Fix with Codex, que redacta un parche para que lo revises antes de seleccionar Create draft pull request, según la guía de configuración de Cloud.
Si has usado /security-review de Claude Code, esto es bastante más estructurado. El informe se lee como un documento de auditoría, no como un comentario de código.
Dónde tropezó
Mi primera ejecución falló. El escaneo pasó dos minutos y medio en su etapa previa y luego terminó con "Scan agent did not create required draft artifacts" y una carpeta de salida vacía. Los registros mostraron que el agente no podía ver los ajustes de entorno que necesitaba, incluida la ruta de Python. Ya había usado 527.000 tokens de entrada, unos 0,74 a 1,40 dólares, para no producir nada. La segunda ejecución funcionó después de pasar la ruta de Python explícitamente y dejar que heredara el entorno de mi shell.
No soy el único al que le pasó. Un issue abierto en el repositorio, #73, describe el mismo patrón en Windows y Linux: el escaneo corre, se facturan los tokens, luego falla el guardado y "the 'partial output' directory is completely empty." El indicador --max-cost de la CLI no te salva aquí, y las preguntas frecuentes de la CLI de OpenAI dicen que el límite es "an estimate, not a hard spending cap." Lo fijé en $4, y el extremo alto de mi estimación final fue 6,77 dólares.
Este es el argumento más fuerte a favor de Cloud frente a la CLI. En Cloud, OpenAI se encarga del contenedor, el entorno y la configuración de Python, así que toda esta clase de fallos de configuración local no debería llegarte.
¿Es razonable el coste?
El coste es lo que me hizo bajar la nota. Mi escaneo usó 3,6 millones de tokens en 60 líneas de código. El desglose lo explica:
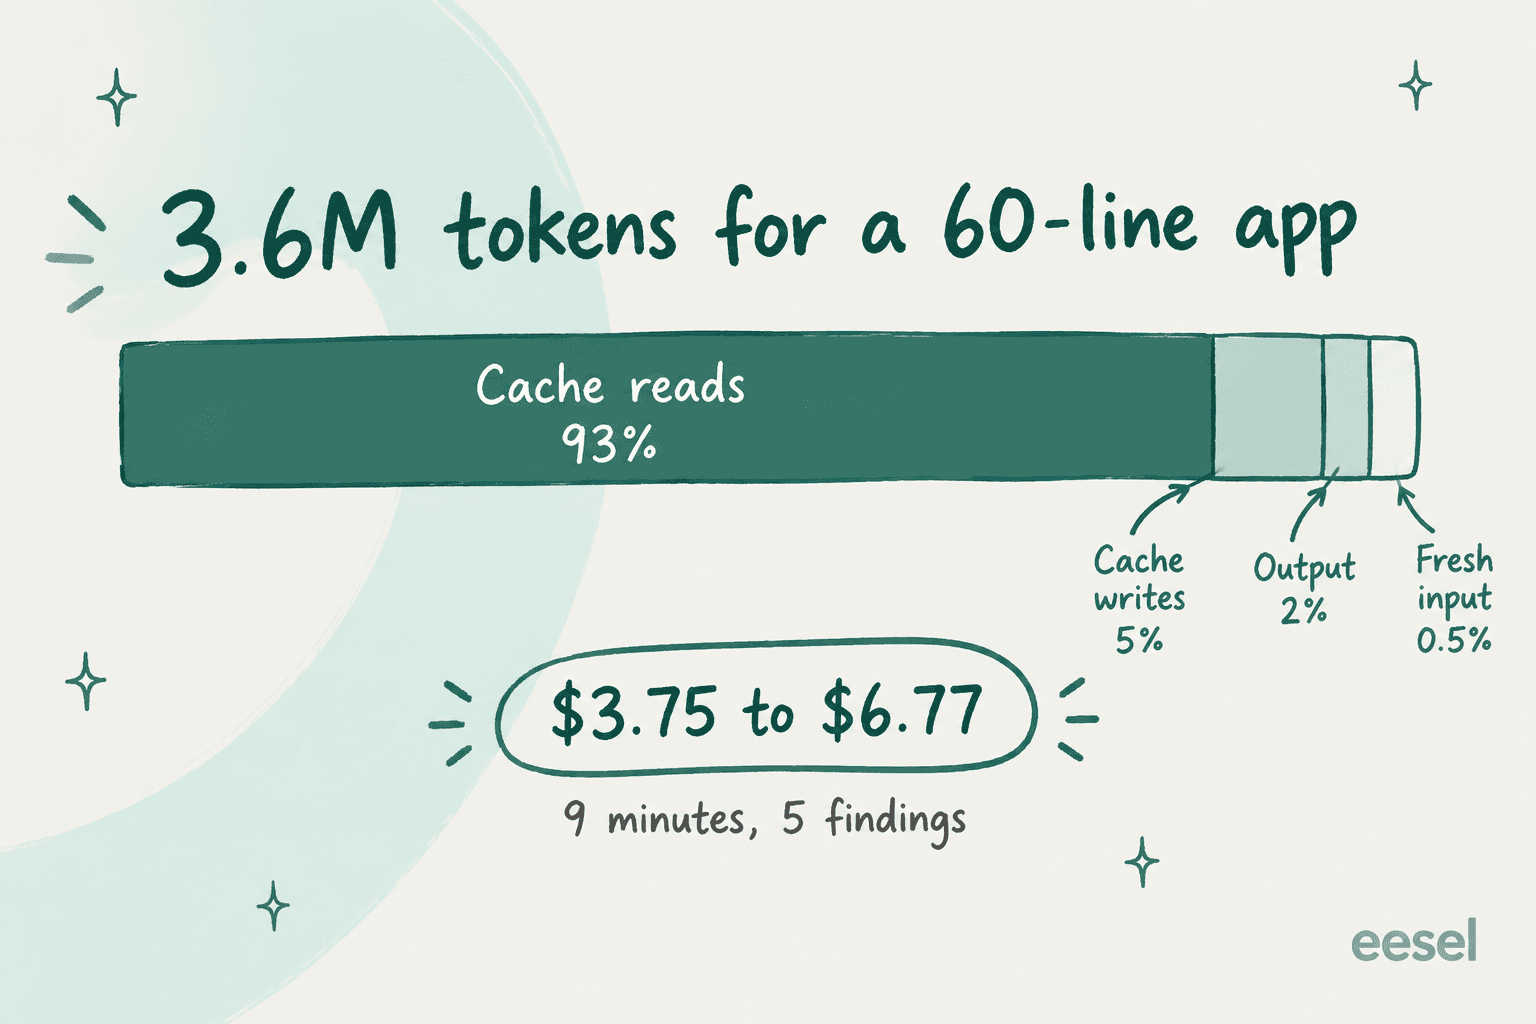
El 93 % de los tokens fueron lecturas de caché. El agente vuelve a leer una y otra vez sus propias instrucciones, el modelo de amenazas y el código mientras avanza por el modelado de amenazas, el descubrimiento, la validación, el análisis de rutas de ataque y el informe. Gran parte es un coste fijo, así que un repositorio más grande no debería costar proporcionalmente más por línea. Pero significa que incluso un escaneo trivial cuesta unos dólares, y la monitorización de commits repite parte de ese trabajo en cada push.
En la propia tabla de precios de la CLI para gpt-5.6-sol, las lecturas de caché cuestan 0,40 dólares por millón de tokens y la salida 20 dólares por millón. La salida fue solo el 2 % de los tokens, pero 1,46 dólares de la estimación baja.
En Cloud no verás dólares. Los escaneos consumen el uso de Codex incluido en tu plan y luego créditos. La página de precios de OpenAI dice "Daybreak Blue uses GPT-5.6 Sol credit rates," que son 100 créditos por millón de tokens de entrada, 10 por millón de entrada en caché y 500 por millón de salida. Es el doble de la tarifa de GPT-6 Sol.
Estos son los planes que pueden acceder a Cloud, según el resumen del DevDay y la misma página de precios:
| Plan | Precio | Acceso a Cloud | Vía de excedente |
|---|---|---|---|
| Plus | 20 $/mes | No incluido | No aplica |
| Pro | 100, 200 o 500 $/mes | Sí, según el DevDay | Créditos de ChatGPT |
| Business | 20 $/usuario/mes anual, 25 $ mensual | Sí, según el DevDay | Créditos del espacio de trabajo |
| Enterprise y Edu | Contactar con ventas | Sí | Créditos del espacio de trabajo o pago por uso |
| Solo clave de API | Tarifas de API | Sin funciones en la nube | Facturado por token |
El panorama de planes tiene una arruga. La matriz de funciones de la misma página de precios todavía marca "Codex Security for connected GitHub repositories" como solo Enterprise y Edu. Confiaría en el post más reciente del DevDay, pero también comprobaría que el plugin aparece en tu propio espacio de trabajo antes de mejorar de plan por esto. Mi guía de precios de Codex explica más sobre cómo se consumen los créditos.
Para poner mi escaneo en perspectiva, unos pocos dólares por escaneo de repositorio es barato comparado con una hora de un ingeniero de seguridad. Es caro al lado de un escáner basado en reglas que corre gratis en cada pull request. Por eso el modelo correcto es usar ambos, no uno u otro.
La trampa de Daybreak Blue que la mayoría pasará por alto
Daybreak Blue es la mejor razón para elegir Cloud, y viene con una condición que no está en el anuncio de lanzamiento. Solo se aplica cuando inicias sesión con ChatGPT.
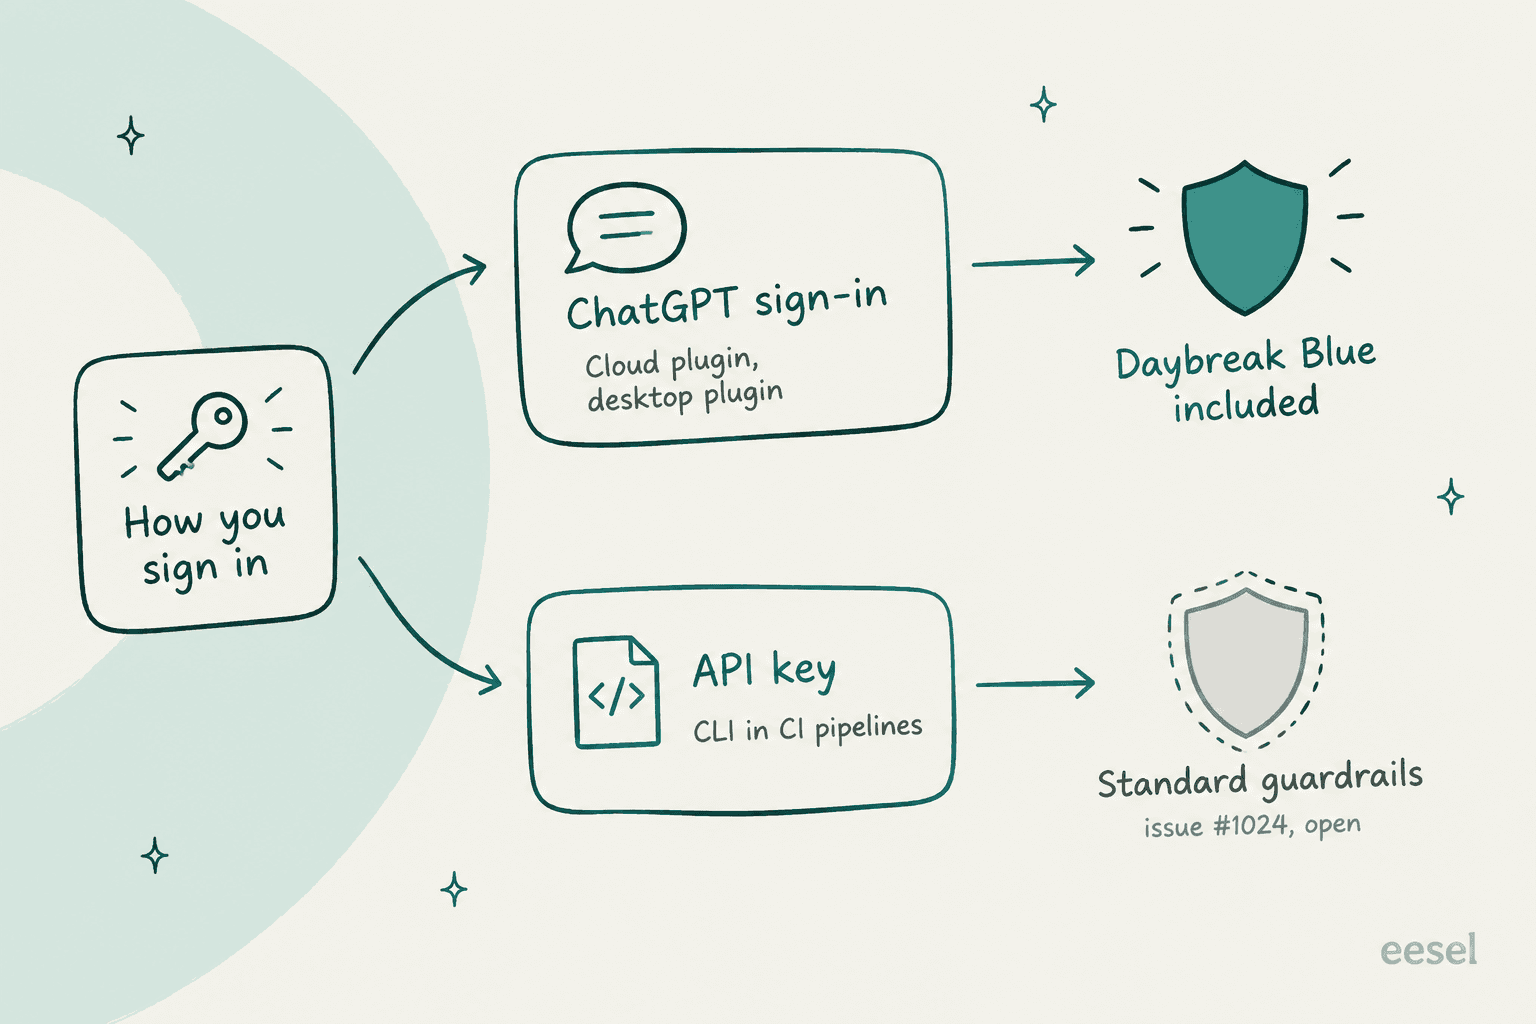
Un issue abierto, #1024, presentado por un equipo que ya está aprobado para Daybreak Blue, informa de que la versión fijada de Codex en la CLI "filters out the cyber access program unless authentication is through ChatGPT." Así que la selección de Blue se descarta cuando usas una clave de API, que es justo como corren la mayoría de los pipelines de CI. El registro de cambios del plugin lo respalda desde otro ángulo: "Sessions that use only an API key can't verify account access."
¿Por qué importa? Porque el problema de los rechazos es real. Cuando OpenAI liberó la CLI en julio, el hilo de Hacker News se llenó de gente que se topó con ello:
"Thing is, you WILL encounter refusals with Sol doing anything remotely adjacent to security work. Which for Codex Security is kinda... problematic."

Otro usuario vio un escaneo de una pequeña biblioteca de código abierto correr más de 40 minutos y terminar con "This content was flagged for possible cybersecurity risk":
"it ran for over 40 minutes and during that time I had no idea what was happening, thought it was frozen or in a bad state. Also, it ate through 25% of my weekly credits :("
Para ser justo, no tuve un solo rechazo en mi app de prueba, ni siquiera con las salvaguardas estándar. Puede ser porque mis errores son de manual y mi app es diminuta. El hilo del issue de ese error, #56, sigue abierto. Mi lectura práctica es usar Cloud o un plugin con sesión de ChatGPT para cualquier cosa seria, y tratar los escaneos de CI con clave de API como una barrera más ligera hasta que se corrija #1024.
Qué dicen otros usuarios
Los informes prácticos sobre Cloud específicamente todavía son escasos, ya que solo tiene dos días. El hilo de lanzamiento en Hacker News no tenía comentarios cuando lo revisé. Las voces hasta ahora vienen sobre todo de la CLI y de la vista previa anterior del plugin, que ejecutan el mismo escáner.
La opinión positiva viene de Simon Willison, que lo probó en abril:
"I've been previewing this in Codex for a few weeks - it's very good! Had some great results from it having it run security reviews against code written using other models"
Las opiniones escépticas se dividen en dos grupos. Algunos piensan que es sobre todo una estructura alrededor de los modelos de OpenAI. El análisis de un ingeniero en X resumió la CLI como "just JS calling Codex in a loop." Yo discreparía un poco. Tras leer mi informe de 55 KB, la estructura claramente añade orden que un prompt simple no tendría. Pero es cierto que la calidad viene del modelo.
El otro grupo se preocupa por la cobertura. Un comentarista de Hacker News, retransmitiendo publicaciones del mantenedor de curl Daniel Stenberg, dijo que tanto Codex Security como Claude Mythos no reportaron ningún problema en curl antes de que el escaneo de otra herramienta llevara a seis CVE. Es de segunda mano, pero sigue siendo una advertencia justa. La mejor cifra que publica OpenAI es de la época de Aardvark, cuando encontró el 92 % de las vulnerabilidades conocidas en sus propios repositorios de prueba "golden", y todavía no hay una comparativa pública frente a herramientas basadas en reglas. Mi cinco de cinco fue sobre errores que sabía que estaban ahí. Un código maduro esconderá los más difíciles.
Cómo se compara con las alternativas
Las preguntas frecuentes de Cloud de OpenAI responden a la pregunta del reemplazo en una línea: "Codex Security complements SAST." Así se comparan las herramientas más cercanas según lo que publica cada proveedor:
| Herramienta | Precio publicado | ¿Verifica sus hallazgos? | ¿Propone correcciones? | Ideal para |
|---|---|---|---|---|
| Codex Security Cloud | Uso de Codex incluido, luego créditos | Sí, reproduce en un entorno aislado | Sí, tú abres el PR en borrador | Errores que exigen razonar, en equipos con plan de ChatGPT |
| Claude Code Security | Sin precio público, vista previa limitada | Reexamina cada hallazgo | Sí, con aprobación humana | Equipos estandarizados en Claude Code |
| GitHub Code Security | 30 $ por committer activo/mes | Análisis CodeQL basado en reglas | Sí, Copilot Autofix | Una base determinista en cada PR |
| Snyk | Nivel gratuito, Team desde 25 $/mes | Reescanea candidatos de corrección | Sí, Snyk Agent Fix | Riesgo de dependencias y de código abierto |
| Semgrep | Gratis hasta 10 colaboradores, Teams desde 30 $/colaborador/mes | No indicado | Guía de remediación | Reglas personalizadas que escribes tú |
La configuración que yo usaría es un escáner basado en reglas en cada pull request como base, mediante los planes de pago de GitHub, Snyk o Semgrep. Luego añadir Codex Security Cloud con una programación para los errores que una regla no puede expresar, como una comprobación de autenticación ausente que solo tiene sentido cuando entiendes toda la app.
Si tu equipo trabaja con Claude Code, su integración con GitHub te da el equivalente más cercano del lado del PR. Para el panorama más amplio, mira mi lista de alternativas a OpenAI Codex. Los equipos de seguridad que evalúen los modelos cibernéticos especializados deberían empezar por el resumen de alternativas a GPT-5.6-Cyber.
Pros y contras
| Pros | Contras |
|---|---|
| Encontró los 5 errores plantados sin falsos positivos | Una app de 60 líneas costó de 3,75 a 6,77 $ y tardó 9 minutos |
| Decisiones de gravedad con razonamiento real, no por reflejo | Mi primera ejecución falló en la configuración y aun así facturó cerca de 1 $ |
| Modelo de amenazas, evidencia y pruebas para cada hallazgo | El acceso por plan es contradictorio entre las propias páginas de OpenAI |
| Exportación SARIF para code scanning de GitHub | Daybreak Blue aún no se aplica a escaneos de CI con clave de API |
| Nunca aplica un parche sin una persona | Sin benchmark público frente a herramientas SAST, solo cifras de OpenAI |
Otra cosa a vigilar es que el repositorio avanza rápido. Un commit fusionado hace dos días, visible en el repositorio de GitHub, cambia el modelo por defecto de la CLI a GPT-6 Sol con xhigh. La versión de npm que instalé todavía usaba gpt-5.6-sol por defecto. Si eso llega, los escaneos deberían abaratarse, ya que la tarifa de créditos de GPT-6 Sol es la mitad de la de GPT-5.6 Sol.
¿Quién debería usar Codex Security Cloud?
Úsalo si estás en ChatGPT Pro, Business, Enterprise o Edu, tu código está en GitHub y no tienes un ingeniero de seguridad que revise cada cambio. Es una segunda opinión sólida sobre los errores de lógica que las herramientas basadas en reglas pasan por alto, y los informes son lo bastante buenos como para entregarlos tal cual a un desarrollador. Empieza con un escaneo de un repositorio en tu servicio más sensible, revisa tu panel de uso antes y después, y solo entonces activa la monitorización de commits.
Sáltalo si tu política dice que el código fuente no puede salir de tu entorno. No es un escáner sin conexión, y como explicó un miembro del equipo de OpenAI en Hacker News, el código y el contexto van al modelo alojado de OpenAI. Sáltalo también si estás en Plus, o si necesitas una barrera barata y determinista en cada pull request. Eso es trabajo para CodeQL o Semgrep.
Espera si planeabas ejecutarlo sin interfaz desde CI con una clave de API. Hasta que se arregle el problema de Daybreak Blue y se calmen los fallos de guardado, la CLI en CI es la forma más débil de usarlo.
Comparado con otros lanzamientos recientes de OpenAI, como el siempre activo OpenAI Dots y GPT-6.1 Sol, este es el que parece más cercano a estar listo para producción. Sigue etiquetado como vista previa de investigación, así que ajusta tus expectativas a la versión que tengas delante.
Prueba eesel para la cola que nunca se detiene
Codex Security hace un solo trabajo, encontrar y explicar errores de seguridad, y gana confianza mostrando su evidencia antes de que una persona actúe. Esa es la misma forma que los compañeros que construyo en eesel. eesel es una plataforma de compañeros de IA con dos perfiles listos para trabajar hoy: un compañero de IA para helpdesk que se une a Zendesk, Freshdesk, Gorgias o Front, y un redactor de blog con IA para contenido y SEO.
En soporte, la lección de mi escaneo se aplica directamente. Confianza no es lo mismo que tener razón. Un equipo B2B de telemática de vehículos en Zendesk vio a un bot responder "sí, soportamos el modelo de tu coche" para marcas que no estaban en su base de datos, solo porque la base de conocimiento decía "soportamos todos los modelos". Por eso eesel ejecuta primero el compañero de helpdesk contra cientos de tus tickets pasados en una simulación, para que veas cada respuesta que habría enviado antes de que toque a un cliente real. Las acciones fuera de sus reglas esperan aprobación humana, como un PR en borrador esperando tu revisión.

Si te atrajo el lado de CLI de Codex Security, eesel también tiene una. La CLI de eesel opera el mismo compañero y espacio de trabajo que ves en el panel, desde una terminal o un script. eesel approvals list muestra lo que espera a una persona, y eesel activity lista cada ejecución para que puedas auditar lo que hizo el compañero. Agentes de programación como Codex y Claude Code también pueden manejarla, porque cada espacio de trabajo funciona además como un servidor MCP. Mi guía de CLI para agentes de IA explica por qué importa.
Los precios son públicos: un plan gratuito con 100 créditos, luego planes desde 299 $/mes por 500 créditos, donde un ticket o chat es un crédito, según la página de precios. Prueba eesel y ejecuta el compañero de helpdesk con tus propios tickets pasados esa misma tarde. Mi explicación sobre los compañeros de IA cubre el modelo con más profundidad.
Preguntas frecuentes
¿Vale la pena Codex Security Cloud?
¿Qué tan preciso es Codex Security Cloud?
¿Cuánto cuesta un escaneo de Codex Security Cloud?
¿Qué planes de ChatGPT incluyen Codex Security Cloud?
¿Puedo usar Codex Security Cloud con una clave de API?
¿Codex Security Cloud corrige los errores que encuentra?
¿Cuáles son las mejores alternativas a Codex Security Cloud?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.