Was ist Codex Security Cloud?
Codex Security ist OpenAIs Application-Security-Agent in OpenAI Codex. Er liest Ihren Code und baut ein Bedrohungsmodell, sucht nach Schwachstellen, prüft jede einzelne und schlägt auch einen Fix vor. Die Cloud-Version startete auf der DevDay am 29. September 2026 als Plugin, das in Codex Cloud gegen verbundene GitHub-Repos läuft. Laut OpenAIs DevDay-Rückblick kann es ganze Repos "on demand or on a schedule, with ongoing checks of new commits" scannen, auch bei geschlossenem Laptop, was praktisch ist.
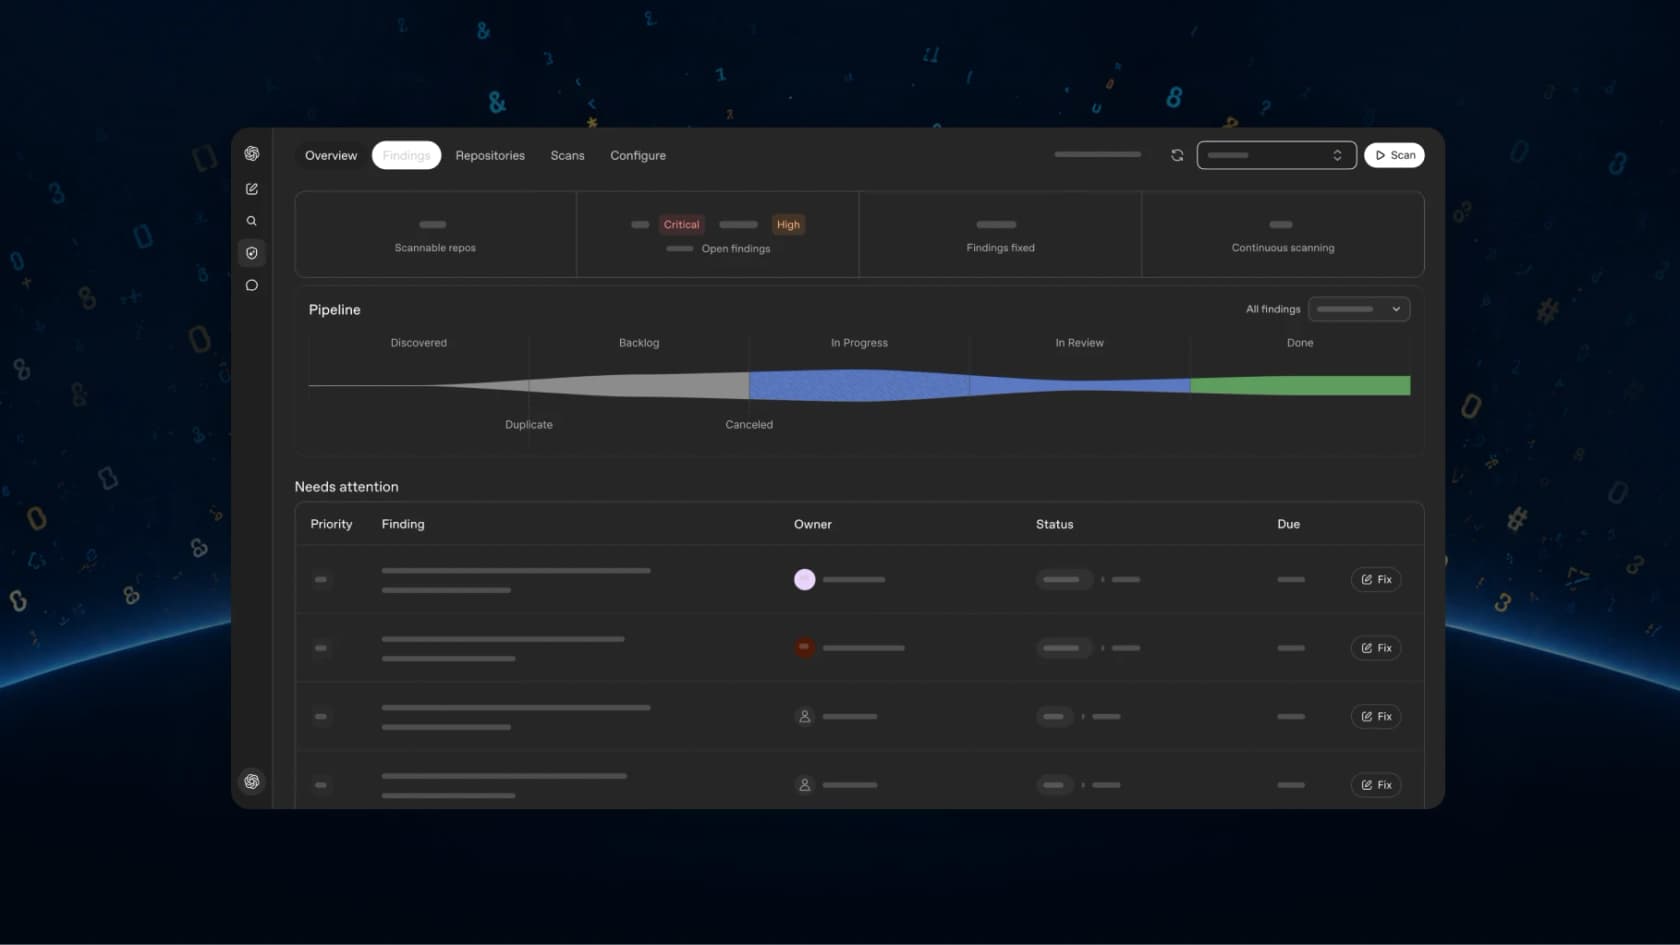
Das wichtigste Upgrade ist der Zugang zu Daybreak Blue, OpenAIs Modell mit weniger Ablehnungen für defensive Sicherheitsarbeit, "without a separate Daybreak application." Das zählt, denn die häufigste Beschwerde vor Cloud waren nicht schlechte Funde. Es waren Scans, die eine halbe Stunde liefen und dann abgelehnt wurden. Mein Beitrag zu GPT-5.6-Cyber erklärt, wie die Blue- und Red-Stufen funktionieren.
Wenn Sie die komplette Funktionstour wollen, führt mein Codex-Security-Cloud-Erklärstück durch Setup, die vier Oberflächen und die Geschichte bis zurück zu Aardvark. Dieser Beitrag ist das Fazit.
Wie ich getestet habe
Ich habe keinen Team-Workspace mit aktiviertem Cloud-Plugin, also nahm ich das Nächstbeste. Das ist die Open-Source-Codex-Security-CLI, die dasselbe Codex-Security-Plugin enthält und dieselbe Pipeline aus Ihrem Terminal ausführt. Ich nutzte Version 0.1.31 mit den Standardeinstellungen, also Modell gpt-5.6-sol mit xhigh Reasoning Effort im Standard-Scanmodus, authentifiziert mit einem OpenAI-API-Key.
Das Testziel war eine winzige interne Ticket-API, die ich für den Test geschrieben habe. Es ist eine einzige Flask-Datei mit etwa 60 Zeilen plus einer einzeiligen README, die sagt, dass sie in einem Firmennetz läuft. Ich habe fünf klassische Bugs eingebaut:
- SQL-Injection in einer Ticket-Suche, die die Kunden-E-Mail in die Abfrage konkateniert.
- Path Traversal in einem Anhang-Download, der einen vom Nutzer gelieferten Dateinamen an einen Ordner anhängt.
- Command Injection in einer Admin-Export-Route, die einen
format-Wert an die Shell übergibt. - Fehlende Autorisierung bei einer Delete-Route, mit dem Kommentar
# TODO: only admins should do this. - Debug-Modus auf allen Interfaces mit
app.run(host="0.0.0.0", debug=True).
Das sind einfache Bugs, und genau das ist der Sinn des Tests. Wenn ein Sicherheitsagent Lehrbuch-Bugs in 60 Zeilen übersieht, ist alles andere egal. Findet er sie, lautet die interessante Frage, wie gut er sie erklärt und was es kostet, dorthin zu kommen.
Zwei Einschränkungen zu meinem Test vorab. Erstens bekommt ein API-Key kein Daybreak Blue, ich lief also mit den Standard-Schutzmechanismen, was bei Ablehnungen die härtere Einstellung gegenüber Cloud ist. Zweitens validierte der Standard-Scan der CLI Funde durch Nachverfolgen der Quelle, und der Bericht sagt "no runtime query was executed." Die Docs von Cloud beschreiben das Reproduzieren von Funden in einem Sandbox-Container, was ich hier nicht ausprobieren konnte.
Was Codex Security gefunden hat
Der zweite Lauf endete nach 8m 56s mit vollständiger Abdeckung. Das ist die ausgegebene Zusammenfassung:
FINDINGS  5 (5 confirmed this scan; 0 previously found; 2 high, 2 medium, 1 low)
COVERAGE  complete
ELAPSED   8m 56s
TOKENS    18,684 uncached input, 3,357,854 cache reads, 173,804 cache writes, 73,204 output, 3,623,546 total
COST      $3.7509776–$6.7699152 (standard, context unknown)
Und so passen die Funde zu dem, was ich eingebaut habe:
| Was ich eingebaut habe | Gefunden? | Vergebene Schwere | Begründung |
|---|---|---|---|
Command Injection in /admin/export | Ja | Hoch | Eine einzige unauthentifizierte Anfrage ermöglicht Befehlsausführung, unter kritisch gehalten, weil die App intern ist |
| Fehlende Auth beim Löschen | Ja, auf jede Route ausgeweitet | Hoch | Keine Route prüft die Identität, daher kann jeder Netzwerk-Client Tickets lesen, ändern und löschen |
| Path Traversal bei Anhängen | Ja | Mittel | Der Pfad-Ausbruch ist direkt, aber die Wirkung hängt davon ab, welche Dateien das Service-Konto lesen kann |
| SQL-Injection in der Suche | Ja | Mittel | Pythons SQLite führt nur ein Statement auf einmal aus, gestapelte Schreibzugriffe sind also nicht möglich, nur Datenlesen |
debug=True auf 0.0.0.0 | Ja | Niedrig | Legt Debug-Fehlerseiten offen, und die Konsole braucht weiterhin eine PIN zum Entsperren |
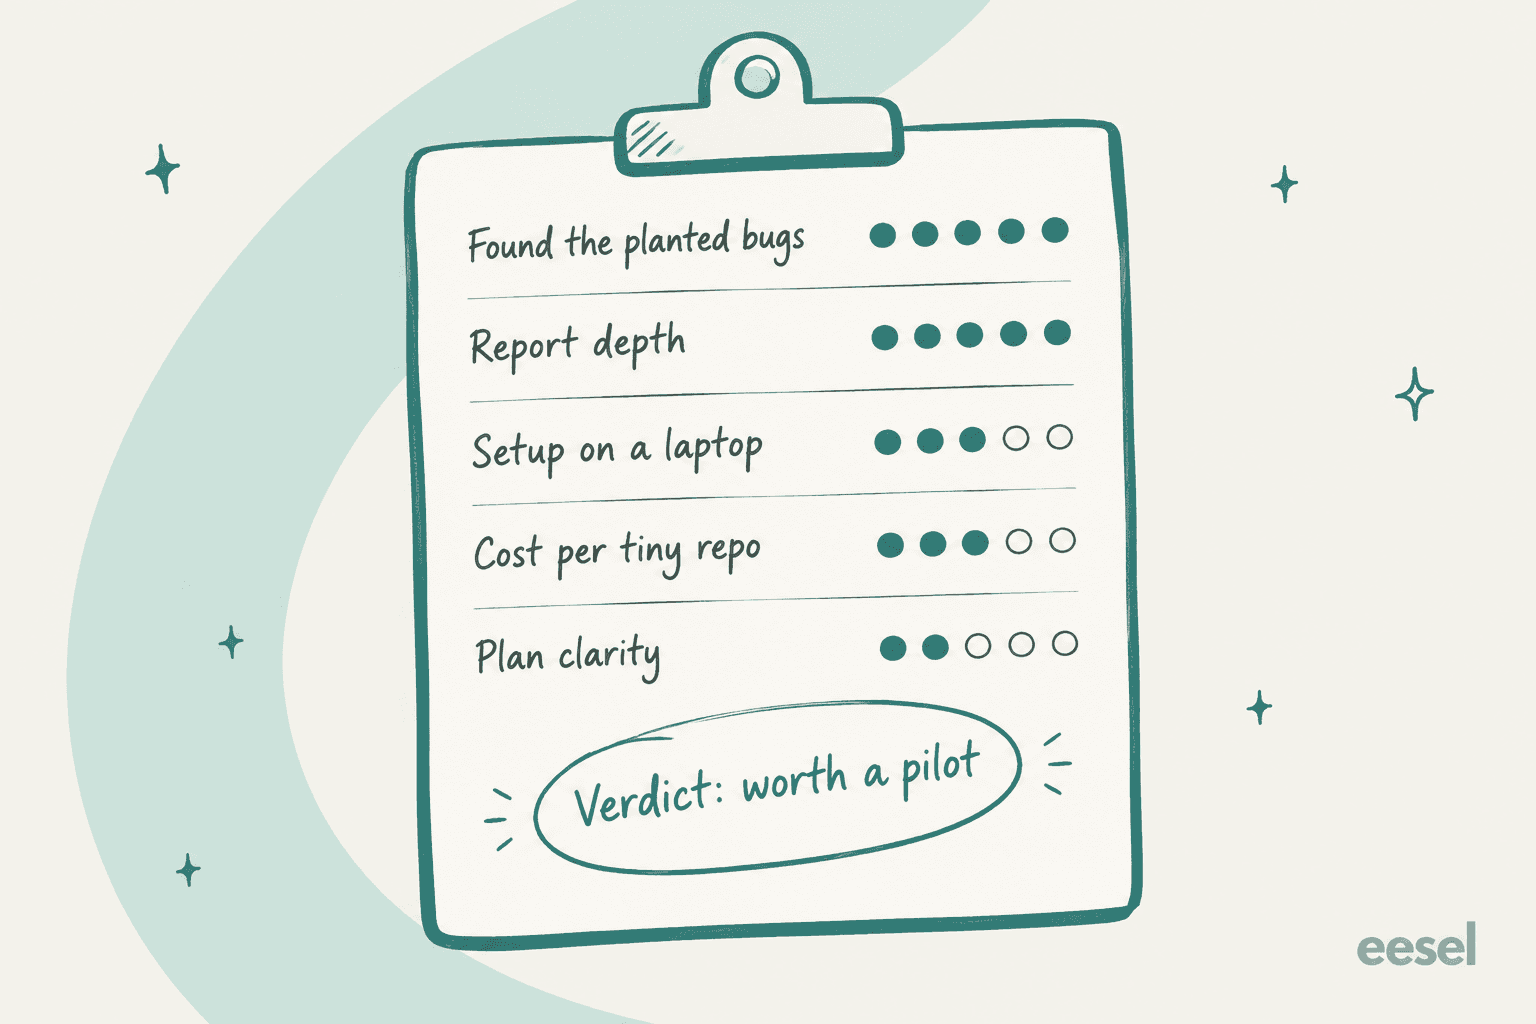
Fünf von fünf, alle mit hoher Konfidenz, und nichts erfunden. Bei einer Spielzeug-App ist das das Minimum, keine Trophäe. Mehr beeindruckt hat mich die Begründung der Schwere. Die meisten Scanner würden die SQL-Injection reflexartig als kritisch einstufen, das ist die übliche Gewohnheit. Dieser hier bemerkte, dass Pythons sqlite3 keine gestapelten Statements ausführt, der Schaden also beim Datenlesen endet, und stufte sie als mittel ein, mit einem Hinweis, was sie erhöhen würde. Solch eine Einschätzung würde auch ein guter menschlicher Reviewer treffen.
Er blieb auch nicht bei meinem TODO-Kommentar stehen. Er stellte fest, dass die Route für Status-Updates dieselbe fehlende Prüfung hatte, und fasste beides zu einem breiteren Fund zusammen: Die App hat überhaupt keine Authentifizierung. Das ist die nützlichere Darstellung, denn den Fix für eine Route umzusetzen, ließe die übrigen offen.
Wie der Bericht aussieht
Der Ausgabeordner enthielt eine report.md, eine findings.json, eine coverage.json und einen SARIF-Export, den Sie in die Code-Scanning-Ansicht von GitHub hochladen können. Der Bericht umfasst 55 KB für eine 60-Zeilen-App, hier wird also nicht an Details gespart.
Vor allen Funden schreibt er ein Bedrohungsmodell Ihrer App. Es listet die Assets (die Ticket-Datenbank, den Anhangordner, den Shell-Zugriff des Prozesses), die Vertrauensgrenzen und auch, was ein realistischer Angreifer tun kann. Er markierte sogar, was er nicht sehen konnte. Meine Export-Route ruft eine export.py auf, die im Repo nicht existiert, und der Bericht sagt das, statt zu raten.
Jeder Fund bekommt dann eine Begründung der Schwere, die Belege Zeile für Zeile nachverfolgt, die "Gegenbelege", die das Risiko senken würden, und einen Abschnitt zur Behebung mit zu schreibenden Tests. Für die Command Injection lautet der Fix:
"Require administrator authorization, remove
shell=True, invoke a fixed interpreter and script with an argument vector, and allowlist the supported export formats."
Das ist korrekt und auch konkret. Er schlug zudem zwei Tests vor: einen, der prüft, dass Shell-Metazeichen in format nie einen zweiten Prozess starten, und einen, der prüft, dass Nicht-Admins die Route nicht erreichen. Ich habe --patch nicht übergeben, also schrieb er keinen Code. In Cloud ist das Pendant der Button Fix with Codex, der einen Patch entwirft, den Sie prüfen, bevor Sie Create draft pull request wählen, laut Cloud-Setup-Anleitung.
Wenn Sie /security-review von Claude Code kennen: Das hier ist deutlich strukturierter. Der Bericht liest sich wie ein Audit-Dokument, nicht wie ein Code-Kommentar.
Wo es gehakt hat
Mein erster Lauf scheiterte. Der Scan verbrachte zweieinhalb Minuten in der Preflight-Phase und brach dann mit "Scan agent did not create required draft artifacts" und einem leeren Ausgabeordner ab. Die Logs zeigten, dass der Agent die benötigten Laufzeiteinstellungen nicht sehen konnte, darunter den Python-Pfad. Er hatte bereits 527.000 Input-Tokens verbraucht, etwa 0,74 bis 1,40 $, um nichts zu produzieren. Der zweite Lauf funktionierte, nachdem ich den Python-Pfad explizit übergab und meine Shell-Umgebung erben ließ.
Ich bin nicht der Einzige, der darauf stieß. Ein offenes Issue im Repo, #73, beschreibt dasselbe Muster unter Windows und Linux: Der Scan läuft, Tokens werden berechnet, dann scheitert das Speichern, und "the 'partial output' directory is completely empty." Das --max-cost-Flag der CLI rettet Sie hier nicht, und OpenAIs CLI-FAQ sagt, das Limit sei "an estimate, not a hard spending cap." Ich setzte es auf $4, und das obere Ende meiner finalen Schätzung lag bei 6,77 $.
Das ist das stärkste Argument für Cloud gegenüber der CLI. In Cloud gehören Container, Umgebung und Python-Setup OpenAI, diese ganze Klasse lokaler Setup-Fehler sollte Sie also nicht erreichen.
Sind die Kosten vertretbar?
Die Kosten haben meine Note gesenkt. Mein Scan verbrauchte 3,6 Millionen Tokens für 60 Zeilen Code. Die Aufschlüsselung erklärt, warum:
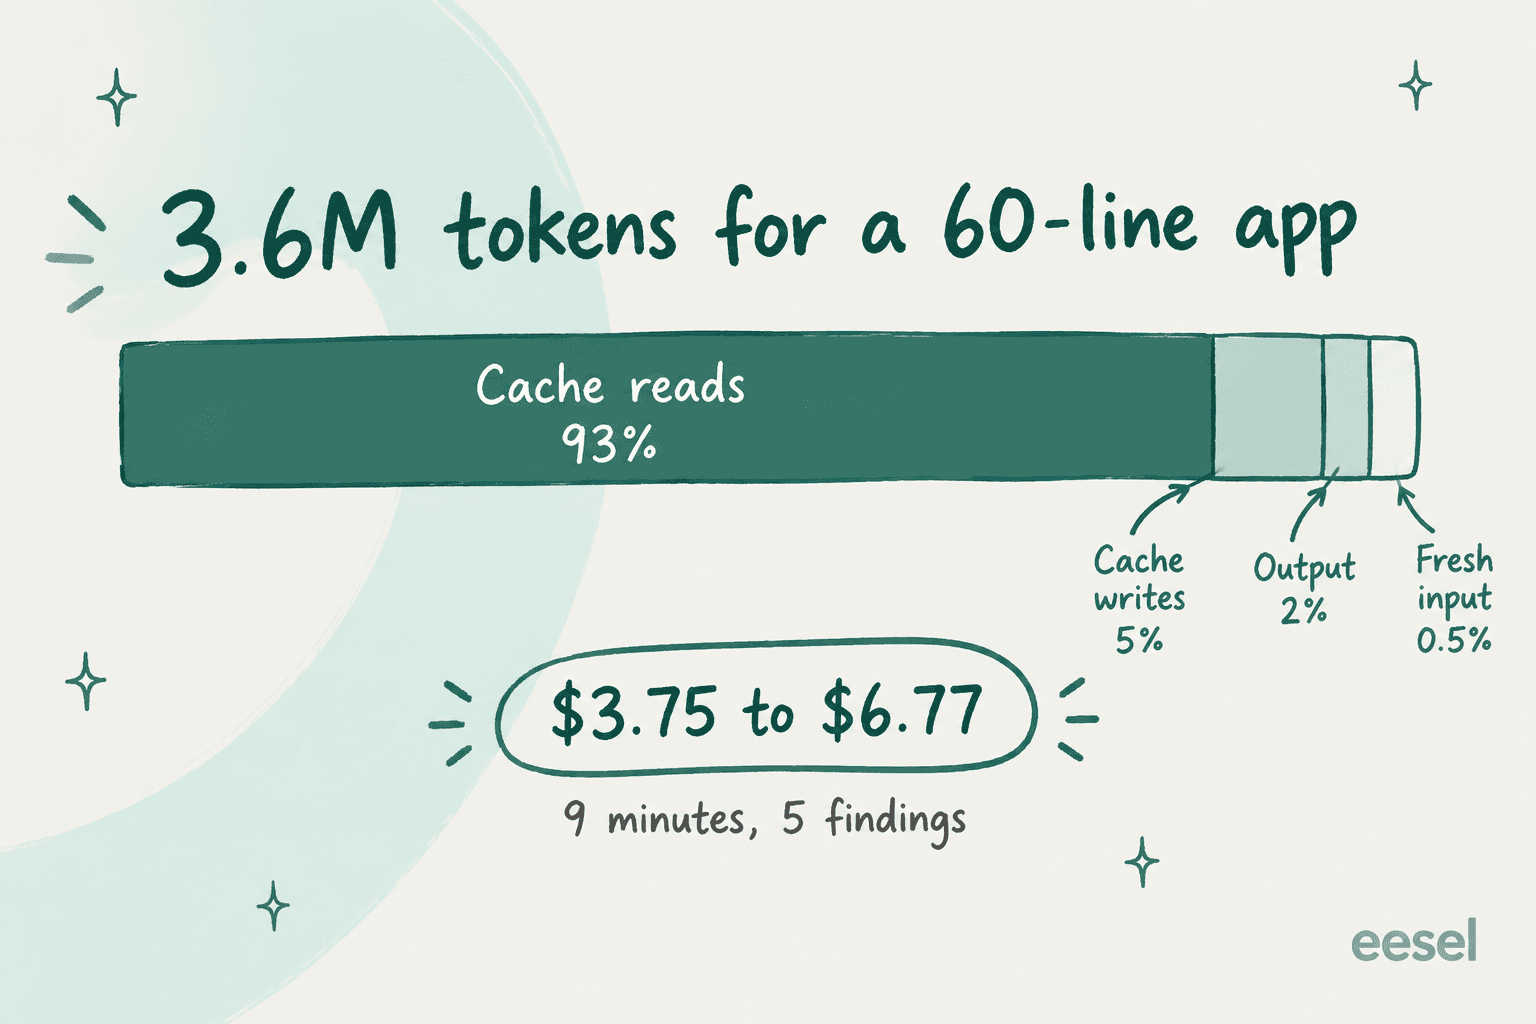
93 % der Tokens waren Cache-Lesezugriffe. Der Agent liest seine eigenen Anweisungen, das Bedrohungsmodell und den Code immer wieder, während er Threat Modeling, Discovery, Validierung, Angriffspfad-Analyse und Reporting durchläuft. Das meiste davon ist fester Overhead, ein größeres Repo sollte also nicht proportional mehr pro Zeile kosten. Aber es heißt, dass schon ein trivialer Scan ein paar Dollar kostet und das Commit-Monitoring einen Teil dieser Arbeit bei jedem Push wiederholt.
In der eigenen Preistabelle der CLI für gpt-5.6-sol kosten Cache-Lesezugriffe 0,40 $ pro Million Tokens und Output 20 $ pro Million. Output machte nur 2 % der Tokens aus, aber 1,46 $ der unteren Schätzung.
In Cloud sehen Sie keine Dollar. Scans ziehen vom im Tarif enthaltenen Codex-Kontingent und danach von Credits. OpenAIs Preisseite sagt "Daybreak Blue uses GPT-5.6 Sol credit rates," also 100 Credits pro Million Input-Tokens, 10 pro Million gecachtem Input und 500 pro Million Output. Das ist das Doppelte des Satzes von GPT-6 Sol.
Diese Tarife bekommen Cloud, laut DevDay-Rückblick und derselben Preisseite:
| Tarif | Preis | Cloud-Zugang | Weg bei Überschreitung |
|---|---|---|---|
| Plus | 20 $/Monat | Nicht enthalten | Nicht zutreffend |
| Pro | 100, 200 oder 500 $/Monat | Ja, laut DevDay | ChatGPT-Credits |
| Business | 20 $/Nutzer/Monat jährlich, 25 $ monatlich | Ja, laut DevDay | Workspace-Credits |
| Enterprise und Edu | Vertrieb kontaktieren | Ja | Workspace-Credits oder Pay-as-you-go |
| Nur API-Key | API-Preise | Keine Cloud-Funktionen | Abrechnung pro Token |
Beim Tarifbild gibt es einen Haken. Die Funktionsmatrix auf derselben Preisseite markiert "Codex Security for connected GitHub repositories" weiterhin nur für Enterprise und Edu. Ich würde dem neueren DevDay-Beitrag trauen, aber ich würde auch prüfen, ob das Plugin in Ihrem eigenen Workspace erscheint, bevor Sie dafür upgraden. Mein Codex-Preisratgeber erklärt mehr dazu, wie Credits verbraucht werden.
Zur Einordnung: Ein paar Dollar pro Repo-Scan sind günstig im Vergleich zu einer Stunde eines Security-Engineers. Teuer sind sie neben einem regelbasierten Scanner, der kostenlos bei jedem Pull Request läuft. Deshalb ist das richtige Modell beides, nicht entweder oder.
Der Daybreak-Blue-Haken, den die meisten übersehen
Daybreak Blue ist der beste Grund für Cloud, und es kommt mit einer Bedingung, die im Launch-Beitrag nicht steht. Es gilt nur, wenn Sie sich mit ChatGPT anmelden.
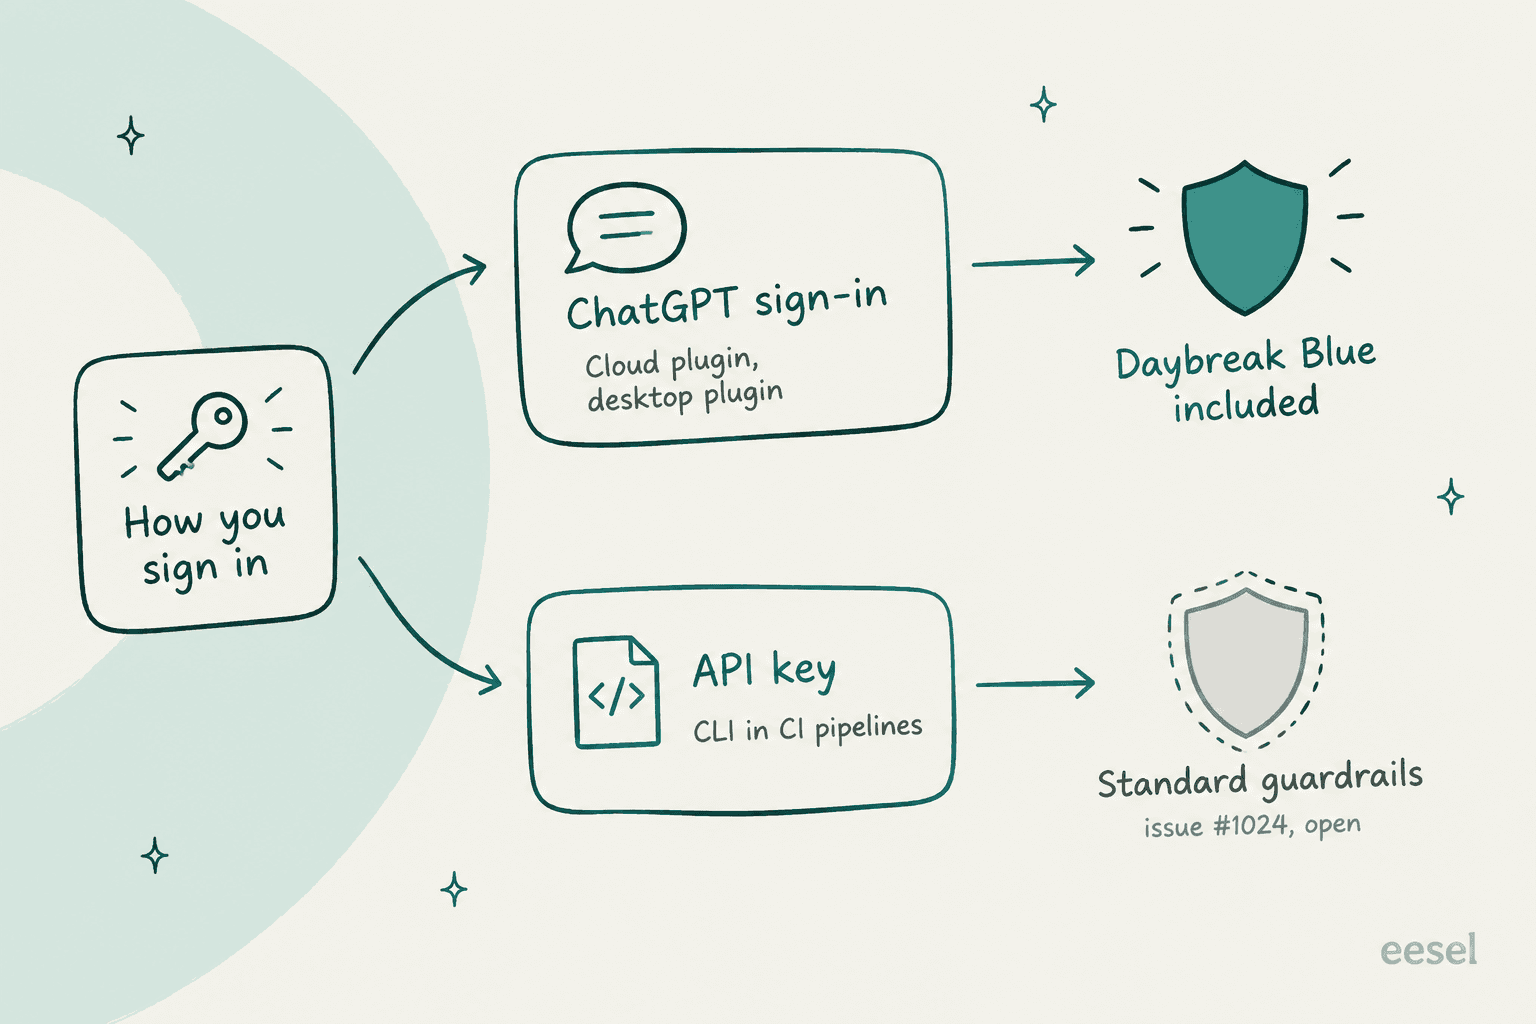
Ein offenes Issue, #1024, eingereicht von einem Team, das bereits für Daybreak Blue freigegeben ist, meldet, dass die angepinnte Codex-Version der CLI "filters out the cyber access program unless authentication is through ChatGPT." Die Blue-Auswahl fällt also weg, wenn Sie einen API-Key nutzen, und genau so laufen die meisten CI-Pipelines. Das Plugin-Changelog bestätigt das aus anderer Perspektive: "Sessions that use only an API key can't verify account access."
Warum ist das wichtig? Weil das Ablehnungsproblem real ist. Als OpenAI die CLI im Juli als Open Source veröffentlichte, füllte sich der Hacker-News-Thread mit Leuten, die darauf stießen:
"Thing is, you WILL encounter refusals with Sol doing anything remotely adjacent to security work. Which for Codex Security is kinda... problematic."

Ein anderer Nutzer sah, wie ein Scan einer kleinen Open-Source-Bibliothek über 40 Minuten lief und dann mit "This content was flagged for possible cybersecurity risk" endete:
"it ran for over 40 minutes and during that time I had no idea what was happening, thought it was frozen or in a bad state. Also, it ate through 25% of my weekly credits :("
Fairerweise: Ich bekam bei meiner Test-App keine einzige Ablehnung, auch nicht mit Standard-Schutzmechanismen. Das kann daran liegen, dass meine Bugs Lehrbuchfälle sind und die App winzig ist. Der Issue-Thread zu diesem Fehler, #56, ist weiterhin offen. Mein praktisches Fazit: Nutzen Sie Cloud oder ein mit ChatGPT angemeldetes Plugin für alles Ernsthafte, und behandeln Sie API-Key-CI-Scans als leichteres Gate, bis #1024 behoben ist.
Was andere Nutzer sagen
Praxisberichte speziell zu Cloud sind noch dünn, denn es ist erst zwei Tage alt. Der Hacker-News-Launch-Thread hatte bei meiner Prüfung keine Kommentare. Die Stimmen bisher stammen meist von der CLI und der früheren Plugin-Vorschau, die denselben Scanner nutzen.
Die positive Einschätzung kommt von Simon Willison, der es schon im April in der Vorschau hatte:
"I've been previewing this in Codex for a few weeks - it's very good! Had some great results from it having it run security reviews against code written using other models"
Die skeptischen Stimmen fallen in zwei Gruppen. Manche halten es für überwiegend ein Harness um OpenAIs Modelle. Das Teardown eines Entwicklers auf X fasste die CLI als "just JS calling Codex in a loop" zusammen. Dem würde ich ein wenig widersprechen. Nach dem Lesen meines 55-KB-Berichts ist klar, dass das Harness Struktur hinzufügt, die ein roher Prompt nicht hätte. Aber richtig ist, dass die Qualität vom Modell kommt.
Die andere Gruppe sorgt sich um die Abdeckung. Ein Hacker-News-Kommentator, der Beiträge von curl-Maintainer Daniel Stenberg wiedergab, sagte, sowohl Codex Security als auch Claude Mythos hätten bei curl null Funde gemeldet, bevor der Scan eines anderen Tools zu sechs CVEs führte. Es ist aus zweiter Hand, aber eine faire Warnung. Die beste von OpenAI veröffentlichte Zahl stammt aus den Aardvark-Tagen, als es 92 % der bekannten Schwachstellen in den eigenen "golden" Test-Repos fand, und es gibt noch keinen öffentlichen Vergleich mit regelbasierten Tools. Mein Fünf-von-fünf-Ergebnis bezog sich auf Bugs, von denen ich wusste. Eine reife Codebasis versteckt die schwierigeren.
Vergleich mit den Alternativen
OpenAIs eigene Cloud-FAQ beantwortet die Ersatzfrage in einer Zeile: "Codex Security complements SAST." So schneiden die nächsten Tools nach dem ab, was jeder Anbieter veröffentlicht:
| Tool | Veröffentlichter Preis | Prüft seine Funde? | Schlägt Fixes vor? | Am besten für |
|---|---|---|---|---|
| Codex Security Cloud | Enthaltenes Codex-Kontingent, danach Credits | Ja, reproduziert in einer Sandbox | Ja, Sie öffnen den Draft-PR | Logiklastige Bugs bei Teams mit ChatGPT-Tarif |
| Claude Code Security | Kein öffentlicher Preis, begrenzte Vorschau | Prüft jeden Fund erneut | Ja, mit menschlicher Freigabe | Teams, die auf Claude Code setzen |
| GitHub Code Security | 30 $ pro aktivem Committer/Monat | Regelbasierte CodeQL-Analyse | Ja, Copilot Autofix | Eine deterministische Basis bei jedem PR |
| Snyk | Gratis-Tarif, Team ab 25 $/Monat | Scannt Fix-Kandidaten erneut | Ja, Snyk Agent Fix | Abhängigkeits- und Open-Source-Risiken |
| Semgrep | Kostenlos bis 10 Contributors, Teams ab 30 $/Contributor/Monat | Nicht angegeben | Hinweise zur Behebung | Eigene Regeln, die Sie selbst schreiben |
Das Setup, das ich fahren würde: ein regelbasierter Scanner bei jedem Pull Request als Basis, über GitHubs kostenpflichtige Tarife, Snyk oder Semgrep. Dann Codex Security Cloud nach Zeitplan für die Bugs, die eine Regel nicht ausdrücken kann, etwa eine fehlende Auth-Prüfung, die erst Sinn ergibt, wenn man die ganze App versteht.
Wenn Ihr Team in Claude Code arbeitet, bietet dessen GitHub-Integration das nächstliegende Pendant auf PR-Seite. Für das breitere Feld siehe meine Liste der OpenAI-Codex-Alternativen. Sicherheitsteams, die die spezialisierten Cyber-Modelle abwägen, sollten mit der Übersicht der GPT-5.6-Cyber-Alternativen beginnen.
Vor- und Nachteile
| Vorteile | Nachteile |
|---|---|
| Fand alle 5 eingebauten Bugs ohne Fehlalarme | Eine 60-Zeilen-App kostete 3,75 bis 6,77 $ und dauerte 9 Minuten |
| Schwere-Einstufungen mit echter Begründung, nicht aus Reflex | Mein erster Lauf scheiterte beim Setup und kostete trotzdem etwa 1 $ |
| Bedrohungsmodell, Belege und Tests zu jedem Fund | Tarifzugang widerspricht sich auf OpenAIs eigenen Seiten |
| SARIF-Export für GitHub Code Scanning | Daybreak Blue gilt noch nicht für API-Key-CI-Scans |
| Wendet nie einen Patch ohne Menschen an | Kein öffentlicher Benchmark gegen SAST-Tools, nur OpenAIs eigene Zahlen |
Noch etwas ist zu beachten: Das Repo entwickelt sich schnell. Ein vor zwei Tagen gemergter Commit, sichtbar im GitHub-Repo, stellt das Standardmodell der CLI auf GPT-6 Sol mit xhigh um. Die von mir installierte npm-Version nutzte noch standardmäßig gpt-5.6-sol. Wenn das landet, sollten Scans günstiger werden, da der Credit-Satz von GPT-6 Sol halb so hoch ist wie der von GPT-5.6 Sol.
Für wen ist Codex Security Cloud?
Nutzen Sie es, wenn Sie ChatGPT Pro, Business, Enterprise oder Edu haben, Ihr Code auf GitHub liegt und kein Security-Engineer jede Änderung prüft. Es ist eine starke Zweitmeinung zu den Logik-Bugs, die regelbasierte Tools übersehen, und die Berichte sind gut genug, um sie unverändert an einen Entwickler zu geben. Starten Sie mit einem Repository-Scan Ihres sensibelsten Dienstes, prüfen Sie Ihr Nutzungs-Dashboard vorher und nachher, und aktivieren Sie erst dann das Commit-Monitoring.
Verzichten Sie, wenn Ihre Richtlinie vorschreibt, dass Quellcode Ihre Umgebung nicht verlassen darf. Es ist kein Offline-Scanner, und wie ein OpenAI-Mitarbeiter auf Hacker News erklärte, gehen Code und Kontext an OpenAIs gehostetes Modell. Verzichten Sie auch, wenn Sie Plus nutzen oder ein günstiges, deterministisches Gate bei jedem Pull Request brauchen. Das ist ein Job für CodeQL oder Semgrep.
Warten Sie, wenn Sie es headless aus der CI mit einem API-Key betreiben wollten. Bis das Daybreak-Blue-Problem behoben ist und sich die Speicherfehler legen, ist die CLI in der CI der schwächste Weg, es zu nutzen.
Verglichen mit OpenAIs anderen jüngsten Launches, etwa dem Always-on-Agenten OpenAI Dots und GPT-6.1 Sol, fühlt sich dieser am nächsten an produktionsreif an. Er ist weiterhin als Research Preview gekennzeichnet, richten Sie Ihre Erwartungen also an der Version aus, die vor Ihnen liegt.
eesel für die Warteschlange, die nie aufhört
Codex Security erledigt eine Aufgabe, nämlich Sicherheits-Bugs zu finden und zu erklären, und verdient Vertrauen, indem es seine Belege zeigt, bevor ein Mensch handelt. Das ist dieselbe Form wie bei den Teammates, die ich bei eesel baue. eesel ist eine Plattform für KI-Teammates mit heute zwei einsatzbereiten Mitarbeitern: einem KI-Helpdesk-Teammate, das zu Zendesk, Freshdesk, Gorgias oder Front stößt, und einem KI-Blogautor für Content und SEO.
Im Support gilt die Lehre aus meinem Scan direkt. Konfidenz ist nicht dasselbe wie Richtigkeit. Ein B2B-Fahrzeug-Telematik-Team auf Zendesk sah, wie ein Bot "yes, we support your car model" für Marken antwortete, die nicht in ihrer Datenbank standen, nur weil die Wissensdatenbank "we support all models" sagte. Deshalb lässt eesel das Helpdesk-Teammate zuerst in einer Simulation gegen Hunderte Ihrer vergangenen Tickets laufen, sodass Sie jede Antwort sehen, die es gesendet hätte, bevor es einen Live-Kunden berührt. Aktionen außerhalb seiner Regeln warten auf menschliche Freigabe, wie ein Draft-PR, der auf Ihr Review wartet.

Wenn Ihnen die CLI-Seite von Codex Security gefallen hat: eesel hat auch eine. Die eesel CLI steuert dasselbe Teammate und denselben Workspace, die Sie im Dashboard sehen, aus einem Terminal oder Skript. eesel approvals list zeigt, was auf einen Menschen wartet, und eesel activity listet jeden Lauf auf, damit Sie prüfen können, was das Teammate getan hat. Auch Coding-Agenten wie Codex und Claude Code können sie bedienen, denn jeder Workspace funktioniert zugleich als MCP-Server. Mein Ratgeber zur KI-Agenten-CLI erklärt, warum das wichtig ist.
Die Preise sind öffentlich: ein kostenloser Tarif mit 100 Credits, dann Tarife ab 299 $/Monat für 500 Credits, wobei ein Ticket oder Chat einen Credit kostet, laut Preisseite. Testen Sie eesel und lassen Sie das Helpdesk-Teammate noch am selben Nachmittag auf Ihren eigenen vergangenen Tickets laufen. Mein Erklärstück zu KI-Teammates behandelt das Modell ausführlicher.
Häufig gestellte Fragen
Lohnt sich Codex Security Cloud?
Wie genau ist Codex Security Cloud?
Was kostet ein Codex-Security-Cloud-Scan?
Welche ChatGPT-Tarife enthalten Codex Security Cloud?
Kann ich Codex Security Cloud mit einem API-Key nutzen?
Behebt Codex Security Cloud die gefundenen Bugs?
Was sind die besten Alternativen zu Codex Security Cloud?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.