

A IA para atualizações da página de status funciona melhor apontada no sentido contrário: deixe a página de status alimentar a IA, e não a IA alimentar a página de status. A página de status é o único lugar em que a engenharia concordou sobre o que é verdade. Um agente de IA que a leia pode associar cada ticket de “está fora do ar?” ao incidente declarado, responder com o texto publicado palavra por palavra e fazer o acompanhamento de cada ticket quando a página disser Resolved.
Escrever a atualização de status continua sendo uma decisão humana. A IA pode redigi-la a partir do canal do incidente, mas um engenheiro a aprova antes de sair, porque essa mensagem chega a todos os clientes de uma vez.
A infraestrutura já existe: o Statuspage envia um webhook a cada atualização de incidente a partir do plano Startup de US$ 99, e Zendesk e Freshdesk agrupam tickets de instabilidade, mas nenhum dos dois escreve as respostas enquanto a instabilidade está acontecendo. Essa lacuna é trabalho para um colega de IA como a eesel, que a SE Ranking usa em 4,650 conversas por mês com agentes configurados para nunca prometer o que a equipe não pode cumprir.
Por que a página de status fica atrás da caixa de entrada do suporte?
Construo integrações na eesel, o que significa que passo muito tempo lendo o que as APIs e os webhooks realmente enviam, em oposição ao que diz a página de marketing. Páginas de status são um bom exemplo. Toda grande ferramenta de página de status já anuncia cada atualização de incidente para quem se inscrever. A maioria dos helpdesks nunca se inscreve.
Então, durante uma instabilidade, dois relógios correm ao mesmo tempo. A engenharia está consertando o problema e, quando alguém tem um minuto, publica uma atualização. O suporte vê chegarem tickets com a mesma pergunta em cinquenta formulações diferentes, e cada agente confere o Slack, a página de status e os colegas para descobrir o que pode dizer. Um comentarista do Hacker News descreveu o lado do cliente com clareza:
"If I'm having issues but you show all green, I'm submitting a case."

E o atraso é real. Outro comentarista, descrevendo a instabilidade de um provedor de hospedagem:
"they only updated the status page to indicate that there's an issue ~20 minutes into the outage."
Vinte minutos é muito tempo numa fila de suporte, e seu tempo de primeira resposta sofre. A solução a que a maioria das equipes recorre é “fazer a IA escrever as atualizações de status mais rápido”. Acho que isso resolve o problema menor. O maior é que a página de status e o helpdesk não conversam entre si, então cada agente vira um revezamento humano entre os dois. Se você leu meu guia de suporte durante instabilidades, este artigo é a fiação por baixo dele: como a página de status se torna a fonte de verdade da IA.
Como a IA e a página de status devem trabalhar juntas?
O padrão que eu construiria tem cinco passos, e apenas um deles envolve a IA escrever algo novo.
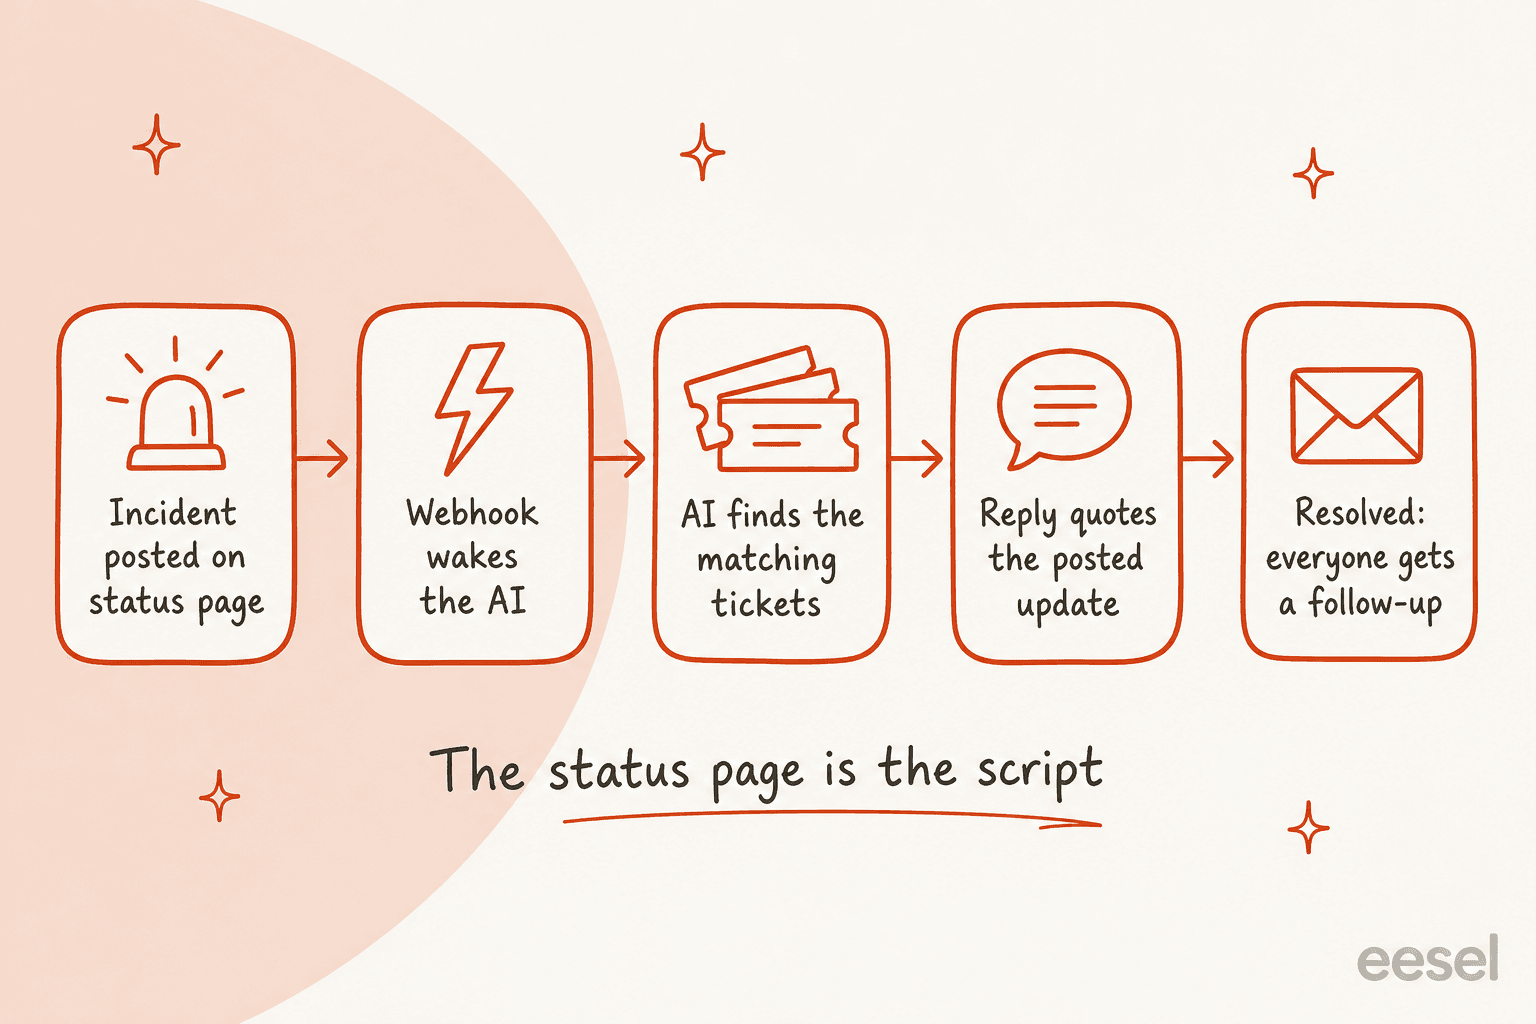
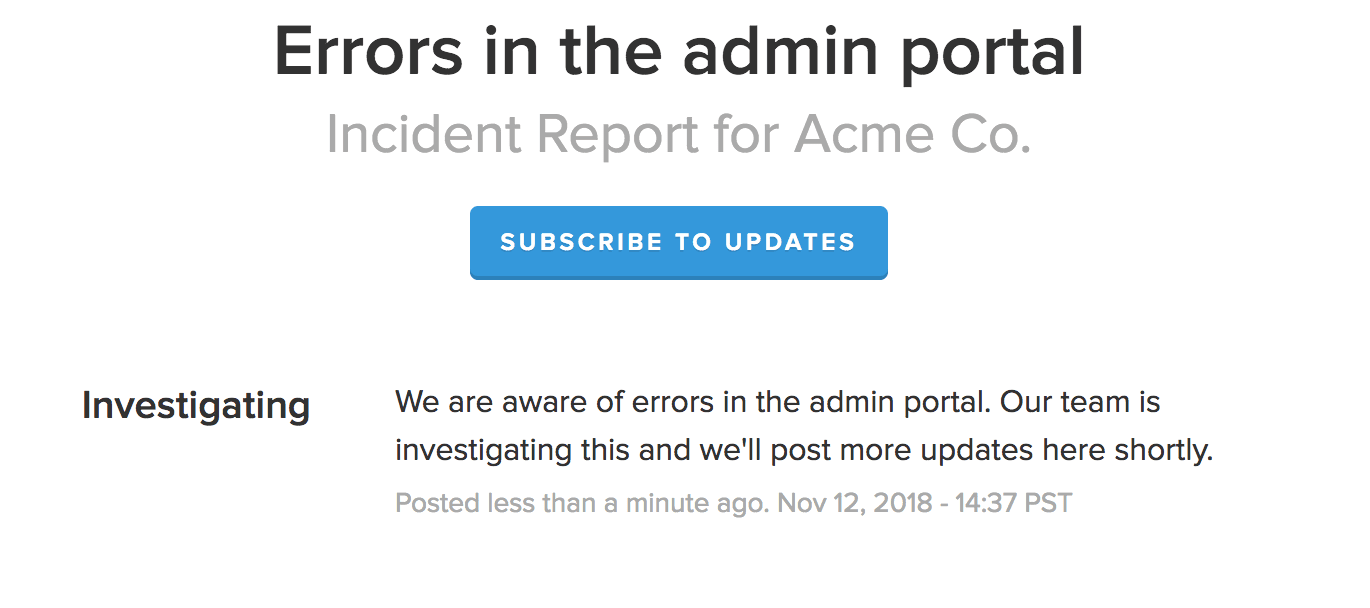
- Um engenheiro publica o incidente. No Atlassian Statuspage, isso é um nome, um de quatro status (Investigating, Identified, Monitoring, Resolved), uma mensagem e os componentes afetados.
- A página de status avisa a IA. Um webhook dispara a cada criação ou atualização, e a IA lê o nome do incidente, o status, a mensagem e os componentes.
- A IA encontra os tickets correspondentes. Tickets novos e abertos que descrevem o componente afetado são marcados com o incidente, de modo parecido com como a deduplicação de tickets agrupa perguntas repetidas.
- A resposta cita a página de status. O cliente recebe a mensagem publicada e um link, nada que os engenheiros não tenham escrito.
- Resolved fecha o ciclo. Quando o status muda para Resolved, cada ticket marcado recebe um acompanhamento, inclusive os que ficaram em silêncio.
A razão de essa ordem importar: a IA nunca decide o que é verdade sobre a instabilidade. Ela decide quais tickets tratam da instabilidade, uma tarefa de triagem em que a IA é boa. Os fatos vêm da página.
O que os webhooks e as APIs das páginas de status realmente enviam?
Esta é a parte que mais me importa, porque decide o que você pode construir sem código sob medida.
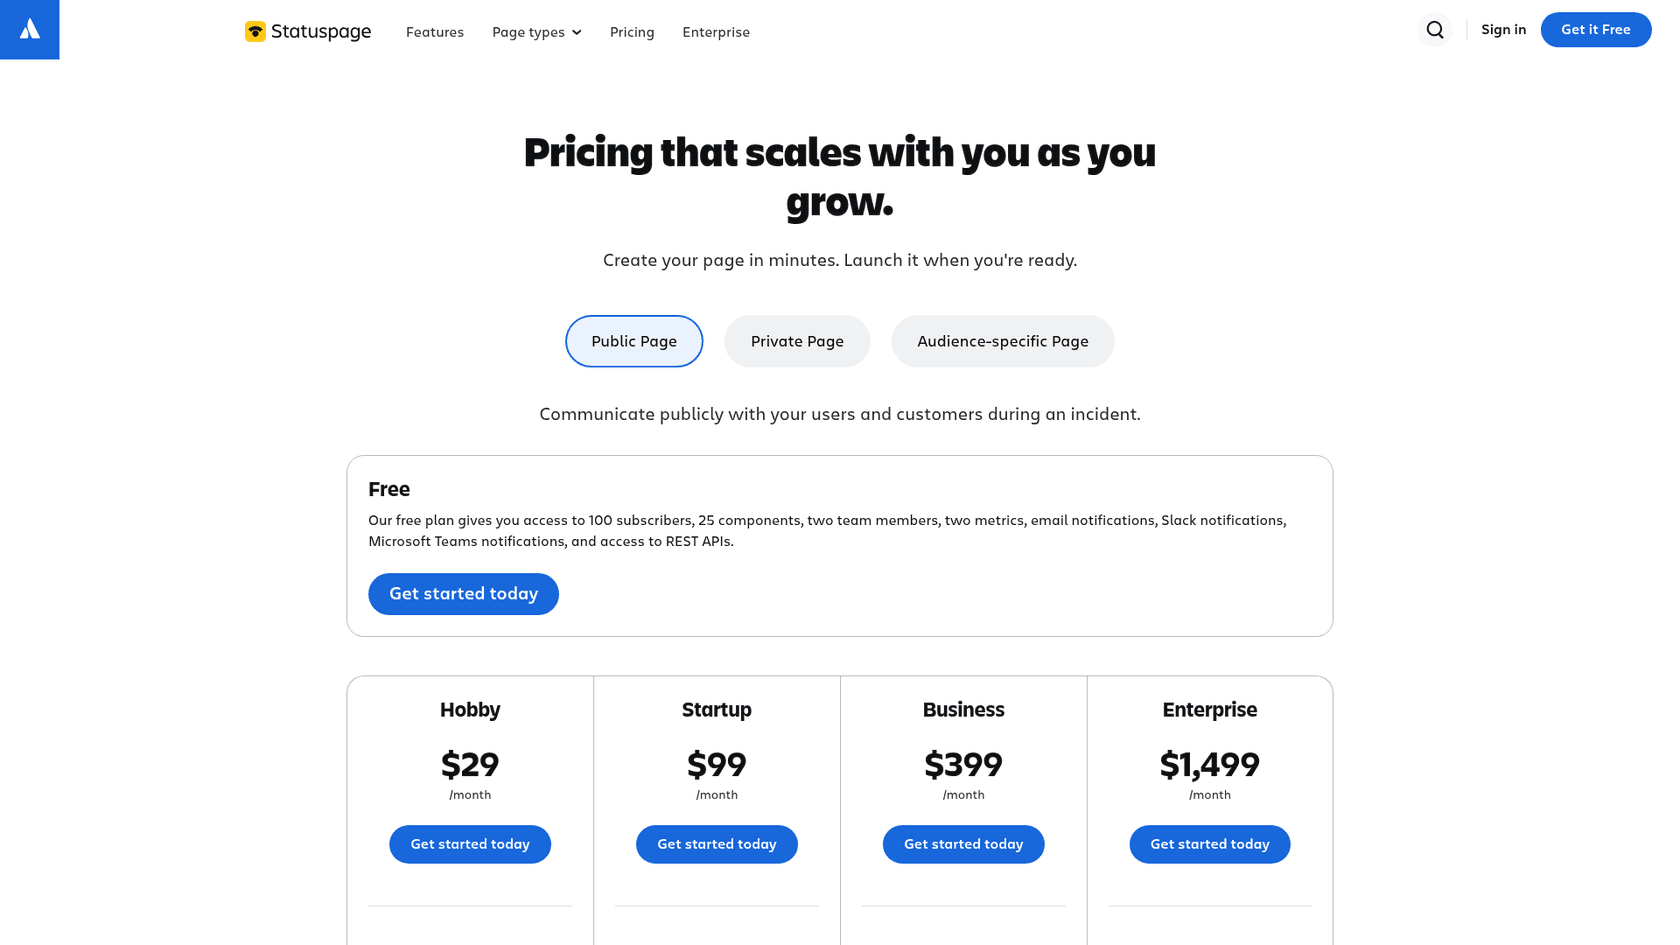
O Atlassian Statuspage pode enviar um webhook "when you create or update an incident, or update a component status", segundo seu guia de notificações por webhook. A carga traz o status geral da página, o componente que mudou com seu status antigo e novo, ou o incidente e sua última atualização. Seu endpoint precisa responder com um código 2xx em até 30 segundos. As notificações por webhook começam no plano Startup por US$ 99 ao mês; Free e Hobby listam apenas e-mail, Slack e Teams.
Também existe um lado de leitura. Toda página pública do Statuspage expõe um endpoint de resumo com o indicador de status, os status dos componentes e os incidentes não resolvidos, sem precisar de chave. A API REST do Statuspage autenticada permite criar e atualizar incidentes, limitada a 1 requisição por segundo por token. Esse limite é adequado para publicar atualizações e ruim para consultas periódicas a partir de um helpdesk movimentado.
A incident.io embute a página de status em seu fluxo de incidentes, de modo que "you're prompted to post when it matters most", e você pode "automate updates entirely or use templates with pre-approved messaging", segundo sua página de status pages. Os clientes se inscrevem por e-mail, Slack e RSS.
O PagerDuty diz que suas páginas de status externas permitem que os visitantes se inscrevam "via email, Slack or webhook", o que dá o mesmo gatilho de push do Statuspage.
Numa configuração da eesel, um push vira uma automação por webhook: você pede uma URL ao agente, cola na página de status como assinante de webhook, e cada atualização de incidente acorda o agente com a carga completa. Um cabeçalho de entrega como X-Eesel-Reference, definido com o ID do incidente, agrupa todas as atualizações de um incidente na página Activity. Para uma página que não consegue enviar push, o Network Access permite que o agente chame diretamente a API da página de status, com a chave guardada nas configurações e nunca exibida à IA.
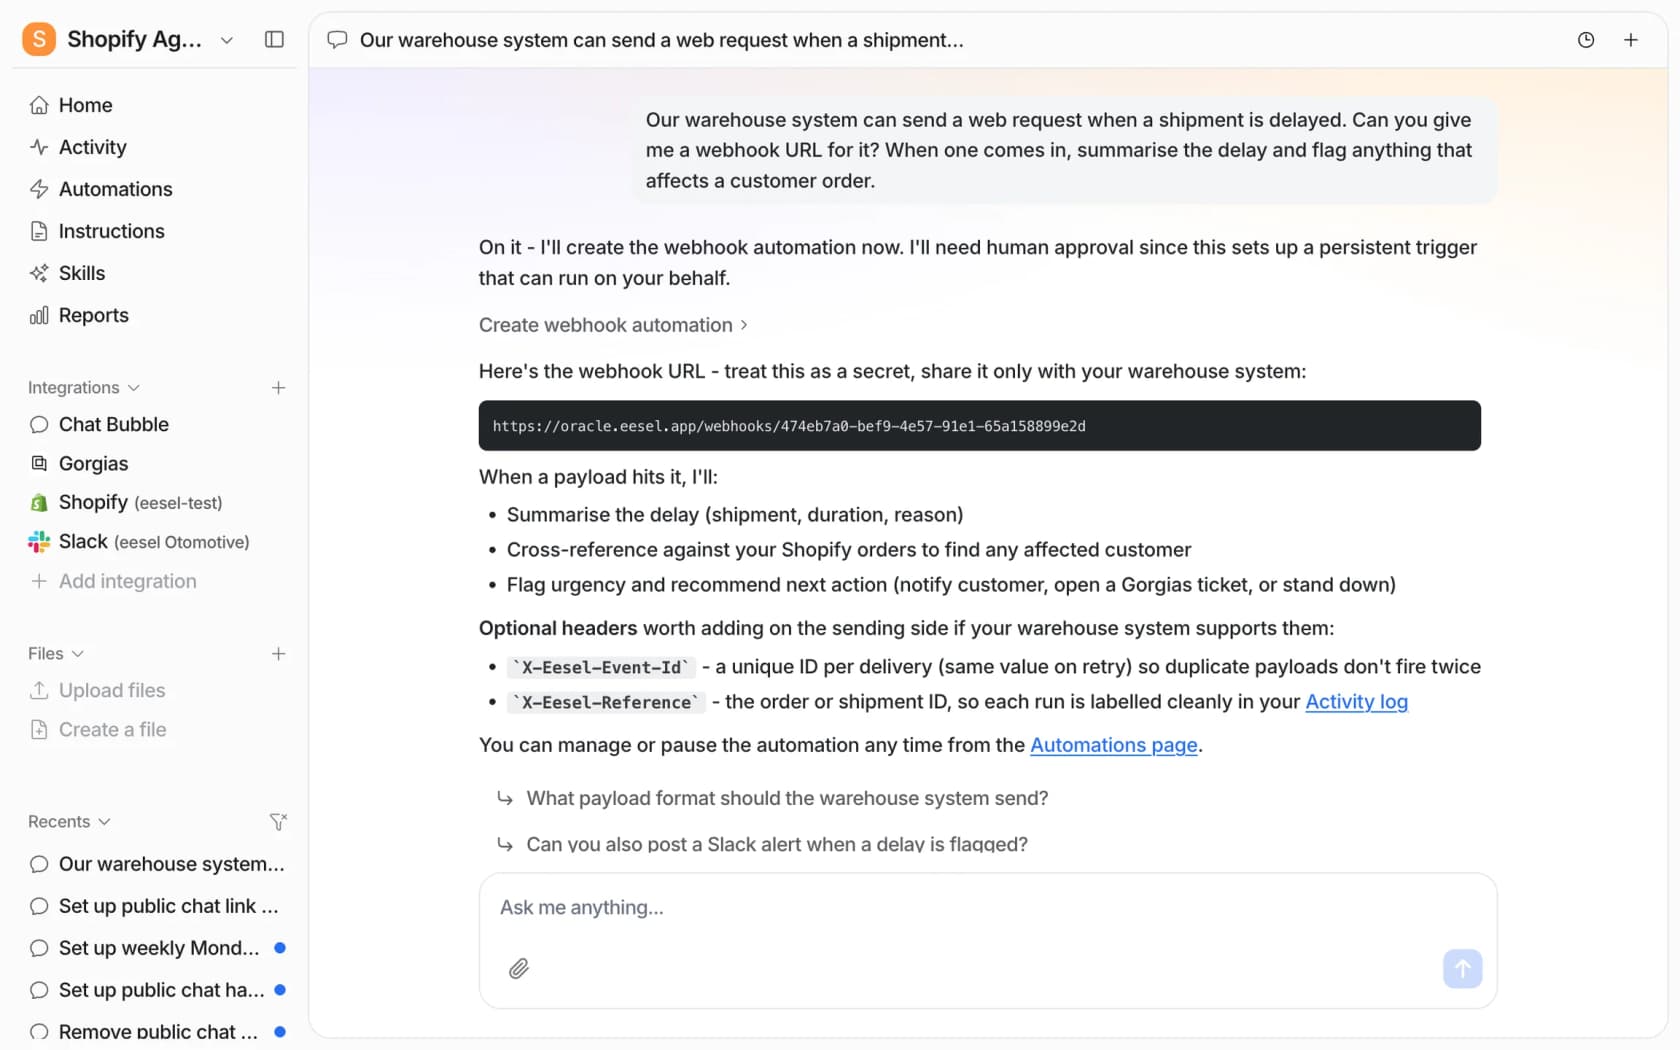
Dois limites que vale conhecer antes de um incidente, não durante. A URL de webhook da eesel aceita 60 entregas por minuto por workspace e processa oito por vez. Uma página de status envia um punhado de atualizações por incidente, então é mais que suficiente, mas é o motivo pelo qual eu nunca apontaria o fluxo bruto de alertas de uma ferramenta de monitoramento para ela. Alimente-a com o incidente confirmado por uma pessoa, não com cada oscilação.
Como a IA deve classificar os tickets de instabilidade?
Quando a IA sabe qual incidente está ativo, cada ticket recebido vai para uma de quatro faixas. É aqui que está a maior parte do valor, e onde a maioria das configurações é grosseira demais.
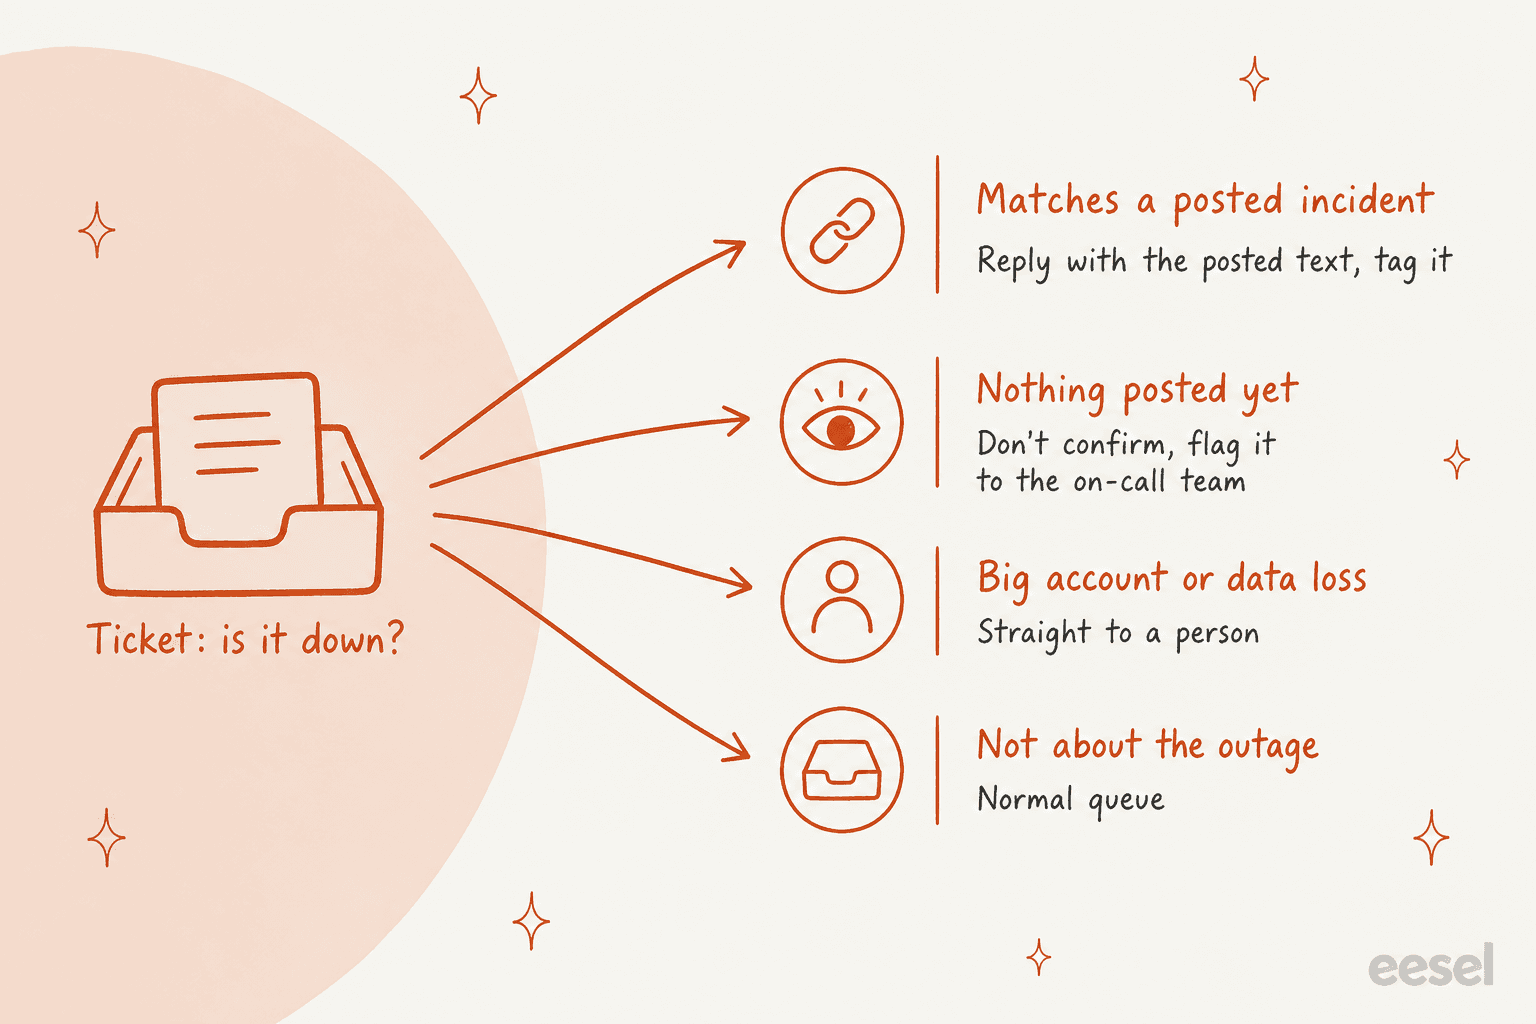
Corresponde a um incidente publicado. O ticket menciona o componente afetado, ou o sintoma que o incidente descreve. A IA responde com a última mensagem publicada, linka a página de status, diz que o ticket será atualizado quando for resolvido e adiciona uma tag de incidente. É a faixa de maior volume e a primeira a automatizar, com a mesma lógica de qualquer automação de primeira resposta.
Nada publicado ainda. Os clientes muitas vezes percebem antes da página. Aqui a IA não deve confirmar uma instabilidade, porque não tem nada com que confirmá-la. Ela pode dizer que a equipe está verificando, marcar o ticket e postar um alerta no canal de plantão. Cinco tickets sobre o checkout em dez minutos sem incidente publicado são um alerta precoce, e o suporte costuma ver isso primeiro. Quando o incidente é publicado, a IA volta a esses tickets e também os responde.
Conta grande ou perda de dados. Alguns tickets não devem receber uma resposta de modelo, por mais correta que seja. Contas enterprise nomeadas, quem relata dados perdidos, quem cita um SLA, quem pede créditos. Eles vão para uma pessoa pelas suas regras normais de escalonamento de IA. A Qontro, uma empresa de software ERP que usa a eesel no Freshdesk, envia instabilidades, perda de dados e dúvidas de cobrança direto para uma pessoa, em vez de deixar a IA investigá-las.
Não é sobre a instabilidade. Uma dúvida de cobrança que chega no meio de um incidente continua sendo uma dúvida de cobrança. Ela vai para a fila normal, e a IA não deve colar o texto do incidente nela só porque o momento coincide. Fique atento a isso nos testes, pois é a falsa correspondência mais comum, a mesma falha que trato em reduzir falsos positivos.
O que a IA deve dizer, e nunca dizer, no meio de uma instabilidade?
As regras são curtas, e fazem a diferença entre uma IA que acalma os clientes e uma que cria um segundo incidente.
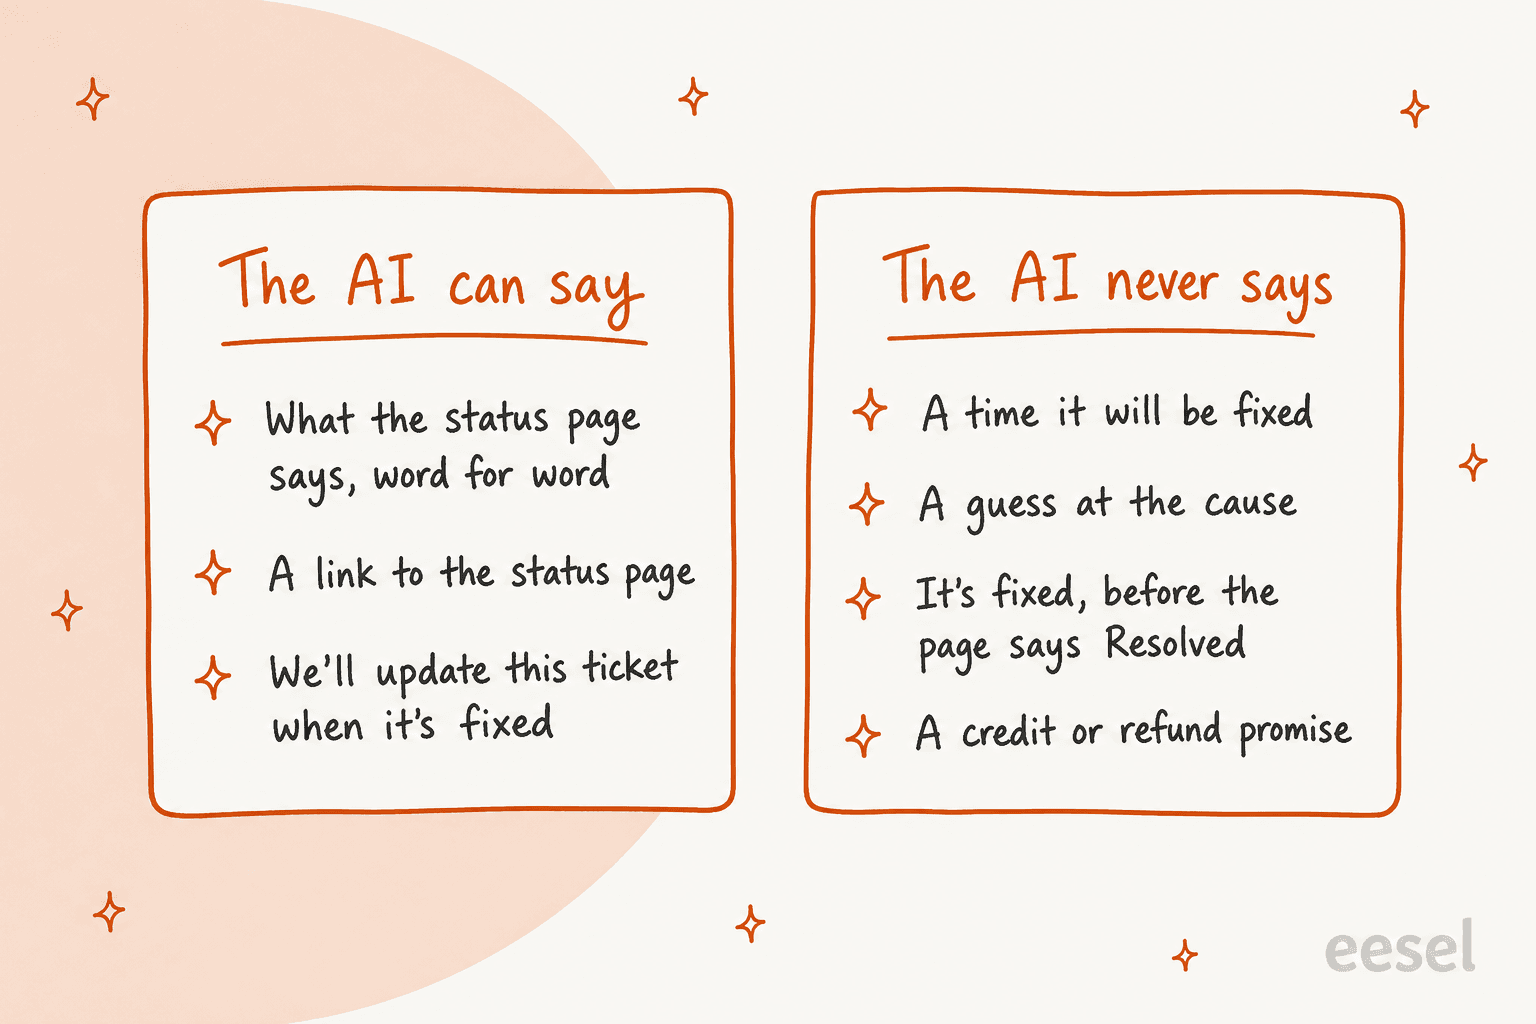
A lista de “nunca” gira em torno de uma coisa: a IA só pode repetir compromissos que a engenharia assumiu. Um modelo a quem se pergunta “quando volta?” produzirá de bom grado um horário que soa razoável, e isso é uma alucinação de IA com carimbo de data e hora. O mesmo vale para a causa raiz. Até “Identified” no Statuspage significa que a equipe encontrou a causa, não que a compartilhou.
Aqui eu me inspiraria em como a SE Ranking configurou seus agentes. A equipe queria o chat ao vivo respondido na hora "without the bot promising things the team could not deliver." Então seus agentes da eesel dizem aos clientes para esperar uma resposta em um ou dois dias úteis, nunca que alguém está entrando agora. É o instinto certo também para instabilidades: uma resposta mais lenta e verdadeira vale mais que uma rápida e inventada.
Também ajuda escrever a resposta como um modelo fixo que a IA preenche, em vez de deixá-la compor livremente:
| Status na página | O que a resposta da IA contém |
|---|---|
| Investigating | A mensagem publicada, o link da página de status, “atualizaremos este ticket quando for resolvido” |
| Identified | A nova mensagem publicada, o link, a mesma promessa de acompanhamento |
| Monitoring | A mensagem publicada, uma nota de que uma correção foi aplicada e está sendo observada, ainda sem “corrigido” |
| Resolved | A mensagem de resolução, um pedido para responderem se o problema continuar, e então o ticket é resolvido |
Como Zendesk e Freshdesk tratam hoje os tickets de instabilidade?
Os helpdesks têm recursos para instabilidades há anos. Eles agrupam bem os tickets. O que não fazem é escrever a resposta ao cliente, e é nos detalhes que a IA se encaixa.
O Zendesk tem tickets de problema e de incidente: você vincula cada relato a um ticket de problema, e resolver o problema resolve os incidentes e copia o comentário de fechamento para cada um que não foi resolvido. Está disponível no Suite Team e acima. Dois limites do próprio artigo do Zendesk importam aqui. "AI agent tickets can't be linked to problem and incident tickets", e quando o problema é resolvido, "Customers are not notified using the messaging channel." Assim, os tickets tratados pelo próprio agente de IA do Zendesk, e os clientes que escreveram por mensagens, podem perder a atualização de fechamento. Meu guia de tipos de ticket do Zendesk cobre a configuração, e você pode definir o tipo automaticamente com uma automação.
O Freshdesk tem tickets vinculados, que agrupam relatos sob um ticket “tracker”. O próprio exemplo do Freshdesk é "your product is facing some unexpected downtime." Um comentário no tracker é transmitido a todos os tickets vinculados, mas "the internal broadcast message will be visible only to agents", então um agente ainda escreve cada resposta ao cliente. E resolver o tracker "would not resolve the linked tickets by default", segundo uma FAQ do Freshdesk.
Juntando tudo, os helpdesks dão o agrupamento. O trabalho da IA é o que fica no meio: decidir qual ticket pertence a qual incidente e escrever a resposta ao cliente a partir do texto da página de status. No Zendesk, uma IA que escreve nos próprios tickets de incidente também contorna o limite “AI agent tickets can't be linked”, porque os tickets continuam sendo tickets comuns.
Quanto custam as ferramentas de página de status?
Veja o que cada ferramenta cobra, segundo sua própria página de preços em 30/10/2026. A página de status costuma ser a parte barata; o custo que surpreende as equipes está no lado do helpdesk, que trato a seguir.
| Ferramenta e plano | Preço | Assinantes | Webhook de saída | Recursos de IA |
|---|---|---|---|---|
| Statuspage Free | US$ 0 | 100 | Não (e-mail, Slack, Teams) | Nenhum listado |
| Statuspage Hobby | US$ 29/mês | 250 | Não | Nenhum listado |
| Statuspage Startup | US$ 99/mês | 1.000 | Sim | Nenhum listado |
| Statuspage Business | US$ 399/mês | 5.000 | Sim, mais assinaturas por componente | Nenhum listado |
| Statuspage Enterprise | US$ 1.499/mês | 25.000 | Sim | Nenhum listado |
| incident.io Basic | Grátis | Ilimitados, 1 página pública | E-mail, Slack, RSS | Editor básico de post-mortem |
| incident.io Team | US$ 15/usuário/mês anual, US$ 19 mensal | Ilimitados | E-mail, Slack, RSS | Editor básico de post-mortem, fluxos de trabalho |
| incident.io Pro | US$ 25/usuário/mês | Ilimitados, mais 1 página interna | E-mail, Slack, RSS | Post-mortems nativos com IA |
| PagerDuty Free | US$ 0 | Sem página de status | n/a | n/a |
| PagerDuty Professional | US$ 21/usuário/mês anual, US$ 25 mensal | 250 na página externa, mais com o complemento Status Pages | Sim (e-mail, Slack, webhook) | Revisões pós-incidente com IA via PagerDuty Advance |
| PagerDuty Reliability Platform Starter | US$ 2.800/ano | Incluído | Sim | Incluído |
Minha leitura: se você já usa incident.io ou PagerDuty para plantão, use a página de status que já tem. Se só precisa de uma página pública e quer o webhook, o Statuspage Startup a US$ 99 é a linha a cruzar. Nenhuma dessas ferramentas responde aos seus tickets, porém; isso continua sendo trabalho do lado do suporte.
Quanto custa uma instabilidade no lado do suporte?
É aqui que os modelos de preço começam a importar. Uma instabilidade é um pico de suporte feito de perguntas quase idênticas, e alguns preços de IA transformam esse pico em fatura.
O Zendesk cobra seu agente de IA por resolução automatizada: US$ 1,50 cada em volume contratado ou US$ 2,00 pay-as-you-go, depois das 5 a 10 incluídas por agente ao mês. O Freshdesk vende sessões do Freddy AI Agent a US$ 49 por 100 depois de 500 grátis uma única vez. O preço da eesel é um lote mensal fixo de créditos, em que um ticket ou chat é um crédito: US$ 299 por 500, até US$ 1.749 por 5.000. Insira abaixo a sua própria instabilidade.
O ponto não é que um modelo seja sempre mais barato. É que o preço por resolução faz de uma instabilidade, o dia em que sua equipe já está mais pressionada, também um evento de custo variável. Um lote mensal fixo é mais fácil de orçar se o seu produto tem um dia ruim de vez em quando.
A IA deve escrever a própria atualização da página de status?
Ela pode redigi-la. Eu não a deixaria publicar. A mensagem da página de status é a única peça de comunicação da instabilidade que chega a todos os clientes de uma vez, e cada resposta de suporte a partir dela a cita. Se estiver errada, tudo que foi construído sobre ela está errado.
Um comentarista do Hacker News, respondendo se as páginas de status são atualizadas automaticamente, resumiu bem o dilema:
"Typically no because there's an art to crafting the actual message around impact… but sometimes yes it is automated"
O bom meio-termo é um rascunho com uma etapa de aprovação. A API REST do Statuspage aceita um novo incidente ou atualização como um simples POST, então um agente de IA com Network Access a api.statuspage.io pode preparar a atualização a partir do canal do incidente, e um engenheiro a aprova antes de ela ser postada. Na eesel, isso é uma ação definida como Needs approval: o agente para, mostra o texto exato e espera Approve ou Deny. Do lado dos incidentes, o plano Pro da incident.io lista um editor de post-mortem nativo com IA e o PagerDuty oferece revisões pós-incidente geradas por IA por meio do complemento Advance, então o relatório posterior está coberto ali.
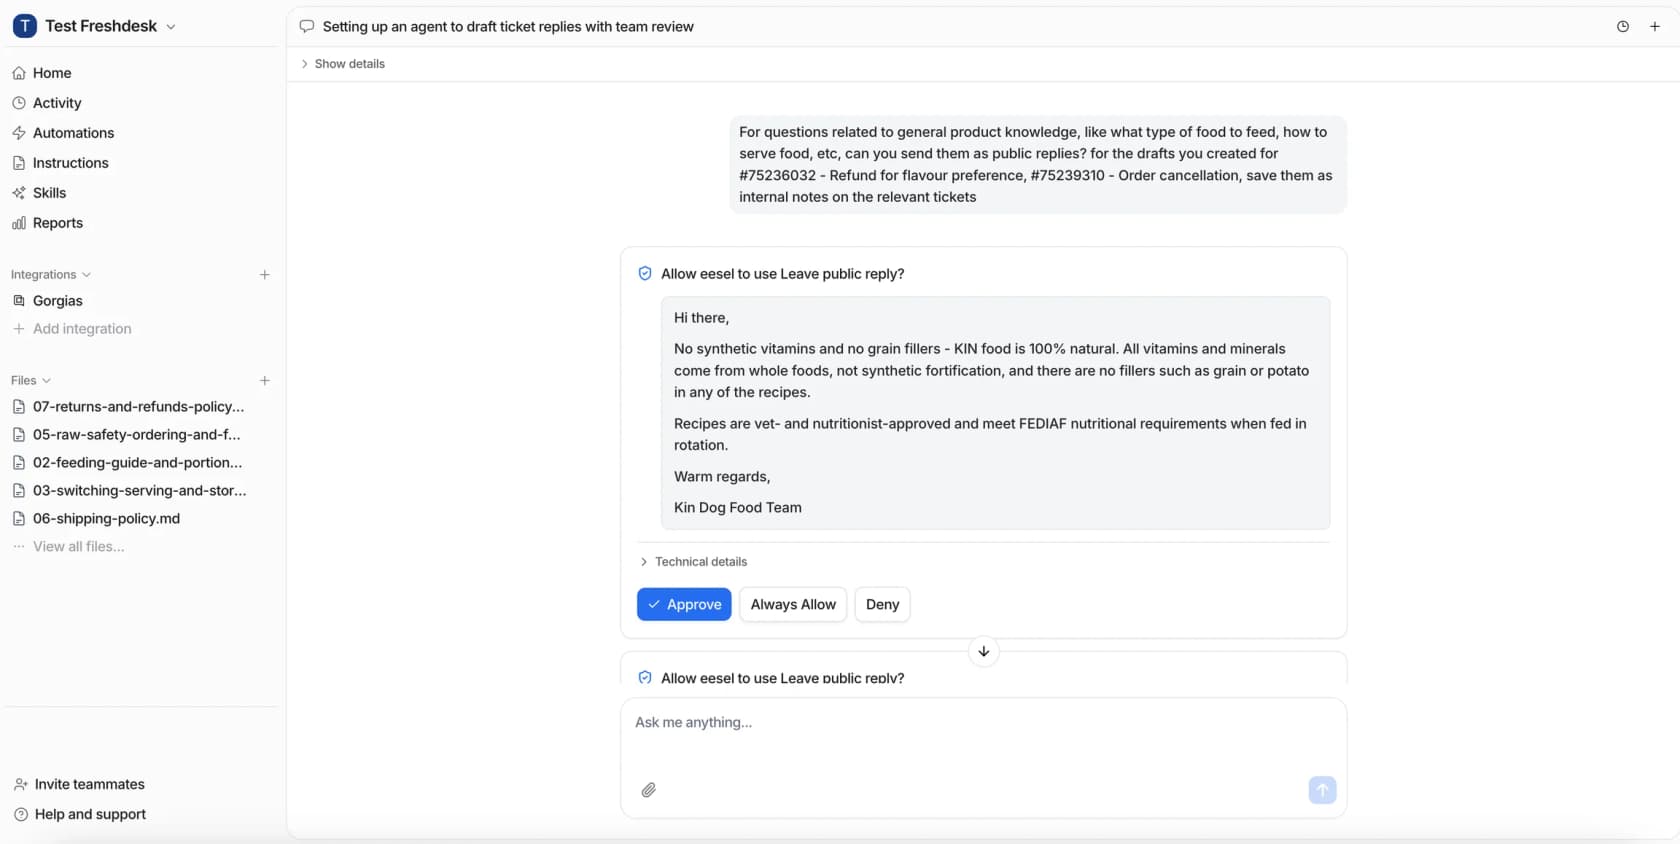
É também assim que eu começaria as respostas do lado do suporte. A Lesson Pro usa a eesel em duas contas do Zendesk, onde ela deixou 1,700 notas internas e redigiu 560 respostas em um mês, com a equipe aprovando antes de qualquer coisa chegar a um cliente. Começar supervisionado nas respostas de instabilidade custa alguns minutos no primeiro incidente e mostra exatamente o que a IA teria enviado.
Como configurar isso antes da próxima instabilidade?
A configuração leva uma tarde. Fazê-la no meio de um incidente leva muito mais, então aqui está a ordem que eu seguiria.
- Escolha a fonte de verdade. Uma página de status, um conjunto de nomes de componentes. Se engenharia e suporte chamam o serviço de checkout de nomes diferentes, resolva isso primeiro, pois a IA associa os tickets por componente.
- Inscreva a IA na página. No Statuspage Startup ou superior, ou no PagerDuty, adicione a URL de webhook do agente como assinante. Caso contrário, use o endpoint de resumo público ou a API do fornecedor via Network Access.
- Escreva as faixas nas instruções. As quatro faixas acima, o modelo de resposta por status e a lista de “nunca dizer”. Nomeie as contas enterprise e as palavras-chave que ficam fora da resposta automática.
- Escolha sua tag e a regra de acompanhamento. Uma tag de incidente por instabilidade, e uma regra de que Resolved dispara um acompanhamento em cada ticket marcado. No Zendesk, você também pode vincular os tickets a um ticket de problema e atualizar o status em massa se preferir fechá-los manualmente.
- Teste numa instabilidade passada. Reproduza os tickets do seu último incidente real e confira cada faixa, a abordagem do meu guia de testes de simulação. Observe de perto a faixa “Não é sobre a instabilidade”.
- Comece com rascunhos, depois entre em produção. Coloque as respostas públicas em Needs approval no primeiro incidente e mude a faixa correspondente para Auto quando os rascunhos estiverem certos. Mantenha créditos e reembolsos sob aprovação de forma permanente.
- Conte. Marque cada ticket de instabilidade tratado pela IA para poder reportar, como a SE Ranking pediu uma tag
ai_handledem todo ticket que a eesel toca, "so containment is counted in Zendesk, not guessed." Meu guia de relatórios de suporte cobre o resto.
Se preferir configurar a partir de um terminal, ou fazer um agente de programação cuidar disso, a CLI da eesel executa o mesmo agente do painel. eesel automations lista a automação por webhook e a liga ou desliga, eesel activity mostra o que o agente fez com cada atualização de incidente e eesel approvals lista as respostas à espera de uma pessoa. Todo comando imprime JSON com uma opção --dry-run para escritas, e por isso o Claude Code, o Cursor ou o Codex conseguem conduzir toda a configuração e ler de volta seus próprios resultados.
Experimente a eesel nos tickets de instabilidade
A eesel é uma colega de IA para o seu helpdesk, e os tickets de instabilidade são um primeiro trabalho limpo para ela. Ela lê cada atualização da sua página de status, associa os tickets de “está fora do ar?” no Zendesk, Freshdesk ou Gorgias ao incidente, responde com o texto publicado e faz o acompanhamento de cada um quando a página diz Resolved. Contas grandes e perda de dados vão direto para sua equipe, como a Qontro encaminha seus tickets de instabilidade.
Comece com rascunhos e aprovações ligadas, reproduza sua última instabilidade e mude a faixa correspondente para Auto quando confiar nela. Os planos começam em US$ 299 por mês para 500 tickets, com 100 créditos grátis para testar antes. Experimente a eesel.