

O Gemini Omni 1.2 Flash é a atualização de 5 de novembro de 2026 do Google DeepMind para seu modelo de vídeo Omni. As principais mudanças são clipes de 15 segundos (antes 10), cerca de US$ 0,07 por segundo de vídeo em 720p (antes cerca de US$ 0,10), e consistência mais apertada de personagens e produtos entre imagens de referência. Ainda é um modelo sobre o qual você constrói, não um trabalhador que faz um serviço. Eu usaria para pipelines de vídeo de anúncios e de produto. Para tickets de suporte ou posts de blog, um colega de equipe pronto para uso como o eesel encaixa melhor, e o eesel CLI permite que um agente de código envie conhecimento aprovado e teste as respostas de um colega de equipe antes de ir ao ar.
O que é o Gemini Omni 1.2 Flash?
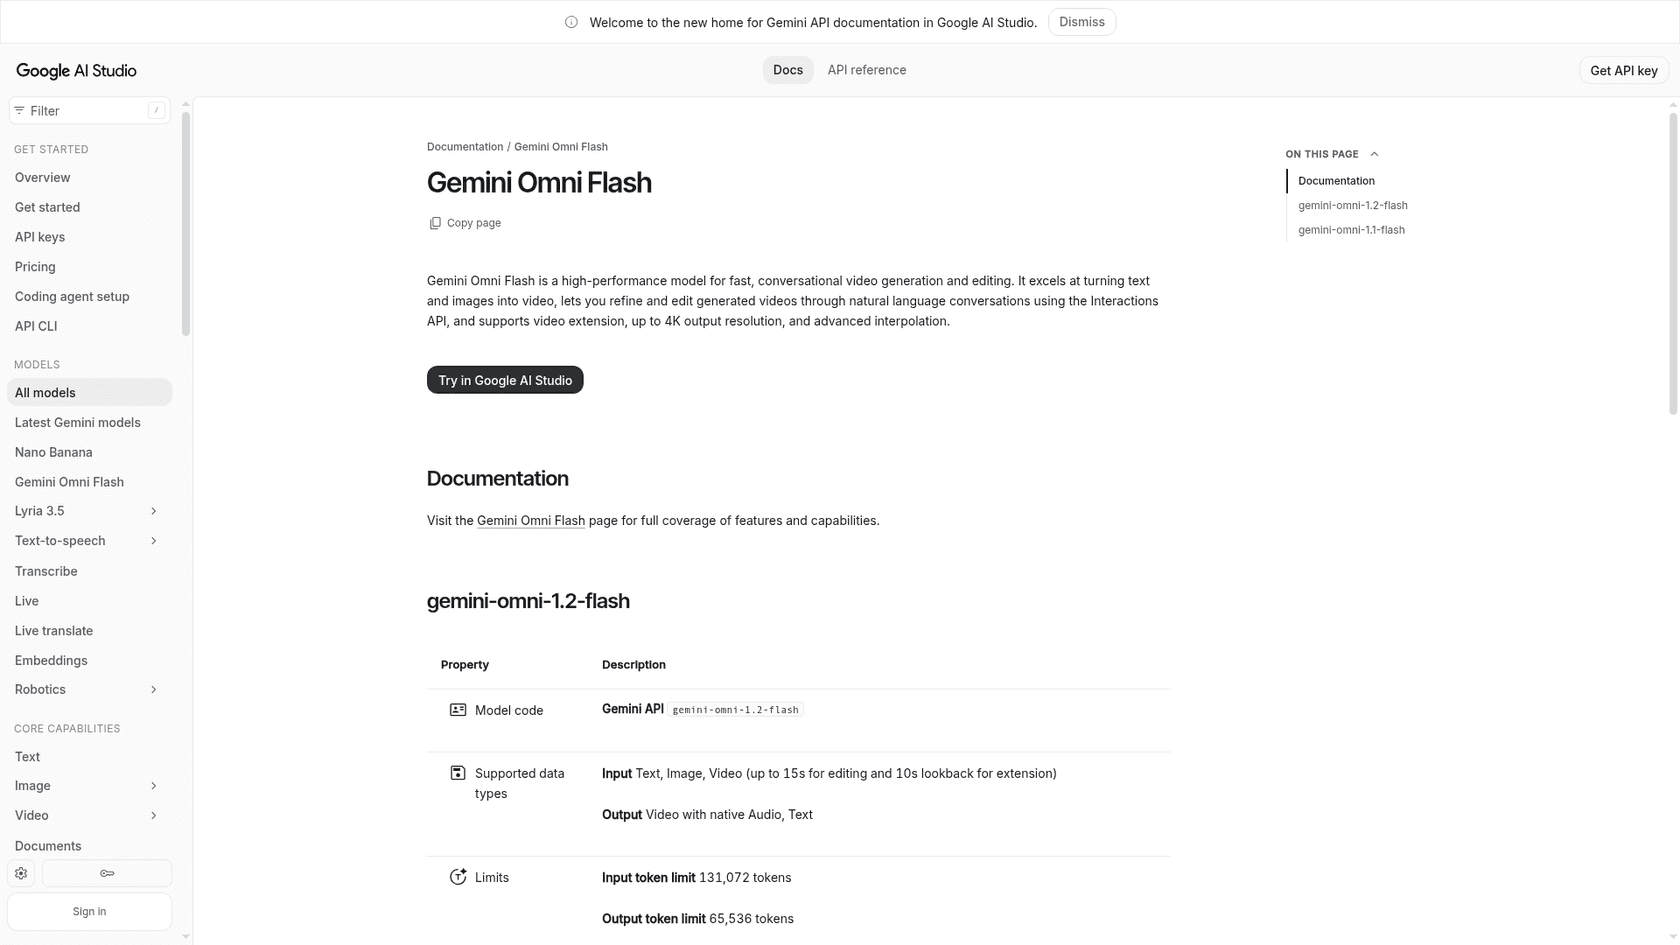
É o terceiro lançamento na linha de vídeo Omni do Google, depois do Gemini Omni Flash original e da atualização de agosto, o Gemini Omni 1.1 Flash. A ficha do modelo do Google lista texto, imagens, áudio e vídeo como entradas, e "vídeo de alta qualidade e alta resolução com áudio" como saída. O ID do modelo na API Gemini é gemini-omni-1.2-flash, e o changelog da API Gemini marca sua disponibilidade geral em 5 de novembro de 2026.
A ideia segue das versões anteriores: você descreve uma cena e depois a refina conversando em vez de renderizar tudo de novo do zero. Se você quer a origem do modelo original, meu review do Gemini Omni Flash conta essa história.
O que mudou desde o 1.1?
Resumindo: clipes mais longos, preço mais baixo e referências mais fortes. Um detalhe vai na direção contrária, que eu sinalizo mais abaixo.
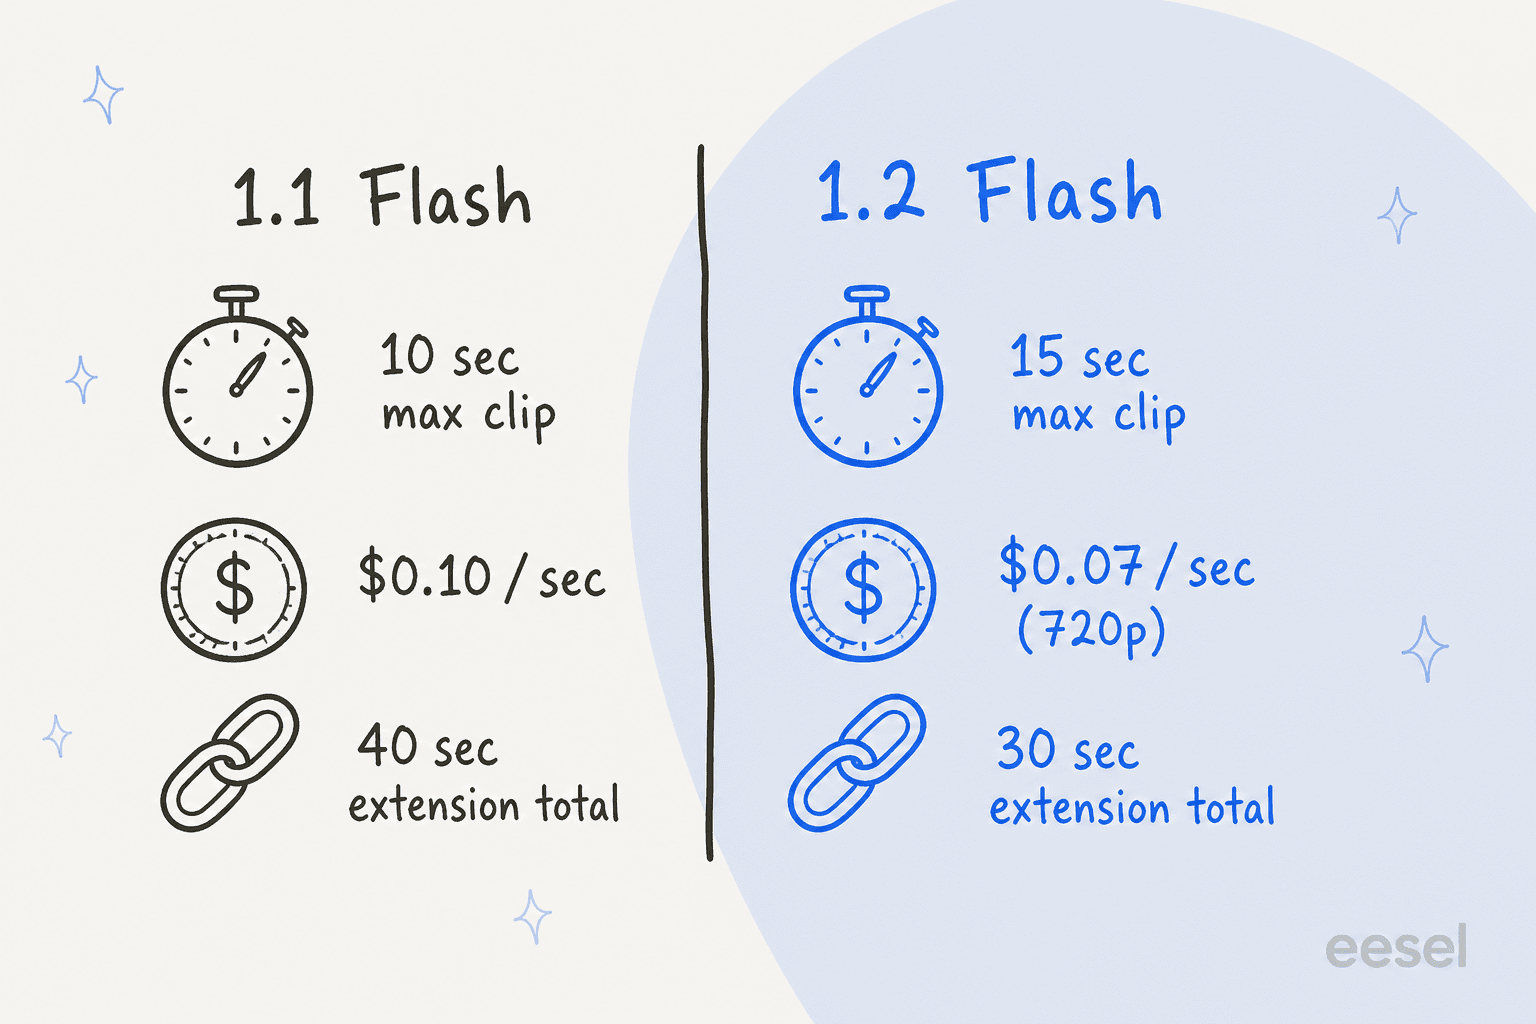
- Duração do clipe: 3 a 15 segundos por geração, em passos de um segundo, segundo a documentação do Google AI Studio. A versão 1.1 limitava uma geração a 10 segundos.
- Preço: a saída de vídeo cai para
US$ 12,00por 1 milhão de tokens, vindo deUS$ 17,50, o que a página de preços coloca em cerca deUS$ 0,07por segundo de vídeo em 720p. - Referências: o changelog diz que o modelo mantém personagens e assuntos mais consistentes em até seis imagens de referência. Referências de áudio ficam atrás de uma allowlist no Google Cloud.
- Fala: o post de lançamento do Google Cloud cita sincronia labial mais clara e condicionamento multi-locutor.
- Limites: os limites de taxa do nível pago dobraram, segundo a mesma entrada do changelog.
Uma coisa vai contra a tendência. No lançamento, o 1.1 anunciava extensão de cena de até 40 segundos no total. A documentação do 1.2 lista a extensão em 3 a 10 segundos por turno, até 30 segundos no total. As páginas do Google não explicam a diferença, então, se você planejava cadeias de 40 segundos, teste antes de se comprometer.
Quão bom ele é, pelos próprios números do Google?
A página do Gemini Omni do Google publica taxas de vitória lado a lado para o 1.2 contra o 1.1. São avaliações do próprio Google, não um benchmark independente, e seus prompts e imagens de referência não estavam nessa amostra.
| Teste | Taxa de vitória 1.2 | Taxa de vitória 1.1 |
|---|---|---|
| Texto para vídeo, consistência visual | 62% | 38% |
| Referência para vídeo, preferência geral | 63% | 37% |
| Referência para vídeo, consistência de identidade | 63% | 37% |
| Imagem para vídeo, preferência geral | 59% | n/a |
| Edição por instrução | 57% | n/a |
Leia isso como "um avanço claro, porém moderado". Uma taxa de vitória de 62% significa que cerca de uma em cada três comparações ainda preferia o modelo mais antigo. Para trabalho de anúncios, as linhas de consistência de referência são as que mais importam, porque cores de produto que escapam são geralmente o motivo pelo qual uma geração é rejeitada.
Quanto custa?
A página de preços da API Gemini lista o modelo apenas no nível padrão. Não há nível gratuito nem nível em lote. A entrada custa US$ 1,50 por 1 milhão de tokens, a saída de texto US$ 9,00, e a saída de vídeo US$ 12,00.
| Resolução | Por segundo | Tokens por segundo |
|---|---|---|
| 360p | US$ 0,023 | 1.931 |
| 720p | cerca de US$ 0,07 | 5.792 |
| 1080p (com upsampling) | US$ 0,104 | 8.688 |
| 4K (com upsampling) | US$ 0,209 | 17.376 |
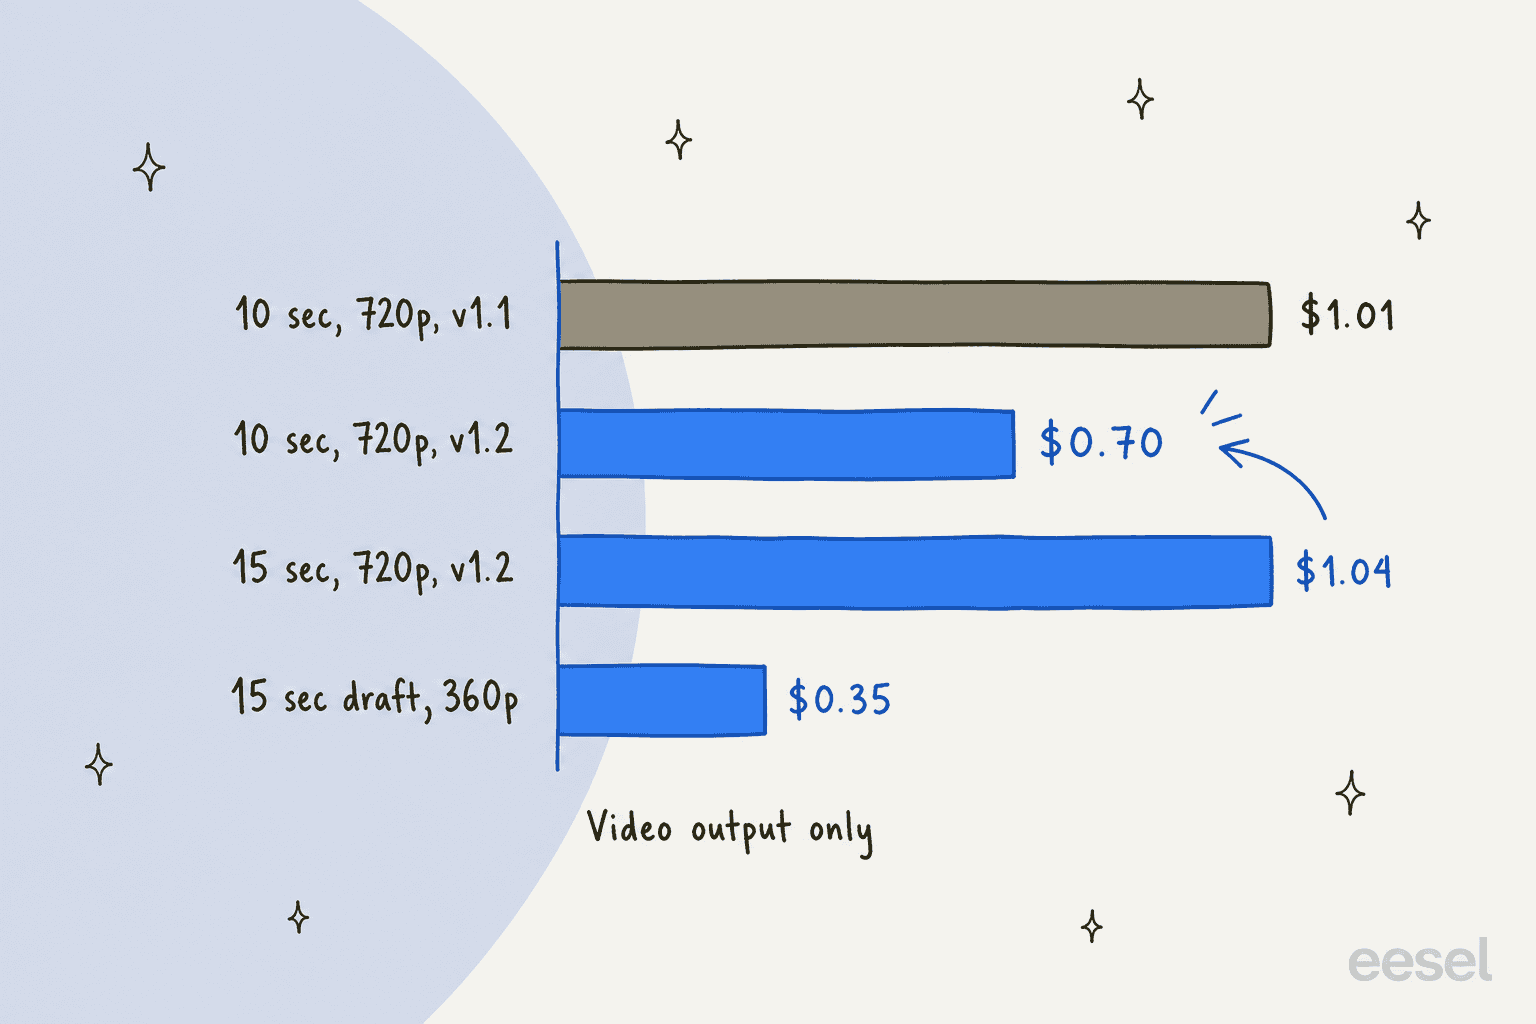
Os 5.792 tokens por segundo em 720p vêm da mesma tarifa usada no meu guia de preços do Omni 1.1. Multiplicando, um clipe completo de 15 segundos em 720p custa cerca de US$ 1,04 e um de 10 segundos cerca de US$ 0,70, contra cerca de US$ 1,01 por 10 segundos no 1.1. Para um contexto mais amplo, veja minha ventilação dos preços do Gemini Omni Flash e o guia geral de preços do Gemini.
A página de preços do Google diz que, a partir de 3 de dezembro de 2026, as solicitações para o ID do modelo 1.1 são roteadas automaticamente para o 1.2 e cobradas nas tarifas do 1.2. Se você tem chamadas 1.1 em produção, seus custos caem sem uma mudança de código, e sua saída também muda sem uma.
Como funciona o fluxo de rascunho e depois upscale?
O post de lançamento do Google descreve rascunhar em 360p ou 720p, e depois fazer upscale da melhor tomada para 1080p ou 4K. Na prática, você itera de forma barata, corrige problemas com uma mensagem de chat de acompanhamento, e só paga pela renderização em alta resolução uma vez.
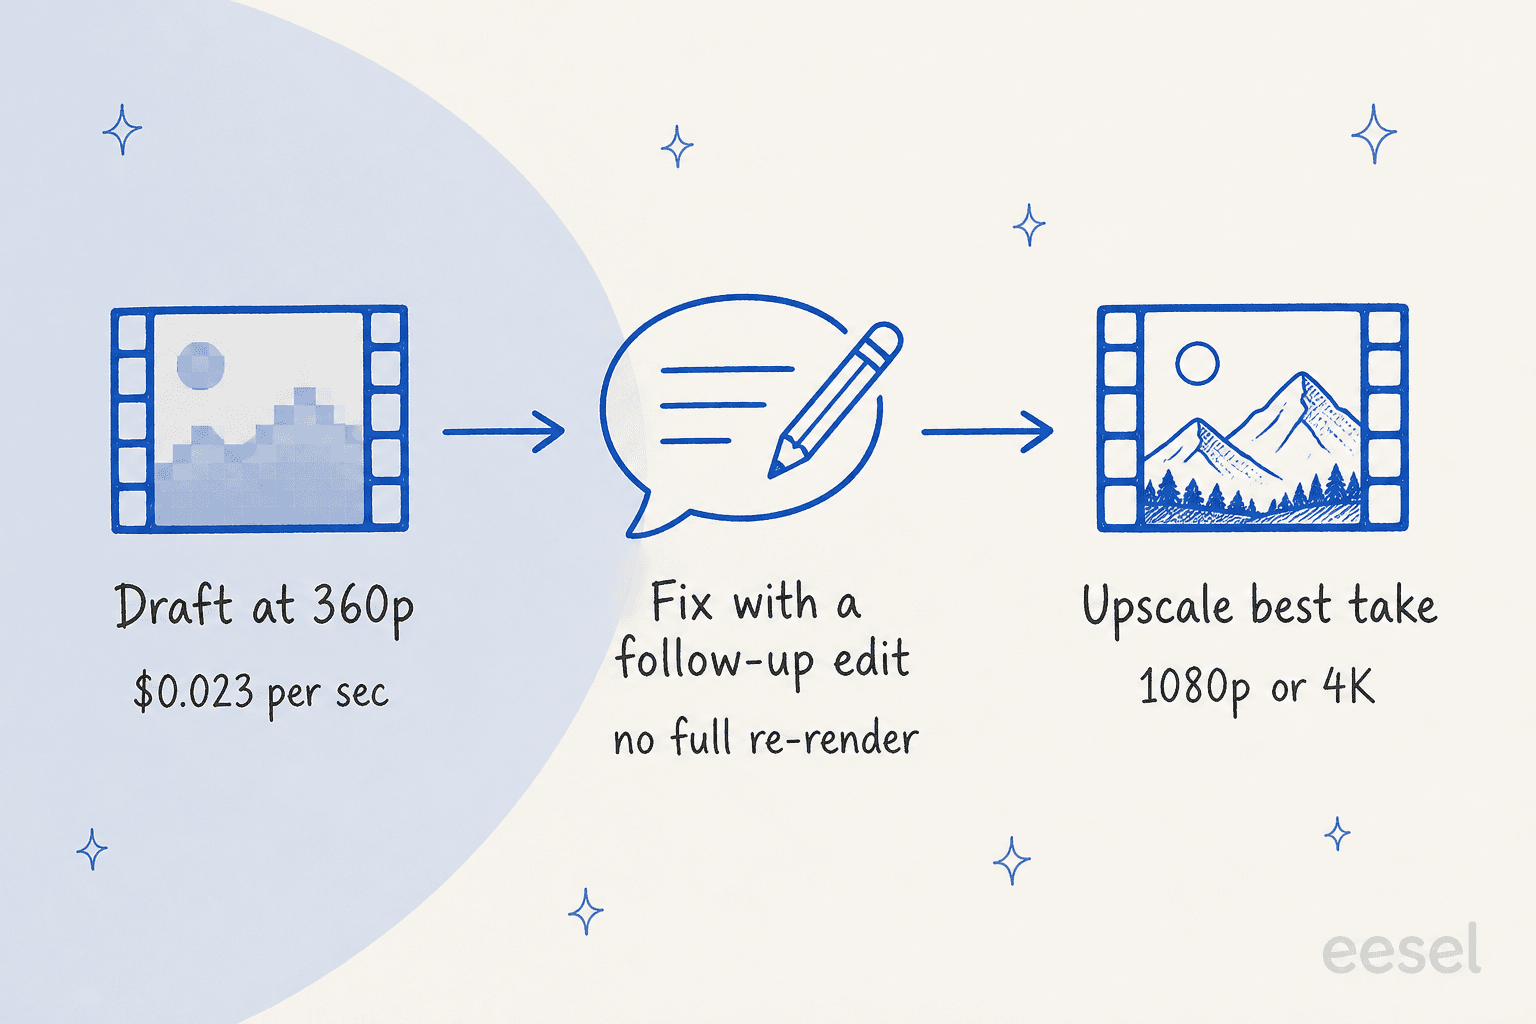
Dois detalhes sobre os quais a documentação fica em silêncio. Ela não diz se um rascunho é cobrado além do seu upscale posterior, então um fluxo de trabalho pesado em rascunhos deveria ser precificado primeiro com uma pequena rodada de teste. E como um comentarista do Hacker News observou sobre o 1.1, rascunhos e renderizações finais não são determinísticos, então um rascunho é uma prévia da direção, não uma garantia do quadro final.
Onde você pode usá-lo?
O Google lista uma ampla variedade de superfícies na ficha do modelo: o app Gemini, o app Gemini Enterprise, o Google AI Studio, YouTube, Flow, Google Cloud, a API Gemini e o Workspace. Detalhes que vale a pena saber:
- Google Vids: o post do Workspace Updates diz que o lançamento começou em 5 de novembro, com um controle deslizante de 3 a 15 segundos e sem controle de administrador. Cobre os planos Business, Enterprise e Education, além de contas pessoais com Google AI Pro ou Ultra.
- Google Cloud: disponível de forma geral pela API e pelo console, com Provisioned Throughput para cargas de trabalho em produção. A criação de vídeo no Gemini para empresas aparece como "em breve".
- Limites de contexto: 131.072 tokens de entrada e 65.536 tokens de saída, saída a 24 FPS, e de 360p até 4K.
O acesso não é igual entre os planos. No tópico de lançamento no Hacker News, um comentarista descreveu o atrito:
"There have been months where we've paid 1500€ for my AI models, but I can't bother with Google's models because I literally don't know how to get them."

E quanto à segurança e à procedência?
Toda saída carrega uma marca d'água SynthID imperceptível, e a página de produto do Google adiciona C2PA Content Credentials. A ficha do modelo diz que o modelo pode alterar a fala das pessoas durante a edição de vídeo, uma capacidade atualmente restrita. Ela também relata que, com base em avaliações do Gemini 3.1 Pro e do Gemini 3.7 Flash, é improvável que o modelo alcance qualquer nível de capacidade monitorado ou crítico.
Quem já está construindo sobre ele?
O post de lançamento do Google Cloud cita uma série de equipes de produtos de vídeo: a invideo diz que 15 segundos permitem que uma cena completa caiba em uma única geração, a QuickFrame AI diz que a saída de 15 segundos em 1080p permite que os usuários montem um anúncio completo de TV conectada em uma única passada, e a Picsart aponta o modo rascunho para iteração rápida de conceitos. Esses são parceiros de lançamento que o Google escolheu destacar, então leia-os como enquadramento, não como análises neutras. Ainda assim, o padrão é claro: anúncios, animação de produto e ferramentas criativas.
Se você está comparando modelos de vídeo, meu guia de preços do Sora 2 e a lista de alternativas ao Sora 2 cobrem o lado da OpenAI, e o post de alternativas ao Omni 1.1 cobre o campo mais amplo.
Onde o Gemini Omni 1.2 Flash se encaixa?
Eu sou o Rama, e eu ponho integrações e APIs em produção no eesel, então eu leio o lançamento de um modelo como um engenheiro: qual é o contrato, e o que eu ainda preciso construir? O Omni 1.2 te dá um bom contrato para vídeo: um ID de modelo, um preço por segundo, limites documentados. Você ainda constrói o aplicativo, a etapa de revisão e a conexão com suas próprias ferramentas.
Essa é a linha que eu vejo entre infraestrutura e um funcionário. Um modelo de vídeo é infraestrutura; o eesel é o funcionário. O eesel é uma plataforma de colegas de equipe com IA, e os clientes contratam colegas de equipe prontos para o trabalho para uma função definida. O time de hoje é um redator de blog com IA e um agente de helpdesk com IA, cada um chegando com as habilidades, integrações e contexto da empresa para sua função.
Prova com nome vale mais que adjetivos aqui. A SE Ranking, empresa de software de SEO, roda um agente eesel separado para cada um de seus três produtos no chat e nos tickets do Zendesk. Em um mês, de 8 de agosto a 8 de setembro de 2026, esses agentes trataram 4.650 conversas, 2.100 delas chats em tempo real respondidos primeiro pelo eesel. Nenhum modelo de vídeo faz esse trabalho, e nenhum agente de helpdesk renderiza um anúncio. Escolha a ferramenta para o trabalho que você realmente tem.
Uma nota prática para desenvolvedores: o eesel CLI permite que um agente de código como o Claude Code ou o Codex envie conhecimento aprovado, ajuste as instruções de um colega de equipe e faça perguntas de teste para checar as respostas antes de algo ir ao ar. Conectar um helpdesk em si ainda precisa de alguém com acesso de administrador para aprovar.
Se você está construindo o lado de conteúdo em torno do vídeo, a mesma lógica se aplica. Meus guias sobre o redator de blog com IA, a automação de blog com IA e o pipeline de conteúdo de blog com IA mostram como entregar esse trabalho. Para scripts que alimentam um modelo de vídeo, veja os geradores de roteiro de vídeo com IA e se a IA pode escrever roteiros de vídeo. Para a linha mais ampla do Google, leia alternativas ao Gemini, Gemini 3.8 Flash, Nano Banana 2, Nano Banana Pro, Gemini Lyria 3, e Gemini vs ChatGPT. Para a ideia de colega de equipe com IA, veja colegas de equipe com IA e funcionários de IA.
Experimente o eesel para o trabalho que um modelo de vídeo não pode fazer
Se a sua equipe faz vídeo com o Omni, alguém ainda precisa escrever os posts em torno dele e responder as perguntas que ele gera. O redator de blog com IA pesquisa e redige conteúdo a partir do seu próprio conhecimento, e o agente de helpdesk com IA entra na sua fila de suporte existente e trabalha a partir dos seus tickets passados e da sua central de ajuda. Você pode experimentar o eesel gratuitamente e simular um colega de equipe com dados históricos reais antes de ir ao ar.
Perguntas frequentes
O que é o Gemini Omni 1.2 Flash?
Quanto custa o Gemini Omni 1.2 Flash?
Quanto tempo pode durar um vídeo do Gemini Omni 1.2 Flash?
Qual é o ID do modelo Gemini Omni 1.2 Flash?
gemini-omni-1.2-flash. A partir de 3 de dezembro de 2026, as solicitações para gemini-omni-1.1-flash são roteadas para o 1.2 e cobradas nas tarifas do 1.2, segundo o changelog da API Gemini.