

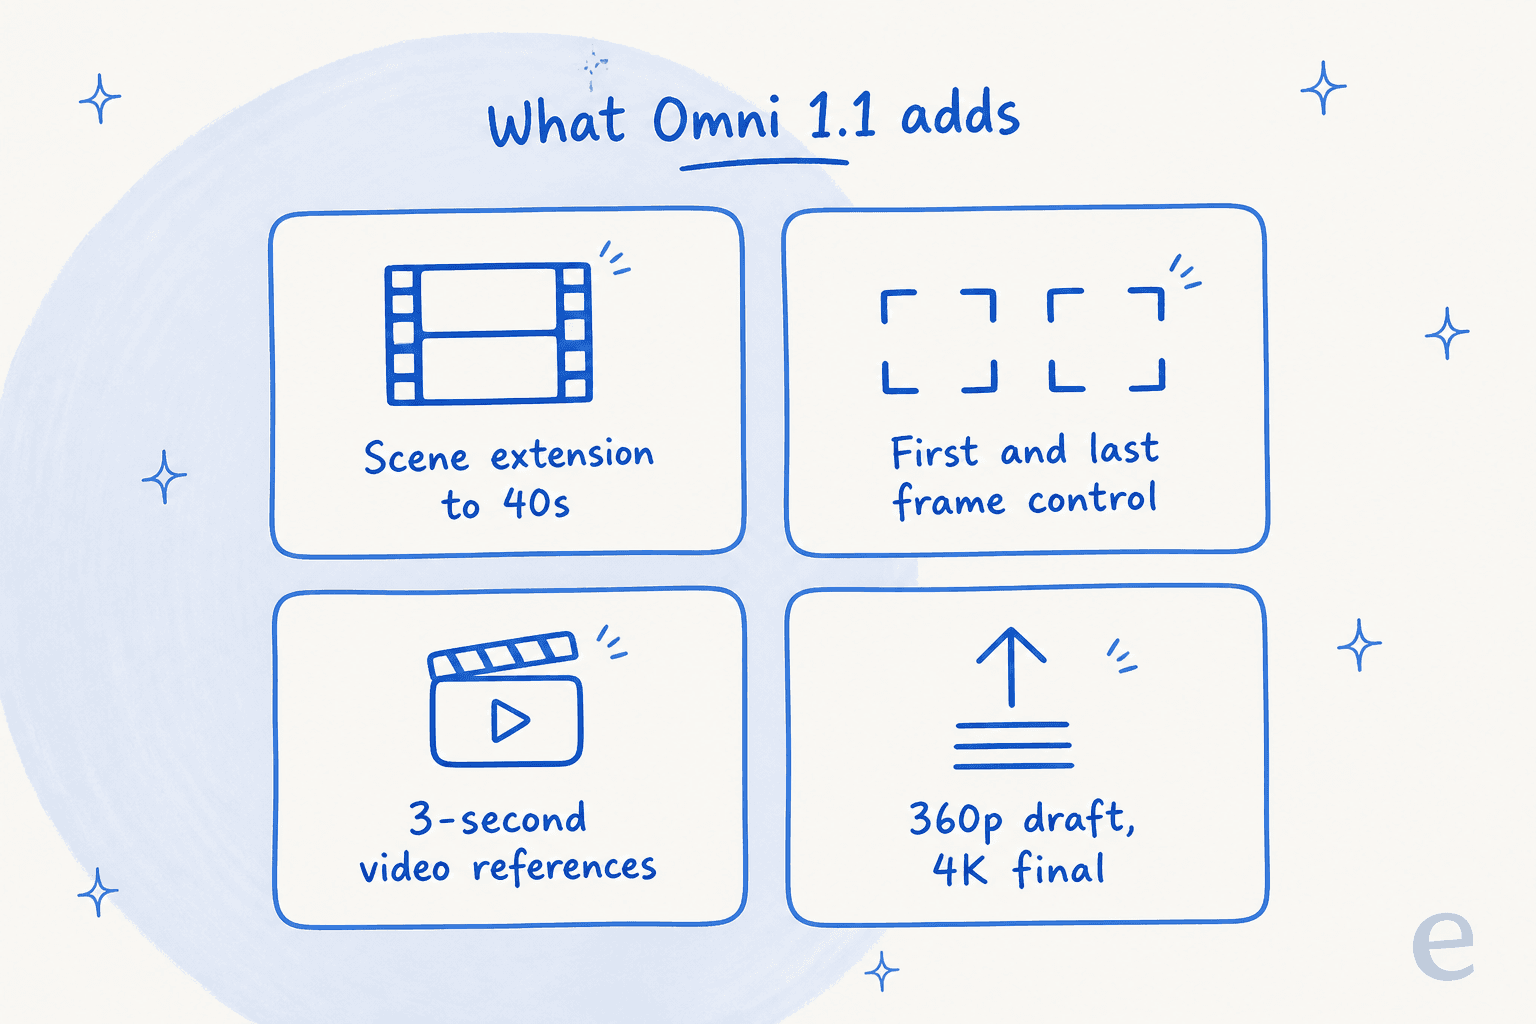
O Gemini Omni 1.1 Flash é a atualização de 27 de agosto de 2026 que o Google DeepMind fez no seu modelo de vídeo com IA. É a mesma ideia any-to-any do Gemini Omni Flash (texto, imagem e vídeo na entrada, vídeo em alta resolução na saída) com quatro novidades voltadas à produção: extensão de cenas que encadeia clipes de até 40 segundos, controle do primeiro e do último quadro, referências de vídeo para manter a consistência dos personagens e um fluxo de rascunho seguido de upscale.
No custo, ele continua no nível pago da API do Gemini sem nível gratuito: a saída de vídeo é cobrada a US$ 17,50 por 1 milhão de tokens, o que dá cerca de US$ 0,10 por segundo de vídeo em 720p, e os rascunhos em 360p saem por aproximadamente um terço disso. Entre os parceiros de lançamento estão Adobe Firefly, Figma Weave e Runway.
É uma ferramenta de vídeo capaz e uma das opções mais fortes da categoria. Também é infraestrutura de modelo bruta, não um profissional que faz um trabalho do início ao fim. Eu construo colegas de IA na eesel, e a verdade sem glamour é que um modelo de vídeo melhor não responde aos seus tickets de suporte nem publica o seu blog. Se esse é o trabalho de verdade, o que se encaixa melhor é um colega pronto para trabalhar como a eesel, não um modelo que você mesmo precisa integrar.
O que o Gemini Omni 1.1 Flash realmente é
O Gemini Omni é a família de modelos de mídia generativa "any-to-any" do Google, e o Omni Flash é o integrante rápido e focado em vídeo. A própria página de produto do Google resume sem rodeios: pense no Gemini Omni como o Nano Banana, mas para vídeo, em que cada edição se apoia na anterior para manter a cena coerente. Você dá um prompt, uma imagem ou um clipe existente e ele devolve vídeo em alta resolução com áudio, que você refina conversando em vez de renderizar tudo do zero a cada vez.
A versão 1.1, anunciada pelos gerentes de produto do Google DeepMind Anish Nangia e Alisa Fortin, é apresentada como "a production-ready update for developers that offers improved control over generative video". A palavra-chave é controle, o tema de toda a atualização. O primeiro Omni Flash provou que o modelo sabia gerar e editar; a 1.1 dá aos desenvolvedores as alavancas para dirigi-lo com precisão. O ID de modelo exposto na API é gemini-omni-1.1-flash.
O que há de novo na 1.1
Se você já conhece o Gemini Omni Flash original, aqui vai a versão curta do que mudou. Quatro recursos chegaram juntos, e cada um atende a uma lacuna específica que impedia o uso do primeiro modelo em pipelines de produção reais.
Extensão de cenas de até 40 segundos
O modelo original limitava cada clipe a 10 segundos, um teto rígido para quem tenta contar qualquer tipo de história. A extensão de cenas permite pegar um vídeo existente e continuar gerando imagens de onde ele parou, em incrementos de 10 segundos, até um total acumulado de 40 segundos. O Google diz que as extensões vêm com melhor consistência visual e fluxo narrativo, de modo que um plano pode continuar ou seguir para outra direção sem uma emenda óbvia.
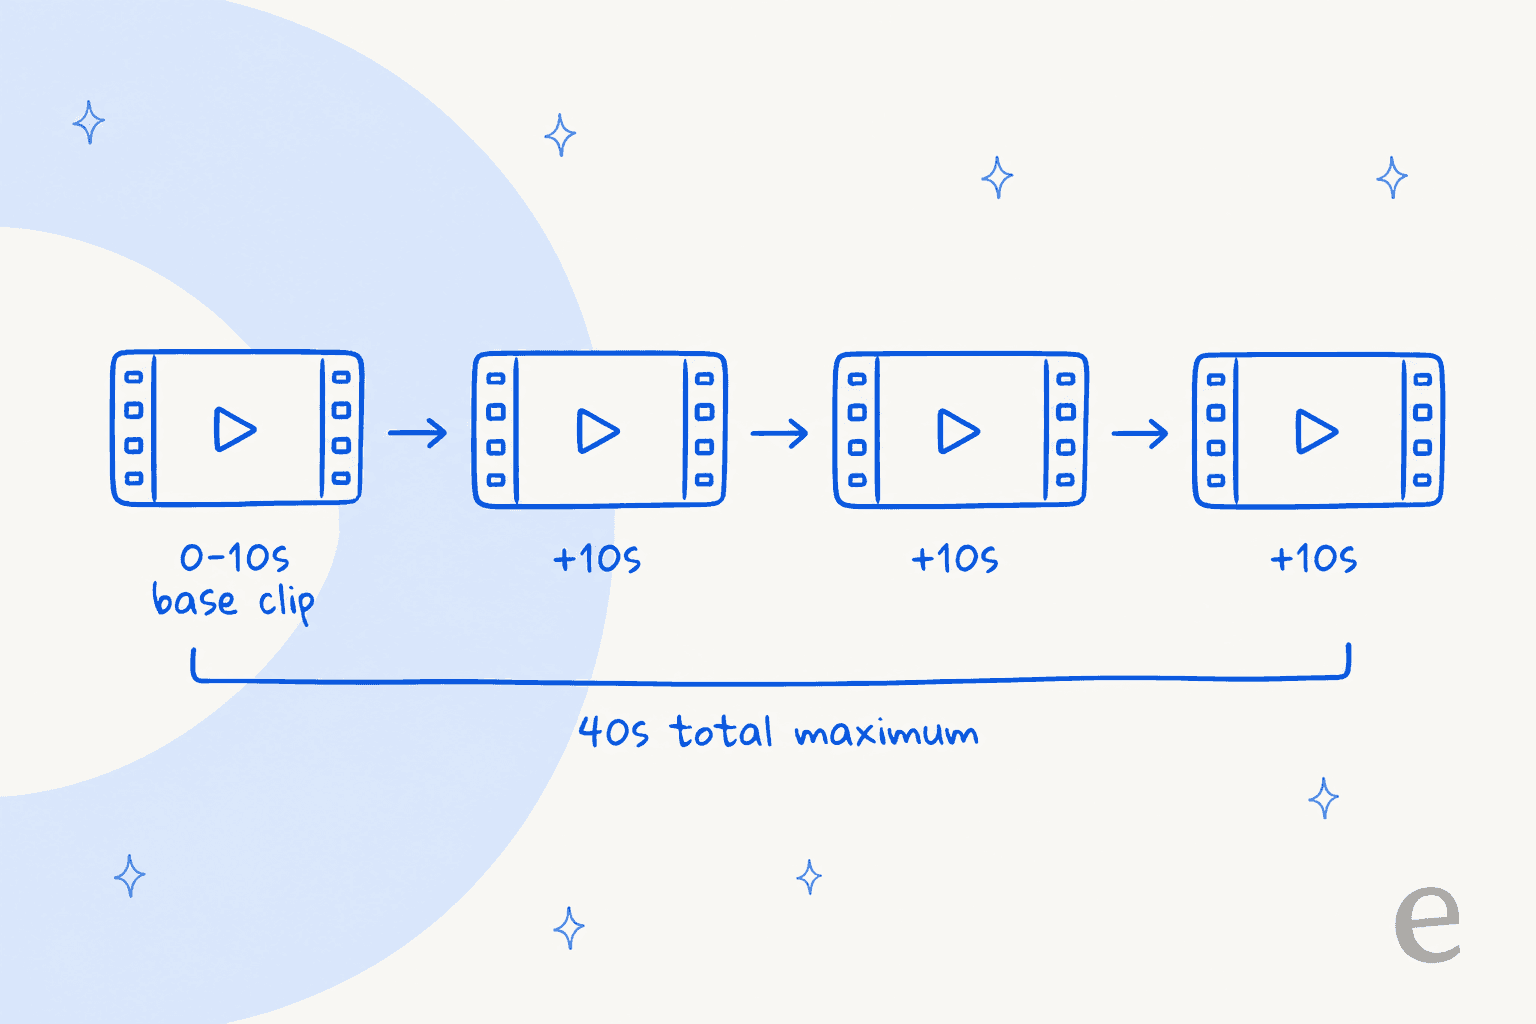
Por baixo, usa o mesmo padrão com estado da edição conversacional do modelo: você encadeia uma nova requisição a um previous_interaction_id com uma entrada como "Continue the scene", e o modelo mantém o contexto da sessão em vez de obrigar você a reenviar o material.
Controle do primeiro e do último quadro
Este é o recurso que as equipes criativas vão notar primeiro. Agora você pode especificar os quadros inicial e final de um plano, e o Omni 1.1 gera o vídeo contínuo entre esses dois quadros-chave. O Google o posiciona como ideal para órbitas de câmera complexas, transições com zoom ou clipes em loop sem emendas. Na prática, transforma "gerar um vídeo e torcer para a câmera fazer algo sensato" em "definir onde o plano começa e termina e deixar o modelo preencher o movimento no meio", uma forma muito mais dirigível de trabalhar.
Referências de vídeo para manter a consistência
A deriva de personagem e de estilo sempre foi a fraqueza silenciosa do vídeo com IA. O Omni 1.1 permite referenciar até três segundos de vídeo ao criar uma nova cena, para que o modelo preserve o contexto visual e mantenha um personagem consistente entre os planos. A demo do Google trocou personagens fornecidos em clipes de referência de dança enviados, mantendo um único plano contínuo, sem cortes de cena, exatamente o tipo de continuidade que antes exigia muita limpeza manual.
Rascunho seguido de upscale
A última adição é a mais prática para quem acompanha o orçamento. Você pode gerar prévias leves em 360p, que o Google descreve como até 60% mais rápidas e com um terço do custo da resolução padrão de 720p, e depois fazer o upscale da saída final para 1080p ou 4K. A ideia é iterar barato e rápido no corte bruto e gastar o processamento de verdade só na versão que você vai manter.
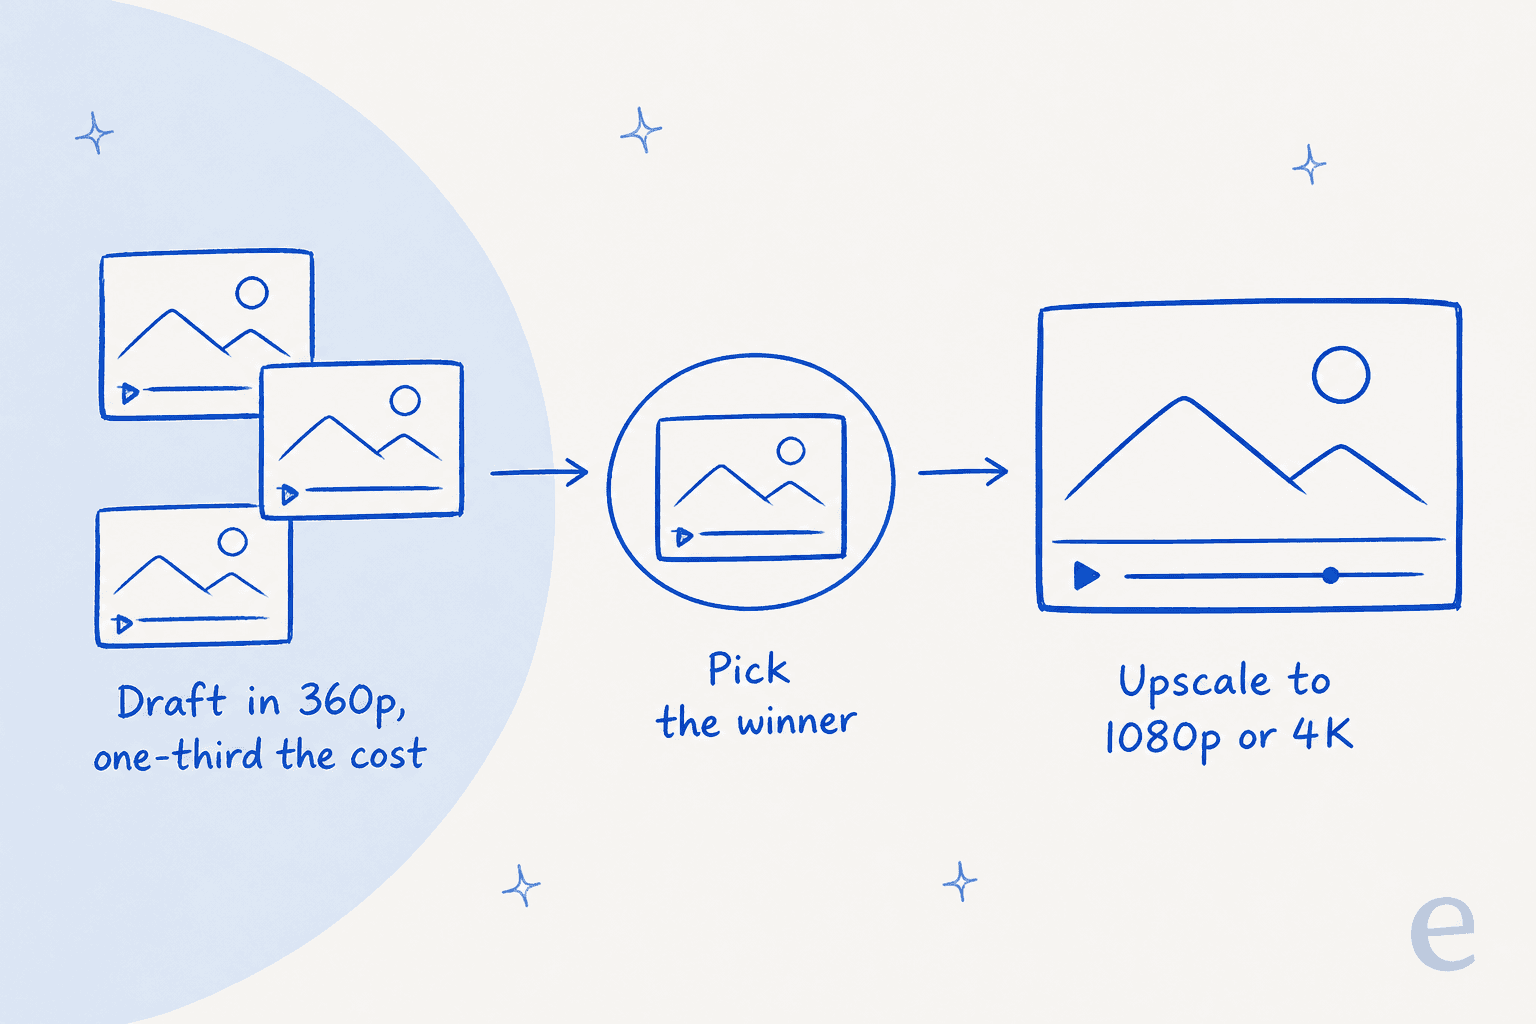
O Google mostrou três apps de exemplo criados com esses controles: um Transition Studio de primeiro e último quadro, um Listing Walk-In imobiliário para movimentos de câmera e um Draft Room que gera três ou quatro variações em 360p para comparar lado a lado. Eles dão uma boa pista de onde o modelo se destaca: em ferramentas de produção, não em clipes avulsos.
Onde você pode usar
O Omni 1.1 foi lançado em várias plataformas já no primeiro dia, o que mostra que o Google quer que ele seja tratado como infraestrutura de produção e não como demo:
- Google AI Studio, para testá-lo diretamente na API do Gemini.
- A Gemini Enterprise Agent Platform, para empresas que desenvolvem sobre a API da Agent Platform.
- Google Flow, disponível globalmente para todos os assinantes do Google AI Plus, Pro e Ultra.
- O app Gemini, onde a extensão de cenas, especificamente, já está ativa para os mesmos níveis de assinatura.
Nas especificações técnicas, a documentação do Google Cloud lista um contexto de entrada de 131.072 tokens e saída de 57.920 tokens, um máximo de 10 segundos por requisição de geração (que a extensão de cenas depois encadeia), até três vídeos por prompt, proporções 16:9 e 9:16 e resoluções de 360p a 4K. O vídeo gerado traz C2PA Content Credentials para indicar a procedência.
Preços do Gemini Omni 1.1 Flash
O modelo de cobrança não mudou desde o lançamento original, e a manchete continua a que importa: não há nível gratuito. Cada segundo gerado custa dinheiro desde o primeiro clipe. Aqui estão os preços atuais do nível pago da API do Gemini:
| Item | Nível gratuito | Nível pago (por 1M de tokens) |
|---|---|---|
| Entrada (texto / imagem / vídeo / áudio) | Não disponível | US$ 1,50 |
| Saída de texto | Não disponível | US$ 9,00 |
| Saída de vídeo | Não disponível | US$ 17,50 |
| Dados usados para melhorar os produtos do Google | n/d | Não |
O custo está no vídeo. O Google cobra a saída de vídeo a uma taxa fixa de 5.792 tokens por segundo de vídeo em 720p, o que, a US$ 17,50 por 1 milhão de tokens, dá uma tarifa efetiva de cerca de US$ 0,10 por segundo. Um guia aproximado, só saída de vídeo:
- ~US$ 0,50 por um clipe de 5 segundos em 720p
- ~US$ 1,00 por um clipe completo de 10 segundos em 720p
- ~US$ 0,03 por segundo para um rascunho em 360p (cerca de um terço da tarifa de 720p, segundo o número do próprio Google)
Essa última linha é a verdadeira história dos preços da 1.1. O nível de rascunho em 360p permite prototipar uma sequência de 40 segundos por centavos e pagar a tarifa cheia só pela versão que você sobe para 4K. É uma estrutura sensata, que recompensa as equipes que iteram antes de se comprometer. O Google publica as tarifas completas por resolução em uma tabela de preços no post de lançamento; a página da API, legível por máquina, ancora a cobrança na taxa de tokens de 720p acima. Para as contas mais detalhadas e exemplos práticos, fizemos o detalhamento no guia de preços do Gemini Omni Flash.
Vale notar que não há nível Batch, Flex ou Priority para este modelo, ao contrário do Gemini 3.5 Flash, então não há desconto em lote documentado com o qual contar. Se quiser o contexto completo de como o Google precifica seus modelos, nosso guia de preços do Gemini cobre os planos de consumo e de API lado a lado.
O que desenvolvedores e parceiros estão dizendo
Quando a família Omni foi aberta aos desenvolvedores pela primeira vez, o líder de IA do próprio Google, Logan Kilpatrick, resumiu a proposta:
"Omni Flash is SOTA at video editing at $0.10 / sec, same as Veo 3.1 Fast!"
A leitura mais útil veio da conta independente de notícias de IA Rohan Paul, que enquadrou o formato real do produto como encadear modelos, e não um modelo isolado:
"Chaining both models is the real product shape, not either model alone. Nano Banana 2 Lite makes reference images, then Gemini Omni Flash animates them."
Para a 1.1 em particular, o Google se apoiou em parceiros de lançamento que rodam o modelo em produção. O diretor criativo da Figma Weave, Itay Schiff, apontou a direção para a qual os novos controles caminham:
"With extensions, richer reference material, and 4K resolution, Gemini Omni Flash takes teams beyond generating videos to truly directing them."
São citações de parceiros que o Google escolheu destacar, então leia como enquadramento de lançamento e não como análises neutras. A leitura independente está no tópico de lançamento do Hacker News (296 pontos, 233 comentários), e é mais mista. O desenvolvedor cube00 contestou a ideia principal do rascunho em 360p:
"While it sounds great you're quickly disappointed after you run the same prompt at standard resolution only to get a different result because it's non deterministic."

É uma observação justa: um rascunho só serve como prévia se a renderização final realmente corresponder a ele, e a geração não é determinística. No lado estratégico, Simon Willison interpretou o lançamento como um sinal de onde o Google está apostando:
"Interesting that OpenAI abandoned Sora entirely but Google are continuing to invest heavily in their own video generation. Maybe because they see video generation as key to developing 'world models'?"
A conclusão equilibrada do tópico: o nível de rascunho em 360p é uma alavanca de custo inteligente, a extensão de cenas ainda mostra alguma deriva em clipes mais longos, e o valor de ponta a ponta do Google (modelo mais Flow) é o que as pessoas valorizam mais do que concorrentes mais chamativos de geração única.
Onde o Gemini Omni 1.1 Flash se encaixa, e onde não
Aqui vai a versão honesta, de alguém que constrói produtos de IA em vez de vender este. O Omni 1.1 é excelente naquilo para que serve: gerar e editar vídeo com controle de direção de verdade, dentro de um pipeline que você mesmo monta. Se você está lançando uma ferramenta criativa, um recurso de vídeo de marketing ou qualquer coisa em que o vídeo é o produto, é uma das opções mais fortes disponíveis, e o preço de rascunho seguido de upscale torna acessível iterar.
O que ele não é, é um trabalhador que faz um serviço. É um modelo, ou seja, infraestrutura. Você ainda precisa construir o app em volta dele, decidir quando chamá-lo, tratar as saídas e ligá-lo ao que você realmente quer entregar. Essa é a troca certa se você é um desenvolvedor criando recursos de vídeo. É a lente errada se o que você precisa é de uma tarefa resolvida de ponta a ponta.
Eu passo os dias do outro lado dessa linha. Na eesel, não vendemos um modelo, vendemos colegas de IA que você contrata para uma função definida. Cada um chega com as habilidades, integrações e contexto da empresa para o seu papel, então não há pipeline para montar. O time atual tem um agente de helpdesk com IA que entra na sua fila de suporte existente e um redator de blog com IA que pesquisa e redige conteúdo. Um novo modelo de vídeo, por melhor que seja o reel de demonstração, não responde a um ticket de suporte nem publica um post. Outro trabalho, outra ferramenta.
Se você está comparando o catálogo mais amplo do Google enquanto está aqui, nosso panorama de alternativas ao Gemini, a visão geral do Google Gemini 3 e o detalhamento dos preços do Gemini 3 cobrem os modelos feitos para texto e raciocínio. No lado de imagem da mesma família, Nano Banana Pro e a análise do Nano Banana 2 são as leituras indicadas, e Gemini vs Perplexity cobre o ângulo da busca com IA.
Experimente a eesel para os trabalhos que um modelo de vídeo não faz
Se você chegou aqui avaliando onde a IA realmente economiza tempo da sua equipe, e a resposta honesta é "não em vídeo", essa é a conclusão útil. A eesel coloca colegas de IA prontos para trabalhar no seu trabalho real: o agente de helpdesk com IA aprende com seus tickets anteriores e sua central de ajuda e resolve as dúvidas de primeira linha dentro das ferramentas que você já usa, e o redator de blog com IA transforma o seu próprio conhecimento em conteúdo publicado e alinhado à marca.
A diferença para um modelo bruto como o Omni 1.1 é que não há nada para construir. Você conecta suas fontes, simula o colega com dados históricos reais antes de ele entrar em operação e o liga. Você pode testar de graça e vê-lo funcionando com o seu próprio conteúdo em poucos minutos.