

O Gemini Omni 1.1 Flash é o modelo de geração de vídeo do Google, lançado em prévia em 27 de agosto de 2026. Ele é cobrado por token em três medidores separados: $1,50 por 1 M de tokens de entrada, $9,00 por 1 M de tokens de saída de texto e $17,50 por 1 M de tokens de saída de vídeo. O Google arredonda o valor do vídeo para cerca de $0,10 por segundo em 720p.
O número que você realmente precisa saber: um clipe de 10 segundos em 720p custa cerca de $1,01 só de saída de vídeo, e a resolução é a sua maior alavanca, já que o 4K custa por segundo cerca de 9 vezes um rascunho em 360p.
Duas coisas surpreendem. Não há plano gratuito, então você paga desde o primeiro token, e não há desconto para lotes, que os modelos Flash somente de texto ainda têm. Os preços são idênticos na API Gemini e no Vertex. Se você só precisa de rascunhos curtos, gere em 360p e amplie os que valem a pena.
O que o Gemini Omni 1.1 Flash realmente é
Eu trabalho com APIs de modelos profissionalmente, então, com qualquer modelo "Flash" novo, a primeira coisa que faço é ignorar o post de lançamento e ler a tabela de preços, porque é ali que está o design real do produto. No caso do Gemini Omni 1.1 Flash, a tabela conta quase tudo: não é um modelo de chat mais barato, é um modelo de vídeo do Google DeepMind que por acaso também entende texto.
O Google o descreve como um modelo multimodal "optimized for video generation, offering video output alongside text responses in a single model." O ID do modelo é gemini-omni-1.1-flash-preview, ele está em fase de prévia (não em disponibilidade geral) e chegou em 27 de agosto de 2026 como a atualização 1.1 do Gemini Omni Flash original. Se você acompanha os outros modelos criativos do Google, pense nele como o irmão em movimento do Nano Banana para imagens e do Lyria para música.
A versão 1.1 é principalmente sobre controle. Agora você tem extensão de cena (alongar um clipe em passos de 10 segundos até um total de 40), controle do primeiro e do último quadro, uma referência de vídeo de 3 segundos para manter os personagens consistentes, ampliação para 4K e um modo rascunho em 360p que, segundo o Google, é até 60% mais rápido e custa cerca de um terço do 720p. Entre os parceiros de lançamento que constroem sobre ele estão Adobe, Figma e Runway.
Uma peculiaridade do nome que vale avisar logo: "Omni" sugere todas as modalidades, mas aqui o modelo aceita texto, imagem e vídeo como entrada e devolve texto e vídeo como saída. Ele gera som (fala, música, efeitos) como parte do vídeo, mas não é um gerador independente de áudio ou de imagens. Para entender onde ele se encaixa na família, nossa visão geral do Gemini percorre toda a linha.
Preços do Gemini Omni 1.1 Flash num relance
Aqui está a tabela completa, direto das páginas do próprio Google. Não há diferença entre preço de tabela e preço real para destrinchar: as tarifas por token são o preço.
| Medidor | Preço por 1 M de tokens | O que cobre |
|---|---|---|
| Entrada | $1,50 | Texto, imagem, áudio ou vídeo enviados |
| Saída de texto | $9,00 | Respostas em texto e tokens de raciocínio |
| Saída de vídeo | $17,50 | Vídeo gerado (com áudio) |
Tanto a página de preços da API Gemini quanto a página de preços do Gemini Enterprise listam esses valores, e eles coincidem. A página da API Gemini acrescenta a versão mais legível: a saída de vídeo custa "approximately $0.10 per second" em 720p, e o plano gratuito é "Not available."
O problema de um modelo de vídeo cobrado por token é que "por 1 M de tokens" esconde a rapidez com que os tokens se acumulam quando a saída são imagens em movimento. É o assunto da próxima seção.
Os três medidores, e por que a saída de vídeo é a que pesa
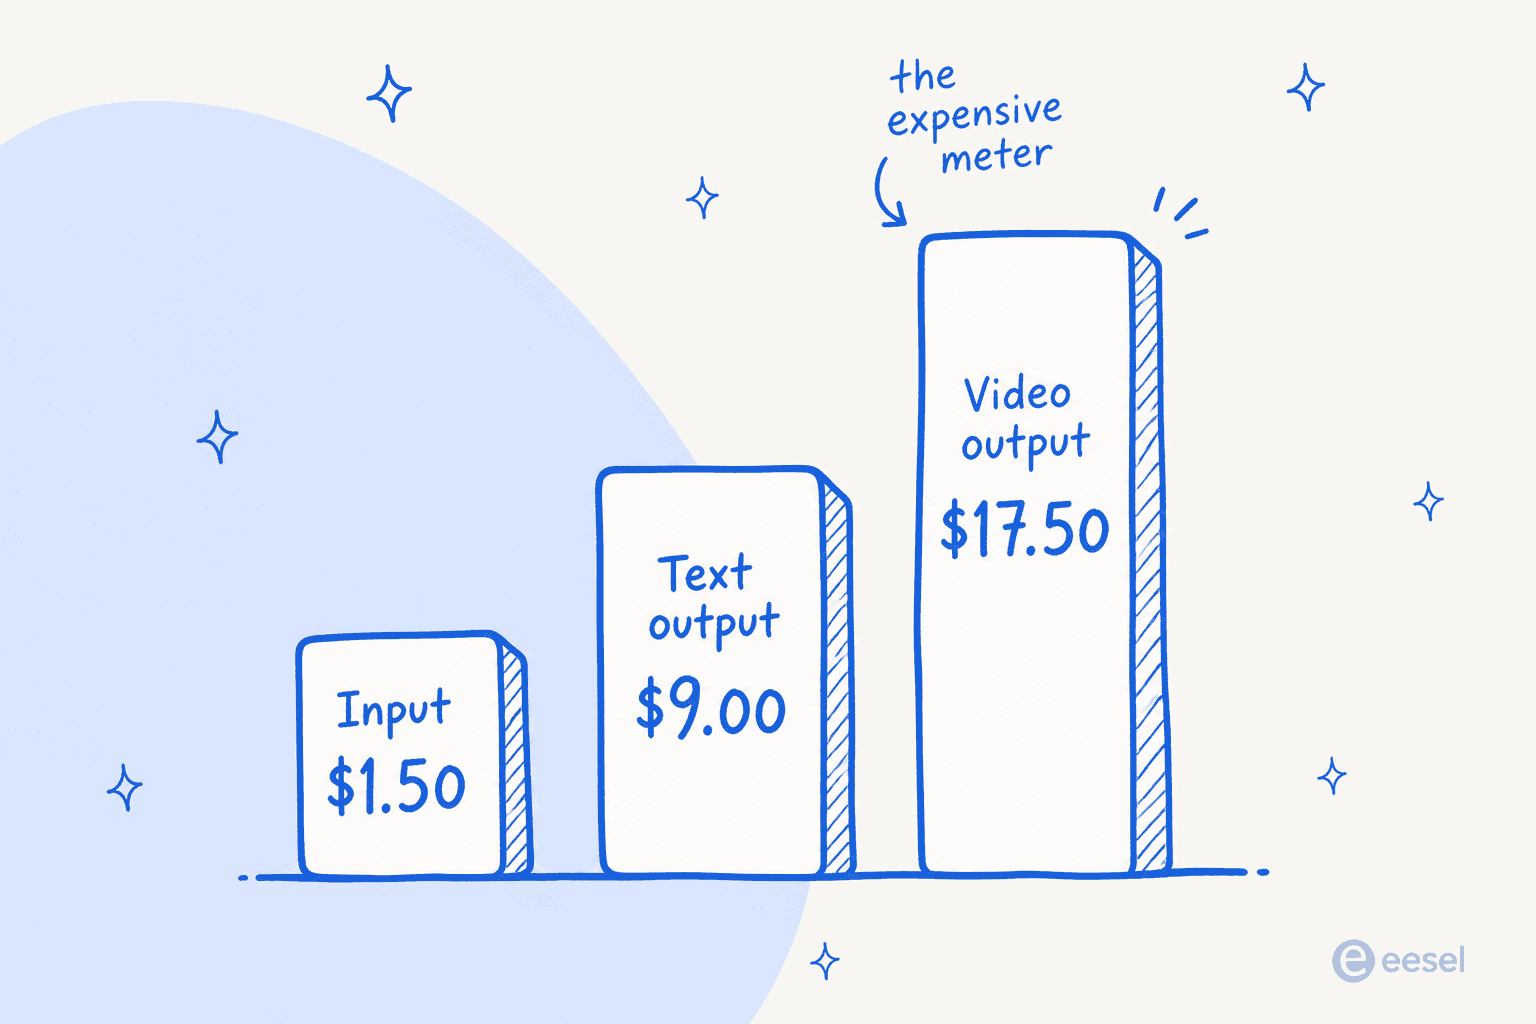
O que você precisa internalizar é que a saída de vídeo custa quase 12 vezes o que custa a entrada, por token. Num modelo de chat comum, entrada e saída ficam a um múltiplo pequeno uma da outra, então você pensa em "custo por chamada" de forma aproximada. Aqui, a mesma chamada pode cobrar três tarifas ao mesmo tempo: os tokens do seu prompt a $1,50, qualquer texto que o modelo devolva a $9,00 e cada quadro do vídeo gerado a $17,50.
Na prática, o medidor de saída de vídeo domina tanto que os outros dois são erros de arredondamento. Um prompt longo pode somar alguns décimos de centavo; alguns segundos em 4K somam dólares. Então, ao orçar este modelo, oriente o orçamento pelos segundos de vídeo e trate o resto como ruído.
Veja como o Google converte cada modalidade de entrada em tokens, que é a base real da cobrança:
| Modalidade de entrada | Taxa de tokens | Custo a $1,50 / 1 M |
|---|---|---|
| Texto | contagem padrão de tokens | $1,50 / 1 M de tokens |
| Imagem | 1.120 tokens por imagem | ~$0,0017 por imagem |
| Áudio | 32 tokens por segundo de áudio | ~$0,00005 por segundo |
| Vídeo | 5.792 tokens por segundo de vídeo | ~$0,0087 por segundo de vídeo |
Esses custos de entrada são minúsculos. Enviar uma imagem de referência custa uma fração de centavo. O dinheiro vai todo na saída.
Quanto um vídeo realmente custa
A saída de vídeo é medida por segundo, e a tarifa por segundo depende da resolução. O Google publica diretamente as taxas de tokens, então isto é aritmética, não estimativa: multiplique os tokens por segundo pela tarifa de saída de $17,50.
| Resolução | Tokens por segundo | Custo por segundo de saída |
|---|---|---|
| 360p (rascunho) | 1.931 | ~$0,034 |
| 720p | 5.792 | ~$0,101 |
| 1080p | 8.688 | ~$0,152 |
| 4K | 17.376 | ~$0,304 |
Alguns números de exemplo para concretizar. Um clipe de 10 segundos em 720p com áudio são 57.920 tokens de saída, ou seja, cerca de $1,01. Os mesmos 10 segundos em modo rascunho 360p custam cerca de $0,34. Em 4K, ficam em aproximadamente $3,04 pelos mesmos 10 segundos. Estender um clipe até o limite de 40 segundos em 720p dá cerca de $4,05 de saída de vídeo.
Coloque seus próprios números abaixo para ver onde um projeto vai parar antes de rodá-lo.
O padrão que a calculadora deixa óbvio: sua conta mensal cresce de forma linear com clipes e segundos, mas a resolução multiplica o total. Duzentos rascunhos curtos em 720p por mês saem por cerca de $200; o mesmo volume em 4K chega perto de $600.
A resolução é a alavanca de custo, então use o modo rascunho
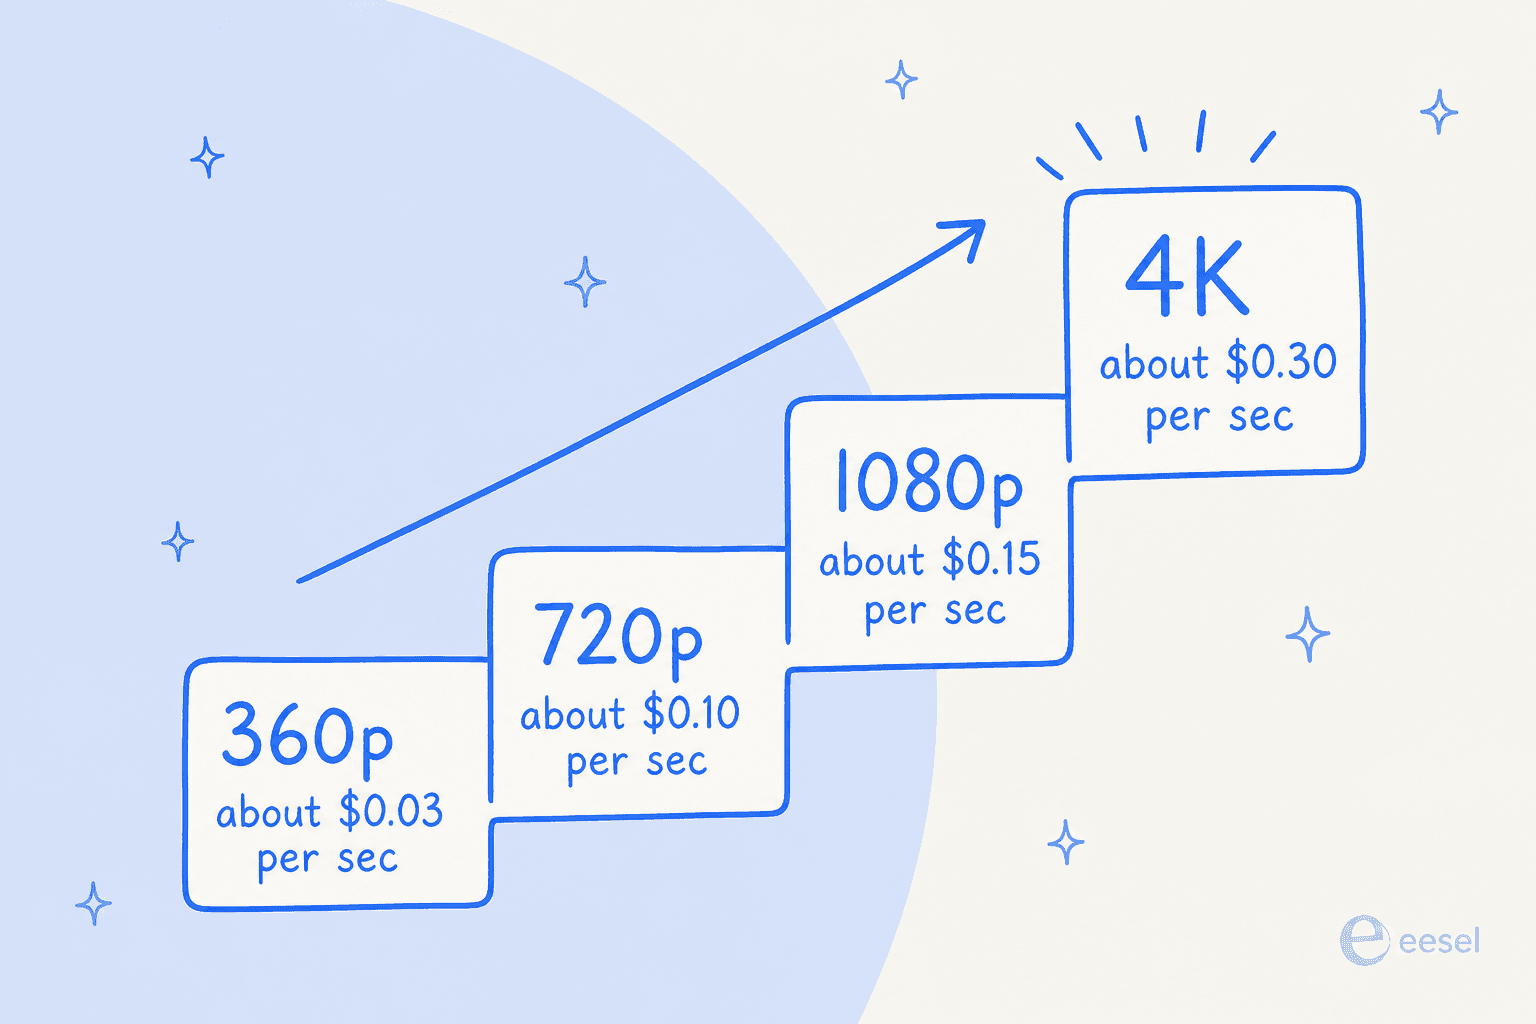
É por isso que o Google lançou o modo rascunho em 360p, e por isso eu construiria todo o meu fluxo de trabalho em torno dele. O custo por segundo sobe cerca de 9 vezes de 360p para 4K, mas as decisões criativas (composição, movimento, se a cena funciona ou não) não precisam de 4K para serem avaliadas. Gere um lote de rascunhos baratos em 360p, escolha o que funciona e depois renderize de novo ou amplie só esse para 1080p ou 4K.
Fazer ao contrário (gerar tudo em resolução máxima e descartar quase tudo) é como a conta de geração de vídeo triplica sem ninguém perceber. É a mesma armadilha que o preço do Nano Banana Pro tem para geração de imagens, só que com uma dimensão extra de tempo multiplicando cada erro.
O que está faltando
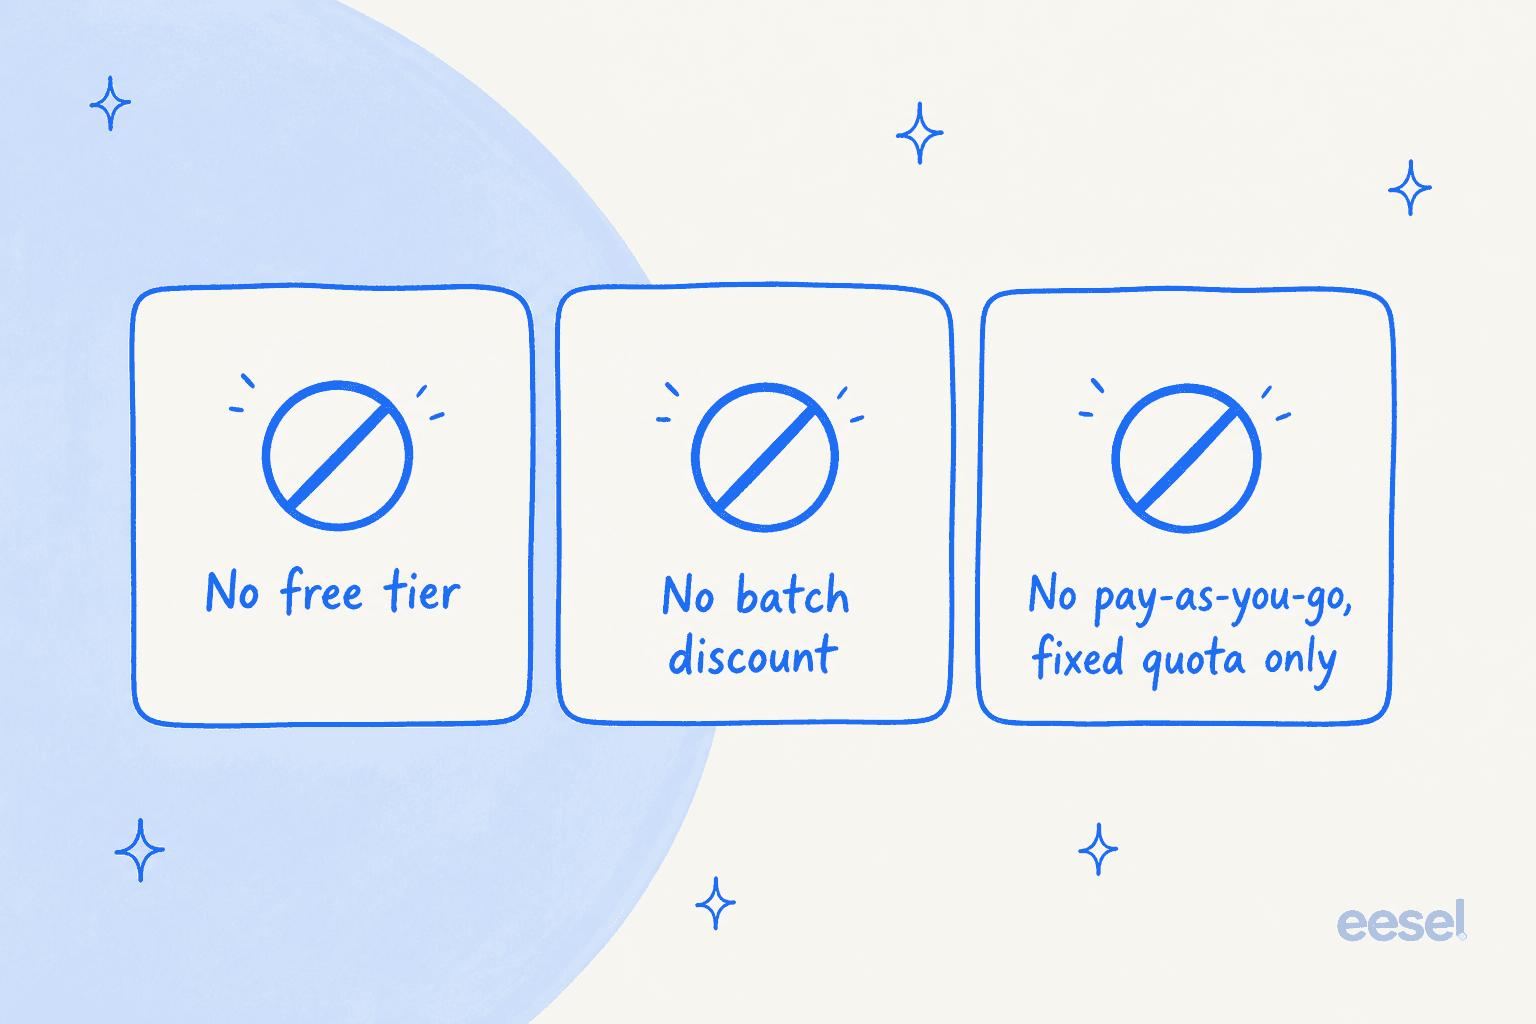
Se você vem dos modelos Gemini Flash somente de texto, três suposições que você traz estão erradas aqui.
- Sem plano gratuito. Os modelos Flash de texto dão uma cota gratuita de API para prototipar. O Omni 1.1 Flash não dá, segundo a página de preços da API Gemini. Você paga desde o primeiro token, então planeje também os testes, não só a produção.
- Sem desconto para lotes. O desconto de 50% para lotes do Google é uma das melhores ofertas da linha Gemini, e não se aplica aqui, porque o modelo não oferece suporte a inferência em lote. Cada segundo custa o preço cheio.
- Sem pagamento por uso nem throughput provisionado. O acesso é apenas por cota fixa, na região global. Para a maioria das equipes isso é aceitável, mas significa que você não pode comprar capacidade dedicada como em cargas de texto de alto volume.
Nenhum desses pontos é impeditivo. São só o tipo de detalhe que transforma um "parece barato" da primeira impressão numa surpresa na primeira fatura, e é por isso que vale gastar dez minutos lendo a especificação antes de se comprometer.
API Gemini vs. Vertex: o preço é o mesmo
Uma pergunta que aparece com todo modelo do Google: sai mais barato pela API Gemini (Google AI Studio) ou pela Gemini Enterprise Agent Platform, da linha Vertex? Para o Omni 1.1 Flash, os preços por token são idênticos: $1,50 de entrada, $9,00 de saída de texto e $17,50 de saída de vídeo nas duas plataformas.
Então a escolha depende de tudo, menos do preço. A API Gemini é a forma mais rápida de começar e o lar natural de um projeto solo ou de um protótipo. A Enterprise Agent Platform é para quem precisa de controles em nível de organização, IAM e o restante da governança do Google Cloud. O modelo também aparece no Google Flow para assinantes do AI Plus, Pro e Ultra, e a extensão de cena aparece no próprio app Gemini. Escolha a plataforma que combina com o jeito como sua equipe já trabalha, não a que você acha que sairá mais barata, porque custam o mesmo.
Como se compara a outros modelos Gemini Flash
A palavra "Flash" treinou todo mundo a esperar algo barato, e é aí que o Omni 1.1 Flash pode enganar. Em texto, ele tem preço de modelo Flash de nível intermediário. O medidor de vídeo é a parte que não tem equivalente na linha de texto.
| Modelo | Entrada / 1 M | Saída / 1 M | Plano gratuito | Lote |
|---|---|---|---|---|
| Gemini Omni 1.1 Flash | $1,50 | $9,00 texto / $17,50 vídeo | Não | Não |
| Gemini 3.5 Flash (texto) | $1,50 | $9,00 | Sim | Sim |
| Gemini 3.7 Flash (texto) | $0,75* | $3,75* | Sim | Sim |
| Gemini 2.5 Flash (texto) | $0,30 | $2,50 | Sim | Sim |
*O Gemini 3.7 Flash está com preço promocional que sobe para $1,50 / $7,50 depois de 31 de dezembro de 2026, segundo a página de preços da API Gemini.
A conclusão: os tokens de texto do Omni 1.1 Flash custam exatamente o mesmo que os do Gemini 3.5 Flash, então você não paga um ágio para conversar com ele. Você paga pelo medidor de vídeo, que é um produto genuinamente diferente do que os modelos Flash de texto fazem. Compará-lo em preço com o 2.5 Flash não faz sentido; eles não fazem o mesmo trabalho.
O Gemini Omni 1.1 Flash vale a pena?
Se você precisa de geração de vídeo programática com controle fino (extensão de cena, controle de quadros-chave, consistência de personagens) e se sente à vontade gerenciando custos por segundo, ele tem preço justo pelo que faz, e o fluxo de rascunhos em 360p o mantém acessível na fase de iterar e descartar, onde de outra forma iria a maior parte do gasto.
Onde eu pisaria no freio: se você está só experimentando, a falta de plano gratuito faz cada teste custar dinheiro de verdade, e se o seu caso é renderização em lote de alto volume, a ausência de desconto para lotes dói. Nesses casos, faça storyboards com cuidado e prototipe em 360p antes de tocar numa resolução maior.
O resumo honesto é que o Omni 1.1 Flash é um bom negócio para trabalho de vídeo controlado e iterativo e uma má escolha para gerar no escuro. Saiba qual dos dois você vai fazer antes de integrá-lo.
Escrevendo o conteúdo em torno da sua stack de IA
Um modelo como o Gemini Omni 1.1 Flash é infraestrutura: uma capacidade bruta que você integra a um produto. Ele não conhece sua marca, sua documentação nem o que você quer publicar. É essa lacuna que a eesel preenche. Em vez de uma API de modelo, a eesel oferece um colega de equipe de IA pronto para trabalhar, e um dos atuais é um redator de blog com IA que já conhece o contexto da sua empresa e transforma um tema em um rascunho pesquisado e no tom da marca, da mesma forma que nosso colega de IA de helpdesk cuida dos tickets de suporte.
Então, se você está lançando demos em vídeo com o Omni 1.1 Flash e precisa do post de lançamento, da página de documentação e do conteúdo comparativo que acompanha, esse é o colega que você deve contratar. É grátis para testar e se conecta às ferramentas onde seu conteúdo já vive.
Perguntas frequentes
Quanto custa o Gemini Omni 1.1 Flash?
O Gemini Omni 1.1 Flash é cobrado por token: $1,50 por 1 M de tokens de entrada (texto, imagem, áudio ou vídeo), $9,00 por 1 M de tokens de saída de texto e $17,50 por 1 M de tokens de saída de vídeo. O Google coloca a saída de vídeo em cerca de $0,10 por segundo em 720p. Consulte a página de preços da API Gemini para ver os valores atualizados.
O Gemini Omni 1.1 Flash tem plano gratuito?
Não. Ao contrário dos modelos Gemini Flash somente de texto, o Gemini Omni 1.1 Flash não tem plano gratuito, então cada requisição é cobrada desde o primeiro token. Se você quer uma forma gratuita de testar os modelos do Google, os níveis de preços padrão do Gemini ainda incluem uma cota gratuita de API.
Quanto custa um vídeo de 10 segundos com o Gemini Omni 1.1 Flash?
Um clipe de 10 segundos em 720p com áudio gera cerca de 57.920 tokens de saída, o que dá aproximadamente $1,01 em custos de saída de vídeo, antes de somar qualquer token de entrada ou de texto. Usando o modo rascunho em 360p, cai para cerca de $0,34.
O Gemini Omni 1.1 Flash tem o desconto de 50% para processamento em lote?
Não. Este modelo não oferece suporte a inferência em lote, então o desconto habitual de 50% do Gemini para lotes não se aplica. Os modelos Flash somente de texto, como o Gemini 3.5 e 3.7 Flash, ainda têm esse desconto.
Os preços do Gemini Omni 1.1 Flash são iguais no Vertex AI e na API Gemini?
Sim. As tarifas por token são idênticas no Google AI Studio (a API Gemini) e na Gemini Enterprise Agent Platform (a linha do Vertex): $1,50 de entrada, $9,00 de saída de texto e $17,50 de saída de vídeo por 1 M de tokens. A disponibilidade é apenas na região global.