

O Google lançou o Gemini 3.6 Flash em 21 de julho de 2026 como seu novo modelo "workhorse" (cavalo de batalha). Resumindo: é uma atualização real e que vale a pena em relação ao 3.5 Flash, usando 17% menos tokens de saída e reduzindo o preço de saída de $9,00 para $7,50 por 1M. Não é um modelo de ponta, e nunca tentou ser, o Google não lançou nenhum 3.5 Pro junto com ele.
Onde ele vence: uso de computador, raciocínio com gráficos e vídeos longos, e memória de contexto longo, tudo a uma fração do preço do Claude Sonnet 5. Onde ele perde: nos benchmarks mais difíceis de programação e trabalho de conhecimento, ele fica atrás do GPT-5.6 e do Claude Sonnet 5.
A verdadeira história aqui não é "o Google alcançou a ponta". É que o nível barato ficou mais barato e mais eficiente, que é exatamente o que importa se você roda agentes em grande volume. E se você vai apontar isso para uma fila de suporte, lembre-se de que o modelo é a parte fácil. Eu construo a camada que transforma um modelo como esse em um agente de IA para helpdesk de verdade, e nada disso é o modelo.
O que o Gemini 3.6 Flash realmente é
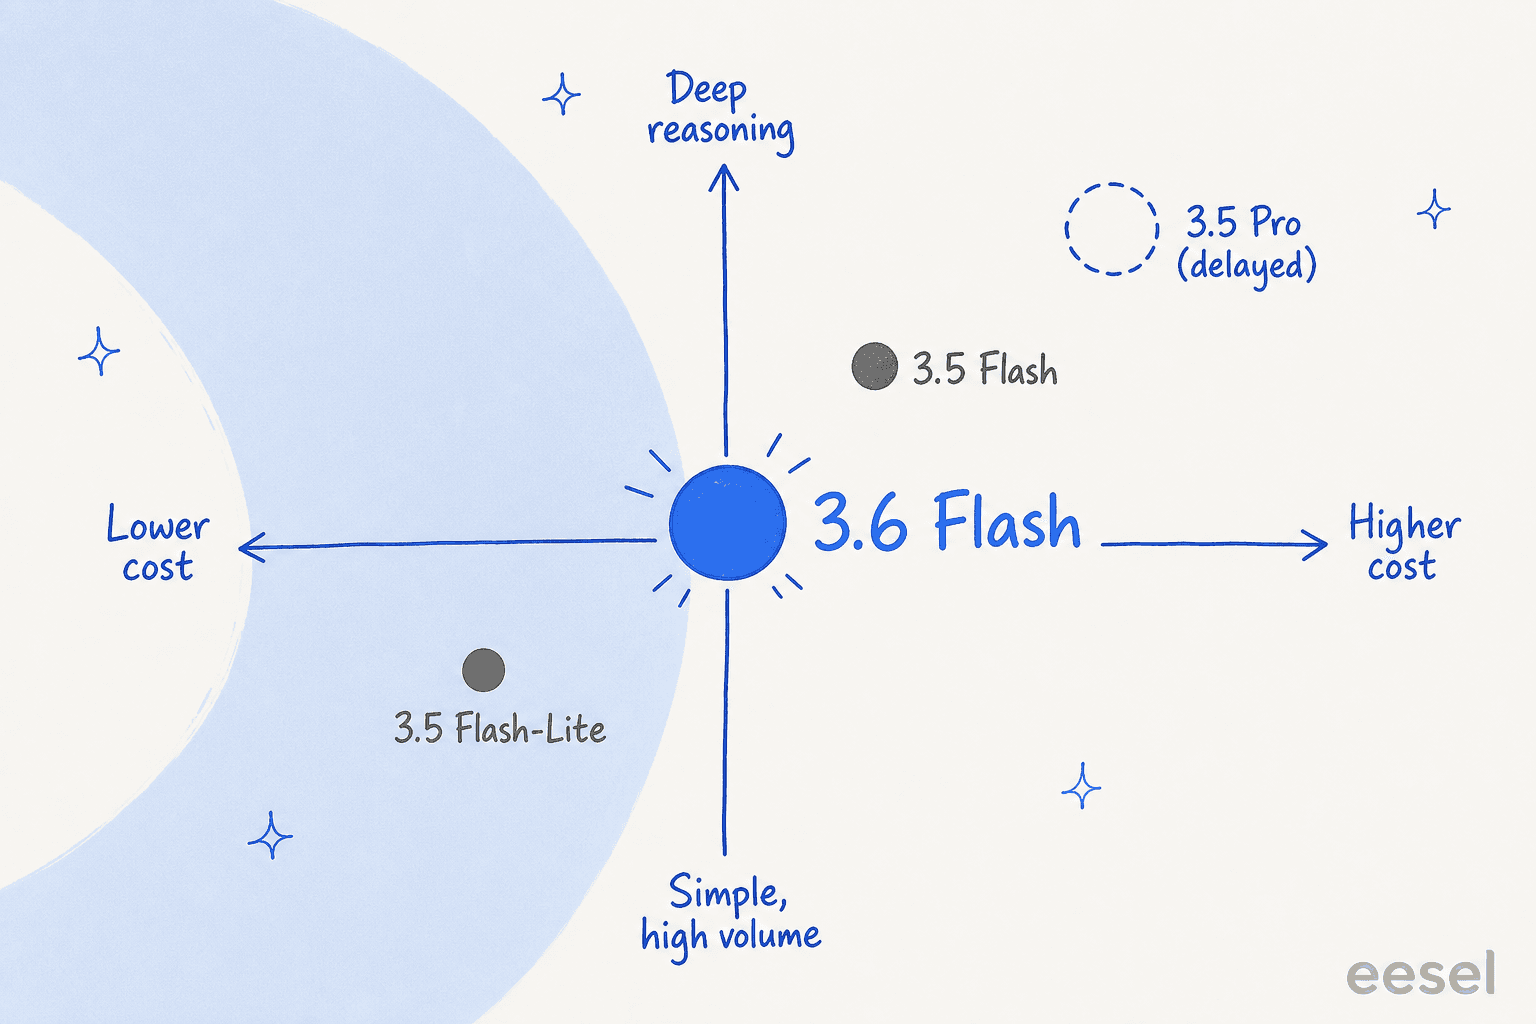
O Google divide o Gemini em níveis: Pro para o raciocínio mais difícil, Flash para o trabalho do dia a dia e Flash-Lite para tarefas baratas de alto volume. O Gemini 3.6 Flash é o nível intermediário, e o Google o chama de propósito de "workhorse". É o modelo que você usa quando está executando algo milhares de vezes por dia e se importa com custo e latência tanto quanto com inteligência bruta.
Ele se constrói diretamente sobre o 3.5 Flash e sobre o feedback dos desenvolvedores que o usam. O discurso central é eficiência: menos etapas de raciocínio e chamadas de ferramentas para concluir uma tarefa com várias etapas, menos divagação nas respostas, e um preço mais baixo por token de saída. Ele também traz um corte de conhecimento mais recente, avançado de janeiro de 2025 para março de 2026.
Por baixo do capô você tem o que esperaria de um modelo moderno: uma janela de contexto de 1.048.576 tokens, entrada multimodal em texto, imagem, vídeo, áudio e PDF, além de chamada de funções, saída estruturada, execução de código, cache de contexto e embasamento por busca. O uso de computador, em que o modelo controla um navegador ou desktop, é agora uma ferramenta integrada do lado do cliente em pré-visualização.
A história da eficiência é a verdadeira história
Aqui está o número que me fez prestar atenção. No benchmark de programação DeepSWE, o 3.6 Flash termina a tarefa média com 97.000 tokens de saída, enquanto o 3.5 Flash consumia 276.000, um corte de cerca de 65%. No Artificial Analysis Index, mais amplo, a diferença é menor, mas ainda real, caindo de 28K para 23K.
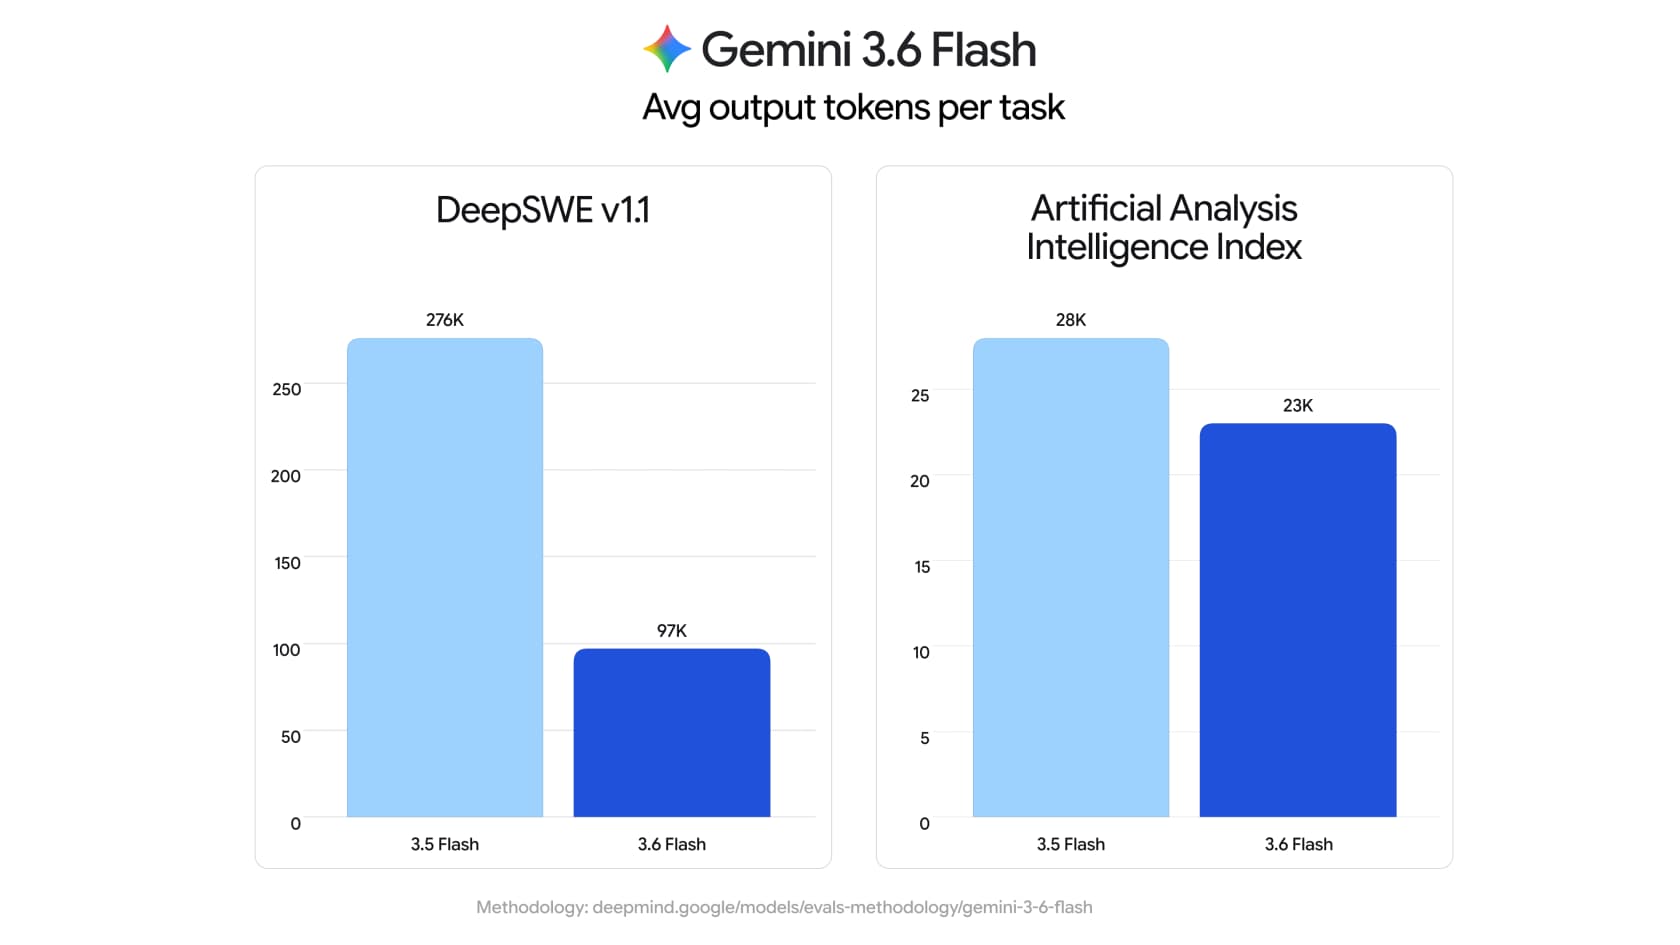
Por que a contagem de tokens importa mais do que o preço de tabela? Porque é nos tokens de saída que a conta realmente se acumula, e um agente é uma máquina que gasta tokens. Um único ticket de suporte tratado por um agente não é uma única chamada ao modelo, é uma cadeia: ler o ticket, buscar na base de conhecimento, decidir, talvez chamar uma ferramenta, redigir, verificar. Cada etapa gasta tokens. Cortar os tokens por etapa reduz o custo de toda a cadeia, além da taxa por token já mais baixa.
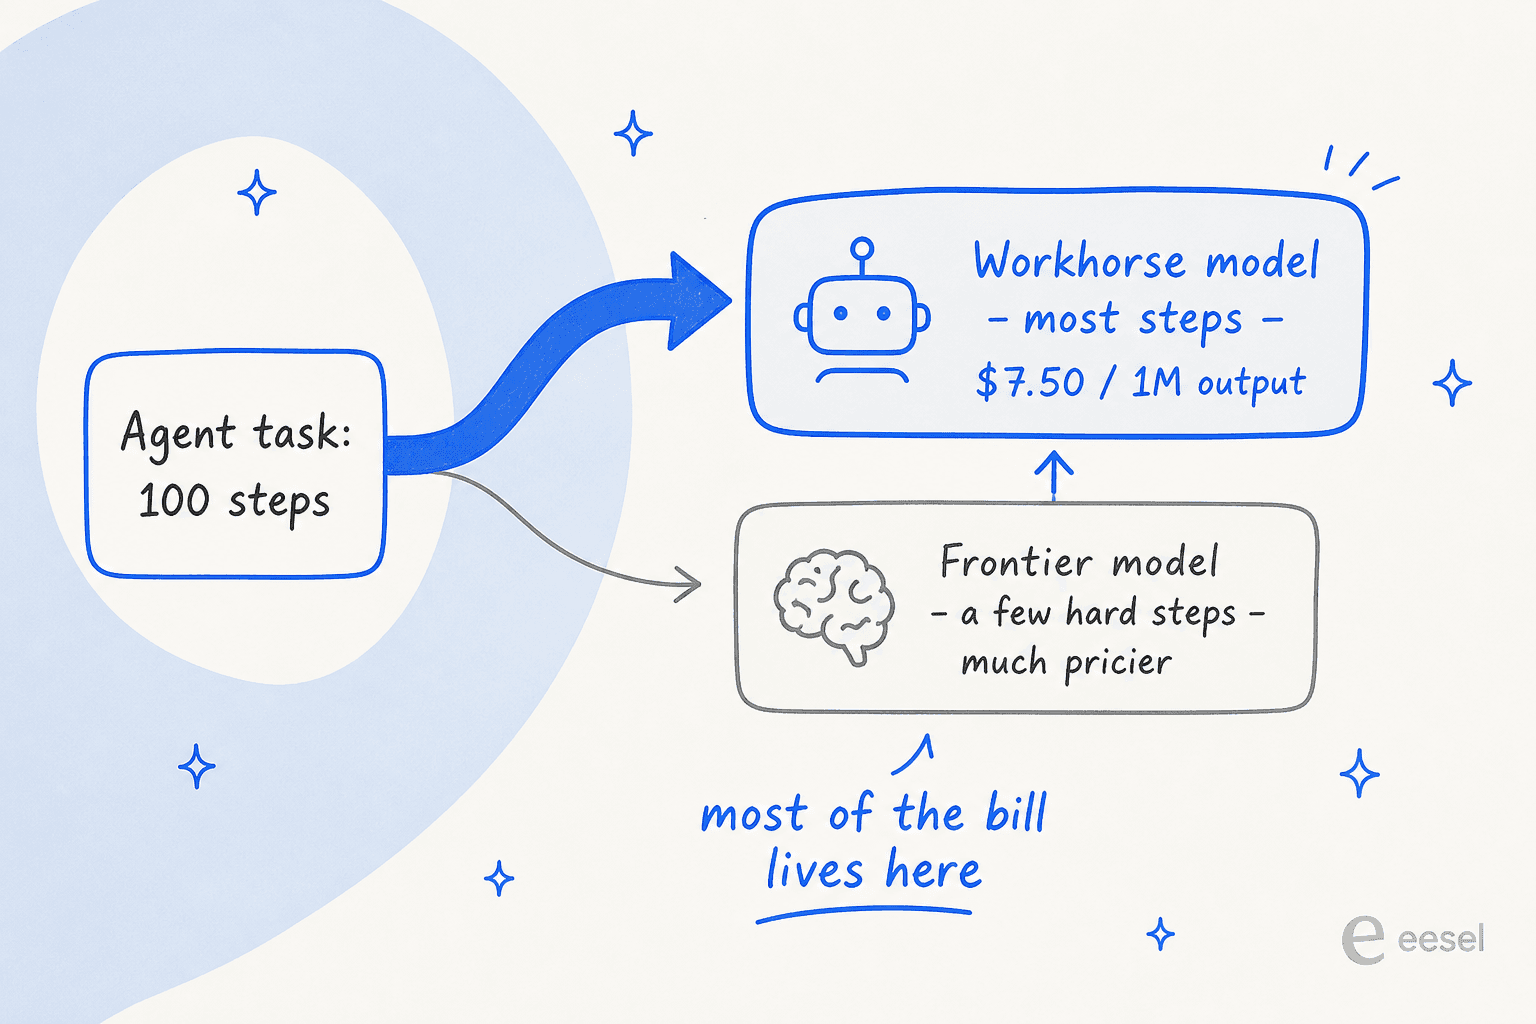
Isso também explica por que o posicionamento de "workhorse" é honesto. Em um fluxo de trabalho real de agentes, a maioria das etapas é rotineira e é direcionada ao modelo barato, enquanto apenas as etapas realmente difíceis precisam de um modelo de ponta, se precisarem. Assim, a maior parte da sua conta vive na faixa do workhorse, e tornar essa faixa 17% mais barata por token e muito mais eficiente por tarefa é mais importante do que um lançamento mais chamativo de um Pro teria sido.
Benchmarks: onde ele vence, onde ele perde
Frente à própria família, o 3.6 Flash é um salto claro. O gráfico do Google mostra que ele supera tanto o 3.5 Flash quanto o 3.1 Pro do ano passado em programação de longo horizonte, engenharia de ML, trabalho de conhecimento e uso de computador.
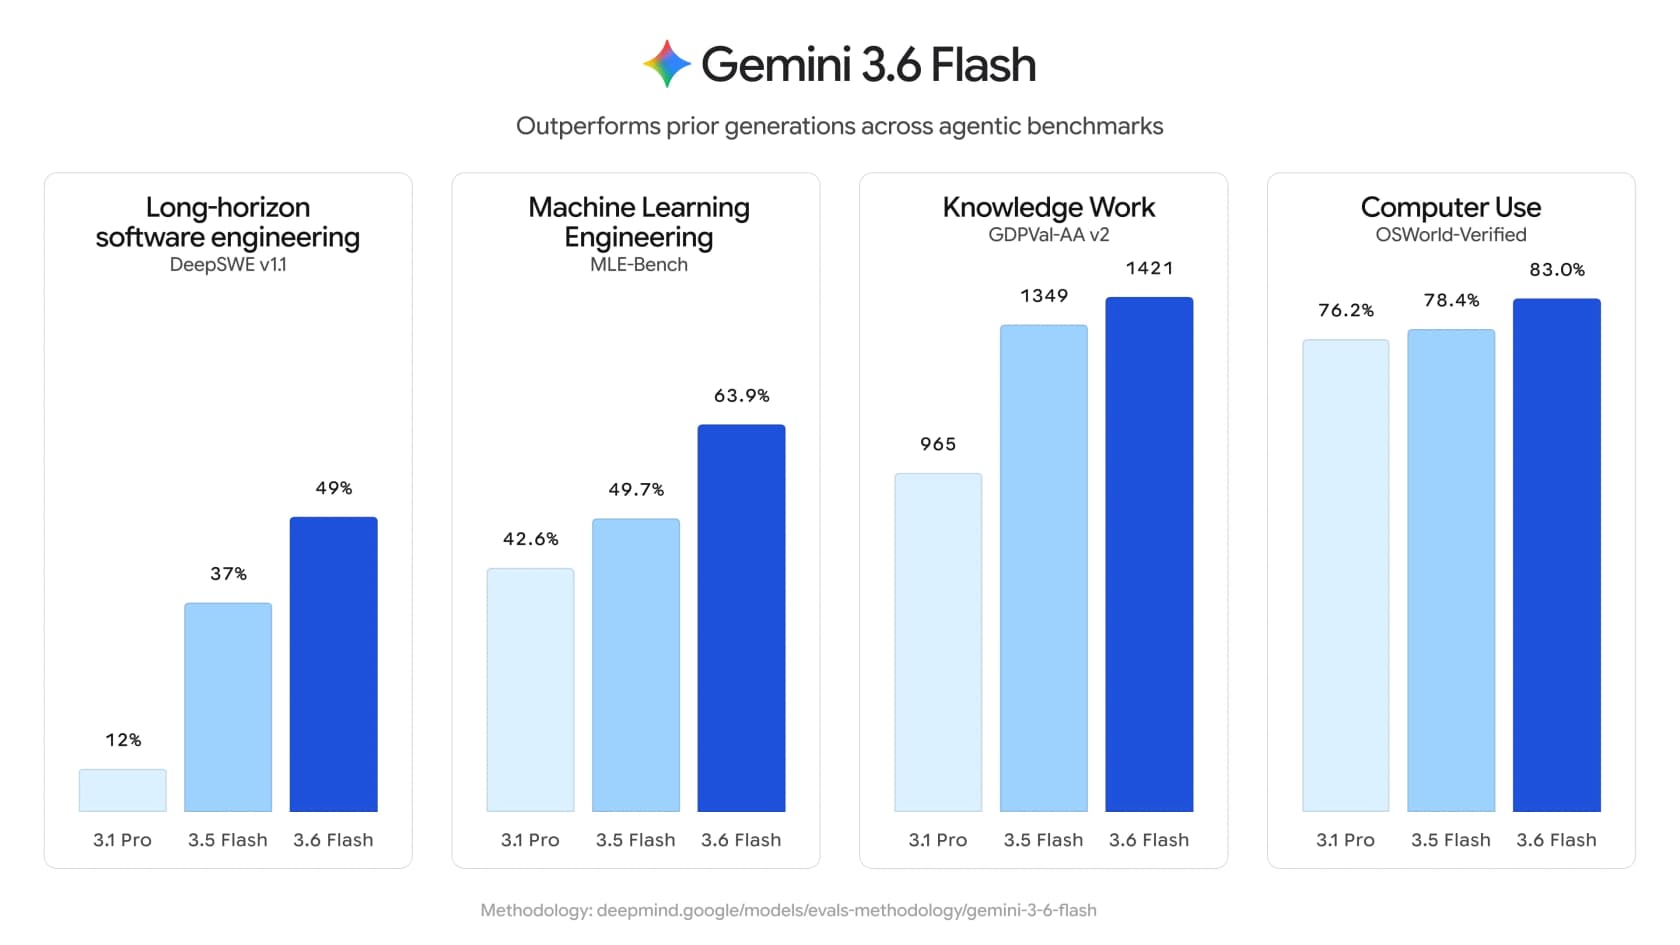
A pergunta mais útil é como ele se compara aos modelos entre os quais você realmente escolheria. O Google publicou uma tabela comparativa, e é preciso reconhecer que ele não esconde as derrotas.
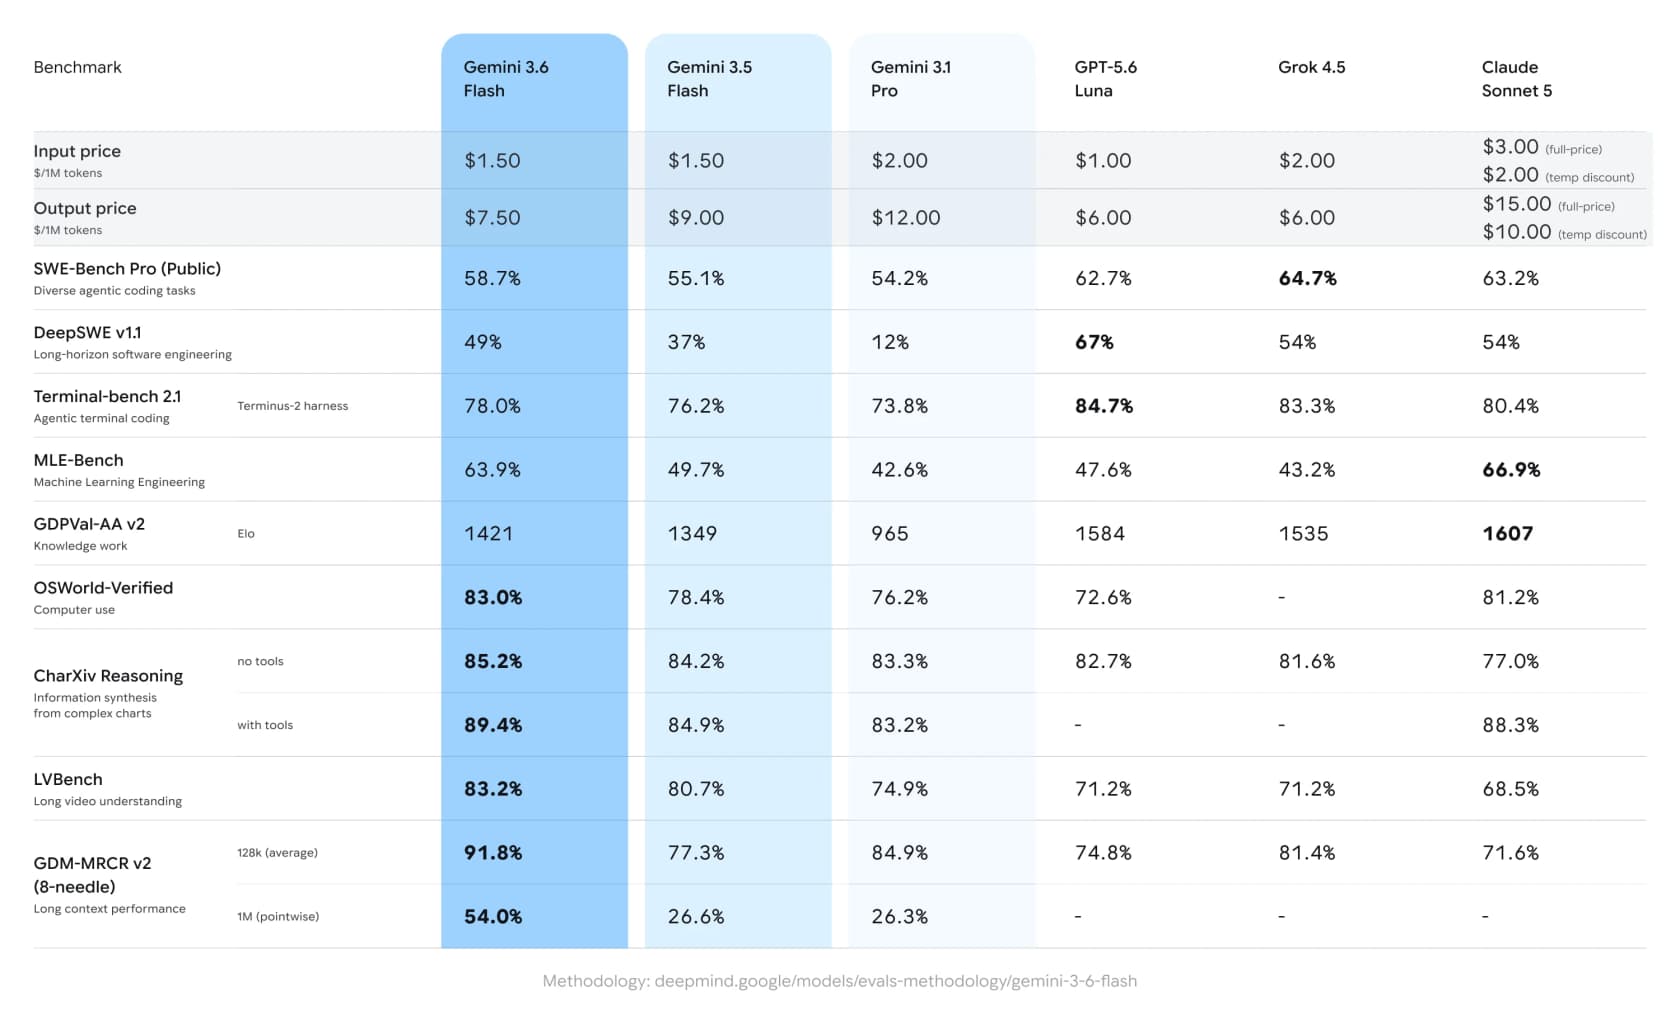
Lendo essa tabela com honestidade, um padrão claro aparece. Nos testes mais difíceis de programação com agentes, o 3.6 Flash fica atrás da ponta: 58,7% no SWE-Bench Pro contra 64,7% do Grok 4.5 e 63,2% do Claude Sonnet 5, e 49% no DeepSWE contra 67% do GPT-5.6 Luna. No trabalho de conhecimento (GDPval-AA v2), seu Elo de 1421 fica bem abaixo do GPT-5.6 (1584) e do Claude Sonnet 5 (1607).
Mas ao olhar para as tarefas que correspondem ao trabalho real de agentes, ele lidera todo o placar: 83,0% no OSWorld-Verified (uso de computador), 89,4% no raciocínio com gráficos do CharXiv, 83,2% no vídeo longo do LVBench, e um enorme 91,8% na memória de contexto longo do GDM-MRCR, onde o rival mais próximo está na faixa dos 70%. Para um modelo que custa um quinto do Claude Sonnet 5 na saída, é um desempenho muito forte exatamente nas dimensões que importam para o trabalho com agentes.
Minha leitura: isso é um cavalo de batalha, não um campeão. Se o seu trabalho é engenharia de software profunda e inédita, os modelos de ponta ainda têm vantagem. Se o seu trabalho é executar muitas tarefas embasadas, com uso intenso de ferramentas e muitos documentos, de forma barata, o 3.6 Flash é uma das melhores opções de custo-benefício do mercado agora.
O preço em detalhes
Aqui está a visão financeira. Todos os valores são por 1M de tokens no nível Standard pago, da página de preços da API Gemini.
| Modelo | Entrada | Saída | Batch (entrada / saída) | Cache de contexto |
|---|---|---|---|---|
| Gemini 3.6 Flash | $1.50 | $7.50 | $0.75 / $3.75 | $0.15/1M + $1.00/1M/hr |
| Gemini 3.5 Flash (anterior) | $1.50 | $9.00 | $0.75 / $4.50 | $0.15/1M |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | $0.15 / $1.25 | $0.075/1M |
Alguns pontos merecem destaque. O preço de entrada se mantém igual, então toda a economia está na saída, que como vimos é onde os agentes gastam. O modo batch dá um desconto fixo de 50% se você puder tolerar o processamento assíncrono. A saída inclui os tokens de raciocínio, então uma resposta "pensada" cobra seu rascunho como saída, mais um motivo pelo qual o ganho de eficiência de tokens se acumula. E existe um nível gratuito genuíno para testes, embora no nível gratuito seu conteúdo possa ser usado para melhorar os produtos do Google, então mantenha os dados de produção no nível pago.
Para tornar essa relação custo-benefício concreta, insira o seu próprio volume:
Com 50M de tokens de saída por mês, migrar do 3.5 Flash para o 3.6 Flash economiza $75, sem ainda contar o ganho de eficiência de tokens. No volume real de um agente, essa diferença aumenta rápido.
Os dois modelos companheiros
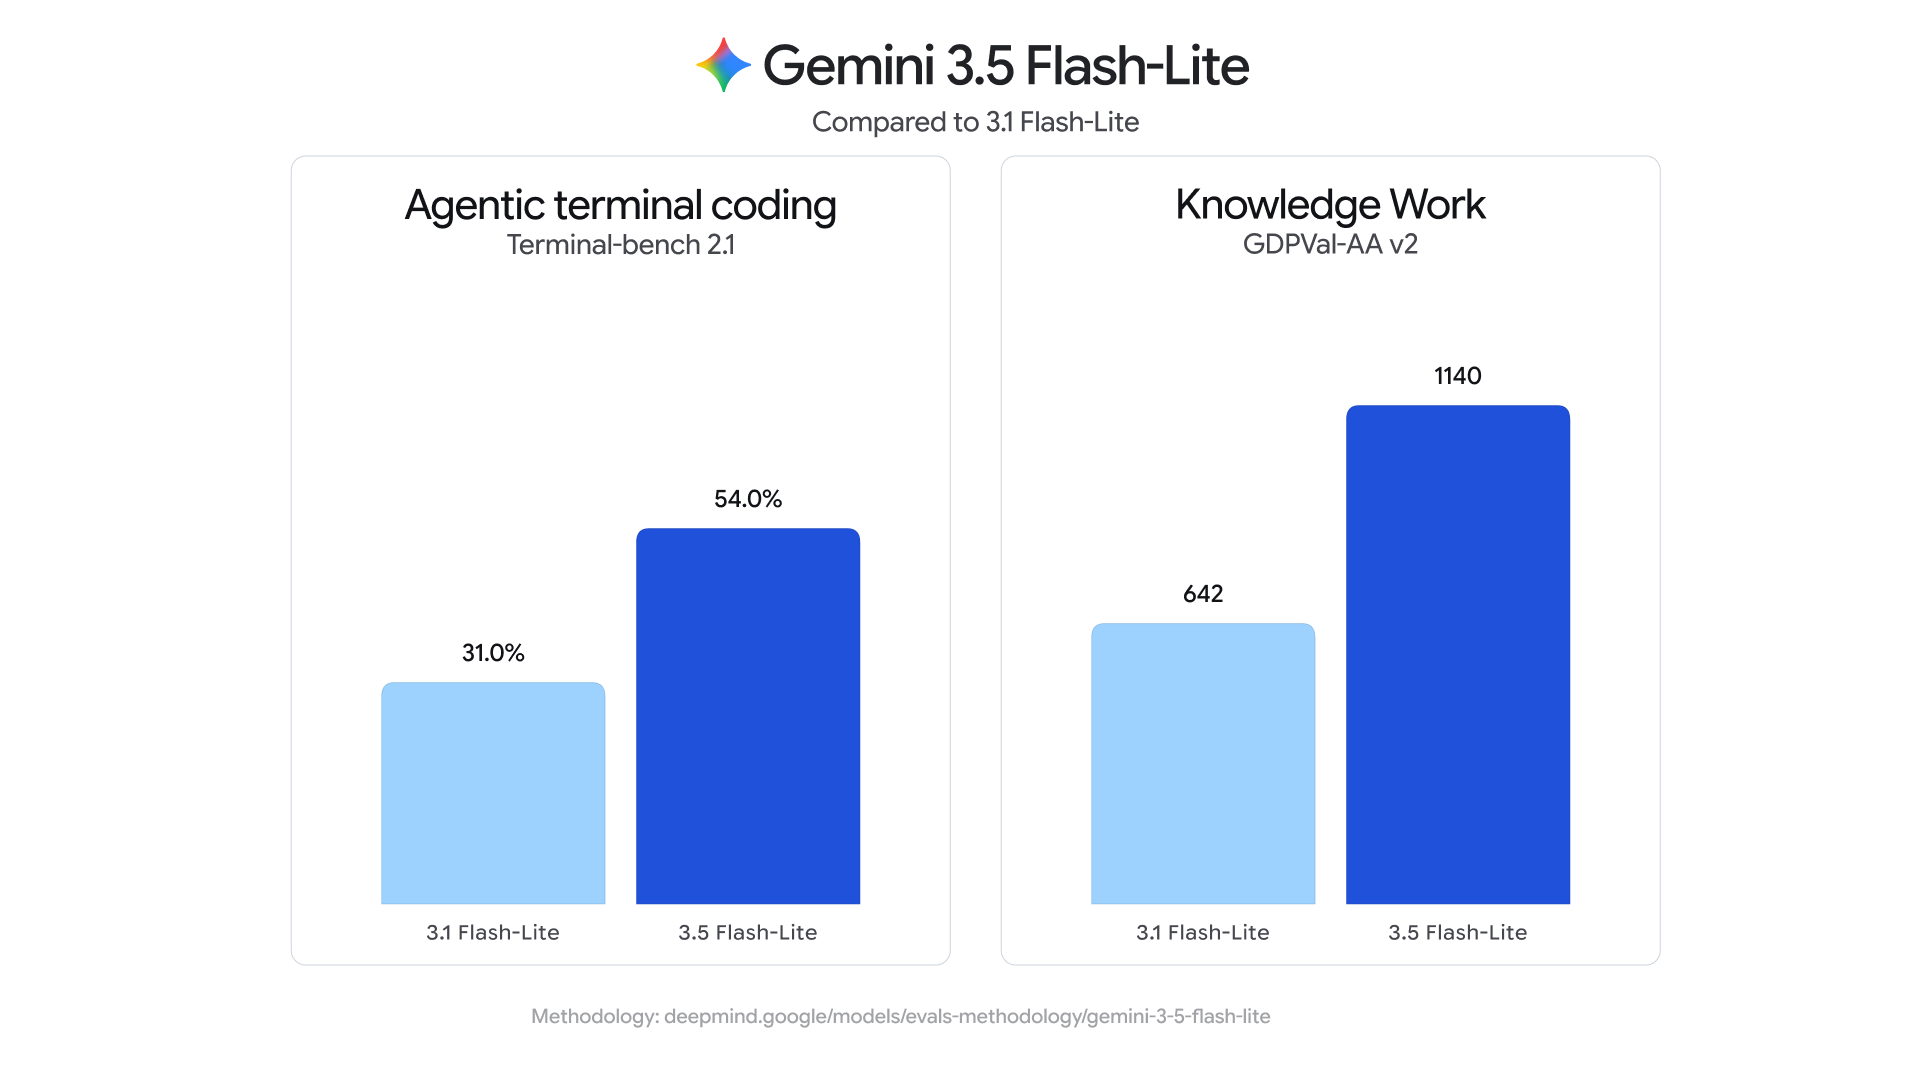
O 3.6 Flash não chegou sozinho. O Gemini 3.5 Flash-Lite é o nível econômico, a $0,30 de entrada / $2,50 de saída, e o Google diz que agora supera com folga o antigo 3.1 Flash-Lite em programação de terminal e trabalho de conhecimento, enquanto funciona rápido o suficiente para tarefas de alto volume como classificação e roteamento.
O terceiro modelo, o Gemini 3.5 Flash Cyber, é um especialista ajustado para trabalho de cibersegurança, e é restrito a governos e parceiros de confiança em vez de estar disponível de forma geral. A maioria das equipes nunca vai usá-lo, mas isso sinaliza onde o Google acha que boa parte do valor dos agentes de curto prazo está.
O que está faltando: sem Pro, e um teaser do Gemini 4
O elefante na sala é o modelo que o Google não lançou. A linha principal Gemini Pro foi atualizada por último em fevereiro de 2026, o Google deu um teaser de um 3.5 Pro em maio, e depois ele foi adiado. O líder de produto Logan Kilpatrick apresentou isso como um trabalho em andamento, não como um cancelamento:
"3.5 Pro is testing with partners and we hope to land it soon."
Ao mesmo tempo, a equipe já está olhando além disso:
"We've kicked off the pre-training run for Gemini 4, our most ambitious yet."
O TechCrunch interpretou o lançamento como o Google mantendo o ritmo na ponta barata e de alto volume do mercado, enquanto sua resposta de ponta ao GPT-5.6 e ao Claude Sonnet 5 ainda está em desenvolvimento. Acho essa uma leitura justa. Também significa que, se você precisa de raciocínio de ponta hoje, o Gemini não é onde você vai encontrá-lo esta semana.
Então, o Gemini 3.6 Flash vale a pena?
Se você já está construindo sobre o Gemini Flash, é um sim fácil. Ele é mais barato, mais eficiente e melhor em quase todos os benchmarks do que o modelo que substitui, sem nenhuma desvantagem real. Mude e siga adiante.
Se você está escolhendo entre famílias, é preciso ser honesto sobre a natureza do trabalho. Para engenharia profunda e inédita, os modelos de ponta ainda têm vantagem. Para trabalho embasado, com uso intenso de ferramentas, voltado a documentos e telas, em grande escala, o 3.6 Flash se destaca em custo-benefício.
O único ponto em que eu discordaria do entusiasmo é o salto que algumas pessoas fazem de "modelo barato ótimo" para "bot de suporte ótimo". Essas coisas não são a mesma, e a lacuna entre elas é onde a maioria dos projetos de suporte com IA falha silenciosamente.
Um modelo não é um agente de suporte
Eu construo as integrações que colocam modelos como esse em filas de suporte reais, então deixe-me ser direto sobre o que um lançamento de modelo muda e não muda para esse trabalho. O modelo é a camada de commodity na base da pilha. Tudo que torna um agente de IA realmente seguro para colocar na frente de clientes está por cima disso.
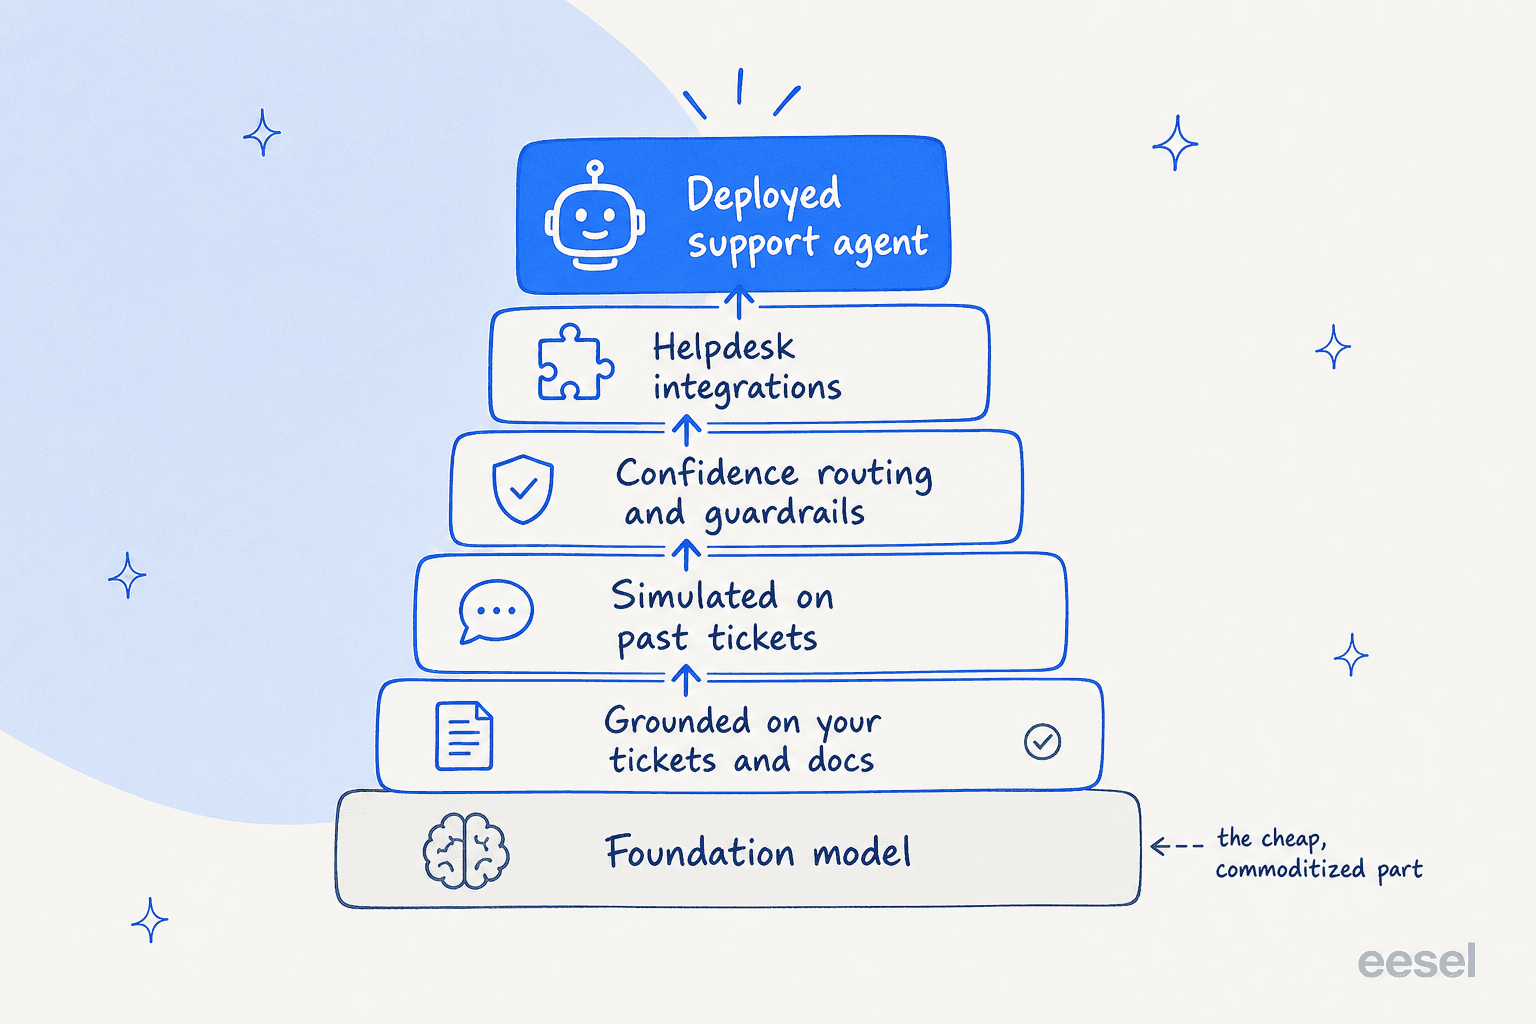
Eu já vi um modelo de aparência confiante dar a um cliente uma resposta limpa, bem escrita e completamente errada. É por isso que toda implantação da eesel é simulada com seus tickets históricos antes de responder a uma pessoa real, para que você veja a cobertura e a precisão por tópico e possa corrigir as lacunas primeiro. É também por isso que confiamos no roteamento baseado em confiança: respostas de baixa confiança se tornam rascunhos, não respostas automáticas.
Essa camada é o que transforma "existe um modelo rápido" no fato de a smava rodar um agente Zendesk totalmente automatizado sobre mais de 100.000 tickets em alemão por mês, ou na Gridwise resolvendo 73% das solicitações de nível 1 em seu primeiro mês. Nada disso é o modelo. É o embasamento, a simulação, os guardrails e as integrações com o helpdesk em torno dele.
A boa notícia para quem usa a eesel: por ser independente de modelo, um Flash mais barato e eficiente por baixo dos panos é um ganho gratuito. Você recebe a economia sem precisar decidir em qual modelo confiar ou reescrever nada. Essa é a forma certa de aproveitar um lançamento como esse, como uma melhoria no ingrediente, não como um produto que você implanta bruto.
Experimente a eesel
O Gemini 3.6 Flash é um cavalo de batalha realmente bom, mas se o motivo pelo qual você se importa é "quero automatizar minha fila de suporte", o modelo é os 10% fáceis desse projeto. A eesel é os outros 90%: ela aprende com seus tickets anteriores e documentos de ajuda, simula a implantação no seu histórico real para que você conheça os números antes de entrar em produção, e se conecta ao Zendesk, Freshdesk, Gorgias e mais de 100 ferramentas em minutos.

Por ser independente de modelo, melhorias como essa chegam como um ganho silencioso de custo em vez de uma migração. O preço é baseado em uso, a $0,40 por conversa sem taxas por assento, e há um teste gratuito sem cartão. Se você preferir ver com seus próprios tickets em vez de ler mais um gráfico de benchmark, é exatamente para isso que a simulação existe.