

FreshchatにはAIの品質保証が実際にある。FreddyのPost Resolution Quality Coachは解決済みの各会話を6つの固定パラメータで評価し、Good、NeutralまたはBadのラベルを付け、Quality Score Reportに反映させる。これはProとEnterpriseでのFreddy AI Copilot(1エージェントあたり月29ドル)のアドオンだ。評価されるのはエージェントの書き方と顧客の感情であり、回答がポリシーに合っていたか、チャットが正しいグループに行ったか、自分で追加したいルールかどうかではない。Freshworksは独自基準を文書化していない。それらの確認には、毎週サンプルを手作業で読むか、eeselのようなAIチームメイトに、指定したチャットを書いたルールと照らして読ませ、理由を内部コメントに残させる。eesel CLIを使えば、Claude CodeのようなコーディングエージェントがFreshdeskを接続し、自動化を確認し、ライブチャットの指示を作成できる。ただしFreshchat管理者がAPIトークンとWebhookを入力する必要は残る。
FreshchatにAIの品質保証はありますか?
はい(私のFreddy AIレビューでより広いツールキットを解説している)。Freshworksは名前に「Quality Coach」を含む2つのFreddy機能を文書化しており、さらにどのチームも既に持っているCSATレポートもある。それぞれがQAリーダーに何を伝えるかを見てみる。
| Freshchatの機能 | プラン | QAリーダーに伝えること | 伝えないこと |
|---|---|---|---|
| Post Resolution Quality Coach | ProとEnterprise、Freddy AI Copilotのアドオン | 解決済みの各会話のスコアとGood、NeutralまたはBadのラベル、エージェント別・グループ別 | 回答がポリシーに従っていたか |
| Proactive Quality Coach | ProとEnterprise、ベータ、Copilotの一部 | 送信前の返信への修正案 | 送信後に起きたこと全て |
| Chat Conversations OverviewのCSATタブとOverallタブ | レポート | 評価、満足・不満足の件数、傾向、再オープンされたチャット(AI CSATが読み方を解説) | どの返信が間違っていたか、またその理由 |
Post Resolution Quality Coachは何を評価しますか?
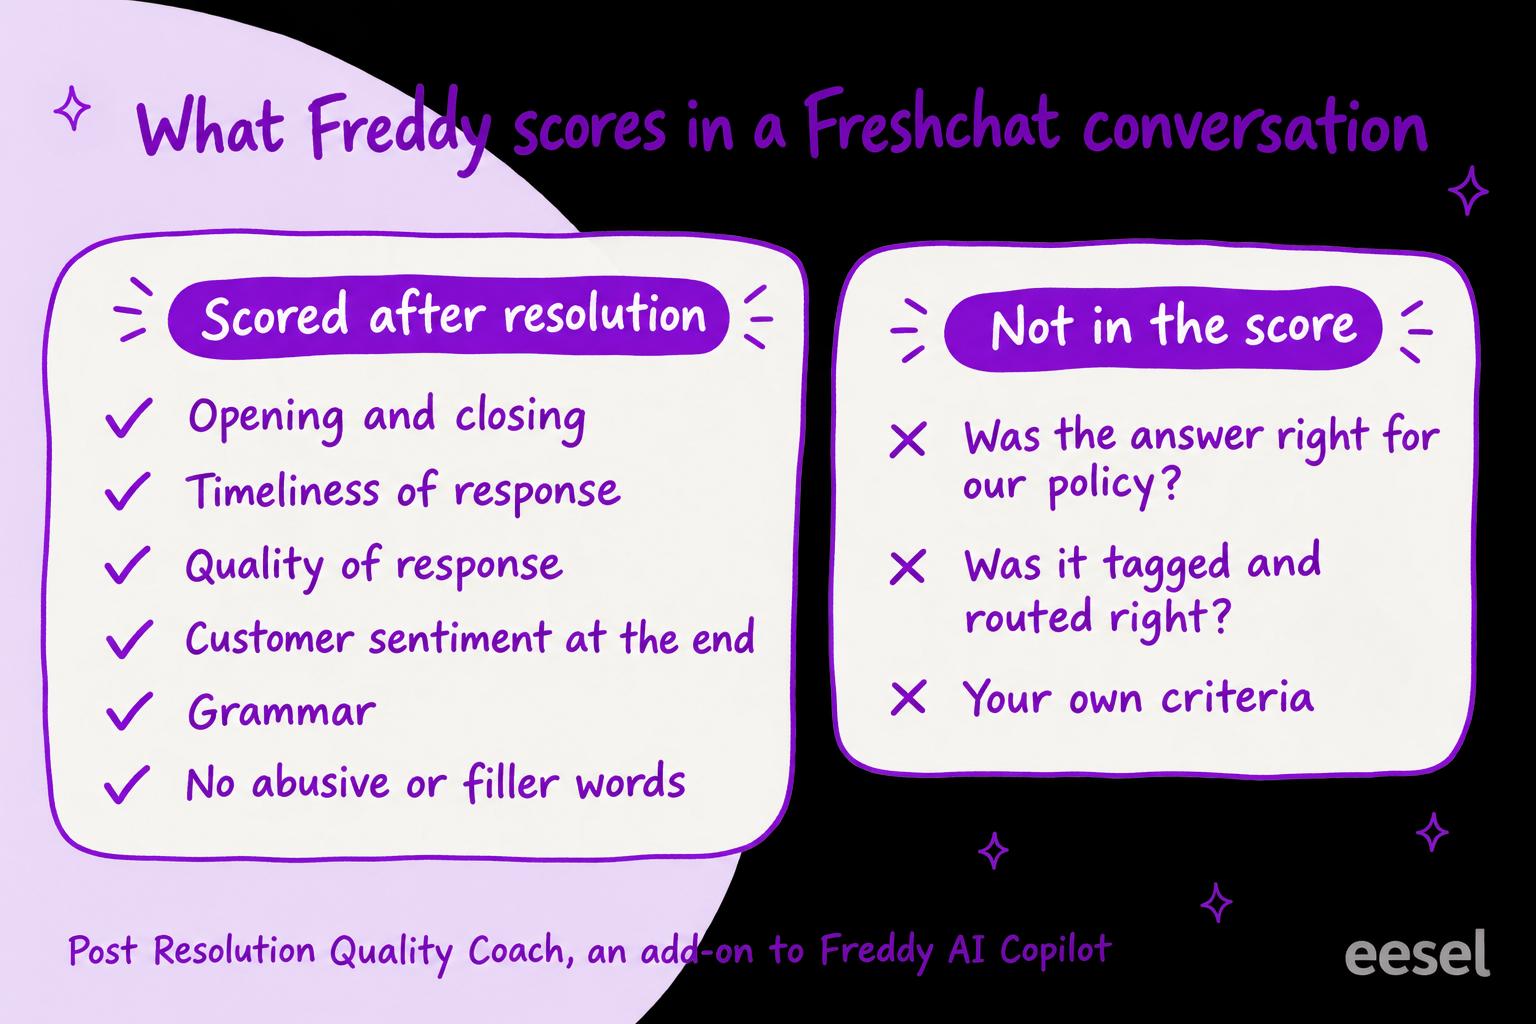
FreshworksのQuality Coach記事は、スコアが"is calculated based on six different parameters"だとしている:
- 会話の開始と終了: "The effectiveness and professionalism demonstrated in initiating and concluding the conversation."
- 返信の速さ: エージェントがどれだけ早く返信したか。
- 返信の質: "The level of detail, relevance, and helpfulness of the agent's response to the customer's query or concern."
- 顧客の感情: 最後までトーンがポジティブまたはニュートラルに保たれているか。
- 返信の文法: 文法、言葉遣い、明瞭さ。
- 侮辱的またはフィラーワードの有無: エージェントの言葉遣いが敬意を保ち専門的であるか。
会話が解決された後、エージェントはエージェント受信箱の第3パネルを開き、どう進んだかのインサイト、改善のヒント、Good、BadまたはNeutralのラベルを見る。スコアに高評価・低評価を付けられ、Freshworksによるとこれは管理者が"assess the effectiveness of the feature for agents"するためのものだ。記事はレビュアーのステップを記述していない:エージェントはスコアに低評価を付けられるが、誰もそれを上書きしない。
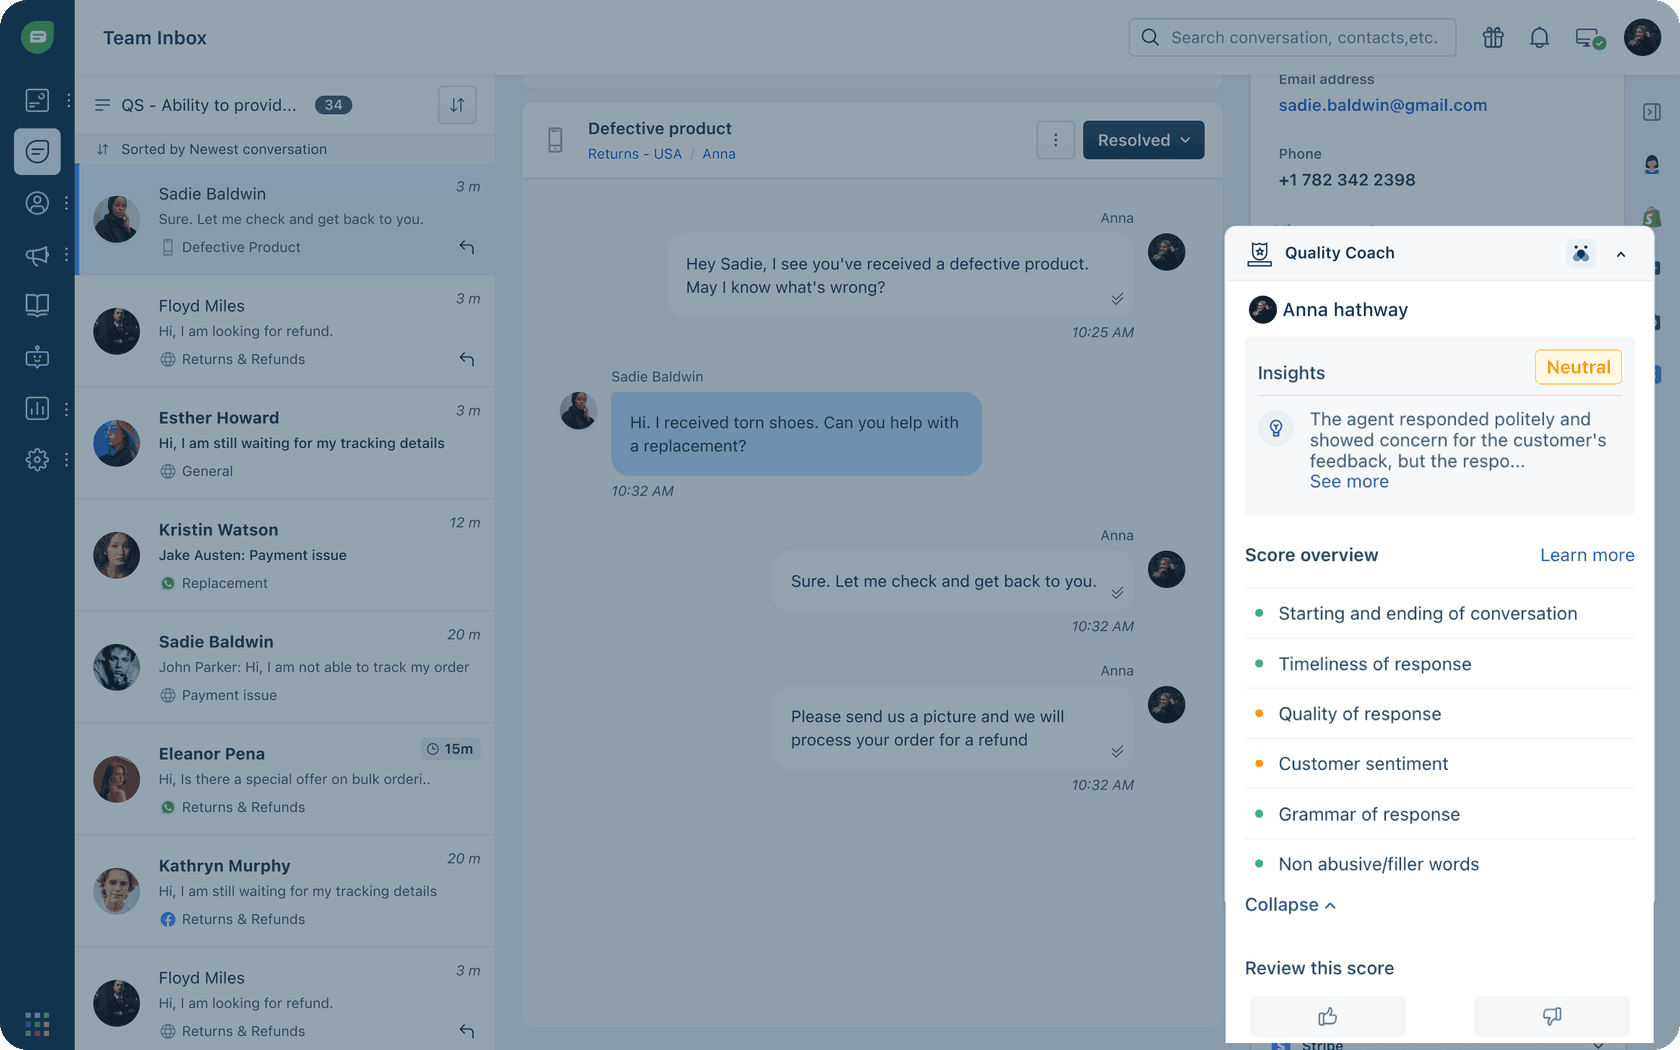
Freshworks自身のスクリーンショットはよく読む価値がある。顧客は壊れた靴の交換を求め、エージェントは"Please send us a picture and we will process your order for a refund"と返信し、コーチは会話をNeutralとし、Quality of responseとCustomer sentimentをアンバーにした。Freddyはここでは Quality of responseをアンバーとした。Freddyが知り得ないのは、返品ポリシーが壊れた靴に対して交換、返金、または先に写真のどれを求めているかだ。その判断には自社のルールが必要で、6つのパラメータはどれも受け付けない。
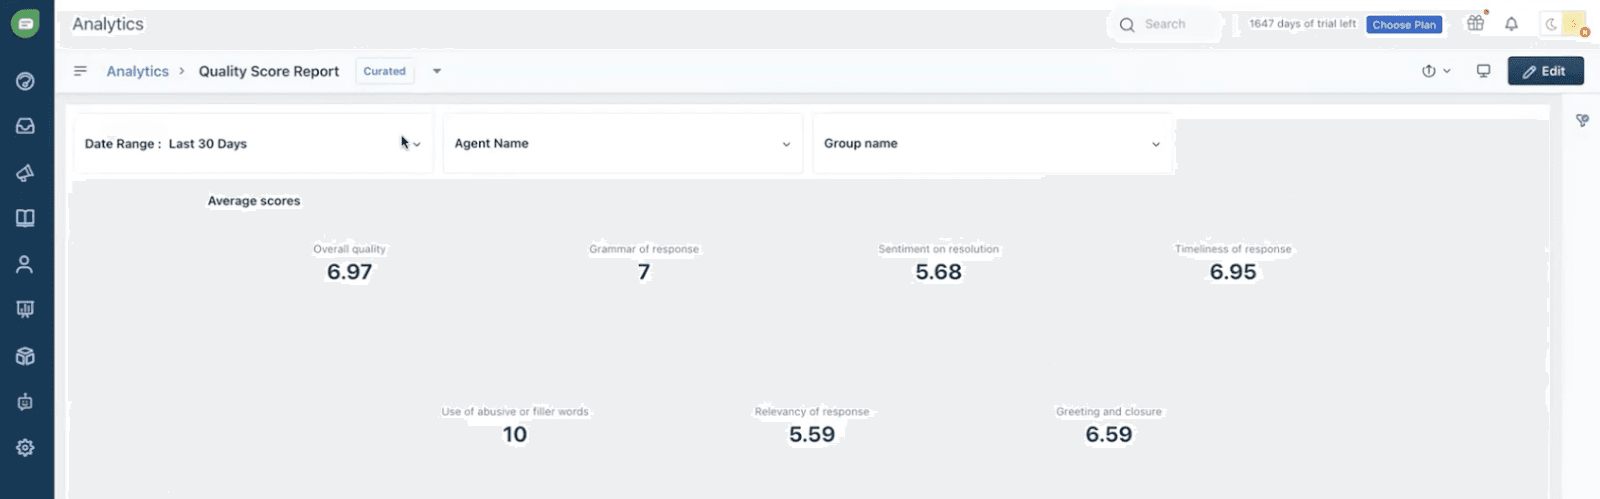
管理者はReports配下、Chat AnalyticsカテゴリでQuality Score Reportを見られる。週次または月次でグループ別・エージェント別にスコアを表示し、時間経過での傾向とエージェント別の内訳を示す。FreshworksはFreddyが"could take couple of minutes to generate the Quality Score"だと注記している。
これを購入する前に知っておくべきことが2つある。Freshworksが記事を最後に更新したのは2024年6月27日で、この機能は"is currently available as an add-on for Freddy Copilot"だとしているため、現在のパッケージングはアカウントマネージャーに確認すること。またCopilotはエージェント単位で購入するフレキシアドオンなので、一部だけ予算を組む前にどのエージェントの会話が評価されるかを確認すること。記事にはそれが書かれていない。
Proactive Quality Coachは何をしますか?
Proactive Quality Coachは返信が送られる前に働く。エージェントがSendをクリックすると、Freddyはメッセージを次の順序で7つのパラメータでチェックする:"Abusive Words > Spelling Check > Grammar > Too long > Filler words > Tone > Relevancy"。5つの良いトーン(共感的で解決志向など)と5つの悪いトーン(防御的や皮肉など)を見分け、各問題をそれぞれの色でハイライトし、エージェントが各提案を受け入れるか無視できるようにする。
初期設定ではオフで、ロールごとに有効化でき、Freshworksはこれを"available in Beta for all customers on Pro and Enterprise plan, as part of the Freddy AI Copilot addon"としている。管理者はFreddyレポートで、提案が何件表示され、受け入れられ、拒否されたかを確認できる。
2つを組み合わせれば、Sendボタンの両側にコーチがいることになる。どちらも返信の書き方に作用する。どちらもチームが決めたことと照らして確認しない。過去のチャットを完全に読むには、AIサポート会話のレビューについての私のガイドを参照。
Freshchatの Quality Coachが確認できないものは何ですか?
Freshworksが文書化している内容には4つの確認が欠けている:
- 自社ポリシー。 6つのパラメータのどれも自社のヘルプセンターやルールを読まないため、丁寧でよく書かれた誤った回答がほとんどの項目で高く評価されることがある。
- フィールド、トピック、ルーティング。 パラメータはすべてメッセージに関するものだ。請求のチャットがBillingグループに行ったか、正しい会話フィールドを得たかは何も確認しない。
- 自社の基準。 記事は6つの固定パラメータを挙げ、「保証確認を必ず先に提案する」のような7つ目を追加する方法はない。
- ボット側。 記事はエージェントの会話について述べている。Freddy AI Agentだけが処理するチャットがスコアを得るかどうかは書かれていないため、得られると仮定しないこと。
これはほとんどのQAプログラムが存在する理由となるギャップだ。速さ、トーン、文法は顧客に見えるが、誤った返金の約束がお金を失わせるものだ。
FreshchatのQAの料金はいくらですか?
Freshchatの料金ページは2026年11月22日時点で、これらのプランを年払い・1エージェントあたり月額で掲載している。Freddy AI Copilotの料金はFreshworksの記事Freddy AI features and pricingによる。
| プラン | 年払い、1エージェントあたり月額 | QAに追加されるもの |
|---|---|---|
| Free | 0ドル、最大10エージェント | Quality Coachは記載なし |
| Growth | 19ドル | Quality Coachは記載なし |
| Pro | 49ドル | Freddy AI Copilotを1エージェントあたり月29ドルで購入可能、両方のQuality Coach機能が付く |
| Enterprise | 79ドル | 同じCopilotアドオン |
Copilotは月払いで1エージェントあたり35ドル。GrowthからProに移行し全員にCopilotを付ける10エージェントのチームの場合、年払いで:Proは10 x 49ドル=490ドル、Copilotは10 x 29ドル=290ドル、合計で月780ドル、Growthの190ドルに対して。Copilotは返信の下書き、要約などももたらし、それは私のFreddy AI料金の記事で解説している。QAだけが購入理由になることはほとんどない。
Freshchatが見逃すものをどう補いますか?
残りを補う方法は2つある。
サンプルを手作業で評価する
最も安い方法は何も新しく必要としない。毎週、リーダーが不満足なCSAT評価、再オープンされた会話、Quality Coachの Badラベルから始めて10から20件の解決済みチャットを選び、それぞれを読み、短いルーブリックで評価する:ポリシーに対する正しい回答、正しいグループとフィールド、プロセスの順守。まず各スコアの意味を合わせておけば、2人のレビュアーが同じチャットを同じように評価できる:サポートQAキャリブレーションが助けになり、AIによるサポートQAについてのこのガイドはAIがどこで速くするかを示している。
限界は明らかだ:人がサンプルを読み、結果はチャットの上ではなくスプレッドシートに残る。
AIチームメイトに自社のルールで確認させる
2つ目の方法は、チャットを読み判断をFreshchatに残すAIエージェントだ。これが私がeeselでやることだ。eeselはFreshdesk連携のチャネルとしてFreshchatに参加する。チームの誰かがダッシュボードチャット、Slackのメンション、または定期実行で依頼すると、どのチャットのメッセージ、そのグループ、担当者、状態、カスタムフィールド、そしてFreshchatのCSATと応答時間の数値を読める。ヘルプセンター、定型文、過去のFreshdeskチケットを読んでいるため、公開済みのポリシーはすでに読んだものになる。
確認するチャットを渡す(例えば今週の低評価チャットのリンクを貼る)と、それは:
- 各会話をそのプロパティとともに読む。
- 平易な言葉で書いたルール(「破損品はまず返金ではなく交換」「請求の質問はBillingグループへ」「配送日を約束しない」)と照らして確認する。
- 判断と理由を内部コメントとして残す。チームは見るが顧客は決して見ない。
- リーダーが読むべきチャットを理由付きでリストする。
ルールを書くのは自分なので、ルーティング、プロセス、ポリシーの確認は単に行を増やすだけで、ポリシーが変わるたびに変更できる。まず限界を知ること:eeselには解決済みの全チャットを一覧表示するコマンドがないため、受信箱を自分で一掃するのではなく、渡されたチャットをレビューする。チームがFreshdeskでメールも扱っているなら、同じエージェントがそのチケットも確認できる。
このような日次確認はすでにeeselの顧客で動いている。Cactus Club CafeはZendeskヘルプデスク上で2つ目のeeselエージェントを動かし、毎朝日次の財務抽出を監査している:各店舗を確認し、バランスが取れていればチケットを解決済みにし、そうでなければ不一致を記載して開いたままにする。2026年8月8日から9月8日の間に約60回実行された。QAレビューも同じ形だ:書かれたルールに対する確認を、チームが働く場所に結果を残す。
FreshchatのQuality CoachはQAに十分ですか?
コーチングには良い出発点だ。解決済みの各会話にスコアを付け、担当したエージェントに見せ、ヒントを与えることは本当のアドバンテージであり、Quality Score Reportはトランスクリプトを誰も読まなくてもリーダーにエージェント別の傾向を示す。Proactive Quality Coachは顧客が見る前にトーンと文法を修正する。
私の見解:すでにProに入っていて下書きや要約のためにCopilotを買うなら、両方のQuality Coach機能をオンにし、Badラベルと不満足なCSAT評価を週次の読むべきリストとして使う。Goodラベルを「正しい」とみなさないこと:それは良く書かれ良く受け取られたという意味にすぎない。QAの問いが「自社ポリシーに対して正しかったか」であれば、Freshchatはそれを自分たちに委ねている:量が少なければ手作業で評価したサンプル、そうでなければAIレビュアー。他のヘルプデスクの同じ問いへの答えは、GorgiasのAI品質保証、FrontのAI品質保証、Help ScoutのAI品質保証についての私の記事にあり、サポートQAのためのAIツールの総括では専用のオプションを比較している。チャットにおけるFreddyの残りの機能についてはFreshchatのAI感情分析とFreshchatのAI返信ドラフトを、引き継ぎには会話要約を参照。代わりに移行を検討中なら、Freshchatの代替を参照。
eeselをFreshchatのポリシーレビュアーとして試す
見逃している確認が「この返信は自社ポリシーに対して正しかったか」であれば、eeselはQuality Coachの隣に追加したいレビュアーだ。Freshdeskアカウントを通じて接続し、ヘルプセンターと過去のチケットを読み、指定したFreshchatの会話を書いたルールと照らして確認し、理由を内部コメントに残す。まずダッシュボードチャットで先週の低評価チャット10件から始め、何が指摘されたかを読み、実際のミスを捉えたルールを残す。
