Qué significa realmente "Meta Muse para la gestión de la base de conocimiento"
Construyo agentes de IA en eesel, y la parte de ese trabajo que nadie pone en una demo es el mantenimiento del conocimiento. Un agente que respondía perfecto en la semana uno empieza a citar en la semana diez el plazo de devolución del trimestre pasado, porque alguien cambió una página de políticas y nadie avisó al bot. Así que, al leer la documentación de Meta para este artículo, me salté el texto de lanzamiento y busqué las partes aburridas: las llamadas de actualización, el calendario de rastreo y lo que sea que te diga lo que el agente no sabe.
Primero, los nombres. "Meta Muse" apunta a tres productos, y solo uno de ellos responde a los clientes desde tu base de conocimiento:
| Producto | Qué es | Papel en la gestión de la base de conocimiento |
|---|---|---|
| Muse | El agente personal de consumo de Meta, lanzado el 8 de septiembre de 2026 | Ninguno. Trabaja para individuos |
| Meta Business Agent | La IA para empresas de Meta en WhatsApp, Messenger e Instagram, lanzada el 3 de junio de 2026 | Responde a los clientes con el conocimiento que le das |
| API Muse Spark | El modelo de Meta, invocado desde tu propio código (Muse Spark 1.3) | Un modelo que tendrías que conectar a tu propia recuperación |
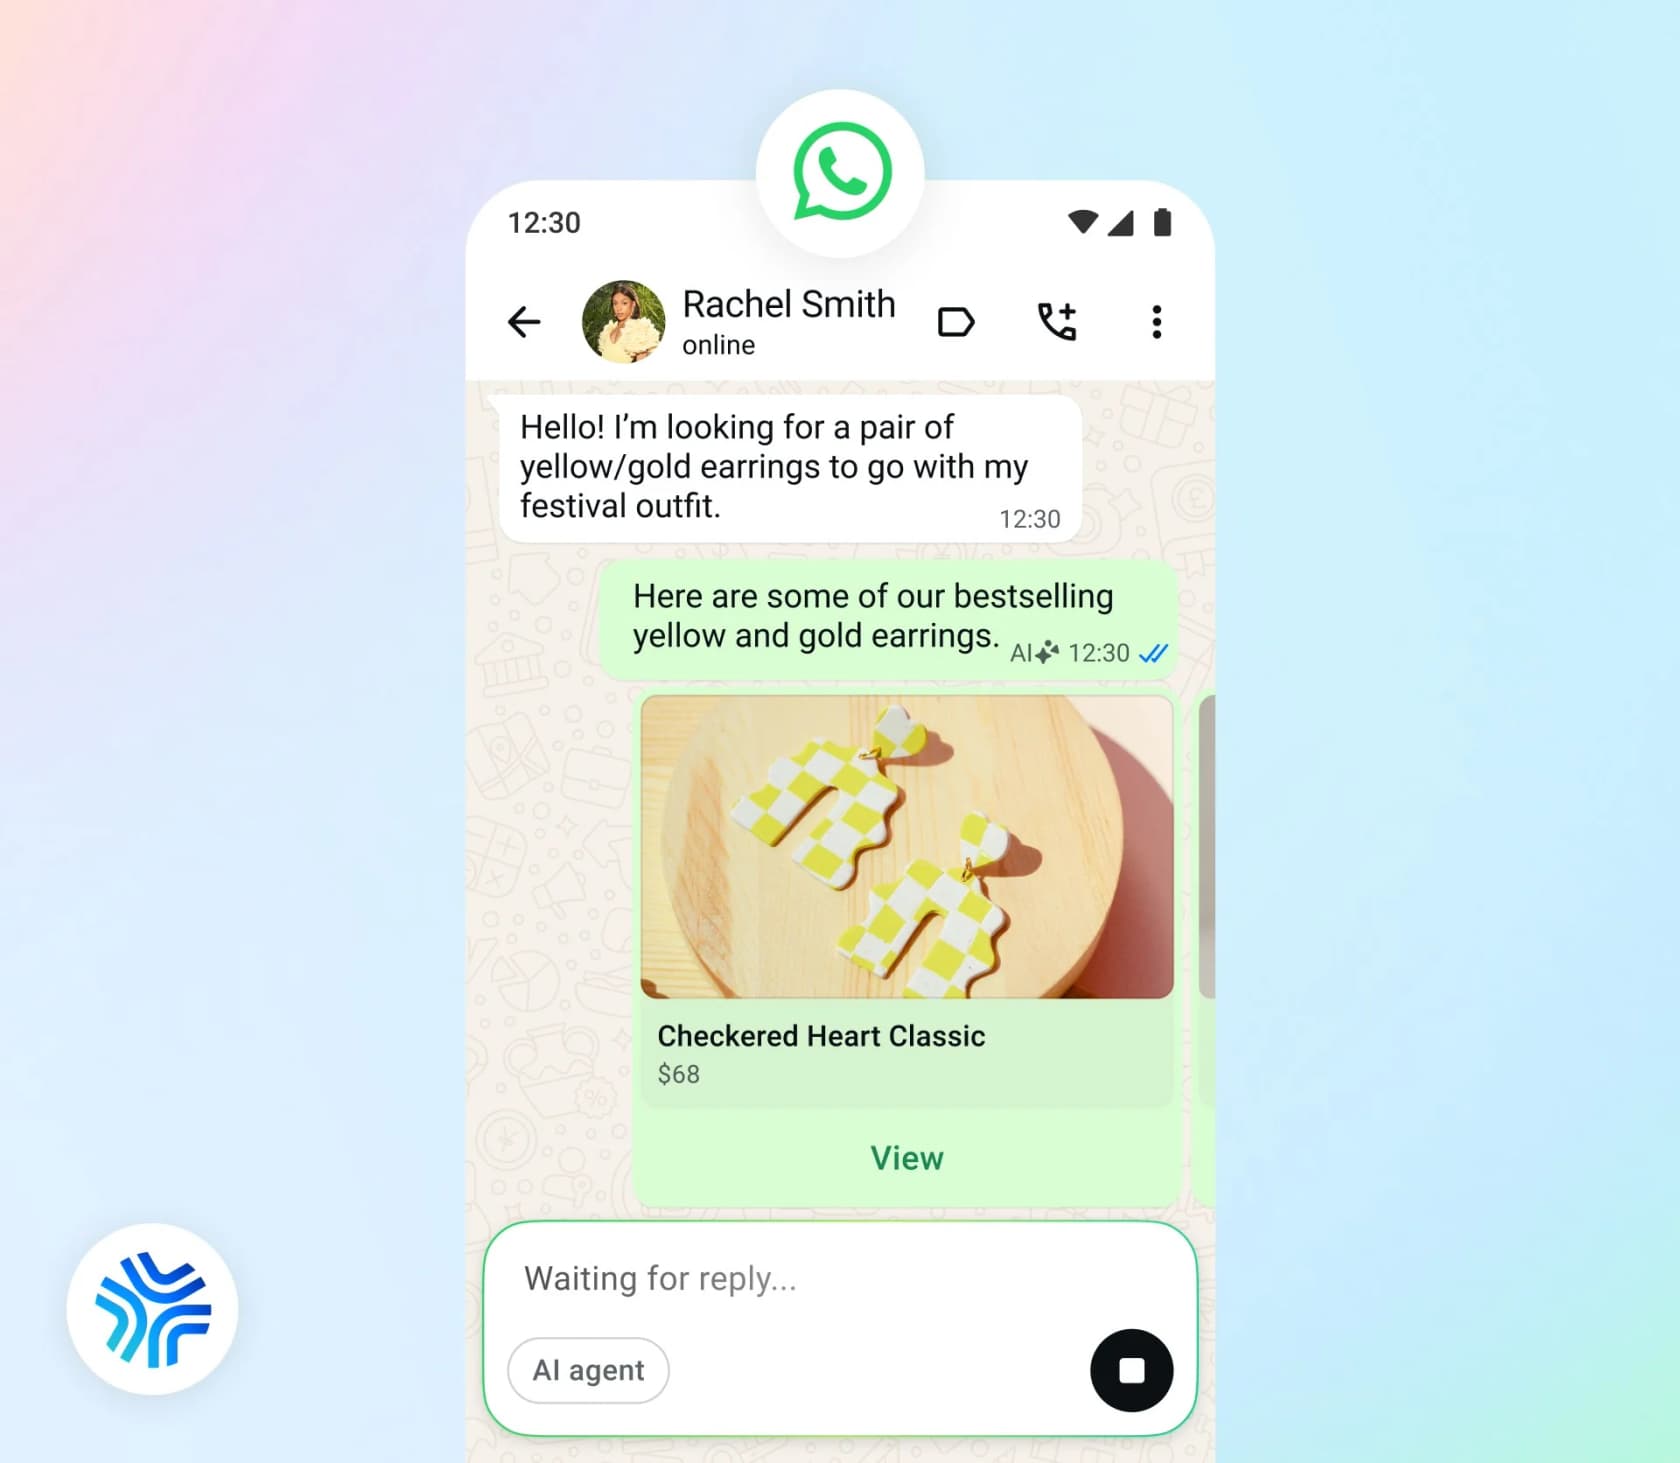
Meta dice que "más de un millón de empresas ya usan un Meta Business Agent en WhatsApp y Messenger" (Meta Newsroom). Viene en dos niveles. El nivel de autoservicio vive en Meta Business Suite y en la app WhatsApp Business. La Meta Business Agent Platform es la versión por API para empresas en la WhatsApp Business Platform. Gestionan el conocimiento de forma muy distinta, así que los veré uno por uno.
Para la división de productos en general, consulta la guía de mi equipo sobre Meta Muse para atención al cliente.
Las cuatro fuentes de conocimiento que lee Business Agent
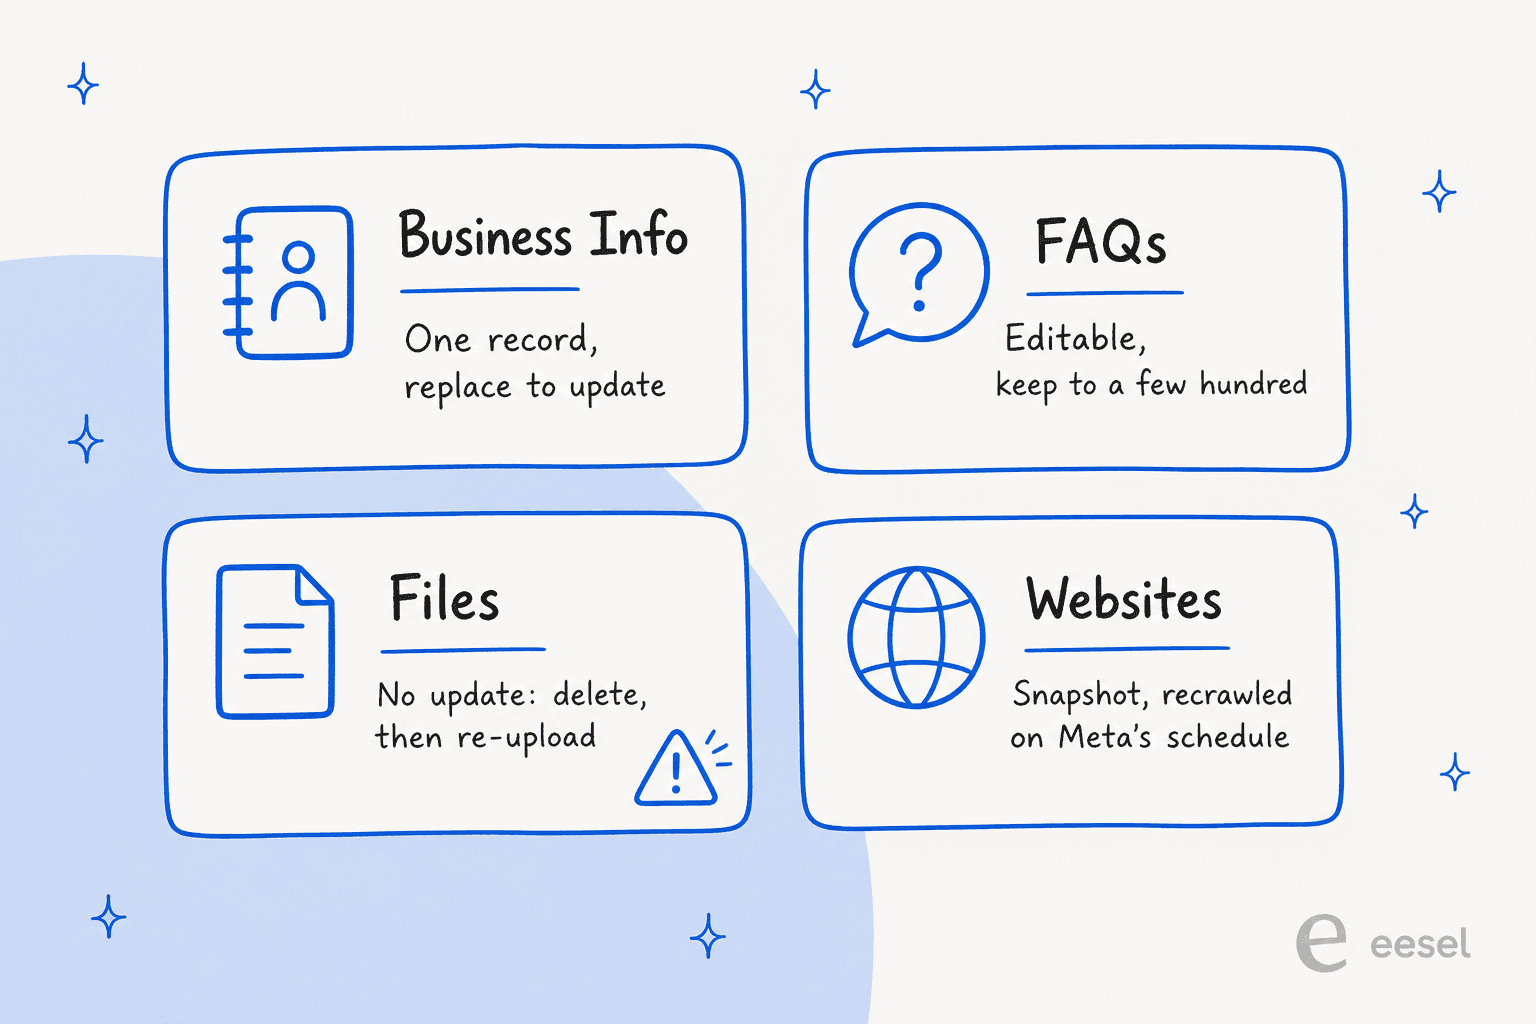
En el nivel Platform, el conocimiento entra por cuatro endpoints que, según Meta, existen "para fundamentar a Meta Business Agent en el contenido de tu negocio, de modo que responda con precisión y resuelva más preguntas sin derivar" (Capabilities). No hay un importador para un centro de ayuda, wiki o helpdesk. Todo llega por una de estas cuatro:
| Fuente | Qué entra | Cómo la cambias | Límites que documenta Meta |
|---|---|---|---|
| Business Info | Métodos de pago, devoluciones, envíos, contacto y ubicación | Un registro por número; PUT lo reemplaza | Singleton |
| FAQ | Pregunta, respuesta, metadatos opcionales | Se edita en el lugar con PUT | "En general más de unos cientos" degrada la recuperación |
| Archivos | PDF, DOC, DOCX, PNG, JPG, además de CSV/XLSX si está habilitado | Sin llamada de actualización: eliminar y volver a subir | 100 MB por archivo |
| Sitios web | Páginas públicas rastreadas, acotadas por subdominio y patrón de URL | Rastreo periódico, sin intervalo indicado | Instantánea en el momento del rastreo |
Los límites vienen de la página de referencia de cada fuente, como las referencias de Business Info y Sitios web. Cada recurso comparte un presupuesto de 1.000 solicitudes por hora.
El orden también importa. Las FAQ ganan sobre todo lo demás. "El agente recupera cada entrada de forma independiente y responde a partir de ella, en lugar de inferir una respuesta desde tus otras fuentes de conocimiento" (referencia de FAQ). Los archivos son el plan B: "El agente recurre al contenido de los archivos cuando ninguna entrada de FAQ coincide con la pregunta del cliente" (referencia de Archivos). Así que tu conjunto de FAQ es la parte que más consultan los clientes, y también la que más editarás.
El idioma es el único punto donde Meta te ahorra trabajo. El agente "lee tus fuentes de conocimiento en su idioma original y responde en el idioma de destino, así que no necesitas localizar tus fuentes de conocimiento" (Capabilities). Un solo conjunto de FAQ cubre todas las configuraciones regionales, y el inglés recibe las mejores respuestas. Es una ventaja real frente a los conjuntos de artículos por idioma de un centro de ayuda multilingüe.
Mantener cada fuente al día
Este es el día a día de gestionar la base de conocimiento con Meta: cuatro fuentes, cuatro maneras distintas de quedarse obsoletas.
Archivos: la trampa de la política desactualizada
Esta es la que pegaría en el monitor. La propia guía de soporte de Meta lo dice claro: "No hay llamada de actualización. Para reemplazar un documento, elimina la entrada antigua y sube la nueva; de lo contrario, el agente recurre a ambas versiones y puede citar una condición que ya retiraste" (guía de atención al cliente).
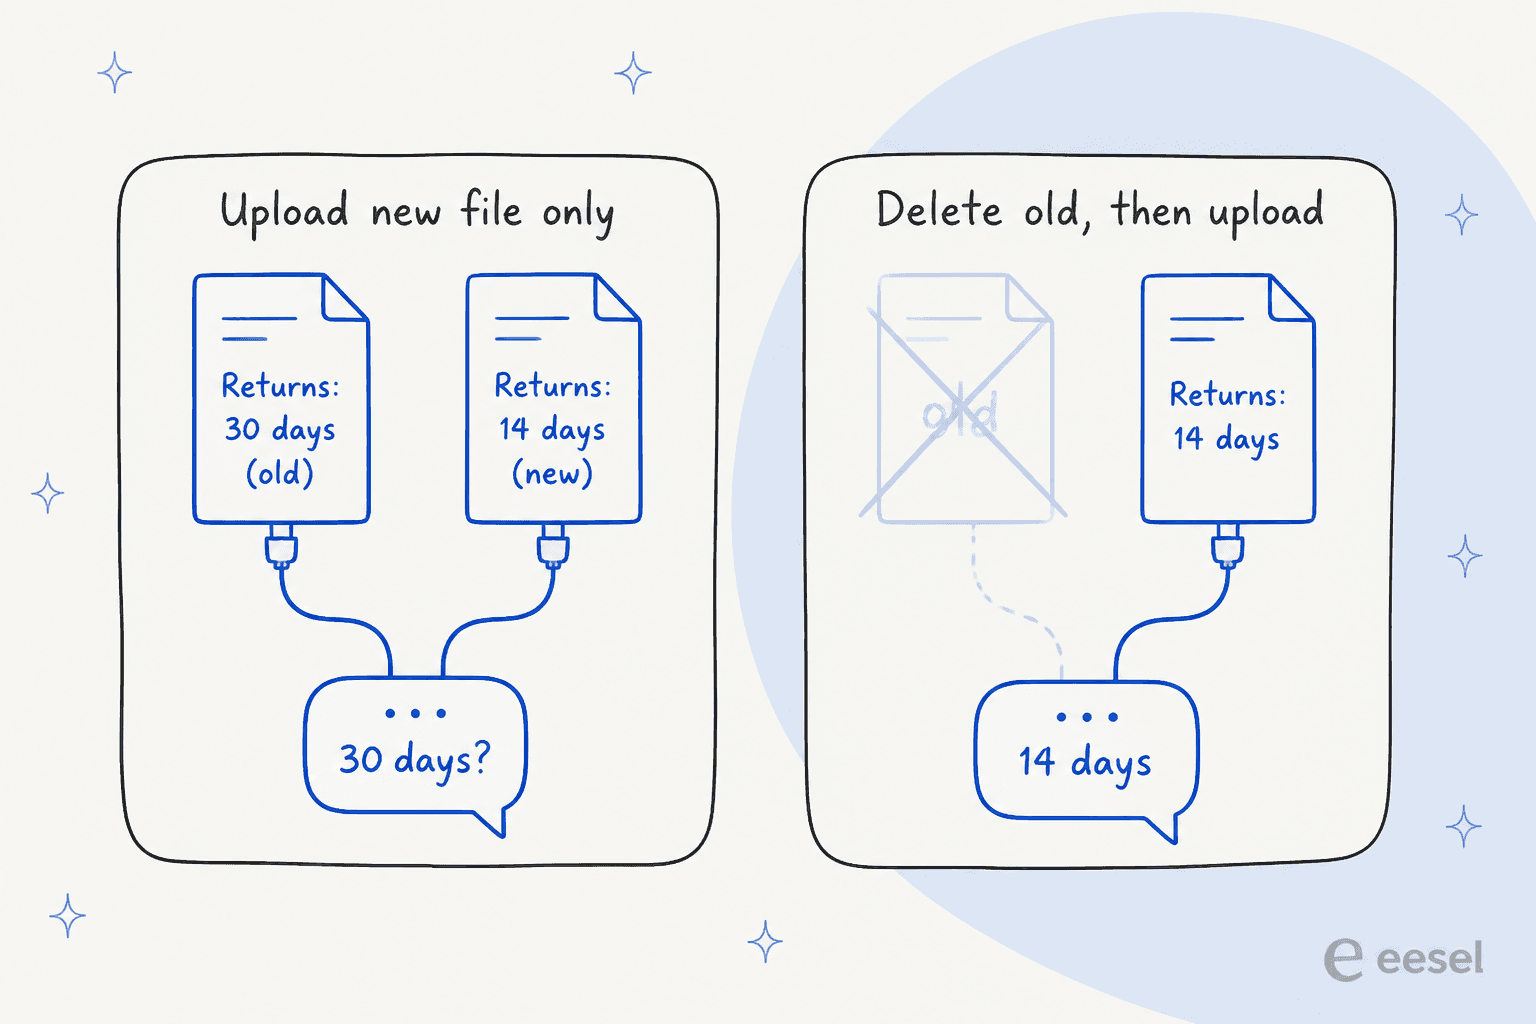
Imagínalo: acortas tu plazo de devolución de 30 a 14 días, subes returns-policy-v2.pdf y sigues con lo tuyo. Ahora los dos PDF están activos. Un cliente pregunta de cuánto tiempo dispone y el agente puede responder desde cualquiera de los dos. La llamada de listado tampoco ayuda mucho, ya que solo devuelve el id y el file_name de cada archivo, "no su contenido" (referencia de Archivos). Si tus nombres de archivo no son disciplinados, no puedes saber qué subida contiene qué versión.
La solución es un script de sincronización que siempre elimine por file_id antes de subir. Meta también advierte contra el volumen: "un conjunto grande de documentos hace que el agente tarde más en encontrar el pasaje correcto, y las preguntas que más importan suelen atenderse mejor con una entrada de FAQ precisa que con una página de condiciones" (guía de atención al cliente).
Sitios web: una instantánea, no un enlace en vivo
El conocimiento de sitios web "es una instantánea tomada en el momento del rastreo" (guía de atención al cliente). Meta dice que los sitios "se vuelven a rastrear periódicamente para que el conocimiento del agente siga actualizado", pero no da un intervalo (referencia de Sitios web). Puedes consultar crawl_status y last_crawled_at, pero la tabla de endpoints no tiene una llamada explícita de "volver a rastrear ahora". Si publicas un cambio de precio a las 9 de la mañana, no sabes cuándo lo verá el agente.
El alcance es la otra palanca. Por defecto se rastrea todo el dominio, y Meta advierte de que "rastrear un sitio de comercio completo arrastra miles de páginas de producto, lo que diluye el contenido de ayuda desde el que debería responder el agente." Usa included_url_patterns para apuntar solo a tus páginas de ayuda. El rastreador no acepta credenciales, así que nada tras un inicio de sesión (una wiki interna, un portal cerrado de socios) puede entrar por esta vía. Mi equipo abordó ese problema específicamente para Confluence y Document360.
FAQ: editables, pero escasas en control
Las FAQ son la fuente más amable. Puedes editar una en el lugar, y "reformular la question cambia con qué mensajes de clientes se empareja la entrada; reformular la answer cambia lo que responde el agente" (referencia de FAQ). Eliminar es limpio: "El agente deja de responder desde ella."
Lo que falta es todo lo que un gestor del conocimiento llamaría metadatos. La respuesta incluye un id y created_at, pero no updated_at, estado ni responsable. La llamada de listado devuelve todas las entradas como un solo arreglo, sin filtro ni paginación. No hay importación masiva ni webhook cuando algo cambia. Si quieres saber qué FAQ se revisó por última vez en marzo, escribe esa fecha tú mismo en el campo opcional metadata.
El consejo de Meta sobre de dónde debe salir la lista de FAQ es revelador: "Exporta los principales motivos desde tu helpdesk, escribe una entrada por motivo con las palabras del comprador" (guía de atención al cliente). Meta da por hecho que los datos de motivos de contacto viven en tu helpdesk, no en Meta. Estoy de acuerdo, y importará más adelante.
Business Info e instrucciones
Business Info es un único registro por número que reemplazas por completo. El comportamiento vive en las instrucciones del agente (la API ahora las llama skills), limitadas a 20.000 caracteres cada una, y cada una nueva o editada pasa primero por una revisión automática. Una marcada como blocked es una que "el agente nunca aplica", "casi siempre porque el texto pide o se refiere a información personal sensible" (referencia de instrucciones del agente). Revisa el estado después de cada edición, o un cambio de política puede quedar sin aplicar sin que te des cuenta.
El nivel de autoservicio: aprender de tus respuestas
El producto de autoservicio funciona de forma muy distinta a la API, y para un negocio pequeño maneja el conocimiento mejor de lo que cabría esperar.
El agente aprende de "tu página de Facebook, chats anteriores y sitio web", y puedes "subir catálogos de productos o listas de precios" (página de Messenger). También aprende mientras trabajas: "Cuando escribes manualmente a un cliente en un chat en el que Meta Business Agent está respondiendo, el Business Agent puede guardar mensajes que contengan información nueva sobre tu negocio" (página de ayuda para enseñar y probar).
Lo que más me gustó es que puedes ver lo que aprendió. En Business Suite, ve a Meta Business Agent, luego a Your info, y "revisa cualquier información en Other info para asegurarte de que tu Meta Business Agent ha aprendido correctamente sobre otras áreas de tu negocio." Puedes buscarla, abrir cualquier elemento y eliminarlo. En la app WhatsApp Business, la pantalla de inicio del agente te permite "consultar el nuevo conocimiento que tu Business Agent ha aprendido" (página de ayuda de configuración).
Para corregir una mala respuesta existe Improve AI response, en el chat de prueba o sobre un mensaje real de la bandeja de entrada. Escribes la respuesta correcta o una instrucción y guardas. La salvedad de Meta merece leerse dos veces: "No responderá con tus palabras exactas. Las respuestas existentes no se actualizarán." Y a veces el agente te pregunta directamente, escribiéndote desde su página oficial "para revisar o añadir conocimiento que debería saber."
Es un verdadero circuito de revisión, y le sirve al dueño que atiende a los clientes desde el móvil. Dos límites impiden que escale a un equipo de soporte. La lista de datos aprendidos y el aprendizaje a partir de respuestas manuales están documentados solo para autoservicio; ningún endpoint de Platform los expone. Y no hay una lista de las preguntas que el agente no pudo responder. Te enteras cuando "se te notifica que tomes el chat."
Descubrir lo que el agente no sabe
Este es el corazón de la gestión de la base de conocimiento y la parte que Meta deja más en tus manos. Estas son todas las señales de huecos que Meta ofrece en el nivel Platform:
| Herramienta | Qué te dice | Qué no |
|---|---|---|
| Agent Test | La respuesta a un mensaje de prueba, más handoff_reason. Los tokens de prueba "no se facturan" | De qué FAQ, archivo o página salió la respuesta. Sin modo por lotes; 500 llamadas por hora por número |
| Agent Eval | Puntúa escenarios simulados de 1 a 5 con un modelo juez, devuelve top_failure_categories con acciones recomendadas | Nada sobre clientes reales. Solo está documentado un endpoint para listar casos, ninguno para crearlos |
| Métricas de conversación | ai_threads (chats en los que el agente respondió) y ai_handoffs (una instantánea en vivo) | Temas, intenciones, preguntas sin responder, resolución |
| Turnos de conversación | Traza paso a paso para un cliente | Una forma de listar todas las conversaciones |
| Webhooks standby | La transcripción completa antes de una derivación | Un motivo asociado a la derivación |
Agent Eval es lo más parecido a un informe de huecos, y es una buena herramienta. Pero responde a "¿cómo maneja mi agente los escenarios que se me ocurrieron?", no a "¿qué preguntaron los clientes la semana pasada para lo que no teníamos respuesta?" Las preguntas que duelen son aquellas para las que nadie pensó en escribir un escenario.
La propia guía de Meta nombra el riesgo real: "los fallos que importan son respuestas seguras a preguntas para las que no tenía base" (guía de atención al cliente). Un consultor de BSP que probó el agente pronto vio justo eso:
"La consistencia es un problema. Vi el mismo producto volver con dos precios distintos en dos respuestas. Si no lo fundamentas bien, simplemente se inventa cosas."

Dos precios en dos respuestas es lo que parece, desde el lado del cliente, un archivo desactualizado junto a uno nuevo. Hemos visto el mismo fallo en eesel. El bot de un proveedor danés de energía solar inventó afirmaciones sobre suscripciones y las envió a clientes reales cuando su base de conocimiento no tenía coincidencia, por eso cada agente de eesel tiene ahora una respuesta alternativa de negarse a contestar y se simula contra tickets pasados antes de salir en vivo. Para más sobre este fallo, consulta la publicación de mi equipo sobre alucinaciones de la IA.
Una rutina semanal de conocimiento para un agente de Meta
Si ejecutas Business Agent en el nivel Platform, este es el circuito que yo construiría. Meta cubre uno de sus cuatro pasos.
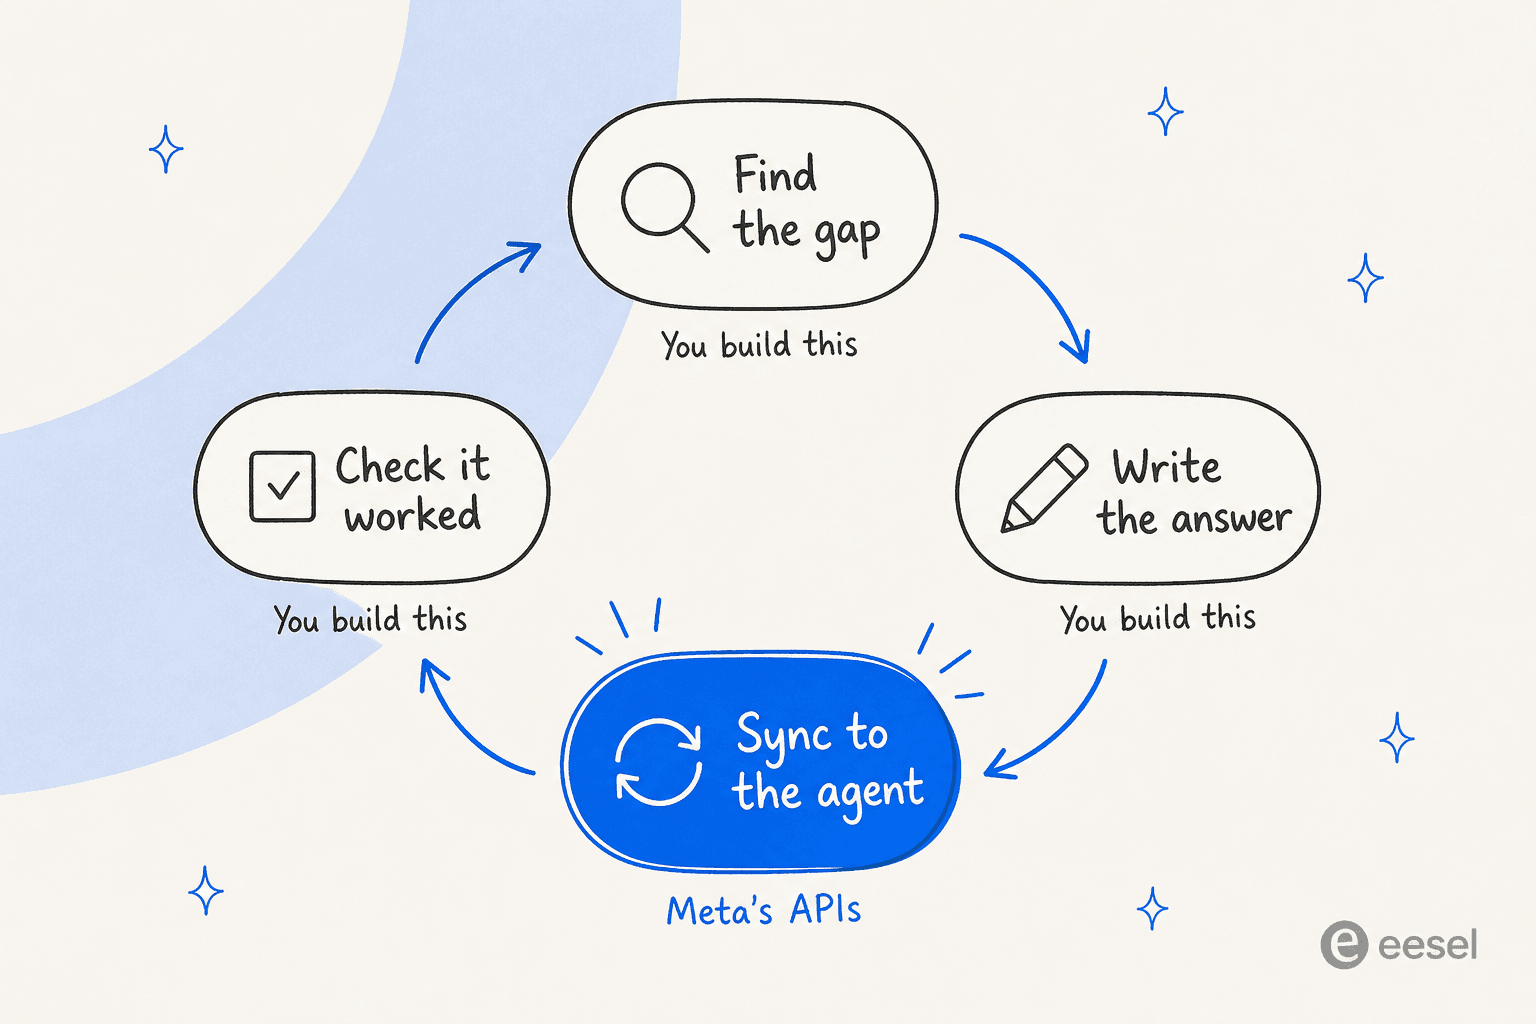
- Registra cada derivación. Suscríbete a los webhooks standby y guarda la transcripción previa a cada derivación. Es tu flujo de huecos en vivo, ya que la baja confianza es uno de los tres disparadores automáticos de derivación (Capabilities).
- Agrupa por tema las derivaciones de la semana. Meta no lo hará, así que usa las etiquetas de tu helpdesk o un clasificador pequeño. Los cinco grupos principales son la lista de redacción de la próxima semana, la misma idea que encontrar artículos que faltan en un centro de ayuda. La guía de mi equipo sobre análisis de huecos de conocimiento recorre el método.
- Escribe primero la corrección como FAQ. Las FAQ se consultan antes que los archivos y se editan sin problemas. Haz que cada respuesta se baste sola (la guía de mi equipo sobre redactar artículos de KB con IA ayuda aquí) y pon un responsable y una fecha de revisión en
metadata. - Sincroniza eliminando antes de subir. Para cualquier archivo modificado, elimina el
file_idantiguo y luego sube. Para cambios en el sitio web, compruebalast_crawled_atantes de dar por hecho que el agente los tiene. - Vuelve a probar el grupo. Pasa las preguntas reales de derivación de la semana por Agent Test (gratis, 500 por hora) y lee las respuestas. Todo lo que siga derivando vuelve al paso 3.
Para una persona con unas decenas de FAQ, es una tarde a la semana. Para un equipo con miles de tickets al mes, es una pequeña herramienta interna y un sistema más que mantener junto a tu helpdesk.
Lo que cuesta gestionar la base de conocimiento en Meta
Las API de conocimiento en sí no llevan una tarifa aparte en la documentación de Meta. Los contadores están en las conversaciones.
| Concepto | Costo |
|---|---|
| Respuestas de Business Agent | 2,00 $ por 1 M de tokens en la WhatsApp Business Platform, unos 4 a 5 centavos por mensaje (precios) |
| Llamadas de Agent Test | No se facturan |
| Respuestas humanas tras una derivación | Los primeros 1.000 mensajes de servicio por número al mes son gratis, luego se cobra por mensaje desde el 1 de octubre de 2026 |
| Tu sincronización, registro y agrupación | Tu propio alojamiento y tiempo de ingeniería |
La tercera fila vuelve al conocimiento. Cada pregunta que tu conocimiento no puede responder se convierte en una derivación, y desde el 1 de octubre cada respuesta humana pasado el nivel gratuito es un mensaje facturable. Un hueco de conocimiento ahora te cuesta dos veces: una en los tokens del agente y otra en las respuestas de tu equipo. El historial completo de tarifas está en el desglose de mi equipo sobre los precios de la API de WhatsApp.
Dónde se queda corta la pila de Meta para gestionar la base de conocimiento
Para ser justos con Meta, el modelo de conocimiento de Business Agent es limpio. Cuatro fuentes bien documentadas, FAQ con prioridad, llamadas de prueba gratuitas y traducción resuelta por ti. Para una tienda centrada en WhatsApp con una lista de FAQ ordenada, es una configuración sensata, y mi equipo la ha analizado junto a Zendesk y Freshdesk. Para la gestión de la base de conocimiento en concreto, esto es lo que yo sopesaría:
- Sin informe de huecos en vivo. Agent Eval cubre escenarios que tú escribiste. Nada lista las preguntas reales que no pudo responder.
- Sin fuentes de las respuestas. Agent Test no dice de qué FAQ, archivo o página salió una respuesta, así que depuras adivinando.
- Los archivos no se actualizan. Si olvidas el paso de eliminar, dos versiones de una política quedan activas a la vez.
- Sin sincronización desde ningún lado. Sin importador de helpdesk, wiki o centro de ayuda, y sin webhooks de cambios. Cada sincronización es un script que mantienes tú.
- Los tickets pasados no son una fuente. Meta te dice que exportes los motivos de contacto desde tu helpdesk y los reescribas como FAQ. Los miles de tickets resueltos de tu equipo, el mejor registro de lo que preguntan los clientes, quedan fuera del agente.
Una regla más que conviene planificar: un número ejecuta una IA. "Una integración activa de agente autorizado bloquea a Meta Business Agent" (descripción general), así que no puedes ejecutar el agente de Meta y otra IA en paralelo en el mismo número. La postura más amplia de Meta está en el análisis de mi equipo sobre la política de Meta para IA de terceros.
El informe de huecos es el gestor del conocimiento
Este es el cambio que me gustaría que se llevara el lector. La gestión de la base de conocimiento suele plantearse como un trabajo de redacción: mejores artículos, FAQ más limpias, PDF más frescos. En la práctica, escribir es la parte fácil, y la IA ya puede redactar artículos de todos modos. Lo difícil es saber qué escribir, y esa lista vive en tus tickets, no en tus documentos.
Aparece constantemente en las llamadas de ventas de eesel. Un equipo de SaaS B2B pidió una IA que responda a partir de su guía de usuario, Slack, KB interna y tickets pasados, y que luego redacte artículos nuevos con los huecos que encuentre. Eso no es pedir un chatbot de base de conocimiento más listo. Es pedir la lista de huecos.
Por eso juzgaría la configuración de conocimiento de cualquier agente de IA con una pregunta: ¿puede decirme, a partir de las conversaciones reales del mes pasado, en qué temas se habría equivocado? La pila de Meta puede decirte cuántos chats se derivaron. No puede decirte por qué.
El mismo patrón aparece cuando pruebas Meta para control de calidad del soporte o triaje de tickets. Para una visión más amplia de las herramientas pensadas para esto, consulta el repaso de mi equipo sobre herramientas de gestión de KB, o la guía para detectar contenido desactualizado del centro de ayuda.
Prueba eesel para gestionar la base de conocimiento
eesel aborda esto desde el otro extremo. Es un compañero de helpdesk con IA que se conecta a WhatsApp y trabaja dentro de tu helpdesk, y aprende de los lugares donde tu conocimiento ya vive: tu centro de ayuda, tickets resueltos, Google Drive, Confluence, Notion y archivos subidos, con sincronización automática. La subida de archivos admite PDF, DOCX, TXT, Markdown, CSV, XLSX, HTML y más, y los archivos nuevos se "procesan e indexan automáticamente" (subir archivos).

La parte que encaja con este artículo es la Simulación. "Reproduce tus tickets pasados y puntúa sus respuestas frente a lo que tu equipo envió realmente" (documentación de helpdesk), y devuelve "un informe puntuado de cómo tu agente maneja un lote de tickets reales, con los huecos específicos y las correcciones sugeridas" (documentación de Informes). La vara de medir son las respuestas de tu propio equipo a tus propios tickets, no un escenario que alguien tuvo que imaginar. En la práctica se lee así: "23 tickets la semana pasada preguntaron por reembolsos prorrateados, pero tus documentos solo cubren cancelaciones totales." Añades el documento, vuelves a ejecutar y ves subir la cobertura de ese tema.
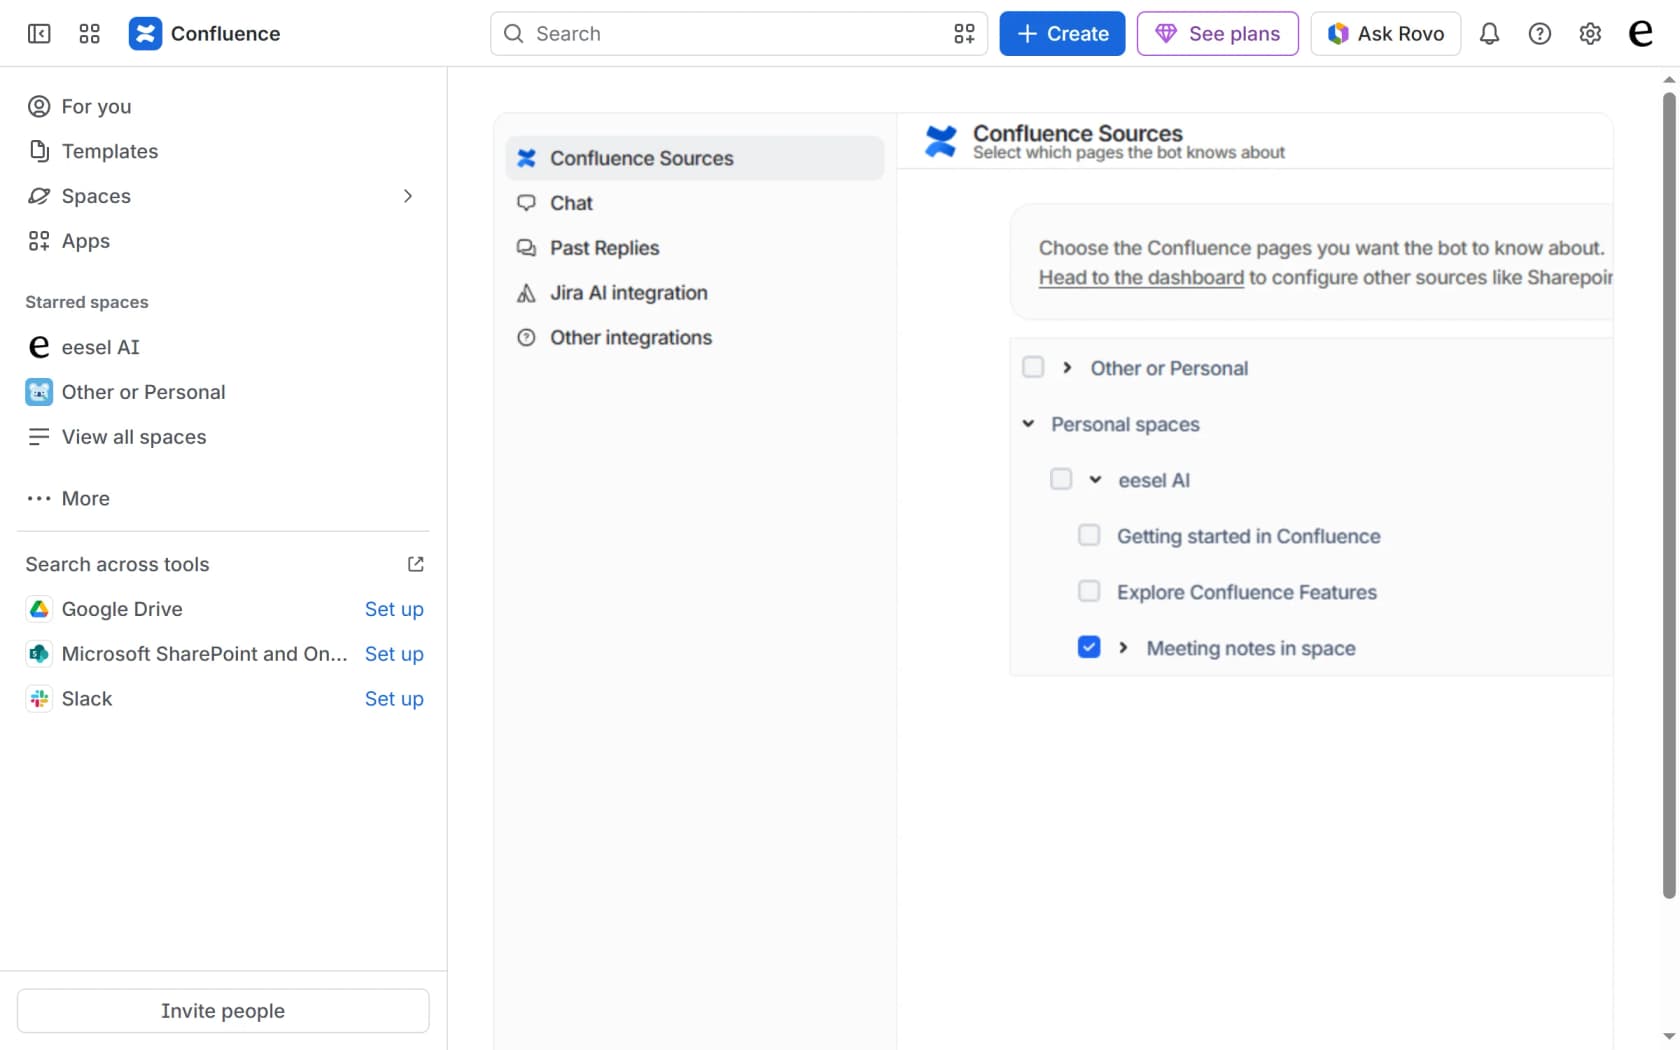
Si prefieres automatizarlo con scripts, la CLI de eesel ejecuta el mismo compañero y espacio de trabajo desde una terminal, y cada comando imprime JSON. Tú o un agente de programación como Claude Code pueden lanzar una simulación tras un cambio de documentos, leer el informe de huecos y revisar la actividad del agente en busca de respuestas de baja confianza, todo sin abrir el panel. También hay una API de agente de atención al cliente si lo conectas a tus propias herramientas.
Una nota honesta. Si WhatsApp es tu único canal, tu conocimiento es una lista ordenada de 50 FAQ y una sola persona lee cada derivación, el agente de autoservicio de Meta y su lista de revisión Other info son una opción razonable y barata. Por la regla de una IA por número, elegirías eesel o Meta Business Agent para un número dado, no ambos. Si tus respuestas viven repartidas entre un centro de ayuda, una wiki y años de tickets resueltos, y las preguntas llegan tanto por correo como por WhatsApp, un informe de huecos construido con tickets reales te ahorra construir tú mismo el circuito anterior. Los precios son un plan mensual fijo de créditos, donde un ticket o chat equivale a un crédito sin importar cuántas respuestas requiera.
Prueba eesel gratis y ejecuta una simulación con los tickets del mes pasado para ver tu lista de huecos antes de salir en vivo.
Preguntas frecuentes
¿Puedo usar Meta Muse para la gestión de la base de conocimiento?
¿Qué fuentes de conocimiento usa Meta Business Agent?
¿Cómo actualizo un archivo en la base de conocimiento de Meta Business Agent?
¿Con qué frecuencia vuelve Meta a rastrear mi sitio web para el agente?
last_crawled_at después de cambiar una página y limita el rastreo a tus páginas de ayuda para que los listados de productos no desplacen las respuestas. Consulta detectar contenido de ayuda desactualizado para localizar páginas obsoletas.¿Cuántas FAQ puede manejar Meta Business Agent?
¿Meta Business Agent muestra qué preguntas no pudo responder?
¿Cuánto cuesta Meta Muse para la gestión de la base de conocimiento?
¿Cuál es una buena alternativa a Meta Business Agent para gestionar la base de conocimiento?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.