

Por qué veo a Hermes como mantenedor de la KB, no como la KB
Trabajo la cola de soporte de eesel todos los días, y cuando una respuesta de IA sale mal, rara vez el culpable es el modelo. Es el artículo de ayuda. Una responsable de soporte de un servicio de seguimiento de autobuses, con 200 a 250 tickets de Zendesk al mes, se dio cuenta en una llamada con nosotros de que toda su base de conocimiento estaba escrita para administradores mientras que los tickets venían de pasajeros. Cada respuesta era técnicamente correcta y prácticamente inútil. Otro equipo, un proveedor danés de energía solar, vio cómo un bot inventaba respuestas y las enviaba a clientes reales cada vez que su base de conocimiento no tenía coincidencia.
Así que "¿puede un agente de IA gestionar mi base de conocimiento?" son en realidad dos preguntas. ¿Puede contener el conocimiento y puede mantenerlo al día? Para Hermes Agent, el agente de código abierto de Nous Research, las respuestas honestas son "no" y "sí, con cuidado".
Hermes es un agente autoalojado con licencia MIT que usted ejecuta en su propia máquina o servidor, y uno de los mejores agentes de IA de código abierto que hay. Si es nuevo en él, mi reseña de Hermes Agent cubre lo básico.
Las guías de atención al cliente y de soporte informático interno cubren los otros dos trabajos que la gente intenta darle. Esta trata del trabajo poco vistoso de la gestión de la base de conocimiento: mantener los artículos precisos, fáciles de encontrar y completos.
Qué sabe realmente Hermes (y dónde lo guarda)
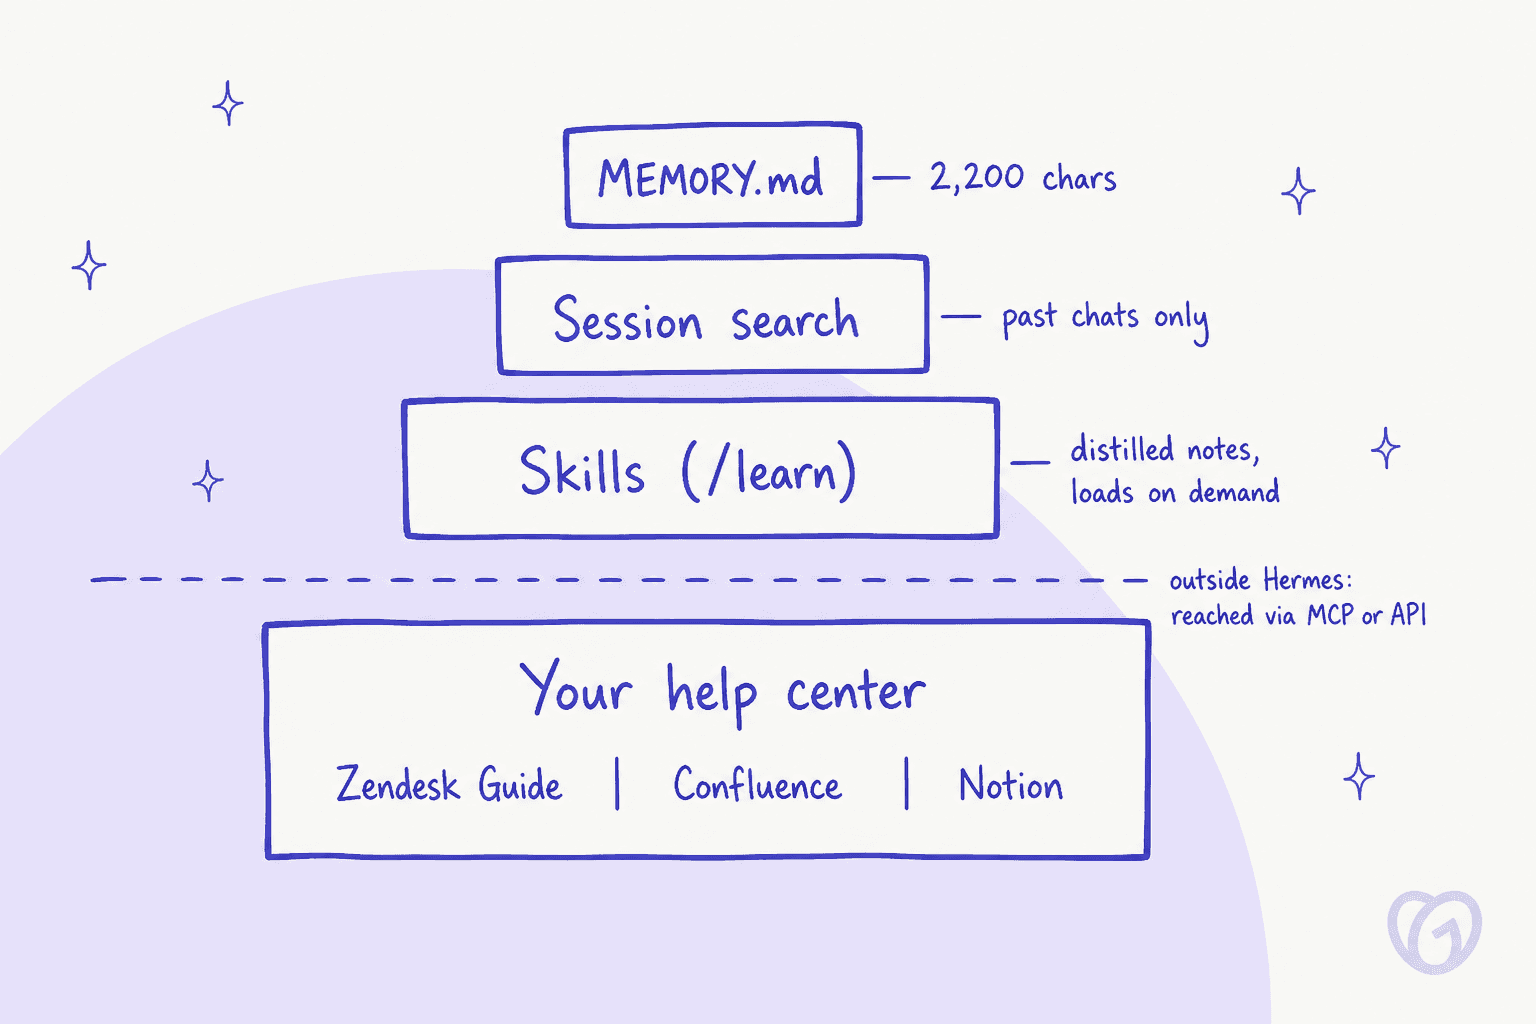
Hermes tiene cuatro lugares donde puede residir el conocimiento, y son de tamaños muy distintos. Gran parte de la confusión sobre "Hermes como base de conocimiento" viene de mezclarlos.
Memoria: pequeña a propósito
La memoria persistente de Hermes son dos archivos. MEMORY.md guarda las notas propias del agente con 2,200 caracteres (unos 800 tokens), y USER.md guarda su perfil con 1,375 caracteres. Eso son unas 8 a 15 entradas. Ambos se cargan en el prompt del sistema como una instantánea congelada al iniciar una sesión, y la memoria no se compacta sola: una escritura por encima del límite devuelve un error y el agente tiene que hacer sitio.
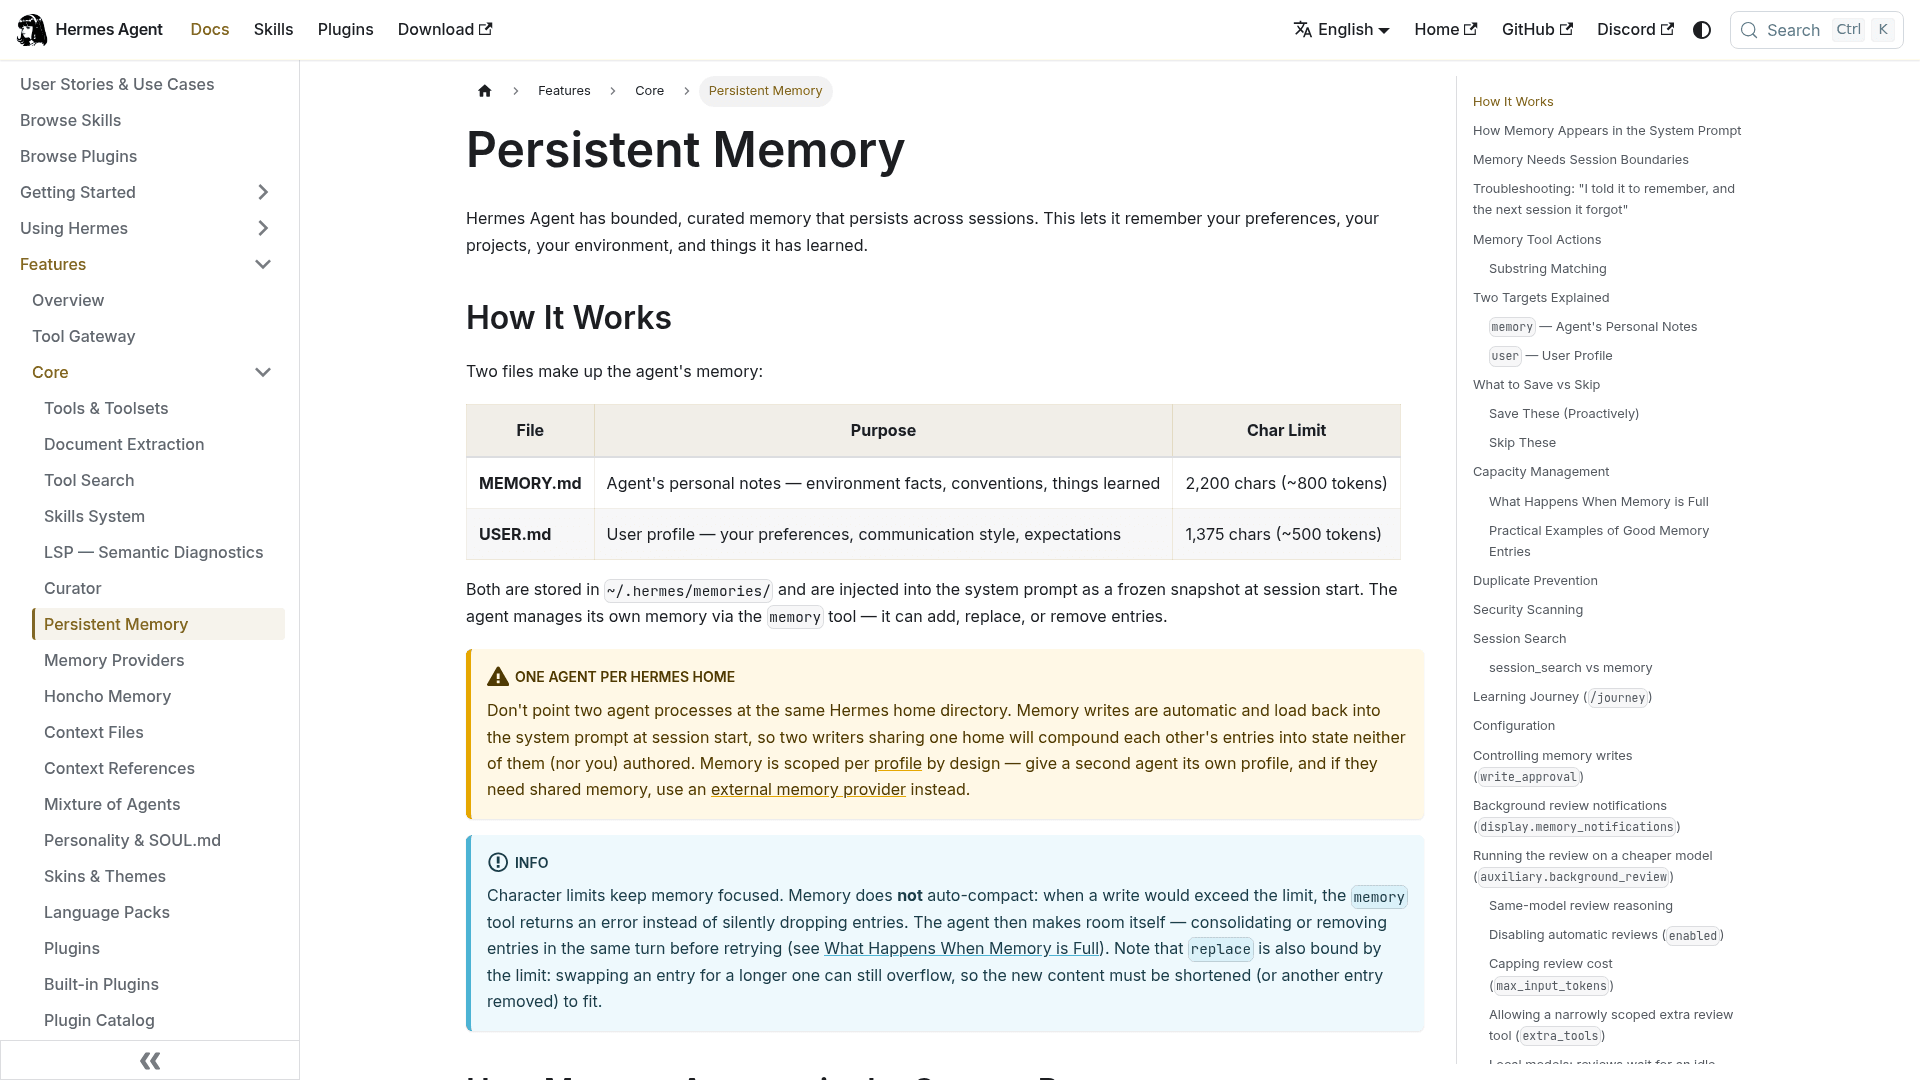
La documentación es refrescantemente directa sobre lo que no pertenece ahí. Los "Raw data dumps" están en la lista de lo que se omite, y para cualquier cosa que el agente necesite en cada ejecución, la documentación dice que un skill es "often the better home than a memory entry". Un solo artículo de ayuda sobre su política de reembolsos consumiría una buena parte de ese presupuesto. Un centro de ayuda no cabe, y nunca estuvo pensado para caber.
Búsqueda de sesiones: conversaciones, no documentos
session_search ejecuta una búsqueda de texto completo en SQLite sobre cada chat pasado, a unos 20 ms por consulta, sin llamadas al modelo. Es ideal para "¿lo hablamos la semana pasada?". No indexa archivos, documentos ni su centro de ayuda. Un documento solo se vuelve buscable aquí si su texto apareció en una conversación pasada.
Skills: lo más parecido a una KB integrada
Los skills son documentos de conocimiento bajo demanda, que se cargan solo cuando son relevantes. El comando /learn convierte una carpeta de documentos o una URL en un "skill de base de conocimiento": un SKILL.md ligero más un archivo destilado por tema en references/. Volver a ejecutar /learn sobre el mismo tema incorpora el material nuevo al skill existente.
Dos salvedades importan para el trabajo de KB:
- Es un resumen, no un espejo. La documentación dice que la destilación "never reproduces passages of the source text". Eso es útil para enseñar al agente su producto, pero no es una copia de sus artículos que pueda citar a un cliente.
- Los skills sin uso se archivan. El curator marca como obsoletos los skills creados por el agente tras
14días sin uso y los mueve a una carpeta de archivo a los30. Un skill de conocimiento que solo toca durante una auditoría trimestral desaparecerá en silencio salvo que lo fije conhermes curator pin <skill>.
Su base de conocimiento real: fuera, accesible por MCP o API
Hermes no tiene RAG ni búsqueda vectorial integrados. La búsqueda semántica sobre documentos implica optar por algo: un proveedor de memoria externo (OpenViking y RetainDB son los dos documentados con ingesta de documentos, y RetainDB cuesta $20/month), el skill de búsqueda opcional qmd o un skill de base de datos vectorial que ejecute usted. Todo lo demás vive en su KB real, a la que Hermes accede mediante MCP, el protocolo de complementos que usa para herramientas externas, o mediante simples llamadas a API.
Esa separación es todo el modelo mental. Su centro de ayuda es la fuente de verdad. Hermes es un trabajador que lo visita, el mismo patrón que explico para conectar la IA al conocimiento de la empresa.
Los tres trabajos de KB que Hermes hace bien
Cuando deja de pedirle a Hermes que sea la base de conocimiento, se vuelve útil rápido. Estos son los tres trabajos que le daría.
1. Auditorías semanales de un wiki en markdown o un repositorio de documentación
El skill llm-wiki incluido (basado en la idea de LLM Wiki de Andrej Karpathy) construye una base de conocimiento en markdown con enlaces cruzados y trae una pasada de lint. Ese lint comprueba páginas huérfanas, enlaces rotos, entradas de índice que faltan, contradicciones, desfase respecto a las fuentes, páginas de más de 200 líneas y contenido obsoleto, definido como páginas cuya fecha updated es más de 90 días anterior a la fuente más reciente que menciona los mismos temas.
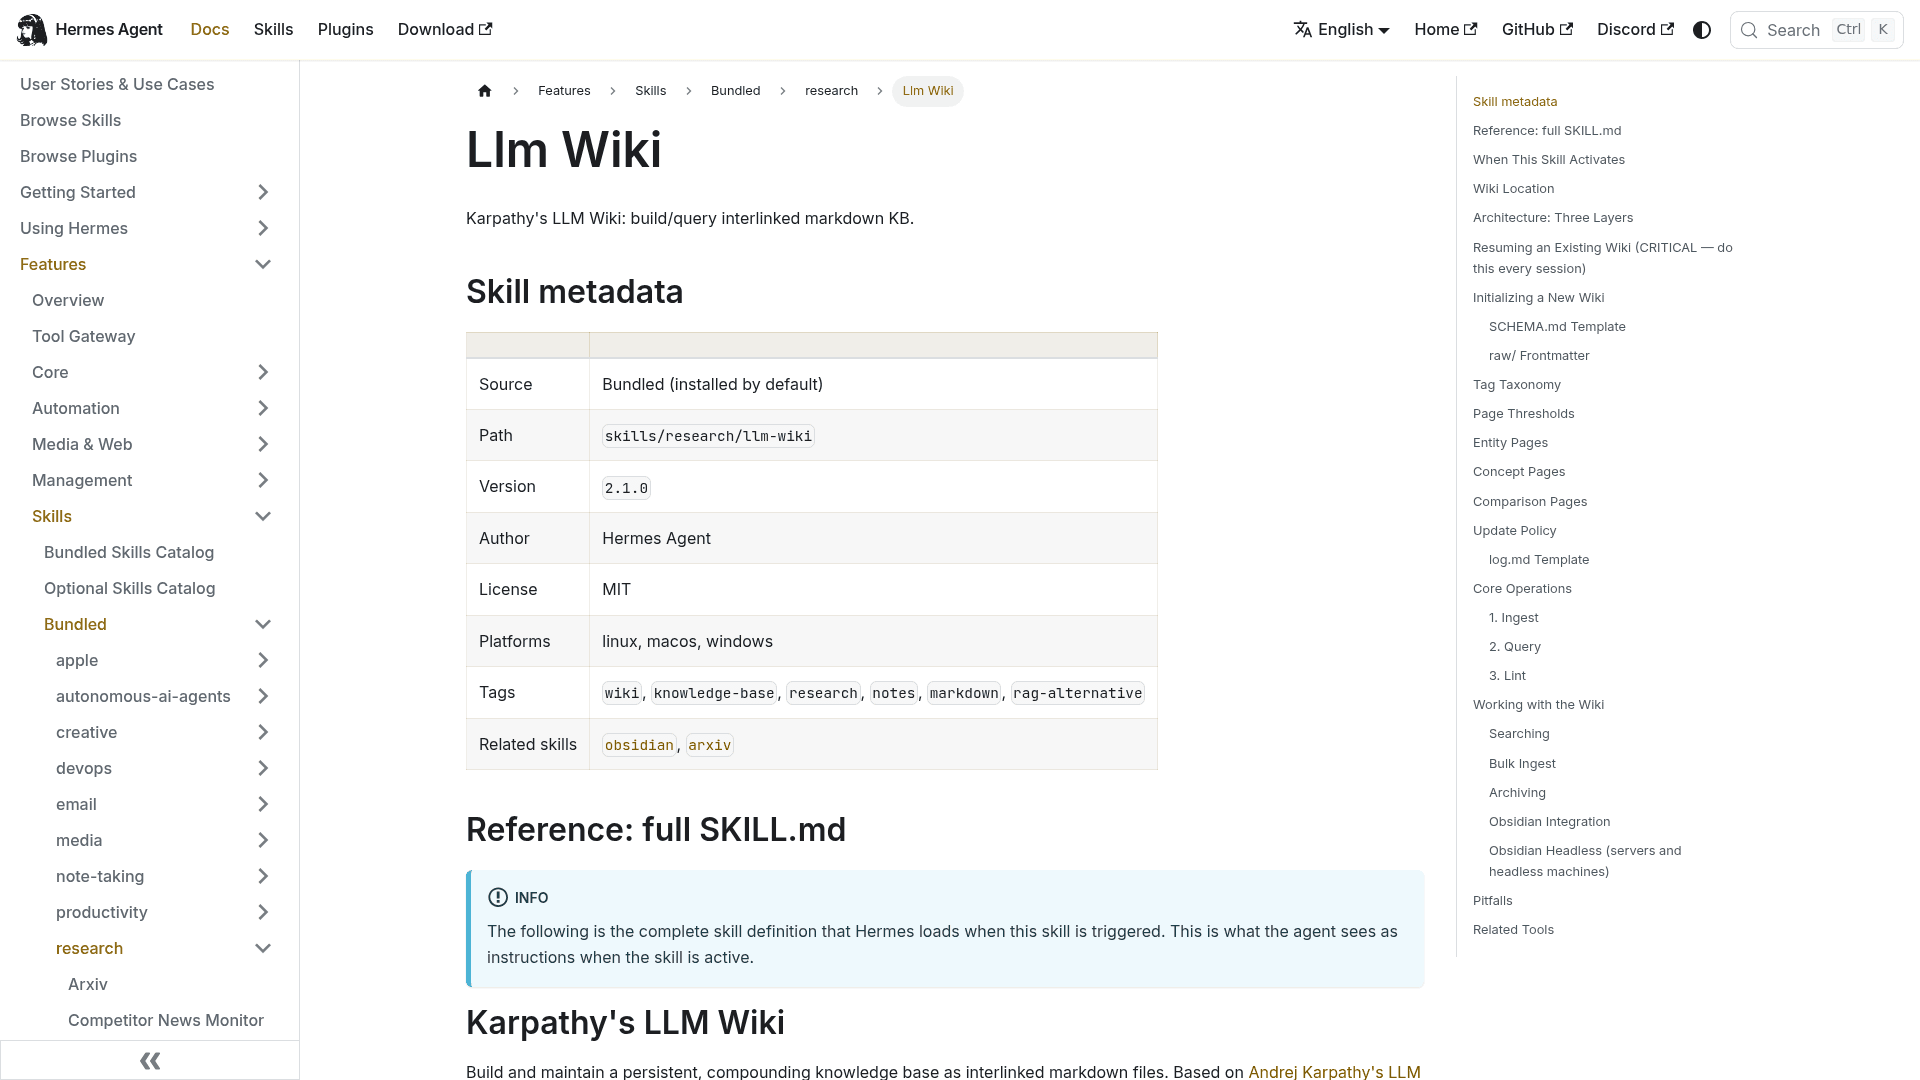
Eso es casi toda una auditoría de la base de conocimiento de soporte gratis, si sus documentos viven como markdown. Para equipos de docs-as-code, las herramientas de archivos de Hermes hacen el resto: read_file pagina archivos grandes (truncando pasados unos 100K caracteres), patch hace ediciones puntuales y devuelve un diff, y search_files es ripgrep por debajo.
2. Redactar artículos que faltan o están desactualizados
Hermes puede escribir artículos en Notion, Confluence, Freshdesk, Help Scout y GitHub a través del servidor MCP o la API de cada plataforma. El patrón que funciona es "redactar, no publicar": el agente escribe un artículo propuesto en un lugar donde una persona lo revisa. Un administrador de Zendesk en Reddit describió el mismo ciclo construido en Make.com años antes de que los agentes estuvieran de moda:
"If it can't it drafts me an article that would cover it, as well as tells me why."

Esa parte de "tells me why" importa. Un borrador con su motivo adjunto se revisa en minutos. Uno sin motivo se queda en una cola. Cubro más del lado de la redacción en mi guía para escribir artículos de KB con IA.
3. Aprender su producto por sí mismo antes de responder nada
Ejecutar /learn sobre su centro de ayuda público le da a Hermes un modelo de trabajo de su producto antes de tocar cualquier otra cosa. Es útil si también usa Hermes para redactar respuestas en otros sitios, y es la misma idea que entrenar a la IA con su base de conocimiento. Un comentarista de Hacker News ejecuta exactamente esta configuración:
"Hermes uses an llm-wiki [...] as a source of information when drafting suggested replies - I have a cronjob that feeds it all emails, slack messages, meeting minutes every single day."

¿Puede Hermes escribir en su centro de ayuda? Depende de la plataforma
Aquí es donde la mayoría de las configuraciones se tuercen, y es la parte que ninguna página de la documentación de Hermes cubre, ya que ninguna menciona un centro de ayuda de cara al cliente. Que Hermes pueda proponer un cambio con seguridad depende mucho más de su plataforma de KB que de Hermes.
El catálogo MCP curado de Hermes tiene 62 entradas. Notion y Atlassian (Jira más Confluence) están en él. Google Drive, GitHub y Zendesk no: GitHub se deja fuera a propósito en favor del skill gh incluido, Google Drive necesita su propio cliente OAuth, y Zendesk no recibe ninguna mención en toda la documentación.
¿Dónde vive su base de conocimiento?
Elija su plataforma para ver cómo puede acceder Hermes y el ajuste que evita que publique por su cuenta.
Vía: API REST del Help Center desde un skill de Hermes o una llamada de terminal. No está en el catálogo MCP de Hermes, y el servidor MCP propio de Zendesk aún no tiene documentación pública.
Ajuste seguro: dé a la cuenta del agente un grupo de permisos sin derechos de publicación, para que solo pueda crear artículos con draft en true.
Ojo: el indicador de borrador funciona por traducción. Activarlo en un artículo publicado lo retira de su centro de ayuda. Proponga las ediciones como un nuevo artículo en borrador.
Vía: el servidor MCP de Atlassian, que está en el catálogo de Hermes. Su v2 lista 65 herramientas de Confluence, incluidas createConfluenceContent y updateConfluenceContent.
Ajuste seguro: marque el servidor con trust: untrusted en Hermes para que cada escritura pida permiso primero. Las ejecuciones desatendidas necesitan un token de API que un administrador de la organización haya activado.
Ojo: las herramientas MCP no listan una opción de borrador, y la herramienta de estado del contenido pone una etiqueta de revisión, no un estado de publicación. Escriba en un espacio de retención restringido o deje un comentario.
Vía: el servidor MCP alojado de Notion, en el catálogo de Hermes. La documentación de Notion muestra la configuración para Hermes y el paso hermes mcp login notion.
Ajuste seguro: incluya solo notion-search, notion-fetch y notion-create-comment hasta que confíe en él, y luego añada una propiedad Status como puerta de revisión.
Ojo: el inicio de sesión es solo OAuth, sin token sin interfaz por ahora, y el modo borrador crea una página privada sin página padre.
Vía: el servidor MCP oficial de Freshdesk (disponible de forma general desde el 10 de septiembre de 2026) tiene createSolutionFolderArticle y updateSolutionArticle.
Ajuste seguro: cree artículos con status 1, que significa borrador. Status 2 publica.
Ojo: cada clave de API conectada obtiene todas las herramientas, y MCP es de pago por uso: Growth incluye 1.200 acciones al año, y luego 15 $ por cada 1.000.
Vía: la API de Docs. El servidor MCP de Help Scout es de solo lectura para conexiones nuevas y no puede editar artículos de Docs.
Ajuste seguro: el endpoint de guardar borrador escribe un borrador sobre un artículo publicado "so that the published version will not be affected."
Ojo: su clave de la API de Docs necesita el permiso "Docs: Create new, edit settings & Collections".
Vía: el skill github incluido en Hermes que maneja la línea de comandos gh, o el propio servidor MCP de GitHub.
Ajuste seguro: escriba en una rama y abra un pull request en borrador. La protección de rama en main es su botón de publicar.
Ojo: casi nada. Un token de acceso personal sirve para ejecuciones desatendidas, a diferencia del inicio de sesión de Notion.
Aquí está la misma imagen como referencia rápida:
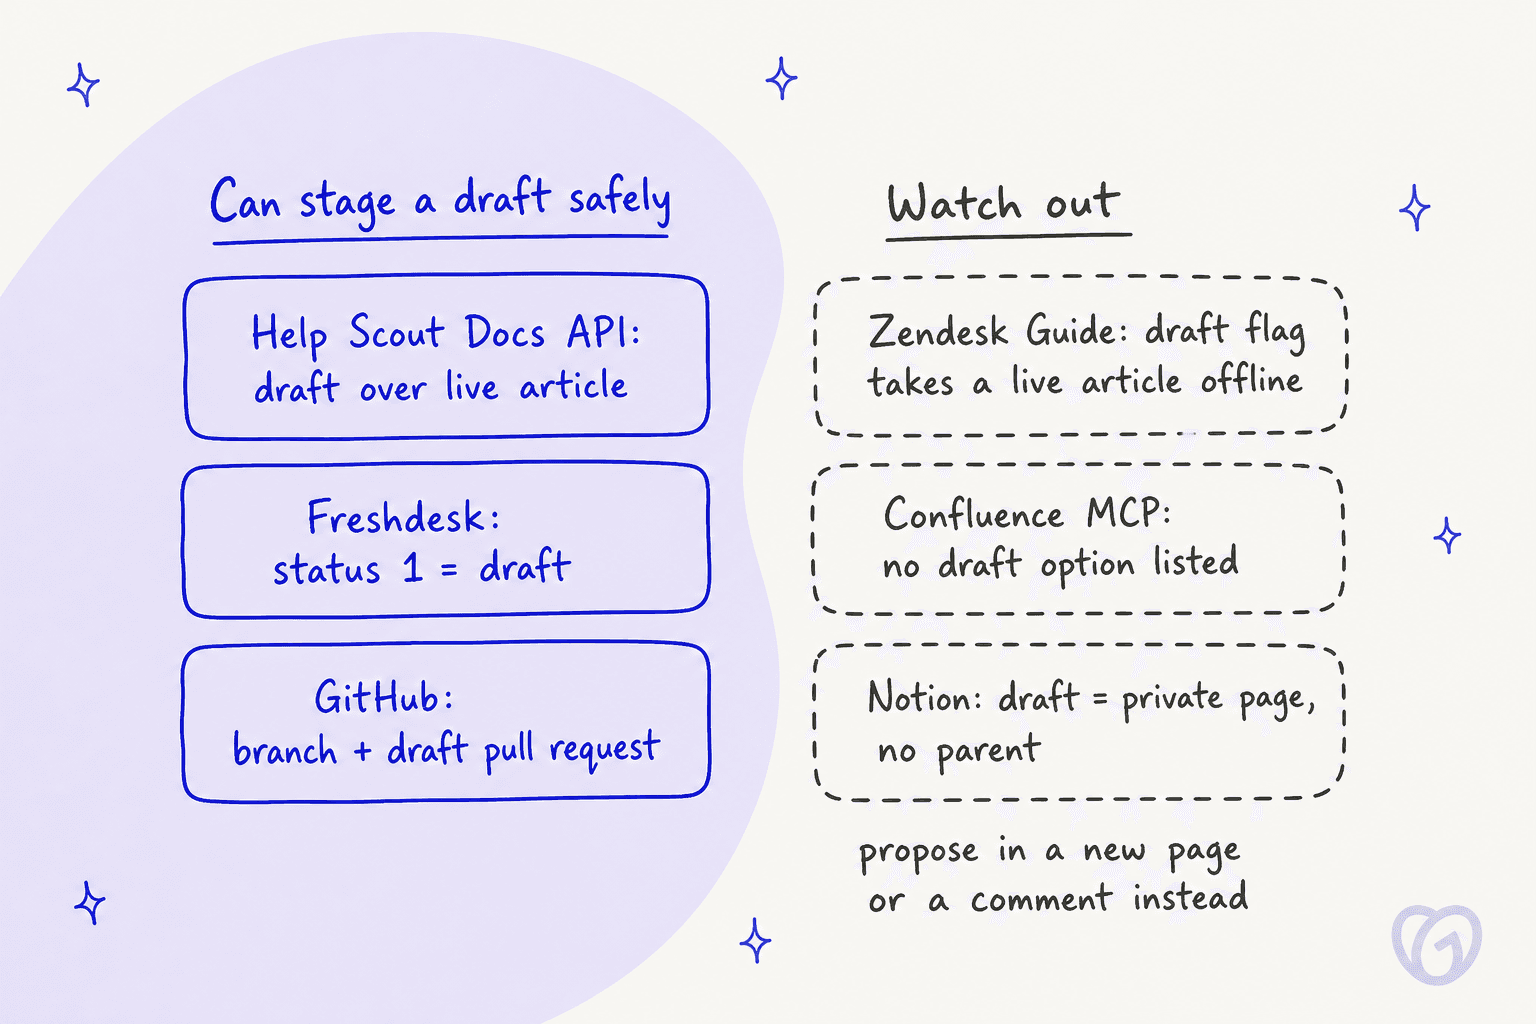
El caso de Zendesk es el que más sorprende. Según la API del Help Center, el campo draft "can be set when creating but not when updating", y las actualizaciones pasan por el endpoint de traducciones, donde draft se aplica a toda esa traducción. No existe un objeto aparte de "edición pendiente", así que un agente que pase un artículo publicado a borrador lo despublica. La ventaja: la API también dice que sin derechos de publicación, "the article must be created using draft=true". Es una buena barrera de protección. Mi entrada sobre la API de Zendesk Guide recorre los endpoints, y los usuarios de Freshdesk pueden ver el equivalente en mi guía de la API de la base de conocimiento de Freshdesk.
| Plataforma | Cómo accede Hermes | Puede preparar borrador | Inicio de sesión | Límites a tener en cuenta |
|---|---|---|---|---|
| Zendesk Guide | API REST (no está en el catálogo) | Solo artículos nuevos, draft: true | Token OAuth o token de API | 200 a 2,500 solicitudes/min según el plan |
| Confluence | MCP de Atlassian (en el catálogo) | No figura en las herramientas MCP | OAuth 2.1, o token de API habilitado por un administrador | Escrituras gratis, llamadas enriquecidas 1-10 créditos Rovo |
| Notion | MCP de Notion (en el catálogo) | Página privada, sin padre | Solo OAuth | 600/min Business+, 180/min el resto |
| Freshdesk | MCP de Freshdesk | Sí, status: 1 | Solo clave de API | 1,200 acciones/año en Growth, luego $15/1.000 |
| Help Scout Docs | API de Docs (el MCP es de solo lectura) | Sí, borrador sobre artículo publicado | Clave de API de Docs | 2,000+ solicitudes cada 10 min |
| Repositorio de docs en GitHub | skill github o MCP de GitHub | Sí, rama más PR en borrador | OAuth o token personal | 80 solicitudes de creación de contenido/min |
Configurar Hermes para la gestión de la base de conocimiento, paso a paso
Esta es la configuración que ejecutaría para un equipo de soporte, en el orden en que la haría. Reserve una tarde para los pasos 1 a 4 si Hermes ya está instalado.
Paso 1: Decida dónde vive la fuente de verdad
Elija un sistema como el lugar donde vive una respuesta correcta. Si su centro de ayuda es Zendesk Guide pero la mitad de las respuestas reales están en Confluence, Hermes auditará gustosamente ambos y redactará en el que alcance primero. Así es como dos artículos acaban contradiciéndose. Si sus agentes también mantienen una base de conocimiento interna aparte, decida ahora cuál gana cuando entran en conflicto. Un comentarista de Reddit en r/CustomerSuccess describió adónde lleva eso:
"the two docs disagreeing thing is the scariest part, bot just picks whichever one it grabbed first and sounds totally sure about it"
Paso 2: Conecte primero en solo lectura
Cuando añade un servidor MCP, Hermes lo sondea y muestra una lista de verificación, y solo las herramientas que marque acaban en tools.include. Empiece solo con herramientas de búsqueda y lectura. Para Notion, usando el servidor alojado de las instrucciones de Notion para Hermes:
mcp_servers:
  notion:
    url: "https://mcp.notion.com/mcp"
    auth: oauth
    trust: untrusted
    tools:
      include: [notion-search, notion-fetch, notion-create-comment]
Luego ejecute hermes mcp login notion una vez para terminar el inicio de sesión OAuth.
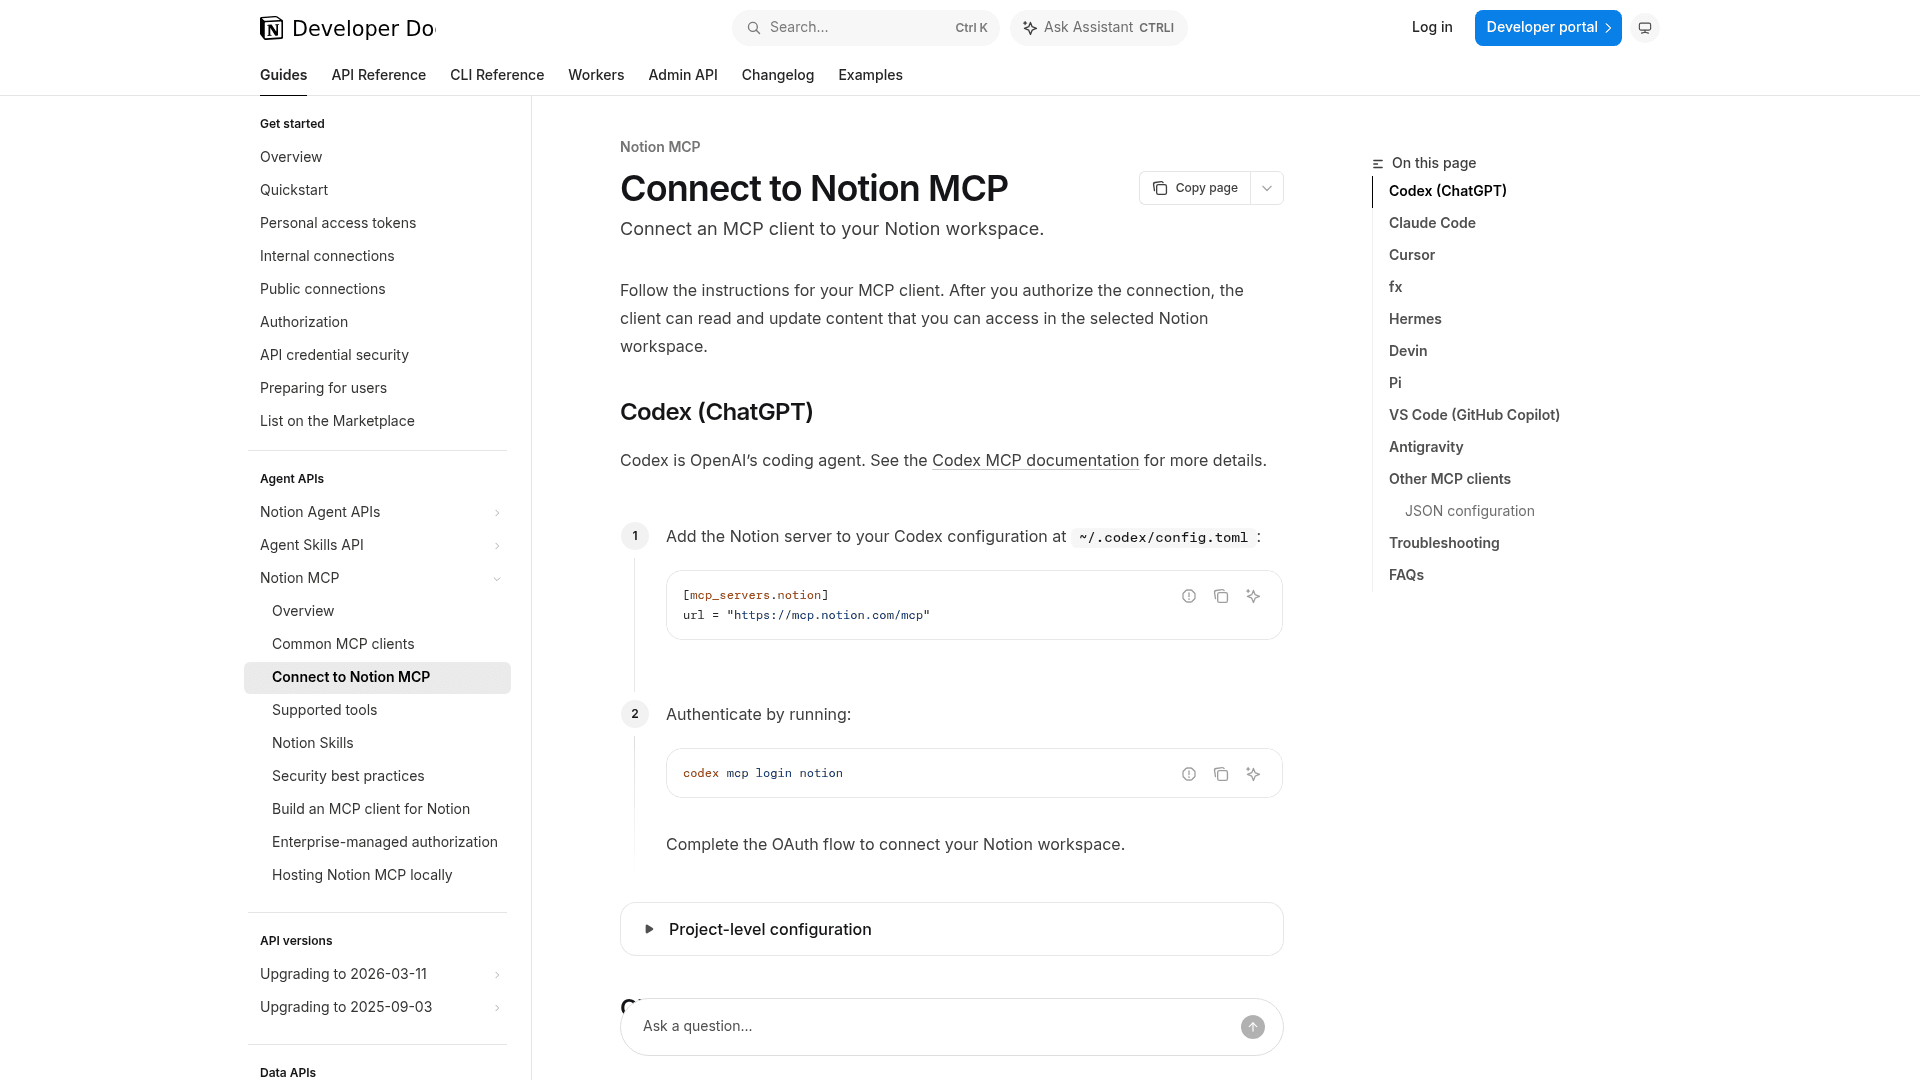
Esa línea trust: untrusted hace el trabajo pesado. Según la referencia de configuración MCP, en un servidor no confiable "every write-capable tool call [...] requires user approval." El valor por defecto es full, que significa ningún aviso.
Paso 3: Active las barreras de escritura que Hermes deja apagadas
El sistema de aprobación de Hermes es irregular, así que active estas a propósito:
memory.write_approval: trueprepara las escrituras de memoria para revisión con/memory pendingy/memory approve <id>.skills.write_approval: truehace lo mismo con los cambios de skills, y/skills diff <id>muestra el diff completo.checkpoints.enabled: truetoma una instantánea antes de las escrituras de archivos, para que/rollbackpueda restaurar una página markdown. Los puntos de restauración son opcionales.
Hay dos cosas que esto no cubre. Las escrituras de archivos simples (write_file, patch) nunca piden permiso; la documentación de seguridad dice "there is no approval prompt", solo hay una lista de rutas bloqueadas y un sandbox de escritura opcional. Y los puntos de restauración solo guardan instantáneas de archivos locales, así que una página de Notion o Confluence modificada mediante MCP depende del historial de páginas de esa plataforma para deshacerse.
Paso 4: Programe una auditoría semanal
Hermes cron acepta horarios en inglés sencillo, puede adjuntar skills y entrega en Slack. Un primer trabajo podría verse así:
hermes cron create "every monday 9am" "Lint the support wiki. List stale pages, orphan pages and contradictions with file paths. If nothing changed since last week, reply [SILENT]." --skill llm-wiki
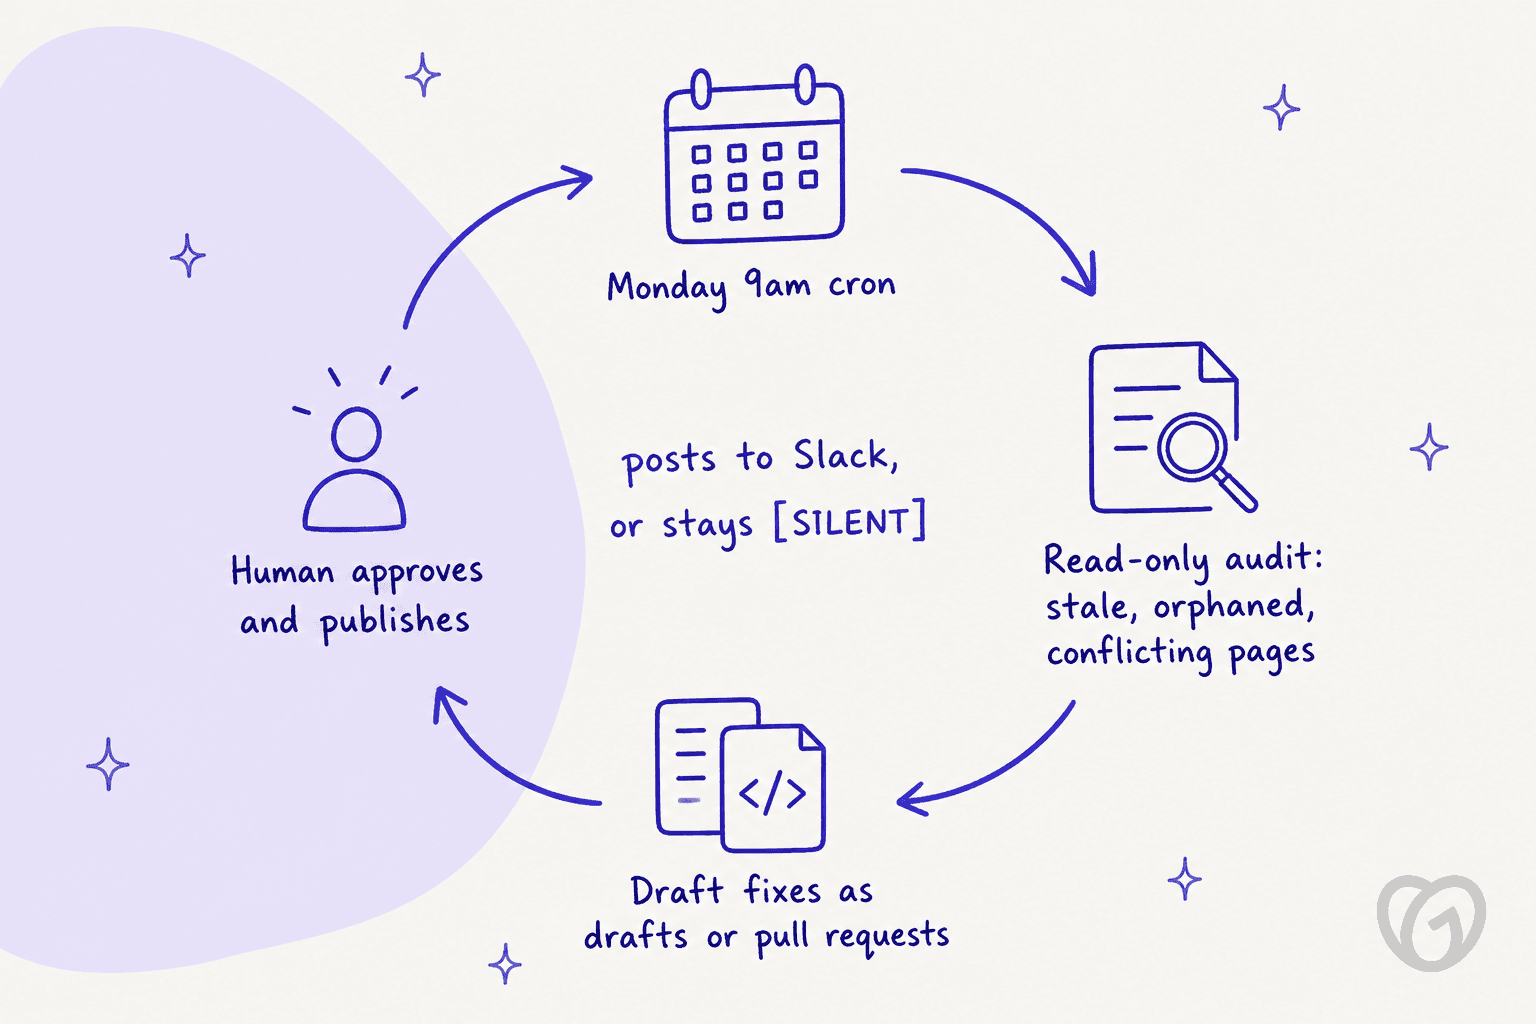
Cron se comporta bien para esto. Una respuesta que contenga [SILENT] suprime la entrega, así que su canal solo oye algo cuando algo cambió, mientras que los trabajos fallidos siempre se entregan. Si una clave, un skill o un servidor MCP no se resuelve, el trabajo se marca como blocked_config, envía una alerta y no hace ninguna llamada al modelo. En cron, los comandos de shell peligrosos se deniegan por defecto. Una peculiaridad: cada ejecución de cron empieza una sesión completamente nueva, así que el prompt tiene que llevar todo lo que el agente necesita.
Paso 5: Añada la redacción cuando la auditoría resulte aburrida
Solo después de unas semanas de auditorías que coincidan con lo que usted habría señalado, dejaría que Hermes escribiera. Añada la herramienta de escritura de su plataforma, mantenga el servidor como untrusted y dirija los borradores a un lugar de revisión: un pull request en borrador, un borrador de Freshdesk, un borrador de Help Scout o un comentario en la página de Confluence. Fije cualquier skill de conocimiento del que dependa el trabajo para que el curator no lo archive a mitad de trimestre.
Dónde fallan las bases de conocimiento gestionadas por agentes
Nadie en la comunidad de Hermes informa de que lo ejecute contra un centro de ayuda de cara al cliente todavía. Todas las historias son sobre un wiki personal o de equipo, normalmente un vault de Obsidian. Pero los modos de fallo se trasladan bien a las KB de soporte, y vale la pena leerlos antes de dar a un agente acceso de escritura.
Las escrituras sin supervisión pudren todo el wiki
Esta es la lección más votada en los hilos de r/hermesagent que leí:
"Don't let the agent write the vault unsupervised. That's the one I wish I'd heard on day one. They will dump session recaps, fake "I remember" facts, and half finished incident notes into Obsidian like it's a trash can. Looks busy. A month later you don't trust a single file."
La propia documentación de Hermes señala un riesgo relacionado: con modelos locales pequeños, "a sentence like 'I've added that to my memory' is just text". El agente puede decir que guardó algo que nunca guardó, por lo que la documentación añade un verificador de mutación de archivos y le dice que "trust the verifier over the model's summary".
Los agentes añaden, rara vez borran
En un hilo de Hacker News titulado "Agents don't need memory, they need documentation", un ingeniero describió cómo la base de conocimiento de su empresa se convertía en un "completely useless giant mess of stale, outdated, duplicated, or superfluous info", incluso con agentes encargándose de la conciliación (kaydub, Hacker News). Los agentes añaden un párrafo en lugar de quitar uno. Para un centro de ayuda, eso significa que su prompt de auditoría debe pedir explícitamente páginas para archivar o fusionar, no solo páginas para actualizar. Mi guía sobre contenido obsoleto del centro de ayuda tiene más sobre cómo detectarlas.
Las escrituras fallan en silencio
"But the main problem is really that it can sometimes just not insert it."
Eso era sobre Hermes enviando resúmenes de investigación a notas. La solución es la misma para un centro de ayuda: verifique que el artículo existe en la plataforma después de escribir, y haga que el informe semanal liste lo que realmente se creó, no lo que el agente pretendía crear.
A escala personal funciona, a escala de empresa es más difícil
"There are a few successes on an individual level (I really like Hermes[0]) but nothing scales to a company level easily."
La memoria de Hermes está acotada por perfil, y la documentación le remite a un proveedor de memoria externo para todo lo compartido. Para un solo responsable de documentación, eso está bien, y es también la razón por la que la retención del conocimiento de soporte no puede vivir en el agente de una sola persona. Para un equipo de soporte de 15 donde todos esperan las mismas respuestas, la fuente compartida tiene que ser su centro de ayuda, lo que le devuelve a la tabla de plataformas de arriba.
Audita lo que está escrito, no lo que preguntan los clientes
Esta es la brecha que yo pesaría más como persona de soporte. El lint de llm-wiki encuentra páginas obsoletas y contradictorias. No puede decirle que una serie de tickets el mes pasado preguntó por una función sin artículo, porque nada en Hermes lee sus tickets del helpdesk para eso a menos que lo construya. Como dijo un fundador en r/startups, gran parte del trabajo es saber "which legacy articles are broken by a new feature" (u/19Vicus90, Reddit r/startups). Los tickets son donde eso aparece primero. Mi entrada sobre el análisis de lagunas de conocimiento cubre qué helpdesks ofrecen esas señales de forma nativa.
Hermes frente a una opción creada para soporte para el mantenimiento de la KB
Para ser justos con Hermes: si sus documentos son markdown en un repositorio y se siente cómodo siendo dueño de un servidor, es un mantenedor flexible y gratuito, y el lint de llm-wiki es una comprobación de páginas obsoletas bien pensada para un wiki en markdown. Donde le cuesta es en la conexión específica de soporte que necesita la gestión del conocimiento con IA para un equipo de soporte.
| Hermes Agent | Compañero de helpdesk de eesel | |
|---|---|---|
| Dónde vive el conocimiento | Su KB, a la que se accede por MCP o API que usted conecta | Su KB, conectada como fuente (Zendesk, Confluence, Notion, Google Drive, sitio web y más) |
| Encuentra lagunas a partir de tickets | No incluido | Los informes muestran una tarjeta de "Knowledge gaps" a partir de conversaciones reales |
| Redacta artículos que faltan | Sí, mediante la vía de borrador de su plataforma | El skill "Update knowledge base" redacta los artículos que faltan |
| Lint de páginas obsoletas en markdown | Sí, llm-wiki | No es el foco |
| Revisión antes de publicar | Opcional (trust: untrusted, aprobaciones de escritura) | Las acciones pasan por aprobaciones |
| Se ejecuta en | Su máquina o servidor | Alojado |
| Coste | Software gratuito más tokens del modelo y alojamiento | Desde $299/month por 500 créditos, nivel gratuito de 100 créditos |
eesel no es la mejor opción para todos. Si su centro de ayuda es un sitio de documentación en GitHub y nadie abre tickets sobre él, Hermes con un pull request en borrador es un ciclo más agradable. Si su base de conocimiento existe para responder a clientes, los tickets son la mejor señal que tiene, y ahí es donde yo empezaría. Para una visión más amplia, mis resúmenes de alternativas a Hermes y de herramientas de base de conocimiento con IA cubren el panorama.
Pruebe eesel para el mantenimiento de la base de conocimiento
Si prefiere no ejecutar un servidor para mantener honesto su centro de ayuda, el compañero de helpdesk con IA de eesel se conecta al conocimiento que ya tiene. Conecta Zendesk, Confluence y Notion como fuentes (hasta 15.000 páginas de Notion por conexión), responde a partir de ellas con una cita en cada respuesta y registra cada vez que se topó con una pregunta que sus documentos no podían responder.
Estas aparecen en Reports como lagunas de conocimiento, y el skill "Update knowledge base" redacta los artículos que faltan para que su equipo los apruebe. Si la tarjeta de ese skill dice "Contact us" en su espacio de trabajo, pida a eesel que lo active.

También tiene una herramienta de línea de comandos, así que si le gustó el flujo de trabajo de Hermes, usted o un agente de programación como Claude Code pueden conectar fuentes, leer instrucciones y aprobar acciones retenidas desde el terminal. Puede empezar gratis con 100 créditos y sin tarjeta en la página de precios. Pruebe eesel en su propio centro de ayuda y vea qué lagunas encuentra en la primera semana.