Was "einen Support-Agenten mit einer API bauen" wirklich bedeutet
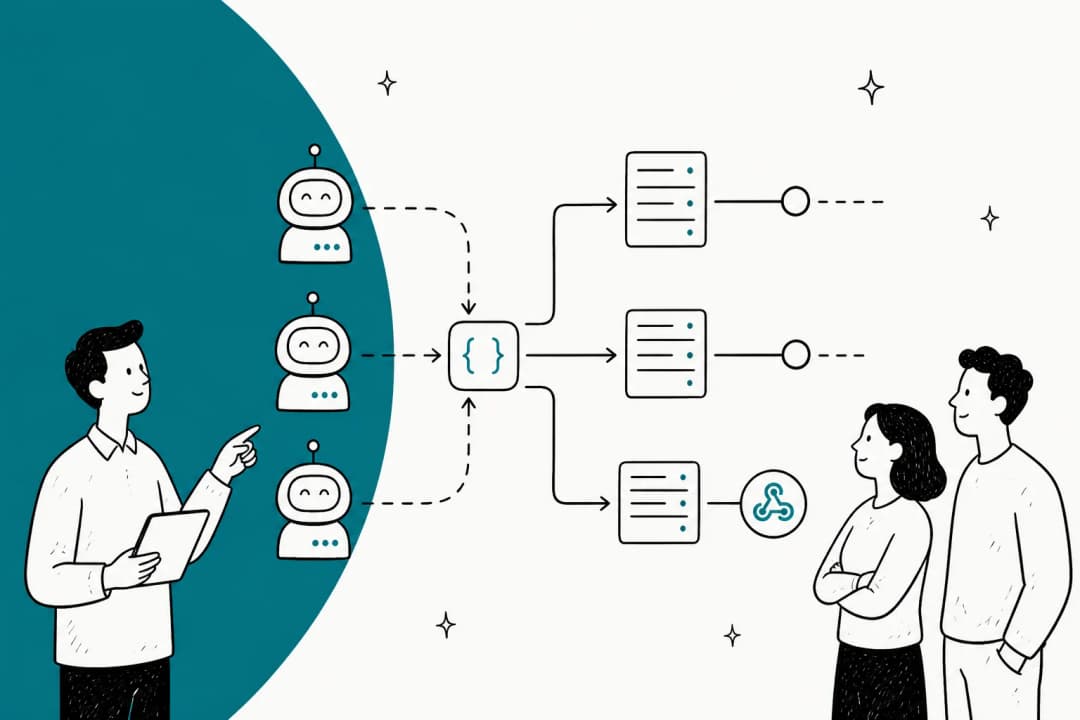
Ich verbringe die letzten Jahre damit, Code zu schreiben, der KI-Agenten an Helpdesks anbindet, und das Erste, was ich jedem sage, der so einen Build startet, ist: Der API-Call an das Modell ist nie der Teil, wo die Zeit hingeht. Ein Support-Agent ist keine einzelne API. Er ist ein kleines System, und "mit einer API bauen" bedeutet in Wirklichkeit, eine Handvoll davon so zusammenzusetzen, dass sie sich wie ein einziger, verlässlicher Kollege verhalten.
Hier ist der Stack, bei dem du landest, ob du ihn geplant hast oder nicht.
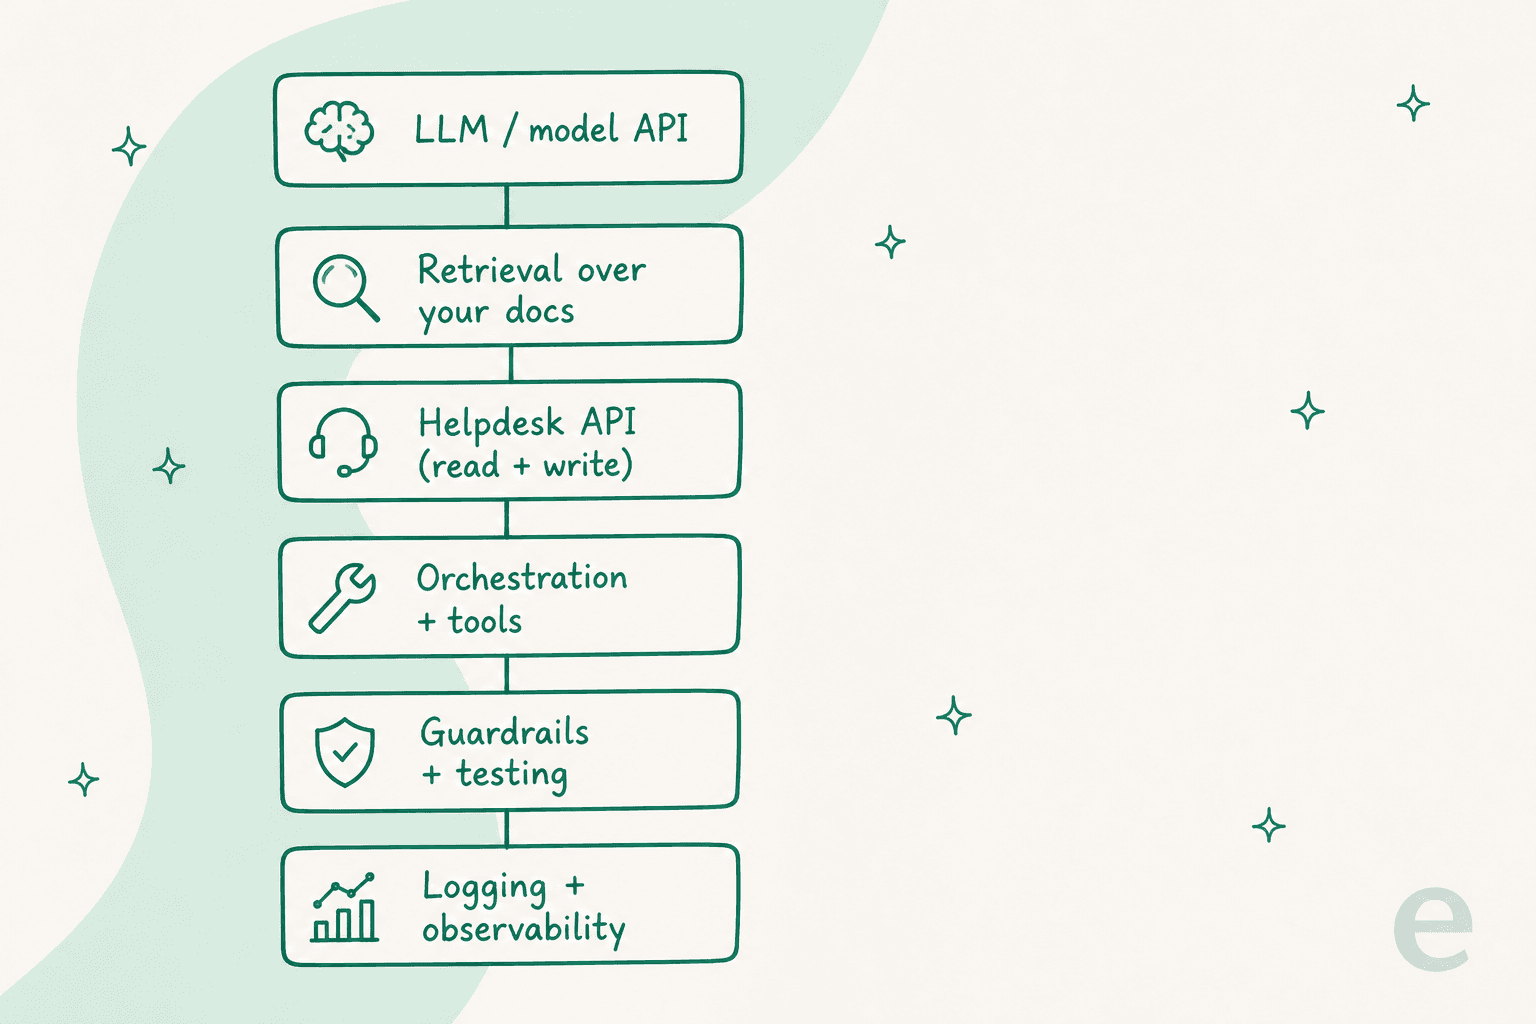
- Eine Model-API. Das LLM, das das Ticket liest und entscheidet, was zu sagen ist. Das ist der Teil, mit dem alle anfangen, und der Teil, der für dein Ergebnis am wenigsten zählt, weil inzwischen jedes ernstzunehmende Modell gut genug ist.
- Retrieval über dein Wissen. Dein Help Center, vergangene Tickets und interne Dokumente, zerlegt in Chunks und indexiert, damit das Modell aus deiner Realität antwortet statt aus dem offenen Internet. Machst du das falsch, hast du einen selbstsicheren Agenten, der selbstsicher falsch liegt.
- Die API deines Helpdesks. Die Lese- und Schreibverbindung zu Zendesk, Gorgias, Front oder wo auch immer deine Tickets liegen. Der Agent muss die Konversation sehen und eine Antwort posten, taggen oder eskalieren können.
- Orchestrierung und Tools. Der Kitt, der es dem Agenten erlaubt, mitten in der Konversation eine Bestellung nachzuschlagen, ein Abo zu prüfen oder einen internen Endpunkt anzusprechen. Ein Support-Agent, der nur reden, aber nicht handeln kann, fängt die einfachen Fragen ab und lässt den Rest liegen.
- Guardrails, Tests und Logging. Die wenig glamouröse Schicht, die verhindert, dass das Ganze in Produktion aus dem Ruder läuft, und mit der du beweisen kannst, dass es funktioniert, bevor es einen echten Kunden beantwortet.
Wenn du die konzeptionelle Version davon willst: Wir haben ein Begleitstück zu der Customer-Support-Agent-API als Kategorie geschrieben. Dieser Beitrag hier ist der praktische: wie du das Ganze tatsächlich zusammensetzt und wo es zwickt.
Weg 1: Selbst aus rohen APIs bauen
Das ist in einer bestimmten Konstellation der richtige Ansatz: Du baust ein Produkt, bei dem der Agent das ist, was du verkaufst, du hast einen Workflow, den kein Anbieter abdeckt, oder du hast Engineers übrig und einen Grund, jede Schicht selbst zu besitzen. Wenn das auf dich zutrifft, hier die ehrliche Form der Arbeit.
Du startest mit einer Model-API und einem Prompt, was einen Nachmittag dauert und sich wie Magie anfühlt. Dann bindest du Retrieval an, und die Demo wird wirklich nützlich. Dann bindest du deinen Helpdesk an, und das Projekt ändert komplett seinen Charakter, weil du jetzt keinen Chatbot mehr baust, sondern eine Integration.
Der Teil, der einfach aussieht, es aber nicht ist
Hier ist, was Außenstehende bei der Schätzung so eines Builds immer falsch machen: Sie bemessen ihn am Modell und an der REST-Oberfläche. Sie schauen in die API-Doku des Helpdesks, sehen saubere Endpunkte für Tickets und Antworten und veranschlagen eine Woche. Dann verschwindet die eigentliche Zeit in den Teilen, die nicht in der Doku stehen.
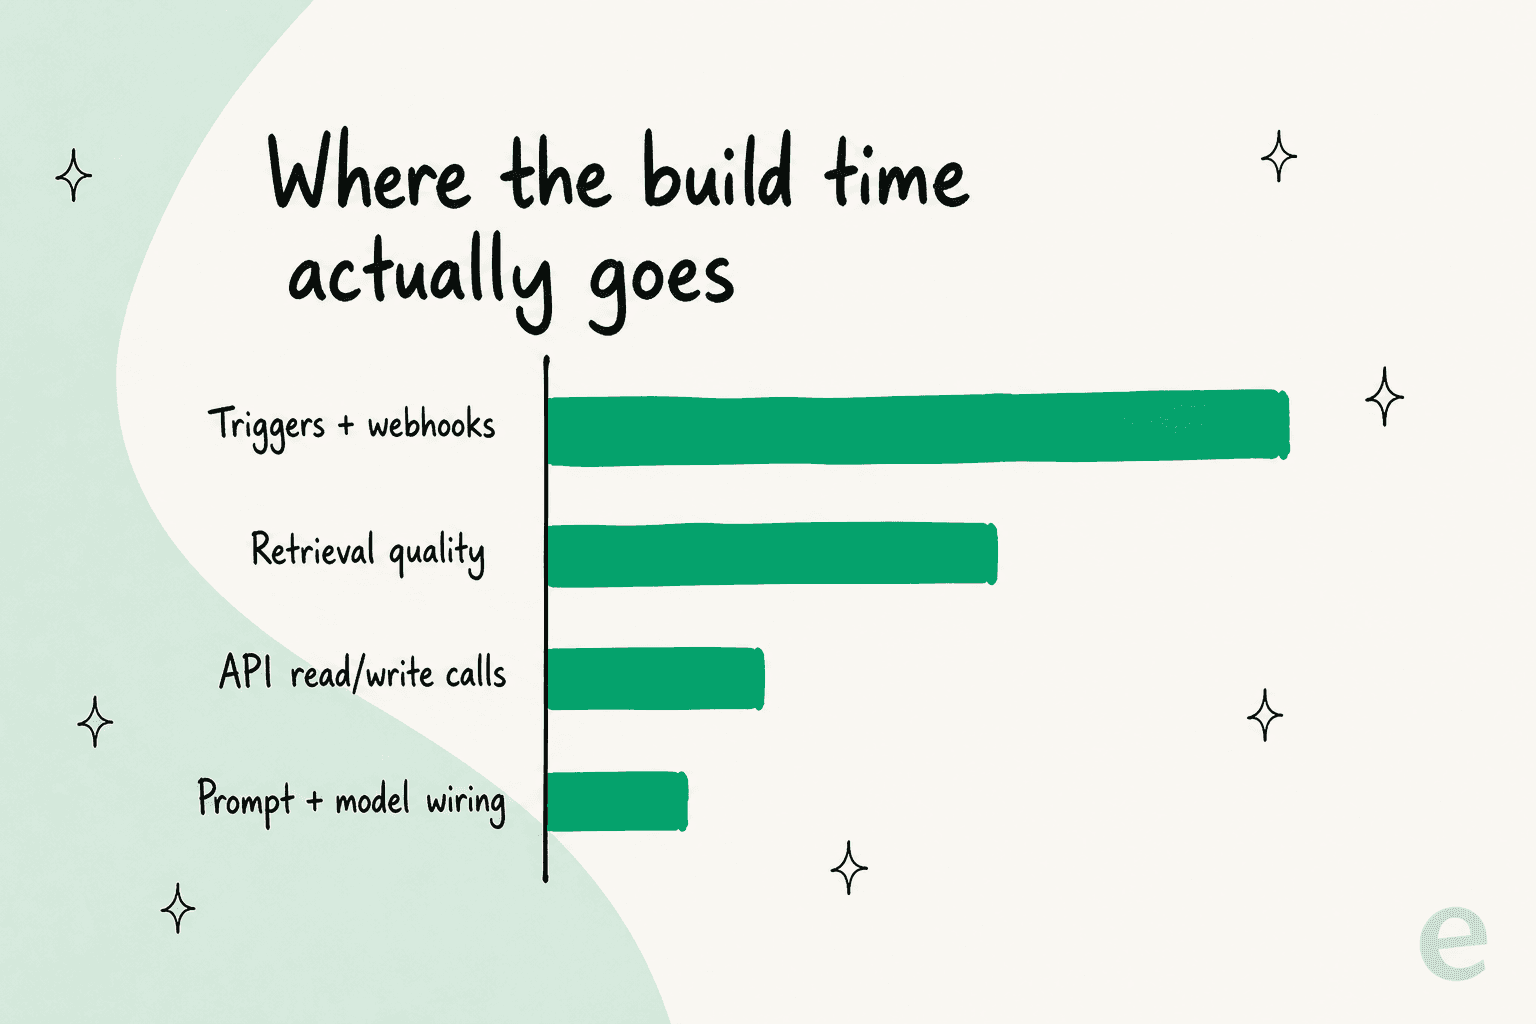
Trigger sind ungefähr die Hälfte des Schmerzes, nicht die API-Calls. Jede Plattform entscheidet unterschiedlich, wann dein Agent aufwacht: Manche feuern echte Webhooks, manche zwingen dich zum Pollen, manche routen alles über Automatisierungsregeln mit ihren eigenen Eigenheiten. Du musst den ganzen Lebenszyklus eines Webhooks pro Kunde verwalten, damit er nie verwaist, doppelt ankommende Events deduplizieren und das versteckte Verhalten jeder Plattform auf die harte Tour lernen. Mein Lieblingsbeispiel: Freshdesk feuert seine Automatisierungsregeln bei agentenerstellten Tickets stillschweigend nie, was mich Stunden gekostet hat, bevor ich verstand, dass das genau so gedacht ist. Nichts davon steht in der Endpunkt-Referenz.
Die Retrieval-Qualität ist der nächste Kostenfaktor. Docs zu indexieren ist einfach; den Agenten dazu zu bringen, bei einer vagen, falsch geschriebenen, realen Frage die richtige Passage abzurufen, ist ein fortlaufender Tuning-Job, keine einmalige Einrichtung. Und "Multi-Instanz" wird dich überraschen: Die Anbindung an Zendesk-die-Plattform ist nicht dasselbe wie die Anbindung an das spezifische Zendesk dieses Kunden, und wenn du das vermischst, bekommst du Bugs, bei denen das Aktivieren einer Aktion für einen Account das Verhalten für einen anderen ändert.
Für wirklich seltene Einzelintegrationen habe ich festgestellt, dass das Gegenteil dessen, was man erwarten würde, am besten funktioniert: Gib dem Agenten einen API-Key, die Doku und ein Referenzskript und lass ihn den Endpunkt direkt ansprechen. Das hat in unseren eigenen Tests einen schwereren Vendor-Abstraktionsansatz geschlagen. Managed OAuth und vorgefertigte Connectoren verdienen sich ihr Geld auf den heißen Pfaden, die du ständig läufst, nicht am Long Tail.
Nichts davon ist ein Grund, nicht zu bauen. Es ist ein Grund, ehrlich zu budgetieren. Wenn du diesen Weg gehst, geht unser Beitrag zu Headless Customer Support und Service-to-Service-KI-Agenten tiefer auf die Architekturmuster ein, die sich bewähren.
Weg 2: Ein Teammitglied einstellen, das bereits programmierbar ist
Hier ist der Weg, den die meisten Teams eigentlich wollen, und der, zu dem ich greifen würde, sofern der Agent nicht dein Kernprodukt ist: Überspring den Bau des Stacks und stell ein KI-Helpdesk-Teammitglied ein, das mit Modell, Retrieval und den 1000+ Integrationen bereits fertig verkabelt ankommt, und steuere es dann per Code.
Der übliche Einwand von Engineers ist berechtigt: Gekaufte Agenten sind Blackboxes, die du über ein Dashboard konfigurierst, und Dashboards passen nicht in einen Pull Request. Genau diese Falle soll dieser Weg vermeiden. Die eesel-Doku sagt wörtlich, alles auf der Seite lässt sich vom Terminal aus erledigen, und dem Agenten wird gesagt, er solle das Dashboard nicht im Browser bedienen. Das Dashboard ist eine Ansicht, nicht die Quelle der Wahrheit.
Konkret besteht die programmierbare Oberfläche aus vier Dingen:
- Eine echte CLI.
npx @eesel/clibringt dich in Gang, ganz ohne ein Konto anzulegen. Du bindest Integrationen an, bearbeitest die Standardanweisungen des Agenten, listest und liest vergangene Läufe miteesel activityund verwaltest menschliche Freigaben, alles über die Shell. Jeder Befehl gibt JSON aus, und--dry-runzeigt dir den genauen Server-Call, den ein Write machen würde, bevor du ihn abschickst. Das ist der Unterschied zwischen einem Spielzeug und etwas, das du in CI einbauen würdest. - Ein MCP-Server pro Workspace.
npx @eesel/cli mcp tokengibt dir eine URL, einen Token und einen paste-fertigen Befehl, um eesel zu Claude oder jedem anderen MCP-Client hinzuzufügen. Dein eigener Agent kann den Workspace dann über Standard-Tools lesen und darauf handeln. - Webhooks. Eine eindeutige URL, die den Agenten weckt, sodass Events aus deinen Systemen einen Lauf auslösen können, ohne dass du eine Polling-Schleife schreibst.
- Network Access. Eine Domain und einen Auth-Header auf die Allowlist setzen, und der Agent kann jede REST-API aufrufen, auf die du ihn zeigst, GET bis DELETE, mit Zugangsdaten, die als Header gespeichert werden, die das Modell nie zu sehen bekommt.
Das deckt die Absicht "Support-Agenten mit einer API bauen" für die meisten Teams ab: Du bekommst dieselbe code-first-, terminal-gesteuerte Kontrolle, die du dir selbst bauen würdest, minus die Monate an Integrations- und Wartungsarbeit. Wenn der Terminal-Workflow der ganze Grund ist, warum du hier bist, gehen wir in KI-Agenten vom Terminal aus verwalten und Support von der Kommandozeile aus automatisieren tiefer darauf ein.
Also: bauen oder kaufen?
Die beiden Wege tauschen dieselbe Sache in entgegengesetzte Richtungen. Bauen kauft dir totale Kontrolle und kostet dich für immer Zeit und Wartung. Ein programmierbares Teammitglied kauft dir Geschwindigkeit und kostet dich einen Teil der tiefsten Anpassbarkeit. Für die meisten Support-Anwendungsfälle gewinnt das Teammitglied, weil "Tickets in unserem Helpdesk lösen" ein gelöstes Problem ist und es sich selten auszahlt, das neu zu erfinden.
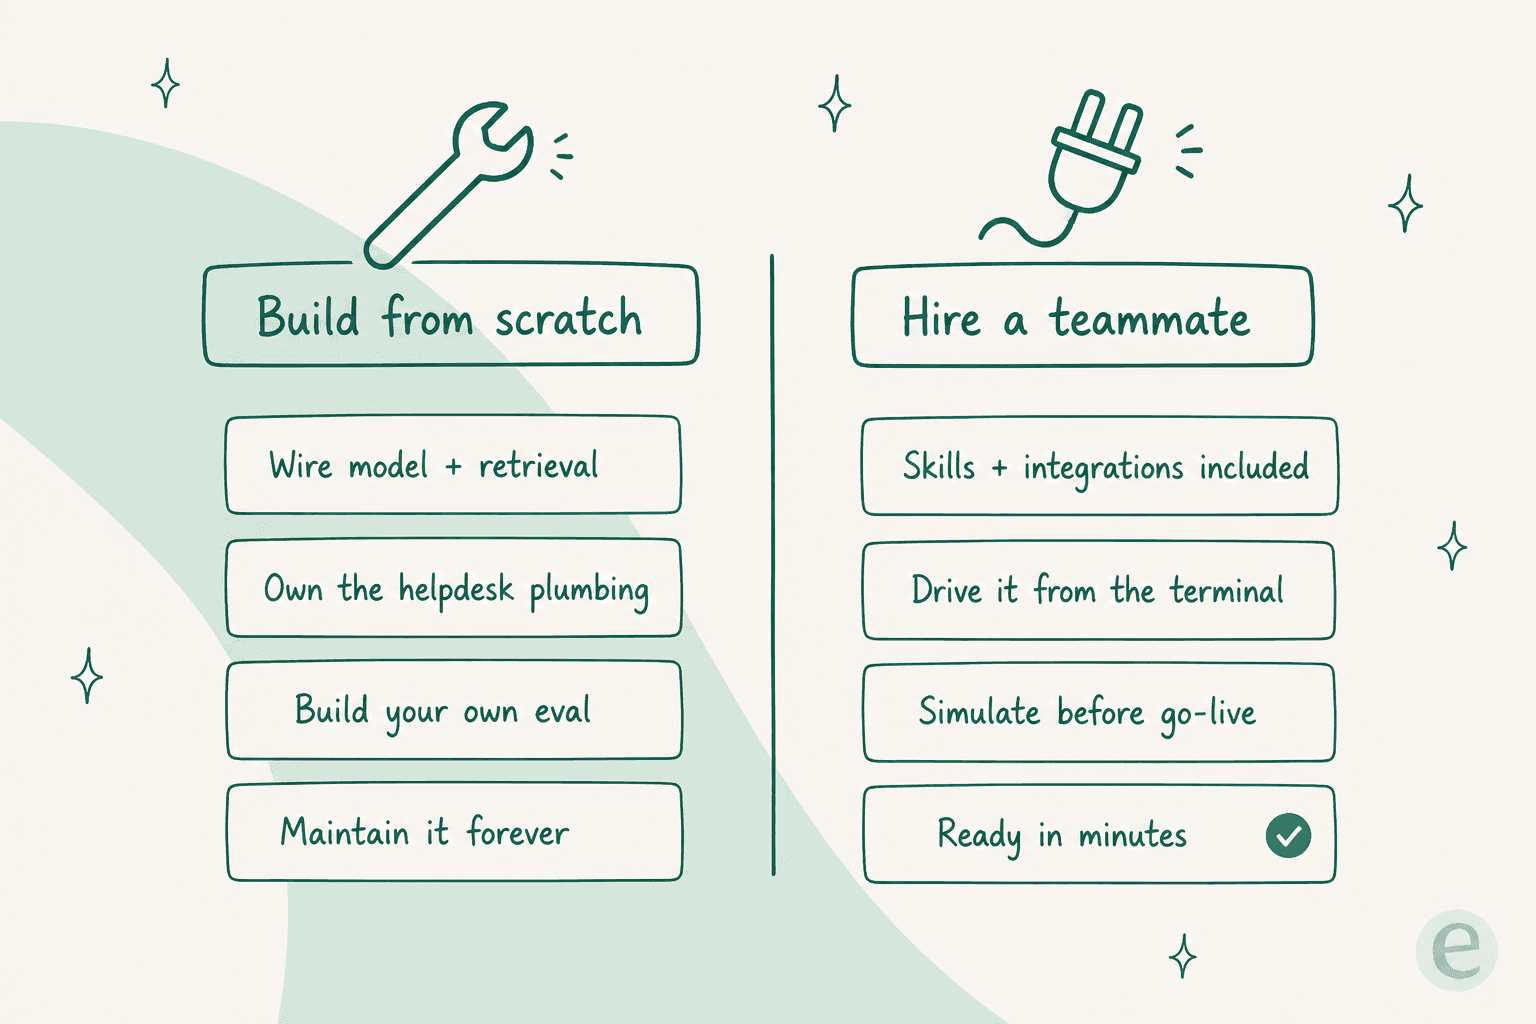
Nutze den kurzen Check unten, um zu sehen, wohin deine eigene Situation tendiert.
Die Teile, die alle unterschätzen
Egal welchen Weg du wählst, drei Schichten entscheiden, ob der Agent vertrauenswürdig ist oder ein Risiko. Es sind auch die Schichten, die ein hastiger DIY-Build auslässt, weshalb es sich lohnt, sie zu benennen.
Testen vor dem Go-live. Das Beängstigendste an einem Support-Agenten ist, dass eine plausible falsche Antwort genau wie eine richtige aussieht. Das willst du nicht vor einem Kunden entdecken. Der Goldstandard ist, den Agenten gegen deine eigenen historischen Tickets laufen zu lassen und zu sehen, was er geantwortet hätte, bevor er live geht. Diesen Testrahmen selbst zu bauen ist echte Arbeit; es ist auch das mit Abstand Wichtigste, was du bauen wirst. eesel liefert einen Simulationsmodus, der genau das macht, und das ist die Funktion, die ich am wenigsten von Grund auf neu bauen möchte.
Human-in-the-loop-Freigaben. Am Anfang willst du, dass der Agent entwirft und ein Mensch freigibt, und dann die Leine lockerst, während Vertrauen aufgebaut wird. Wenn du baust, ist das eine Queue, eine UI und eine State Machine. Auf dem gekauften Weg ist es eesel approvals list und eesel approvals approve <id> --always. Gleiche Idee, sehr unterschiedliche Menge an Code.
Observability. Wenn ein Agent etwas Überraschendes tut, braucht "warum?" eine echte Antwort. Das heißt, jeder Lauf wird mit seinen Inputs, dem abgerufenen Kontext und den Aktionen geloggt, und du kannst einen davon im Detail nachlesen. Wenn du baust, verkabele das von Tag eins an, nicht erst nach dem ersten Vorfall. Bei eesel ist das eesel activity, neuester Lauf zuerst, jeder Einzelfall zum Reinschauen.
Nichts davon ist exotisch. Es ist einfach der Unterschied zwischen einer Demo und etwas, dem du deine Queue anvertrauen würdest, und genau da brechen die "wir bauen das in einem Sprint"-Schätzungen zusammen.
Support-Agenten bauen, ohne die Verkabelung selbst zu bauen
Wenn dein Ziel ein Support-Agent ist, der Tickets in dem Helpdesk löst, den du schon betreibst, gibt dir eesel den Workflow eines Builders ohne dessen Wartungsrechnung. Es ist ein KI-Helpdesk-Teammitglied, das mit deinen vergangenen Tickets und deinem Help Center trainiert, sich in Zendesk, Gorgias, Front und Hunderte andere Tools einklinkt und komplett über eine CLI, MCP und Webhooks gesteuert wird, falls du ein Dashboard lieber nicht anfassen willst.
Das Unterscheidungsmerkmal, auf das ich einen Engineer zuerst hinweisen würde, ist die Simulation: Du lässt den Agenten über deine historischen Tickets laufen und siehst genau, wie er sie behandelt hätte, bevor auch nur ein einziger Kunde involviert ist. Du kannst kostenlos starten, ohne Kreditkarte, und es wird nutzungsbasiert pro Lösung abgerechnet, sodass du es gegen eine reale Zahl abwägen kannst statt gegen einen offenen Build. Die aktuelle Rate findest du auf der Preisseite, und wenn dich der code-first-Ansatz überzeugt hat, probier eesel aus vom Terminal aus mit npx @eesel/cli.
Häufig gestellte Fragen
Wie baue ich einen Kundensupport-Agenten mit einer API?
Muss ich programmieren können, um einen KI-Kundensupport-Agenten zu bauen?
Welche APIs brauche ich, um einen Support-Agenten zu bauen?
Was kostet es, einen Kundensupport-Agenten mit einer API zu bauen?
Ist es besser, einen KI-Support-Agenten zu bauen oder zu kaufen?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.