Was ein Service-zu-Service-KI-Agent tatsächlich ist
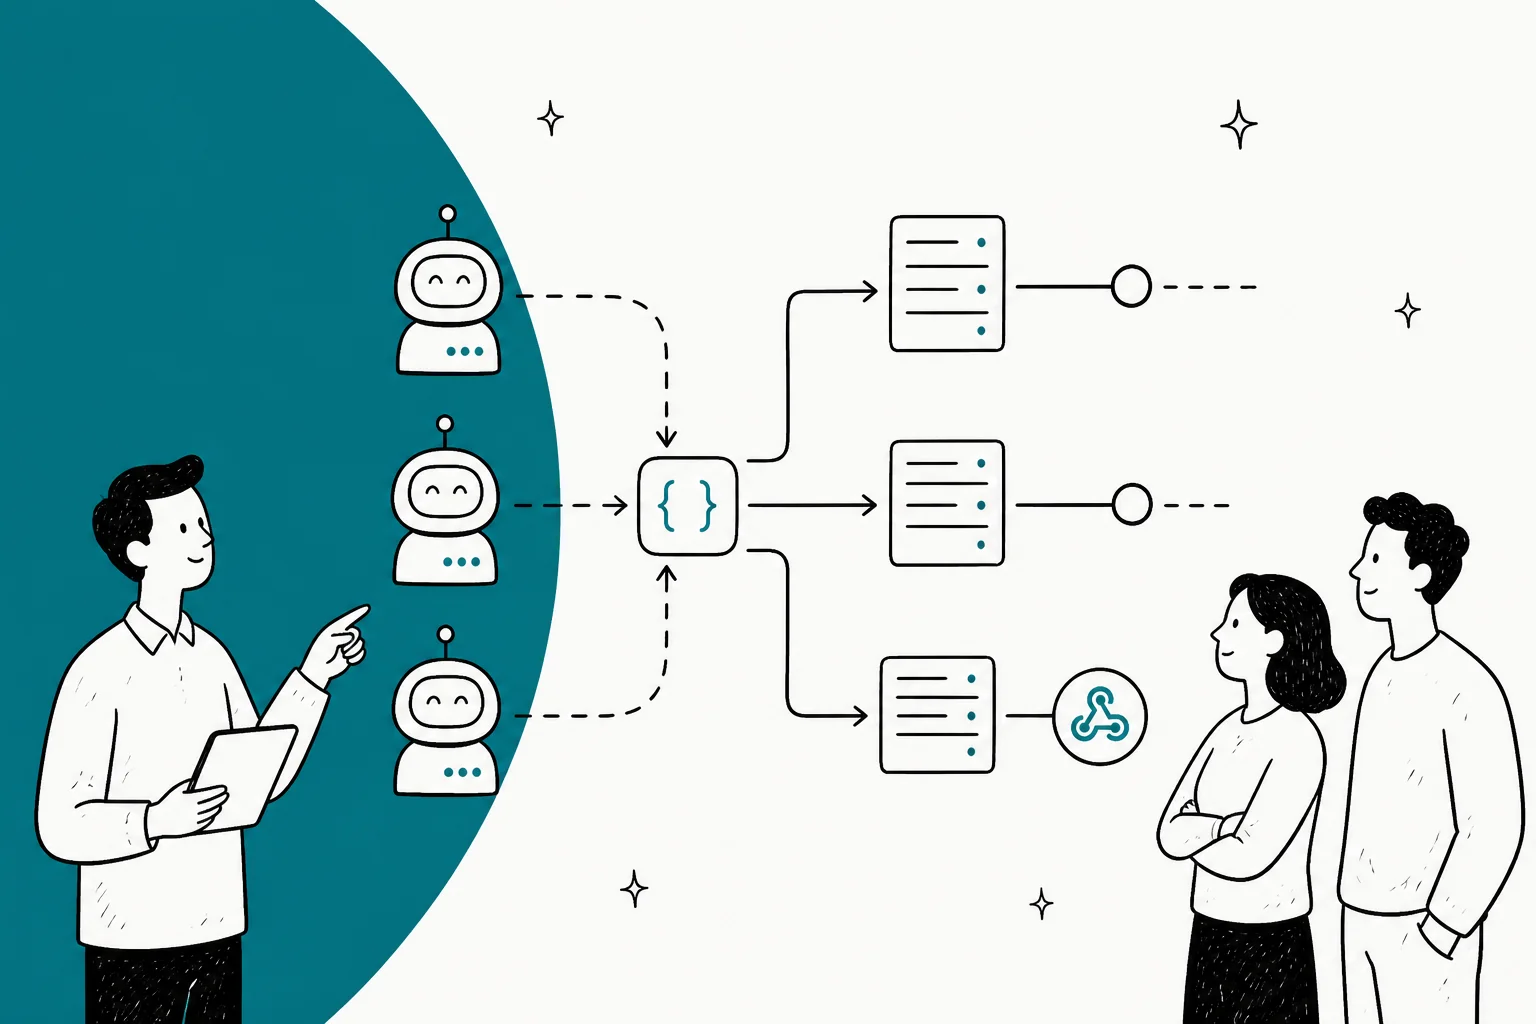
Entfernt man die Buzzwords, ist die Idee alt. „Service zu Service" bedeutet nur, dass ein Stück Software ein anderes über das Netzwerk aufruft, ohne Mensch dazwischen, dasselbe Server-zu-Server-, Machine-to-Machine-Muster, das bereits Ihre Zahlungs-Webhooks und Ihren Billing-Abgleich antreibt. Ein S2S-KI-Agent ist dieses Muster mit einem KI-Agenten als einem der Teilnehmer.
Das entscheidende Merkmal ist also die Schnittstelle, nicht die Intelligenz. Ein Chatbot hat eine Benutzeroberfläche und eine Person auf der anderen Seite. Ein Service-zu-Service-Agent hat einen API-Vertrag und einen anderen Dienst auf der anderen Seite. Das Denken im Inneren kann Wort für Wort identisch sein; was sich ändert, ist, wer oder was mit ihm spricht.
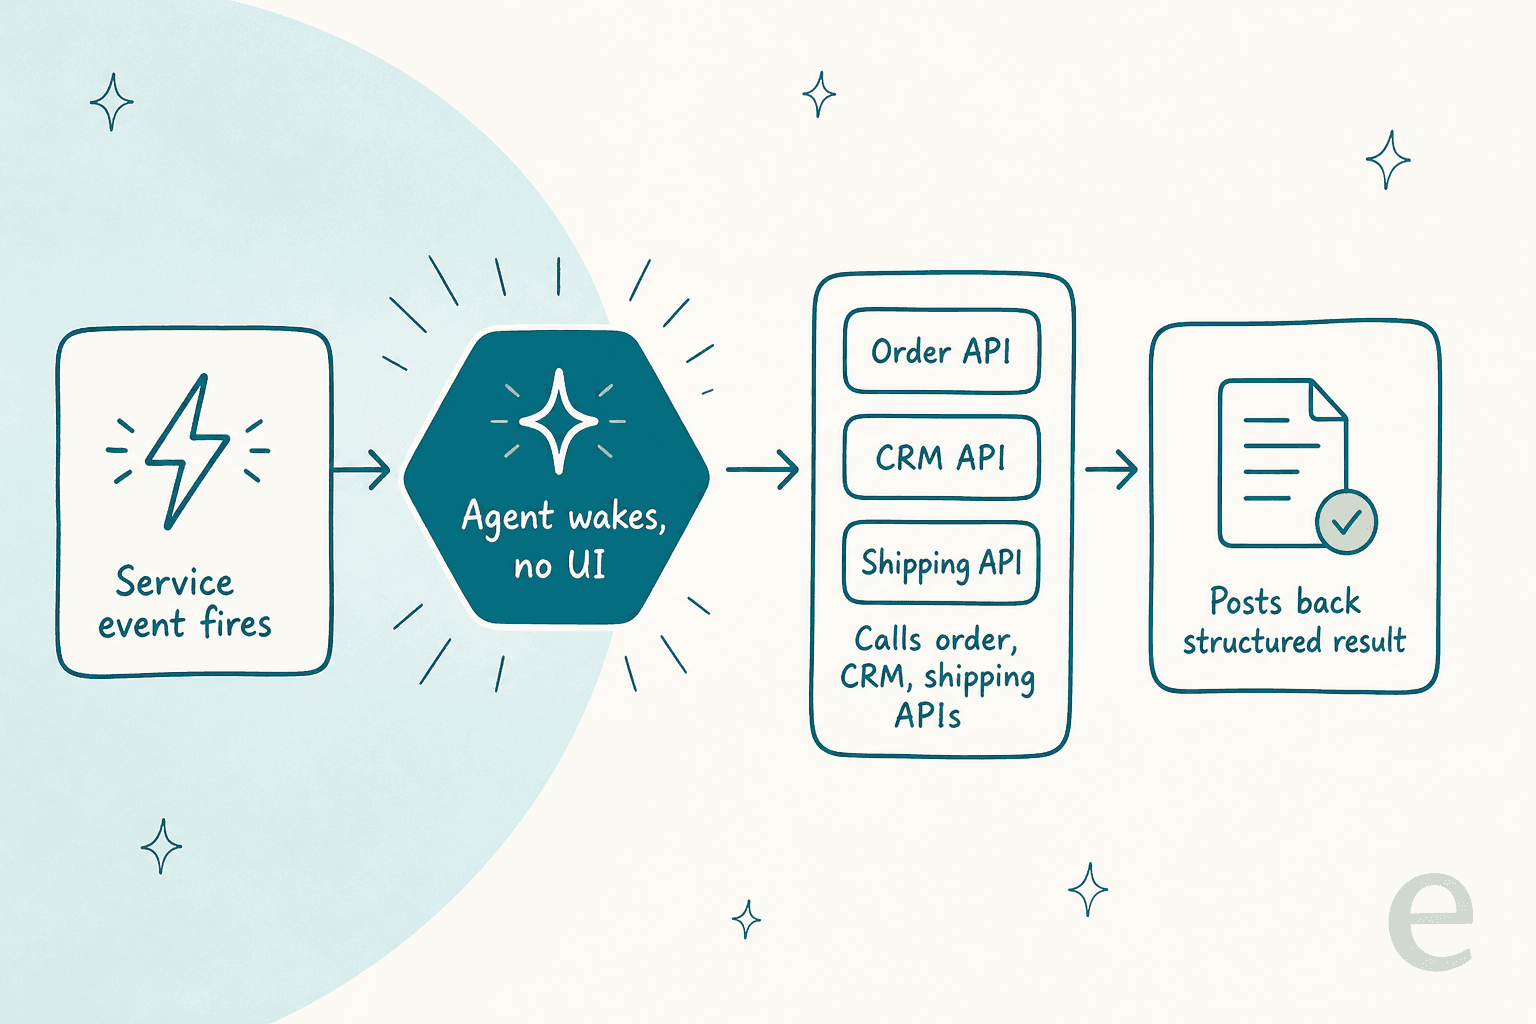
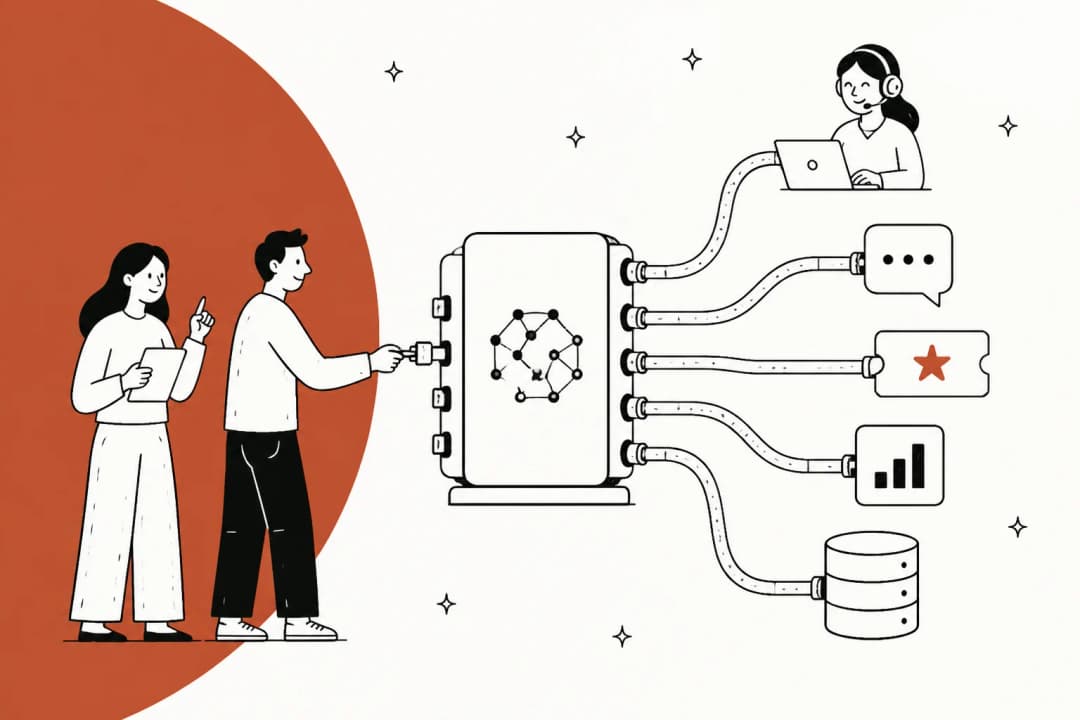
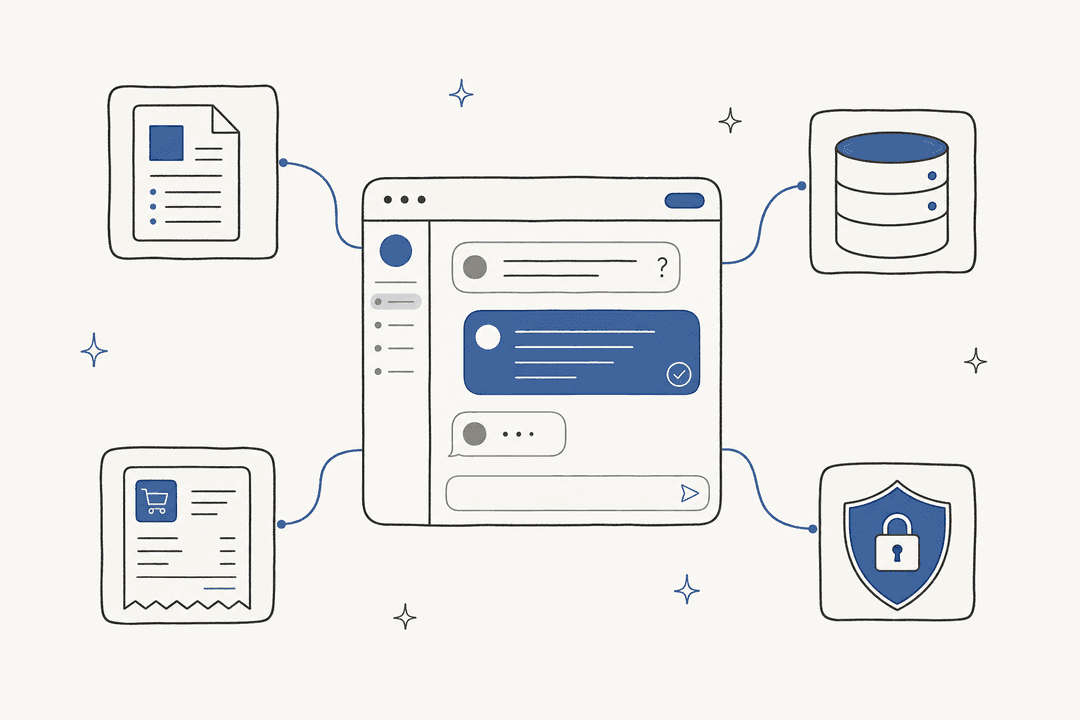
In der Praxis läuft die Schleife wie im obigen Diagramm ab. Ein Service-Event feuert, meist ein Webhook: Ein Ticket wird erstellt, ein Bestellstatus ändert sich, eine Slack-Nachricht kommt an. Der Agent wacht auf, ohne Bildschirm und ohne Sitzung. Er ruft alle APIs auf, die er braucht, das Bestellsystem, das CRM, den Versanddienstleister, um Kontext zu sammeln und eine Aktion auszuführen. Dann meldet er ein strukturiertes Ergebnis zurück: einen Antwortentwurf, ein Tag, eine Statusänderung, eine Payload, die ein anderer Dienst konsumiert.
Dieser Schritt „meldet ein strukturiertes Ergebnis zurück" lohnt sich zu betrachten. Wenn ein menschlicher Agent ein Ticket abschließt, ist die Ausgabe Prosa, die eine Person liest. Wenn ein Service-zu-Service-Agent fertig ist, sind die Ausgaben oft Daten, auf die ein anderes Programm reagiert, also müssen sie wie eine API-Antwort geformt und validiert werden, nicht wie eine Chat-Nachricht. Das ist der Wechsel, der Teams stolpern lässt: Sie bauen nicht mehr eine bessere Antwort, Sie bauen einen zuverlässigen Funktionsaufruf, der zufällig von einem Sprachmodell angetrieben wird.
Wenn Sie die tiefere Version dieses Musters wollen, haben wir es aus mehreren Blickwinkeln aufgeschrieben: die Sicht der Customer-Support-Agent-API (die Baurouten), die Sicht der KI-Helpdesk-API (die zwei Aufgaben, die eine API erfüllt), und die Sicht des Headless-KI-Kundensupports (Support ganz ohne Dashboard betreiben). Dieser Beitrag behandelt das Thema, den Agenten als Dienst in Ihrer Architektur zu betrachten.
Warum Service-zu-Service ein anderes Problem ist als ein Chatbot
Wenn ein Mensch im Chat ist, werden viele Sünden verziehen. Wenn der Bot stockt, wartet die Person. Wenn er eine leicht danebenliegende Antwort gibt, formuliert die Person um. Wenn er ein Login braucht, loggt sich die Person ein. Der Mensch ist ein lebender Fehlerbehandler, der in jeder Interaktion sitzt.
Nimmt man den Menschen heraus, wird all das zu Ihrer Aufgabe. Niemand ist da, um den Aufruf zu wiederholen, niemand bemerkt das Timeout, niemand sieht, dass der Agent das falsche Konto benutzt hat. Der Agent ist jetzt eine Komponente, von der andere Komponenten abhängen, und er muss sich wie eine verhalten: vorhersehbare Schnittstelle, definierte Fehlermodi, eigene Zugangsdaten.
Genau hier zeigt sich auch der echte Wert, der im Hype leicht verloren geht. Wie es ein Hacker-News-Kommentator in einem Thread über das Verbinden von Agenten mit Tools formulierte:
"The 'system integration' benefits only matter when you have an LLM in the loop making decisions about which tools to use."

Das ist die ehrliche Einordnung. Wenn Ihre Automatisierung eine feste Abfolge von API-Aufrufen ohne Urteilsvermögen ist, brauchen Sie keinen Agenten, Sie brauchen ein Skript, und ein einfaches Skript wird einfacher und zuverlässiger sein. Der Agent verdient seinen Platz genau dann, wenn der nächste Aufruf von einer Auswertung unübersichtlicher Eingaben abhängt: eine frustrierte Kundennachricht lesen, entscheiden, ob es sich um eine Rückerstattung oder einen Garantiefall handelt, auswählen, welches von fünf internen Systemen abzufragen ist. Der Service-zu-Service-Wrapper lohnt die Komplexität nur, wenn in der Mitte eine echte Entscheidung steckt.
Der Haken: ein nicht-deterministischer Dienst in einem deterministischen Mesh
Hier ist die Sache, von der ich mir wünschte, jemand hätte sie mir gesagt, bevor ich meinen ersten Agenten in ein Service-Mesh eingebunden habe. Jeder andere Dienst in Ihrer Architektur ist deterministisch: gleiche Anfrage rein, gleiche Antwort raus, jedes Mal. Sie können ihn cachen, Sie können ihn wiederholen, Sie können einen exakten Vergleichstest dafür schreiben. Der KI-Agent ist die eine Box, die diesen Vertrag bricht.
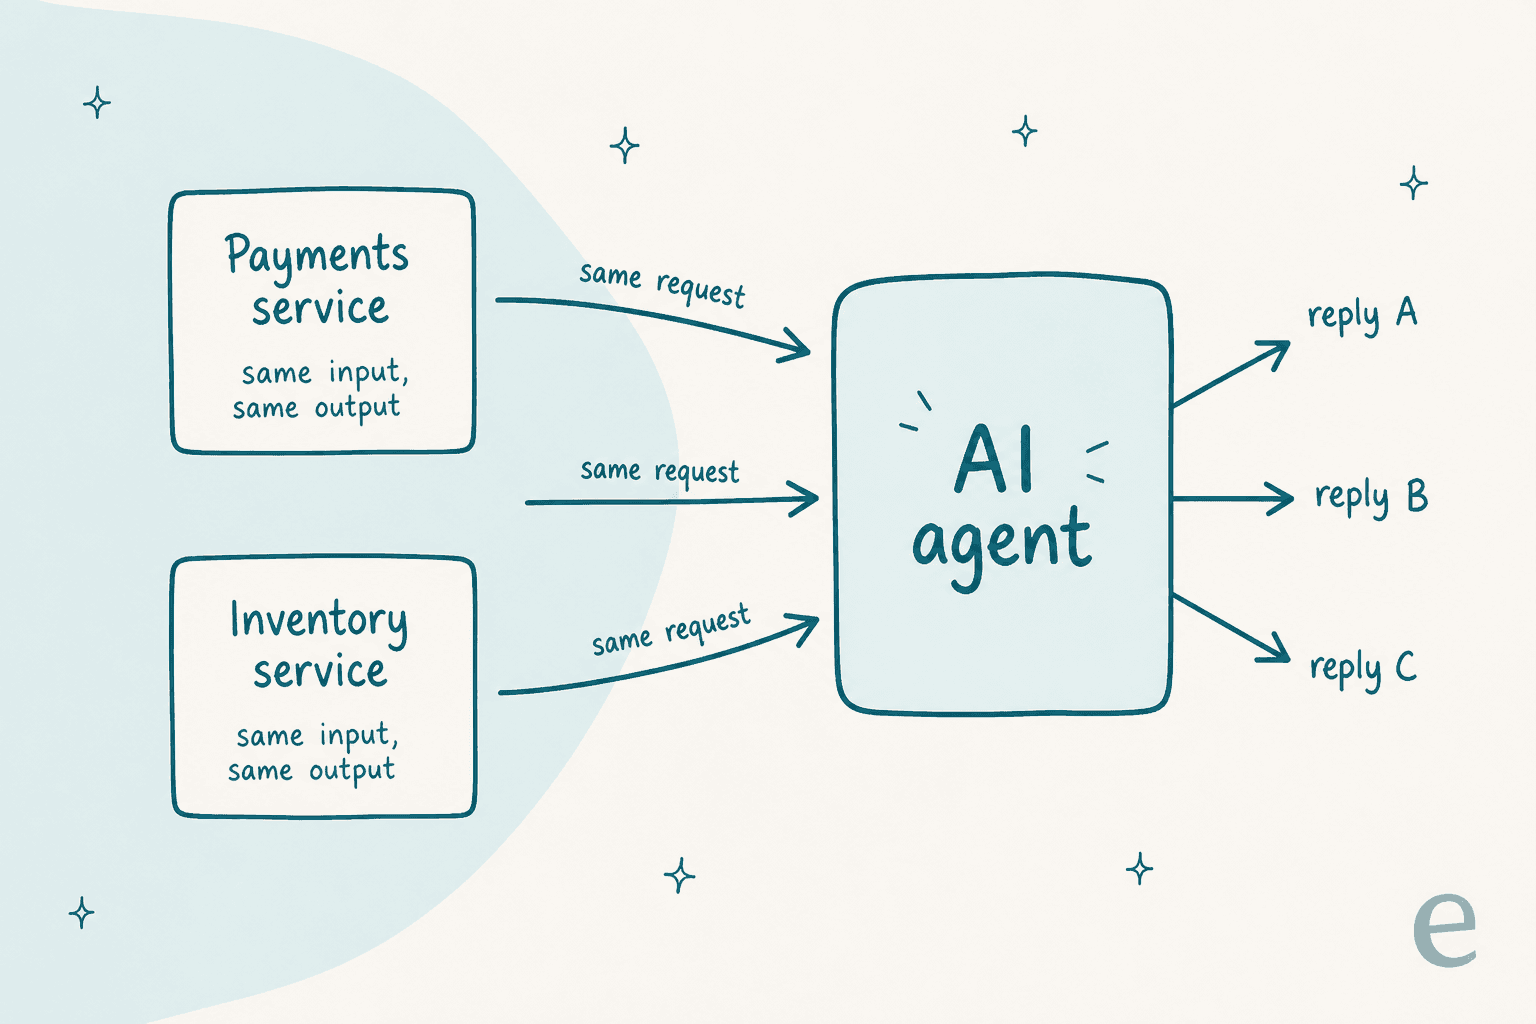
Schicken Sie dieselbe Anfrage dreimal an Ihren Zahlungsdienst und Sie bekommen dreimal dieselbe Antwort. Schicken Sie dieselbe Anfrage dreimal an den Agenten und Sie können Antwort A, Antwort B und Antwort C bekommen. Das ist kein Bug, den man beheben kann, es liegt in der Natur des Modells. Und es kehrt Ihren üblichen Instinkt um: Weil der Agent weniger vorhersehbar ist als die Dienste um ihn herum, braucht er mehr der Schutzmaßnahmen, die Sie normalerweise für die instabile externe Abhängigkeit reservieren würden, nicht weniger.
Konkret bedeutet das: Sie können die Ausgabe des Agenten nicht schon deshalb als vertrauenswürdig behandeln, weil der Aufruf erfolgreich war. Ein 200 OK von einem normalen Dienst bedeutet, dass die Antwort richtig ist. Ein 200 OK von einem Agenten bedeutet, dass er eine Antwort produziert hat. Ob diese Antwort korrekt ist, ist eine separate Frage, die Sie mit Validierung, Guardrails und Tests beantworten müssen, bevor die Ausgabe weiterfließt. Wir haben selbstsicher klingende Agenten gesehen, die auf Live-Queues falsche Antworten gegeben haben, genau deshalb simulieren wir jetzt jedes Rollout zuerst gegen historische Tickets, aber dazu gleich mehr.
Der Service-zu-Service-Vertrag, den Sie tatsächlich eingehen
Sobald man akzeptiert, dass der Agent ein Dienst ist, schreibt sich die Checkliste von selbst. Es ist dieselbe Checkliste, die Sie auf jeden Produktionsdienst anwenden würden, plus einen Punkt, der einzigartig für Agenten ist. Das ist der langweilige Kram, und der langweilige Kram ist es, der eine Demo von etwas unterscheidet, das über Nacht laufen kann.
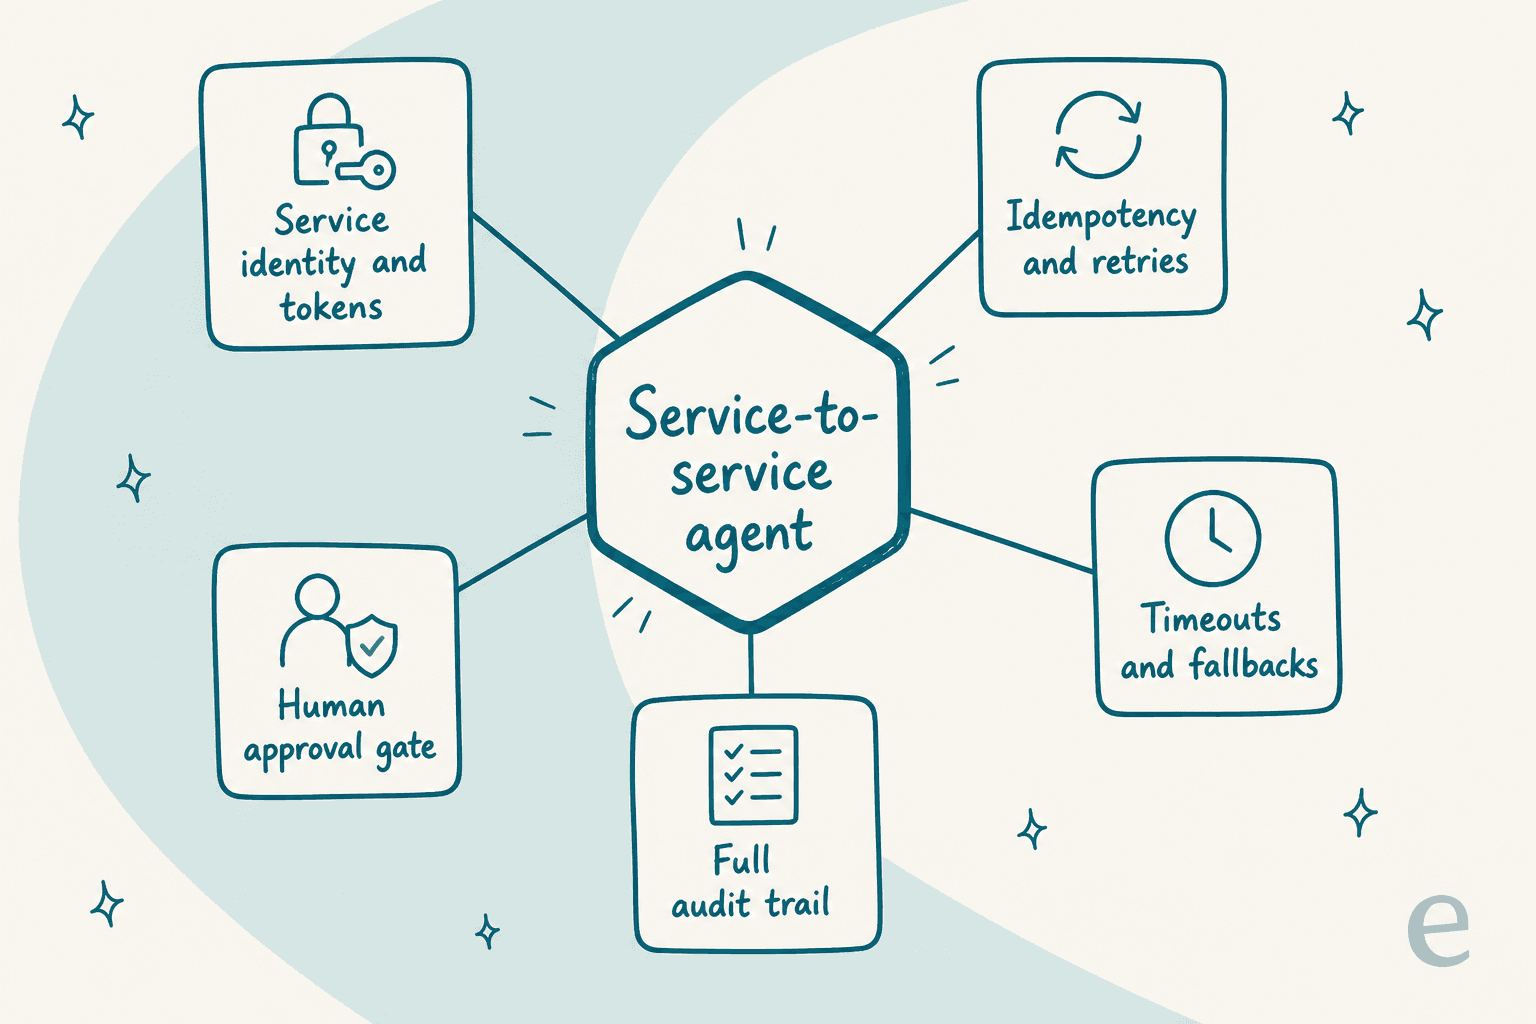
Service-Identität und Tokens. Der Agent authentifiziert sich als er selbst, mit begrenzten API-Tokens oder einem Service-Account, nicht indem er das Login eines Menschen ausleiht. Das ist wichtig für den Auth-Scope und für die Zuordnung: Wenn der Agent ein Ticket aktualisiert, sollte das Audit-Log sagen, dass der Agent es getan hat. Eine wiederkehrende Lücke in diesem gesamten Bereich ist die Auth bei den Verbindungen, die ein Agent herstellt:
"Most providers don't support auth in their client implementations yet. Means it's only good for calling into public data. Private enterprise data is where there's huge value."
Der Wert in der Support-Automatisierung steckt fast vollständig in den privaten Daten, der Bestellung, dem Konto, der Ticket-Historie, also ist es kein Nice-to-have, die Service-Auth richtig hinzubekommen.
Idempotenz und Retries. Weil Sie wiederholen werden (Netzwerke fallen aus), brauchen die Aktionen des Agenten Idempotenz-Schlüssel, damit ein wiederholtes „sende diese Rückerstattung" nicht zwei Rückerstattungen sendet. Das ist Standard-Payments-Disziplin, und sie gilt in dem Moment, in dem ein Agent eine reale Aktion ausführen kann.
Timeouts und Fallbacks. Modellaufrufe sind langsam und hängen sich gelegentlich auf. Jeder S2S-Agentenaufruf braucht ein Timeout und einen definierten Fallback: an einen Menschen weiterleiten, für später einreihen, einen sicheren Standardwert zurückgeben. Schweigen ist keine akzeptable Antwort, wenn ein anderer Dienst auf Sie wartet.
Ein vollständiger Audit-Trail. Jeder Lauf, jeder Tool-Aufruf, jede Entscheidung, protokolliert und wiedergebbar. Wenn um 2 Uhr nachts etwas schiefgeht, müssen Sie genau sehen, was der Agent gesehen und getan hat, nicht raten.
Ein menschliches Freigabe-Gate. Der Punkt, der einzigartig für Agenten ist. Bei risikoreichen Aktionen (Rückerstattungen ausstellen, Konten schließen, irgendetwas Unumkehrbares senden) wollen Sie einen Human-in-the-Loop-Checkpoint, an dem der Agent pausiert, statt eines vollständig autonomen Sendens. Die beste Formulierung der gesamten Denkweise kam von einem anderen Praktiker:
"MCP is just a small, boring protocol that lets agents call tools in a standard way, nothing more... Teams that already handle HTTP APIs safely can apply the same basics here: auth, logging, and isolation."
Das ist das ganze Spiel. Wenn Sie bereits Dienste verantwortungsvoll betreiben, wissen Sie bereits, wie man einen Agenten verantwortungsvoll betreibt. Sie müssen sich nur daran erinnern, es tatsächlich zu tun, denn die Demo funktioniert auch ohne all das, und genau das ist die Falle.
Wie Service-zu-Service im Kundensupport aussieht
Support ist einer der saubersten Anwendungsfälle für dieses Muster, weil ein Support-Ticket bereits ein Event ist und die Systeme, die es berührt, bereits APIs haben. Hier ist ein konkreter Ablauf.
Ein Kunde schreibt eine E-Mail „wo ist meine Bestellung?". Ihr Helpdesk feuert einen Webhook. Der Agent wacht auf, liest die Nachricht und stellt fest, dass er einen Bestellstatus braucht. Er ruft die API Ihrer Commerce-Plattform für die Bestellung auf, ruft die API des Versanddienstleisters für den Tracking-Status auf, prüft den Kundendatensatz in Ihrem CRM auf etwas Relevantes (VIP, offene Beschwerde), und entwirft dann entweder eine Antwort zur Freigabe durch einen Menschen oder, wenn Sie es zugelassen haben, sendet die Antwort und markiert das Ticket als gelöst. Kein Dashboard wurde geöffnet. Jeder Schritt war ein Dienst, der mit einem anderen sprach.
Das ist derselbe WISMO-Flow („where is my order"), den ein menschlicher Agent hundertmal am Tag durchführt, nur ausgedrückt als Machine-to-Machine-Aufrufe. Die Tools, zu denen die meisten Support-Teams greifen, Gorgias, Front, Freshdesk, stellen alle die Webhooks und APIs bereit, die das möglich machen, und liefern zunehmend eigene Agent-orientierte Oberflächen obendrauf.
Der Grund, sich um die S2S-Einordnung hier zu kümmern, ist, dass sie ändert, was Sie testen. Einen Chatbot bewerten Sie nach Antwortqualität. Einen Service-zu-Service-Agenten müssen Sie zusätzlich am Vertrag bewerten: Wiederholt er sauber, läuft er elegant in ein Timeout, protokolliert er jede Aktion, hält er an, bevor er etwas Unumkehrbares tut. Wenn Sie nur die Antworten testen, haben Sie nur die halbe Sache getestet.
Selbst bauen oder einen Teamkollegen engagieren, der bereits Service-zu-Service spricht
Sie haben zwei ehrliche Optionen.
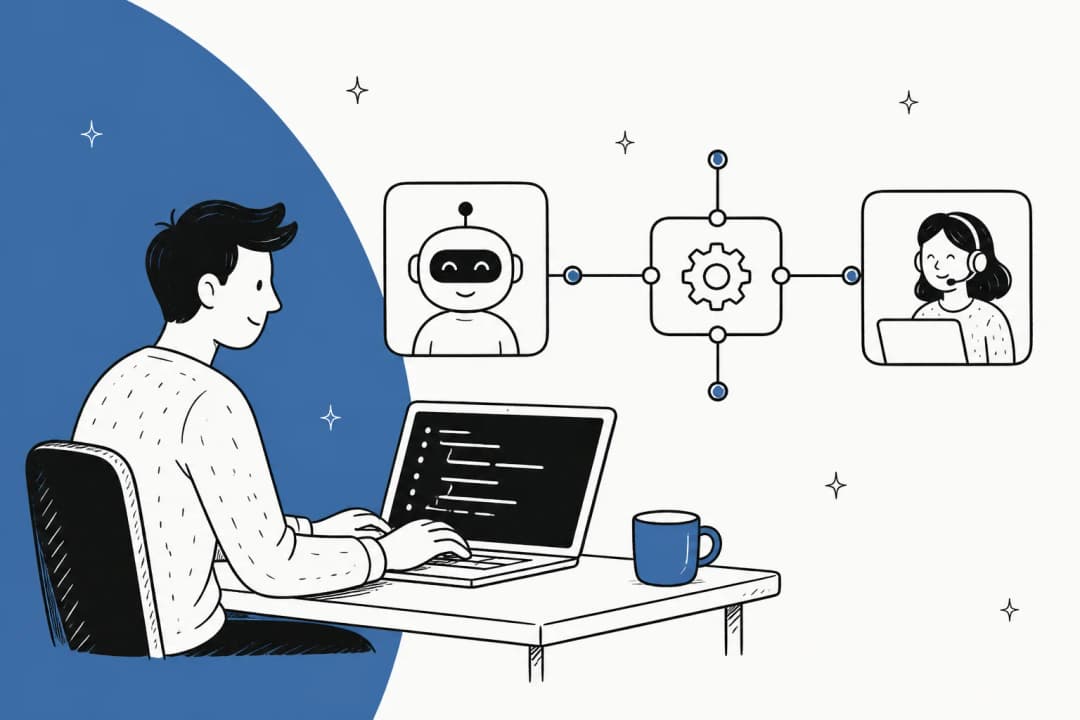
Sie können die Verkabelung bauen. Eine Queue aufsetzen, die Webhooks verdrahten, den Integrationscode für jedes System schreiben, das der Agent berührt, die Auth, die Retries, die Idempotenz, das Audit-Log, den Eval-Harness handhaben. Das ist alles gut erprobtes Engineering, nichts davon ist exotisch, und für ein Team, das volle Kontrolle will, ist es ein vernünftiger Weg. Unsere Leitfäden zur Customer-Support-Agent-API und zum Betrieb eines Agenten über die Kommandozeile führen durch die Baurouten.
Oder Sie engagieren einen Agenten, der die Service-zu-Service-Oberfläche bereits bereitstellt, sodass Sie sich in ihn einbinden, statt ihn zusammenzusetzen. Das ist der eesel-Ansatz, und weil er für diesen Beitrag direkt relevant ist, hier die konkrete Oberfläche statt eines Pitches.
eesels KI-Agent ist von Anfang bis Ende programmierbar. Jeder Workspace ist selbst ein Model Context Protocol Server: Führen Sie npx @eesel/cli mcp token aus, und Sie erhalten eine URL und ein Token, das Sie jedem MCP-Client geben können. Er hört auf Webhooks, sodass jeder Ihrer Dienste ihn mit einem HTTP-Aufruf wecken kann. Und über Network Access kann er jede REST-API aufrufen, die Sie zulassen, wobei die Zugangsdaten als Request-Header gespeichert werden, die das Modell selbst nie sieht, genau die Disziplin bei Service-Identität und Auth aus dem oben genannten Vertrag, für Sie erledigt.
Das Ganze ist auch vom Terminal aus steuerbar. Die CLI authentifiziert sich headless mit Umgebungsvariablen für CI, gibt bei jedem Befehl JSON aus und hat ein --dry-run-Flag, das genau den Server-Aufruf zeigt, den ein Schreibvorgang machen würde, ohne ihn abzusenden, sodass Sie sie in eine Pipeline einbinden und als Code verwalten können. Wenn Sie die Day-Two-Operations-Sicht darauf wollen, haben wir das separat unter KI-Agenten vom Terminal aus verwalten aufgeschrieben.
eesel ausprobieren
Wenn Sie abwägen, ob Sie den Service-zu-Service-Stack selbst zusammenbauen oder mit einem bereits existierenden starten sollen, ist der schnellste Weg, es herauszufinden, eesel auf Ihre eigenen Tickets anzusetzen und zuzuschauen, wie es läuft. Bevor irgendetwas live geht, spielt sein Simulationsmodus den Agenten gegen Tausende Ihrer echten historischen Tickets ab, sodass Sie die Antworten und die Aktionen sehen, die er durchgeführt hätte, an Ihren tatsächlichen Daten, statt einer Demo zu vertrauen. Das ist die ehrliche Version von „einen nicht-deterministischen Dienst testen": ihn über echte Fälle laufen lassen und lesen, was er tut.
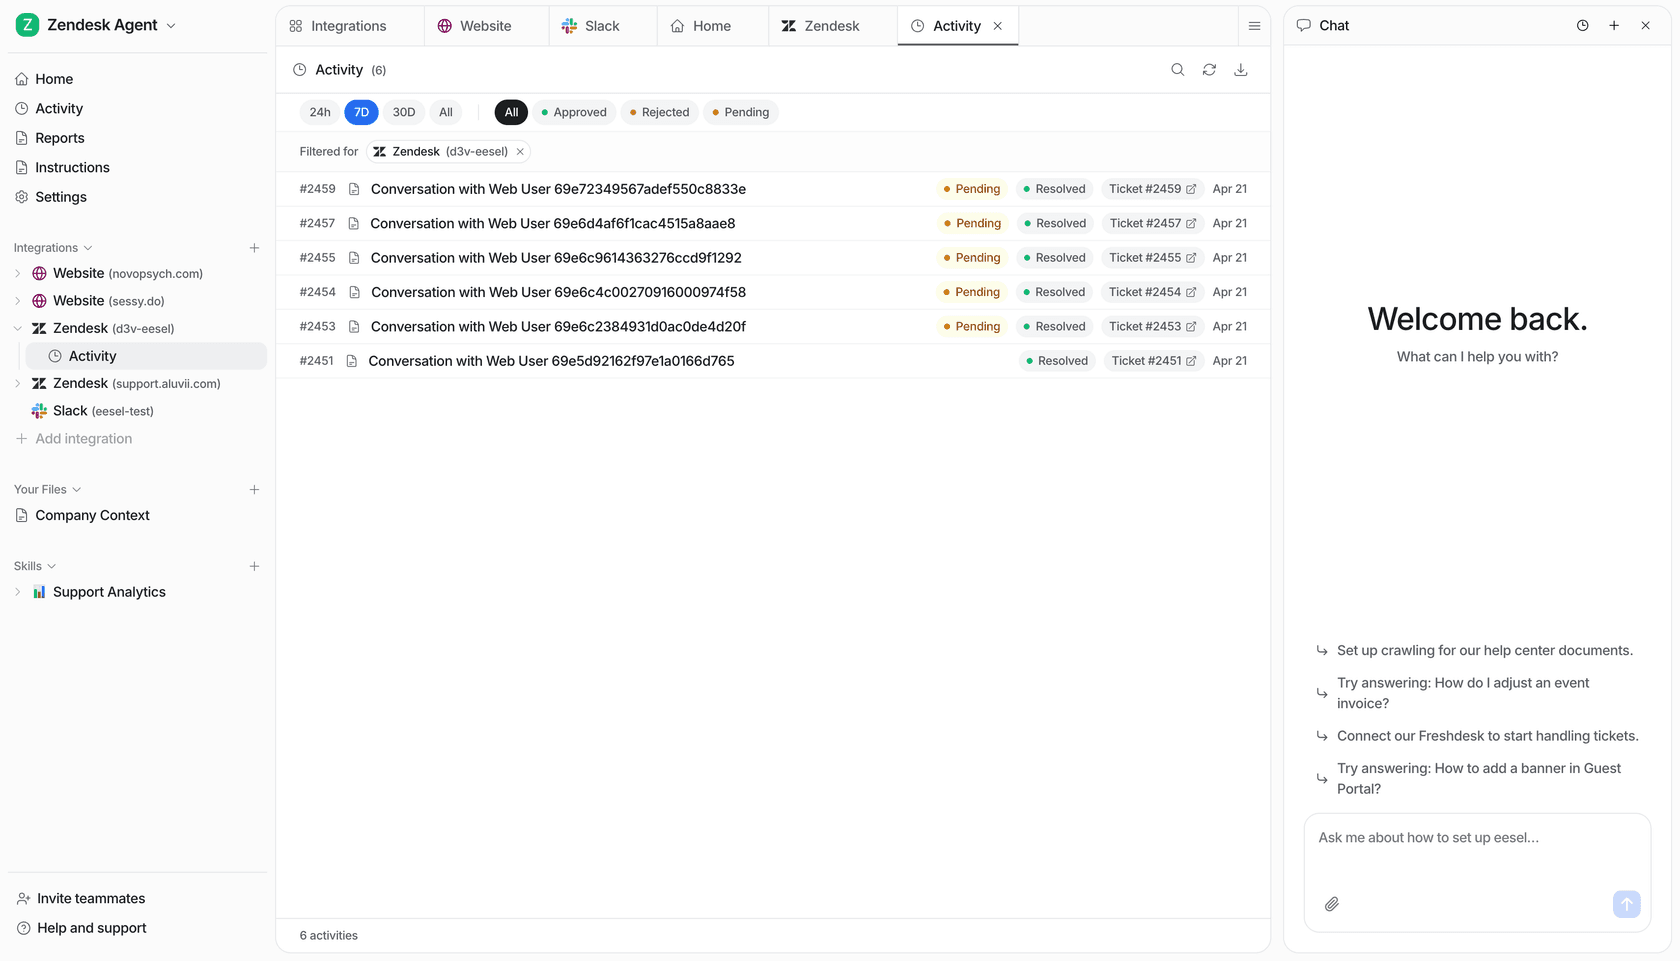
Jeder Lauf landet dann in einem Aktivitätslog, das Sie im Dashboard oder in der CLI lesen können, das ist der Audit-Trail, den der Vertrag verlangt. Die Preisgestaltung ist nutzungsbasiert mit 0,40 $ pro Ticket, mit einem kostenlosen Guthaben von 50 $ zum Start, ohne Gebühr pro Sitzplatz und ohne Plattformgebühr unterhalb von Enterprise, das ist die Abrechnungsform, die tatsächlich Sinn ergibt, wenn ein Dienst und nicht ein Sitzplatz die Arbeit erledigt. Sie können kostenlos starten, ohne Kreditkarte und ohne Verkaufsgespräch, und in Minuten sehen, wie es an Ihren eigenen Daten funktioniert.
Häufig gestellte Fragen
Was ist ein Service-zu-Service-KI-Agent?
Wie unterscheidet sich ein Service-zu-Service-Agent von einem Chatbot?
Muss ich einen Service-zu-Service-KI-Agenten selbst bauen?
Wie authentifiziert man einen Service-zu-Service-KI-Agenten?
Wie viel kostet der Betrieb eines Service-zu-Service-Support-Agenten?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.