Was Leute wirklich mit „Customer Support Agent API“ meinen
Suche nach „customer support agent API“ und du bekommst Ergebnisse, die kaum etwas miteinander zu tun haben. Das liegt daran, dass der Begriff drei grundverschiedene Aufgaben in einer Formulierung zusammenfasst, und die Leserin oder der Leser hinter jedem Ergebnis will etwas anderes.
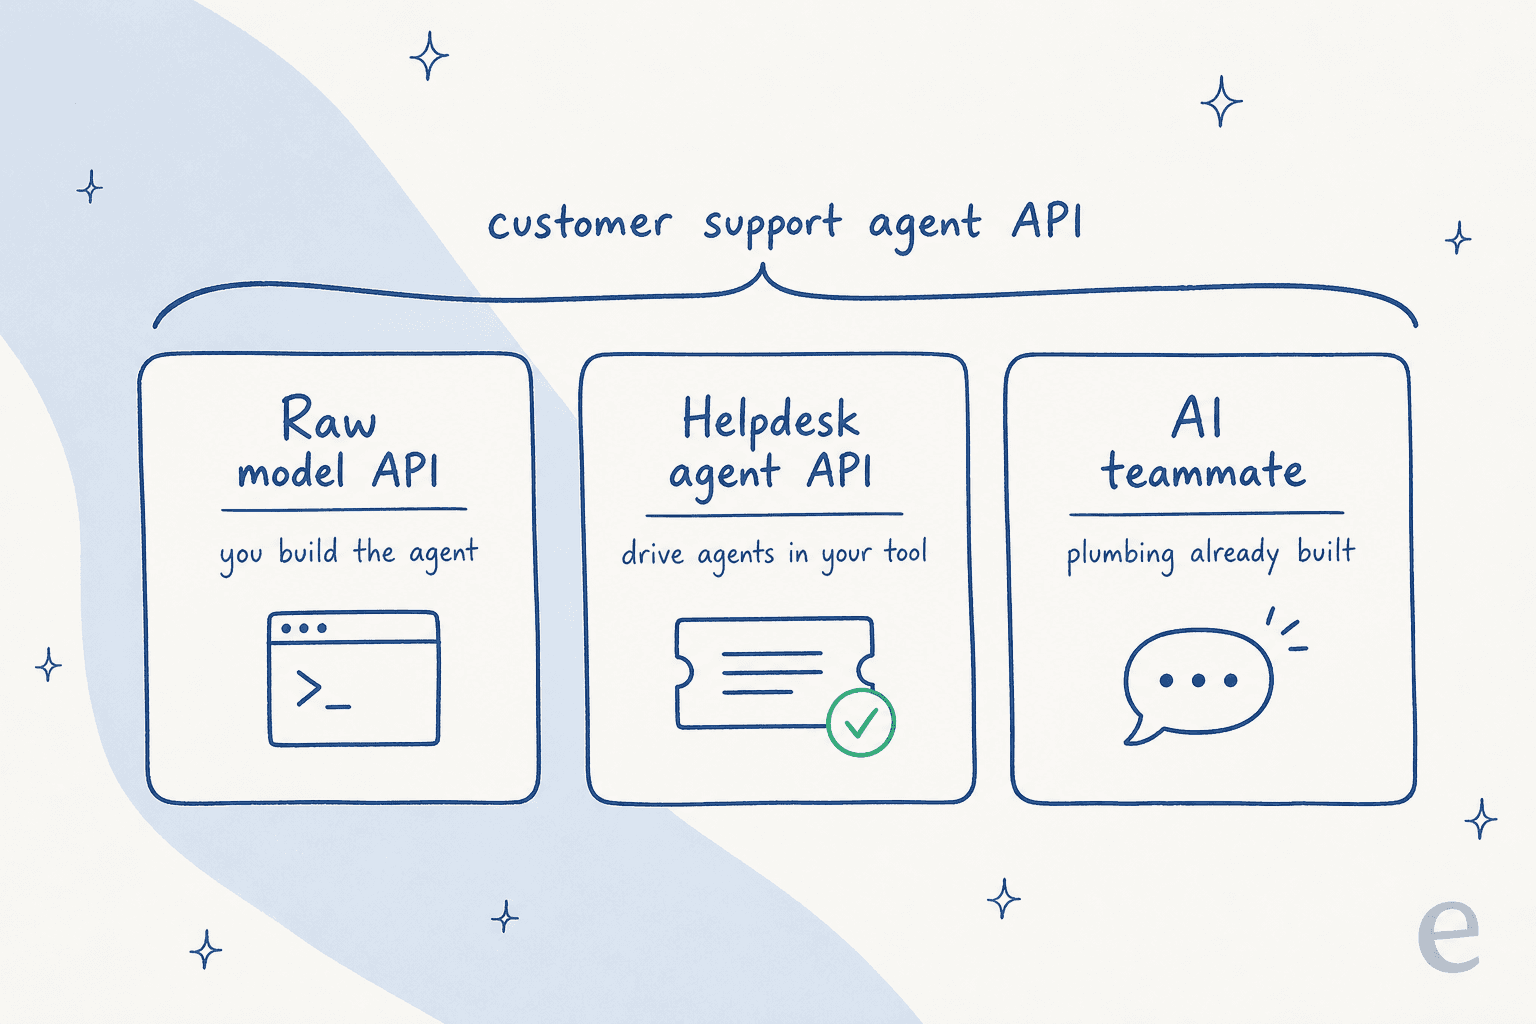
Die drei Wege, danach geordnet, wie viel du selbst baust:
- Selbst bauen auf einer Foundation-Model-API. Du bekommst ein Modell und Bausteine; du setzt den Agenten selbst zusammen.
- Deinen Helpdesk steuern über dessen Agenten-, Conversations- oder MCP-API. Der Anbieter besitzt die Support-Oberfläche; du richtest einen Agenten darauf aus.
- Ein fertiges Teammitglied einstellen, das bereits weiß, wie man Support macht. Die Infrastruktur ist gebaut; du konfigurierst es und gehst live.
Ich gehe jeden einzeln durch: was er dir wirklich gibt und wo die versteckte Arbeit steckt. Wenn du nur eines aus diesem Artikel mitnimmst: die API ist niemals der Agent. Los geht's, warum das so ist.
Weg 1: Selbst bauen auf einer reinen Modell-API
Das ist der Weg, den die meisten Entwickler zuerst vor Augen haben, und er ist derjenige, der sich still und leise in ein Neun-Monats-Projekt verwandelt. Sowohl OpenAI als auch Anthropic verkaufen Modell-Infrastruktur, keinen fertigen Support-Agenten. Beide sind hervorragend in dem, was sie tun. Sie decken nur einen viel kleineren Ausschnitt von „Customer Support Agent“ ab, als der Begriff suggeriert.
Hier ist, was du bekommst. OpenAIs Responses API ist die primäre Aufruf-Oberfläche, und das quelloffene Agents SDK führt die Agent-Schleife in deinem eigenen Prozess aus. OpenAIs eigene Dokumentation ist unverblümt bei der Aufteilung: Du besitzt „Deployment, Tool-Implementierungen, State-Speicherung und Genehmigungsentscheidungen, während das SDK die Agent-Schleife ausführt.“ Bei Anthropic sieht es genauso aus. Die Messages API plus Tool Use gibt dir einen strukturierten Tool-Aufruf; dein Code führt ihn aus. Das Claude Agent SDK fügt Sessions, Hooks, Subagenten und Berechtigungen hinzu, aber die Schleife läuft weiterhin in deinem Prozess, und die Persistenz ist deine Integration.
Beide geben dir dieselben Bausteine: ein Modell, eine Möglichkeit, Tools zu definieren, eine Agent-Schleife, gehostete Retrieval-Primitive (OpenAIs File Search, serverseitige Tool Use bei Anthropic) und, für Sprachsupport, OpenAIs Realtime API. Was dir keines von beidem gibt, ist der eigentliche Support-Agent.
Was die API dir gibt, gegenüber dem, was du selbst baust
Die Lücke ist größer, als sie auf einem Quickstart aussieht. Eine „Bestellung nachschlagen und Rückerstattung auslösen“-Funktion ist ein Tool-Aufruf, den das Modell ausgibt; der Code, der mit Shopify und deinem Abrechnungssystem spricht, ist vollständig deiner. Dasselbe gilt für jedes andere tragende Element eines Support-Agenten.
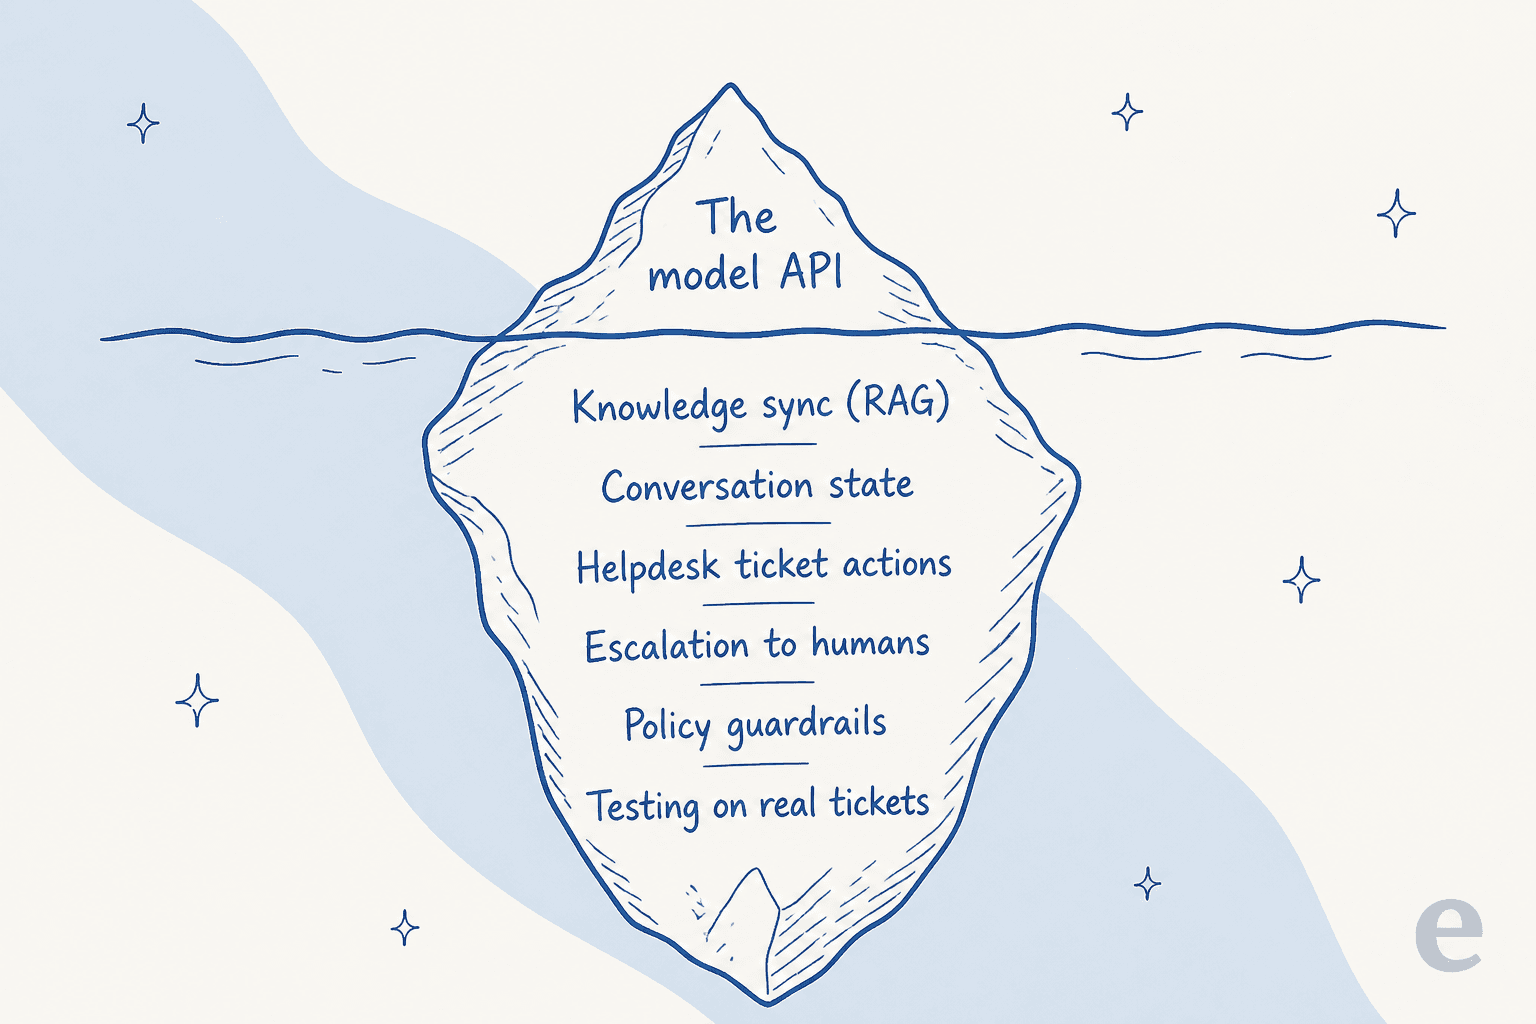
Alles unterhalb der Wasserlinie ist deine Ingenieursarbeit:
- Wissensabgleich und Retrieval. File Search und Tool Use geben dir einen Retrieval-Mechanismus, aber ihn mit deinem Live-Helpcenter synchron zu halten, plus Chunking, Reranking und Zugriffskontrolle, ist deine Aufgabe.
- Konversationsstatus. Die Basis-APIs sind zustandslos pro Aufruf. Du speicherst und sendest den Verlauf selbst erneut.
- Ticket-Aktionen. Ein Zendesk-Ticket aktualisieren, an Tier 2 eskalieren, einen Tag vergeben: alles Funktions-Tools, die du implementierst.
- Guardrails und Eskalation. Beide SDKs bieten Input-, Output- und Tool-Guardrails plus menschliche Freigabe, aber jede ist Code, den du pro Richtlinie schreibst.
- Tests gegen echte Tickets. Du bekommst Tracing und Eval-Hooks. Die Testsuite, die deinen Verlauf abspielt und Antworten bewertet, ist dein Build.
Das ist keine Kritik an den Modellanbietern. Es ist einfach der ehrliche Umfang. Wenn du den tieferen Primitiven-Vergleich willst, geht unser Vergleich AgentKit vs. Anthropic API Tool für Tool durch.
Die Pro-Token-Rechnung, die niemand einplant
Das Kostenmodell ist die schärfste Überraschung. Du zahlst pro Token für jede einzelne Nachricht, egal ob das Ticket jemals gelöst wird, für den System-Prompt, die abgerufenen Wissens-Chunks, die Tool-Call-Roundtrips, die Modell-Reasoning und jeden Retry.
Grobe Erstanbieter-Preise, pro Million Token auf der Standard-Stufe:
| Modell | Input | Cached Input / Treffer | Output |
|---|---|---|---|
| OpenAI gpt-6-astra | 10,00 $ | 1,00 $ | 50,00 $ |
| OpenAI gpt-5.6-terra | 2,00 $ | 0,20 $ | 12,00 $ |
| Anthropic Claude Opus 5 | 5,00 $ | 0,50 $ | 25,00 $ |
| Anthropic Claude Sonnet 5 | 2,00 $ | 0,20 $ | 10,00 $ |
| Anthropic Claude Haiku 4.5 | 1,00 $ | 0,10 $ | 5,00 $ |
Prompt-Caching hilft bei Support sehr, da du bei jeder Runde denselben Helpcenter-Kontext erneut sendest: Ein Cache-Treffer wird zu etwa 10 % des Standard-Input-Preises gelesen. Aber Caching dämpft nur die Zahl, es ändert nicht die Abrechnungseinheit. Eine Support-Konversation, die zehn Runden dauert, bei jeder Runde zwölf Chunks abruft und zweimal wiederholt wird, rechnet all das ab, selbst wenn der Kunde unzufrieden davongeht.
Weg 2: Deinen Helpdesk über dessen eigene Agenten-API steuern
Der zweite Weg überspringt den Bau des ganzen Agenten und richtet stattdessen einen auf den Helpdesk aus, den du bereits betreibst. Jeder größere Helpdesk bietet eine programmatische Oberfläche, und die Form dieser Oberfläche hat sich im letzten Jahr stark verändert.
Die klassische Variante ist eine REST-API plus Webhooks. Nimm Zendesk. Du kannst ein externes Modell über vier Wege einbinden: einen Erstanbieter-Connector mit deinem eigenen Schlüssel, einen Webhook aus einem Trigger zu deinem eigenen Dienst und zurück über die REST-API, eine Sidebar-App, die das Modell über Zendesks Proxy aufruft, oder einen MCP-Server. Es funktioniert, aber die DIY-Pipeline (Weg zwei) bedeutet, dass du für die Auth, das Polling, die Retries und, entscheidend, die Rate-Limits verantwortlich bist. Diese Limits sind die harte Obergrenze für jede Integration:
| Zendesk-Suite-Plan | API-Anfragen / Minute |
|---|---|
| Team | 200 |
| Growth | 400 |
| Professional | 400 |
| Enterprise | 700 |
| Enterprise Plus | 2.500 |
Jede Anreicherung, jedes Zurückschreiben und jedes Nachbearbeiten historischer Tickets verbraucht vom selben Pro-Minute-Budget. Das vergisst man leicht, bis ein Bulk-Reprocessing-Job es überschreitet.
MCP verändert diesen Weg still und leise
Die größere Verschiebung ist, dass Helpdesks von „hier ist eine REST-API, bau selbst“ zu eigenen Model-Context-Protocol-Servern übergegangen sind. MCP ist ein offener, von Anthropic eingeführter Standard, um Agenten über ein standardisiertes Protokoll mit externen Systemen zu verbinden, statt für jedes Tool eine maßgeschneiderte Integration zu bauen. Zendesks eigene Beschreibung des alten Schmerzpunkts spricht Bände: Echtzeitdaten heute mit KI zu verbinden „erfordert APIs, einen erfahrenen Entwickler (oder zwei) und lange Vorlaufzeiten“, und sie bewerben inzwischen einen Zendesk-MCP-Client, bei dem „im Gegensatz zu APIs MCP-Integrationen nur einmal eingerichtet werden müssen“.
Die Liste der Erstanbieter-Server wächst schnell:
- Gorgias bietet einen kostenlosen MCP-Server unter
mcp.gorgias.com/mcp, jetzt in der offenen Beta, der einen Workspace mit jedem MCP-kompatiblen Client verbindet. - Front dokumentiert einen Server unter
mcp.frontapp.com/mcpmit einem ungewöhnlich sauberen Berechtigungsmodell: OAuth 2.1 mit PKCE, Tokens pro Nutzer und die Scopesread,write,send, sodass „die effektiven Berechtigungen des Agenten genau die Berechtigungen des autorisierenden Teammitglieds sind“. - Atlassian betreibt einen offiziellen Remote-MCP-Server, der Jira, Confluence und Jira Service Management über OAuth mit Agenten verbindet. Für ein ITSM-Publikum ist das der primäre Weg, ein Service Desk von einem Agenten aus zu steuern.
Das sind wirklich gute Nachrichten für die Buy-vs-Build-Rechnung. Die Infrastruktur, die du früher von Hand schreiben musstest, pflegt jetzt der Anbieter. Was MCP nicht löst, ist der Agent selbst: Der Server stellt Tools bereit, aber das Denkvermögen, die Retrieval-Qualität und die Guardrails, die entscheiden, wann tatsächlich diese Rückerstattung ausgelöst wird, musst du weiterhin selbst mitbringen. Wenn du die No-Code-Variante suchst, ein Modell mit einem Helpdesk zu verbinden, deckt unser Leitfaden zur Integration von ChatGPT mit Zendesk das ab.
Weg 3: Ein Teammitglied einstellen, das die Infrastruktur mitbringt
Der dritte Weg ist der, der dem entspricht, was die meisten Menschen, die „customer support agent API“ eingeben, eigentlich wollen: ein Agent, der bereits weiß, wie man Support macht, den man auf seinen eigenen Stack ausrichten und konfigurieren kann, statt ihn zusammenzubauen. Hier setzt ein Tool wie eesel an, und es lohnt sich, genau zu sein, warum es eine andere Kategorie ist als die ersten beiden Wege und nicht nur ein hübscherer Wrapper darum.
Ein KI-Helpdesk-Teammitglied kommt mit dem gesamten Eisberg bereits vorgefertigt an. Es trainiert auf deinen bisherigen Tickets und deinem Helpcenter, tritt der Warteschlange in dem Helpdesk bei, den du bereits nutzt, schlägt Bestellungen nach, taggt und triagiert und entwirft oder sendet Antworten. Der Retrieval-Stack, der Konversationsstatus, die Ticket-Aktionen und die Eskalationslogik sind alle abgedeckt. Du konfigurierst Verhalten, statt Infrastruktur zu implementieren.
Der Teil, der einem Entwickler am wichtigsten ist: „fertig gebaut“ bedeutet nicht „geschlossene Blackbox“. eesel behält eine echte programmierbare Oberfläche für die Randfälle, die die Standardeinstellungen nicht abdecken:
- Network Access lässt den Agenten jede REST-API aufrufen, die du erlaubst, mit GET, POST, PATCH und DELETE, und Auth-Headern pro Domain. Zugangsdaten werden als Header gespeichert und dem Modell nie angezeigt.
- Webhooks geben jedem Tool eine eigene URL, die den Agenten mit allem weckt, was es sendet.
- Eine CLI und individuelle Skills lassen dich die Teile skripten, die du selbst besitzen willst, und ein einzelner Skill kann mehrere Tools in einem Durchlauf umfassen: Helpdesk lesen, Shopify prüfen, in Slack posten.
Die Unterscheidung, die ich festhalten würde: Eine reine Modell-API ist Infrastruktur, und eesel ist die Angestellte. Du schreibst weiterhin Code, wo Code einen Mehrwert bringt; du musst nur nicht Retrieval, Status und Helpdesk-Connectors von Grund auf neu bauen, um dorthin zu kommen.
Die 90 %, die das Wort „API“ immer verbirgt
Hier würde ich dem Bau-Instinkt widersprechen. Der Konsens der Entwickler, die tatsächlich Support-Agenten ausgeliefert haben, ist bemerkenswert einheitlich, und es lautet nicht „bau niemals selbst“. Es lautet, dass der Modellaufruf der leichte Teil ist und die Wartungskosten dort liegen, wo das Geld wirklich verbrannt wird.
Fang mit Retrieval an, das jeder unterschätzt. Der meistbeachtete RAG-Thread auf Hacker News (551 Punkte) ist ein Post-Mortem über die Verarbeitung von über 5 Millionen Dokumenten, und ein Microsoft-Engineer, der eine populäre Open-Source-RAG-Vorlage pflegt, widersprach dem Instinkt „einfach eine Vektordatenbank hinzufügen“ deutlich:
"So few developers realize that you need more than just vector search for RAG, so I still spend many of my talks emphasizing the FULL retrieval stack for RAG."

Die eigene Schlussfolgerung des ursprünglichen Posters war, dass einmaliges Retrieval nicht ausreicht; man landet am Ende bei einer agentischen Schleife, die Ergebnisse bewertet und Folgeabfragen stellt. Das ist ein echtes System, kein Konfigurationsschalter.
Dann gibt es das Problem, dass ein Support-Agent handeln kann, nicht nur reden. In einem Ask-HN-Thread über die Vermeidung von Halluzinationen in der Produktion war die schärfste Formulierung genau dazu:
"The failure mode I keep seeing isn't hallucination per se... it's blurred responsibility between intent and execution. Once a model can both decide and act, you've already lost determinism."
Ein Agent, der Rückerstattungen auslösen oder Kontostatus ändern kann, braucht eingeschränkte Aktionsräume und Allow-/Deny-Listen, nicht nur einen besseren Prompt. Und ohne Tests kannst du nicht wissen, ob deine Guardrails halten, was fast niemand richtig macht. Wie es ein r/AI_Agents-Thread formulierte: „kein Fehler geworfen“ und „Aufgabe abgeschlossen“ können beide wahr sein, während die Antwort auf eine Weise falsch war, die zählt. Das ist das stärkste Argument für Simulation: echte vergangene Tickets abspielen und die Antworten des Agenten gegen das bewerten, was dein Team tatsächlich gesendet hat, in einer Sandbox, bevor er eine Live-Warteschlange berührt. Das ist einer der Kern-Skills von eesel genau aus diesem Grund, und es ist das, was ein Build von Grund auf fast immer auslässt.
Schließlich die Wartungskosten, die eigentliche Zahl. Der meistzitierte Realitätscheck, aus einem r/AI_Agents-Thread mit über 460 Kommentaren, benennt es direkt:
"The hardest part wasn't the LLM or voice quality - it was keeping the agent's knowledge current as policies changed and edge cases emerged."

Das ist die Wartung, die die meisten Selbstbau-Pläne nie einplanen. Wir betreiben KI seit Jahren auf Live-Support-Warteschlangen, und die Randfälle sind der ganze Job: die Richtlinie, die letzte Woche geändert wurde, die Produktlinie, die gestern gestartet ist, der eine seltsame Rückerstattungsablauf, der jeden generischen Agenten bricht. Genau das ist die Arbeit, die in keinem Quickstart auftaucht und nie aufhört.
Pro Token vs. pro Ergebnis: das Kostenmodell, das wirklich entscheidet
Zoom heraus, und die drei Wege trennen sich sauber entlang einer Achse: wie du zahlst. Weg eins und zwei setzen dich auf einen Pro-Token-Zähler. Ein fertiger Agent bepreist typischerweise stattdessen pro Einheit erledigter Arbeit.
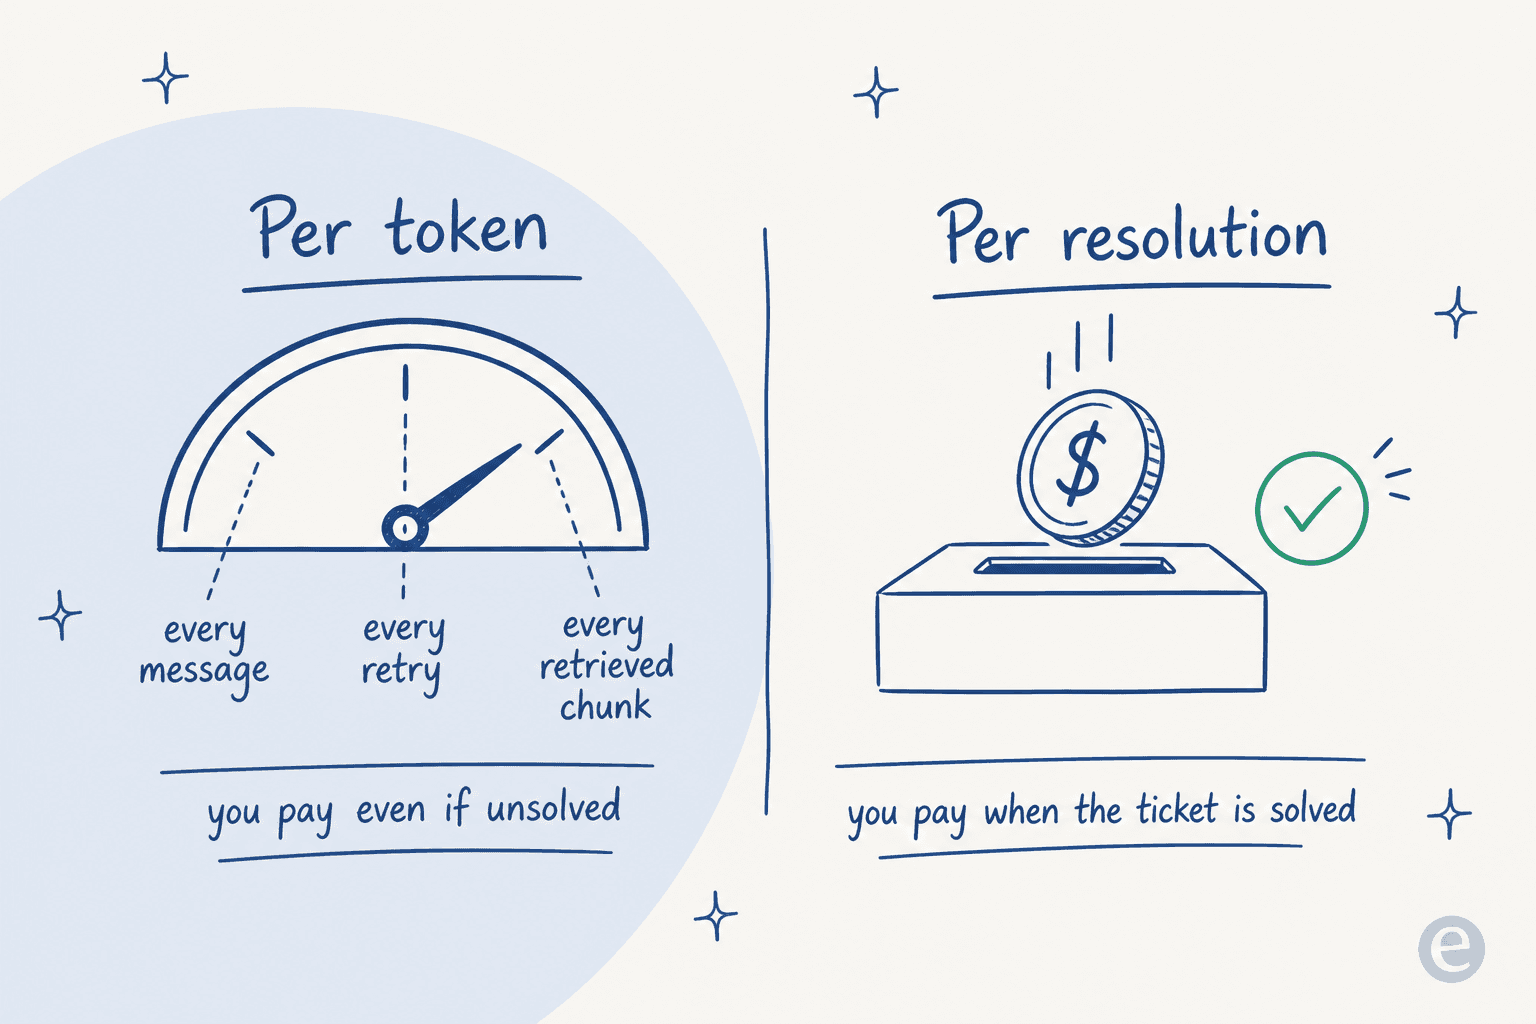
Der Unterschied ist nicht akademisch. Pro Token bedeutet eine unbegrenzte, nutzungsförmige Rechnung, die du prognostizieren und deckeln musst, und sie steigt mit jedem Retry und jeder langen Konversation, gelöst oder nicht. Ergebnisbasierte Preisgestaltung koppelt Ausgaben an erledigte Arbeit. eesel zum Beispiel ist nutzungsbasiert mit etwa 40 US-Cent pro bearbeitetem Ticket, abgerechnet pro Ticket oder Helpdesk-Konversation statt pro Antwort, ohne Gebühr pro Sitzplatz, ohne Plattformgebühr und ohne monatliches Minimum. Rechne das Ingenieursgehalt hinter einem selbst gebauten Agenten und die Wartungsstunden, die er jede Woche frisst, dazu, und der „günstigere“ DIY-Weg ist es oft nicht. Wie es ein Entwickler formulierte: Agenten, die „10 Minuten am Tag sparen, aber still und leise Stunden pro Woche an Wartung kosten“, sind die Falle; die eigentlichen Kosten liegen nie im Bau selbst.
Welchen Weg solltest du also tatsächlich wählen?
Keiner dieser Wege ist falsch. Sie passen zu unterschiedlichen Teams. Hier die Kurzversion, danach eine schnelle Möglichkeit, dich selbst einzuordnen.
Und dieselben Abwägungen als Tabelle:
| Dimension | Reine Modell-API | Helpdesk-Agent / MCP-API | Fertiges Teammitglied |
|---|---|---|---|
| Du baust den Agenten | Ja, alles davon | Das Denkvermögen und die Guardrails | Nein, du konfigurierst ihn |
| Retrieval / Wissensabgleich | Deine Aufgabe | Deine Aufgabe | Bereits eingebaut |
| Helpdesk-Connectors | Deine Aufgabe | Die des Anbieters (eine Plattform) | Bereits eingebaut (1000+) |
| Test vor Go-Live | Du baust das Testgeschirr | Du baust das Testgeschirr | Simulation auf vergangenen Tickets |
| Abrechnungseinheit | Pro Token | Pro Token + Plan-Limits | Pro bearbeitetem Ticket |
| Zeit bis zum ersten gelösten Ticket | Wochen bis Monate | Tage bis Wochen | Minuten bis Stunden |
| Individueller Code weiterhin möglich | Vollständig | Vollständig | Network Access, CLI, Skills |
Wenn du noch das breitere Feld sondierst, gehen unsere Übersichten zu den besten KI-Agenten und der besten KI für Ticket-Triage Tool für Tool durch.
eesel ausprobieren
Wenn du bis hierher gelesen hast und „auf einer Modell-API bauen“ gegen „einen Agenten kaufen“ abwägst: Die ehrliche Antwort für die meisten Support-Teams ist, dass der Eigenbau auf einem Quickstart günstiger aussieht und im zweiten Jahr mehr kostet. eesel ist der dritte Weg, richtig gemacht: ein KI-Support-Teammitglied, das sich in den Helpdesk einklinkt, den du bereits nutzt, auf deinen bisherigen Tickets und Dokumenten trainiert und, der Teil, den ein Eigenbau von Grund auf fast immer auslässt, auf deiner echten Ticket-Historie simuliert, bevor er ein echtes beantwortet.
Du behältst die programmierbare Oberfläche dort, wo sie zählt: Network Access für jede REST-API, Webhooks, eine CLI und individuelle Skills, ohne zuerst Retrieval, Status und Connectors neu zu bauen. Es ist kostenlos zu starten, ohne Kreditkarte und ohne Verkaufsgespräch, und die Preisgestaltung erfolgt pro bearbeitetem Ticket, sodass du für erledigte Arbeit zahlst statt für verbrannte Token. Wenn du lieber einen Agenten auf deine Warteschlange ausrichten willst, als ein Quartal lang einen zu bauen, ist das der schnellste Weg, es an deinen eigenen Tickets zu sehen.
Häufig gestellte Fragen
Was ist eine Customer Support Agent API?
Sollte ich einen Support-Agenten auf einer Modell-API bauen oder kaufen?
Wie viel kostet eine Customer Support Agent API?
Was ist MCP und wie hängt es mit einer Support Agent API zusammen?
Kann ich einen KI-Agenten über eine API mit meinem bestehenden Helpdesk verbinden?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.