Was „programmierbar" eigentlich bedeuten sollte
Suchst du nach „programmierbare Kundensupport-KI", findest du zwei Lager, die aneinander vorbeireden. Das eine meint: „Es gibt eine API, also kann ich sie automatisieren." Das andere meint: „Ich schreibe den Agenten selbst." Beide sind zu eng gefasst.
Programmierbar bedeutet, auf eine Art, die für den Support wirklich zählt, dass du fünf Dinge formen kannst: wie sich die KI verhält, was sie weiß, was sie tun kann, was ihr erlaubt ist zu tun, und wie du sie erweiterst, wenn die Standardeinstellungen nicht mehr ausreichen. Ein Tool, das dir einen Webhook gibt, aber keine Kontrolle über Retrieval, ist nicht wirklich programmierbar – es ist nur an den Rändern scriptbar. Ein Tool, mit dem du den System-Prompt bearbeiten kannst, aber keine Aktion auf einem Ticket ausführen kannst, ist ein Chatbot mit Textfeld.
Diese Einordnung ist aus Kostengründen wichtig. Der Instinkt, besonders unter Entwicklern, ist, dass echte Kontrolle einen Aufbau vom Modell aufwärts erfordert. Dieser Instinkt macht aus einer Zwei-Wochen-Integration still und leise ein Neun-Monate-Plattformprojekt. Bevor du dich für einen Weg entscheidest, hilft es also, das gesamte Spektrum auf einen Blick zu sehen.
Das Programmierbarkeits-Spektrum
Hier ist die ehrliche Bandbreite, von der wenigsten bis zur meisten Kontrolle – und sie deckt sich fast perfekt damit, wie viel Wartungsaufwand du hast.
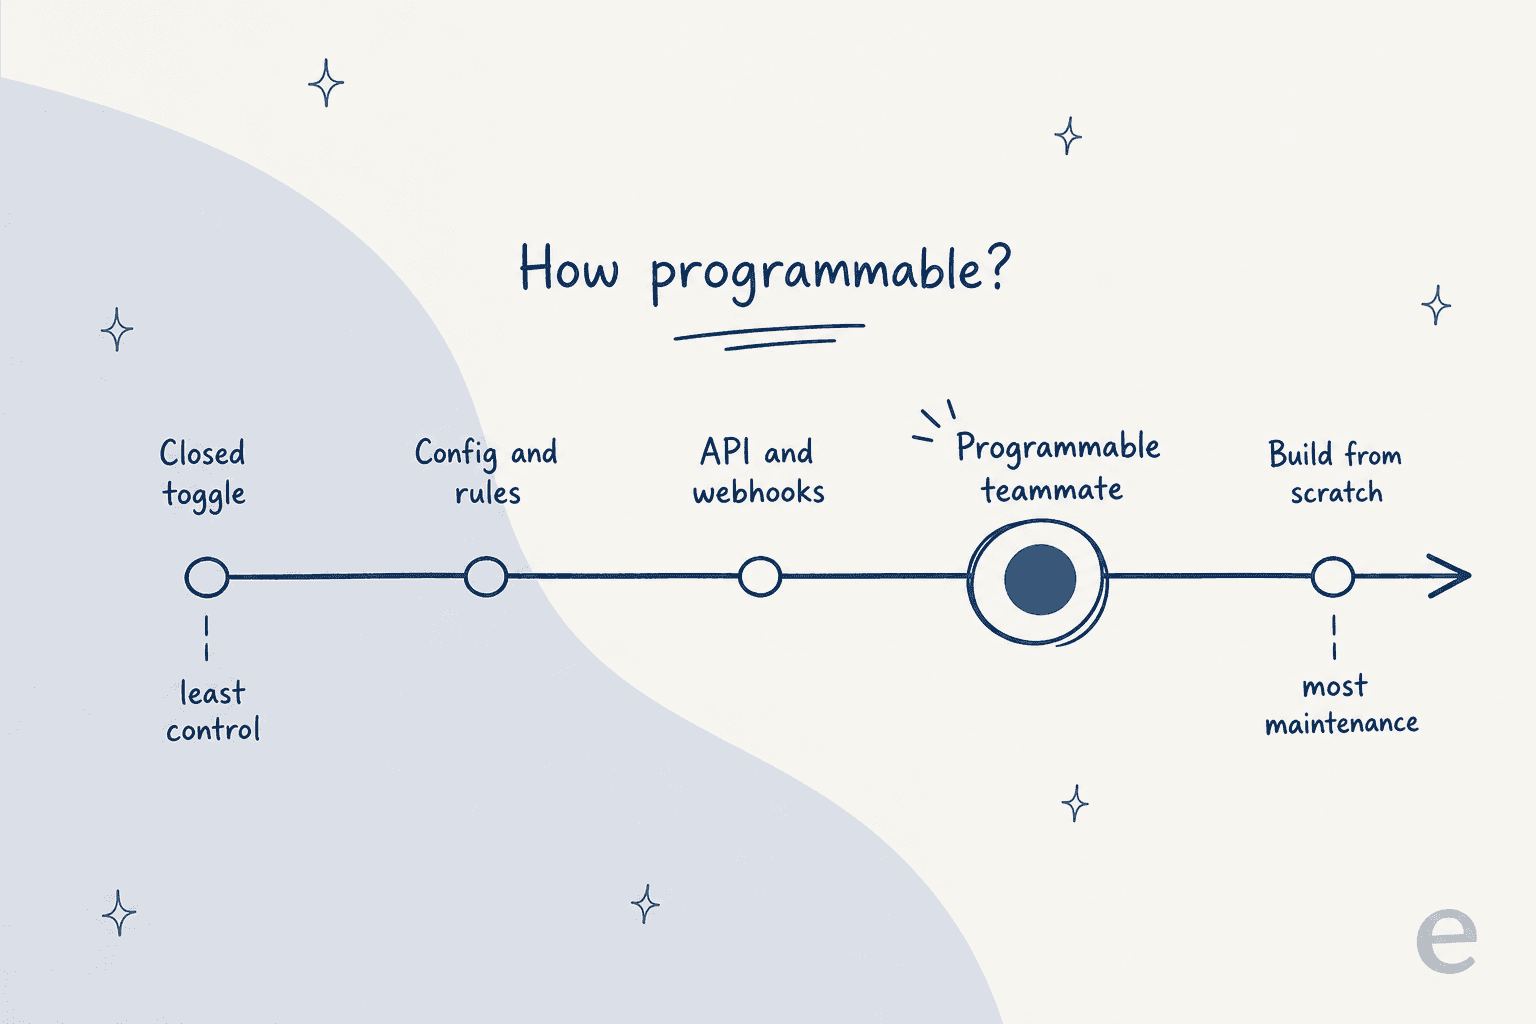
Von links nach rechts betrachtet:
- Geschlossener Schalter. Ein Anbieter-Bot, den du einschaltest. Du bearbeitest ein paar vorgefertigte Antworten, vielleicht eine Fallback-Nachricht. Null Engineering, null echte Kontrolle. Großartig, bis dein Prozess nicht in die Schablone passt.
- Konfiguration und Regeln. Ein No-Code-Builder: Intents, Entscheidungsbäume, regelbasiertes Routing. Mehr Kontrolle, aber immer noch innerhalb der Schienen des Anbieters. Du kommst nicht über das hinaus, was die Oberfläche zulässt.
- API und Webhooks. Der Helpdesk oder Bot stellt REST-Endpunkte und Event-Hooks bereit. Du kannst ihn aus deinem eigenen Code steuern, aber du verlegst die Leitungen selbst und lieferst weiterhin die Intelligenz.
- Programmierbares Teammitglied. Ein fertiger Agent, der Retrieval, Aktionen und Tests mitbringt und eine echte Entwickleroberfläche behält. Du konfigurierst das Verhalten und scriptest die Ränder; du baust die Engine nicht neu. Das ist nicht ohne Grund der hervorgehobene Punkt.
- Von Grund auf selbst bauen. Du baust den Agenten auf einer Foundation-Model-API zusammen. Maximale Kontrolle, maximaler Wartungsaufwand und eine Pro-Token-Rechnung für jede Nachricht.
Die meisten Inhalte zu diesem Thema tun so, als gäbe es nur die Wahl zwischen #1 und #5: einen dummen Bot kaufen oder einen intelligenten bauen. Das interessante Terrain – und dort, wo die meisten Support-Teams landen sollten – ist #4.
Die fünf Dinge, die dich eine programmierbare Support-KI kontrollieren lässt
Bevor wir die Wege vergleichen, lohnt es sich, konkret zu werden, was du eigentlich programmierst. Wenn ich sage, eine Support-KI ist „programmierbar", meine ich diese fünf Oberflächen, die sich entweder öffnen oder verschlossen bleiben.
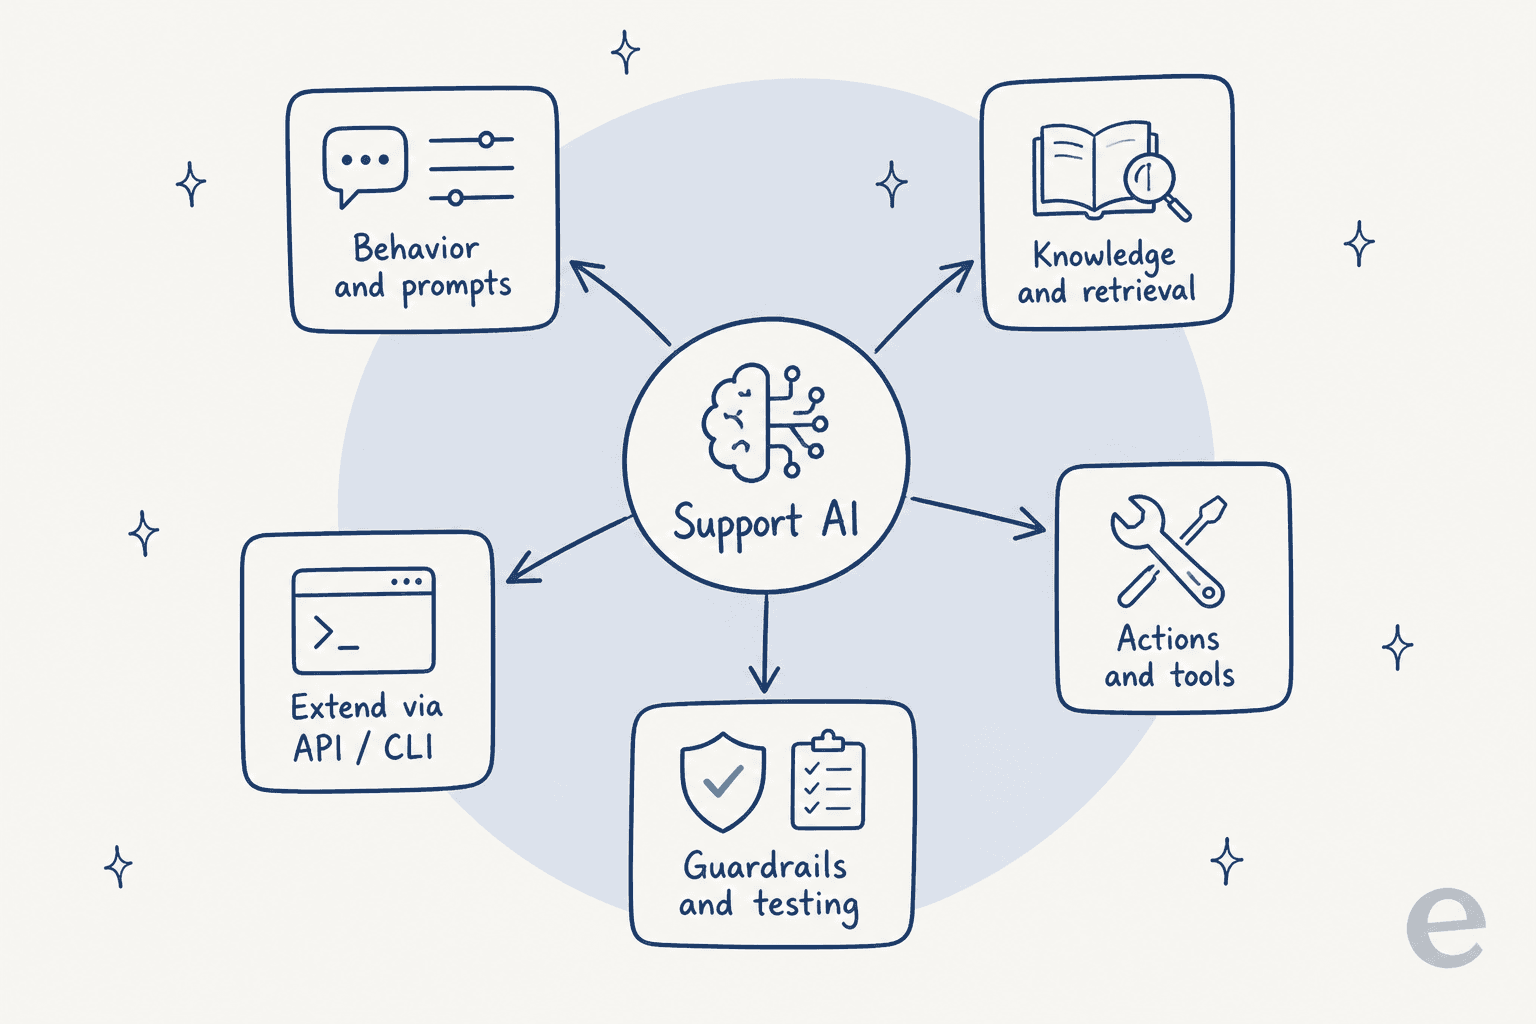
- Verhalten und Prompts. Ton, Persona, wann eskaliert wird, wann still geblieben wird. Grundvoraussetzung, aber viele geschlossene Bots geben dir immer noch nur ein Begrüßungsfeld.
- Wissen und Retrieval. Was die KI liest, bevor sie antwortet: dein Help Center, vergangene Tickets, interne Dokumentation. Die Qualität davon trennt eine nützliche Antwort von einer selbstsicheren falschen – und es ist die Oberfläche, die geschlossene Tools am stärksten verstecken.
- Aktionen und Tools. Ob die KI eine Bestellung nachschlagen, ein Ticket taggen, eine Rückerstattung ausstellen oder triagieren und weiterleiten kann – nicht nur darüber reden.
- Leitplanken und Tests. Was ihr erlaubt ist zu tun, und wie du beweist, dass sie sich richtig verhält, bevor sie einen Kunden erreicht. Fast immer das, was ein Eigenbau von Grund auf nicht mitbringt.
- Erweiterung über API und CLI. Das Fluchtventil für alles, was die Standardeinstellungen nicht abdecken: einen internen Dienst aufrufen, ein Skript ausführen, ein Tool einbinden, das niemand vorhergesehen hat.
Ein Tool, das alle fünf öffnet, ist wirklich programmierbar. Ein Tool, das eins oder zwei öffnet, vermarktet nur das Wort. Behalte diese Liste im Hinterkopf, während wir die beiden Wege durchgehen, über die sich Leute tatsächlich den Kopf zerbrechen: der Eigenbau von Grund auf und der Mittelweg.
Weg A: von Grund auf auf einer Modell-API aufbauen
Das ist der Weg, den sich die meisten Entwickler vorstellen, wenn sie „programmierbar" hören, und es ist der, der zu einem Projekt wird. Sowohl OpenAI als auch Anthropic verkaufen Modellinfrastruktur, keinen fertigen Support-Agenten – und darin sind sie exzellent. Sie decken nur einen viel kleineren Teil von „Kundensupport-KI" ab, als der Begriff vermuten lässt.
Du bekommst echte Bausteine: ein Modell, eine Möglichkeit, Tools zu definieren, eine Agent-Loop, ein paar gehostete Retrieval-Primitive. Was du nicht bekommst, ist der Support-Agent. OpenAIs eigene Dokumentation ist unverblümt bei dieser Aufteilung: Du besitzt „Deployment, Tool-Implementierungen, Zustandsspeicherung und Freigabeentscheidungen, während das SDK die Agent-Loop ausführt." Anthropics Claude Agent SDK hat dieselbe Form: Sessions, Hooks und Berechtigungen, aber die Loop läuft in deinem Prozess, und die Persistenz ist deine Integration.
So ist ein Schritt wie „Bestellung nachschlagen und Rückerstattung ausstellen" ein Tool-Aufruf, den das Modell erzeugt; der Code, der mit Shopify und deinem Abrechnungssystem spricht, ist vollständig deiner. Dasselbe gilt für jedes andere tragende Element: Retrieval, das mit deiner Live-Dokumentation synchron bleibt, Konversationsstatus, Ticket-Aktionen, Eskalation und das Test-Framework. Wenn du die Tool-für-Tool-Version davon willst, geht unser Vergleich AgentKit vs. Anthropic API in die Tiefe.
Das Kostenmodell ist die schärfste Überraschung. Du zahlst pro Token für jede Nachricht, egal ob das Ticket jemals gelöst wird – für den System-Prompt, die abgerufenen Textausschnitte, die Tool-Round-Trips, das Reasoning und jeden Retry.
| Model | Input (pro 1 Mio.) | Cached Input | Output (pro 1 Mio.) |
|---|---|---|---|
| OpenAI gpt-6-astra | $10.00 | $1.00 | $50.00 |
| OpenAI gpt-5.6-terra | $2.00 | $0.20 | $12.00 |
| Anthropic Claude Opus 5 | $5.00 | $0.50 | $25.00 |
| Anthropic Claude Sonnet 5 | $2.00 | $0.20 | $10.00 |
| Anthropic Claude Haiku 4.5 | $1.00 | $0.10 | $5.00 |
Prompt Caching mildert die Zahl für den Support deutlich ab, da du bei jeder Runde denselben Help-Center-Kontext erneut sendest – ein Cache-Treffer wird zu etwa 10 % des Standard-Input-Preises abgerechnet. Aber Caching verändert die Höhe der Rechnung, nicht die Abrechnungseinheit. Eine Konversation mit zehn Runden, die pro Runde ein Dutzend Textausschnitte abruft und zweimal wiederholt wird, wird komplett abgerechnet – auch wenn der Kunde unzufrieden geht.
Das ist kein Seitenhieb auf die Modellanbieter. Es ist der ehrliche Umfang: eine rohe Modell-API ist Infrastruktur, kein Mitarbeiter. Bau hier, wenn die Logik des Agenten dein Produkt ist.
Weg B: ein programmierbares Teammitglied, das die Engine mitbringt
Der Mittelweg ist der, der dem entspricht, was die meisten Leute wirklich wollen, wenn sie „programmierbare Kundensupport-KI" eingeben: ein Agent, der bereits weiß, wie man Support macht, den sie auf ihren Stack ausrichten, konfigurieren und scripten können, statt ihn zusammenzubauen. Hier setzt ein Tool wie eesel an, und es lohnt sich, präzise zu sein: Das ist eine andere Kategorie als eine rohe Modell-API, kein freundlicherer Wrapper darum.
Ein KI-Helpdesk-Teammitglied kommt mit der komplett vorgebauten Engine. Es trainiert auf deinen vergangenen Tickets und deinem Help Center, tritt der Warteschlange in dem Helpdesk bei, den du bereits betreibst, schlägt Bestellungen nach, taggt und triagiert und entwirft oder versendet Antworten. Retrieval, Konversationsstatus, Ticket-Aktionen und Eskalation sind bereits erledigt. Du konfigurierst Verhalten, statt Infrastruktur zu implementieren.
Der Teil, der für einen Entwickler zählt: „Fertig" bedeutet nicht „geschlossene Box." eesel behält eine echte programmierbare Oberfläche für die Ränder, die die Standardeinstellungen nicht abdecken.
- Network Access lässt den Agenten jede REST-API ansprechen, die du erlaubst – mit GET, POST, PATCH und DELETE sowie Auth-Headern pro Domain. Zugangsdaten leben als Header und werden dem Modell nie gezeigt.
- Webhooks geben jedem Tool eine eindeutige URL, die den Agenten mit welcher Payload auch immer aufweckt.
- Eine CLI und individuelle Skills lassen dich die Teile scripten, die du selbst besitzen willst, und ein einzelner Skill kann in einem Durchlauf mehrere Tools umfassen: den Helpdesk lesen, Shopify prüfen, in Slack posten.
Die Unterscheidung, an der ich festhalten würde: Du schreibst weiterhin Code, wo Code Mehrwert bringt, du baust nur nicht Retrieval, Zustand und Helpdesk-Connectoren von Grund auf neu, um dorthin zu kommen. Und weil es sich in den Helpdesk einklinkt, den du bereits betreibst, sind die Connectoren (1000+ davon) das Problem des Anbieters, nicht deins.
MCP erweitert die Mitte, still und leise
Es gibt einen zweiten Grund, warum der Mittelweg immer stärker wird: Helpdesks sind von „hier ist eine REST-API, bau selbst" dazu übergegangen, eigene Model-Context-Protocol-Server auszuliefern. MCP ist ein offener, von Anthropic eingeführter Standard, um einen Agenten über ein einziges Protokoll an externe Systeme anzubinden, statt für jedes Tool eine maßgeschneiderte Integration zu bauen.
Die Liste der Erstanbieter wächst schnell:
- Gorgias liefert einen kostenlosen MCP-Server unter
mcp.gorgias.com/mcp, jetzt in offener Beta. - Front dokumentiert einen Server unter
mcp.frontapp.com/mcpmit einem ungewöhnlich sauberen Berechtigungsmodell: OAuth 2.1 mit PKCE und Scopes pro Nutzer, sodass die Berechtigungen des Agenten genau denen des autorisierenden Teammitglieds entsprechen. - Atlassian betreibt einen offiziellen Remote-MCP-Server, der Jira, Confluence und Jira Service Management über OAuth verbindet.
Was MCP nicht tut, ist die KI von sich aus programmierbar zu machen. Der Server stellt Tools bereit; das Gehirn, die Retrieval-Qualität und die Leitplanken, die entscheiden, ob die Rückerstattung tatsächlich ausgestellt wird, musst du weiterhin selbst mitbringen oder kaufen. Es ist die Verbindungsschicht – und genau deshalb erleichtert es den Weg des „programmierbaren Teammitglieds", nicht den Weg „alles selbst bauen."
Die Falle: „programmierbar" mit „von mir gebaut" verwechseln
Hier würde ich dem Instinkt zu bauen widersprechen. Der Konsens von Entwicklern, die tatsächlich Support-Agenten ausgeliefert haben, ist bemerkenswert einheitlich, und er lautet nicht „niemals bauen." Er lautet: Der Modellaufruf ist der einfache Teil, und alles, was programmierbar klingt, versteckt einen Wartungsschwanz.
Fang mit der Tatsache an, dass ein Support-Agent handeln kann, nicht nur reden. In einem Ask-HN-Thread über die Vermeidung von Halluzinationen in Produktion drehte sich die schärfste Formulierung genau darum:
"The failure mode I keep seeing isn't hallucination per se... it's blurred responsibility between intent and execution. Once a model can both decide and act, you've already lost determinism."

Ein Agent, der den Kontostatus ändern kann, braucht eingeschränkte Aktionsräume und Allow-/Deny-Listen, nicht nur einen besseren Prompt. Und du kannst nicht wissen, ob deine Leitplanken halten, ohne Tests – was fast niemand richtig baut. Das ist das stärkste Argument für Simulation: echte vergangene Tickets wiederholen und die Antworten des Agenten gegen das bewerten, was dein Team tatsächlich verschickt hat, in einer Sandbox, bevor er eine echte Warteschlange berührt. Genau deshalb ist das einer der Kern-Skills von eesel, und es ist das, was ein Eigenbau von Grund auf fast immer auslässt.
Dann ist da noch Retrieval, das alle unterschätzen. Ein Microsoft-Ingenieur, der eine populäre Open-Source-RAG-Vorlage pflegt, hat den Reflex zerstreut:
"So few developers realize that you need more than just vector search for RAG, so I still spend many of my talks emphasizing the FULL retrieval stack for RAG."
Einmaliges Retrieval reicht nicht aus; am Ende brauchst du eine agentische Loop, die Ergebnisse bewertet und erneut abfragt. Das ist ein echtes System, kein Konfigurationsschalter. Und sobald es gebaut ist, taucht die eigentliche Zahl auf: die Wartung. Aus einem r/AI_Agents-Thread mit über 460 Kommentaren:
"The hardest part wasn't the LLM or voice quality - it was keeping the agent's knowledge current as policies changed and edge cases emerged."

Wir betreiben seit Jahren KI auf echten Support-Warteschlangen, und die Edge Cases sind der ganze Job: die Richtlinie, die letzte Woche geändert wurde, die Produktlinie, die gestern gestartet ist, der eine merkwürdige Rückerstattungsablauf, der jeden generischen Agenten kaputtmacht. Diese Arbeit taucht in keinem Quickstart auf, und sie hört nie auf.
Kontrolle vs. Wartung: die Achse, die es wirklich entscheidet
Zoom raus, und die Wege sortieren sich auf zwei Achsen: wie viel Kontrolle du bekommst und wie viel Wartung du leisten musst. Der Fehler ist die Annahme, dass beide zusammen wachsen – dass mehr Kontrolle immer mehr Instandhaltung kostet.
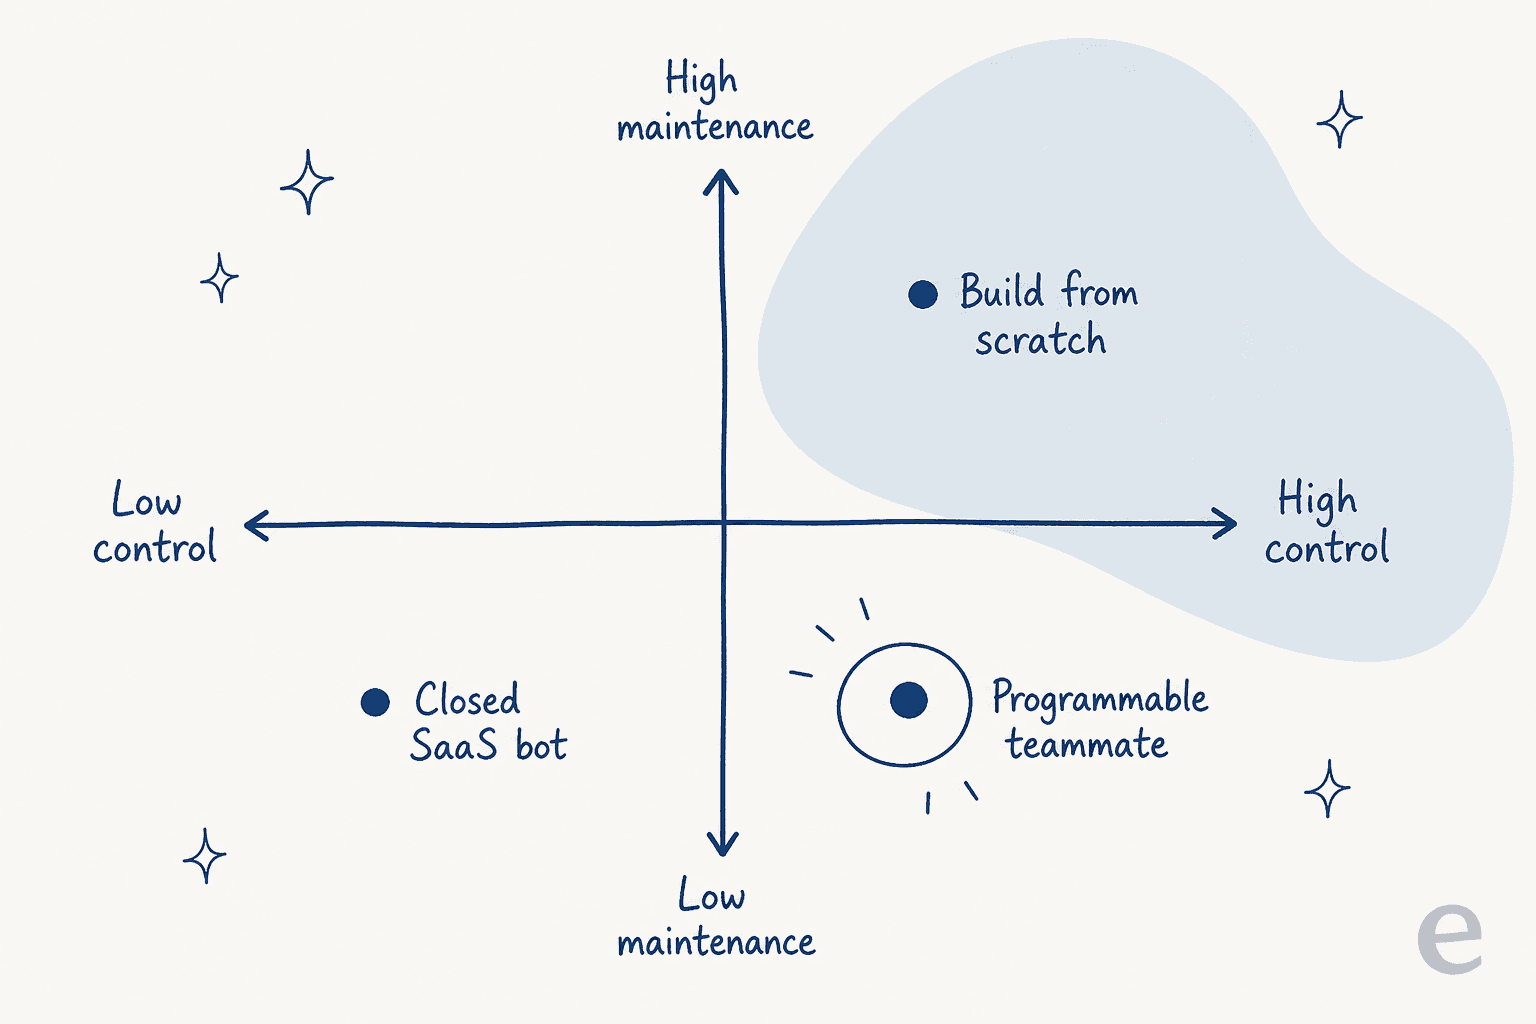
Ein geschlossener Bot bedeutet niedrige Kontrolle und niedrige Wartung. Eigenbau von Grund auf bedeutet hohe Kontrolle und hohe Wartung – die Diagonale, von der alle annehmen, sie sei die einzige Linie. Das gesamte Versprechen eines programmierbaren Teammitglieds ist die untere rechte Ecke: hohe Kontrolle ohne den hohen Wartungsaufwand, weil Engine, Connectoren und Tests die Instandhaltung von jemand anderem sind und du trotzdem eine API, eine CLI und Webhooks für die Ränder bekommst.
Bei den Kosten zeigt sich derselbe Bruch. Ein Eigenbau setzt dich auf einen Pro-Token-Zähler, der mit jedem Retry und jeder langen Konversation steigt, gelöst oder nicht, plus das Ingenieurgehalt dahinter. eesel dagegen ist nutzungsbasiert bei etwa 40 Cent pro bearbeitetem Ticket, abgerechnet pro Ticket statt pro Antwort, ohne Gebühr pro Sitzplatz, ohne Plattformgebühr und ohne Monatsminimum. Wie es ein Entwickler formulierte: Agenten, die „10 Minuten am Tag sparen, aber still und leise Stunden pro Woche an Wartung kosten", sind die Falle; der Eigenbau ist selten die günstige Option, als die er sich in einem Quickstart darstellt.
Welchen Weg solltest du also wählen?
Keiner der beiden Wege ist falsch; sie passen zu unterschiedlichen Teams. Hier die Kurzversion als Tabelle.
| Dimension | Eigenbau von Grund auf (Modell-API) | Programmierbares Teammitglied |
|---|---|---|
| Du baust die Engine | Ja, alles davon | Nein, du konfigurierst sie |
| Retrieval / Wissenssynchronisation | Musst du bauen und warten | Eingebaut, synchronisiert deine Doku |
| Helpdesk-Connectoren | Deine (pro Plattform) | Eingebaut (1000+) |
| Individueller Code | Vollständig, alles deins | Network Access, Webhooks, CLI, Skills |
| Test vor Go-live | Du baust das Test-Framework | Simulation mit vergangenen Tickets |
| Abrechnungseinheit | Pro Token, gelöst oder nicht | Pro bearbeitetem Ticket |
| Zeit bis zum ersten gelösten Ticket | Wochen bis Monate | Minuten bis Stunden |
Die schnelle Regel: Wenn die Logik des Agenten dein eigentliches Produkt ist und du Entwickler hast, die Retrieval, Leitplanken und Evals für immer betreuen, bau auf einer Modell-API. Wenn du gelöste Tickets und eine programmierbare Oberfläche für die Ränder willst, ist ein fertiges Teammitglied schneller, im zweiten Jahr günstiger und braucht deutlich weniger Betreuung. Wenn du das Feld noch sondierst, gehen unser Leitfaden zu den besten KI-Agenten und die Übersicht zu KI für Ticket-Triage Tool für Tool durch.
Probiere eesel aus
Wenn du bis hierher „einen programmierbaren Agenten bauen" gegen „einen kaufen" abgewogen hast: Die ehrliche Antwort für die meisten Support-Teams ist, dass der Eigenbau in einem Quickstart günstiger aussieht und im zweiten Jahr mehr kostet. eesel ist der Mittelweg richtig gemacht: ein KI-Support-Teammitglied, das sich in den Helpdesk einklinkt, den du bereits betreibst, auf deinen vergangenen Tickets und deiner Doku trainiert und – der Schritt, den ein Eigenbau von Grund auf fast immer auslässt – simuliert auf deiner echten Ticket-Historie, bevor es eine echte beantwortet.
Du behältst die programmierbare Oberfläche dort, wo es zählt – Network Access für jede REST-API, Webhooks, eine CLI und individuelle Skills –, ohne zuerst Retrieval, Zustand und Connectoren neu zu bauen. Es ist kostenlos zu starten, ohne Kreditkarte und ohne Verkaufsgespräch, und die Abrechnung erfolgt pro bearbeitetem Ticket, sodass du für erledigte Arbeit zahlst statt für verbrannte Token. Wenn du lieber einen programmierbaren Agenten auf deine Warteschlange ansetzt, statt ein Quartal lang einen zu bauen, ist das der schnellste Weg, ihn an deinen eigenen Tickets zu sehen.
Häufig gestellte Fragen
Was ist programmierbare Kundensupport-KI?
Muss ich meinen eigenen KI-Support-Agenten bauen, damit er programmierbar ist?
Was kostet programmierbare Kundensupport-KI?
Wie passt MCP in eine programmierbare Support-KI?
Kann ich einen programmierbaren Support-Agenten testen, bevor er live geht?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.