Was „KI-Helpdesk-API“ tatsächlich bedeutet
Suche nach „KI-Helpdesk-API“, und die Ergebnisse ziehen in zwei Richtungen, weil zwei unterschiedliche Menschen diesen Satz eintippen. Der eine will die KI einschalten, die sein Helpdesk bereits verkauft, und sie programmatisch steuern. Der andere will sein eigenes Modell mitbringen und es in die Daten und Aktionen des Helpdesks einbinden. Das sind nicht dieselben Projekte, und das Werkzeug, das eines löst, berührt das andere kaum.
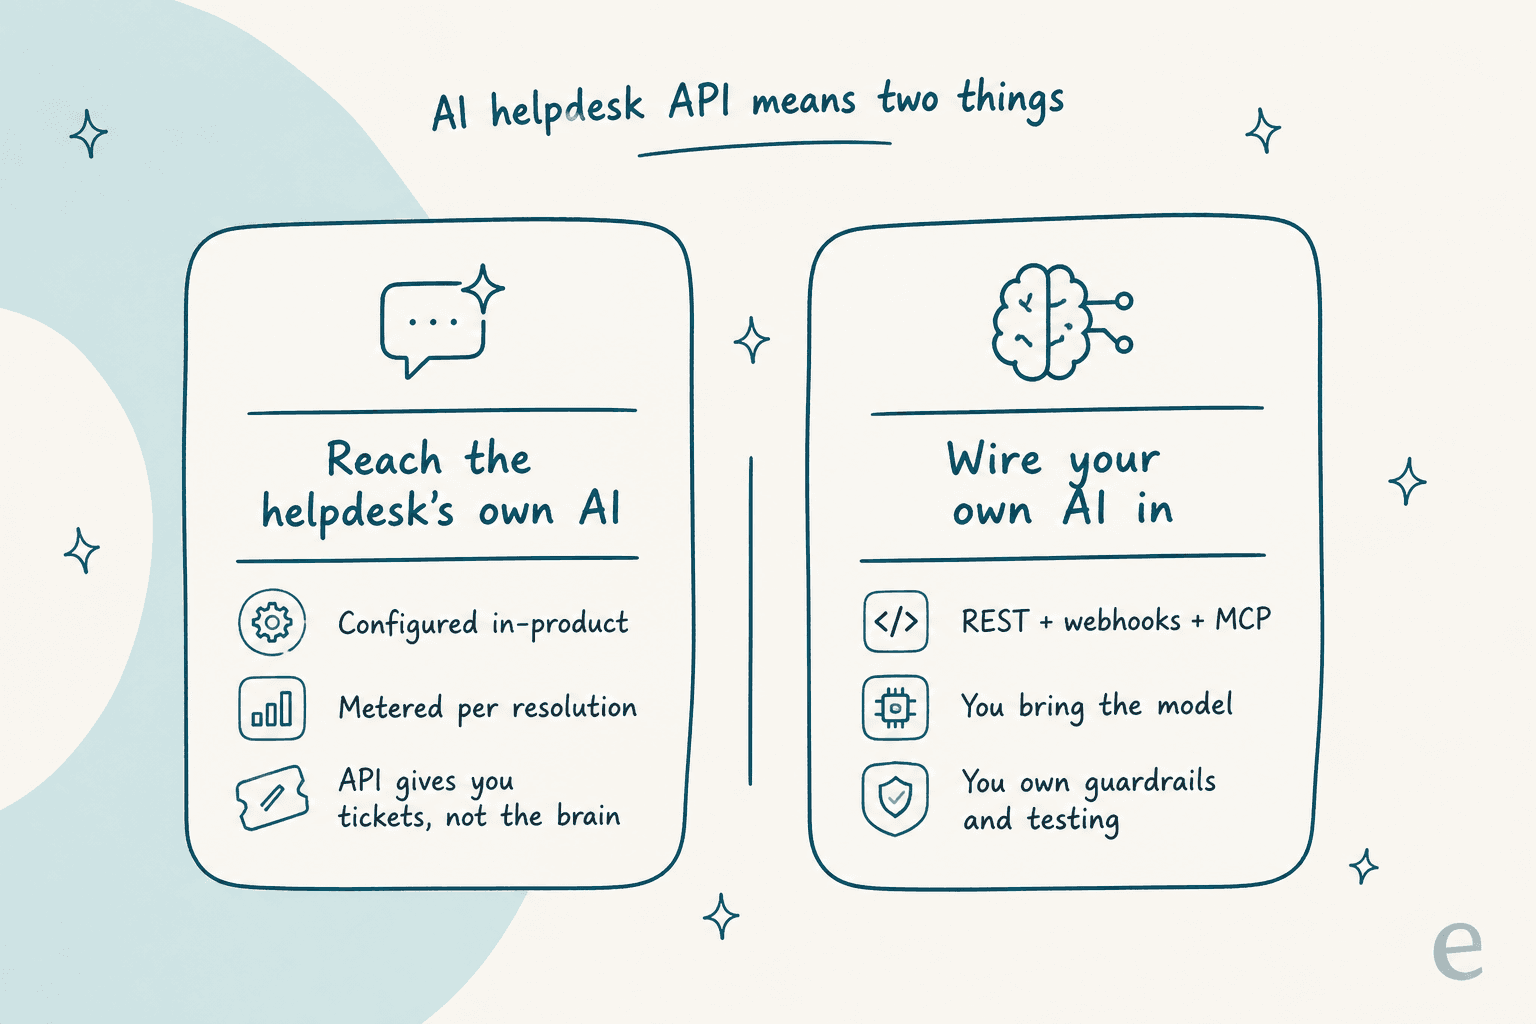
Bevor wir Anbieter für Anbieter durchgehen, halte diese Unterscheidung fest:
- Die eigene KI des Helpdesks erreichen. Schalte den KI-Agenten des Anbieters ein, füttere ihn mit deinem Help Center und lass ihn antworten. Die API dient hauptsächlich dazu, Tickets darum herum zu bewegen, nicht dazu, ihn umzuprogrammieren.
- Deine eigene KI einbinden. Nutze die REST-API, Webhooks und den MCP-Server, um Tickets zu lesen und Antworten mit einem Modell zu schreiben, das du kontrollierst.
Ich habe Support-Automatisierung auf beiden Seiten dieser Linie gebaut, und der Fehler, den ich am häufigsten sehe, ist ein Team, das die zweite Aufgabe wählt, obwohl es die erste wollte, oder das ein Team von Grund auf bezahlt, um nachzubauen, was der Anbieter bereits liefert. Gehen wir durch, was jeder Helpdesk tatsächlich bereitstellt, und dann die ehrlichen Kosten jedes Wegs.
Die Helpdesk-API-Oberfläche, Anbieter für Anbieter
Jeder ernstzunehmende Helpdesk gibt dir drei Dinge: eine REST-API zum Lesen und Schreiben von Tickets, Webhooks, um auf Ereignisse zu reagieren, und, im letzten Jahr, bei manchen einen eigenen MCP-Server, sodass sich ein Agent einmal statt über handverdrahtete Endpunkte verbinden kann. Darüber sitzt der eigene KI-Agent des Anbieters, der fast immer ein separates, separat bepreistes Feature ist.
Hier ist die Lage bei den Plattformen, auf denen die meisten Teams tatsächlich sind. Die Abrechnungsspalte bezieht sich auf die native KI, nicht auf die API selbst, die normalerweise in deinem Plan enthalten ist (vorbehaltlich Ratenlimits).
| Helpdesk | REST-API + Webhooks | Eigener MCP-Server | Abrechnungseinheit der nativen KI |
|---|---|---|---|
| Zendesk | Ja, ratenlimitiert je nach Plan | Ja (MCP-Client) | 1,50 bis 2,00 $ pro automatisierter Lösung |
| Freshdesk | Ja (API v2) | Noch nicht eigenständig | Freddy pro gelöster Sitzung; Copilot-Add-on pro Sitzplatz |
| Gorgias | Ja | Ja (mcp.gorgias.com) | Pro automatisierter Lösung (Überschreitung ~1,50 $) |
| Front | Ja | Ja (mcp.frontapp.com) | Copilot + Autopilot als kostenpflichtige Add-ons |
| HubSpot Service Hub | Ja | Über Konnektoren | Breeze-Credits; ~60 Lösungen/Monat, danach nutzungsbasiert |
| Salesforce Service Cloud | Ja | Über Agentforce / MCP | Agentforce ~2 $ pro Unterhaltung oder Credits |
| Jira Service Management | Ja | Ja (Rovo MCP) | Rovo / virtueller Agent, ab Premium gesperrt |
Zwei Muster fallen auf. Erstens: Die REST-plus-Webhooks-Basis ist universell und auf gute Weise langweilig: Willst du ein Ticket lesen, taggen oder eine Antwort von deinem eigenen Dienst aus posten, lässt dich jede dieser Plattformen das tun. Zweitens: die MCP-Spalte ist dort, wo sich im letzten Jahr am meisten bewegt hat, und das ungleichmäßig, manche Anbieter liefern einen sauberen eigenen Server, andere erwarten, dass du über einen Partner-Konnektor gehst.
Die native KI ist ein Feature, kein Endpunkt
Hier ist der Teil, der Leute stolpern lässt. Wenn Zendesk oder Freshdesk sagt, es habe „KI“, ist diese KI ein Produkt, das du in ihrem Admin-Bereich einschaltest, auf dein Wissen ansetzt und pro Lösung bezahlst. Sie ist wirklich nützlich. Du kannst sie nur nicht über die API umprogrammieren.
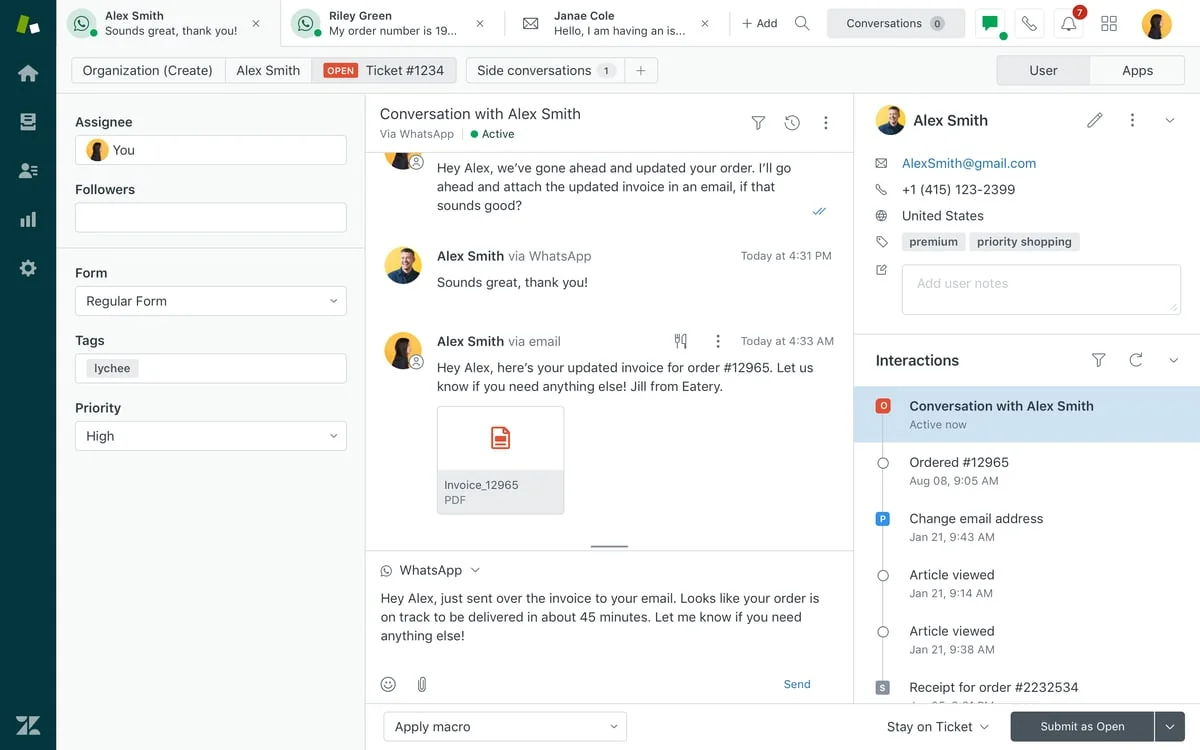
Nimm Zendesk. Seine KI-Agenten werden im Produkt konfiguriert, und Lösungen werden mit 1,50 $ auf einem Suite-Plan und 2,00 $ eigenständig abgerechnet. Die REST-API ist exzellent für Tickets, Nutzer, Trigger und Makros, und Zendesk hat sogar einen eigenen MCP-Client veröffentlicht, sodass ein Agent auf Live-Daten zugreifen kann. Aber die Denkleistung der Antwort-Engine gehört ihnen. Du stellst sie ein; du baust keine eigene Agenten-Schleife darum. Für das vollständige Bild führt unser Leitfaden zu Zendesk-KI-Agenten durch Einrichtung und Kosten.
Freshdesk ist gleich gestrickt. Freddy AI beantwortet Kunden und entwirft für Agenten, abgerechnet pro gelöster Sitzung mit Copilot als Add-on pro Sitzplatz, und die API v2 steuert Tickets und Kontakte. Das Composite unten ist ein Marketing-Foto, zeigt aber die echte Sache, die Freddy tut: eine Ticket-Zusammenfassung, eine Stimmungskarte und Bestellkontext, eingeblendet neben der Unterhaltung.
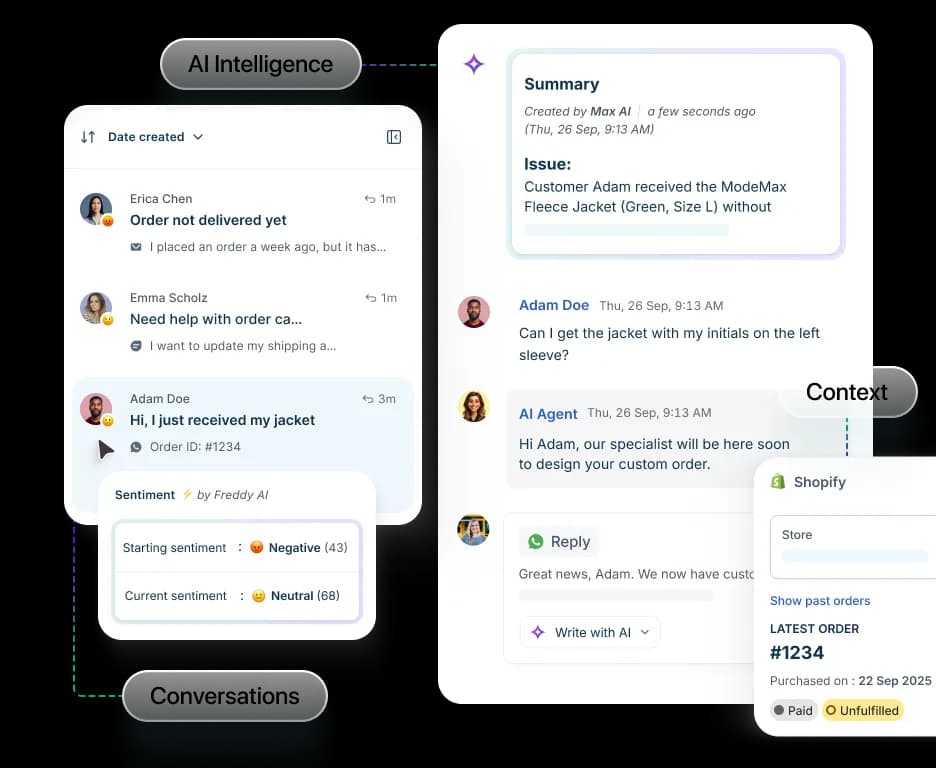
Wenn dein Ziel also war „meine Helpdesk-KI aus eigenem Code aufrufen und ändern, wie sie denkt“, lautet die ehrliche Antwort bei fast jedem Anbieter: dafür ist die API nicht da. Die API bewegt Tickets. Die KI ist ein Regler im Admin-Bereich. Brauchst du echte programmatische Kontrolle über den Agenten, bist du eigentlich in der zweiten Aufgabe, ein eigenes Modell einzubinden.
Deine eigene KI in den Helpdesk einbinden
Das ist der Bau, den sich die meisten Entwickler vorstellen, wenn sie „KI-Helpdesk-API“ suchen: den Helpdesk behalten, ein Modell mitbringen, beide verbinden. Das ist ein echter und vernünftiger Weg, und er teilt sich in eine klassische und eine neuere Version.
Die klassische Version ist REST plus Webhooks. Ein Ticket kommt herein, ein Webhook feuert an deinen Dienst, du rufst dein Modell auf, und du schreibst die Antwort über die REST-API zurück. Das funktioniert überall. Der Haken ist, dass du jeden unglamourösen Teil davon selbst besitzt: die Authentifizierung, das Polling, die Retries und die Ratenlimits. Diese Limits sind eine echte Obergrenze, keine Fußnote. Zendesk zum Beispiel begrenzt Anfragen pro Minute je nach Plan:
| Zendesk-Suite-Plan | API-Anfragen / Minute |
|---|---|
| Team | 200 |
| Growth | 400 |
| Professional | 400 |
| Enterprise | 700 |
| Enterprise Plus | 2.500 |
Jeder Anreicherungsaufruf, jedes Zurückschreiben und jedes Nachladen historischer Tickets zehrt vom selben Pro-Minute-Budget. Ein Bulk-Reprocessing-Job, der harmlos wirkte, wird es sprengen, und dann ist deine Integration das, was dich um 2 Uhr nachts weckt.
MCP verändert diesen Weg still und leise
Die neuere Version ist das Model Context Protocol, ein offener Standard, den Anthropic eingeführt hat, um einen Agenten über ein Protokoll statt über eine maßgeschneiderte Integration pro Tool mit einem System zu verbinden. Helpdesks haben begonnen, eigene MCP-Server auszuliefern, und Zendesks Beschreibung des alten Schmerzes ist bezeichnend: Echtzeitdaten mit KI zu verbinden erforderte früher „APIs, einen erfahrenen Entwickler (oder zwei) und lange Vorlaufzeiten“, während eine MCP-Integration „nur einmal eingerichtet werden muss“.
Die eigenen Server, die man kennen sollte:
- Gorgias liefert einen kostenlosen Server unter
mcp.gorgias.com/mcp, jetzt in offener Beta, der einen Workspace mit jedem MCP-kompatiblen Client verbindet. Für das breitere Bild siehe unsere Einschätzung zu KI-Agenten in Gorgias. - Front dokumentiert einen Server unter
mcp.frontapp.com/mcpmit einem ungewöhnlich sauberen Berechtigungsmodell: OAuth 2.1 mit PKCE, Tokens pro Nutzer undread-,write-,send-Scopes, sodass die Rechte des Agenten genau die des autorisierenden Teammitglieds sind. - Atlassian betreibt einen offiziellen Remote-MCP-Server, der Jira, Confluence und Jira Service Management über OAuth mit Agenten verbindet. Für ein ITSM-Team ist das der Hauptweg, um ein Service-Desk von einem Agenten steuern zu lassen.
Das verbessert die Kauf-versus-Bau-Rechnung wirklich: die Verkabelung, die du früher selbst schreiben musstest, pflegt jetzt der Anbieter. Was MCP nicht löst, ist die KI selbst. Der Server stellt Werkzeuge bereit; die Qualität der Suche, das Schlussfolgern und die Guardrails, die entscheiden, ob diese Rückerstattung wirklich ausgestellt wird, bringst du weiterhin selbst mit. Willst du die No-Code-Version, ein Modell mit einem Helpdesk zu verbinden, deckt unser Leitfaden zur Integration von ChatGPT mit Zendesk das ab.
Wo die KI im Stack tatsächlich lebt
Es hilft, sich die Schichten vorzustellen. Die Helpdesk-API und ihre Webhooks sind die Basis des Stacks: deine Daten und deine Aktionen. MCP ist die Verbindungsschicht darüber. Aber die beiden Schichten, die einen Agenten tatsächlich gut im Support machen, sind die, für die keine API sorgt.
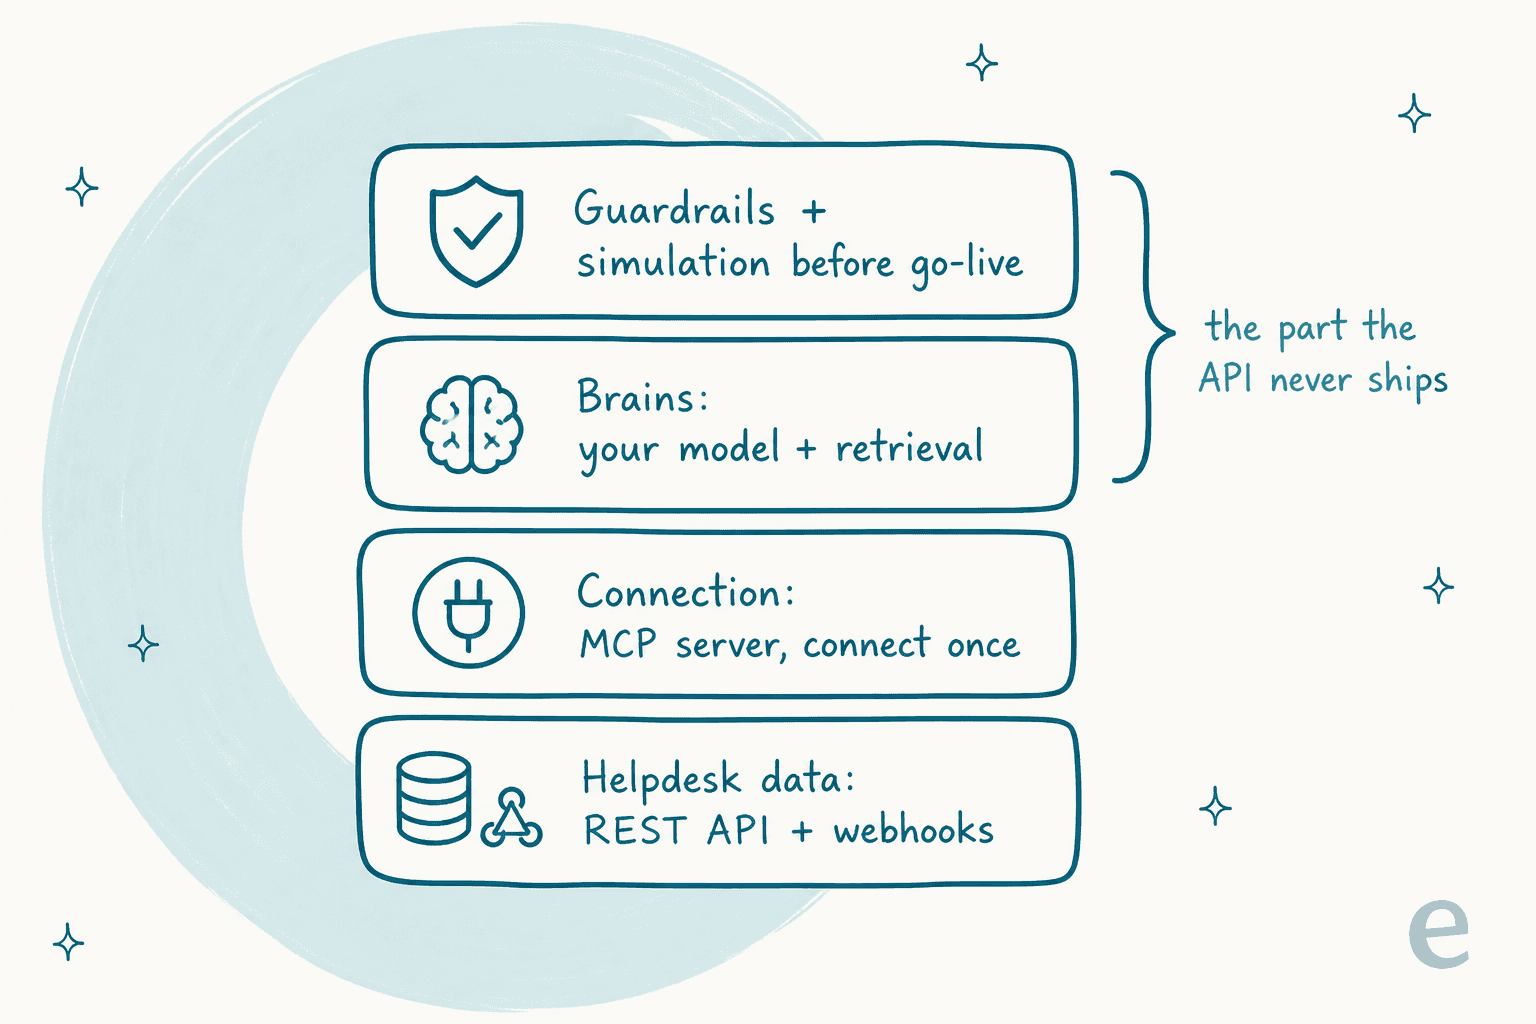
Gehst du diesen Weg mit einer rohen Modell-API darunter, ist das Kostenmodell pro Token, bei jeder Nachricht, egal ob das Ticket je gelöst wird. Grobe Preise der Anbieter selbst, pro Million Tokens auf der Standard-Stufe:
| Modell | Input | Gecachter Input / Treffer | Output |
|---|---|---|---|
| OpenAI gpt-5.6-terra | 2,00 $ | 0,20 $ | 12,00 $ |
| Anthropic Claude Sonnet 5 | 2,00 $ | 0,20 $ | 10,00 $ |
| Anthropic Claude Haiku 4.5 | 1,00 $ | 0,10 $ | 5,00 $ |
Prompt-Caching hilft im Support sehr, da du bei jeder Runde denselben Help-Center-Kontext erneut sendest, und ein Cache-Treffer liest zu etwa 10 % des Standard-Input-Preises. Aber Caching macht die Zahl weicher, es ändert nicht die Einheit. Eine zehnrundige Unterhaltung, die pro Runde ein Dutzend Chunks abruft und zweimal wiederholt, rechnet alles ab, selbst wenn der Kunde unzufrieden geht. Für den tieferen Primitiv-Vergleich geht unser AgentKit-vs-Anthropic-API-Vergleich Tool für Tool durch.
Die 90 %, die das Wort „API“ immer verbirgt
Hier würde ich jeden ausbremsen, bevor er sich auf den Bau festlegt. Der Konsens von Entwicklern, die tatsächlich Support-Agenten ausgeliefert haben, ist bemerkenswert einheitlich, und es ist nicht „nie bauen“. Es ist, dass der Modellaufruf und die API-Konnektoren die einfachen 10 % sind, und der Wartungsschwanz dort liegt, wo die echten Kosten leben.
Fang mit Retrieval an, das jeder unterschätzt. Der meistdiskutierte RAG-Thread auf Hacker News (551 Punkte) ist ein Post-Mortem über das Verarbeiten von Millionen Dokumenten, und ein Microsoft-Ingenieur, der eine populäre Open-Source-RAG-Vorlage pflegt, widersprach heftig dem Instinkt „füg einfach eine Vektordatenbank hinzu“:
„So wenige Entwickler merken, dass man für RAG mehr als nur Vektorsuche braucht, deshalb verbringe ich in vielen meiner Vorträge noch Zeit damit, den VOLLEN Retrieval-Stack für RAG zu betonen.“

Dieses Retrieval mit einem lebenden Help Center synchron zu halten, mit Chunking, Reranking und Zugriffskontrolle, ist ein echtes System, keine Konfigurations-Checkbox. Unser Erklärstück zu RAG vs. einem reinen LLM erklärt, warum.
Dann gibt es den Wartungsschwanz, die Zahl, die niemand vorhersieht. Der meistzitierte Realitätscheck, aus einem r/AI_Agents-Thread mit 460+ Kommentaren, benennt es direkt:
„Der schwerste Teil war nicht das LLM oder die Sprachqualität - es war, das Wissen des Agenten aktuell zu halten, während sich Richtlinien änderten und Randfälle auftauchten.“

Das passt zu dem, was ich beim Betreiben von KI auf echten Support-Warteschlangen beobachtet habe: die Randfälle sind der ganze Job. Die Richtlinie, die letzte Woche geändert wurde, die Produktlinie, die gestern startete, der eine seltsame Rückerstattungs-Flow, der jeden generischen Agenten bricht. Nichts davon taucht in einem Quickstart auf, und es hört nie auf. Und du kannst nicht einmal feststellen, ob deine Guardrails halten, ohne echte Tickets gegen sie abzuspielen, was der eine Schritt ist, den ein selbst gebauter Ansatz fast immer auslässt. Diese Lücke, Simulation vor dem Go-Live, ist genau das, was dir die API-Schicht nicht geben kann.
Die dritte Option: eine Schicht, die den ganzen Stack liefert
Es gibt einen Weg, der dem entspricht, was die meisten Leute, die „KI-Helpdesk-API“ eintippen, tatsächlich wollen: eine KI, die schon weiß, wie man Support macht, die sich in den Helpdesk einklinkt, den du betreibst, und live geht, statt ein Kit, das du selbst zusammenbaust. Hier setzt ein Werkzeug wie eesel an, und es lohnt sich, präzise zu sein, warum das eine andere Kategorie ist und nicht nur ein netterer Wrapper um die beiden obigen Wege.
Ein KI-Helpdesk-Agent kommt mit dem ganzen Stack vorgebaut. Er trainiert auf deinen vergangenen Tickets und deinem Help Center, tritt der Warteschlange innerhalb des Helpdesks bei, den du bereits betreibst, schaut Bestellungen nach, taggt und priorisiert und entwirft oder sendet Antworten. Das Retrieval, der Unterhaltungsstatus, die Ticket-Aktionen und die Eskalationslogik sind erledigt, sodass du Verhalten konfigurierst statt Infrastruktur zu implementieren. Und anders als die native KI, die in einen einzigen Helpdesk eingebacken ist, ist er portabel: eesel verbindet sich über 1000+ Integrationen, statt dich an die Antwort-Engine eines Anbieters zu binden.
Der Teil, der einem Entwickler wichtig ist: „fertig gebaut“ bedeutet nicht „geschlossene Box“. eesel behält eine echte programmierbare Oberfläche für die Ränder, die die Standardwerte nicht abdecken:
- Network Access lässt den Agenten jede REST-API aufrufen, die du erlaubst, mit GET, POST, PATCH und DELETE, und Auth-Headern pro Domain. Zugangsdaten werden als Header gespeichert und dem Modell nie gezeigt.
- Webhooks geben jedem Tool eine eigene URL, die den Agenten mit allem weckt, was es sendet.
- Eine CLI und eigene Skills lassen dich die Teile skripten, die du selbst besitzen willst, und ein einziger Skill kann mehrere Tools in einem Durchlauf umfassen: den Helpdesk lesen, Shopify prüfen, in Slack posten.
Die Unterscheidung, an der ich festhalten würde: eine rohe Modell-API ist Infrastruktur, die native Helpdesk-KI ist ein Feature, und eesel ist das Teammitglied, das dazwischen sitzt. Du schreibst weiterhin Code, wo Code Mehrwert bringt; du baust nur Retrieval, Zustand und Konnektoren nicht von Grund auf neu, um dorthin zu kommen.
Pro Lösung vs. pro Ticket: das Kostenmodell, das entscheidet
Zoom raus, und die Wege teilen sich sauber danach, wie du bezahlst. Dein eigenes Modell mitzubringen setzt dich auf einen Pro-Token-Zähler. Die native Helpdesk-KI setzt dich auf einen Pro-Lösung-Zähler, zusätzlich zu deinen Sitzplätzen. Eine fertige Schicht bepreist typischerweise pro bearbeitetem Ticket.
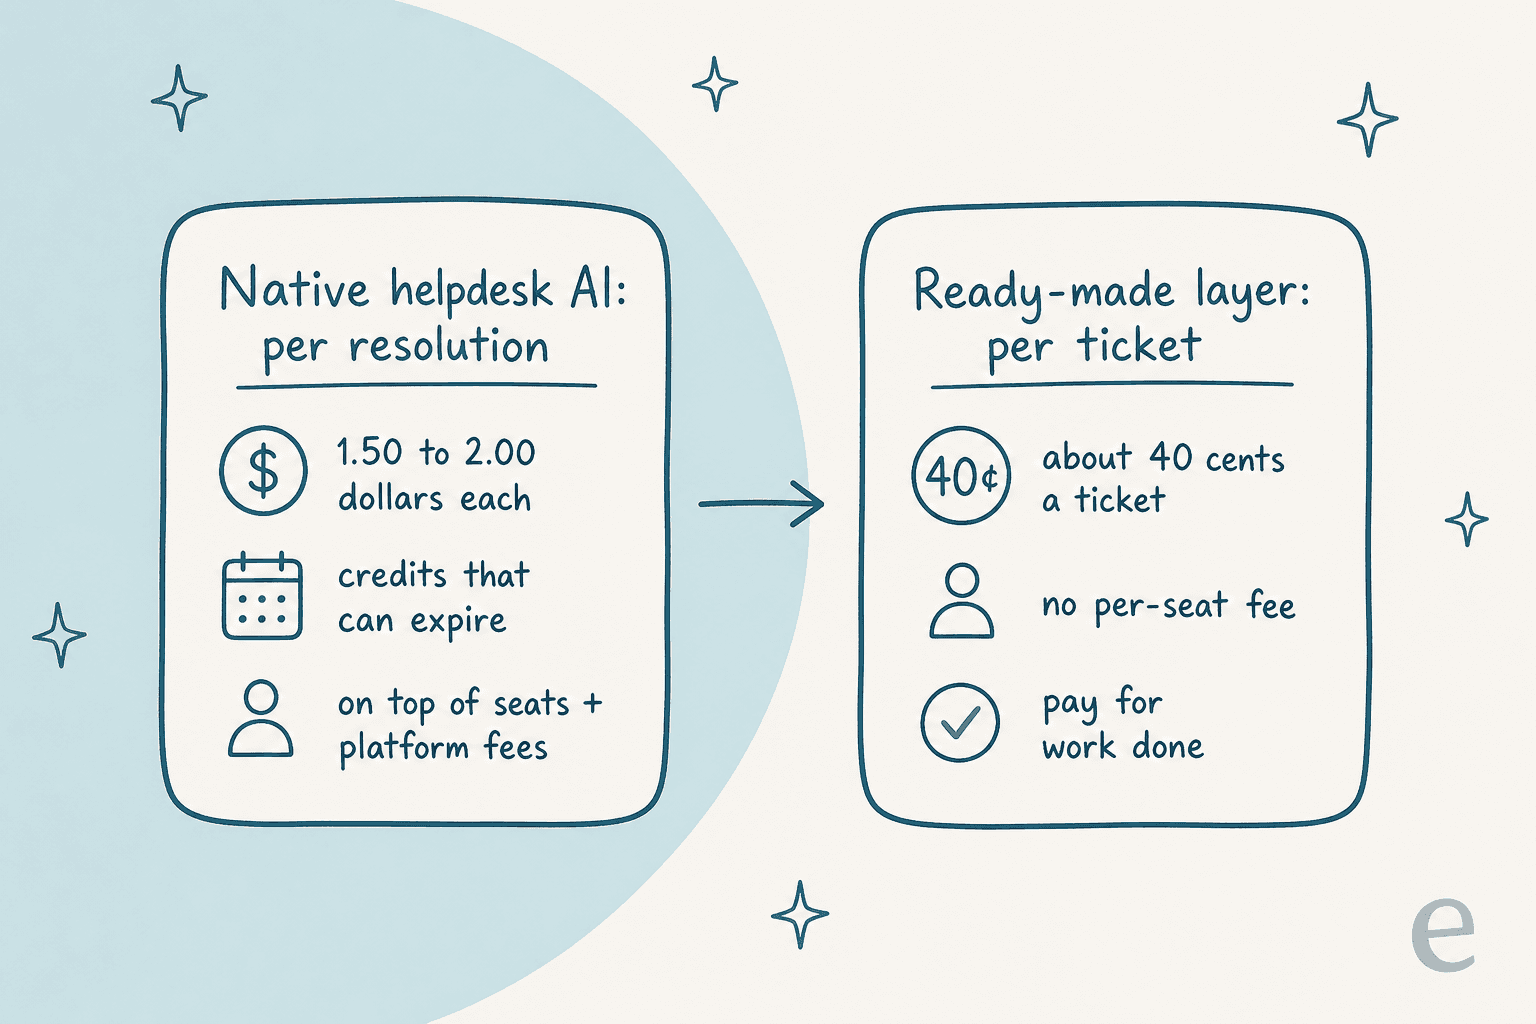
Der Unterschied ist nicht akademisch. Pro-Lösung-Preise klingen fair, bis du merkst, dass sie sich auf Pro-Sitzplatz-Kosten stapeln, und dass „Lösung“ oft vom Anbieter so definiert wird, dass sie mehr davon zählt, als du erwartet hättest. Pro-Token-Preise sind eine unbegrenzte, nutzungsförmige Rechnung, die du prognostizieren und deckeln musst. eesel dagegen ist nutzungsbasiert bei rund 40 Cent pro bearbeitetem Ticket, abgerechnet pro Ticket oder Helpdesk-Unterhaltung statt pro Antwort, ohne Gebühr pro Sitzplatz, ohne Plattformgebühr und ohne monatliches Minimum. Addiere das Ingenieursgehalt hinter einem selbst gebauten Agenten und die Wartungsstunden, die er jede Woche frisst, und der „günstigere“ DIY-Weg ist es oft nicht. Die Falle, wie es ein Entwickler formulierte, ist der Agent, der zehn Minuten am Tag spart, aber still und leise Stunden pro Woche kostet, um am Leben zu bleiben.
Welchen Weg solltest du also wählen?
Keiner davon ist falsch. Sie passen zu unterschiedlichen Situationen. Die Kurzversion: Willst du die KI deines Helpdesks erreichen, konfigurierst du eigentlich ein Feature, du rufst keine API auf. Willst du dein eigenes Modell einbinden, starte mit der REST-API und dem eigenen MCP-Server deines Anbieters und plane die 90 % ein, die die Konnektoren nicht abdecken. Willst du gelöste Tickets ohne einen Bau, nutze eine Schicht, die den ganzen Stack liefert.
Hier sind die Kompromisse als Tabelle:
| Dimension | Native Helpdesk-KI | Eigenes Modell einbinden | Fertige Schicht |
|---|---|---|---|
| Du baust den Agenten | Nein, es ist ein Feature | Ja, das Gehirn und die Guardrails | Nein, du konfigurierst ihn |
| Programmatische Kontrolle der KI | Begrenzt (Konfiguration im Produkt) | Voll | Network Access, CLI, Skills |
| Retrieval / Wissenssynchronisation | Vom Anbieter, eine Plattform | Deins | Eingebaut |
| Helpdesk-Konnektoren | Einer (dein Anbieter) | Von dir zu pflegen | Eingebaut (1000+) |
| Test vor Go-Live | Begrenzt | Du baust den Testrahmen | Simulation auf vergangenen Tickets |
| Abrechnungseinheit | Pro Lösung + Sitzplätze | Pro Token | Pro bearbeitetem Ticket |
| Zeit bis zum ersten gelösten Ticket | Tage | Wochen bis Monate | Minuten bis Stunden |
Kartierst du noch das breitere Feld, gehen unsere Übersichten der besten KI-Agenten und der besten KI für Ticket-Triage Tool für Tool durch, und unser Stück zur Customer-Support-Agent-API gräbt sich speziell in den Selbstbau-Weg ein.
Probier eesel aus
Bist du hier gelandet, weil du „meine Helpdesk-KI einschalten“ gegen „mein eigenes Modell einbinden“ abgewogen hast, und keins fühlte sich ganz richtig an, ist das die ehrliche Antwort: das eine ist ein gesperrtes Feature und das andere ein Vierteljahr Engineering. eesel ist der dritte Weg, richtig gemacht, ein KI-Support-Teammitglied, das sich in den Helpdesk einklinkt, den du bereits betreibst, auf deinen vergangenen Tickets und Docs trainiert und, der Schritt, den beide anderen Wege auslassen, auf deiner echten Ticket-Historie simuliert, bevor es ein Live-Ticket beantwortet.
Du behältst die programmierbare Oberfläche, wo es zählt, Network Access für jede REST-API, Webhooks, eine CLI und eigene Skills, ohne Retrieval, Zustand und Konnektoren zuerst neu zu bauen. Es ist kostenlos zum Start, ohne Kreditkarte und ohne Verkaufsgespräch, und die Bepreisung ist pro bearbeitetem Ticket, sodass du für geleistete Arbeit zahlst statt für verbrannte Tokens oder gezählte Lösungen. Willst du lieber einen Agenten auf deine Warteschlange ansetzen, als ein Vierteljahr einen zu bauen, ist das der schnellste Weg, ihn an deinen eigenen Tickets zu sehen.
Häufig gestellte Fragen
Was ist eine KI-Helpdesk-API?
Kann ich die eingebaute KI meines Helpdesks über dessen API aufrufen?
Was kostet eine KI-Helpdesk-API?
Was ist MCP und wie hängt es mit einer Helpdesk-API zusammen?
Kann ich einen KI-Agenten über eine API mit Zendesk oder Freshdesk verbinden?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.