Was Menschen wirklich wollen, wenn sie "KI-Agenten vom Terminal aus verwalten" sagen
Ich baue die Integrationen und APIs bei eesel, daher liegt dieser Suchbegriff nah an meinem Arbeitsalltag. Wenn jemand ihn eintippt, fragt er so gut wie nie nach einem Chat-Prompt in seiner Shell. Es ist ein Platform Engineer, ein Ops-Lead oder ein Founding Engineer, der bereits alles andere über die Kommandozeile betreibt und gerade einen KI-Support-Agenten in die Hand gedrückt bekommen hat, der komplett hinter einem Web-Dashboard lebt. Das fühlt sich falsch an, so wie sich ein Server falsch anfühlt, den man nur durch Klicken konfigurieren kann.
Der Instinkt ist richtig, und etliche Entwickler haben das schärfer formuliert, als ich es je könnte:
"Devs spent decades building CI/CD, monitoring, rollbacks, and circuit breakers because deploying software and hoping it works was never acceptable. Then they built AI agents and somehow went back to hoping."

Das ist der Juckreiz hinter der Suche. Alles andere im modernen Stack ist Code, den man versionieren, reviewen, deployen und zurückrollen kann. Dann taucht der KI-Agent als Einstellungsseite auf, auf der jemand im Browser Verhalten umschaltet, ohne Audit-Trail und ohne Möglichkeit, eine Änderung zu testen, bevor echte Kunden darauf treffen. Das Terminal steht hier stellvertretend für eine ganze Disziplin: Wenn es ein Produktionssystem ist, sollte es auch wie eines bedienbar sein.
Die eigentliche Frage ist also nicht "Gibt es eine CLI." Sie lautet: "Kann ich diesen Agenten so behandeln wie den Rest meiner Infrastruktur?" Das rahmt die ganze Sache neu, und das ist der Rahmen, den man sich für den Rest dieses Beitrags merken sollte.
Der Wandel: Ein Agent ist ein Dienst, den man betreibt, kein Bot, den man einrichtet
Die meisten Inhalte über KI-Support-Agenten hören beim Setup auf. Helpcenter verbinden, Tonfall wählen, einschalten. Aber das Setup ist Tag eins. Die Arbeit, die wirklich zählt, ist Tag zwei und jeder Tag danach: Die Konfiguration driftet, ein Wissensartikel veraltet, ein neues Produkt startet und der Agent beginnt, selbstbewusst falsche Antworten dazu zu geben. Einen Agenten zu verwalten ist eine Schleife, kein Launch.
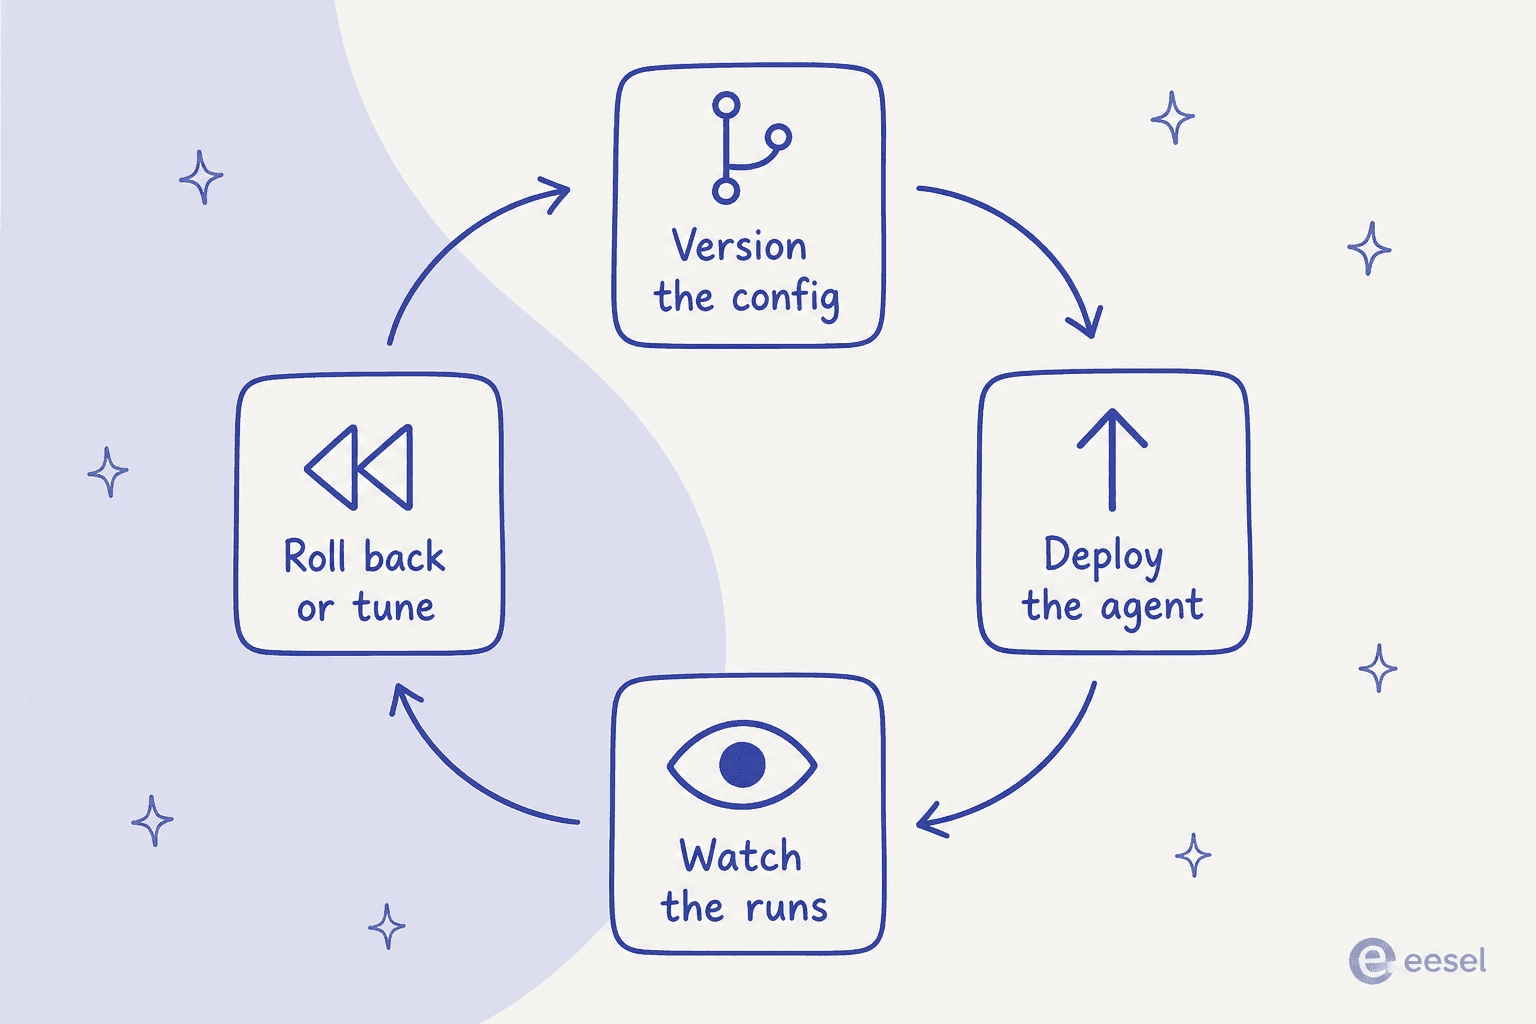
Genau dafür bietet "Ops-as-Code" ein Zuhause. Versioniere die Konfiguration, damit eine Änderung ein Diff ist, das jemand reviewen kann. Deploye über eine Pipeline, damit ein Rollout wiederholbar ist. Beobachte die Läufe, damit du weißt, was der Agent tatsächlich getan hat. Rolle zurück oder justiere nach, wenn etwas nicht stimmt. Nichts davon ist exotisch; so würde man jeden Dienst betreiben. Der einzige Grund, warum sich das bei einem KI-Agenten neu anfühlt, ist, dass so viele Tools zuerst als Dashboards gebaut wurden und nie eine programmierbare Oberfläche bekommen haben. Ein Team, das ein Agents-as-Code-Framework baut, hat das Ziel klar formuliert:
"Orloj treats agents the way infrastructure-as-code treats cloud resources. You write a manifest that declares an agent's model, tools, permissions, and execution limits."

Sobald man diesen Rahmen verinnerlicht hat, hört das Terminal auf, das Ziel zu sein, und wird zur Schnittstelle zum Ziel. Du willst, dass das Verhalten des Agenten etwas ist, das du diffen kannst, nicht etwas, an dessen letzte Änderung du dich am nächsten Dienstag erinnern musst.
Was du heute wirklich skripten kannst
Hier kommt der praktische Teil. Wenn dein Tool eine API oder eine CLI bereitstellt, funktioniert überraschend viel Agenten-Management bereits aus einer Shell heraus. Das universelle Muster, egal welcher Anbieter, ist dasselbe wie bei jedem anderen Dienst: Die Konfigurationsdatei ist die Quelle der Wahrheit, die API ist das Deploy-Ziel, und die Versionskontrolle ist das Audit-Log. In Rohform ist das einfach curl und jq, zum Beispiel um den letzten Tag an Läufen abzurufen und Eskalationen zu zählen:
curl -s https://api.yourtool.com/v1/agent/runs \
  -H "Authorization: Bearer $AGENT_TOKEN" \
  --data-urlencode "since=$(date -u -v-1d +%FT%TZ)" \
| jq '[.runs[] | select(.outcome == "escalated")] | length'
Manche Tools überspringen den rohen REST-Schritt und geben dir eine erstklassige CLI. eesel ist eines davon: Sein Kommandozeilen-Tool ist ein echtes npm-Binary (@eesel/cli), und die Doku sagt unverblümt, dass das Terminal die vorgesehene Schnittstelle ist, keine Nebentür: alles auf der Seite "kann vom Terminal aus erledigt werden." Eine typische Sitzung sieht so aus:
eesel login                 # browser once, or set EESEL_API_TOKEN for CI
eesel status                # what's connected, is knowledge current, plan
eesel activity              # every run, newest first (JSON by default)
eesel instructions          # read or edit the agent's standing rules
eesel approvals list        # actions held, waiting on a human
Jeder Befehl gibt JSON aus, Fehler kommen als eine strukturierte Zeile auf stderr zurück, und wenn du EESEL_API_TOKEN (plus EESEL_AGENT_ID) setzt, läuft das Ganze headless in CI, ganz ohne Browser-Login. Häng das Ganze an einen Cron-Job oder eine GitHub Action, und du hast planbares, überprüfbares, versioniertes Agenten-Management, ganz ohne Dashboard.
Der Haken ist die Größe dieses "wenn". Viele Support-KIs kommen ohne API, die diesen Namen verdient, also setzt der Anbieter die Obergrenze dessen, was du skripten kannst. Das ist die wichtigste Sache, die du vor dem Kauf prüfen solltest: Ein Tool ohne programmierbare Oberfläche kann niemals vom Terminal aus verwaltet werden, egal wie sehr du es dir wünschst. Es lohnt sich, das Spektrum der Steuerbarkeit durchzugehen, bevor du dich festlegst.
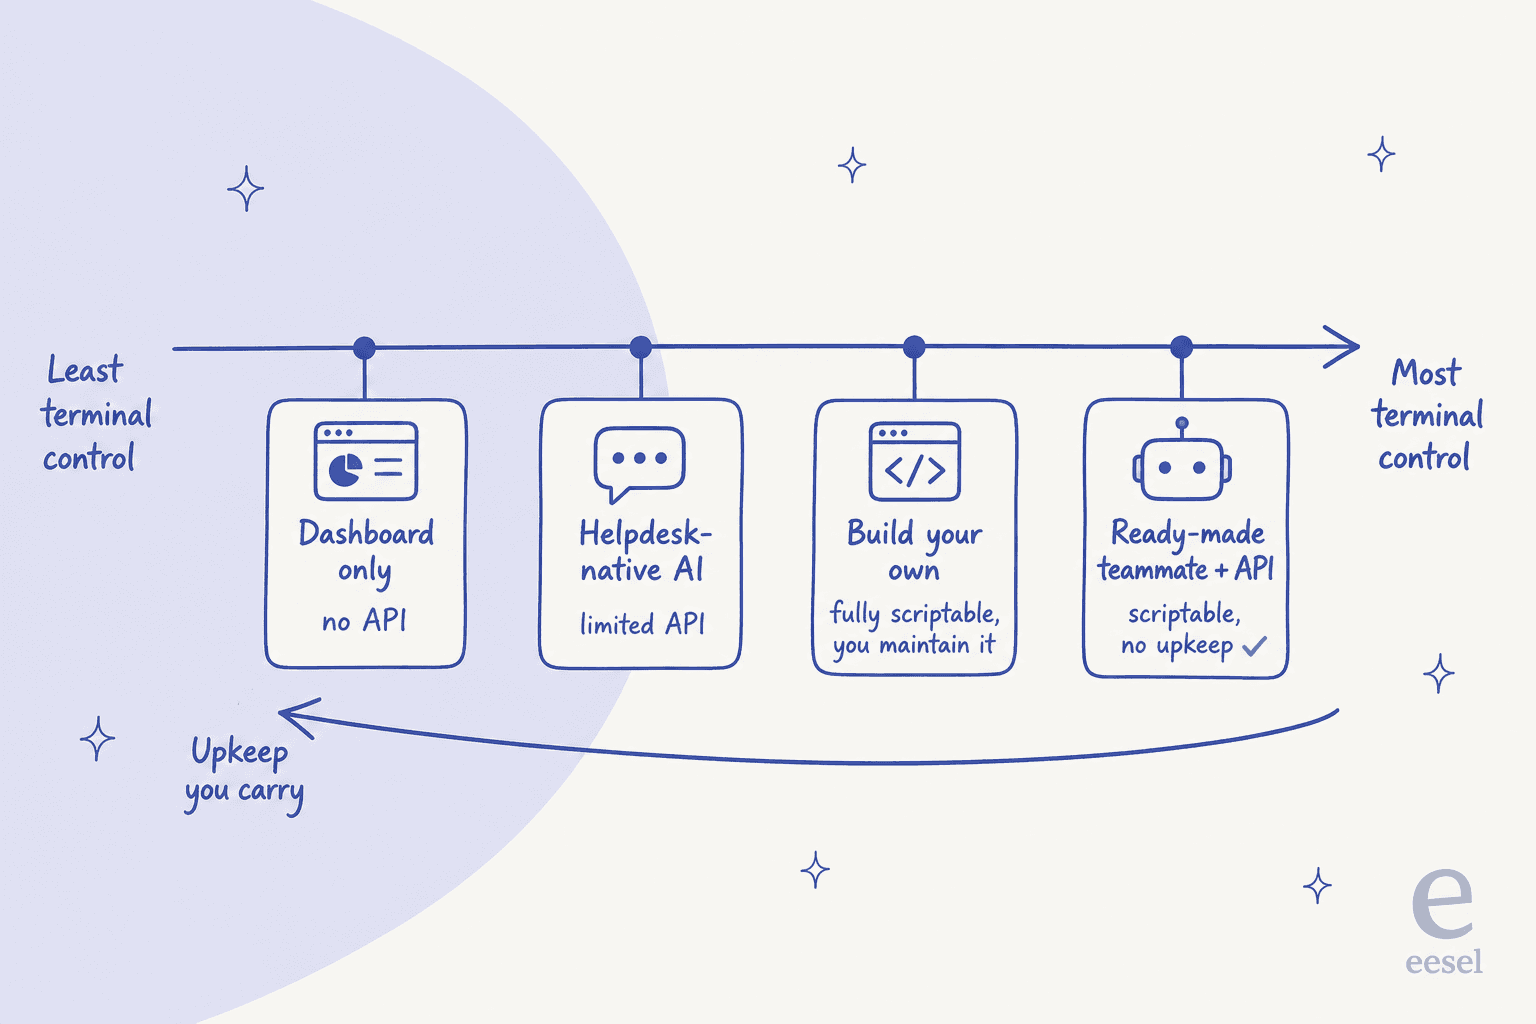
Es gibt einen echten Trade-off entlang dieser Linie. Einen eigenen Agenten auf einer Modell-API zu bauen, gibt dir volle Kontrolle und vollen Wartungsaufwand: Du besitzt das Retrieval, die Guardrails, das Eval-Framework und jeden 2-Uhr-morgens-Alarm, wenn eine Prompt-Regression ausgeliefert wird. Ein fertiger Agent mit einer richtigen API gibt dir das meiste an Skriptfähigkeit ohne den Wartungsschwanz. Welches Ende du willst, hängt davon ab, ob die Verwaltung des Agenten dein Job ist oder eine Steuer auf deinen eigentlichen Job. (Wenn du die Build-Seite abwägst, gehen wir in unseren Deep Dives zu Customer-Support-Agent-API und AI-Helpdesk-API genauer darauf ein.)
Die Hälfte, die dir das Terminal nicht abnimmt: sehen, was der Agent getan hat
Hier ist die Falle. Das Deployen von der Kommandozeile aus ist die einfache Hälfte, und sie wiegt dich in der Annahme, du hättest alles unter Kontrolle. Dein Skript läuft, die API gibt 200 zurück, dein Terminal druckt exit 0, und du machst weiter. Aber ein sauberer Exit-Code sagt dir, dass die Änderung ausgeliefert wurde. Er sagt dir nichts darüber, ob der Agent das Richtige tut.
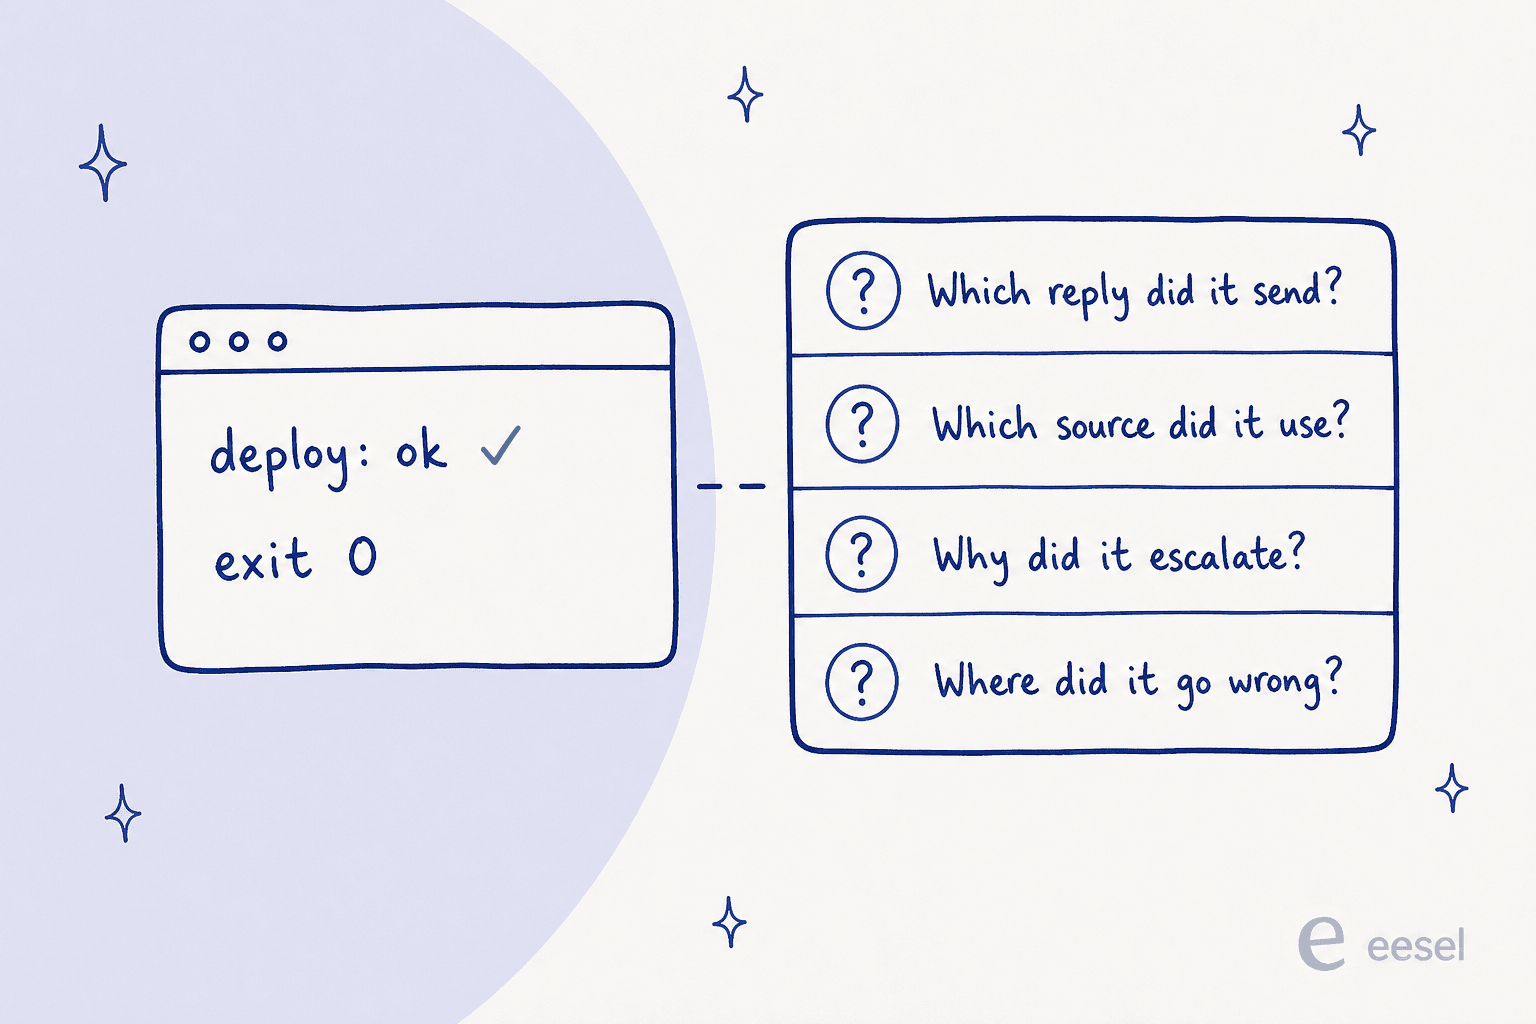
Hier bricht ein Großteil der DIY-Agenten-Projekte still in sich zusammen. Du kannst das Deploy an einem Nachmittag automatisieren; du kannst dir aber nicht wegautomatisieren, wissen zu müssen, welche Antwort an welchen Kunden ging, auf welche Wissensquelle sich der Agent gestützt hat und warum er entschieden hat, ein Ticket zu eskalieren und ein anderes zu beantworten. Der Erfahrungsbericht eines Entwicklers über sechs Monate Produktionsausfälle hat das Fehlermuster auf den Punkt gebracht:
"Agent works in testing. Works in the demo. Ships to production. Two weeks later - same input, different output. No error. No log that helps. Just a wrong answer delivered confidently."
Das ist Beobachtbarkeit, und sie ist der teure Teil beim Bauen und der leichte Teil beim Überspringen. Deshalb hat sich die Stimmung in den Entwickler-Foren still von "welches Modell" zu "kann ich sehen, was er getan hat" verschoben:
"honestly I'm starting to think observability is becoming more important than the model itself"
Die Lektion, die wir immer wieder neu lernen: Ein Terminal ist nur so nützlich wie die Lauf-Historie hinter dem Tool, das es steuert. Wenn der Agent deployen, aber dir seine Arbeit nicht zeigen kann, hast du den Teil automatisiert, der nie das Problem war. Wenn du ein Tool bewertest, prüfe die Lese-Seite genauso hart wie die Schreib-Seite. Kannst du das vollständige Transkript eines Laufs abrufen? Kannst du Konfidenz und Quellen hinter einer Antwort sehen? Kannst du benachrichtigt werden, wenn etwas driftet? Ein Dashboard, das das wunderschön zeigt, aber nichts davon einem Skript zugänglich macht, ist für deine Automatisierung immer noch eine Blackbox.
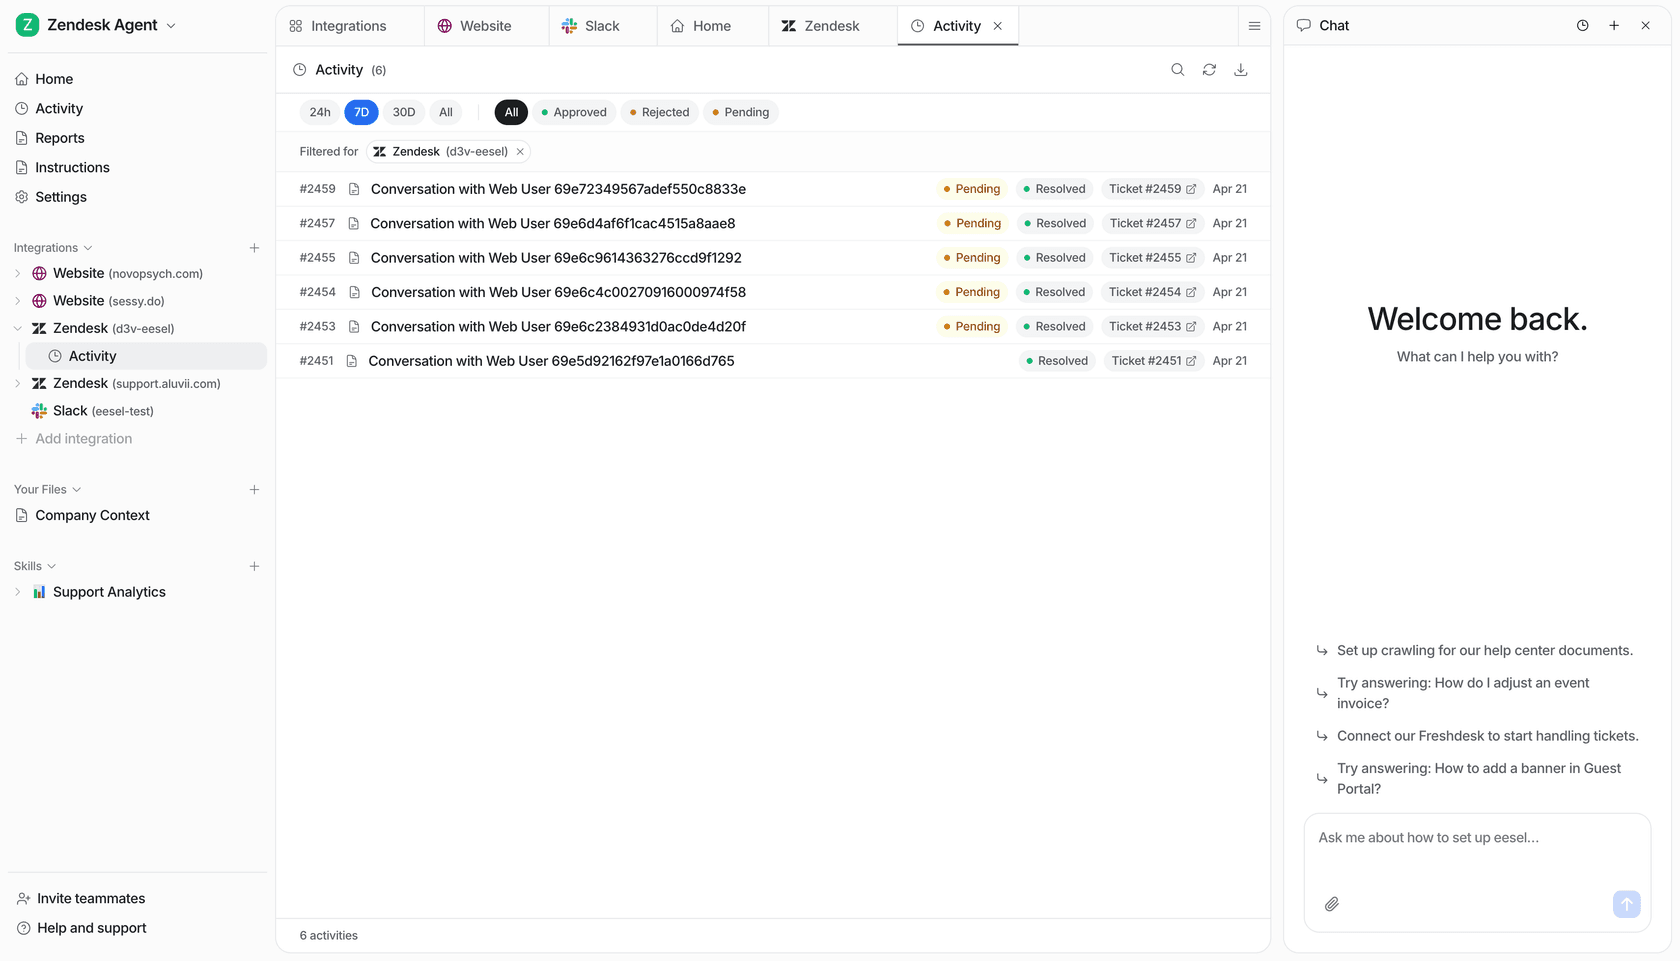
Das ist der Teil, auf den ich bei uns am stolzesten bin: eesel activity listet jeden Lauf neueste zuerst auf und lässt dich einen davon in voller Detailtiefe lesen, und weil es dasselbe JSON ist, das das Dashboard zeigt, ist eine Antwort nie etwas, das einfach irgendwo passiert ist, wo du es nicht sehen kannst. Kombiniere das mit eesel approvals, und ein Mensch kann eine wartende Aktion halten, genehmigen oder ablehnen, ohne je die Shell zu verlassen.
Vor dem Deploy testen: die Staging-Umgebung für Agenten
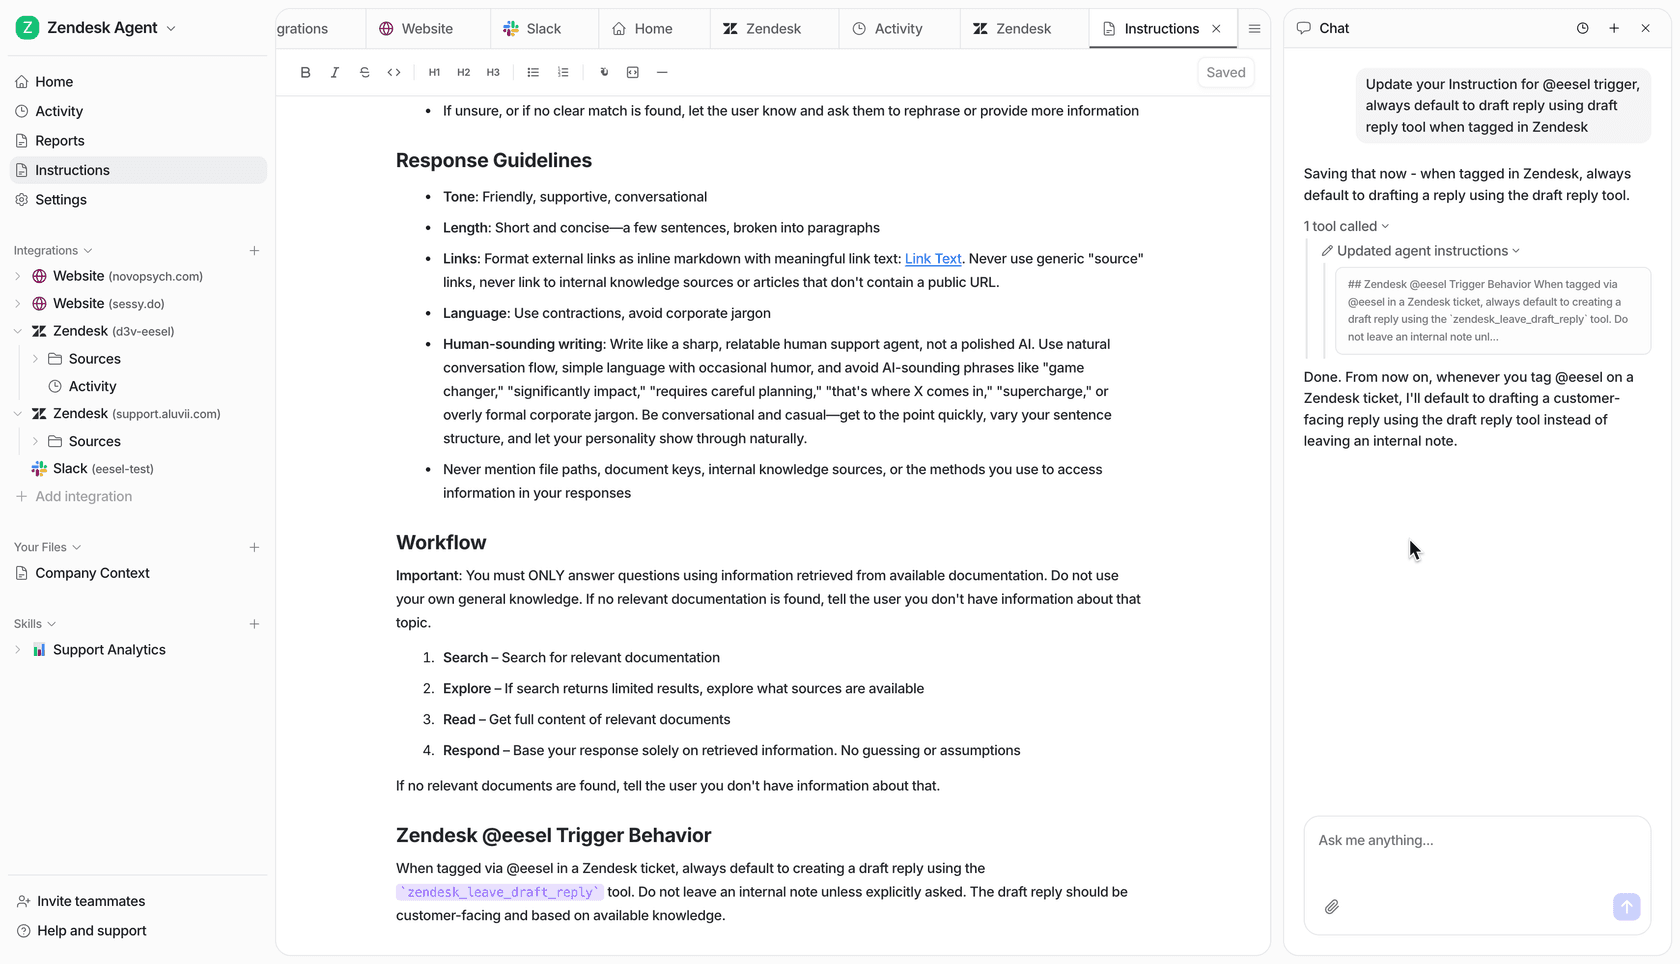
Wenn du eine Gewohnheit aus dem Betrieb von Diensten nimmst und auf Agenten anwendest, dann diese: Liefere nie eine Konfigurationsänderung direkt an Kunden aus. In normaler Software hast du eine Staging-Umgebung. Bei einem KI-Agenten besteht das Äquivalent darin, deine eigenen vergangenen Tickets gegen die neue Konfiguration erneut abzuspielen und zu prüfen, was passiert wäre, bevor auch nur ein einziger echter Kunde es sieht. Ein Entwickler, der diesen Zyklus durchlaufen hat, beschrieb die Lösung als Snapshot-Testing:
"What finally fixed the cycle for me was treating agent behavior like snapshot tests. Record the trajectory when it's working, save it as baseline, diff after every change. If the tool path shifted or output drifted - block the deploy before it hits prod."
Der Grund, warum das wichtig ist, ist nicht theoretisch. Bei τ-bench, dem Tool-Agenten-Benchmark von Sierras Forschungsteam, erzielte der beste Agent unter 50 % bei realistischen Support-Aufgaben, und ein GPT-4o-Agent, der seinen pass^1-Score erreichte, fiel bei pass^8 auf rund 25 % – ein ~60%iger Zuverlässigkeits-Einbruch allein durch achtmaliges erneutes Ausführen derselben Aufgabe. Die Schlagzeilen-Genauigkeit ist nicht die erschreckende Zahl. Die Lauf-zu-Lauf-Inkonsistenz ist es, und der einzige Weg, sie zu erwischen, bevor es deine Kunden tun, ist, die neue Konfiguration zuerst gegen die Realität laufen zu lassen.
Wir haben dasselbe auf die harte Tour über mehr als drei Jahre gelernt, in denen wir KI auf lebenden Support-Warteschlangen eingesetzt haben. Wir haben zugesehen, wie ein selbstbewusst klingender Bot still falsche Antworten austeilte, weshalb jetzt jeder Rollout zuerst gegen historische Tickets simuliert wird. Diese Simulation ist deine Regressions-Suite. Auf Befehlsebene macht ein --dry-run-Flag die kleine Version derselben Idee: Es druckt den genauen Aufruf, den ein Schreibvorgang machen würde, ohne ihn abzusenden, damit du siehst, was eine Änderung tut, bevor sie es tut.
Das ist auch die ehrliche Grenze des Skriptens. Du kannst den Replay automatisieren. Du kannst das Deploy vom Ergebnis abhängig machen. Was du nicht skripten kannst, ist die Ermessensentscheidung, ob ein 4-Punkte-Rückgang in einer Ticket-Kategorie für den 10-Punkte-Gewinn anderswo akzeptabel ist. Das Terminal macht den Test billig und wiederholbar; ein Mensch liest trotzdem das Ergebnis. Wie ich es intern schon gehört habe: Du kannst das Ticket skripten, aber nicht die Antwort.
Was der Betrieb kostet, und wo sich die Rechnung versteckt
Der Betrieb eines Agenten hat einen Zähler, und dieser Zähler ist der Punkt, an dem "vom Terminal aus verwalten" still zu einer Budgetfrage wird. Die Einheit ist wichtiger als die Zahl, weil die Einheiten nicht dieselben sind. Manche Tools rechnen pro Lösung ab, manche pro Konversation, manche pro API-Token, und ein Skript, das täglich Tausende von API-Aufrufen abfeuert, um Läufe abzufragen, kann eine überraschende Rechnung verursachen, wenn du pro Aufruf bezahlst.
Die ehrliche Version einer Kostentabelle für einen Support-Agenten sieht so aus:
| Ansatz | Was du skriptest | Wer es wartet | Grobes Kostenmodell |
|---|---|---|---|
| Nur-Dashboard-Tool | Nichts, keine API | Anbieter | Pro Lösung oder pro Sitz |
| Helpdesk-native KI | Begrenzte Konfiguration über die Helpdesk-API | Anbieter | Pro Lösung (oft 1,50 bis 2,00 $) |
| Eigenbau auf einer Modell-API | Alles | Du | Pro Token, bei jeder Nachricht und jedem Retry |
| Fertiger Agent mit CLI (eesel) | Konfiguration, Läufe, Aktionen | Anbieter | 0,40 $ pro bearbeitetem Ticket |
Die beiden Enden sind die interessanten. Eigenbau gibt dir eine Pro-Token-Rechnung, die unabhängig davon berechnet wird, ob das Ticket gelöst wird, plus die Gehaltskosten der Person, die Retrieval und Guardrails wartet. Ein Pro-Ticket-Modell wie das von eesel ist flat pro bearbeiteter Konversation, egal wie viele Nachrichten es braucht, ohne Pro-Sitz- oder Plattformgebühr, was die Ausgaben vorhersehbar genug macht, um sie tatsächlich in ein Skript und ein Budget zu packen. Bei 1.000 Tickets im Monat sind das etwa 400 $, und du zahlst nur für die Tickets, die du an den Agenten routest, nicht für die, die deine Menschen weiterhin bearbeiten.
Probiere eesel für einen Support-Agenten, den du wirklich bedienen kannst
Wenn der ganze Grund, warum du danach gesucht hast, der ist, dass du einen Support-Agenten wie einen Dienst betreiben willst, statt ein Dashboard zu babysitten, dann ist das die Lücke, für die eesel gebaut wurde. Es ist ein KI-Teammitglied, das deinem bestehenden Helpdesk beitritt (Zendesk, Freshdesk, Front, Gorgias, Help Scout und anderen), auf deinen vergangenen Tickets und Docs trainiert und dir eine echte programmierbare Oberfläche gibt: eine CLI, einen MCP-Server pro Workspace, Webhooks und ausgehenden Network Access, damit der Agent deine eigenen Systeme aufrufen kann.
Du kannst es installieren und komplett aus einer Shell heraus steuern:
npx @eesel/cli init chat-bubble --site https://your-site.com
eesel chat "what's our refund policy?"   # test an answer before go-live
eesel activity                            # watch what it actually did
Die zwei Gewohnheiten aus diesem Beitrag, die am wichtigsten sind, sind eingebaut: Du simulierst gegen deine historischen Tickets vor dem Go-Live, und du rollst schrittweise aus, wobei jede Antwort ein Entwurf bleibt, bis sie sich das Recht verdient hat, selbstständig zu senden. Und weil es 0,40 $ pro Ticket ohne Pro-Sitz-Gebühr kostet, kannst du mit ein paar Ticket-Typen anfangen und von einem Skript aus skalieren statt von einem Verkaufsgespräch.
Du kannst kostenlos starten, ganz ohne Kreditkarte, ihn in wenigen Minuten in deinen Helpdesk einbinden und sehen, wie er mit deinen echten Tickets umgeht, bevor du dich auf irgendetwas festlegst. Das ist der Punkt: ein Agent, den du testen, beobachten und bedienen kannst, nicht einer, dem du blind vertrauen musst.
Häufig gestellte Fragen
Kann man KI-Agenten wirklich vom Terminal aus verwalten?
Was bedeutet 'Ops-as-Code' für einen KI-Support-Agenten?
Wie deploye ich Änderungen an einem KI-Agenten von der Kommandozeile aus?
Wie viel kostet der Betrieb eines KI-Support-Agenten?
Was passiert, wenn ein KI-Agent in der Produktion eine falsche Antwort gibt?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.