

O Tencent Hunyuan Hy4 (a "Hy4 preview") é um modelo grande de pesos abertos feito para realizar trabalho, não para bater papo. É um modelo Mixture-of-Experts de 770B parâmetros com 49B ativos por token, contexto de 1M de tokens e licença Apache 2.0, lançado em 28 de agosto de 2026 para programação, produtividade de escritório, desenvolvimento de jogos e pesquisa científica.
Nos números: o teste cego da própria Tencent o coloca um fio à frente do Kimi K3 e do GLM-5.3, mas nos benchmarks públicos ele alterna vitórias com esses dois e geralmente fica atrás do Claude Opus 5 e do GPT-5.6. A leitura honesta é "mais ou menos no nível dos outros modelos de ponta chineses", com duas vantagens reais: é o mais barato entre os modelos abertos de ponta, a US$ 0,834 de entrada / US$ 2,501 de saída por milhão de tokens, e os pesos são genuinamente abertos.
O problema que domina toda discussão: ele é grande demais para rodar localmente. Só os pesos precisam de cerca de 924 GB mesmo quantizados, então é um modelo de data center ou de API, não de notebook. E como é um modelo bruto, a maioria das equipes vai conhecer o Hy4 pela API ou por um produto construído sobre ele, não baixando-o. Se o que você realmente quer é uma IA que faça um trabalho específico do início ao fim, uma colega pronta para trabalhar como a eesel se encaixa melhor do que qualquer modelo base, o Hy4 incluído.
O que o Tencent Hy4 realmente é
A Tencent lançou e abriu o código do Hy4 preview em 28 de agosto de 2026, chamando-o de um modelo "built for real-world productivity tasks, delivering outstanding performance across coding, office work, and scientific research." É o modelo mais novo da equipe Hunyuan da Tencent, depois da linha Hy3, e chegou com pesos abertos desde o primeiro dia.
O enquadramento importa. Ele não é vendido como um assistente simpático para competir com um chatbot de IA geral. A Tencent o co-projetou com os próprios produtos CodeBuddy e WorkBuddy e o treinou com dados de trabalho de engenheiros de software, desenvolvedores de jogos, analistas financeiros e especialistas em segurança. As capacidades principais são coisas como depuração de longo prazo, transformar contexto bagunçado de vários arquivos em documentos e planilhas, gerar um protótipo de jogo jogável a partir de um único prompt e raciocinar sobre problemas de pesquisa em dinâmica molecular ou matemática pura.
Estas são as especificações que importam, segundo o model card no Hugging Face:
| Propriedade | Valor |
|---|---|
| Arquitetura | Mixture-of-Experts (MoE) |
| Parâmetros totais | 770B |
| Parâmetros ativos por token | 49B |
| Camadas | 78 (1 densa + 77 MoE) |
| Especialistas roteados / compartilhados | 256 roteados + 1 compartilhado, top-8 ativados |
| Tamanho do contexto | 1M de tokens |
| Atenção | Gated DeepSeek Sparse Attention (Gated DSA) |
| Licença | Apache 2.0 |
| Variantes | BF16 instruct + build FP8 oficial |
Um bom sinal de honestidade: a Tencent rotula isto como "preview" e lista abertamente seus defeitos. O model card admite que o Hy4 gasta mais tempo do que o necessário raciocinando em tarefas complexas e tem "a tendency to over-verify its own work." Essa abordagem de lançar cedo e iterar é a mesma que deixou o Hy3 muito mais forte entre a preview e a versão final.
Como funciona o design Mixture-of-Experts
Os dois números em que todos se fixam, 770B e 49B, descrevem o truque central de um modelo Mixture-of-Experts, e vale entendê-lo porque explica tanto por que o Hy4 é rápido quanto por que é um pesadelo para rodar.
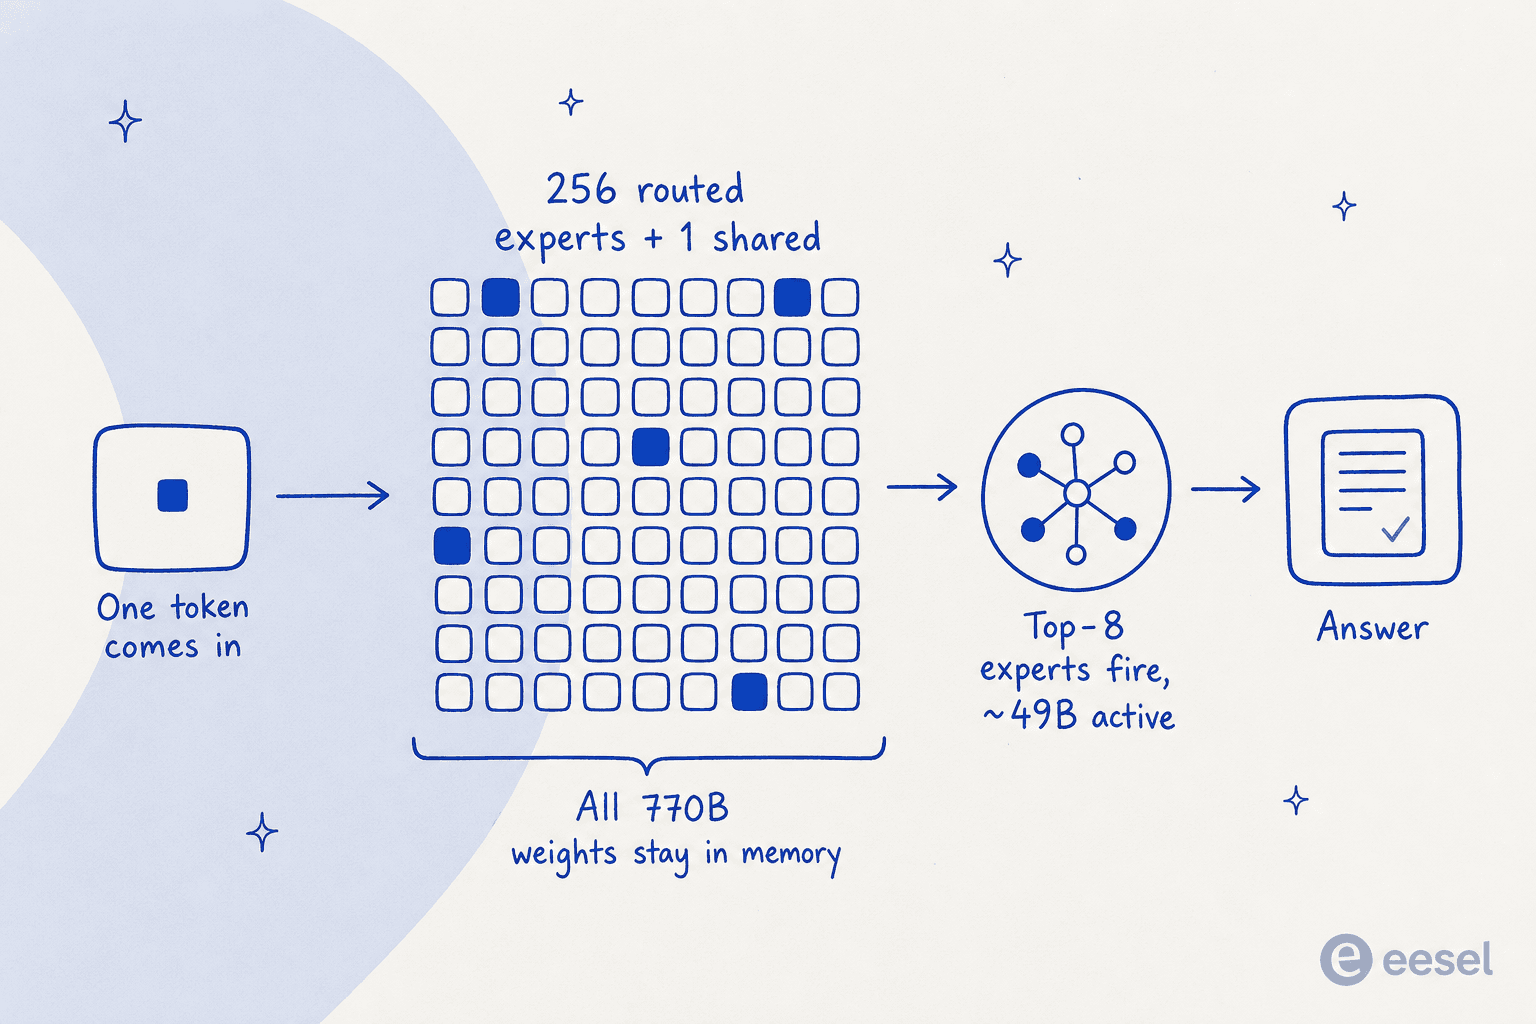
A base tem 78 camadas. A primeira é uma camada densa padrão; as outras 77 contêm cada uma 256 especialistas roteados mais 1 especialista compartilhado. Quando um token chega, um roteador escolhe os 8 especialistas mais relevantes para ele, e só esses (mais o compartilhado) realmente calculam. Assim, mesmo com 770B de parâmetros, cerca de 49B disparam por token. Isso mantém o throughput de inferência viável: você não paga o custo de computação de um modelo denso de 770B a cada token.
Por baixo do capô, a Tencent se apoiou em ideias do DeepSeek e do GLM: a atenção usa Gated Sparse Attention com um cache de índice reutilizável, e há uma camada nativa de previsão de múltiplos tokens acoplada para decodificação especulativa, que acelera a geração em lotes pequenos. O importante é guardar o problema da próxima seção: MoE economiza computação, não memória. Todos os 770B pesos ainda precisam estar na memória da GPU ao mesmo tempo.
Os benchmarks, lidos com honestidade
O material de lançamento da Tencent afirma "supera o GLM-5.3 e o Kimi K3", e é tecnicamente verdade, mas muito mais frágil do que parece. A afirmação vem de uma avaliação cega interna: 163 especialistas da casa avaliaram saídas de modelos em 203 tarefas de engenharia, dando a cada uma uma nota de até 4,00.
| Modelo | Média da avaliação cega (/4,00) | Resultado par a par do Hy4 |
|---|---|---|
| Hy4 preview | 2,99 | - |
| Kimi K3 (Moonshot) | 2,94 | Hy4 vence 51,2% / empata 7,9% / perde 40,9% |
| GLM-5.3 (Z.AI) | 2,92 | Hy4 vence 46,8% / empata 12,8% / perde 40,4% |
Uma diferença de 0,05 ponto na escala de quatro pontos do próprio fabricante é um dar de ombros estatístico. A própria Tencent ressalva que é "bounded by its tasks, model versions, raters, and procedure... not an independent public benchmark". Contra o GLM-5.3, as vitórias do Hy4 só superam as derrotas por 47 a 40. É um quase empate vestido de liderança.
O gráfico de benchmarks públicos conta a história completa, e é o que vale olhar com honestidade:
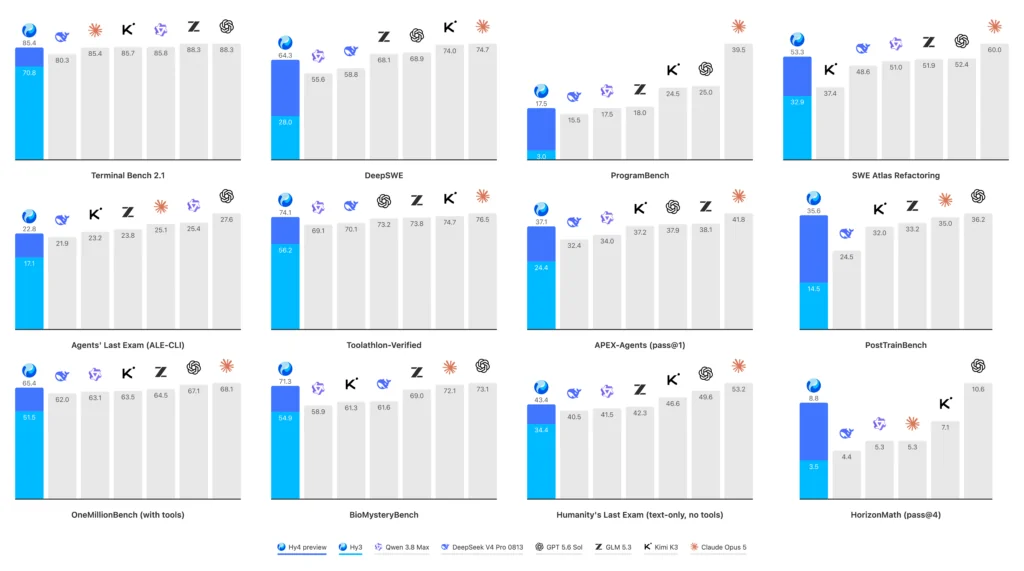
O Hy4 faz algumas pontuações fortes: 92,3 no GPQA Diamond, 85,4 no Terminal Bench, 82,9 no SWE-bench Multilingual, e lidera o campo aberto no HorizonMath e no BioMysteryBench. Mas, olhando os doze painéis, o Claude Opus 5 ou o GPT-5.6 geralmente está no topo, com o Hy4 agrupado no meio do pelotão ao lado do Kimi K3, do GLM-5.3 e do Qwen 3.8 Max. A comunidade percebeu o enquadramento rápido:
Why do they always highlight benchmarks where it scored less than other models the same as the ones where it scored better? It's so misleading. I can't even tell which benchmarks it actually beat other models.

Para uma colocação independente, o Hy4 ainda não está listado no índice de inteligência da Artificial Analysis, então não há uma pontuação agregada neutra para citar (como referência, o atual líder dessa tabela, o Claude Opus 5, está em 63). O único sinal de terceiros até agora vem do ranking de programação da LMArena:
Hy4 preview by @TencentHunyuan just landed ~#5 in the Code Arena: WebDev with 1633 pts (AutoEval)... Among open models, Hy4 preview is ~#3, compared to Hy3 at #7.
É um salto real sobre o Hy3, mas note a ressalva "AutoEval": a Arena diz que um modelo de recompensa deu votos automáticos em vez de votos humanos ao vivo, então trate como provisório. Minha leitura: o Hy4 é um modelo aberto legitimamente forte, mais ou menos no nível dos outros modelos de ponta chineses, e o "supera" é marketing em cima de um quase empate. Se quiser um confronto direto mais aprofundado, a comparação Qwen 3.8 Max vs Kimi K3 cobre a mesma faixa.
Dá para rodar de verdade?
Essa foi a pergunta que dominou todo tópico de lançamento, e a resposta é sóbria. MoE economiza computação, mas todos os 770B pesos precisam morar na memória da GPU.
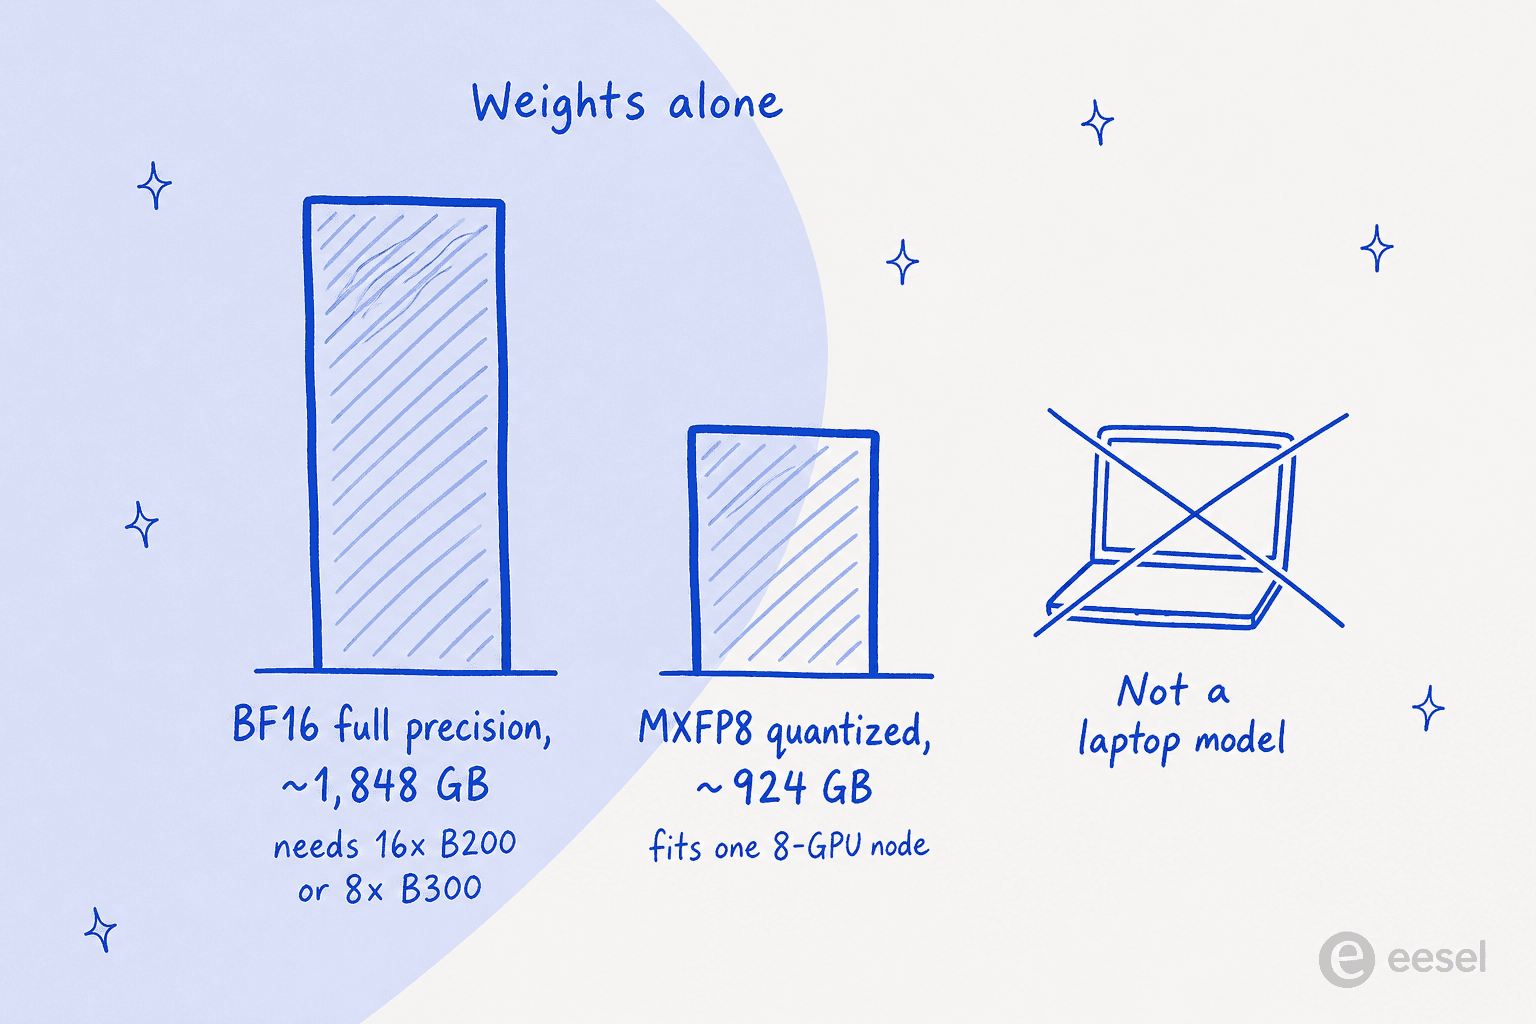
Segundo a receita oficial do vLLM, os pesos completos em BF16 somam cerca de 1.848 GB. A conclusão é direta: você precisa de "16x B200 or 8x B300 minimum for weights + KV cache." A versão quantizada MXFP8 reduz isso a mais ou menos metade, cerca de 924 GB, que cabe em um nó de 8 GPUs dos aceleradores mais novos com muita VRAM, e é por isso que o exemplo de serving padrão usa tensor-parallel de tamanho 8. Há um checkpoint FP8 oficial e um kit de quantização chamado AngelSlim para comprimi-lo ainda mais, mas nada disso o coloca ao alcance de um computador doméstico. O pessoal do r/LocalLLaMA, que roda modelos grandes por hobby, em sua maioria desistiu:
I don't know who around here runs 780b models, but I am happy for them :)
Até as contas de quantização da própria comunidade são sombrias: uma versão Q4 fica em torno de 450-512 GB, e uma máquina de 256 GB só comporta quantizações de 1-2 bits. Como um comentarista disse, se você tem 256 GB, "you'll probably be much better off with GLM-5.3-Flash Q4". Então, para a maioria das pessoas, "pesos abertos" é um fato de licença, não prático. Você vai usar o Hy4 por uma API.
Preços e comparação
O preço da API do Hy4 é US$ 0,834 por milhão de tokens de entrada, US$ 2,501 por milhão de saída e US$ 0,042 para acertos de cache. Entre os modelos abertos de ponta, é o mais barato do grupo.
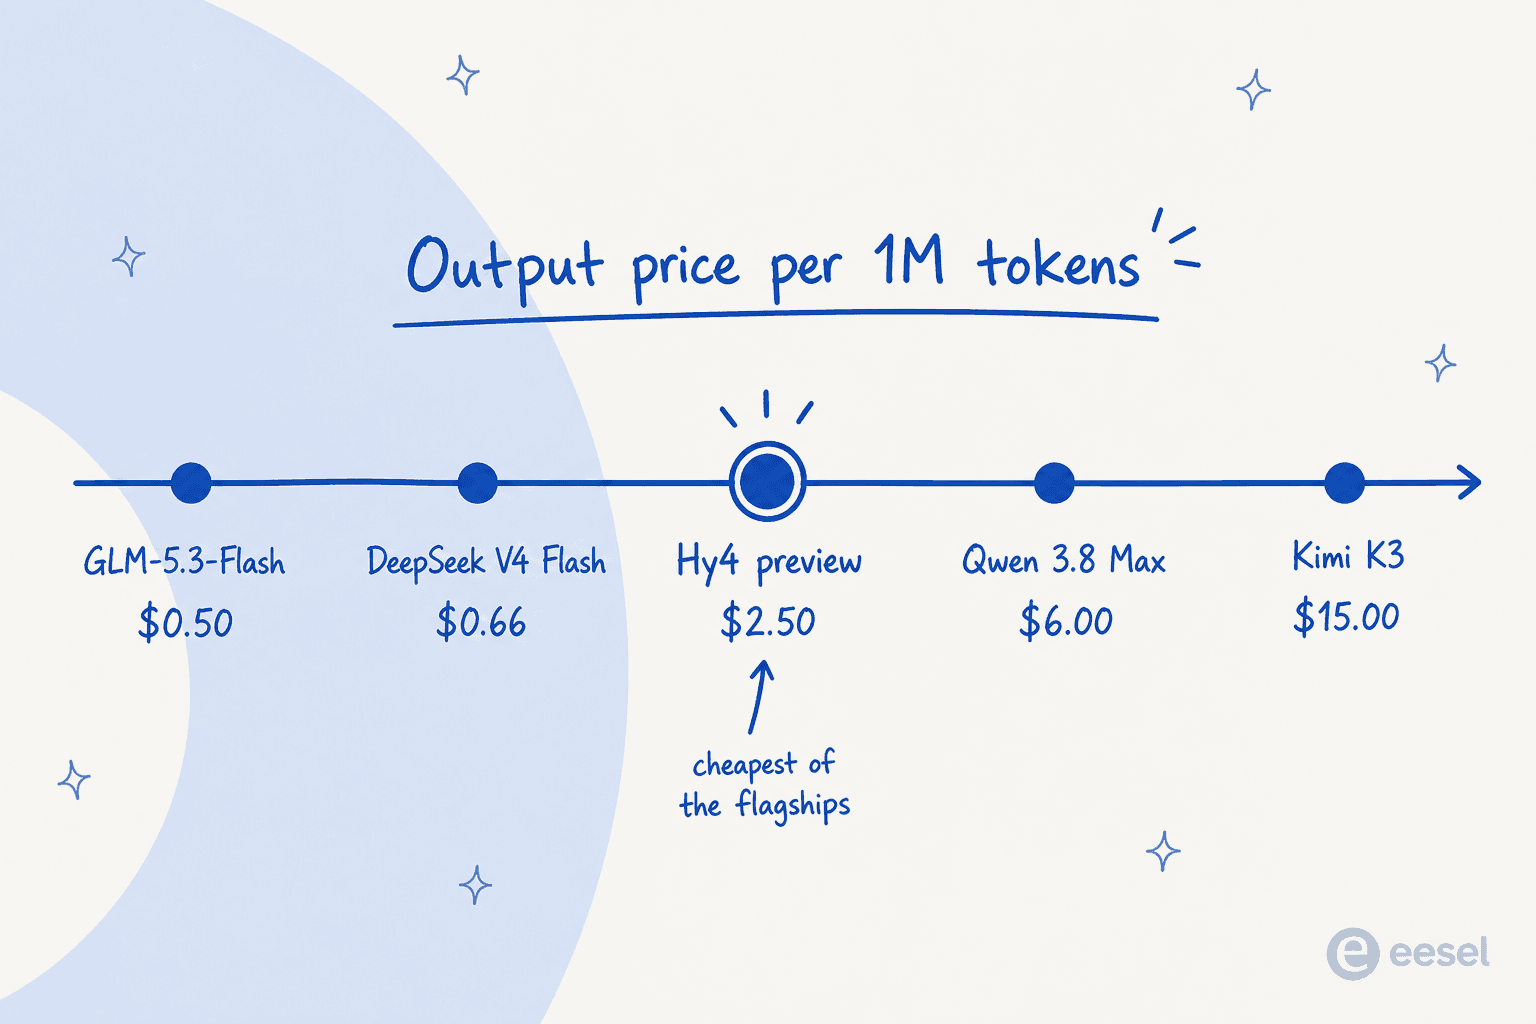
Este é o quadro completo frente ao campo atual de pesos abertos (tudo por milhão de tokens, verificado em 30 de agosto de 2026):
| Modelo | Entrada | Saída | Entrada com acerto de cache | Pesos |
|---|---|---|---|---|
| Hy4 preview (Tencent) | US$ 0,834 | US$ 2,501 | US$ 0,042 | Apache 2.0 |
| GLM-5.3-Flash (Z.AI) | US$ 0,15 | US$ 0,50 | US$ 0,03 | Abertos |
| DeepSeek V4 Flash | US$ 0,22 / US$ 0,44 | US$ 0,66 / US$ 1,32 | US$ 0,007 | MIT |
| GLM-5.3 (Z.AI) | US$ 1,40 | US$ 4,40 | US$ 0,26 | Abertos |
| Qwen 3.8 Max | US$ 2,00 | US$ 6,00 | US$ 0,25 | Personalizada |
| Kimi K3 (Moonshot) | US$ 3,00 | US$ 15,00 | US$ 0,30 | Abertos |
Então o Hy4 fica confortavelmente abaixo do GLM-5.3, do Qwen 3.8 Max e do Kimi K3 (cuja tarifa de saída é quase 6x a do Hy4). Mas não é o piso de preço. O DeepSeek V4 Flash e o GLM-5.3-Flash são ambos bem mais baratos, e a tarifa fora do horário de pico do DeepSeek o deixa em uma fração do custo do Hy4. E há um problema para quem já usa o Hunyuan:
But the new HY4 pricing is roughly 5-6x higher than HY3, so you're looking at about a 400-500% increase in input/output cost.
A única pechincha de verdade na tabela de preços é o cache de contexto a US$ 0,042 por milhão, que um usuário notou ser bem menor que o do GLM-5.3. Se sua carga relê um contexto fixo grande (uma base de código, um documento longo) em muitas chamadas, essa tarifa de cache é onde o Hy4 fica interessante. Para um detalhamento de custo maior dos vizinhos, o guia de preços do DeepSeek V4 Flash e o guia de preços do Kimi K3 são bons complementos.
Como acessar o Hy4 hoje
Se você não vai montar um nó de 8 GPUs, aqui está onde realmente acessá-lo:
- API: o ID do modelo é
hy4-preview, servido pelo Tencent Cloud TokenHub e pelo OpenRouter. Há suporte a APIs nos formatos OpenAI e Anthropic, e o OpenRouter o oferece com uma política de dados de retenção zero, uma boa vantagem sobre algumas APIs próprias chinesas cujos termos são vagos sobre uso para treinamento. - Grátis por duas semanas: o Hy4 é grátis no WorkBuddy e no CodeBuddy desde o lançamento, e o acesso gratuito ao Hy3 em ambos foi estendido até 30 de setembro. Também pode ser usado dentro dos apps Yuanbao e ima da Tencent.
- Pesos abertos: disponíveis no Hugging Face, GitHub, ModelScope e GitCode, com build BF16 e FP8.
Um esclarecimento, já que circulou no lançamento: CLIs de programação de terceiros adotaram o Hy4 rapidamente via OpenRouter, mas esses não são canais gratuitos oficiais da Tencent. As únicas ofertas gratuitas próprias são WorkBuddy e CodeBuddy.
O ângulo da automelhoria
A afirmação mais futurista do lançamento passa fácil despercebida. A Tencent diz que o Hy4 contribuiu para o próprio desenvolvimento, participando da "automated optimization of training methods, data strategies, evaluation frameworks, and low-level operators", o que ela chama de um "early-stage recursive self-improvement loop." A versão concreta e verificável: o Hy4 analisou gargalos na própria pilha de inferência e as otimizações resultantes aumentaram o throughput de ponta a ponta em 31,8%.
Eu receberia o enquadramento grandioso de "automelhoria" com um pé atrás (um modelo propondo fusões de operadores está muito longe de um modelo se redesenhando), mas o número de 31,8% de throughput é específico e real, e é o tipo de exibição de engenharia que costuma envelhecer bem. Ele também alimenta a esperança recorrente da comunidade de que o lançamento final chegue bem mais forte que esta preview:
And this is a PREVIEW? The actual release must actually be fable level or higher then?
Então, quem deveria usar o Hy4?
Depois de passar por tudo, este é meu veredito honesto. O Hy4 é um modelo de ponta de pesos abertos sério, com uma vantagem real de preço sobre o Kimi K3 e o Qwen 3.8 Max, fortes benchmarks de programação e ciência e uma licença permissiva Apache 2.0. Se você está construindo um agente de IA em uma infraestrutura que você controla, quer uma licença genuinamente aberta e tem orçamento de API ou hardware, é uma escolha legítima, principalmente para trabalho de programação com contexto longo e muito cache.
Mas seja realista em duas coisas. Não é a opção mais barata (DeepSeek e os modelos Flash ganham nisso), e não é um líder disparado (está no mesmo nível dos pares chineses e atrás da fronteira fechada). E, criticamente, o Hy4 é infraestrutura. É um modelo bruto que responde a prompts. Ele não conhece o seu negócio, não vive nas suas ferramentas e não faz um trabalho sozinho. Essa lacuna, entre um modelo poderoso e algo que realmente faz o trabalho, é todo o sentido da próxima seção.
Experimente a eesel
Esta é a distinção que importa: o Hy4 é um modelo; a eesel é a colega que você contrata. Um modelo base como o Hy4 entrega inteligência bruta que você depois precisa ligar, instruir com prompts, conectar aos seus dados e supervisionar. A eesel é uma plataforma de colegas de IA onde você contrata colegas prontas para trabalhar em tarefas específicas, cada uma chegando com as habilidades, integrações e contexto da empresa para o seu papel.
O elenco atual inclui uma colega de IA para o helpdesk que entra na sua fila de suporte existente, consulta pedidos, etiqueta tickets e redige ou envia respostas dentro do helpdesk que você já usa, e uma redatora de blog com IA que cuida de pesquisa, redação e SEO de uma só vez. Ambas treinam com seus tickets anteriores, sua central de ajuda e seus documentos, e entram no ar em minutos em vez de exigir uma equipe de ML. Onde um modelo deixa você com uma caixa de prompt, uma colega chega já conhecendo o trabalho.
A outra coisa que modelos brutos não fazem: antes de uma colega da eesel entrar no ar, você pode simulá-la com seus tickets históricos, para saber como ela realmente vai se sair, em vez de virar a chave e torcer. É grátis para testar, sem cartão de crédito e sem ligação de vendas. Se seu objetivo é realizar trabalho de verdade em vez de operar um cluster de inferência, comece com a eesel.