

O Tencent Hy4 preview tem dois preços, e o que todo mundo cita é o menor. Na API ele custa $0.834 por milhão de tokens de entrada e $2.501 por milhão de saída, com a entrada em cache a $0.042 (anúncio oficial). Entre os modelos de ponta de pesos abertos com os quais ele se compara, esse é o lugar barato.
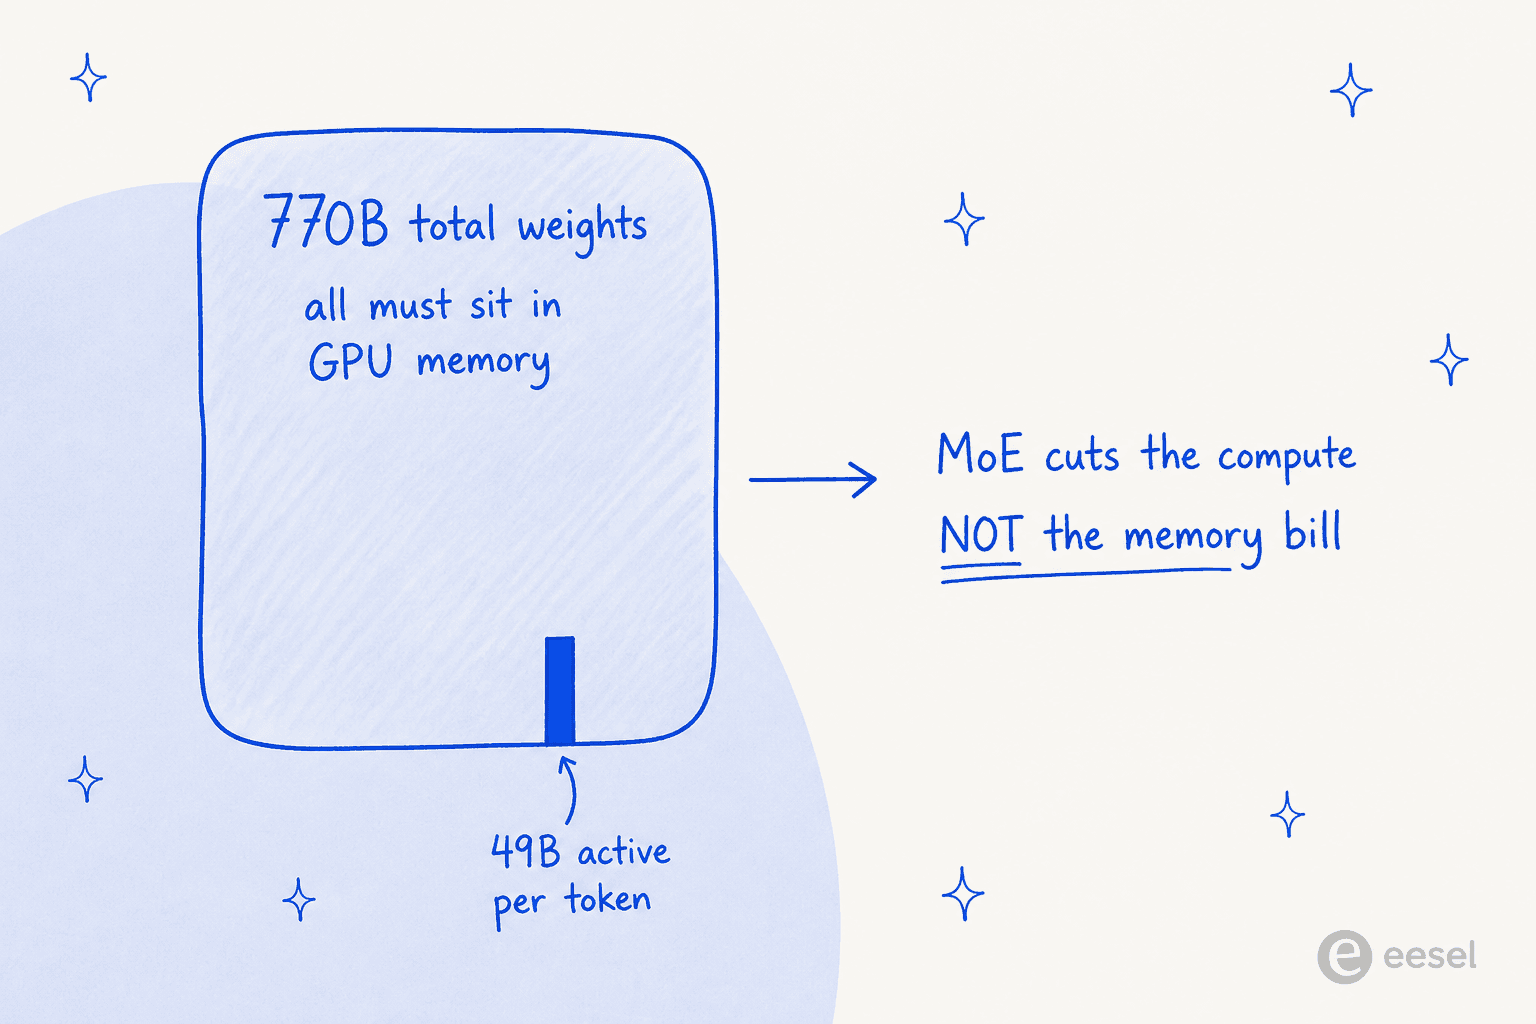
O número maior é o hardware. O Hy4 é um modelo Mixture-of-Experts de 770B parâmetros, e o MoE reduz o cálculo por token, não a conta de memória, então todos os 770B pesos precisam estar ao mesmo tempo na memória da GPU. Rodá-lo por conta própria significa 16x B200 ou 8x B300, um nó de data center, não uma estação de trabalho.
Então a leitura honesta sobre os preços do Tencent Hy4: alugado via API ele tem preço competitivo, mais barato que o Kimi K3 ou o Qwen 3.8 Max, embora o DeepSeek V4 Flash continue sendo bem mais barato. Se tentar ter o modelo em casa, o preço é uma linha séria de capital. E ele é 5-6x mais caro que o Hy3 que substitui, então usuários atuais não devem supor um upgrade gratuito.
Se o que você realmente quer é um trabalho concluído em vez de um modelo provisionado, uma colega de IA pronta é um caminho mais curto e muitas vezes mais barato que tudo isso.
Preços da API do Tencent Hy4 num relance
Passo a maior parte da minha semana pensando em como os compradores realmente buscam ferramentas como esta, e "preços do Tencent Hy4" quase sempre são duas perguntas: quanto custa um token e quanto custa o conjunto para rodar. Vamos primeiro à pergunta do token, porque é a simples.
Aqui estão as tarifas publicadas da API, direto do anúncio de lançamento da Tencent, todas por milhão de tokens:
| Medidor | Preço por 1M de tokens | O que cobre |
|---|---|---|
| Entrada | $0.834 | Todo token que você envia (prompt, contexto, documentos recuperados) |
| Saída | $2.501 | Todo token que o modelo gera de volta |
| Entrada em cache | $0.042 | Tokens de entrada servidos do cache em um prompt repetido |
Três coisas dessa tabela merecem destaque.
Primeiro, a proporção entre saída e entrada é de cerca de 3:1, o que é normal para um modelo de muito raciocínio. Como o Hy4 é um grande raciocinador (mais sobre isso abaixo), suas contas vão pender para o medidor de saída, então o número de $2.501 é o que você deve usar no planejamento, não o $0.834 de manchete.
Segundo, a tarifa de cache é muito barata, $0.042. Se a sua carga repete um prompt de sistema grande ou uma base de conhecimento fixa em muitas chamadas, e a maioria das cargas agênticas faz isso, os acertos de cache derrubam o preço efetivo de entrada em cerca de 20 vezes. É uma alavanca real, e é o que separa um agente de IA bem construído de um chatbot baseado em regras ou de um wrapper ingênuo que paga o preço cheio por cada token.
Terceiro, não existe um plano gratuito permanente. O teste tem prazo (duas semanas nos apps da própria Tencent) e depois disso cada token é medido e cobrado.
Estime sua conta mensal do Tencent Hy4
Tarifas por milhão de tokens são difíceis de sentir. Insira um volume mensal aproximado e veja quanto o Hy4 custa em comparação com os outros modelos abertos de ponta. A calculadora assume as tarifas padrão sem cache para todos os modelos.
O preço que ninguém cita: rodar por conta própria
É aqui que "pesos abertos" fica caro, e é a coisa mais importante a entender antes de se empolgar com o fato de o Hy4 ser de código aberto. A licença Apache 2.0 significa que você tem permissão para rodá-lo em qualquer lugar. O hardware decide se você consegue e quanto custa.
A receita do vLLM é direta sobre o piso. Os pesos completos em BF16 têm cerca de 1.848 GB. Mesmo os pesos quantizados em MXFP8 têm ~924 GB. O mínimo da própria receita: "16xB200 or 8xB300 minimum for weights + KV cache." Um único nó de 8x H100 (640 GB) não comporta.
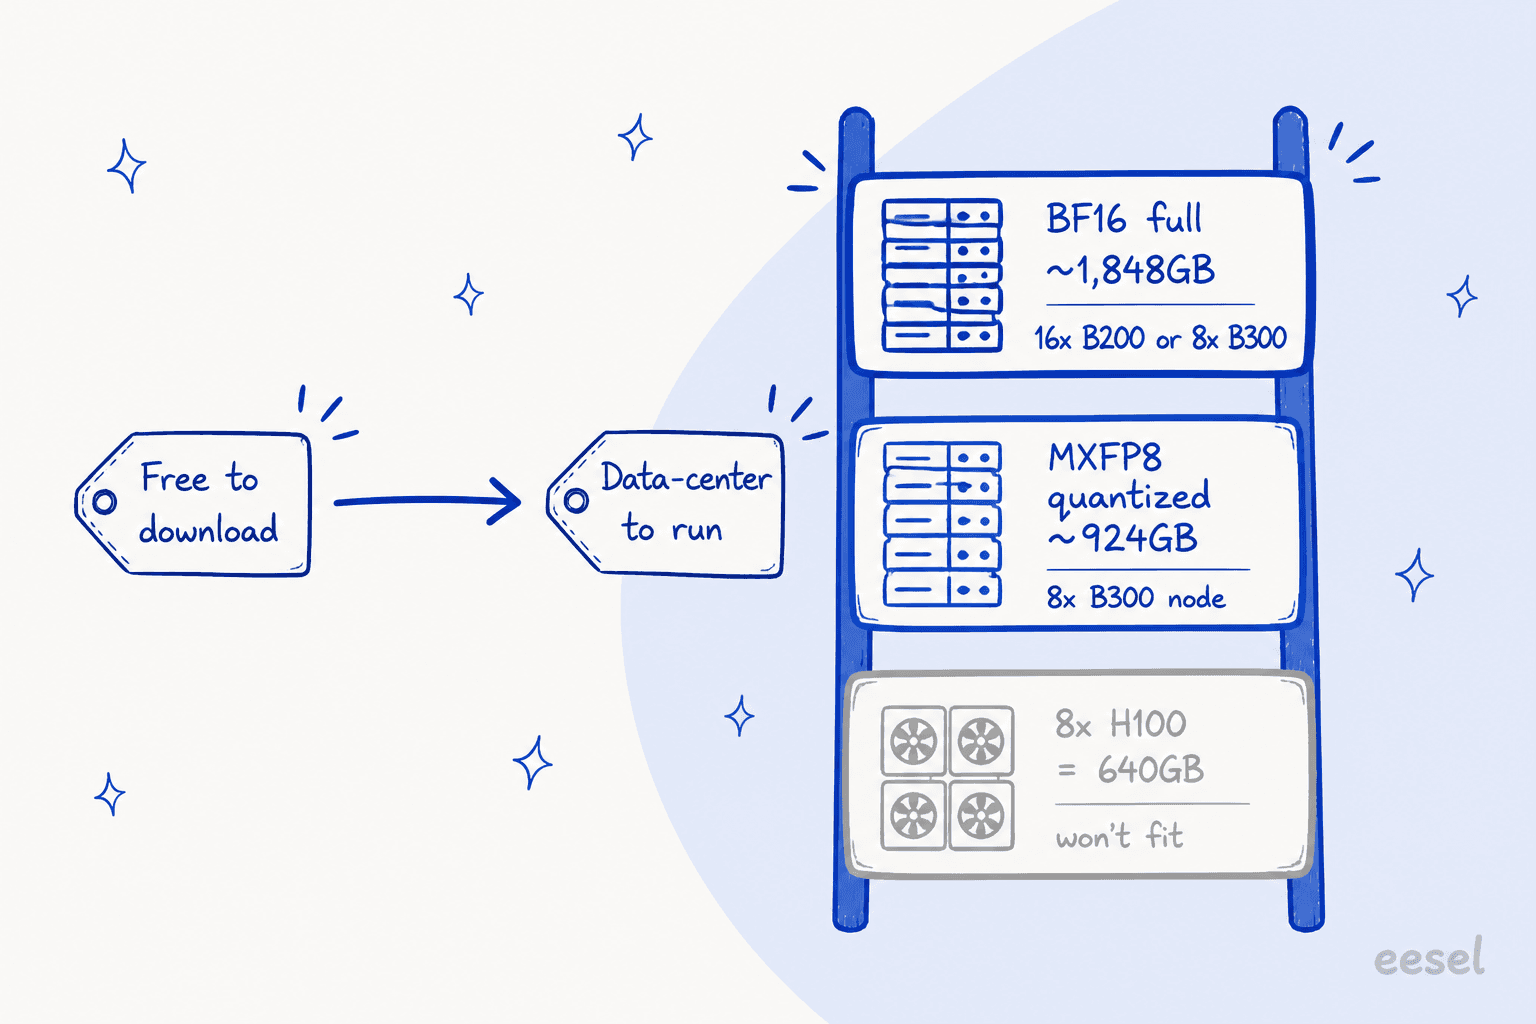
Vamos colocar números aproximados nisso. Alugar um nó de 8x B200 de um provedor de GPU em nuvem custa na casa das dezenas de milhares de dólares por mês, e a receita completa em BF16 pede dois. Comprar o silício direto é uma compra de capital de seis dígitos antes mesmo de ligá-lo. Esse é o preço real do Tencent Hy4 para quem quer ser dono da própria inferência, e ele supera de longe a tarifa por token, a menos que você rode a máquina com utilização muito alta.
O pessoal do r/LocalLLaMA, que roda modelos grandes em casa como hobby, recebeu a novidade com partes iguais de admiração e resignação:
The amount of people who can drop $5-10k to run these locally is vanishingly small.

A conta de quantização que eles fizeram é útil se você estiver tentado. Um GGUF Q4 chega a cerca de 450 GB, então 512 GB de memória é o mínimo realista, e uma máquina de 256 GB só comporta as quantizações de 1-2 bits. Um detalhamento aprofundado foi claro: se você tem 256 GB, está muito melhor com o GLM-5.3-Flash. Para uso local, um modelo menor e bem pós-treinado continua vencendo o argumento de custo.
A conclusão sobre preços: para quase todo mundo, "usar" o Hy4 significa usar a API. Hospedar por conta própria é um projeto de data center, não um item de orçamento.
Preços do Tencent Hy4 frente aos outros modelos de ponta de pesos abertos
Veja onde o Hy4 fica diante dos concorrentes, tudo por milhão de tokens, verificado em 30 de agosto de 2026.
| Modelo | Parâmetros totais / ativos | Contexto | Entrada | Saída | Entrada com acerto de cache |
|---|---|---|---|---|---|
| Hy4 preview (Tencent) | 770B / 49B | 1M | $0.834 | $2.501 | $0.042 |
| DeepSeek V4 Flash | 284B / 13B | 1M | $0.22 / $0.44 | $0.66 / $1.32 | $0.007 |
| DeepSeek V4 Pro | 49B-class active | 1M | $0.66 / $1.32 | $1.98 / $3.96 | $0.022 |
| Qwen 3.8 Max | 2.4T / 95B | 1M | $2.00 | $6.00 | $0.25 |
| Kimi K3 | 2.8T / 104B | 1M | $3.00 | $15.00 | $0.30 |
| GLM-5.3 | não divulgado | n/d | $1.40 | $4.40 | $0.26 |
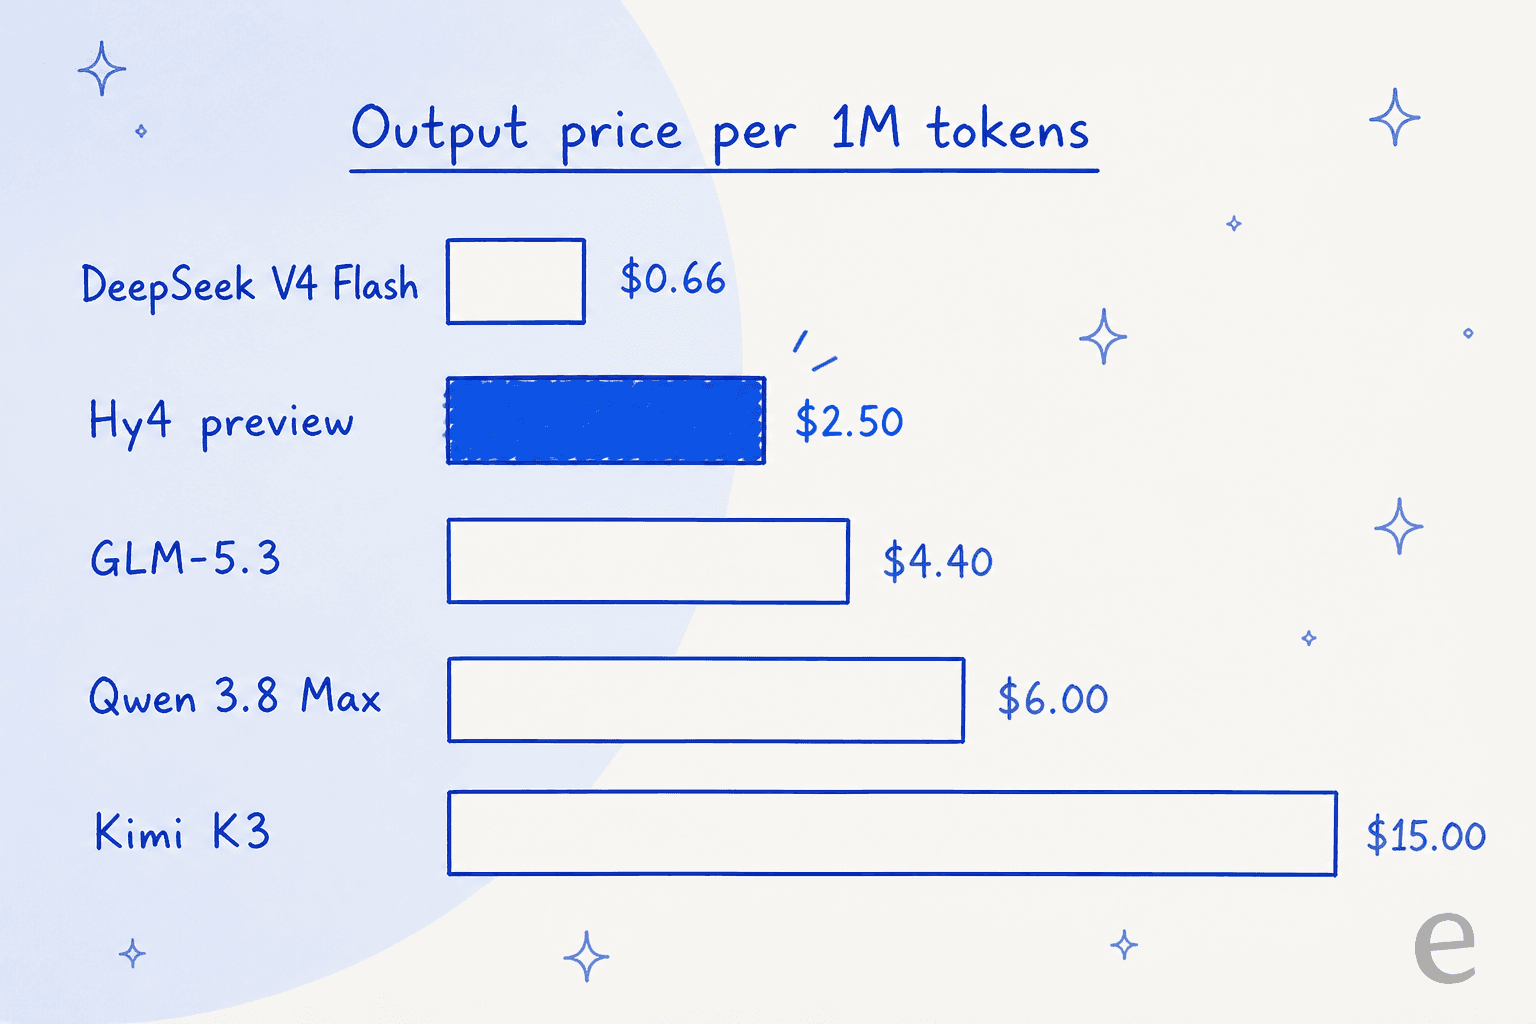
O gráfico conta a mesma história mais rápido. No medidor que domina a maioria das contas, a saída, o Hy4 é o segundo mais barato deste grupo, atrás apenas do DeepSeek V4 Flash.
Duas ressalvas honestas acompanham esse preço.
Primeiro, o Hy4 é cerca de 5-6x mais caro que o Hy3, como apontado no tópico de preços da comunidade. Se você já usa o Hy3, é um salto de custo real, não um desconto, e vale decidir se a capacidade extra muda o seu resultado.
Segundo, o DeepSeek V4 Flash é dramaticamente mais barato nos dois medidores, e em muito trabalho agêntico "barato e bom o bastante" vence. Um desenvolvedor disse isso sem rodeios depois de fazer um teste real:
even mimo 2.5 was same good and on 1/20 of the costs... the model is interesting if the price is lower but not for 2.5 USD per million output.
Esse é o cerne da posição de preço do Hy4: ele não é o mais barato e não tenta ser. É a opção de preço intermediário que oferece pontuações de código de nível de ponta e contexto de 1M, e se isso compensa o prêmio em relação ao DeepSeek ou a um modelo da linha Flash depende inteiramente de quanto a qualidade extra move os seus números.
Como testar o Hy4 barato (ou de graça)
Se você quer experimentar antes de comprometer um orçamento, há algumas rotas de baixo custo:
- Grátis por duas semanas nos apps WorkBuddy e CodeBuddy da Tencent desde o lançamento. Sem custo de tokens durante a janela.
- OpenRouter, que lista o Hy4 preview com uma política de dados de retenção zero. Útil se você quer uma única chave de API para muitos modelos e se importa com o tratamento de dados.
- Tencent Cloud TokenHub, a rota de primeira mão se você já está na nuvem da Tencent.
Para a maioria dos compradores, o movimento inteligente é rodar um piloto pequeno na janela gratuita, medir a sua divisão real entre entrada e saída (use a calculadora acima com esses números) e só então decidir se a tarifa do Hy4 supera a de um modelo mais barato para a sua carga específica.
O que o preço do Hy4 realmente compra, e onde ele vaza
Mais uma nuance de preço que não aparece na tabela de tarifas. A Tencent é franca ao dizer que esta preview raciocina por mais tempo que o necessário e verifica demais o próprio trabalho. Num modelo cobrado por token, um raciocinador excessivo infla discretamente a sua conta, porque você paga por cada um desses tokens de saída extras. Então o custo efetivo do Hy4 numa tarefa tagarela e carregada de verificação pode ficar acima do que a tarifa de tabela sugere, justamente o tipo de coisa que só aparece depois que você está em produção.
Essa é a lacuna a que sempre volto. A tarifa bruta de um modelo diz quanto custa um token. Não diz quantos tokens o trabalho vai consumir, se os seus prompts acertam o cache, quanto você vai gastar em novas tentativas ou quanto vale o tempo de engenharia para conectar tudo. Esses são os números que decidem a conta real, e são os que um benchmark ou uma tabela de preços nunca mostra.
Se você quer o contexto mais profundo de especificações e benchmarks por trás desses preços, a análise completa do Tencent Hy4 e a visão geral do Hy4 explicam pelo que você está pagando.
E se você está comparando puramente por custo, estes detalhamentos são as próximas leituras naturais:
- Preços do Qwen 3.8 Max
- Preços do Kimi K3 e a análise do Kimi K3
- Preços do Gemini
- Preços da Mistral
- DeepSeek V4, o atual piso de preço
Experimente a eesel: contrate a colega e pule a conta de tokens
É assim que eu coloco a questão depois de anos vendo equipes escolherem modelos. Um modelo como o Hy4 é infraestrutura, um motor sem carro em volta. A eesel AI é a funcionária. Em vez de escolher um modelo, provisionar GPUs ou medir tokens e construir você mesmo a recuperação, os guardrails, as integrações e as avaliações, você contrata uma colega de IA pronta para trabalhar numa função específica, e ela chega já sabendo como fazê-la.

Hoje a equipe tem duas colegas. A colega de IA para helpdesk entra na sua fila existente no Zendesk, no Freshdesk ou em uma caixa de entrada compartilhada, treina com seus tickets anteriores e sua central de ajuda, e redige ou envia respostas. Você pode simulá-la com tickets históricos antes que ela responda a um único cliente, para saber o custo e o comportamento de antemão em vez de acionar um interruptor e torcer. A redatora de blog com IA faz a pesquisa, a redação e o SEO de um post longo em uma única execução.
Ambas rodam em modelos de ponta por baixo dos panos, então você obtém a capacidade sem provisionar uma única GPU nem ler uma tabela de tarifas, e os preços mensais fixos da própria eesel (a partir de $299/mês por 500 créditos) são um número previsível em vez de um medidor bruto de tokens que você precisa projetar. Você pode começar de graça, sem cartão de crédito e sem ligação de vendas.
Quer a conta de ponta a ponta em vez de uma tarifa por token? Estes artigos tornam isso concreto: