

O Tencent Hy4 preview é um modelo open-weight impressionante e, para a maioria das pessoas, um que você vai alugar em vez de rodar. É um modelo Mixture-of-Experts com 770B de parâmetros totais, 49B ativos por token e uma janela de contexto de 1M de tokens, lançado como open-weight sob Apache 2.0 no Hugging Face em 28 de agosto de 2026.
Nos benchmarks, ele fica no topo dos modelos abertos: 92,3 no GPQA Diamond, 82,9% no SWE-bench Multilingual e um pouco à frente do Kimi K3 e do GLM-5.3 na avaliação cega da própria Tencent. Mas o gráfico publicado por ela mostra que ele alterna vitórias e derrotas com esses rivais, então "no mesmo nível dos melhores modelos abertos" é a leitura honesta, não "supera todos".
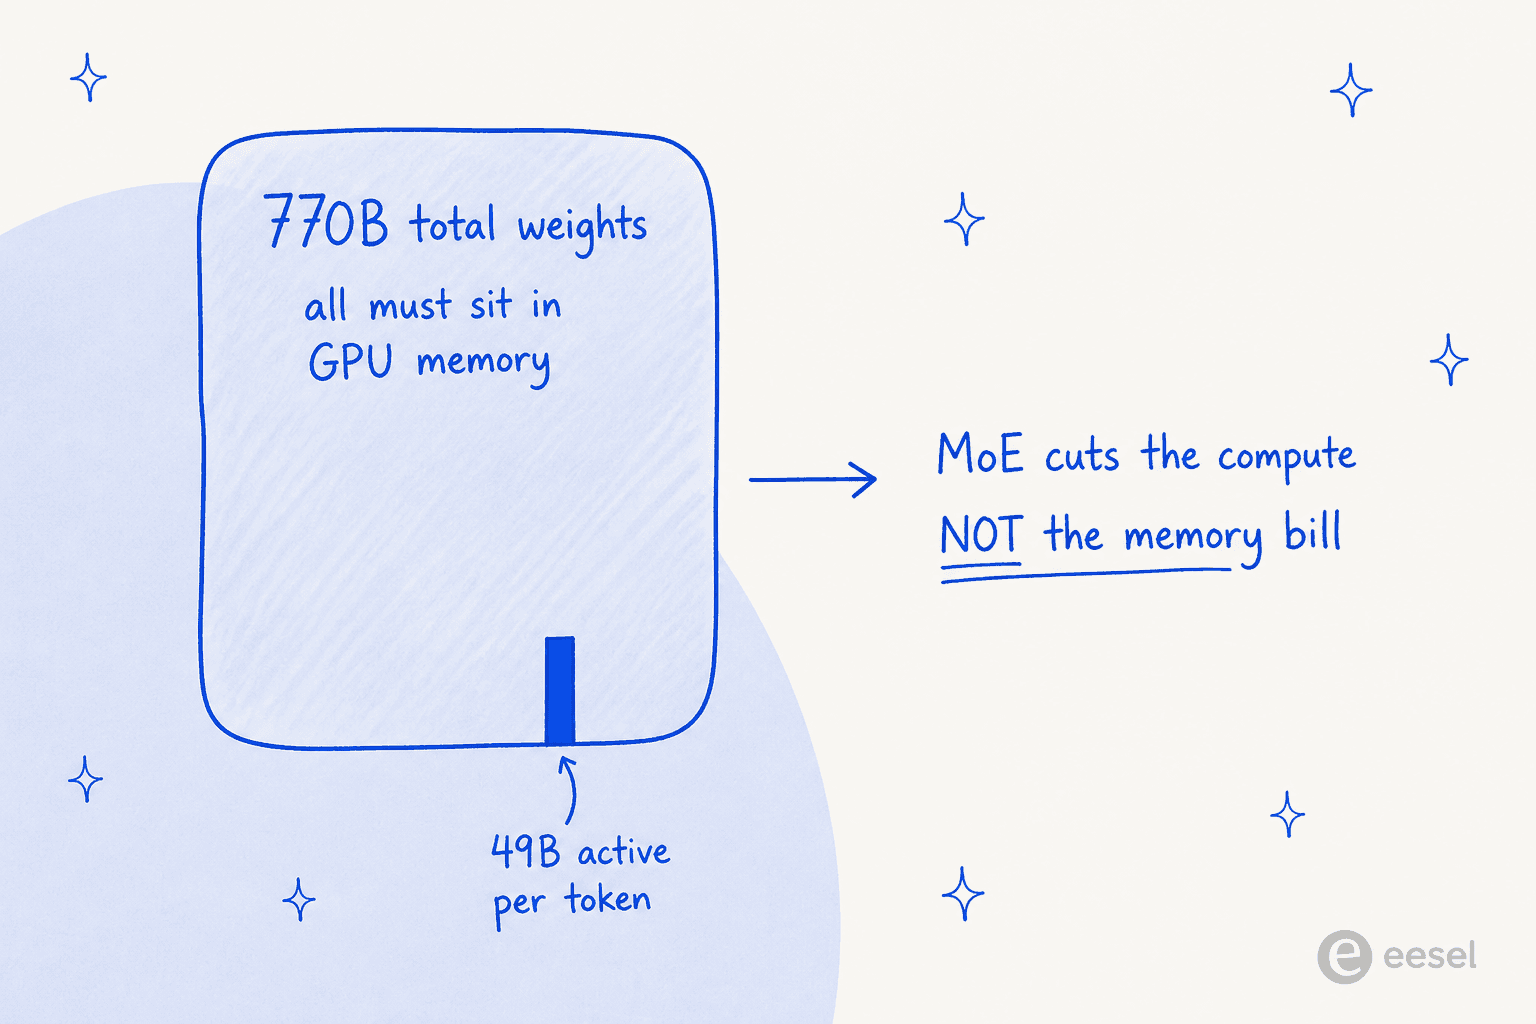
O problema é rodá-lo. O MoE reduz o cálculo por token, não a conta de memória: todos os 770B pesos precisam estar na memória da GPU, então você precisa de 16x B200 ou 8x B300 para o modelo completo. Pela API, custa $0,834 de entrada / $2,501 de saída por milhão de tokens, o que fica abaixo do Qwen 3.8 Max e do Kimi K3, mas é 5-6x mais caro que o Hy3 que ele substitui, e o DeepSeek V4 Flash continua bem mais barato.
Para quem é? Equipes que constroem ferramentas agênticas de programação ou pesquisa, que querem pesos abertos e uma licença permissiva, e que têm (ou alugam) o hardware. Se você só quer o resultado, um ticket de suporte respondido ou um blog escrito, um colega de IA pronto é um caminho mais curto do que montar você mesmo um modelo de 770B.
O que a Tencent realmente lançou
Eu construo, profissionalmente, os agentes de IA que ficam por cima de modelos como este, então um novo modelo open-weight de ponta é a parte da minha semana que eu realmente espero com ansiedade. Passei os últimos anos observando o que separa um modelo que brilha em demonstrações de um que sobrevive a uma fila de produção real, e o Hy4 é um bom teste dessa lacuna.
Aqui vai a versão curta do que chegou. A equipe Hunyuan da Tencent lançou e abriu o código do Hy4 preview em 28 de agosto de 2026, posicionando-o como "built for real-world productivity tasks... across coding, office work, and scientific research." É o sucessor da linha Hy3 de julho, e a Tencent o entrega no formato "primeiro a prévia, depois o lançamento oficial", a mesma cadência de antes.
As principais especificações, direto do model card:
- 770B de parâmetros totais, 49B ativos por token (um design Mixture-of-Experts).
- 78 camadas, com 256 especialistas roteados mais 1 especialista compartilhado; cada token aciona os 8 melhores especialistas roteados.
- Janela de contexto de 1M de tokens.
- Licença Apache 2.0, com um modelo BF16 e uma versão quantizada FP8 oficial lançados lado a lado.
Um detalhe que achei interessante: a Tencent diz que o Hy4 participou do próprio desenvolvimento, propondo e executando experimentos sobre métodos de treinamento e operadores de baixo nível, e otimizou de forma autônoma a própria pilha de inferência para um ganho de 31,8% de throughput. Eles chamam isso de "an early-stage recursive self-improvement loop." É um enquadramento de marketing sobre um resultado real, mas é o tipo de afirmação que vale guardar.
Como a conta de 770B / 49B realmente funciona
Se Mixture-of-Experts é novidade para você, os dois números grandes parecem contraditórios: como um modelo de 770B pode ser apenas "49B" de alguma coisa? A resposta é que o MoE divide a rede em muitas sub-redes de especialistas e, para cada token, um roteador escolhe um pequeno punhado para rodar de fato. Assim, o cálculo por token se comporta como o de um modelo de ~49B, e é isso que mantém o Hy4 rápido o bastante para ser servido.
A armadilha é supor que um número ativo menor significa hardware menor. Não significa. Cada um dos 770B pesos precisa estar residente na memória da GPU, porque o roteador pode escolher qualquer especialista para o próximo token. O MoE oferece matemática mais barata, não uma máquina mais barata.
Por baixo do capô há mais engenharia do que a ficha técnica deixa transparecer: a atenção usa Gated DeepSeek Sparse Attention com um IndexCache para reaproveitar índices esparsos entre camadas, e há uma camada nativa de predição de múltiplos tokens acoplada para decodificação especulativa. Se você acompanhou os artigos de arquitetura do DeepSeek e do GLM, muito disso vai parecer familiar, o que por si só é um sinal de quão rápido a fronteira open-weight converge para os mesmos truques.
Os benchmarks, lidos com honestidade
O Hy4 vai bem nos benchmarks. Nas pontuações verificadas que o Hugging Face exibe, ele atinge 92,3 no GPQA Diamond, 82,9% resolvidos no SWE-bench Multilingual, 65,7 no SWE-bench Pro e 64,3 no Deep SWE. Para um modelo open-weight, são números fortes de programação e raciocínio, e a comunidade percebeu. Um comentarista no tópico com todos os benchmarks resumiu o clima:
For a 770B parameters model, it's impressive.

A comparação com que a Tencent abre é uma avaliação cega interna: 163 especialistas avaliaram resultados em 203 tarefas de engenharia, com nota máxima 4,00. O Hy4 ficou com 2,99, à frente do Kimi K3 (2,94) e do GLM-5.3 (2,92). É um resultado real, mas é o teste da própria Tencent, e uma diferença de 0,05 ponto numa escala de 4 é um quase empate, não um nocaute.
O gráfico público dela conta a história completa, e vale olhá-lo em vez de aceitar o resumo de olhos fechados. Contra o Claude Opus 5 e o GPT-5.6 Sol, o Hy4 (azul escuro) geralmente fica atrás; contra o Kimi K3 e o GLM-5.3, troca golpes benchmark a benchmark.
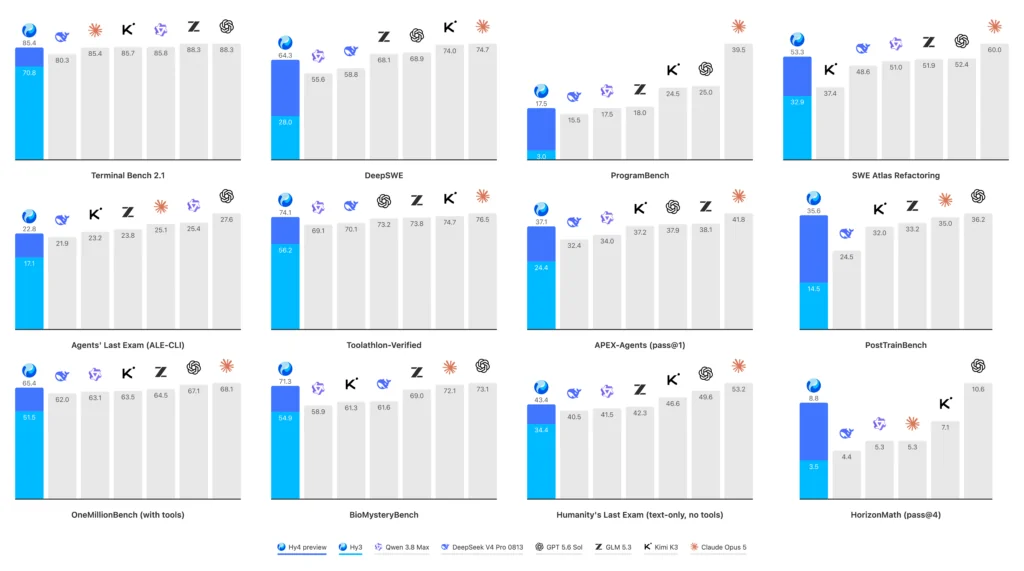
O leitor mais atento do tópico do r/LocalLLaMA fez a contagem que o marketing não fez:
I don't think their own chart backs the beats glm and kimi line. Against kimi k3 it's behind on 7 of the 12 benchmarks... The beats claim comes from the internal blind test where wins only beat losses 47 to 40 against glm.
De forma independente, a conta oficial da Arena informou que o Hy4 ficou em cerca do 5º lugar no ranking WebDev da Code Arena com 1.633 pontos, aproximadamente o 3º entre os modelos abertos, embora tenha sinalizado que é uma colocação inicial de AutoEval (um modelo de recompensa votando no lugar de votos humanos ao vivo), não uma posição definitiva. E ele ainda nem está no índice da Artificial Analysis, então não há uma pontuação de inteligência independente para citar. Minha leitura: é um modelo aberto forte, de primeira linha, não o novo nº 1, e o enquadramento "supera todos" é a parte que eu descontaria.
Mais uma coisa que a Tencent admite abertamente e que eu respeito: esta prévia raciocina mais do que o necessário e verifica demais o próprio trabalho. Eles lançam cedo de propósito, do mesmo jeito que a prévia do Hy3 fez antes de a versão final dar, segundo relatos, um salto de 50-100%.
Dá para rodar de verdade?
É aqui que o rótulo "open-weight" se complica, e é a coisa mais importante a entender antes de se empolgar. Pesos abertos e uma licença Apache 2.0 significam que você pode rodar o Hy4 em qualquer lugar. O hardware é que decide se você consegue.
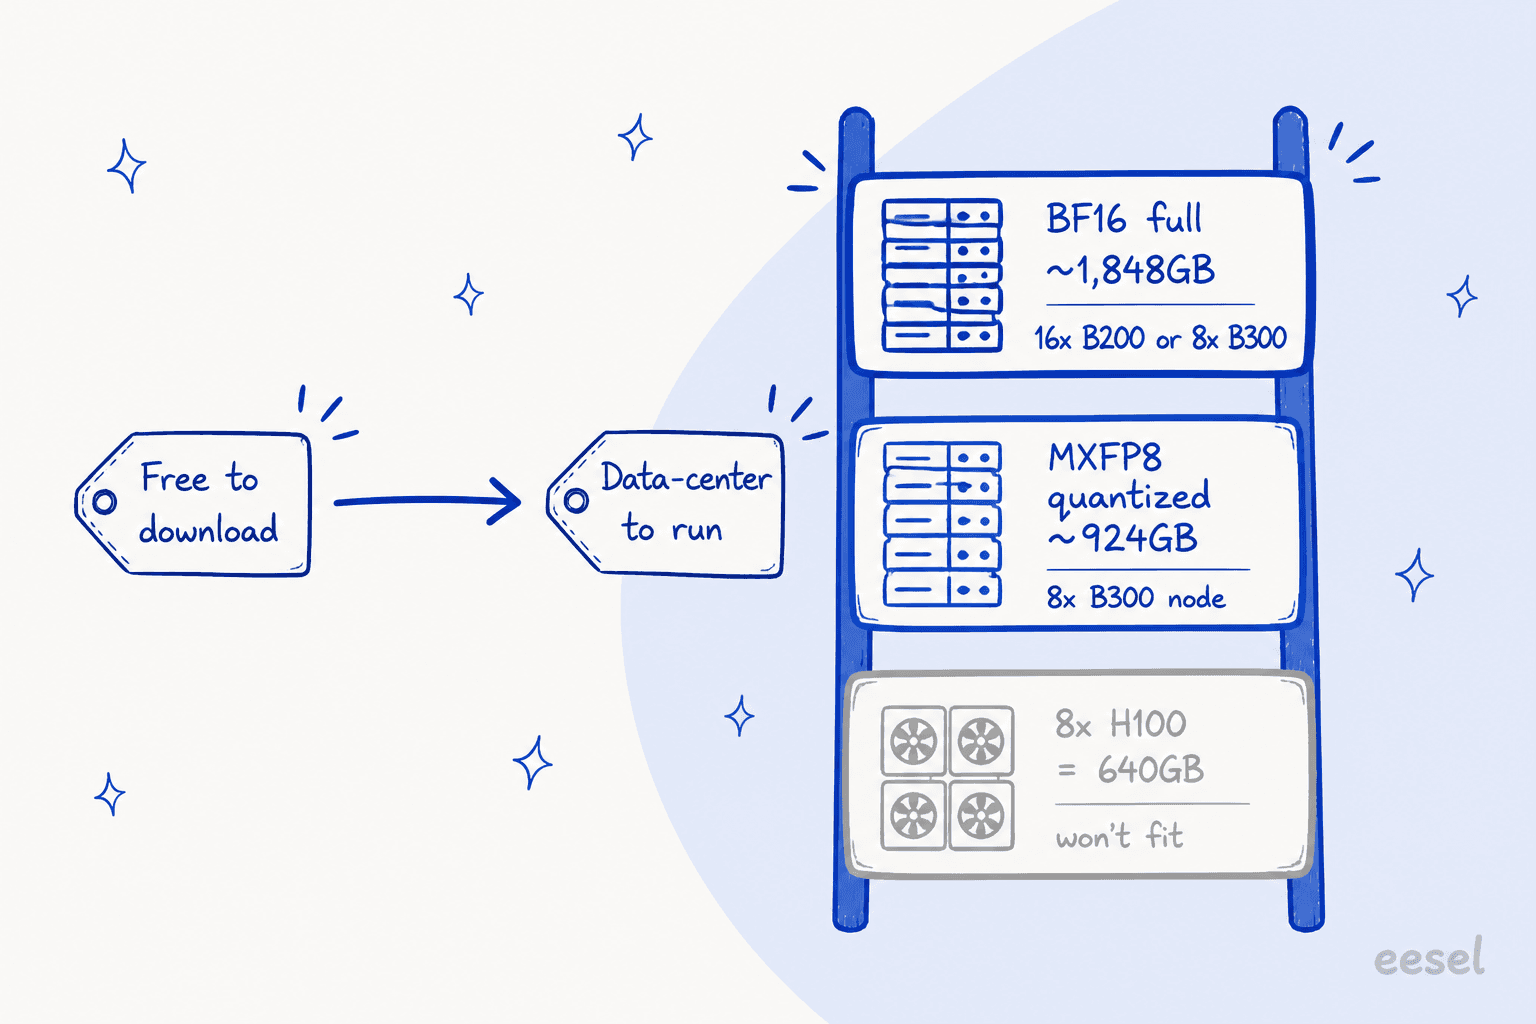
A receita do vLLM é direta. Os pesos completos em BF16 têm cerca de 1.848 GB. Mesmo os pesos quantizados MXFP8 têm ~924 GB. O piso da própria receita: "16xB200 or 8xB300 minimum for weights + KV cache." Um único nó de 8x H100 (640 GB) não comporta. É um modelo de data center, ponto final.
O pessoal do r/LocalLLaMA, que roda modelos grandes em casa como hobby, recebeu-o com partes iguais de admiração e resignação:
The amount of people who can drop $5-10k to run these locally is vanishingly small.
A conta prática de quantização que eles fizeram é útil se você se sentir tentado: um GGUF Q4 fica em torno de 450 GB, então 512 GB é o mínimo realista, e uma máquina de 256 GB só comporta as quantizações de 1-2 bits. Como uma análise detalhada resumiu: "if you have 256GB, you'll probably be much better off with GLM-5.3-Flash Q4." Esse é o veredito recorrente: para uso local, um modelo menor e bem pós-treinado é a escolha mais inteligente, e os modelos Flash da Z.AI continuam sendo citados como os que vale buscar.
Então, na prática, "usar" o Hy4 significa a API ou um dos apps da Tencent, não a sua própria máquina.
Quanto custa o Tencent Hy4
Na API, o Hy4 preview custa $0,834 por milhão de tokens de entrada e $2,501 por milhão de saída, com entrada em cache a $0,042 (anúncio oficial). Entre os modelos abertos de ponta com os quais ele se compara, é a opção barata.
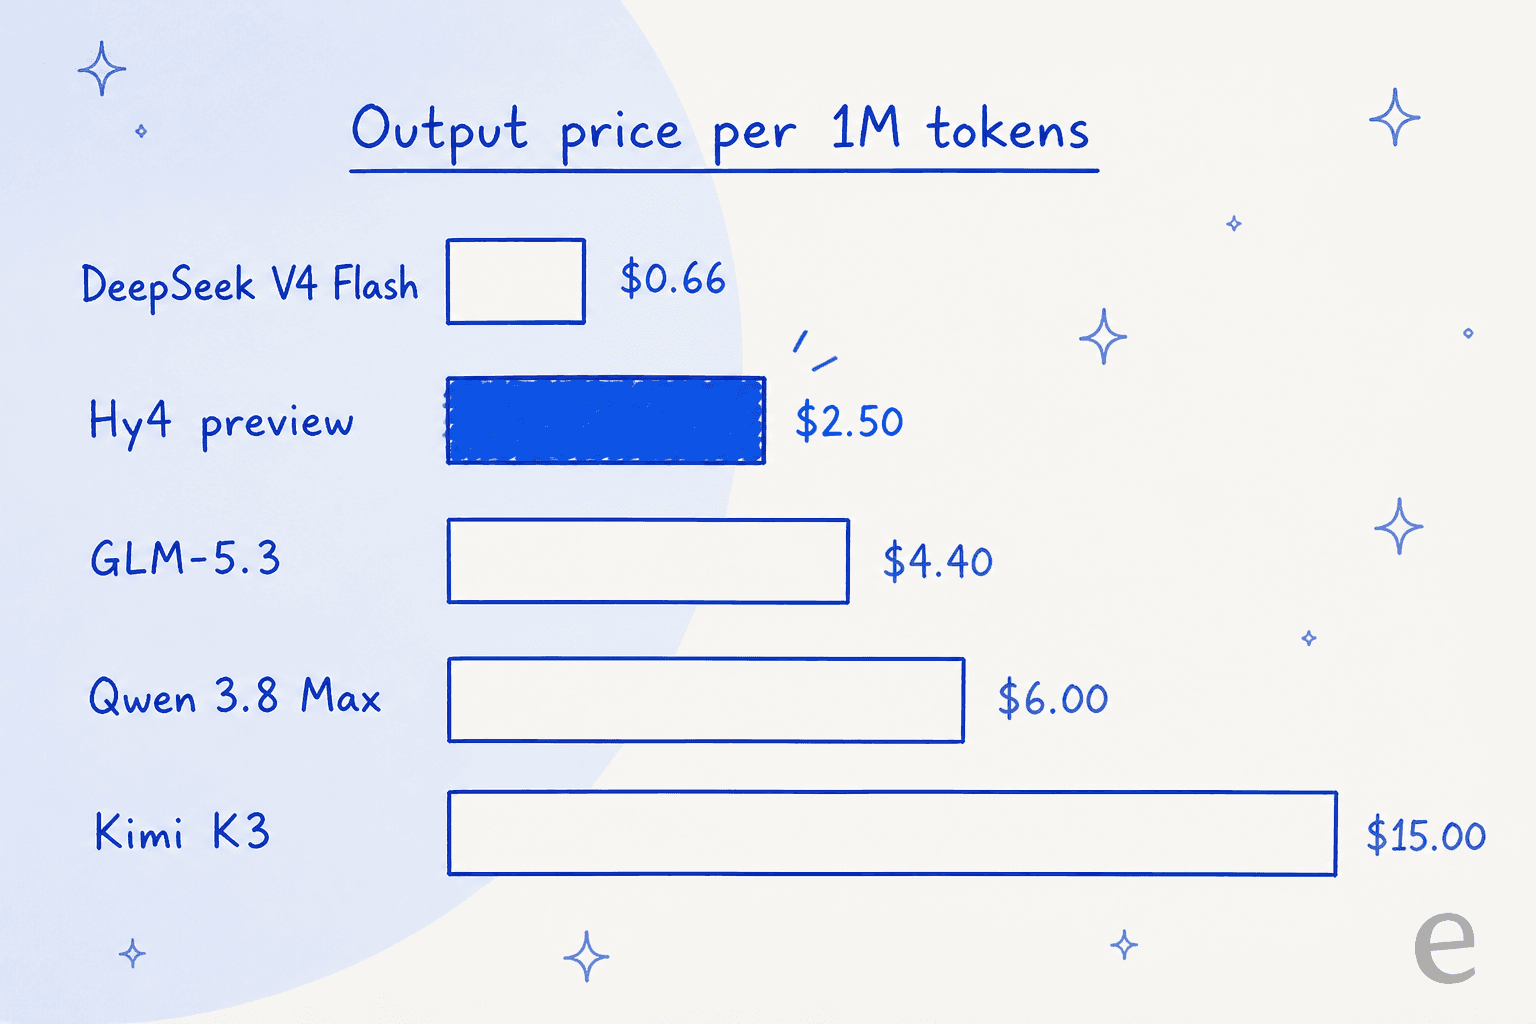
Aqui está o quadro completo frente aos rivais, tudo por milhão de tokens:
| Modelo | Parâmetros totais / ativos | Contexto | Entrada | Saída | Entrada com acerto de cache |
|---|---|---|---|---|---|
| Hy4 preview (Tencent) | 770B / 49B | 1M | $0.834 | $2.501 | $0.042 |
| DeepSeek V4 Flash | 284B / 13B | 1M | $0.22 / $0.44 | $0.66 / $1.32 | $0.007 |
| DeepSeek V4 Pro | 49B-class active | 1M | $0.66 / $1.32 | $1.98 / $3.96 | $0.022 |
| Qwen 3.8 Max | 2.4T / 95B | 1M | $2.00 | $6.00 | $0.25 |
| Kimi K3 | 2.8T / 104B | 1M | $3.00 | $15.00 | $0.30 |
| GLM-5.3 | não divulgado | n/d | $1.40 | $4.40 | $0.26 |
Duas ressalvas honestas se somam a isso. Primeiro, o Hy4 é cerca de 5-6x mais caro que o Hy3, então, se você já usa o Hy3, é um salto de custo real, não um desconto. Segundo, o DeepSeek V4 Flash continua dramaticamente mais barato nos dois medidores, e para muito trabalho agêntico "barato e bom o bastante" vence. Um desenvolvedor fez um teste real e disse isso sem rodeios:
even mimo 2.5 was same good and on 1/20 of the costs... the model is interesting if the price is lower but not for 2.5 USD per million output.
Se quiser testá-lo sem pagar, o Hy4 é gratuito por duas semanas no WorkBuddy e no CodeBuddy, e está listado no OpenRouter (com uma política de dados de retenção zero, um bom detalhe frente a algumas APIs próprias chinesas).
Então, para quem o Tencent Hy4 realmente serve?
Depois de alguns dias com ele e dos testes da comunidade, é aqui que eu chego.
Recorra ao Hy4 se você está construindo ferramentas agênticas de programação, automação de escritório ou pesquisa, quer especificamente pesos abertos e uma licença permissiva Apache 2.0, e tem o hardware (ou o orçamento de API) para rodar um modelo em escala de fronteira. As pontuações de programação e matemática são reais, a janela de contexto é enorme e o preço fica abaixo dos outros modelos abertos de ponta.
Pule se você roda modelos localmente em uma estação de trabalho (um modelo de nível Flash bem pós-treinado vai servir melhor com uma fração da memória), se o custo bruto por token é sua principal alavanca (o DeepSeek V4 Flash é muito mais barato) ou se você só quer o trabalho pronto e não se importa com qual modelo o faz.
Esse último caso é o que vejo com mais frequência, e vale ser honesto: a maioria das pessoas que pergunta "devo usar o Hy4?" na verdade não quer um modelo. Quer uma fila de suporte zerada, um blog escrito ou uma tarefa de pesquisa concluída. Um modelo bruto de 770B é um motor brilhante sem carro ao redor: você ainda precisa construir a recuperação de informação, as proteções, as integrações, as avaliações e a lógica de contingência antes que ele faça algo útil em produção. Essa é a lacuna entre um benchmark impressionante e algo que sobrevive a tráfego real, e é a parte em que passo o dia inteiro.
Experimente a eesel: contrate o colega, pule a infraestrutura do modelo
Do meu ponto de vista: modelos como o Hy4 são infraestrutura. A eesel AI é o funcionário. Em vez de escolher um modelo e ligar tudo ao redor dele, você contrata um colega de IA pronto para trabalhar numa função específica, e ele já chega sabendo como fazê-la.
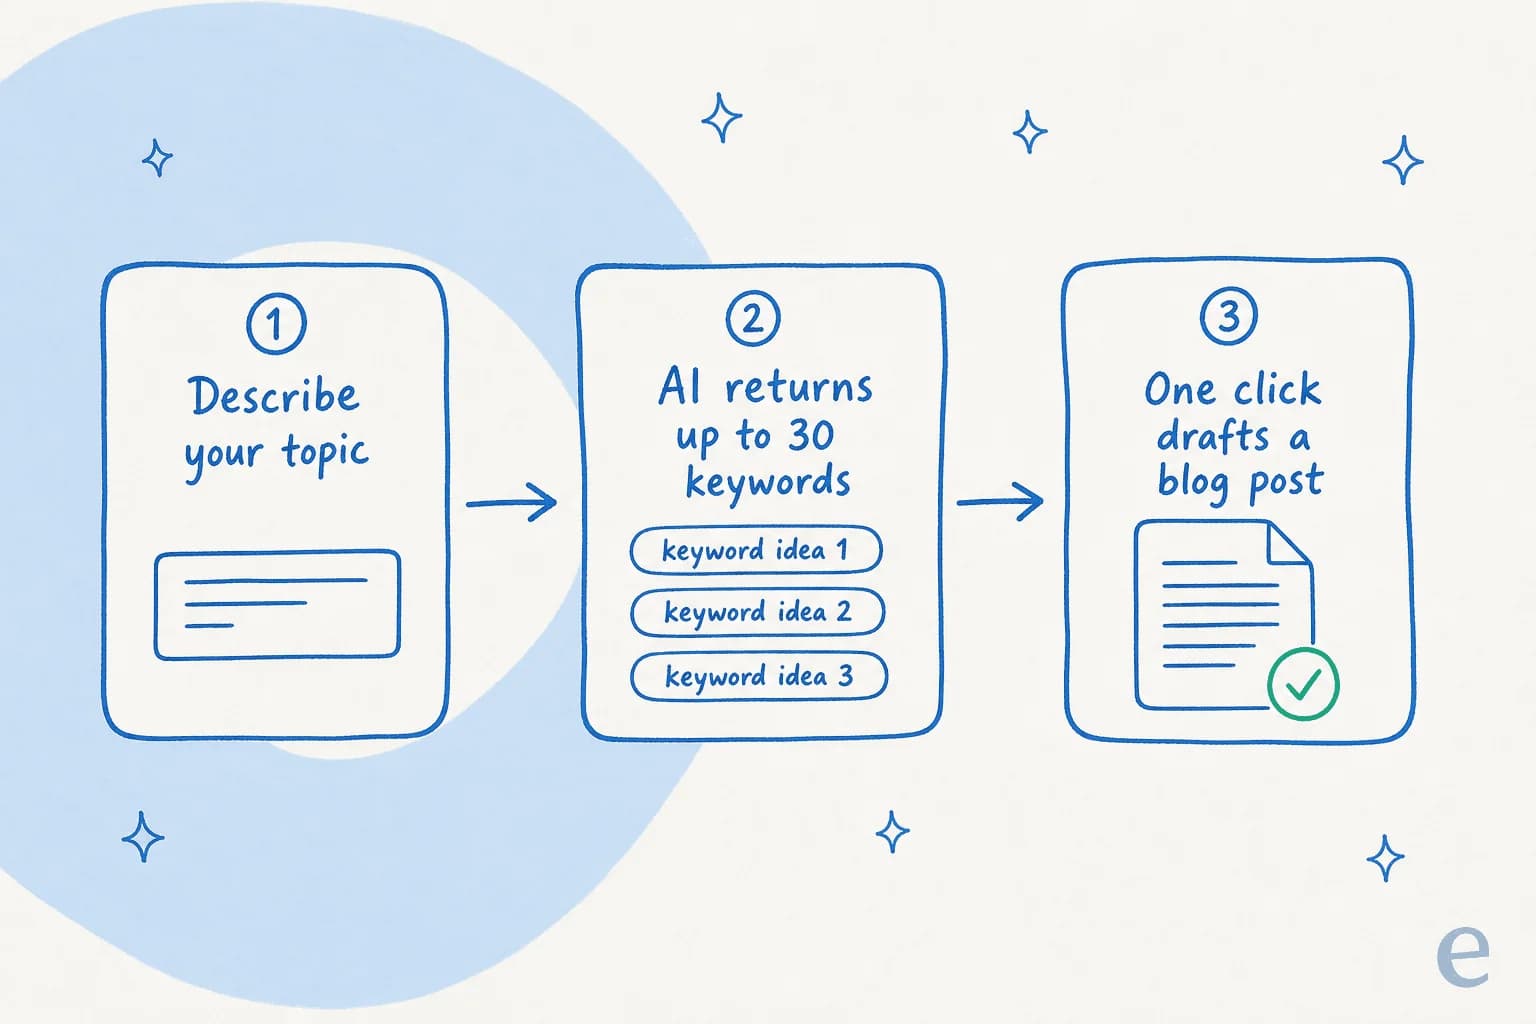
Hoje o time tem dois colegas. O colega de IA para helpdesk entra na sua fila existente no Zendesk, Freshdesk, Gorgias ou numa caixa de entrada compartilhada, treina com seus tickets antigos e sua central de ajuda, e redige ou envia respostas, e, o mais importante, você pode simulá-lo com seus tickets históricos antes que ele responda a qualquer cliente, para saber como ele vai se comportar em vez de apertar um botão e torcer. O redator de blog com IA faz a pesquisa, a escrita e o SEO de um post longo em uma única execução. Ambos rodam em modelos de ponta por baixo dos panos, então você obtém a capacidade de algo como o Hy4 sem provisionar uma única GPU. Você pode começar de graça, sem cartão de crédito e sem ligação de vendas.