As 8 melhores alternativas ao Tencent Hy4 em 2026

Rama Adi

Katelin Teen
Última edição August 30, 2026
Resumo
O Tencent Hy4 preview é um modelo de pesos abertos realmente forte: um lançamento de mistura de especialistas de 770B que corta o preço dos outros carros-chefe chineses e chega perto do topo dos modelos abertos na arena de código WebDev. O problema é que você provavelmente não consegue rodá-lo. É um modelo de mistura de especialistas, então só 49B parâmetros são acionados por token, mas todos os 770B ainda precisam estar na memória da GPU ao mesmo tempo, o que significa um servidor de oito GPUs. Ele também custa cerca de cinco a seis vezes mais que o Hy3 e ainda é uma prévia.
Então a pergunta real não é "o Hy4 é bom?" (é), e sim "qual modelo me dá resultados de nível Hy4 em um hardware e orçamento que eu realmente tenho?". Minhas escolhas:
- GLM-5.3-Flash - a melhor alternativa geral: 320B, nativamente multimodal e barato.
- DeepSeek V4 Flash - o piso de preço, com licença MIT e pequeno o bastante para hospedar por conta própria.
- GLM-5.3 - o mais próximo da qualidade do Hy4 (é o modelo contra o qual a Tencent se compara).
- Kimi K3 - o mais forte para execuções longas de código com agentes.
- Qwen 3.8 Max, DeepSeek V4 Pro, Claude Opus 5 e GPT-5.6 completam a lista para necessidades multimodais, de contexto longo e de zero infraestrutura.
Mais uma coisa: se o motivo de você querer um modelo é responder tickets de clientes, não precisa montar um sozinho. A eesel é um colega de IA para o helpdesk que já roda sobre modelos de fronteira, se conecta às suas ferramentas atuais e deixa você testar com tickets passados antes de entrar no ar.
Por que as pessoas estão olhando além do Hy4
Primeiro, sejamos justos com o Hy4, porque ele merece. A equipe Hunyuan da Tencent lançou um modelo aberto de fronteira de verdade: 770B parâmetros no total, 49B ativos, janela de contexto de 1M de tokens, pesos abertos no Hugging Face e um preço mais baixo que o do GLM-5.3, do Qwen 3.8 Max e do Kimi K3. No ranking Code Arena WebDev ficou por volta do #5, cerca de #3 entre os modelos abertos, um salto de +115 pontos sobre o Hy3. Se você tem o hardware, é uma escolha forte.
Aqui é onde complica, e é a parte com que lido toda semana construindo sobre esses modelos. Um modelo de mistura de especialistas economiza computação por token, não memória. O roteador só ativa 49B dos 770B parâmetros para cada token, então é rápido, mas os 770B inteiros ainda precisam estar carregados e residentes. Na prática, são cerca de 924GB de pesos na versão MXFP8, ou seja, um nó de oito GPUs da classe B300. Uma máquina com oito H100 (640GB) não comporta. A leitura da comunidade no r/LocalLLaMA chegou ao mesmo ponto: modelo incrível, impossível de rodar em casa.
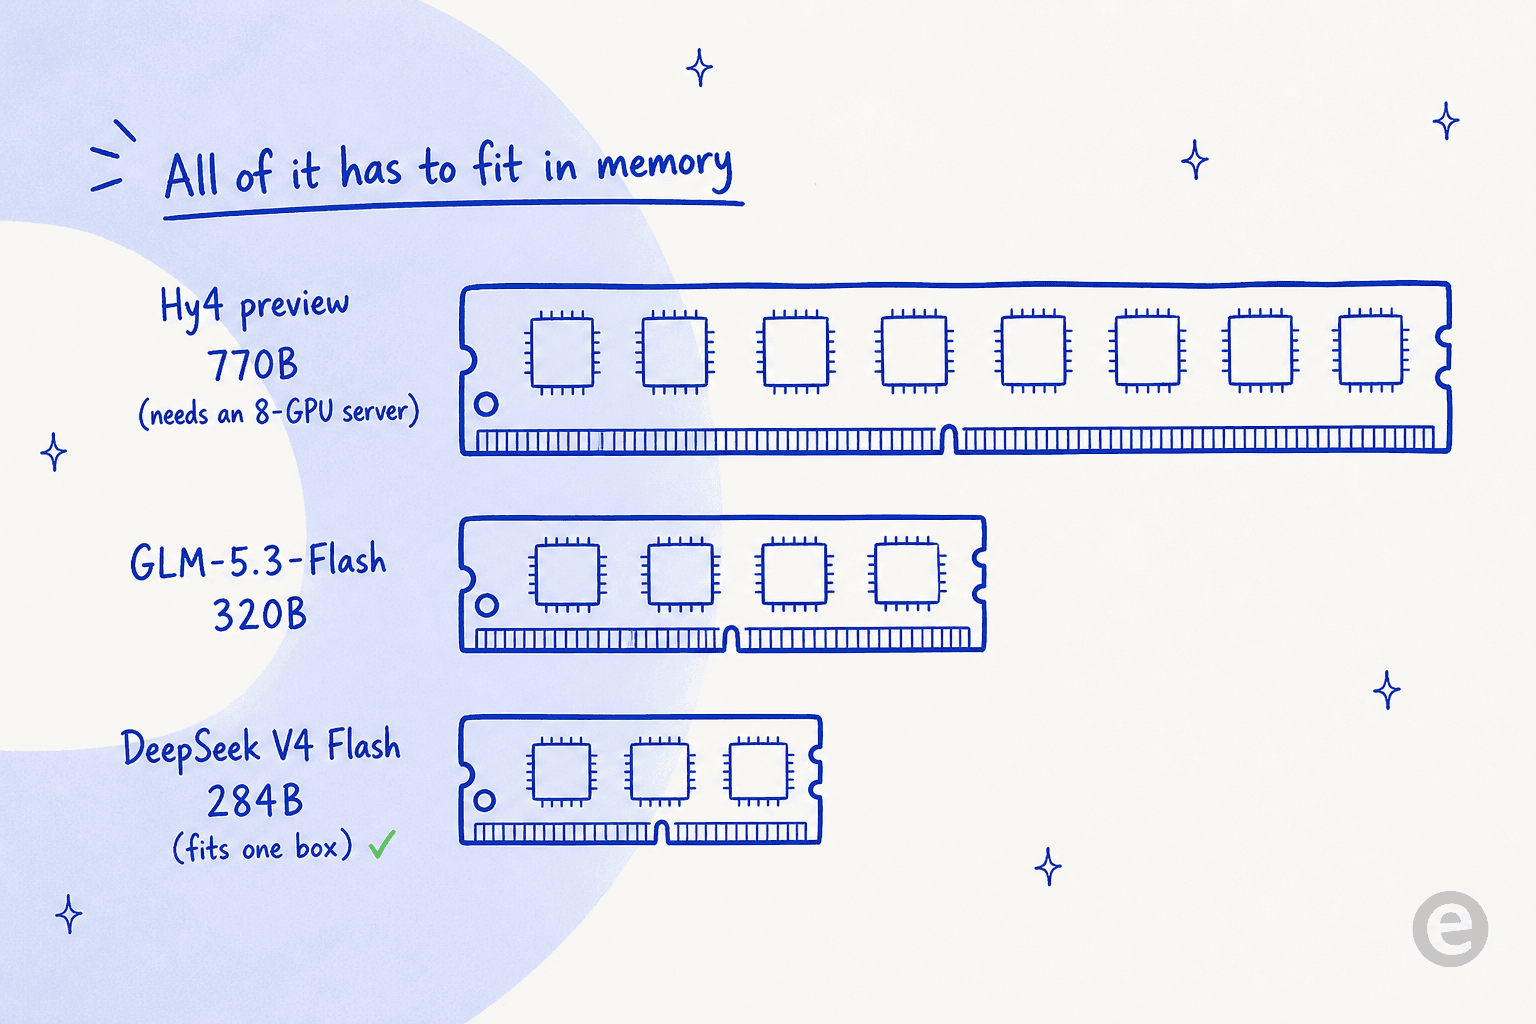
O segundo problema é o custo. O Hy4 corta o preço dos rivais carros-chefe, mas é um salto grande em relação ao modelo que ele substitui, então quem já usa o Hy3 enfrenta um aumento real na conta, mesmo parecendo barato ao lado do Kimi. E o terceiro é a maturidade: é uma prévia, e a própria Tencent observa que o modelo tende a raciocinar e verificar demais.
Nada disso faz do Hy4 um modelo ruim. Faz dele um modelo com um grupo restrito de pessoas que realmente conseguem implantá-lo. Para todos os outros, as alternativas abaixo levam você quase lá em um hardware que você pode pagar.
Como o Hy4 realmente se compara a essas alternativas
Antes de chegar às escolhas, vale ver o confronto direto. Esta é a grade de benchmarks da própria Tencent no lançamento, e a parte útil é que os rivais nela são exatamente os modelos desta lista: Qwen 3.8 Max, DeepSeek V4 Pro, GPT-5.6 Sol, GLM-5.3, Kimi K3 e Claude Opus 5.
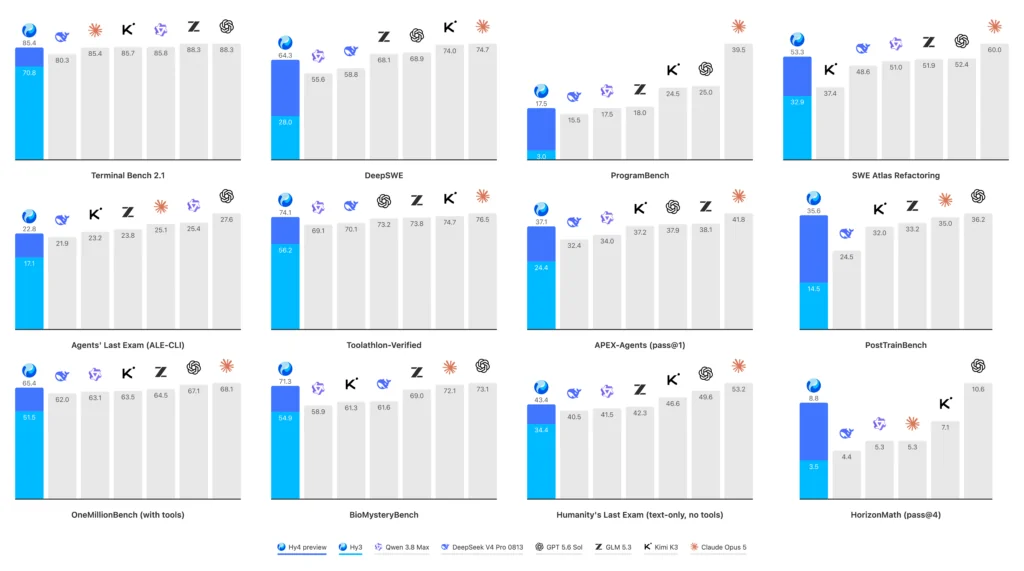
Duas ressalvas honestas. Primeiro, é o gráfico do próprio fornecedor, então leia como ponto de partida, não como veredito. Segundo, o Hy4 ainda não está no índice independente da Artificial Analysis, então não há uma pontuação de inteligência neutra para citar. A avaliação cega interna da própria Tencent colocou o Hy4 em 2,99/4,00 contra o Kimi K3 (2,94) e o GLM-5.3 (2,92), perto o bastante para a comunidade de CLI de código ler como um empate triplo, com o preço como a real vantagem do Hy4.
Como escolhi estes modelos
Eu construo as integrações e a parte técnica dos modelos na eesel, então escolher qual modelo rodar de fato em produção é boa parte da minha semana. Um número de ranking é a parte fácil. As perguntas que decidem na prática são: consigo comportar os pesos, quanto custa um mês real de tokens, a licença permite que eu lance um produto, e ele aguenta uma execução longa com agentes em vez de uma única resposta brilhante? Por isso ponderei assim:
- Facilidade de implantação - se uma equipe normal consegue rodar ou pagar de forma realista, não só uma gigante de nuvem.
- Preço por 1M de tokens - da tabela do próprio fornecedor, sinalizando promoções e peculiaridades de horário de pico/fora de pico.
- Licença e pesos abertos - se você pode hospedar por conta própria e o que pode fazer.
- Capacidade real - força em código e em agentes, não só uma nota de destaque.
Todo preço e especificação abaixo vem das páginas do próprio fornecedor, conferidas em 30 de agosto de 2026. Onde um número é um benchmark interno do fornecedor e não um independente, eu digo.
As alternativas em resumo
| Modelo | Melhor para | Parâmetros totais / ativos | Contexto | Entrada $/1M | Saída $/1M | Pesos abertos | Licença |
|---|---|---|---|---|---|---|---|
| GLM-5.3-Flash | Melhor opção geral | 320B / 18B | 1M | $0.075* | $0.25* | Sim | Aberta (HF) |
| DeepSeek V4 Flash | Menor preço | 284B / 13B | 1M | $0.22-0.44 | $0.66-1.32 | Sim | MIT |
| GLM-5.3 | Mais próximo do Hy4 | Não divulgado | 1M | $1.40 | $4.40 | Sim | Aberta (HF) |
| Kimi K3 | Código com agentes | 2.8T / 104B | 1M | $3.00 | $15.00 | Sim | "other" |
| Qwen 3.8 Max | Multimodal + ecossistema | 2.4T / 95B | 1M | $2.00 | $6.00 | Sim (base) | qwen3.8-max |
| DeepSeek V4 Pro | Recuperação em contexto longo | 49B de classe ativos | 1M | $0.66-1.32 | $1.98-3.96 | Sim | Aberta |
| Claude Opus 5 | Zero infraestrutura | Não divulgado | 1M | $5.00 | $25.00 | Não | Proprietária |
| GPT-5.6 | Níveis de API gerenciada | Não divulgado | Níveis de contexto longo | $0.20-5.00 | $1.20-30.00 | Não | Proprietária |
*O GLM-5.3-Flash está em uma promoção de lançamento de 50% ($0.15 / $0.50 de tabela) que termina em 9 de setembro de 2026. A DeepSeek mostra de fora do pico a pico; um horário dos EUA/UE costuma ser cobrado na tarifa mais baixa, fora do pico. Todas as tarifas conforme a página de preços de cada fornecedor, conferidas em 30 de agosto de 2026.
O padrão salta aos olhos quando tudo está lado a lado: os dois modelos "Flash" são uma ordem de grandeza mais baratos que o nível de fronteira, e as APIs fechadas (Opus 5, GPT-5.6) ficam no topo em preço, mas não pedem nada de você em troca. Aqui está a mesma imagem como preço de saída, que costuma ser a conta que realmente dói em um agente falante:
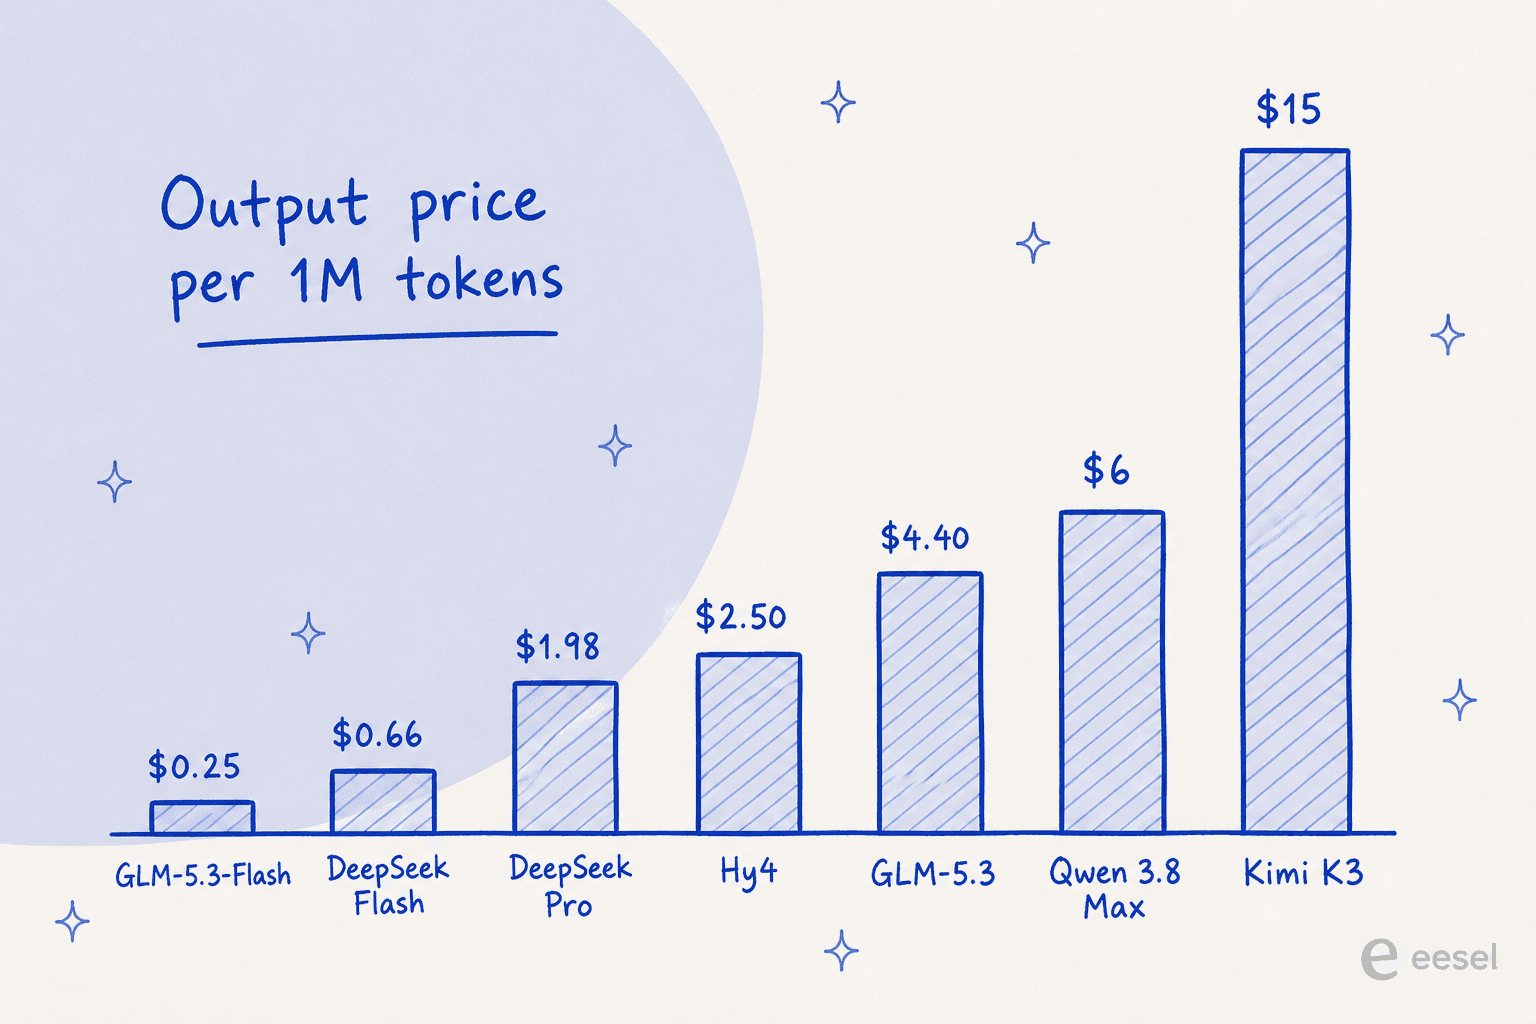
Se você não tem certeza de em qual canto do mapa se encaixa, esta ferramenta rápida leva você a uma escolha.
1. GLM-5.3-Flash
Melhor para: equipes que querem qualidade de nível Hy4 em um hardware que realmente consigam rodar, ao menor preço realista.
Este é o primeiro que eu escolheria. O GLM-5.3-Flash, da Z.ai (antiga Zhipu AI), é um modelo de mistura de especialistas de 320B com apenas 18B ativos, e é o primeiro modelo nativamente multimodal da linha GLM-5, lidando com texto, imagem e vídeo. O discurso da Z.ai é "inteligência de fronteira, custo flash", e os números sustentam a segunda metade: ele marca 57 no índice de inteligência da Artificial Analysis a cerca de $0.045 por tarefa com desconto, um nível que antes custava cerca de 10x mais.
O motivo de ele superar o Hy4 para a maioria é simples: com 320B no total, tem menos da metade do tamanho do Hy4, então é bem mais fácil de servir, e foi testado discretamente como "ox-alpha" no OpenRouter, onde virou o modelo mais usado da semana, tudo servido em chips chineses. No Code Bench da própria Z.ai ele chega a 29,0 contra 29,5 do Claude Opus 4.8, quase empate.
Prós: nativamente multimodal (texto, imagem, vídeo), pesos abertos no Hugging Face e, de longe, a melhor relação preço-capacidade desta lista.
Contras: as comparações de benchmark são da própria Z.ai, e o preço de destaque é uma promoção de lançamento. A Z.ai não publicou uma ficha completa de parâmetros e contexto de forma tão limpa quanto alguns rivais.
Preço: $0.075 de entrada / $0.25 de saída por 1M durante a promoção de lançamento de 50% (tabela $0.15 / $0.50), que termina em 9 de setembro de 2026. A entrada em cache custa $0.015. Também incluído no GLM Coding Plan a partir de $18/mês.
Veredito: se você só pode testar uma alternativa ao Hy4, que seja esta. É o raro modelo que é mais barato e menor e multimodal, e é o que eu indicaria a uma equipe que gostou do Hy4 mas não conseguia justificar o servidor de oito GPUs.
2. DeepSeek V4 Flash
Melhor para: o menor custo absoluto por token e a licença mais amigável à hospedagem própria do grupo.
O DeepSeek V4 Flash é o piso de preço, e a diferença é grande. É um modelo de mistura de especialistas de 284B com 13B ativos, publicado sob uma verdadeira licença MIT, e com cerca de 167GB de pesos é o único modelo de classe fronteira desta lista que uma equipe bem equipada consegue rodar em casa por menos de US$ 10 mil. Fora do pico, custa cerca de $0.22 de entrada / $0.66 de saída por 1M, aproximadamente um quarto da tarifa de saída do Hy4.
Há uma peculiaridade que vale conhecer: a tabela da DeepSeek é dividida por horário do dia, com o pico seguindo o horário comercial chinês (01:00-04:00 e 06:00-10:00 UTC). Uma fila de suporte dos EUA ou da UE roda principalmente na janela fora do pico da DeepSeek, então você tende a pagar a metade mais barata da tabela por padrão. A única crítica honesta é a verbosidade: testes independentes mostram que ele gasta bem mais tokens de saída que os rivais para chegar a uma resposta, então a economia por token diminui um pouco por tarefa.
Prós: o mais barato por ampla margem, licença MIT e pequeno o bastante para hospedar por conta própria.
Contras: prolixo (mais tokens de saída que os pares), e os termos da API paga da DeepSeek não dizem nada sobre uso para treinamento, em vez de declararem explicitamente que é seguro, com residência de dados na China. Isso importa se você envia dados de clientes pela API oficial.
Preço: entrada sem cache $0.22 fora do pico / $0.44 no pico; saída $0.66 / $1.32; entrada com acerto de cache a partir de $0.007, conforme a página de preços da DeepSeek.
Veredito: se o fator decisivo é a fatura, este é o seu modelo. Só reserve orçamento para a sua tagarelice e mantenha dados pessoais de clientes fora do endpoint oficial, a menos que tenha lido os termos com cuidado.
3. GLM-5.3
Melhor para: o mais próximo da qualidade real do Hy4, do modelo contra o qual a Tencent escolheu se comparar.
Quando a Tencent quis mostrar que o Hy4 era de classe fronteira, o GLM-5.3 foi um dos dois modelos que ela colocou ao lado dele, e o Hy4 só o superou por 2,99 a 2,92 na avaliação cega da própria Tencent. Em outras palavras, se você quer o modelo que mais se aproxima da qualidade real do Hy4, este é o candidato óbvio, e ele vem de uma linhagem com histórico sério em código de longo prazo (seu antecessor GLM-5.2 foi o primeiro modelo de pesos abertos a passar de 80% no Terminal-Bench).
Ele também é mais barato que o Hy4 na entrada e fica na mesma faixa na saída, então você não paga um prêmio por um modelo quase igual. A Z.ai não publica a contagem exata de parâmetros do GLM-5.3 de forma tão clara quanto alguns rivais, então deixo esse número de fora em vez de citar um agregador.
Prós: o rival com benchmark mais próximo do Hy4, pesos abertos, forte herança em código de longo prazo, 1M de contexto e endpoints compatíveis com OpenAI e Anthropic, então se encaixa nas ferramentas existentes.
Contras: a ficha pública da Z.ai especificamente para o 5.3 é pobre em parâmetros totais/ativos e, como o Hy4, é um modelo grande para hospedar por conta própria.
Preço: $1.40 de entrada / $4.40 de saída por 1M, entrada em cache $0.26, conforme a documentação de preços da Z.ai. Também disponível pelo GLM Coding Plan.
Veredito: se o seu objetivo é "me dê o Hy4, mas que eu consiga implantar sem as ressalvas da prévia", o GLM-5.3 é a troca mais segura. É a alternativa equivalente.
4. Kimi K3
Melhor para: execuções longas de código com agentes e muitas ferramentas, onde a profundidade importa mais que o preço.
O Kimi K3, da Moonshot AI, é o maior modelo aqui: 2.8T no total, 104B ativos, com 1M de tokens de contexto e pesos abertos que saíram no prazo. No índice de inteligência da Artificial Analysis ele está em 57, na faixa do #4 no lançamento, e é o modelo que o Hy4 vence com menos convicção nos números pareados da própria Tencent (o Hy4 ganha apenas 51,2% das vezes). Ele é realmente bom em sessões longas com agentes.
O que você precisa saber é que o Kimi K3 é caro e te compromete: o raciocínio não pode ser desligado em nenhum nível, e reduzir o esforço não o deixa mais barato (os níveis são cobrados à mesma tarifa). Com $3 de entrada / $15 de saída por 1M, está no território do Claude Sonnet, aproximadamente 23x a tarifa de saída do Hy4 sem cache. Ele se justifica em trabalho difícil e de várias etapas; para chamadas simples, é exagero.
Prós: capacidade de agentes e de código de nível fronteira, visão nativa, enorme contexto de 1M e pesos abertos no Hugging Face.
Contras: o modelo mais caro desta lista, sem como desligar o raciocínio, e não aceita URLs públicas de imagem (só base64 ou IDs de arquivo).
Preço: $3.00 de entrada / $0.30 com acerto de cache / $15.00 de saída por 1M, conforme a Moonshot. Os planos do app de consumo vão de um gratuito até $199/mês.
Veredito: recorra ao Kimi K3 quando a tarefa for uma execução de agente realmente difícil e longa e a qualidade for tudo. Para qualquer coisa rotineira, um dos modelos mais baratos acima faz o mesmo trabalho por um décimo da fatura.
5. Qwen 3.8 Max
Melhor para: trabalho multimodal e o ecossistema mais profundo entre os laboratórios chineses.
O Qwen 3.8 Max, da Alibaba, é um modelo de mistura de especialistas de 2.4T / 95B que chegou à disponibilidade geral no início de agosto, com 1M de contexto e entrada nativa de imagem e vídeo. Está no ranking da Artificial Analysis na posição 6 (índice ~58) e também é forte nos rankings de WebDev e visão da LMArena. O que o destaca do grupo é o ecossistema: a Qwen tem uma das maiores famílias de modelos abertos que existem, então há um irmão menor para quase qualquer orçamento, e o Max hospedado adiciona visão, modo sem raciocínio e ferramentas integradas sobre a base aberta.
Uma nota de justiça que sempre incluo: os pesos base totalmente abertos (Qwen3.8-2.4T-A95B) foram lançados, mas não equivalem em recursos ao Max hospedado, que adiciona a entrada de visão e o contexto padrão de 1M. E o membro permissivo com licença Apache da família é o menor Qwen3.8-27B, não o Max em si.
Prós: nativamente multimodal, família de modelos enorme e bem apoiada, um ecossistema real de ferramentas e pesos base abertos.
Contras: a licença do Max não é Apache, as versões hospedada e aberta diferem em capacidade e, com $6 de saída, é mais caro que as opções da GLM e da DeepSeek.
Preço: $2.00 de entrada / $6.00 de saída por 1M, cache implícito $0.25, conforme a QwenCloud.
Veredito: escolha o Qwen 3.8 Max se entrada multimodal e uma família ampla de modelos importam para você, ou se quer padronizar em um laboratório com muitos tamanhos de modelo. Em pura relação preço-capacidade, o GLM-5.3-Flash ainda leva vantagem.
6. DeepSeek V4 Pro
Melhor para: recuperação em contexto longo e busca de agulha no palheiro, onde o Flash menor tem dificuldade.
Se o DeepSeek V4 Flash é a escolha de orçamento, o DeepSeek V4 Pro é a escolha de recuperação. Ele roda mais parâmetros ativos (classe 49B) que o Flash, e isso aparece onde importa: na tabela entre modos da própria DeepSeek, o Pro lidera o Flash no SimpleQA-Verified (57,9 contra 34,1) e na busca de agulhas em 1M de contexto. O ranking de preferência humana da LMArena também continua colocando o Pro acima do Flash. É o modelo para quando o trabalho é ler um documento muito longo e extrair um fato preciso.
Há uma armadilha que aviso a quem roteia níveis de esforço: o mapeamento publicado pela DeepSeek atende uma requisição low no Pro como high, então não existe execução barata do Pro, você paga a tarifa cheia e não consegue reduzir o raciocínio. Se o controle de custos importa, é um motivo para ficar no Flash, a menos que precise especificamente da recuperação do Pro.
Prós: recuperação e busca em contexto longo mais fortes que o Flash, ainda com pesos abertos e com a mesma tarifa por horário que favorece agendas fora da China.
Contras: você não pode fazer uma requisição Pro barata de baixo esforço, e custa cerca de 3x a tarifa do Flash sem cache.
Preço: entrada sem cache $0.66 fora do pico / $1.32 no pico; saída $1.98 / $3.96, conforme a página de preços da DeepSeek.
Veredito: a maioria das equipes deve começar no Flash e só passar ao Pro para as cargas específicas (perguntas sobre documentos longos, recuperação precisa) em que o Flash claramente fica aquém. Não pague pelo Pro em tudo.
7. Claude Opus 5
Melhor para: equipes que querem qualidade de primeira linha e zero infraestrutura para rodar.
Aqui vai a reformulação honesta: para muitas equipes, a verdadeira alternativa a um modelo de pesos abertos de 770B não é outro modelo de pesos abertos, é não rodar nenhum. O Claude Opus 5 é o carro-chefe da Anthropic, está em #1 no índice de inteligência (por pouco, com 61-63 conforme o instantâneo) e não há nada para encaixar na memória. Você chama uma API e recebe uma resposta de fronteira.
A contrapartida é preço e abertura. Com $5 de entrada / $25 de saída por 1M, é uma ordem de grandeza mais caro que as opções de pesos abertos, e não há pesos para hospedar. A comunidade também aponta que o Opus 5 tende a gastar mais tokens de saída que o antecessor no mesmo esforço, então o custo por tarefa subiu mesmo com a mesma tarifa de tabela, embora o contra-argumento seja o custo por tarefa bem-sucedida. Não é a escolha barata; é a escolha sem complicação, no topo do ranking.
Prós: qualidade líder de fronteira, 1M de contexto sem sobretaxa de contexto longo e zero infraestrutura para rodar.
Contras: muito mais caro por token que os modelos abertos, pesos fechados e pode ser verboso com esforço alto.
Preço: $5 de entrada / $25 de saída por 1M (inalterado em relação ao Opus 4.8), com lote a 50% de desconto e leituras de cache a 0,1x, conforme a Anthropic.
Veredito: se o seu gargalo é tempo de engenharia e não orçamento de tokens, o Opus 5 é a resposta limpa. Você troca dinheiro por nunca mais pensar em GPUs.
8. GPT-5.6
Melhor para: uma API gerenciada com uma linha escalonada, para equilibrar custo e capacidade a cada chamada.
A outra resposta de API gerenciada é o GPT-5.6, e o ponto forte dele é a variedade. Em vez de um único preço, a OpenAI oferece uma escada: gpt-5.6-luna a $0.20 de entrada / $1.20 de saída por 1M para trabalho barato e de alto volume, gpt-5.6-terra a $2 / $12 no meio e gpt-5.6-sol a $5 / $30 no topo. Isso permite ajustar o modelo ao trabalho em vez de pagar tarifas de carro-chefe em toda chamada, uma alavanca realmente útil se o seu tráfego é uma mistura de pedidos fáceis e difíceis.
A única pegadinha estrutural para colocar na conta: a OpenAI cobra uma faixa de contexto longo com formato de 2x quando você cruza o limite de contexto, o mesmo padrão que a xAI usa (e que Anthropic e Google não usam). Então, se a sua carga usa muito contexto longo, a tarifa efetiva é maior que a de destaque. O GPT-5.6 Sol também fica logo atrás do Opus 5 no índice de inteligência, então é uma opção real de fronteira, não um substituto de orçamento.
Prós: uma linha escalonada que permite ajustar o custo por chamada, um ecossistema maduro de API e ferramentas e nenhuma infraestrutura para rodar.
Contras: pesos fechados, e a faixa de contexto longo mais ou menos dobra a tarifa em chamadas de contexto grande.
Preço: de $0.20 / $1.20 (luna) a $5 / $30 (sol) por 1M, com multiplicador de contexto longo, conforme a OpenAI.
Veredito: se você gosta da ideia de uma API gerenciada mas a tarifa fixa do Opus 5 parece pesada para o seu tráfego fácil, as faixas do GPT-5.6 são a escolha mais flexível. Só calcule a sobretaxa de contexto longo antes de se comprometer.
As duas famílias, em uma imagem
Dando um passo atrás, toda opção aqui cai em um de dois campos: pesos abertos que você pode rodar ou alugar barato, e APIs gerenciadas em que você não roda nada. Este mapa é como eu explicaria a escolha a um colega em dez segundos.
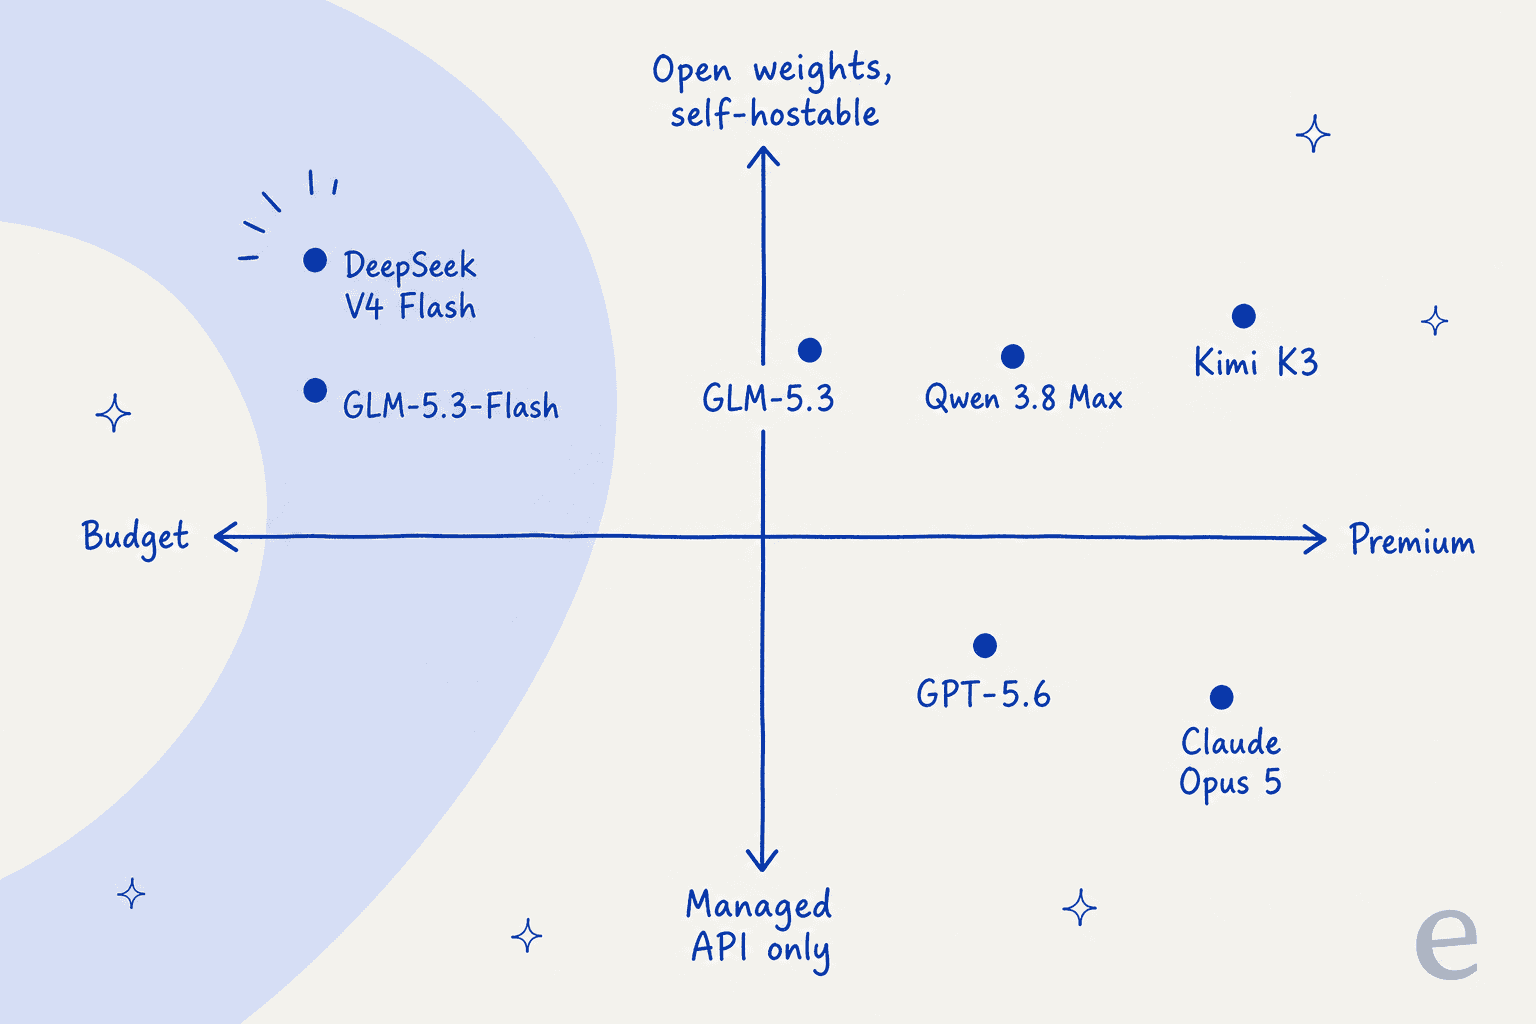
Se controle e custo foram o que afastou você do Hy4, fique na linha de cima, de pesos abertos, e comece com o GLM-5.3-Flash ou o DeepSeek V4 Flash. Se foi o esforço bruto de rodar um modelo de 770B, desça para a linha gerenciada e deixe a Anthropic ou a OpenAI carregarem a infraestrutura.
Experimente a eesel
Todo modelo desta lista tem uma coisa em comum: são infraestrutura bruta. Escolher o Hy4 ou qualquer alternativa é escolher um motor. Você ainda precisa construir o carro em volta: a conexão com a sua central de ajuda, as proteções, as integrações e alguma forma de testar antes de ele responder a um cliente real.
Se o motivo de você comparar modelos é o suporte ao cliente, a eesel pula toda essa construção. É um colega de IA para o helpdesk que já roda sobre modelos de fronteira, então você herda a qualidade do modelo sem nunca escolher, hospedar ou encaixar um na VRAM. Ela se conecta a ferramentas como Zendesk, Freshdesk e Slack, aprende com seus tickets passados e sua central de ajuda e, a parte que mais me importa como alguém que já viu bots confiantes darem respostas confiantemente erradas, deixa você simular com milhares dos seus tickets históricos reais antes de ela responder a qualquer pessoa ao vivo.

Então, se você chegou aqui comparando modelos para montar um agente de suporte, vale perguntar se você precisa do modelo ou do colega já pronto. Você pode experimentar a eesel de graça, e ela se conecta ao seu helpdesk atual em poucos minutos.