

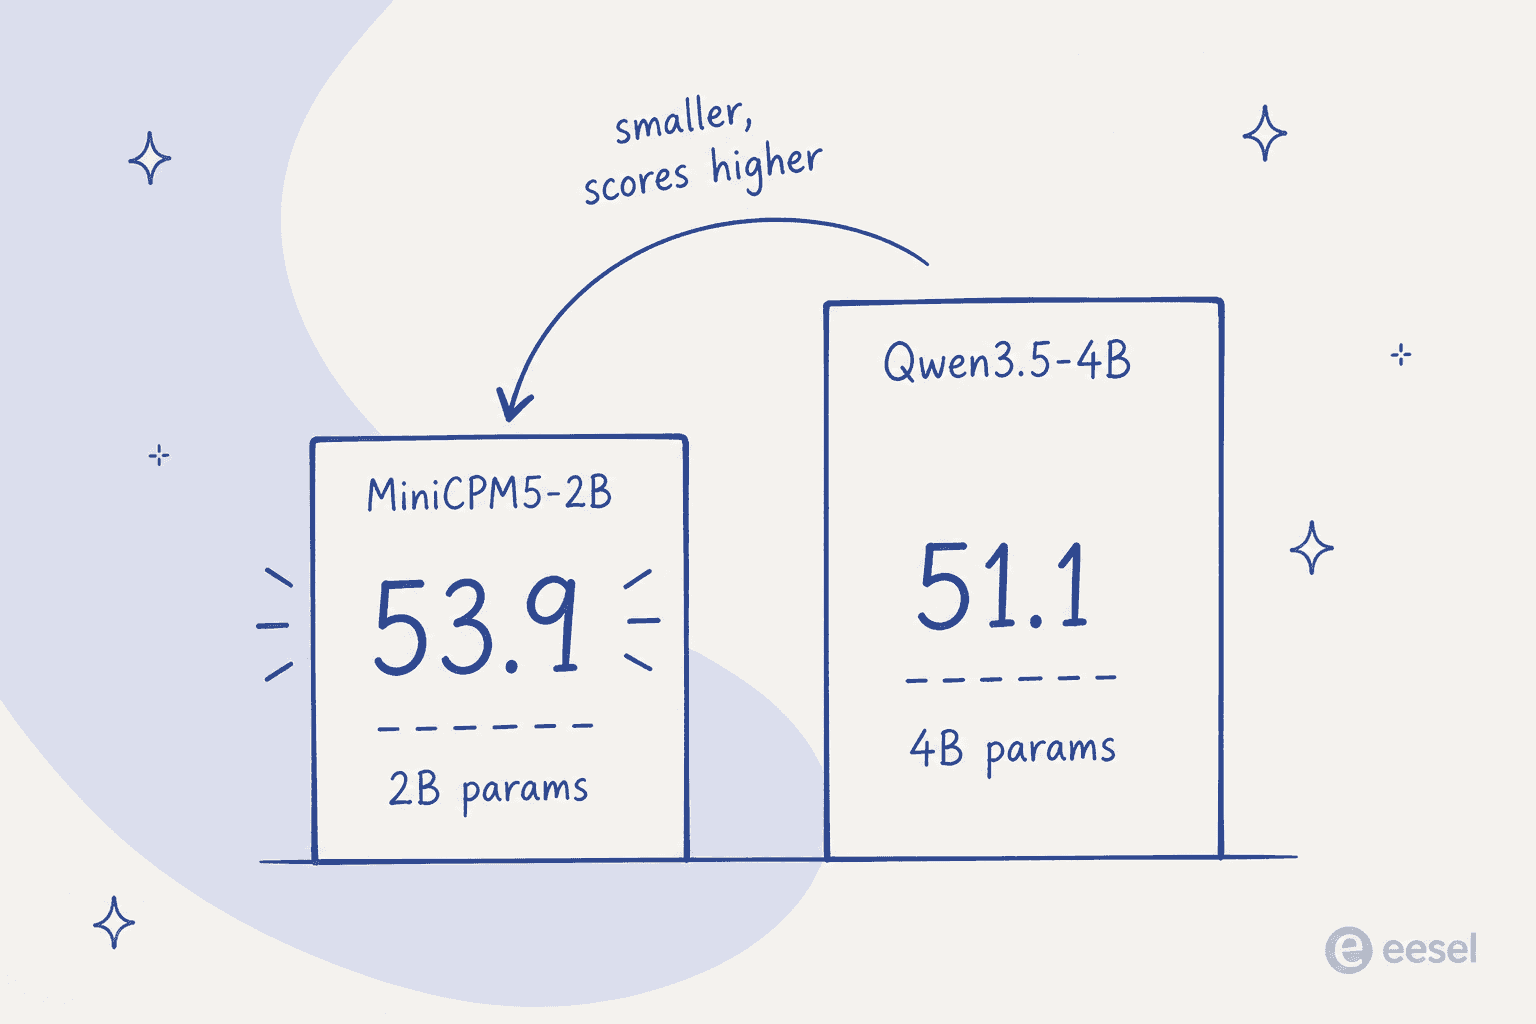
O MiniCPM5-2B é um novo modelo somente de texto, com 2,5 bilhões de parâmetros, da OpenBMB, feito para rodar no seu próprio hardware. A manchete é real: ele tem média de 53,9 em 34 benchmarks, o que a OpenBMB apresenta como o estado da arte open source da classe de 2B, e dentro do conjunto de comparação deles ultrapassa por pouco o melhor modelo de 4B, o Qwen3.5-4B com 51,1. Ele tem licença Apache-2.0, contexto nativo de 128K e roda em celulares, laptops e mini-PCs por meio de Ollama, llama.cpp, MLX e afins.
As ressalvas honestas: ele é somente texto, sem visão, só em inglês e chinês, e parte da comunidade desconfia de que suas vitórias em benchmarks sobrevivam ao contato com ambientes de programação reais. Há também uma discrepância pública na sua pontuação no Artificial Analysis Index (rastreadores independentes dizem 15, o próprio tuíte da OpenBMB diz 23).
Para quem importa: se você está construindo assistentes locais, ferramentas no dispositivo ou um agente enxuto e quer algo pequeno e de licença permissiva, o MiniCPM5-2B é um dos modelos abaixo de 4B mais interessantes do momento. Se você realmente precisa de uma IA que resolva tickets de suporte em produção, um modelo bruto é o nível errado, e explico por quê perto do final.
O que o MiniCPM5-2B realmente é
O MiniCPM5-2B chegou por volta de 6 e 7 de setembro de 2026 como o segundo modelo da linha MiniCPM5 da OpenBMB, depois do menor MiniCPM5-1B. A OpenBMB (também conhecida como ModelBest) lança há alguns anos modelos pequenos e eficientes, e esta linha gira em torno de uma única coisa: levar capacidade real para hardware de borda em vez de uma GPU de data center.
Estas são as especificações que importam, todas da ficha do modelo:
| Campo | Valor |
|---|---|
| Parâmetros | 2.516.756.480 (cerca de 2,52B) |
| Arquitetura | LlamaForCausalLM padrão, 42 camadas |
| Atenção | Grouped-query, 16 cabeças de consulta, 2 cabeças KV |
| Tamanho do contexto | 131.072 tokens (128K) |
| Licença | Apache-2.0 (pesos e repositório) |
| Modalidade | Somente texto, inglês e chinês |
| Formatos | BF16, mais GGUF, MLX de 4 bits, GPTQ de 4 bits |
Uma escolha de design faz muito trabalho silencioso aqui. O MiniCPM5-2B usa a arquitetura simples LlamaForCausalLM, de modo que, nas palavras da OpenBMB, os motores populares podem carregá-lo diretamente com "no custom kernels, no model-code fork." É por isso que ele saiu com suporte desde o dia 0 em vLLM, SGLang, llama.cpp, Ollama, LM Studio e MLX, em vez da espera usual de duas semanas até o ecossistema alcançar. Se você já tentou rodar um modelo aberto novo no dia em que ele saiu, sabe que essa amplitude desde o dia 0 não é garantida.
O outro número de destaque são os 128K de contexto, realmente grandes para um modelo tão pequeno, e os benchmarks de contexto longo (mais sobre eles abaixo) sugerem que não é apenas um número de ficha técnica que desmorona na prática.
Os benchmarks: um 2B consegue mesmo superar um 4B?
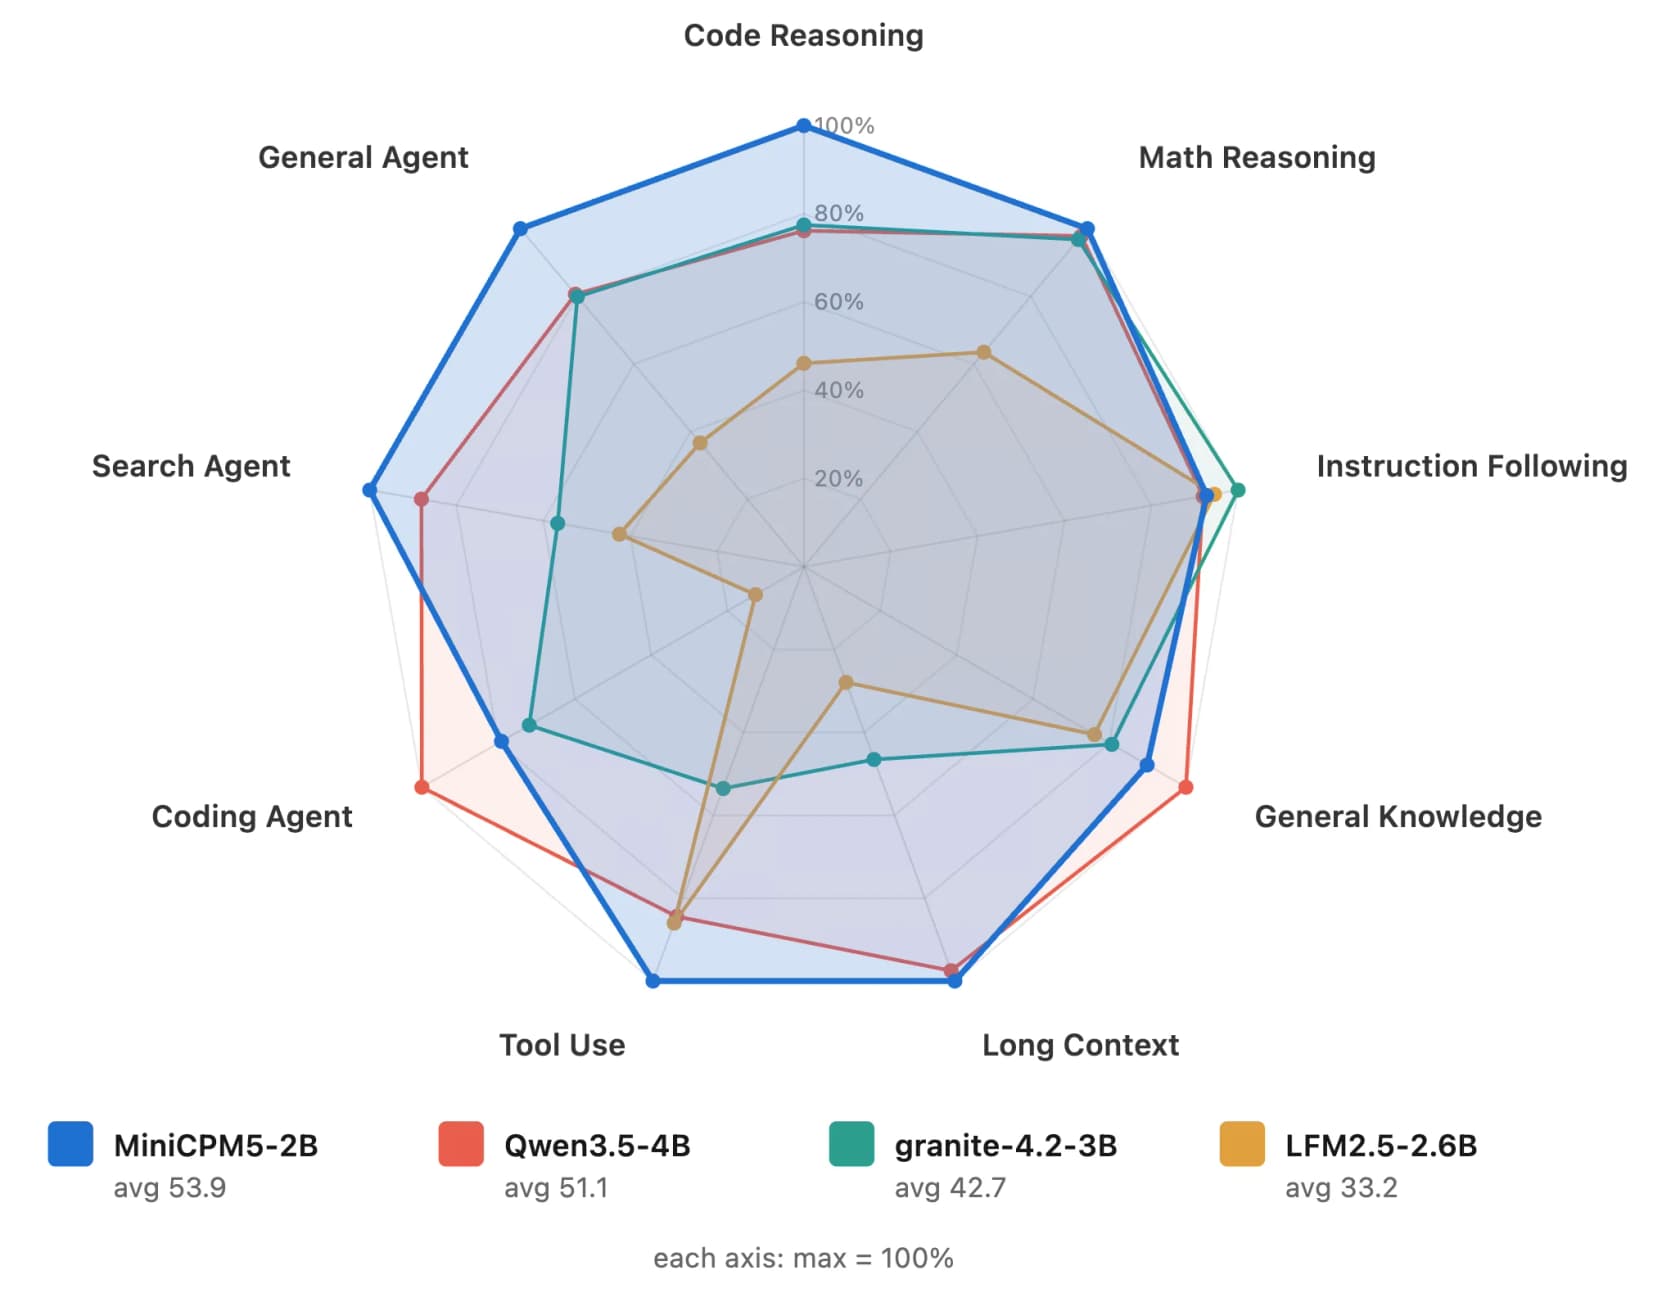
Essa é a afirmação a que todo mundo se agarrou, então vou colocar a tabela real na sua frente. Na suíte de 34 benchmarks da OpenBMB, o MiniCPM5-2B tem média de 53,9, à frente do Qwen3.5-4B com 51,1 e bem acima dos outros modelos da classe de 2B contra os quais foi testado.
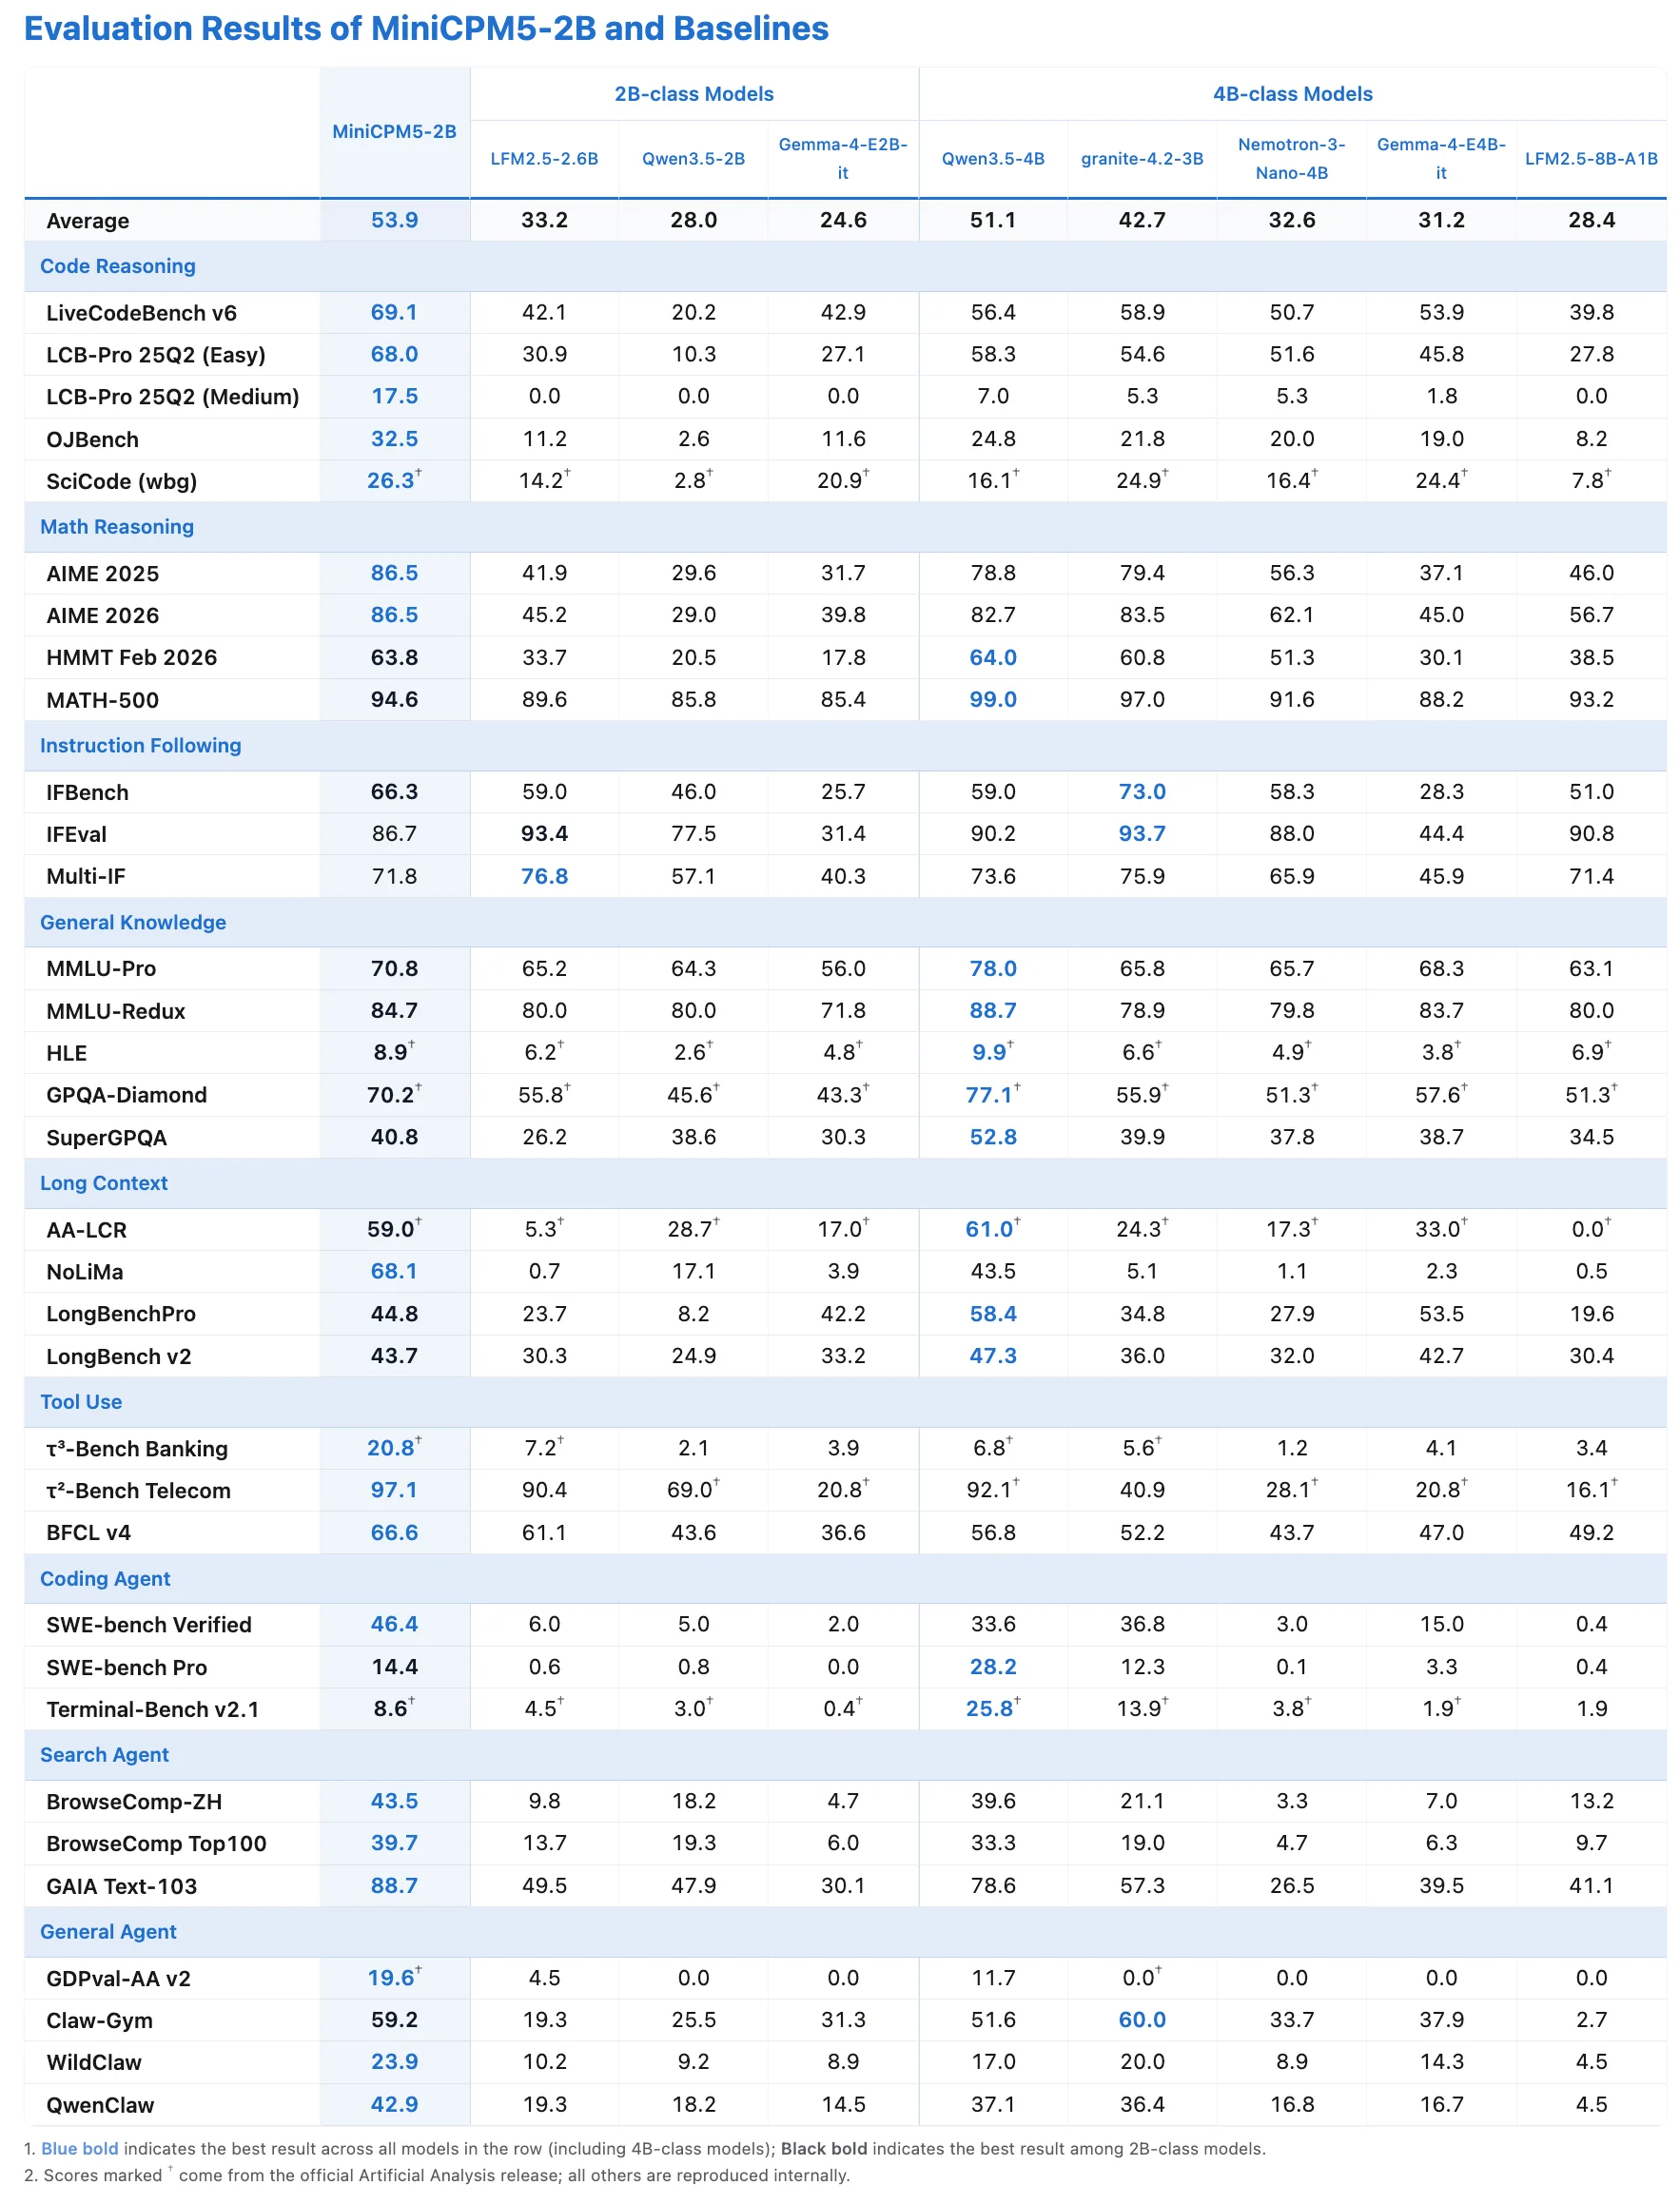
As linhas de destaque são onde fica interessante. Em matemática, ele alcança MATH-500 94,6 e AIME 2026 86,5. Em raciocínio de código, lidera a tabela com LiveCodeBench v6 69,1 e SWE-bench Verified 46,4, ambos acima do Qwen de 4B. Em uso de ferramentas, registra τ²-Bench Telecom 97,1 e BFCL v4 66,6, e do lado dos agentes de busca o GAIA Text-103 chega a 88,7. Para um modelo que você pode rodar em um laptop, esses números de agentes e uso de ferramentas são a parte surpreendente.
Duas coisas para manter com honestidade. Primeiro, este é o conjunto de comparação da própria OpenBMB, então o "supera o 4B" é verdadeiro dentro dos modelos e benchmarks que eles escolheram, não uma afirmação universal. O Qwen de 4B ainda vence várias linhas de conhecimento e contexto longo (MMLU-Pro 78,0, GPQA-Diamond 77,1). Segundo, há uma discrepância real no número de terceiros. O tópico de lançamento no r/LocalLLaMA e a submissão no Hacker News relatam ambos um Artificial Analysis Intelligence Index de 15, "the highest of any open weights model at 4B parameters or below." Já o próprio tuíte de lançamento da OpenBMB afirma pontuação 23 mais 20 no Agentic Index. Isso não bate nas fontes que consegui checar, provavelmente por diferença de versão ou de arredondamento, então eu confiaria no 15 independente como o número conservador e trataria o 23 como o número do fornecedor.
Mais uma nuance que vale apontar: a OpenBMB não publica as pontuações clássicas de MMLU, GSM8K ou HumanEval que as pessoas procuram por instinto. A ficha usa uma suíte mais nova (MMLU-Pro, LiveCodeBench, SWE-bench e assim por diante), então, se você compara com a ficha técnica de um modelo mais antigo, não vai achar uma linha limpa para comparação direta.
Como um modelo de 2B ficou tão bom
A parte que acho mais interessante não é a pontuação, e sim a receita de treinamento que a produziu, porque ela explica por que um modelo de 2B rende acima do seu tamanho em vez de soar como marketing.
A versão final não é uma única execução de treinamento. Depois do treinamento base e intermediário nos conjuntos de dados UltraData da OpenBMB, a etapa de pós-treinamento faz ajuste fino supervisionado e depois aprendizado por reforço com professores especializados em matemática, código, tarefas agênticas e escrita, usando o algoritmo JustRL II. O truque inteligente é o último passo: a destilação on-policy funde 16 modelos especialistas separados (incluindo 5 especialistas agênticos) no único lançamento de 2B por meio de KL reversa de vocabulário completo entre aluno e professor. Em termos simples, eles treinaram um banco de especialistas e depois comprimiram as habilidades deles de volta em um único modelo pequeno.
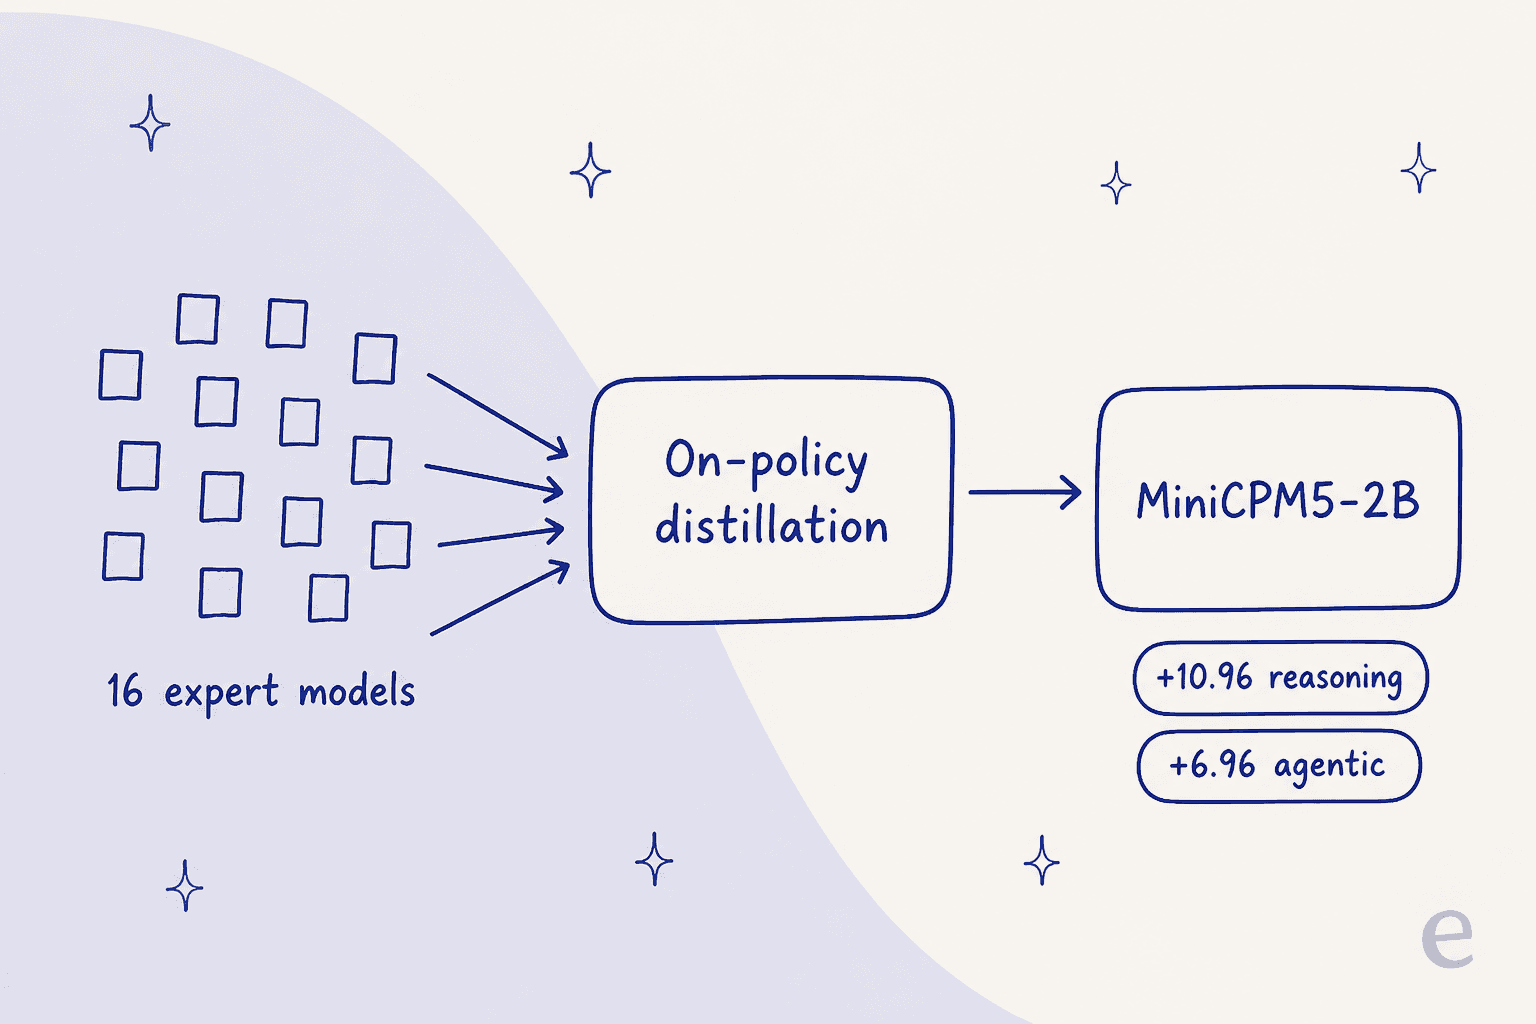
Segundo a ficha do modelo, essa etapa de RL mais destilação elevou os benchmarks de raciocínio e gerais em média 10,96 pontos e as tarefas agênticas em 6,96 pontos em relação ao checkpoint só com SFT. É um salto grande para uma passada de pós-treinamento e é o mecanismo por trás da história de "modelo pequeno, pontuação grande". Se você quer entender como os modelos pequenos modernos estão sendo construídos, vale ler essa receita com atenção.
Rodando: onde o MiniCPM5-2B se encaixa
Como usa uma arquitetura padrão, colocar o MiniCPM5-2B para rodar é refrescantemente sem graça, o que é um elogio. A ficha do modelo traz um comando de uma linha do vLLM:
pip install "vllm>=0.21"
vllm serve openbmb/MiniCPM5-2B --port 8000
Se você se importa com chamada de ferramentas, o SGLang é o backend recomendado: o modelo emite chamadas de ferramentas no estilo XML e o parser embutido minicpm5 do SGLang as converte em tool_calls compatíveis com a OpenAI. Há também um modelo rascunho DSpark para decodificação especulativa, se você quiser saída mais rápida sem mudar os resultados. Para laptop e celular, as versões GGUF e MLX de 4 bits rodam com Ollama, LM Studio, llama.cpp e MLX, e a OpenBMB também afirma adaptação desde o dia 0 para chips Intel, Arm e Rockchip, com cerca de 1,7x de ganho em prefill e 1,2x em decode em hardware móvel Arm SME2.
As demonstrações de vazão no dispositivo são onde ele deixa de ser uma ficha técnica. Um testador rodou 32 subagentes concorrentes em um único DGX Spark com média de 931 tokens por segundo e pico de 1.364, tudo no modelo de 2B. A OpenBMB recompartilhou outra execução rodando em um MacBook de 16 GB, chamando busca na web e resumindo resultados inteiramente no dispositivo. São os tipos de carga que um modelo compacto e rápido destrava e que um modelo gigante na nuvem não alcança em latência ou custo.
O que as pessoas estão realmente dizendo
A recepção no r/LocalLLaMA, o lar natural do público para modelos como este, foi na maior parte encantada:
"Hot damn. Very promising."

Mas duas linhas de crítica apareciam o tempo todo, e ambas são justas. A primeira é a falta de suporte a visão, que claramente incomodou o público local:
"Sad that there is no vision though. Having to switch to Lfm2.5-vl-3b for it is a bummer"
A segunda é um ceticismo saudável sobre se as pontuações de ranking se traduzem em trabalho útil. Sobre a demonstração de vazão, uma resposta foi direta:
"you get some likes here, but useful code? I don't think so"
E um testador prático relatou que ele falha quando operado por um ambiente de programação real, o que ele atribuiu à versão quantizada de 2B mais o drafter. Essa é a lição recorrente com modelos pequenos: vencer um benchmark não é o mesmo que ser um agente confiável, e a lacuna aparece justamente quando você o liga a um loop de ferramentas real.
As limitações honestas
Para reunir as ressalvas em um só lugar, porque uma análise justa as nomeia com clareza:
- Sem visão nem áudio. Este checkpoint é somente de texto. O multimodal vive na linha separada MiniCPM-V, então tarefas com imagem significam rodar um segundo modelo.
- Apenas inglês e chinês. Testadores da comunidade confirmaram o escopo de idiomas, então não é um modelo amplamente multilíngue.
- Os benchmarks superam os relatos do mundo real. As falhas com o ambiente de programação citadas acima são o que você deve testar por conta própria antes de construir sobre ele.
- Uma discrepância pública de pontuação. A diferença de 15 contra 23 no Intelligence Index não foi resolvida, e números executados pelo fornecedor sempre merecem uma sobrancelha levantada.
- A adoção na primeira semana ainda é pequena. A ficha do modelo mostrava 2.879 downloads na primeira semana, então os testes de estresse da comunidade estão só começando.
Nenhuma delas o afunda. Elas apenas o situam: o MiniCPM5-2B é um excelente modelo de borda para pesquisa e entusiastas, e uma base promissora para ferramentas no dispositivo, e não um cérebro pronto para produção.
Modelo versus colega de equipe: o que um modelo de 2B pode e não pode fazer pelo suporte
Aqui está o reenquadramento que me importa, já que muita gente lendo uma análise de modelo está discretamente se perguntando se poderia apontar algo assim para a sua fila de suporte.
Um modelo bruto é um ingrediente, não uma refeição. O MiniCPM5-2B te dá pesos e uma ficha de benchmarks forte. Para transformar isso em algo que um cliente toca, você ainda precisa hospedá-lo, instruí-lo, conectá-lo ao seu helpdesk, alimentá-lo com o seu conhecimento, dar ferramentas a ele, adicionar proteções e testá-lo para que ele não dê com confiança uma resposta errada. É um projeto de engenharia de verdade, mais próximo de construir um agente de IA do que de escolher um bom modelo. É a mesma lacuna que eu apontaria se você estivesse olhando para o MiniCPM5-2B, um modelo Qwen ou um endpoint da OpenAI: o modelo é infraestrutura, e o trabalhador de verdade é tudo o que você constrói por cima dele.
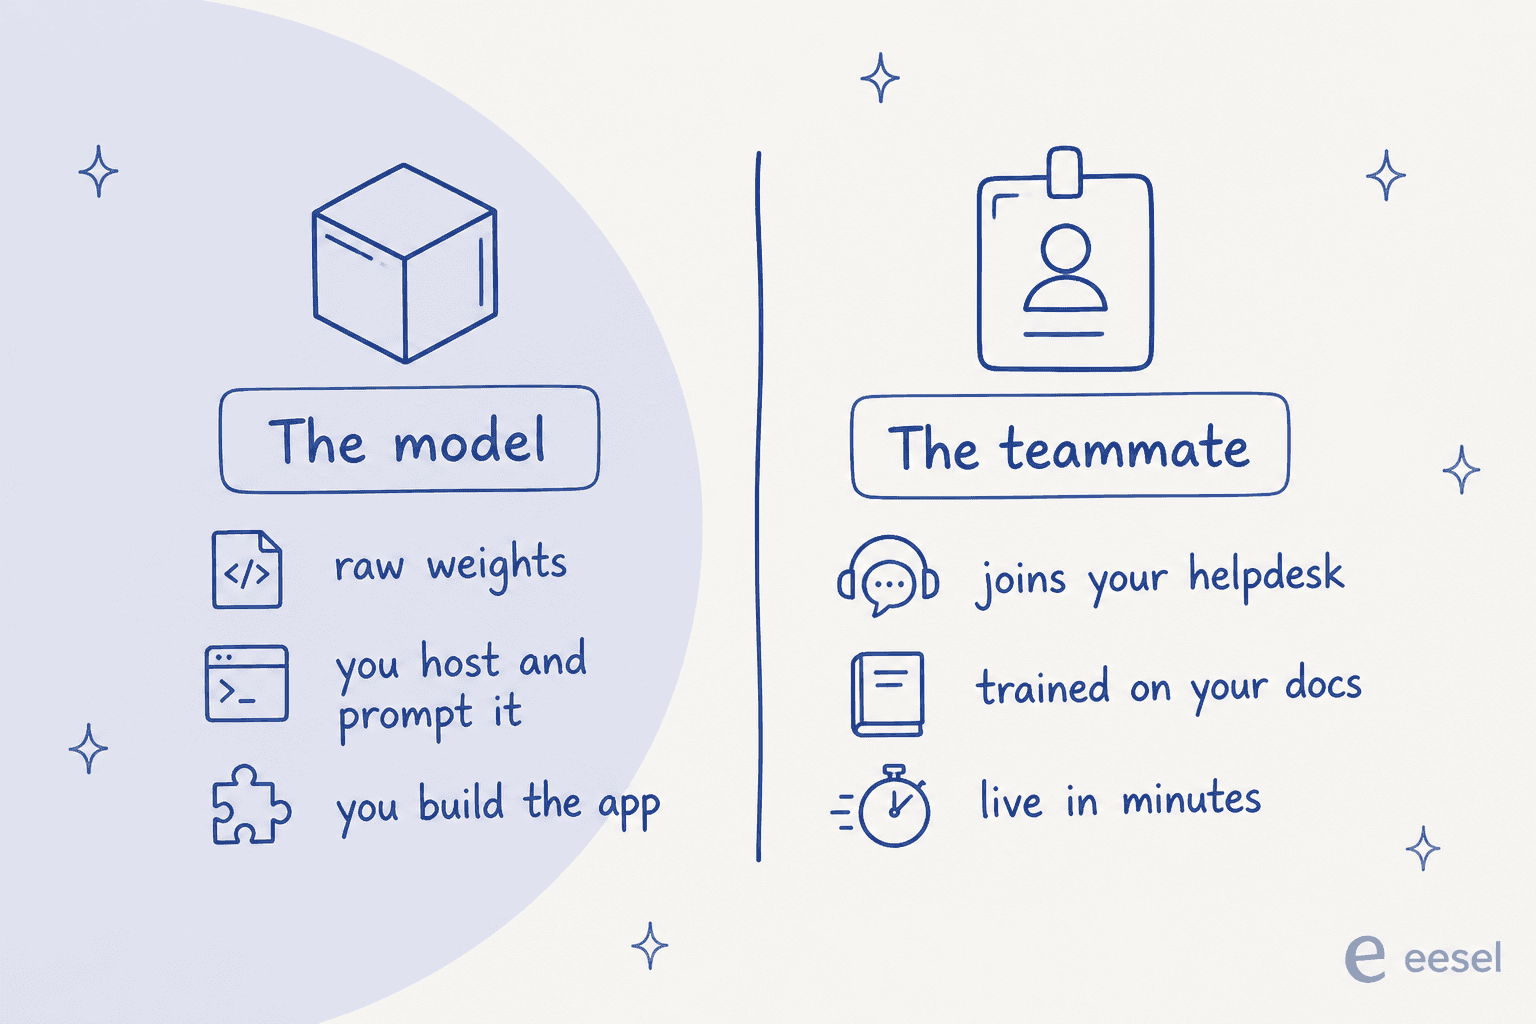
Essa distinção é a razão de existir da eesel. Em vez de te entregar um modelo para conectar, ela entrega um colega de equipe de IA pronto para trabalhar em uma função específica, e o seu colega de equipe de IA para helpdesk já vem com as integrações, o contexto da empresa e as ferramentas de suporte embutidos. O trade-off é real e vale deixar claro: você não roda os seus próprios pesos no seu próprio laptop como faz com o MiniCPM5-2B. O que você recebe em troca é algo que responde tickets reais em minutos em vez de meses.
Experimente a eesel para suporte com IA
Se o seu motivo para ler uma análise de modelo de 2B era "isso poderia ajudar a minha equipe de suporte", a resposta honesta é que um modelo sozinho não ajuda, mas o colega de equipe de IA construído em cima de um pode.
A eesel se conecta ao helpdesk que você já usa (Zendesk, Freshdesk, Gorgias, Help Scout e mais), treina nos seus tickets e documentos anteriores e pode entrar no ar em minutos. A parte que eu não pularia: ela pode ser simulada com os seus tickets históricos antes de tocar em qualquer conversa ao vivo, para você ver exatamente como ela teria respondido a clientes reais. Essa é a disciplina de "testar antes de confiar" que os céticos do modelo acima ficam pedindo, embutida no produto. E para o pessoal de terminal e scripts que gostou do ângulo no dispositivo do MiniCPM5-2B, a eesel também oferece um CLI e suporte a MCP, para que uma pessoa, um script ou um agente de programação como Claude Code ou Cursor possa operar o mesmo colega de equipe sem abrir o painel.
Você pode experimentar a eesel de graça, sem cartão de crédito e sem conversa com vendas, e ter um colega de equipe respondendo tickets antes de você terminar de montar a sua própria infraestrutura de inferência.