

O que conta como feedback para um agente de suporte?
Feedback para um agente de suporte é qualquer sinal que mostra como uma resposta foi recebida e o que fazer diferente da próxima vez. A maioria das equipes pensa na planilha de pontuação de QA, mas ela é uma de cinco fontes, e geralmente a mais lenta.
| Fonte | Quem dá | Com que rapidez chega | Para que serve |
|---|---|---|---|
| Notas em tickets ativos | Agente sênior ou líder de equipe | De minutos a horas | Corrigir uma resposta antes ou logo depois de enviada |
| Revisões de QA | Analista ou líder de QA, em uma planilha de pontuação | De dias a semanas | Consistência na equipe, identificar padrões |
| Comentários de CSAT do cliente | O cliente | De horas a dias | Tom e resultado, nas palavras do cliente |
| Métricas | O relatório do helpdesk | Semanal | Tendências: tempo de atendimento, taxa de reabertura, resolução |
| Autoavaliação e avaliação entre pares | O próprio agente ou outro agente | Quando for agendada | Desenvolver julgamento, compartilhar o que funciona |
Eu trabalho na fila de suporte da eesel todos os dias, e o feedback que mudou a forma como escrevo respostas quase nunca veio de uma pontuação. Veio de alguém que deixou uma nota num ticket que eu tinha acabado de responder, enquanto eu ainda lembrava por que tinha escrito daquele jeito.
Esse é o quadro para o resto deste guia: cada fonte tem seu trabalho, e os problemas começam quando uma equipe espera que a mais lenta faça todos.
Por que a maior parte do feedback para agentes de suporte não muda nada?
Pergunte aos agentes sobre feedback e você ouvirá as mesmas quatro reclamações, repetidamente. Nenhuma delas é "meu gestor foi direto demais".
Chega tarde. Uma revisão de QA escrita duas ou três semanas depois do ticket pede ao agente que se lembre de uma conversa da qual já teve cem outras desde então. Até lá, o hábito já se repetiu dezenas de vezes.
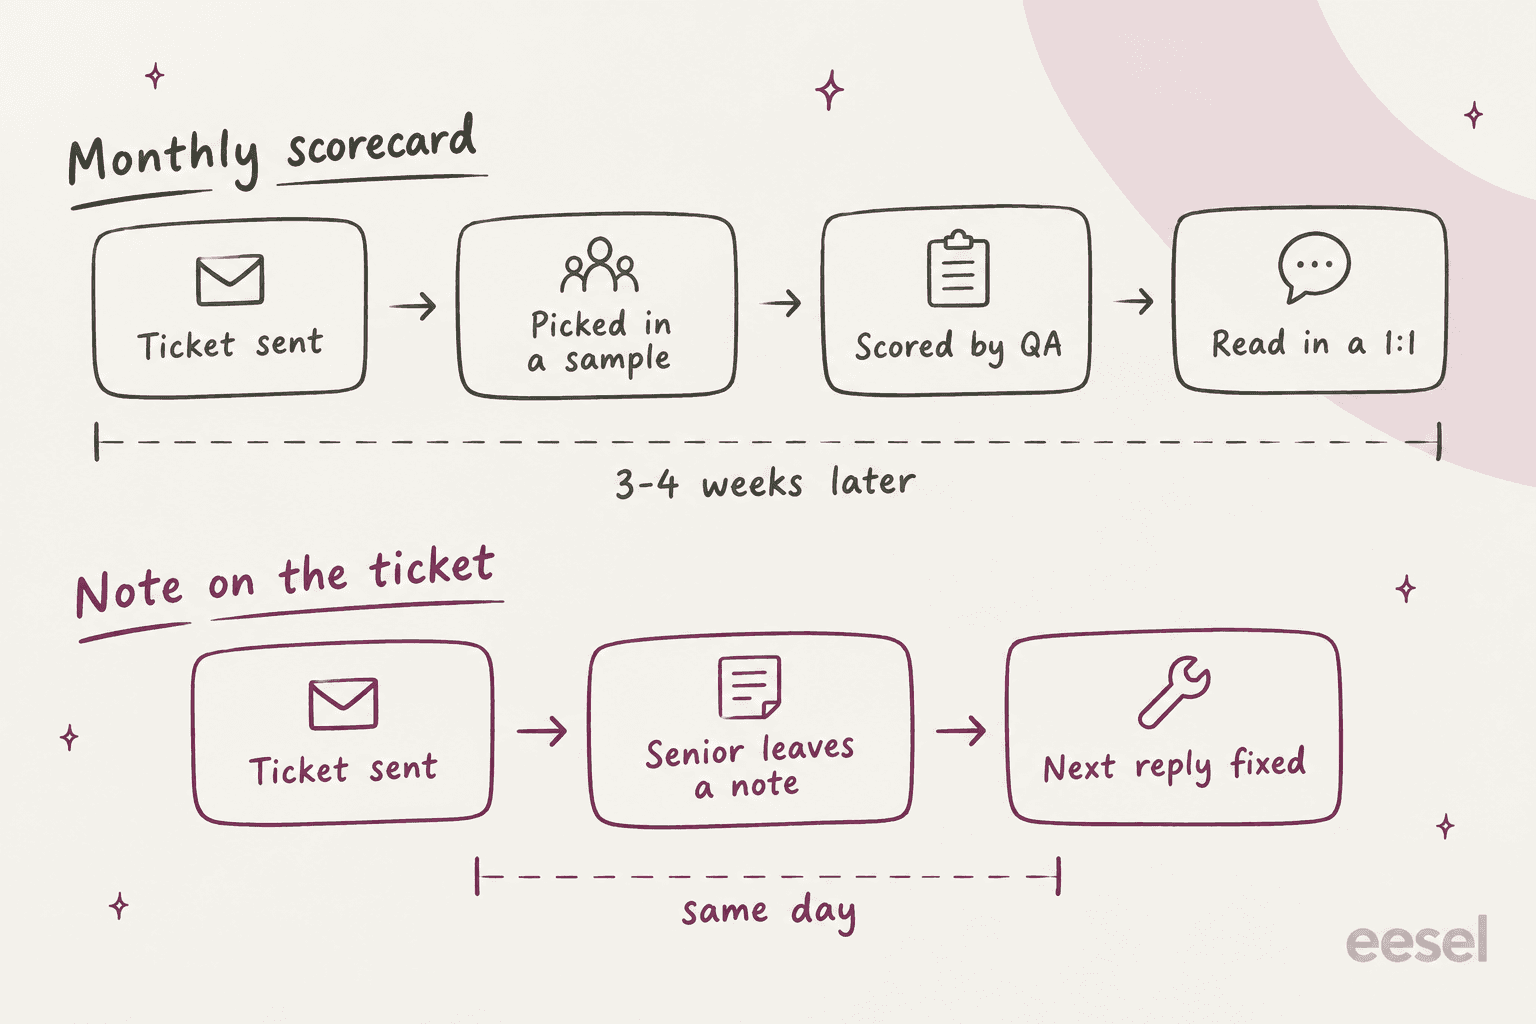
É uma pontuação sem conversa. Este é o grande. Uma porcentagem diz ao agente que algo deu errado, nunca o que fazer no próximo ticket.
"I've gotten the same QA scores for weeks now. I haven't reviewed a single call with my boss yet and I've been graded on 8 or 9 calls. She's sent out a copy of the QA agent rubric sheet for two or three of them - the rest, no detail at all. But with no info on account and no call review or coaching on it, I really can't process the percentage score."

A amostra é pequena demais para ser justa. Quando um revisor lê dois tickets por mês por agente, um ticket ruim vira a história toda. Um agente tirou zero numa ligação que de resto foi perfeita porque o cachorro latiu: "Out of hundreds of calls, they got the one where he barked!" Outro apontou que os revisores pulam os tickets difíceis e pontuam os curtos que qualquer um acerta, o que premia exatamente os agentes errados.
A planilha de pontuação mede a coisa errada. Os agentes aprendem o que você realmente valoriza pelo peso dos critérios, não pelo pôster de valores na parede.
"I did tech support, only 30% of our score was actually fixing the user's problem. 70% was getting the opening/closing right, bullshit empathy statements, positive responses about being able to fix the problem (even when I couldn't because it was a misroute that I'd have to transfer), offering to send the knowledge article you were using, etc.."
Métricas usadas como feedback têm a mesma falha, só que mais alto. No Hacker News, um ex-agente de call center descreveu uma equipe tão focada na duração média das ligações que era "common practice" irritar clientes de propósito para que pedissem um supervisor e a ligação pudesse ser transferida. Outro descreveu uma ligação de tradutor que durou quase uma hora e o único feedback no dia seguinte, na versão dele, foi "your handle time is too high." Ele saiu em uma semana.
A boa notícia é que os agentes têm clareza sobre o que querem no lugar. Um frequentador do r/callcentres passa todo feedback por três perguntas: é objetivo, é justo e é construtivo? Se o revisor "can't give practical advise", ele é descartado. É uma régua melhor para gestores do que a maioria dos slides de treinamento.
O ritmo do feedback: diário, semanal, mensal, trimestral
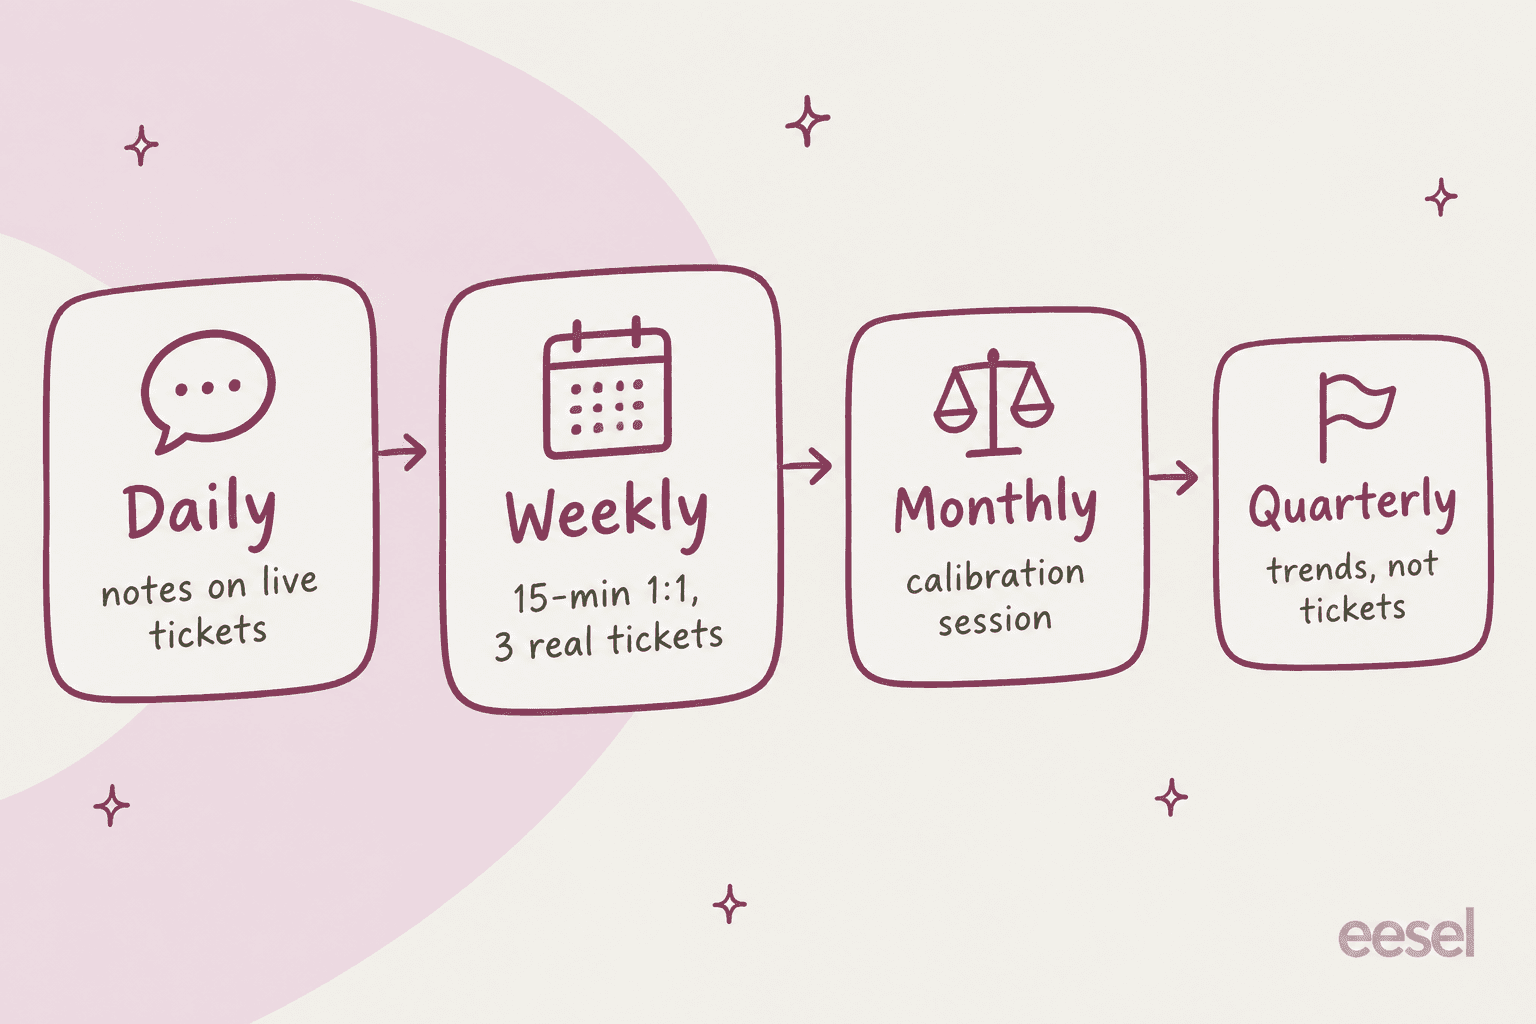
A solução para um feedback tardio e raso não é mais QA. É colocar cada tipo de feedback na cadência em que ele realmente funciona. Este é o ritmo que eu montaria para uma equipe de cinco a 50 agentes.
Diário: notas em tickets ativos
Esta é a camada que ensina a maior parte, e a que a maioria das equipes não formaliza. Um sênior ou líder lê um punhado de respostas por dia e deixa uma nota interna curta no ticket: o que funcionou, ou a única coisa a mudar. Para agentes novos, vá um passo antes e revise as respostas antes de serem enviadas.
Um líder de suporte no Hacker News descreveu exatamente isso: agentes novos acompanham os especialistas e, quando o líder os considera prontos, respondem tickets "reviewed by a senior before sending," segundo essa discussão. É o feedback mais barato que você vai dar, porque chega enquanto o agente ainda tem o problema do cliente na cabeça. Meu guia de onboarding mostra como configurar esses acessos só de notas em cada helpdesk.
Todo helpdesk faz isso com ferramentas pelas quais você já paga. Os threads privados do Freshdesk, as notas do Help Scout, as notas internas do Gorgias e os comentários do Front notificam quem você @menciona (detalhes por ferramenta na tabela mais abaixo).
Semanal: uma 1:1 de 15 minutos sobre três tickets reais
Escolha três tickets da semana do agente: um que ele tratou bem, um que deu errado e um que ele mesmo escolhe. Leiam juntos. Pergunte o que ele faria diferente antes de dizer qualquer coisa.
Três tickets é o número certo. Um parece um veredito sobre um dia ruim; dez viram uma palestra. Leve também os comentários de CSAT, porque as palavras do cliente pesam diferente das de um revisor.
"It sounds like your boss is really letting you down. A big part of their job is to help you perform better. When I worked the floor I'd have a weekly meeting with my boss and we'd go over my surveys then."
Mantenha a proporção honesta. Uma líder de QA de despacho do 911 disse no Reddit que dá "a lot of positive and supportive feedback as well as coaching feedback." Se toda 1:1 é uma lista de erros, os agentes param de trazer os tickets sobre os quais têm dúvida. Para a redação, meu post de exemplos de feedback de QA tem redações de antes e depois por critério da planilha de pontuação.
Mensal: calibre os revisores, não os agentes
Quando três revisores dão três pontuações diferentes ao mesmo ticket, os agentes percebem, e toda pontuação depois disso fica suspeita. Um agente contou que leu o roteiro palavra por palavra e mesmo assim recebeu "3 different scores" de três revisores.
A calibração é a solução. Todos pontuam separadamente o mesmo lote pequeno, depois vocês se reúnem e concordam sobre a resposta certa. A versão mais concreta que encontrei veio de um ex-líder de equipe de qualidade:
"Every month we'd pick a random call, all score separately, then get together and decide the correct score for each quality point. Whatever we all decided on, we had to be within 3% of that score (and certain elements had to be 100% on point)."
O Zendesk QA tem sessões de calibração embutidas, com uma revisão-base para comparar. Duas ressalvas que vale conhecer: a calibração não envia notificações, então o líder precisa avisar os revisores de que existe uma sessão, e os agentes não veem nada dela. Ambas são escolhas de design razoáveis, mas coloque você mesmo a sessão no calendário.
Trimestral: tendências, não tickets
A conversa trimestral é onde as métricas entram, e só como tendências. "Sua taxa de reabertura caiu de 9% para 5% desde março" é útil. "Você teve um tempo de atendimento alto no dia 14" não é. Meus exemplos de avaliação de desempenho e o guia de KPIs mostram quais números se sustentam.
Se você quer um guia de escolha para saber onde vai um feedback específico, esta é a versão que mantenho fixada:
Onde este feedback deve ir?
Escolha a situação. Você recebe o canal, o momento e uma frase que pode adaptar.
- "Uma coisa rápida: este cliente está no plano anual, então o prazo de reembolso é de 30 dias, não 14. Pode enviar um acompanhamento corrigindo?"
- Se a política também está confusa na central de ajuda, corrija o artigo na mesma sessão.
- Pergunte primeiro: "Como você acha que este cliente se sentiu ao ler sua resposta?"
- Depois mostre uma frase reescrita, não um e-mail reescrito.
- Atualize a macro, o artigo de ajuda ou as instruções da IA que continuam produzindo o erro.
- "Atualizei a macro de envio, então você não precisa mais lembrar da exceção."
- "Sua taxa de reabertura subiu de 5% para 9% em seis semanas. Vamos puxar três tickets reabertos e ver o que eles têm em comum."
- Nunca traga um único dia ruim como métrica.
- "Esta resposta ao ticket de cobrança duplicada agora é o modelo. Clara, curta, e respondeu à próxima pergunta antes de ela ser feita."
- Elogio em público funciona como treinamento para todos os outros.
Como dar feedback que os agentes realmente possam usar
O ritmo decide quando. Estes cinco hábitos decidem se o agente sai sabendo o que fazer diferente.
- Ancore cada ponto em um ticket real. "Seja mais empático" não significa nada. "No ticket 4182, o cliente disse que foi cobrado duas vezes; sua primeira linha foi direto para os passos do reembolso" é algo que o agente consegue visualizar e corrigir.
- Uma coisa por conversa. Se há cinco problemas, escolha o que mais custa ao cliente. Os outros quatro podem esperar uma semana, e o agente vai de fato lembrar do um.
- Pergunte antes de dizer. "O que você mudaria aqui?" Metade das vezes o agente percebe sozinho, e o feedback a que a pessoa chega por conta própria fixa melhor do que o recebido.
- Diga por que importa para o cliente. "Confirme o número do pedido" é uma regra. "Confirme o número do pedido, porque dois dos tickets reabertos da semana passada foram reembolsos enviados para o pedido errado" é um motivo.
- Separe coaching de avaliação. Uma 1:1 que termina com "e por isso você está em 72%" torna toda conversa futura defensiva. Guarde a pontuação para a avaliação; deixe a 1:1 para o próximo ticket.
Eu acrescentaria mais uma para quem gerencia uma equipe mista de agentes novos e experientes: não julgue os novatos na segunda semana com a mesma planilha de pontuação. Uma líder de equipe no Reddit, reagindo a uma turma de contratados dispensada após 10 dias com uma meta de 80%, disse de forma simples: "10 days is nothing." Meu guia de tempo de adaptação mostra os prazos que as equipes realmente veem.
Deixe os agentes responder: contestações e autoavaliações
Um sistema de feedback sem forma de discordar é um sistema de notas. Os agentes sabem a diferença, e as histórias de contestação no r/callcentres são uma lição sobre o que dá errado.
Um agente contestou uma pontuação de 95,5%, o gestor concordou, e a revisão voltou com 90,25% e cerca de oito "new errors found," escreveu o agente. Outro disse que as contestações de pesquisas ruins eram "almost always ignored for months," e depois negadas, segundo o comentário dele. E alguém notou que uma pontuação tinha mudado em silêncio depois de um recurso bem-sucedido, sem nenhuma mensagem: "an acknowledgment of it would be nice."
Compare com o som de um processo que funciona:
"If there's a problem with one of my scores and I feel I have a reason to dispute we have a process, but I've never even had to use it because the scorer just looks at it and either clarifies in a way that makes sense to me or changes it because they agree with me. They are reasonable, and not retaliatory, even the semi cranky ones. That's how adults behave at work."
As regras que fazem a diferença são simples: um motivo por escrito do agente, um prazo de resposta definido, uma decisão explicada em qualquer caso e uma notificação quando for resolvida. Um revisor do outro lado acrescentou uma de que gosto: quando o QA erra, "we own up to it and award the points back and issue an apology," como um revisor de QA colocou.
O Zendesk QA incorpora quase tudo isso ao produto. O agente abre a revisão, escolhe quem recebe a contestação, pode sugerir novas pontuações por categoria e precisa escrever um comentário explicando o porquê. O destinatário aceita, aceita parcialmente ou rejeita, os dois lados são notificados e não há limite de contestações por revisão, segundo a documentação de contestação do Zendesk QA.
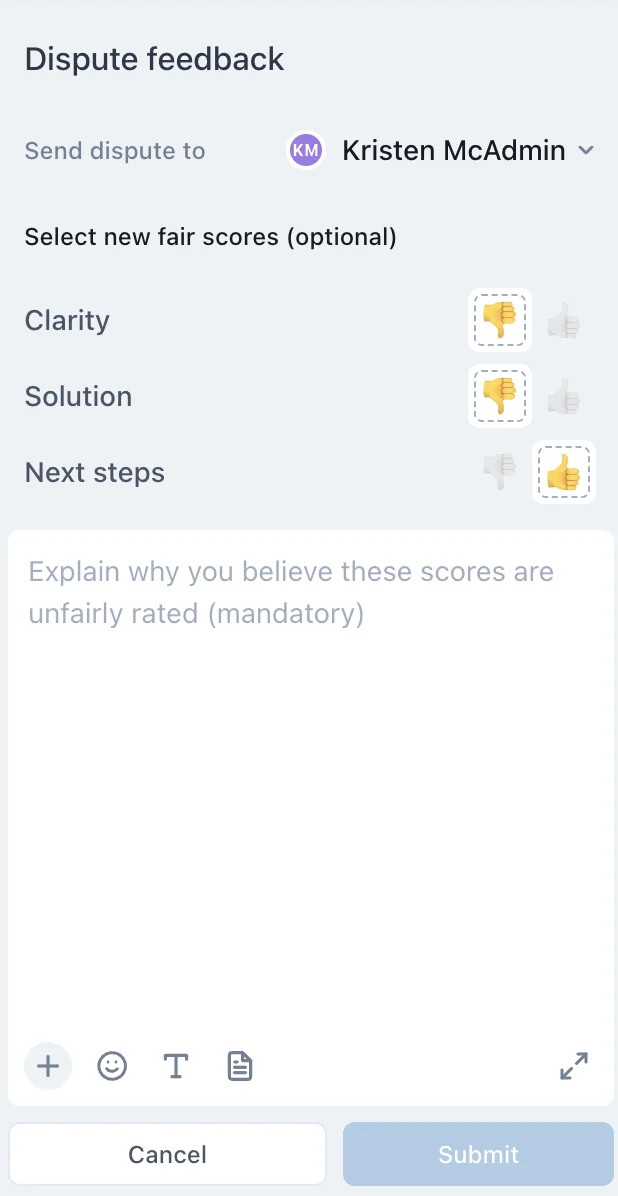
Há também um painel de contestações com o tempo médio de resolução em dias e uma tabela de quais revisores são mais contestados, um jeito discreto de identificar um revisor que precisa de calibração. O MaestroQA (agora Rippit) chama sua versão de recursos, com a opção de um líder de equipe revisar o recurso primeiro, e o Scorebuddy dá aos agentes um processo de "request a review" a partir do painel deles.
As autoavaliações são a metade subestimada. O Zendesk QA permite ativar autoavaliações por workspace, para que os agentes pontuem as próprias conversas na mesma planilha. Faça uma por mês ao lado da pontuação do revisor, e a diferença entre os dois números costuma ser um tema de 1:1 melhor do que qualquer um deles sozinho.
Onde o feedback vive no seu helpdesk
Aqui fica prático, e aqui encontrei as maiores surpresas na documentação dos fornecedores. Nem todo helpdesk deixa os agentes verem suas próprias pontuações de qualidade, e os complementos de pontuação com IA são deliberadamente cautelosos sobre como suas pontuações são usadas.
| Ferramenta | Onde o feedback é escrito | Agente notificado? | Caminho de contestação | Auto / avaliação entre pares | Pontuação com IA | Preço |
|---|---|---|---|---|---|---|
| Zendesk QA | Comentários de revisão (hashtags, @menções), sessões de coaching, pins | Sim, por e-mail ou Slack, de imediato a mensal | Sim: novas pontuações, comentário obrigatório, aceitar / parcial / rejeitar | Ambas, mais calibração | AutoQA, 8 categorias do sistema | Complemento de $35/agente/mês, anual |
| Front Smart QA | Planilha de pontuação com IA na barra lateral, substituição pelo admin com comentário, comentários internos | @menções sim; nenhum alerta específico de QA documentado | Nenhum documentado | Não documentada | 15 critérios padrão, até 10 personalizados | $20/assento/mês, incluído no Enterprise |
| Gorgias Auto QA | Pontuações de IA no ticket; líderes editam; notas internas | Notas sim; agentes não veem as pontuações de QA | Nenhum | Não documentada | 3 critérios automáticos, 4 manuais | Exige assinatura do AI Agent |
| Freshdesk | Notas privadas e threads privados com @menções | Sim, e-mail ao responsável e participantes | Nenhum módulo de QA encontrado | Nenhuma encontrada | Nenhuma encontrada | Threads em todos os planos |
| Help Scout | Notas com @menções | Sim, Notification Station mais e-mail opcional | Nenhum módulo de QA encontrado | Nenhuma encontrada | Nenhuma encontrada | Notas em todos os planos |
| MaestroQA / Rippit | Notas por rubrica, sessões de coaching com tarefas | Não confirmado publicamente | Sim, recursos com aprovação opcional do líder | Programa de avaliação entre pares | AutoQA | Rippit Free, $185, $495/mês |
| Scorebuddy | Planilhas de pontuação com feedback do avaliador, sessões de coaching | Painéis do agente em tempo real | "Request a review" | Pontuação entre pares e calibração | 500 ou 1.000 pontuações de IA/mês | Somente sob cotação |
Alguns detalhes dessa tabela merecem ser explicados, porque mudam como você conduziria o feedback em cada ferramenta.
O Zendesk QA acompanha se os agentes leem o feedback. O painel de Reviews informa Unseen reviews, a parcela de revisões manuais que o agente ainda não abriu, e o painel de Coaching acompanha se os agentes revisaram o feedback recebido. Se a sua taxa de não vistas é alta, seu problema de feedback não é a redação, é a entrega. A página de Activity do agente reúne revisões, comentários, reações, feedback de CSAT e contestações em um só lugar.
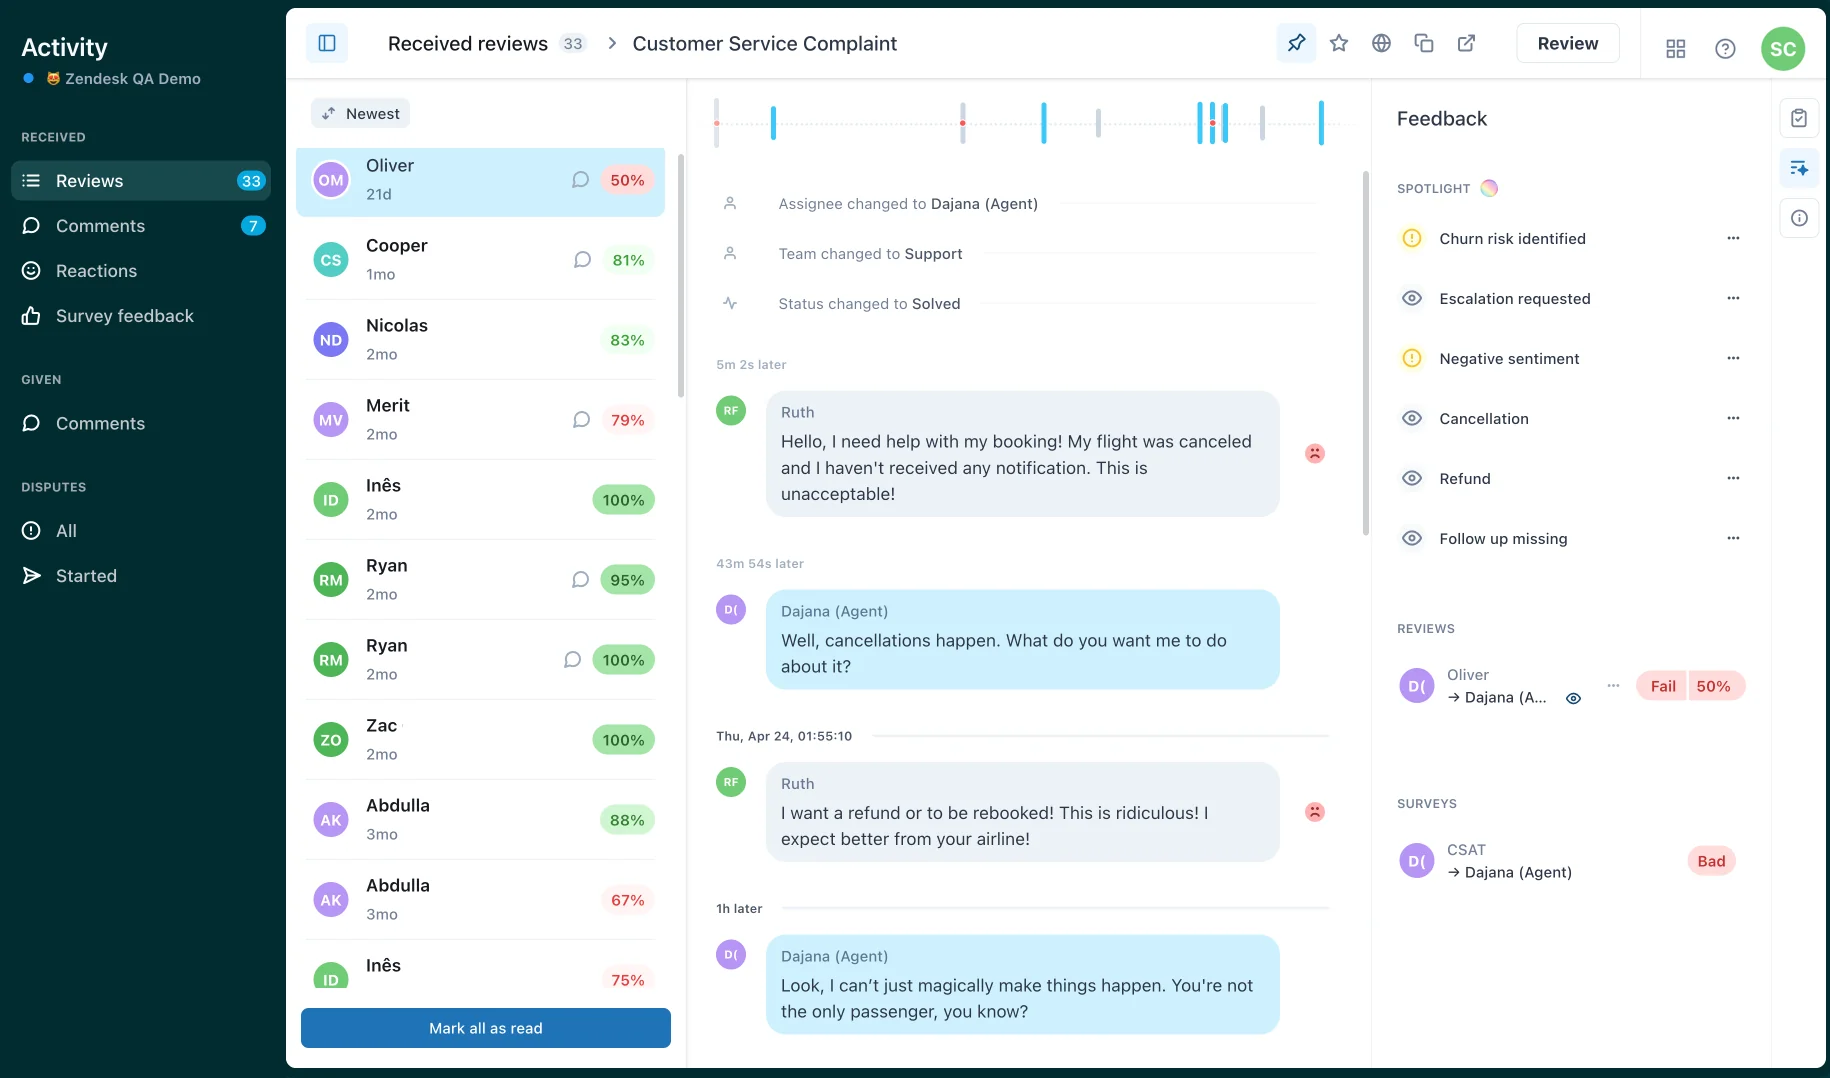
O Zendesk mantém separadas as pontuações de IA e as humanas. Os resultados do AutoQA alimentam uma pontuação de qualidade automática, enquanto a pontuação de qualidade interna se baseia apenas em revisões manuais, e a própria documentação de configurações da conta da Zendesk diz que as avaliações do AutoQA "are for guidance only and shouldn't be used for performance decisions." É uma linha sensata para copiar mesmo que você use outra ferramenta. O complemento de QA custa $35 por agente por mês além de qualquer plano Support ou Suite, segundo os preços da Zendesk.
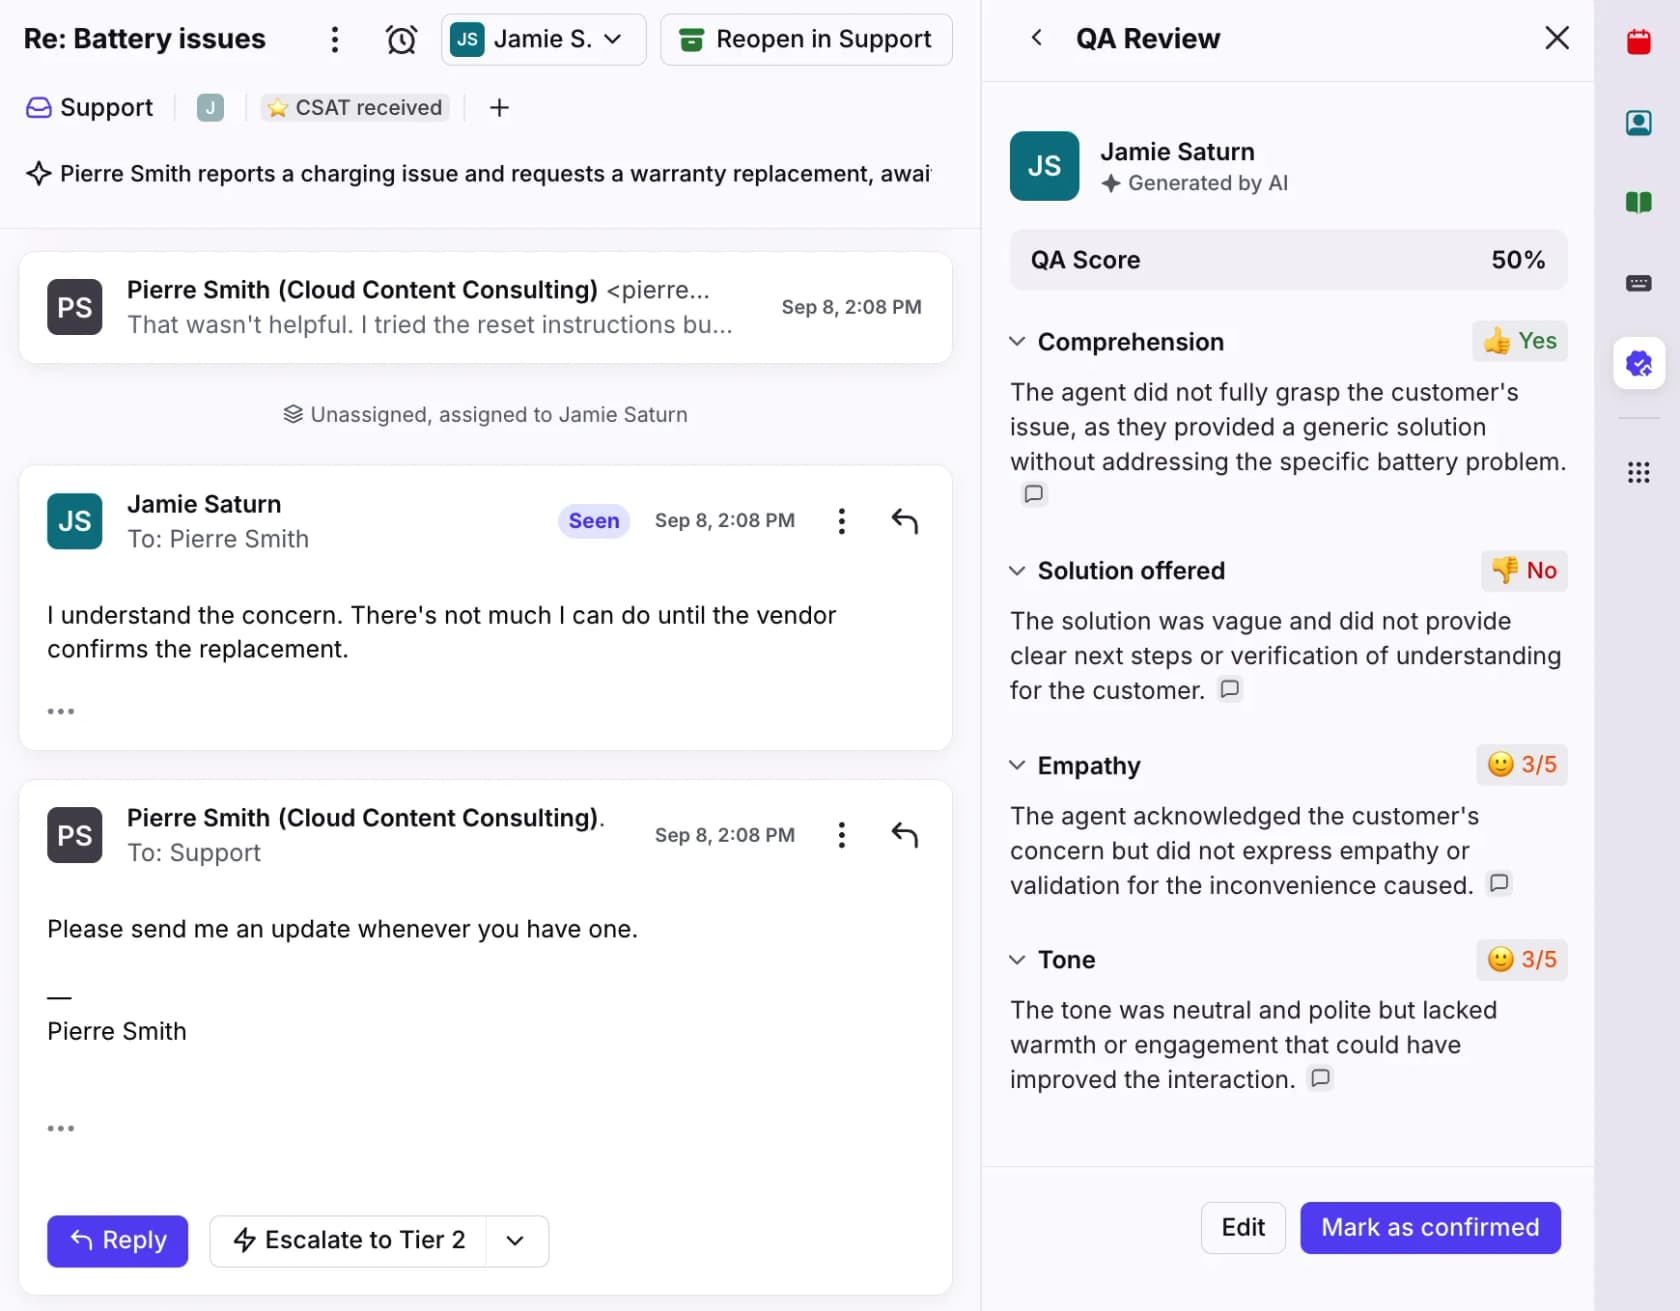
O Front mostra aos agentes as próprias pontuações de IA, com o raciocínio. O Smart QA coloca uma planilha de pontuação na barra lateral da conversa com uma explicação escrita por critério, e os agentes só veem os próprios resultados. Admins podem substituir uma pontuação, adicionar um comentário e marcá-la como confirmada, e então o nome deles substitui "Generated by AI." O Front também pede que se avise os clientes quando o Smart QA estiver pontuando suas conversas, algo que eu faria com qualquer ferramenta. Custa $20 por assento por mês no Starter e no Professional, e está incluído no Enterprise a $105, segundo o artigo de ajuda do Smart QA e os preços do Front.
O Gorgias Auto QA é uma ferramenta de gestor, não feedback para agentes. Ele pontua automaticamente completude da resolução, comunicação e domínio do idioma, mas "only the account owner, admins, and leads can view and change QA scores," segundo a documentação do Auto QA. Então, no Gorgias, qualquer feedback que chega a um agente passa por uma nota, uma 1:1 ou um relatório que você compartilha. Tudo bem, desde que alguém realmente tenha a conversa.
Freshdesk e Help Scout não têm planilha de pontuação de QA nativa na documentação ou nas páginas de preços. O feedback ali passa por notas e @menções, que notificam o agente, mais CSAT. Os threads privados do Freshdesk permitem comentar uma resposta específica e incluir o responsável, o que funciona bem para a camada diária. Se você quer planilhas de pontuação em qualquer um dos dois, precisa de uma ferramenta de QA dedicada.
Os comentários de CSAT são a única fonte que todo grande helpdesk mostra aos agentes. No Zendesk a avaliação fica no topo do ticket com os comentários em Events; o Freshdesk os mostra nas Activities do ticket; o Gorgias deixa todos os perfis abrirem o relatório de Satisfação com seus comentários em destaque. Use-os na 1:1 semanal, não como um ranking.
Corrija uma vez: quando o feedback é na verdade uma resposta que falta
Esta é a parte que mudou como eu penso sobre feedback. Se você se pega dando a mesma correção pela terceira vez, a agentes diferentes, o problema provavelmente não são os agentes.
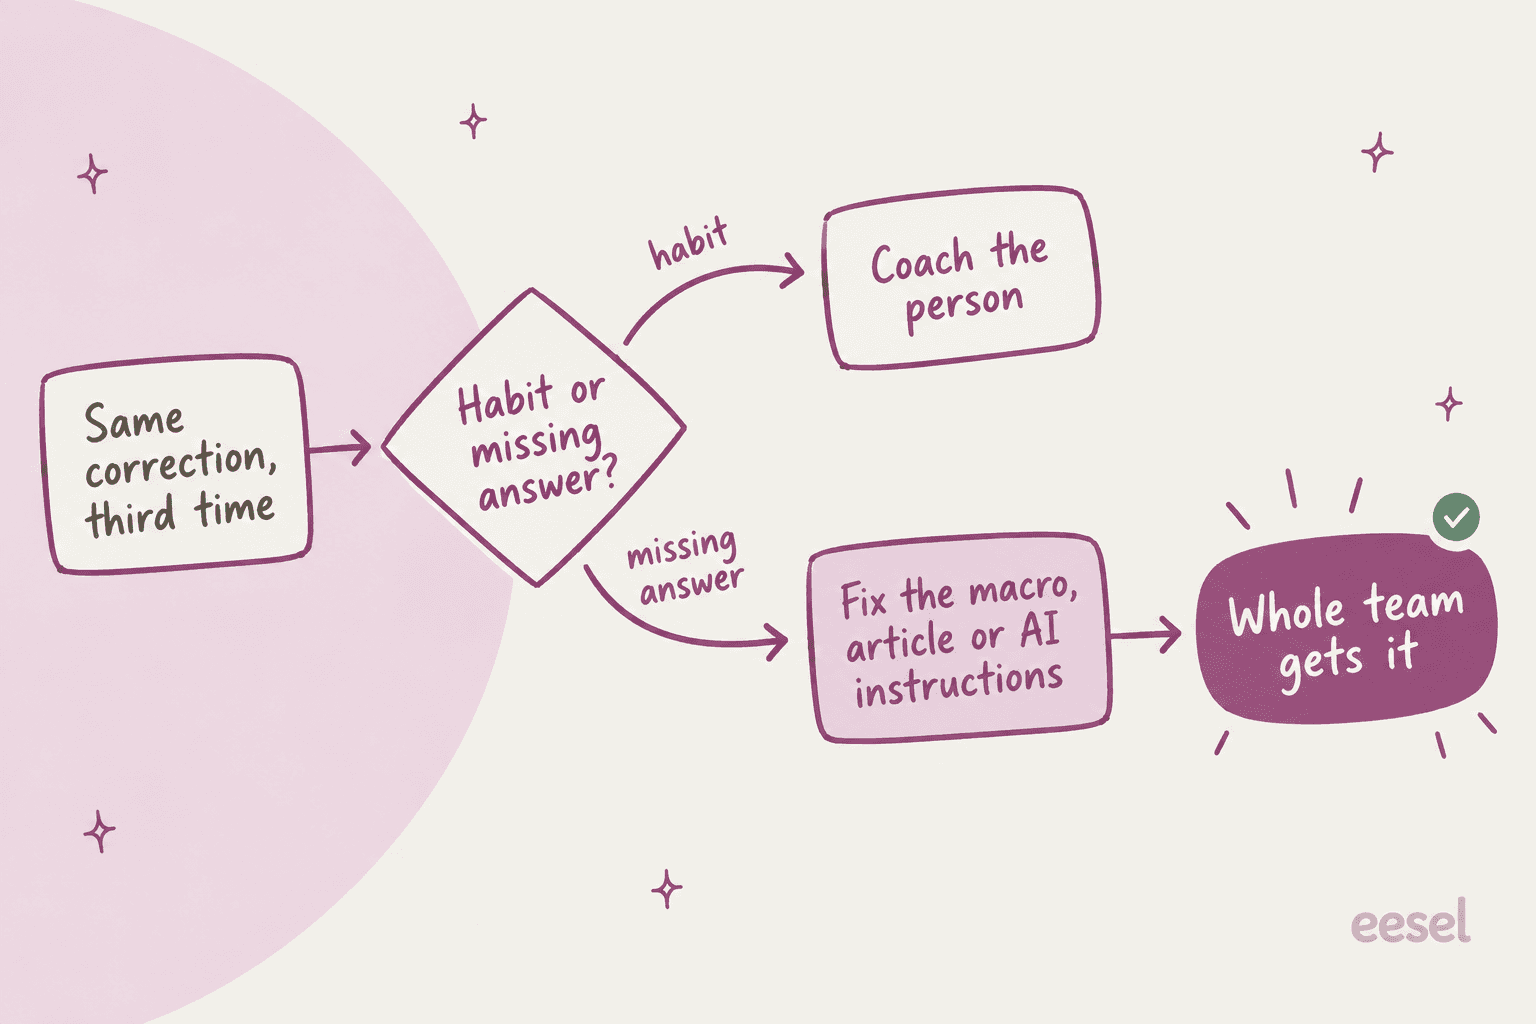
Correções repetidas geralmente são uma lacuna na base de conhecimento, uma macro desatualizada ou uma política que vive na cabeça de um sênior. Fazer coaching com cada agente separadamente é lento, e a próxima contratação cai direto no mesmo buraco. Corrigir a fonte uma vez corrige para todos, e muitas vezes é uma edição de cinco minutos.
Vi isso com clareza em um teste da eesel que analisei. Os agentes enviavam os rascunhos da IA sem alterações em apenas cerca de 12% das vezes; o padrão comum era "glance and rewrite", transformando rascunhos longos em respostas de uma a três frases. Detalhando, cerca de 65% eram tamanho e tom, cerca de 20% precisavam de dados aos quais a IA não estava conectada, e apenas cerca de 5% eram a IA errando nos fatos. Todos os agentes davam o mesmo feedback, à mão, em cada ticket. A solução não foi fazer coaching com os agentes nem com a IA ticket a ticket. Foi treinar com as respostas enviadas da própria equipe para que os rascunhos saíssem na voz dela desde o início.
A mesma lógica vale para a sua equipe humana. Mantenha uma lista contínua de correções das notas diárias. Tudo que aparecer três vezes é corrigido na fonte: o artigo de ajuda, a macro ou as instruções da IA. Depois mencione na 1:1 para o agente saber que o problema era o sistema, não ele. Esse gesto faz mais pelo moral do que qualquer sanduíche de feedback.

Se um copiloto de IA redige respostas para sua equipe, ele também pertence a este ciclo. Ele precisa do mesmo feedback que um contratado novo, e o bom é que uma correção feita uma vez se aplica a todos os rascunhos futuros. Escrevi mais sobre isso no meu guia de coaching de um agente de IA.
Erros que fazem o feedback para agentes de suporte sair pela culatra
- Guardar tudo para a avaliação mensal. Quando chega, o agente já repetiu o hábito por semanas. Notas diárias o pegam no segundo ticket, não no quadragésimo.
- Pontuar tickets de que ninguém fala. Uma revisão que o agente nunca discute é uma nota, não feedback. Confira sua taxa de não vistas se a sua ferramenta a informa.
- Dar peso na planilha a roteiros. Se 70% da pontuação são saudações e encerramentos, os agentes vão otimizar saudações e encerramentos. Dê mais peso à resolução no primeiro contato e à precisão do que à redação.
- Usar pontuações de IA para decisões de desempenho. Até os fornecedores dizem para não fazer isso. Use a IA para achar os tickets que merecem uma revisão humana e depois revise-os.
- Trazer um único dia ruim como métrica. Uma ligação de tradutor pode arruinar o tempo de atendimento de um dia. Olhe tendências de três semanas ou mais.
- Não ter caminho de contestação, ou ter um lento. Agentes que não podem reagir deixam de confiar em todas as pontuações, inclusive nas justas.
- Fazer coaching com pessoas sobre um processo quebrado. Se três agentes cometem o mesmo erro, corrija primeiro a macro ou o artigo.
eesel para feedback a agentes de suporte
Se a sua equipe continua recebendo o mesmo feedback nos mesmos tipos de ticket, a correção mais rápida é colocar a resposta certa diante dos agentes antes de enviarem. O colega de helpdesk com IA da eesel se conecta ao Zendesk, Freshdesk, Gorgias e ao resto da sua stack, aprende com sua central de ajuda, suas macros e tickets passados, e redige cada resposta como uma nota interna para um agente conferir e enviar. Agentes novos veem como sua equipe responde a um reembolso ou a uma queda antes de escrever uma palavra, o que transforma muito feedback posterior em uma edição rápida anterior.

O que mais gosto para feedback: quando um líder corrige uma resposta no chat, a eesel grava essa correção nas próprias instruções, então o ajuste aparece em todos os rascunhos futuros em vez de ser repetido em cinco 1:1s separadas. Um fundador que usa Freshdesk colocou assim em uma avaliação no G2:
"When we re-test, it correctly incorporates the coaching... specifically on enabling newer team members to have a 24/7 supervisor that coaches them on how to handle inquiries."
Para deixar claro o território: a eesel não é uma planilha de pontuação de QA nem uma ferramenta de contestação para agentes humanos, então mantenha o Zendesk QA, o Front Smart QA ou uma plataforma de QA dedicada para isso. O que ela faz é reduzir quanto feedback corretivo você precisa dar logo de início. Você pode testar a eesel grátis com 100 créditos e ver os rascunhos nos seus próprios tickets.