

Sim, mas muito menos do que a maioria das equipes espera. Passei o mesmo ticket de suporte pelos modelos atuais da OpenAI em 14 idiomas: o espanhol usou 1,17x os tokens do inglês, o alemão 1,27x, o japonês 1,45x e o tailandês 1,73x. Nos preços atuais dos modelos, isso adiciona uma fração de centavo por ticket. O que realmente pesa é a cobrança e a precisão. Se seu fornecedor cobra por ticket ou por resolução, a diferença de tokens nunca chega à sua fatura, enquanto uma taxa de resolução mais fraca em um idioma custa muito mais em tempo humano. A eesel cobra um crédito por ticket em qualquer idioma, então o que vale testar é a qualidade da resposta, não os tokens.
O suporte com IA custa mais em idiomas diferentes do inglês?
Eu construo os agentes de IA na eesel, e boa parte dos tickets que eles tratam não está em inglês. A smava, um comparador de empréstimos alemão, faz passar cerca de 27.000 tickets do Zendesk por mês pela eesel, quase todos em alemão, e cada um recebe uma etiqueta de idioma escrita em um campo do Zendesk antes de um consultor vê-lo. A Koffer.ch recebe rascunhos em alemão, francês, inglês e italiano, com a ortografia suíça. Então a pergunta «isso custa mais em japonês?» eu ouço de compradores o tempo todo.
A resposta honesta tem duas camadas. Há um custo de tokens pequeno e real, que vem de como os modelos de linguagem dividem o texto em pedaços. E há um custo operacional muito maior, que depende de quão bem a IA responde nesse idioma e de como seu fornecedor cobra. A maioria dos artigos sobre esse tema para na primeira camada. Este cobre as duas.
Se você está configurando o suporte ao cliente multilíngue com a eesel, a CLI da eesel permite que um agente de IA de programação envie o conhecimento aprovado de cada mercado, como artigos de ajuda exportados em alemão e japonês, e depois faça perguntas de teste em cada idioma e revise as respostas antes de qualquer coisa ir ao ar. Conectar o próprio helpdesk ainda precisa de alguém com acesso de administrador para aprovar.
Quantos tokens mais cada idioma usa?
Modelos de linguagem não leem palavras. Eles leem tokens, pedaços de texto que um tokenizador recorta da sua mensagem. O inglês recebeu a maior parte da atenção quando esses tokenizadores foram construídos, então ele empacota mais significado em cada token. Outros idiomas precisam de mais tokens para dizer a mesma coisa, e as APIs de modelos cobram por token.
Para obter números reais em vez de regras gerais, escrevi uma troca de suporte realista: um cliente pergunta onde estão seus tênis de corrida e se pode receber um reembolso, e uma resposta do agente com os detalhes de rastreamento e a política de devolução. Traduzi isso para 13 idiomas e contei os tokens de duas formas: com o tokenizador de código aberto da OpenAI o200k_base, e com o próprio endpoint de contagem de tokens de entrada da OpenAI para gpt-6.1-terra, gpt-6-luna e gpt-5.4-mini. Os três modelos atuais retornaram números idênticos (o tokenizador mais seis tokens de embrulho da mensagem), então uma única coluna cobre toda a linha atual da OpenAI.
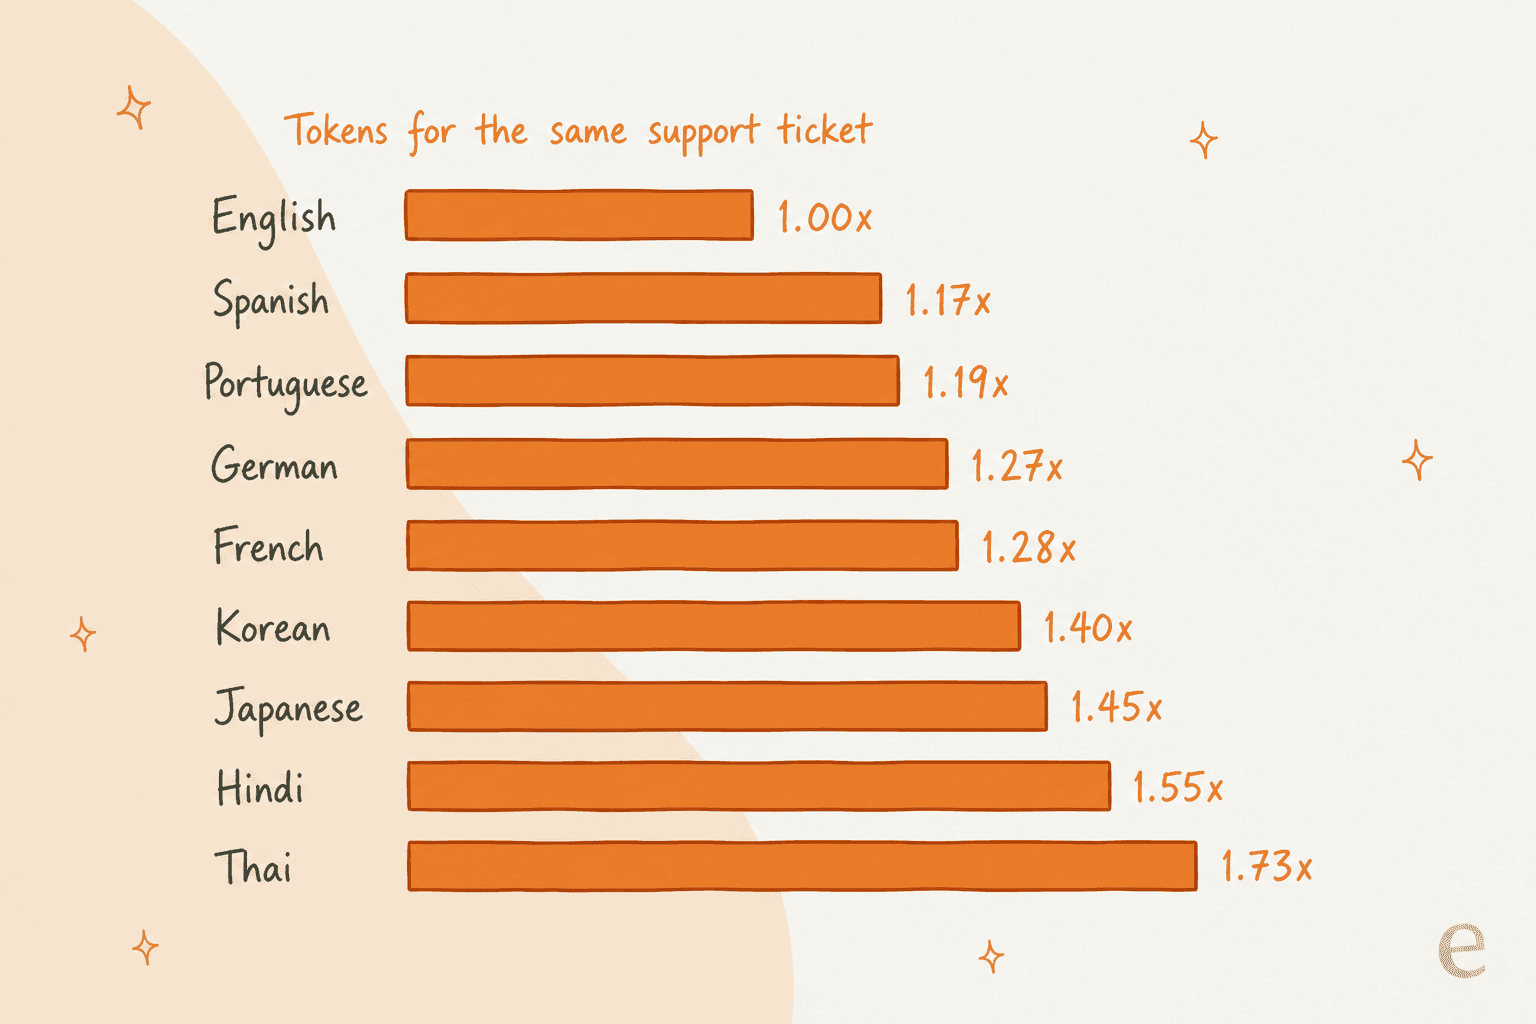
| Idioma | Tokens nos modelos atuais da OpenAI | vs. inglês | Tokens no tokenizador da era GPT-4 (cl100k) | vs. inglês |
|---|---|---|---|---|
| Inglês | 166 | 1,00x | 163 | 1,00x |
| Chinês (simplificado) | 182 | 1,10x | 256 | 1,57x |
| Espanhol | 194 | 1,17x | 219 | 1,34x |
| Português (Brasil) | 198 | 1,19x | 230 | 1,41x |
| Árabe | 206 | 1,24x | 467 | 2,87x |
| Alemão | 210 | 1,27x | 257 | 1,58x |
| Indonésio | 211 | 1,27x | 257 | 1,58x |
| Francês | 213 | 1,28x | 249 | 1,53x |
| Italiano | 226 | 1,36x | 253 | 1,55x |
| Vietnamita | 228 | 1,37x | 372 | 2,28x |
| Coreano | 233 | 1,40x | 354 | 2,17x |
| Japonês | 241 | 1,45x | 345 | 2,12x |
| Hindi | 258 | 1,55x | 775 | 4,75x |
| Tailandês | 288 | 1,73x | 670 | 4,11x |
Três coisas chamam atenção:
- A penalidade é real, mas moderada nos modelos atuais. A maioria dos idiomas europeus fica entre 1,17x e 1,36x. Japonês e coreano ficam em torno de 1,4x. Só o tailandês e o hindi passam de 1,5x.
- Tokenizadores antigos eram brutais. No tokenizador
cl100k_baseusado pelo GPT-4 e GPT-3.5, o hindi levava 4,75x e o árabe 2,87x. Se o bot de um fornecedor ainda roda em um modelo antigo, a diferença que você paga é várias vezes maior do que na primeira coluna. - Seus números vão variar. Isso é um único ticket. Um ticket em alemão repleto de nomes de produtos compostos, ou um em japonês muito formal, podem mover os números alguns pontos em qualquer direção. Anthropic e Google usam seus próprios tokenizadores, então meça no modelo que você realmente usa. O endpoint de contagem de tokens da Anthropic é gratuito, e o guia de tokens do Google calcula um token do Gemini em cerca de quatro caracteres de inglês.
O que isso significa por ticket?
Um multiplicador de tokens só importa quando está ligado a um preço, e um ticket de suporte não é só a mensagem do cliente. Ele também carrega suas instruções de sistema e os artigos de ajuda que a IA usou para responder. Esse contexto costuma estar em inglês, e não cresce quando o cliente escreve em japonês.
Aqui está um exemplo calculado com o GPT-6.1 Terra, que a OpenAI lista a 1,00 $ por milhão de tokens de entrada e 5,00 $ por milhão de saída. Minhas suposições: 3.000 tokens de instruções e artigos de ajuda em inglês, 1.000 tokens de conversa e uma resposta de 400 tokens, sem tokens de raciocínio.
| Configuração | Tokens de entrada | Tokens de saída | Custo por ticket | vs. inglês |
|---|---|---|---|---|
| Ticket em inglês | 4.000 | 400 | $0,0060 | 1,00x |
| Ticket em japonês, central de ajuda em inglês | 4.450 | 580 | $0,0074 | 1,23x |
| Ticket em japonês, central de ajuda em japonês | 5.800 | 580 | $0,0087 | 1,45x |
| Ticket em japonês, traduzido para inglês e de volta | 6.250 | 1.980 | $0,0162 | 2,69x |
Dois resultados me surpreenderam quando calculei isso pela primeira vez:
- O conhecimento em inglês dilui a penalidade. Quando a central de ajuda permanece em inglês, só a conversa e a resposta ficam mais caras, então um idioma de 1,45x se torna um ticket de 1,23x. Modelos atuais conseguem responder em japonês a partir de artigos de origem em inglês, e é a mesma ideia por trás de como a eesel responde aos clientes holandeses, alemães e franceses da Innr a partir de uma única central de ajuda com cerca de
1.500artigos e tickets passados. - O pipeline que traduz primeiro é o caro. Traduzir a mensagem do cliente para inglês, responder em inglês e depois traduzir a resposta de volta adiciona duas chamadas de modelo, e a tradução é majoritariamente saída, o tipo de token mais caro. Nesse exemplo, isso custou 2,2x uma resposta nativa em japonês. As equipes costumam adicionar uma camada de tradução para economizar e acabam pagando mais.
Com 5.000 tickets em japonês por mês, a configuração nativa com central de ajuda em inglês adiciona 6,75 $ por mês em relação ao inglês. Esse é todo o «imposto de idioma» em tokens. Mesmo em um modelo premium como o GPT-6 Astra, a 10 $ de entrada e 50 $ de saída por milhão, isso fica bem abaixo de cem dólares por mês. Se você constrói sobre a Anthropic, a mesma proporção se mantém no Claude Haiku 5.5 e no Claude Sonnet 5.5.
Quem paga o imposto de idioma, você ou seu fornecedor?
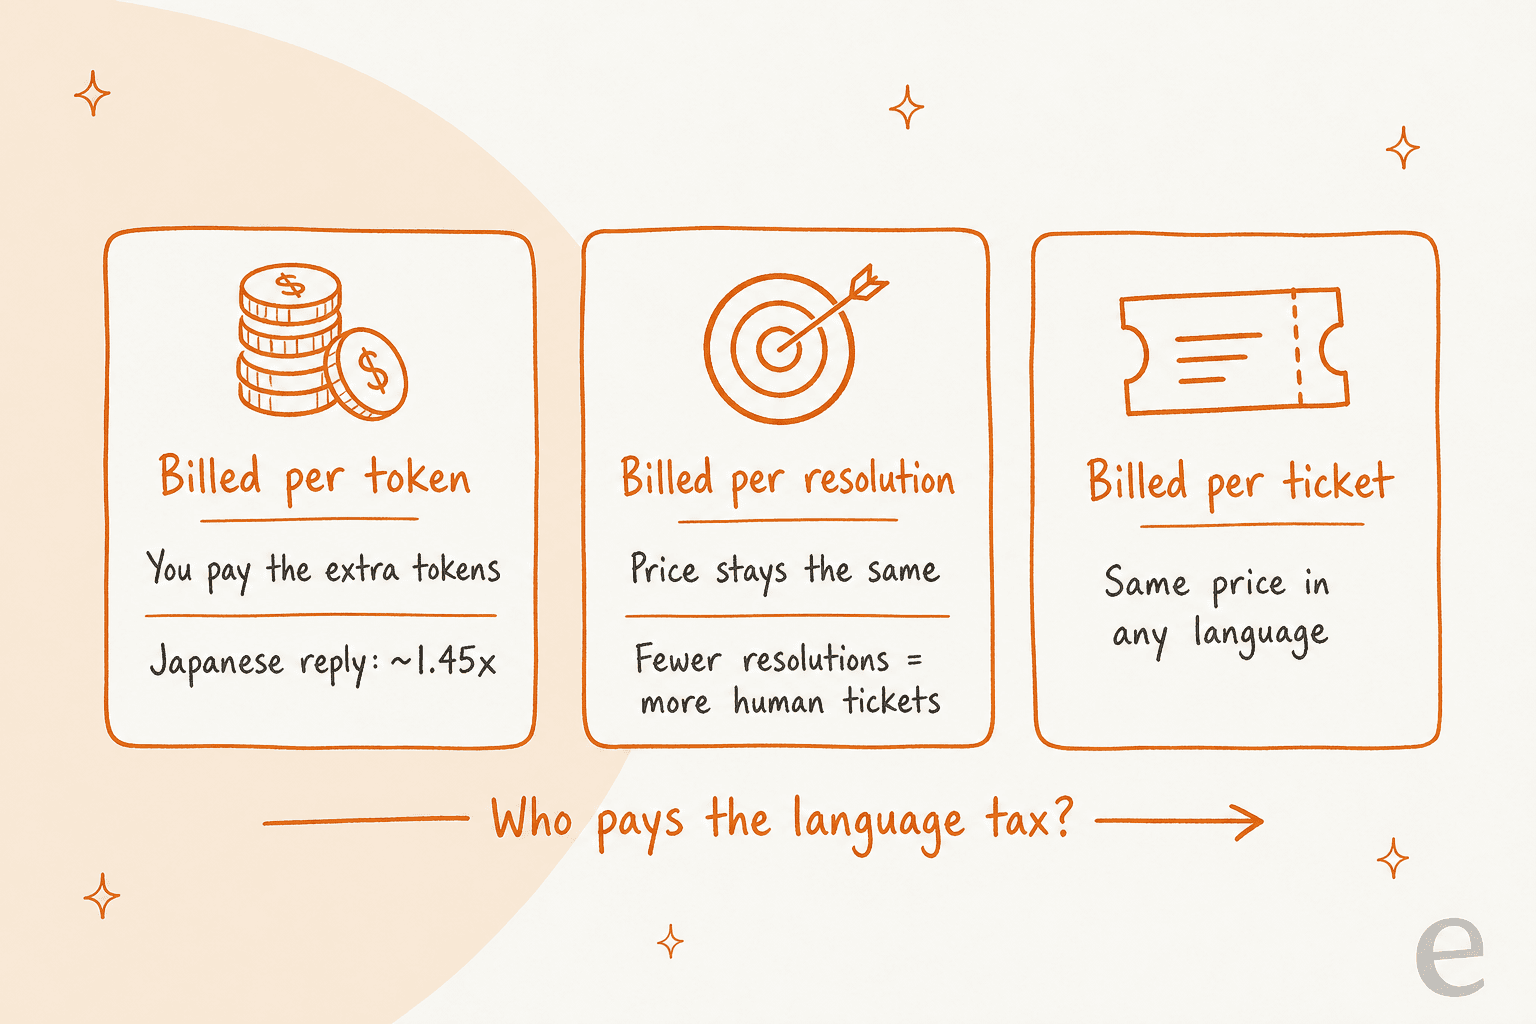
Se esse custo extra de tokens chega até você depende da unidade em que sua IA é cobrada. Vejo três modelos de cobrança no suporte com IA hoje, e só um repassa a diferença de tokens.
| Modelo de cobrança | Quem usa | Preço unitário | O idioma muda o preço? |
|---|---|---|---|
| Por token | Direto na API da OpenAI, Anthropic ou Google | Varia por modelo | Sim, conforme o multiplicador de tokens acima |
| Por resolução automatizada | Agentes de IA do Zendesk | 1,50 $ com compromisso, 2,00 $ pague conforme o uso | Não |
| Por sessão de IA | Freshdesk Freddy AI Agent | Primeiras 500 sessões incluídas, depois 49 $ por 100 | Não |
| Por interação automatizada | Gorgias AI Agent | De 0,85 $ a 1,00 $ dependendo do plano | Não |
| Por ticket atendido | eesel | 1 crédito, a partir de 299 $ por 500 créditos | Não |
Nenhuma das páginas de preços que verifiquei lista uma sobretaxa de idioma. A página de preços do Zendesk anuncia suporte para mais de 80 idiomas em seus agentes de IA pelo mesmo preço por resolução, e a página de preços da Freshworks e a página de preços da Gorgias cobram suas unidades de sessão e interação do mesmo jeito, independentemente do idioma.
Isso não torna o idioma gratuito nesses planos. Apenas move o custo para outro lugar:
- Por resolução significa que você só paga quando a IA resolve o ticket. Se ela resolve menos tickets em japonês, sua fatura de IA para japonês cai, e sua fatura humana sobe mais. Leia deflexão vs. taxa de resolução antes de comparar orçamentos nessa unidade.
- Por sessão ou interação cobra pela tentativa, então um idioma mais fraco custa o mesmo em IA e ainda assim envia mais tickets para pessoas.
- Por ticket é o mais estável. A página de preços da eesel diz que um ticket custa um crédito «independentemente de quantas respostas vão e voltam», então uma thread longa em alemão e uma curta em inglês custam o mesmo.
De onde vem o custo real de um ticket que não está em inglês?
Depois que você percebe que tokens custam centavos, a questão do dinheiro se move para os lugares que custam dólares por ticket.
Uma taxa de resolução menor em alguns idiomas. Esse é o grande fator. Se a IA resolve 60% dos tickets em inglês mas só 50% dos japoneses, essa diferença de 10 pontos em 5.000 tickets são 500 tickets extras para sua equipe todo mês. A um custo ilustrativo de 5 $ de tempo de agente por ticket (use seu próprio número dos benchmarks de custo por ticket), isso são 2.500 $ por mês, contra 6,75 $ de tokens extras. A calculadora abaixo deixa você testar seus próprios números.
Conhecimento no idioma do cliente. Traduzir uma central de ajuda é um custo único mais manutenção a cada vez que um artigo muda. Muitas vezes você não precisa disso: uma IA que lê artigos em inglês e responde em alemão evita a fatura de tradução, e só os artigos que os clientes leem diretamente precisam de uma versão localizada. Minha comparação de software de base de conhecimento multilíngue cobre as ferramentas para quem precisa disso.
Terminologia sem tradução limpa. Em uma chamada de vendas este ano, uma equipe B2B de telemetria veicular se expandindo para novos mercados da UE se preocupava porque termos técnicos como «chicote elétrico» não têm um equivalente direto em alguns idiomas. Isso é um risco de qualidade, não um custo de tokens, e é a razão para manter um glossário curto de termos de produto por idioma nas instruções da IA.
Revisão por falantes nativos. Alguém precisa verificar se a resposta em alemão soa como sua marca e não como um livro didático. Os clientes da Koffer.ch esperam a ortografia suíça em alemão, que um modelo genérico vai errar se não for instruído. Reserve tempo de revisão por idioma nas primeiras semanas, depois passe à amostragem; meu guia de QA de suporte multilíngue tem uma rotina de revisão, e qualidade de idioma no suporte ao cliente cobre o que avaliar.
Salários locais mudam a comparação. Um preço fixo por resolução parece barato contra um salário dos EUA e caro contra um mais baixo. Um cliente do Zendesk disse isso sem rodeios em um comentário no próprio artigo de ajuda do Zendesk:
"A $1.5 per conversation is viable only for the US/Europe. In our case, we will have to disable the chatbot and look for an alternative solution."
Então, se sua fila em idiomas diferentes do inglês é atendida a partir de um mercado mais barato, compare o preço unitário da IA com o custo por resolução real dessa equipe, não com os números da sua sede.
Como estimo o custo do suporte com IA por idioma?
Você consegue uma estimativa confiável por idioma em uma tarde. É assim que eu faria:
- Retire uma amostra de tickets reais por idioma. Pegue 100 a 200 tickets recentes de cada idioma, com a mesma mistura de temas. Comparar redefinições de senha em inglês com falhas técnicas em japonês distorce o resultado.
- Conte os tokens no modelo que você vai usar. OpenAI, Anthropic e Google todos oferecem endpoints de contagem de tokens, e o da Anthropic é gratuito. Conte as mensagens dos clientes, suas instruções e os artigos de ajuda que a IA provavelmente vai buscar, e depois compare cada idioma com o inglês.
- Verifique como seu fornecedor cobra. Se é por ticket, por resolução ou por sessão, pule totalmente a conta de tokens; seu preço unitário é o mesmo em qualquer idioma. Se você está construindo sobre uma API bruta, multiplique as contagens de tokens pelo preço do modelo.
- Teste a taxa de resolução por idioma. Esse é o número que move seu orçamento. Rode a IA em tickets passados em cada idioma e avalie as respostas contra o que sua equipe realmente enviou. Meu guia para testar um agente de IA antes do lançamento explica o passo a passo, e revisar conversas de suporte com IA cobre as verificações contínuas.
- Precifique a diferença em tempo humano. Multiplique os tickets que a IA não vai resolver em cada idioma pelo custo por ticket da sua equipe. Adicione horas de revisão por falantes nativos para o primeiro mês. Essa soma, não o tokenizador, é o seu custo real do suporte com IA em idiomas diferentes do inglês.
Se um idioma sair fraco no passo 4, a solução geralmente é um conhecimento melhor, não outro modelo: uma página de política que falta, um glossário de produto, ou algumas respostas de exemplo nesse idioma. Depois de ir ao ar, acompanhe as taxas de escalonamento para IA por idioma, porque um salto ali é o primeiro sinal de que a IA está com dificuldades em um mercado.
Se você prefere terceirizar toda a fila, compare esses números com o custo de uma equipe terceirizada no meu detalhamento do custo de terceirização de atendimento ao cliente, e verifique primeiro se a IA consegue lidar com o suporte ao cliente multilíngue para sua mistura de idiomas.
eesel para suporte em qualquer idioma
A eesel se junta ao seu helpdesk como uma colega de equipe de IA para suporte e responde no idioma em que o cliente escreveu, a partir do conhecimento que você já tem, mesmo que esteja todo em inglês. Ela funciona dentro do Zendesk, Freshdesk e dos outros principais helpdesks, e cobra um crédito por ticket em qualquer idioma, então uma thread em alemão e uma em inglês custam o mesmo. A smava usa para etiquetar e redigir tickets em alemão em duas marcas, e a Innr recebe rascunhos em quatro idiomas a partir de uma única central de ajuda.

Você pode conectar seu helpdesk, rodá-lo nos seus tickets passados em alemão ou japonês, e ler os rascunhos antes de um cliente vê-los. Teste a eesel gratuitamente por sete dias, sem cartão.