

Sem Chromium dentro. Essa é a primeira coisa a dizer. A Cloudflare lançou um navegador que escreveu do zero em doze semanas, rodando inteiramente em isolates V8 no Workers, principalmente Rust compilado para WebAssembly. Ele vive dentro do Browser Run, gratuito enquanto a beta durar. Passa de 235.000 subtestes do Web Platform. Também roda Doom.
A troca é real e, para crédito da Cloudflare, ela publica as duas metades. Em tarefas comuns de agentes, o Kitesurf usa de 3,1 a 3,8 vezes menos CPU e de 4,7 a 7 vezes menos memória que o Chromium. Ele também leva de 1,7 a 1,8 vez mais no relógio. E agora a parte que vale uma pausa. A tabela de preços publicada do Browser Run cobra horas de navegador e navegadores simultâneos. Não CPU. Não memória. Ou seja, aos preços de hoje, o medidor que o Kitesurf vence é o da própria Cloudflare, e o medidor que ele perde é o seu. Ninguém paga isso ainda porque a beta é gratuita, e a Cloudflare diz que a economia também chegará aos clientes. Simplesmente não há nenhuma tarifa do Kitesurf publicada para conferir isso.
Eu construo as integrações da eesel, então um lançamento como este me parece uma lista de compras de peças, não um produto. Mais de três anos colocando agentes de IA em filas de suporte reais me ensinaram uma coisa sobre agentes que dirigem navegadores. A renderização quase nunca é o que quebra. A identidade é. A eesel perdeu clientes que saíram para construir diretamente sobre a API do Claude, e todos os que voltaram disseram a mesma frase: que a demo era os 20% fáceis. Então: se você quer a IA respondendo tickets em vez de tirando capturas de páginas, a eesel se conecta ao seu helpdesk e à sua documentação e depois se reproduz sobre o seu histórico real de tickets antes de falar com qualquer cliente. Teste grátis. Sem navegador.
O medidor que o Kitesurf otimiza não é o que você paga
Comece pela frase da própria documentação da Cloudflare: "Kitesurf wins on the memory and CPU that drive your bill (by 3-7x)."
Agora abra a página de preços do Browser Run, atualizada pela última vez em abril de 2026. Há exatamente dois medidores:
| Medidor | Workers Free | Workers Paid |
|---|---|---|
| Horas de navegador | 10 minutos por dia | 10 horas/mês, depois US$ 0,09 por hora |
| Navegadores simultâneos (apenas Browser Sessions) | 3 | 10, em média mensal, depois US$ 2,00 por navegador |
Nenhum deles é CPU. Nenhum deles é memória. Horas de navegador são tempo de relógio, informado por requisição no cabeçalho de resposta X-Browser-Ms-Used, e as Quick Actions são cobradas apenas por horas de navegador. Navegadores simultâneos são uma contagem de unidades, não uma medida de recursos. A mesma distinção que torna tão difícil comparar preços de API de LLM entre fornecedores.
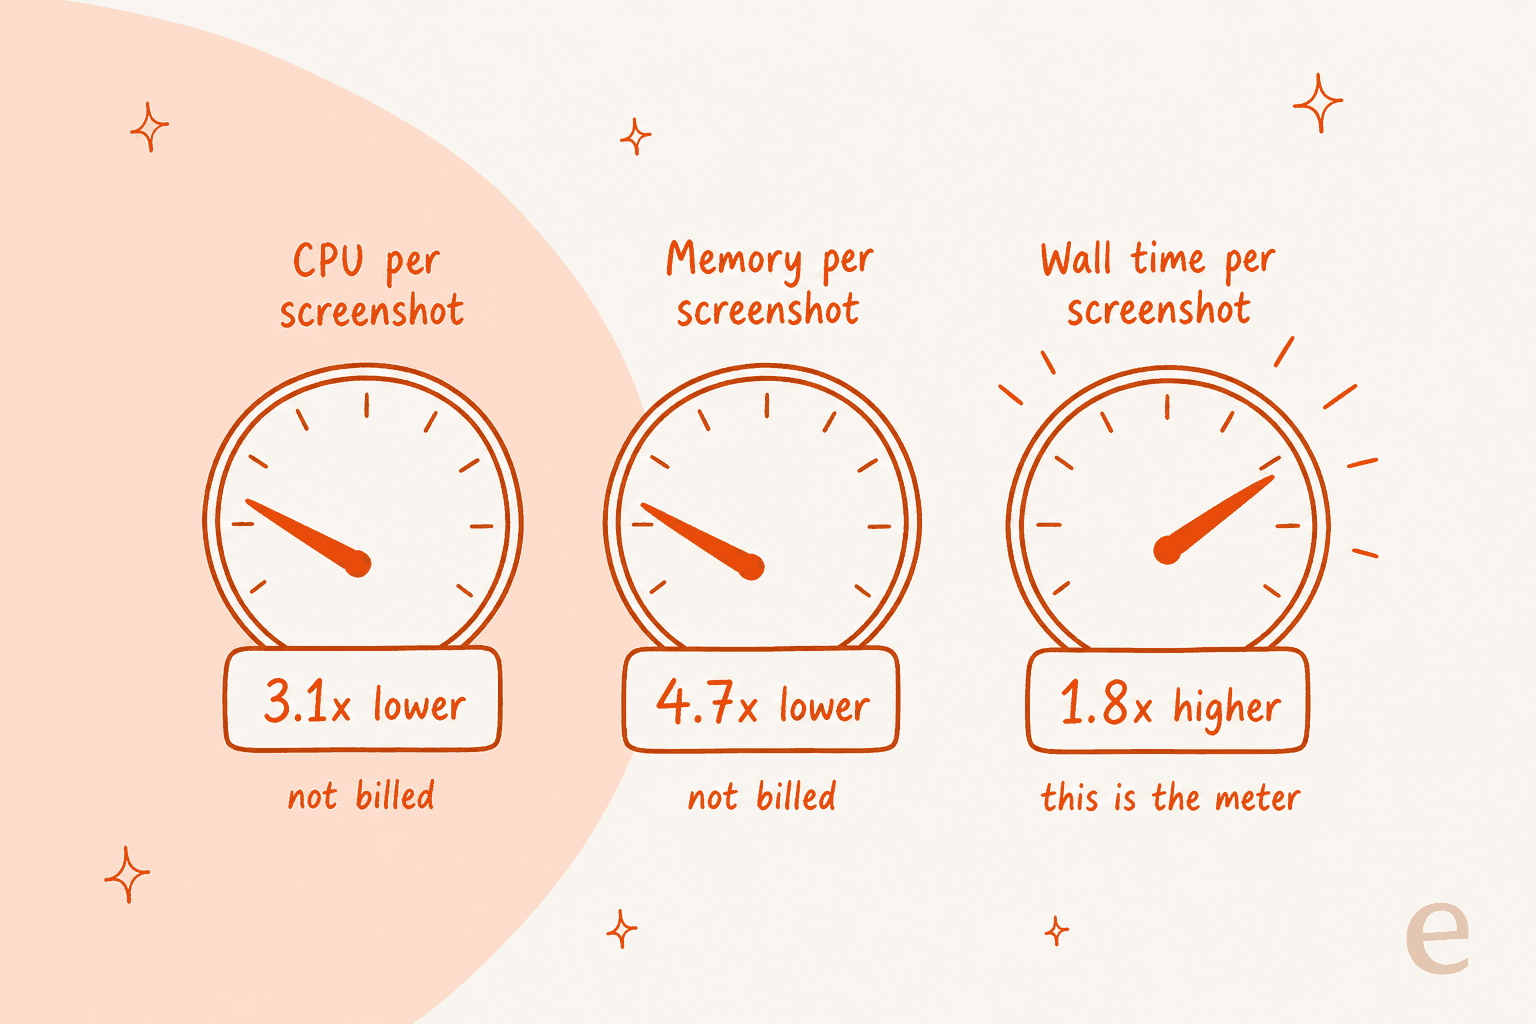
Então, pela tabela publicada, rodar o mesmo trabalho no Kitesurf em vez de no Chromium faz o medidor cobrado avançar cerca de 1,7 a 1,8 vez mais rápido. A economia de CPU e memória é grande e real, mas ela cai na frota da Cloudflare, onde uma sessão de captura de tela cai de 271,0 MiB para 57,8 MiB. Um ganho real de plataforma, e exatamente o tipo de coisa que mais tarde permite a um provedor elevar os tetos de concorrência e cortar preços. Ainda não é uma linha na sua fatura. Quem já tentou modelar o custo por resolução sabe o quanto o custo unitário de um provedor e o seu preço unitário podem se distanciar.
Duas ressalvas, que prefiro dizer com clareza a enterrar. Primeira: o tempo real do benchmark e os ms de navegador cobrados são medidos de formas diferentes, então trate esse multiplicador como uma direção e não como um decimal. Segunda: o Kitesurf é gratuito durante a beta, o que faz a resposta honesta para "quanto custa?" ser nada, hoje. A pergunta real é o que acontece na disponibilidade geral. Essa resposta não foi publicada.
Aqui está a conta com a tabela atual, para você colocar o seu próprio volume:
Com um milhão de capturas por mês, a diferença fica em cerca de US$ 12,78. Com dez milhões, cerca de US$ 128. Números absolutos pequenos, porque o Browser Run já é barato de partida, e isso faz parte da leitura honesta: hoje ninguém escolhe o Kitesurf para economizar em horas de navegador. Escolheriam porque a capacidade da própria Cloudflare fica mais barata, que é como se chega, com o tempo, a tetos de concorrência maiores e uma tabela melhor. Esse teto já se mexeu duas vezes este ano, de 30 para 120 em abril e depois para 200 na página de limites atual.
O que o Kitesurf realmente é
Três componentes. Os nomes são, para variar, incomumente literais.
O Engine é a única peça voltada ao público. Ele fala o Chrome DevTools Protocol sobre WebSocket mais uma superfície REST por HTTP, e também é o único componente que guarda o estado da sessão. Essa escolha de CDP é toda a história de compatibilidade, em termos de adoção: aponte Puppeteer, Playwright, chrome-remote-interface ou qualquer agente que fale MCP e CDP para ele, e funciona. Você ativa acrescentando browser=kitesurf ao endpoint. Essa é a migração inteira.
O PageScript é onde uma página realmente vive. Cada página, e também cada iframe fora de processo, ganha seu próprio isolate de longa duração criado via Dynamic Workers, com um globalThis limpo e um documento DOM. A análise de HTML e CSS vem do Blitz e do Stylo, o analisador de CSS do Firefox. Ambos em Rust.
O PageRenderer transforma a página calculada em pixels. Sem estado, guardando apenas um cache descartável, e o Engine chama renderFrame() nele por Workers RPC. Como ele não guarda nada, uma renderização travada simplesmente é encerrada e repetida em vez de depurada.
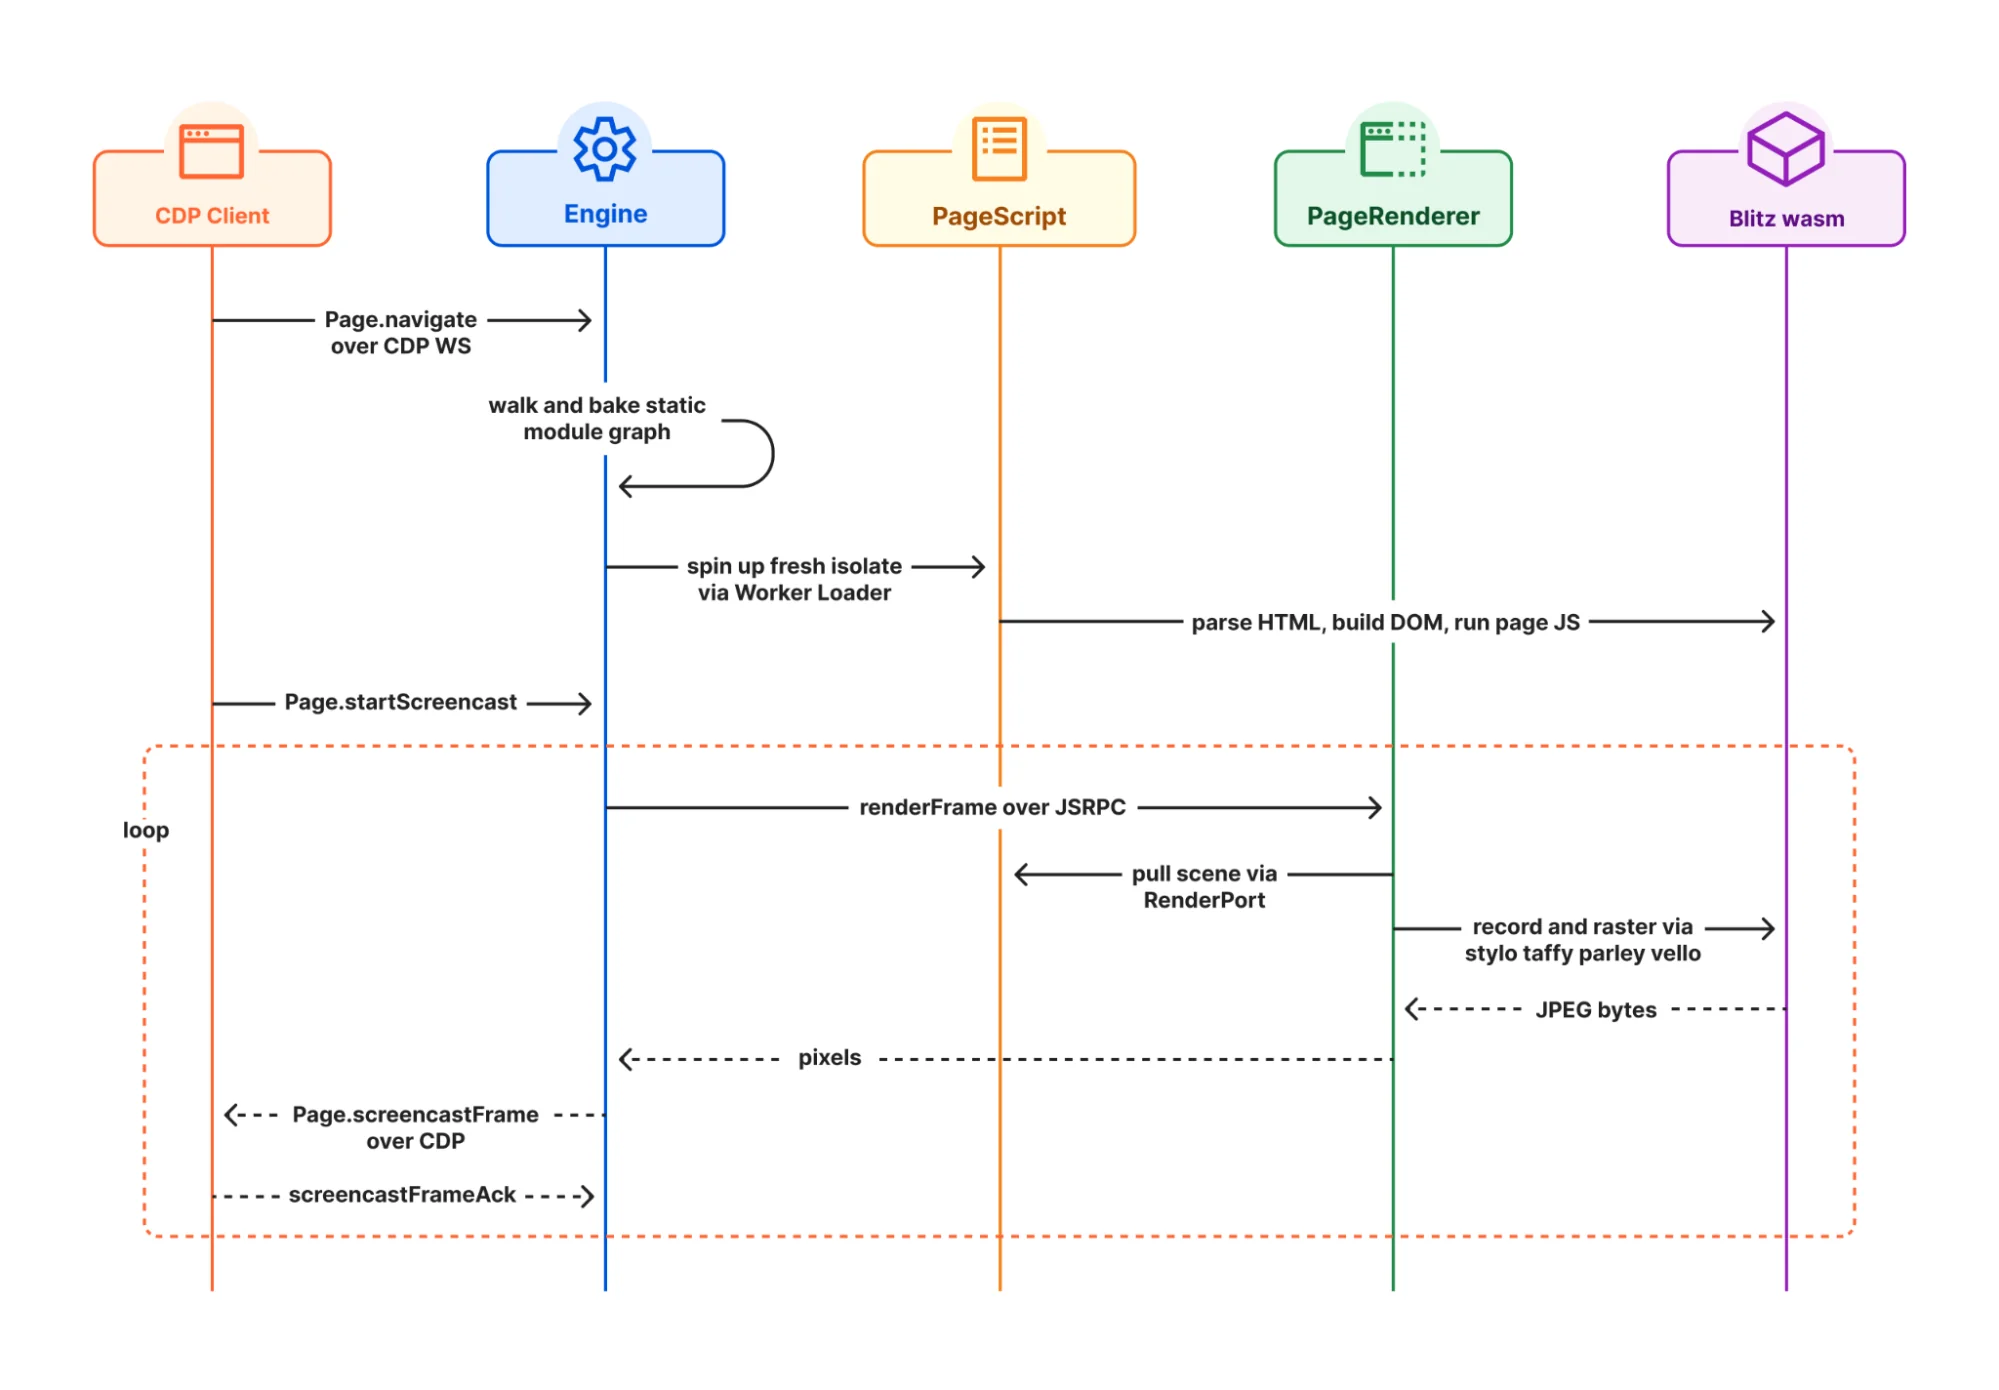
Dois detalhes ali valem mais que o próprio diagrama de arquitetura.
O primeiro: o Workers ainda não suporta eval nativamente, por razões de segurança. A solução da Cloudflare é rodar o Boa, um motor ECMAScript escrito em Rust, dentro do isolate. Como um comentarista resumiu, isso é um motor de JS escrito em Rust, compilado para Wasm, rodando dentro do V8. Celso Martinho, que escreveu o post, concordou no Hacker News e disse que vão migrar para fora do Boa quando o eval nativo chegar. É raro ver um fornecedor rotular a própria camada como subótima no post de lançamento.
O segundo é sobre de onde veio a ideia. A Cloudflare credita o obscura, um motor headless em Rust sob licença Apache-2.0, como a inspiração inicial, e diz que a primeira tentativa foi portá-lo para o Workers com um agente de IA, o que "didn't work very well at first." Depois o autor apareceu no tópico:
"I had no idea Cloudflare had tried porting Obscura until I read this post. Seeing something I built mentioned as the starting point for Kitesurf is an honor... For context, I'm 16."

Até hoje esse repositório tem 22.186 estrelas.
O benchmark, lido linha por linha
A Cloudflare publica medianas de cinco execuções de Quick Actions do Browser Run sobre um corpus de 14 URLs, cujo conteúdo dá para ler: Hacker News, Wikipedia, MDN, três jornais (The Guardian, El Mundo e RTP), além de cinco builds do TodoMVC.
| Métrica | Kitesurf | Chromium (pool aquecido) | Kitesurf, relativo |
|---|---|---|---|
| CPU: captura de tela | 380 ms | 1.173 ms | 3,1 vezes menos |
| CPU: extração de HTML | 229 ms | 877 ms | 3,8 vezes menos |
| Memória: captura de tela | 57,8 MiB | 271,0 MiB | 4,7 vezes menos |
| Memória: extração de HTML | 39,4 MiB | 273,7 MiB | 7,0 vezes menos |
| Tempo real: captura de tela | 1.148 ms | 637 ms | 1,8 vez mais lento |
| Tempo real: extração de HTML | 820 ms | 472 ms | 1,7 vez mais lento |
Três coisas que vale notar aqui.
A comparação é feita contra um pool aquecido, que a Cloudflare nomeia direto no cabeçalho da coluna em vez de esconder. Um Chromium aquecido tem um JIT que já viu a página; o Kitesurf é um renderizador de software frio, sempre. O que torna a disputa justa para uma carga de agentes em rajadas e injusta para uma sessão longa. De qualquer forma, o enquadramento é honesto.
A memória do Chromium quase não muda entre as duas tarefas, 271,0 MiB contra 273,7 MiB, enquanto a do Kitesurf cai de 57,8 para 39,4 MiB. Essa é a forma real do argumento: o Chromium paga por um navegador inteiro, você peça ou não para ele desenhar algo, e o Kitesurf paga aproximadamente em proporção ao trabalho. É a mesma razão pela qual o preço de IA medido por tokens se comporta de forma diferente do preço por assento, e pela qual o preço do GPT-5.6 recompensa prompts curtos.
E esse corpus são quatorze páginas ricas em texto e bem comportadas. Um substituto razoável para "extraia este artigo", ruim para um fluxo de checkout.
O que ele ainda não consegue fazer
A Cloudflare lista quatro lacunas, e prefiro citar a parafrasear: reproduzir vídeo, renderizar WebGL, negociar um handshake de desafio anti-bot com impressões digitais TLS reais ou iniciar uma sessão autenticada de longa duração que exija estado persistente. Para qualquer uma delas, você usa o Chromium padrão do Browser Run.
A quarta é a limitação que sustenta tudo. Um agente que faz algo comercialmente interessante na web passa a maior parte da vida logado, e esse é exatamente o caso que o Kitesurf adia hoje. Qualquer assistente de compras que preste vive atrás de um login, assim como a maior parte do que se pede a um chatbot de e-commerce. O melhor comentário de todo o tópico do Hacker News veio de alguém que passou um dia testando a premissa diretamente, percorrendo a web aberta apenas com HTTP puro:
"Rendering was almost never the blocker. Identity was."
Outra pessoa tirou a conclusão óbvia:
"The missing primitive for agents is not a browser. It is a portable identity and a spendable balance."
O que, para ser justo com a Cloudflare, é algo que ela está construindo separadamente. A mesma limitação é o motivo de existir um protocolo de comércio agêntico e de a versão da Shopify se apoiar em endpoints estruturados em vez de um navegador. O próprio Browser Run agora traz um recurso WebMCP cuja proposta inteira é substituir os ciclos de captura-análise-clique por chamadas diretas de função, o que diz bastante sobre onde a Cloudflare acha que isso termina.
Há também um orçamento exclusivo do playground, bom saber se você testar lá: cada navegação de página recebe 20 segundos de tempo de CPU e 60 segundos de tempo real, e depois a página é interrompida. Um orçamento bom para ler um artigo. Apertado para qualquer coisa parecida com uma execução real de um agente autônomo.
Cobertura de padrões e o formato dessa curva
O post de lançamento afirmava cerca de 215.000+ subtestes do Web Platform aprovados. A documentação do Browser Run já diz mais de 235.000 e detalha por área: DOM 97%, HTML 96%, Selection 99%, SVG 97%, Encoding 99%, CORS 95%, XHR 95%, com URL ficando para trás em 83%.
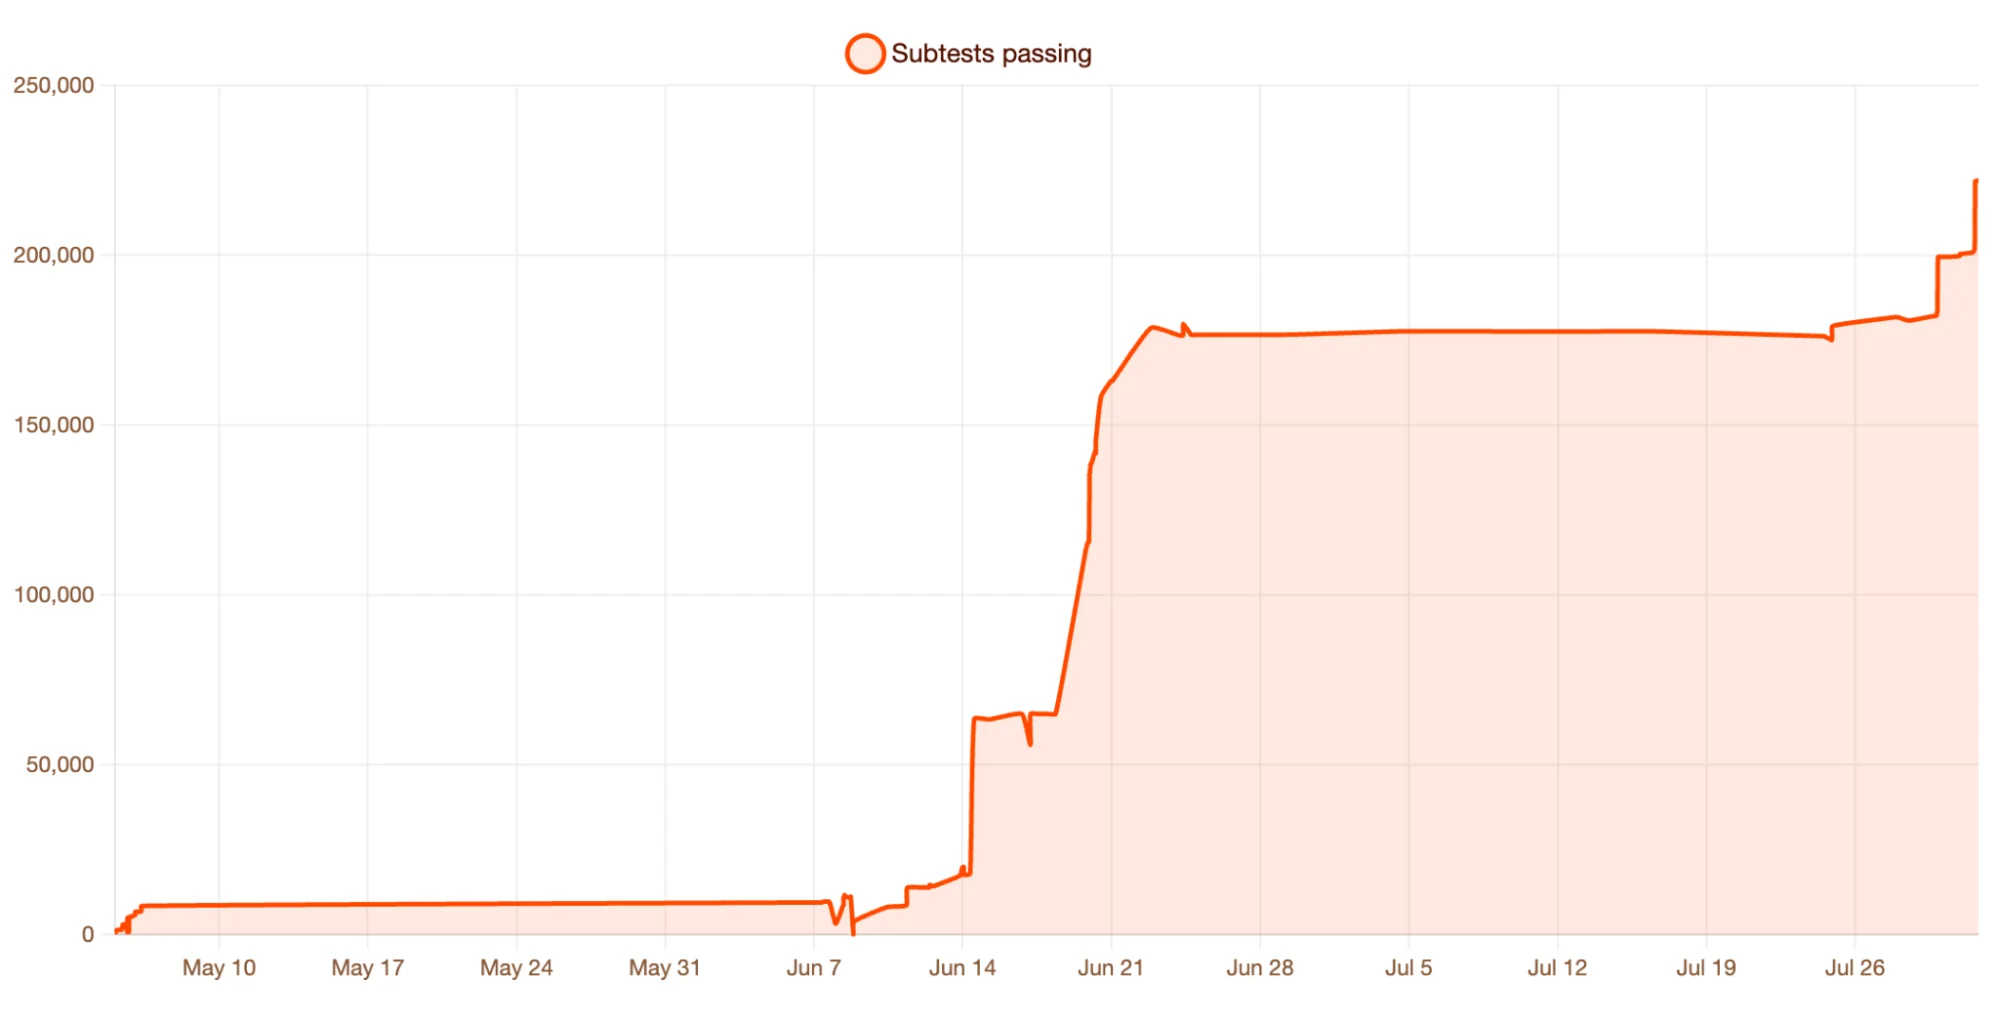
Leia a curva, não a manchete. Ela não é uma rampa suave, são três saltos em degrau e um platô de cinco semanas em torno de 176.000 até o fim de junho e entrando em julho, e depois um salto bem no final. É assim que se parece uma equipe limpando áreas inteiras da especificação em lotes, e significa que extrapolar um ritmo semanal a partir dela, em qualquer direção, é uma má leitura.
Conformidade também não é a mesma coisa que funcionar, e a Cloudflare diz isso, por isso combina o WPT com testes de integração do Puppeteer em várias etapas e execuções de regressão visual contra o Chromium a cada passo. Esse instinto, de que uma suíte de testes aprovada não é um usuário aprovado, é o mesmo por trás do teste adversarial de agentes de IA. É também o motivo pelo qual insisto em uma simulação sobre tickets históricos reais antes de qualquer classificação de tickets entrar no ar.
Um detalhe pequeno. O changelog do Browser Run que o post pede para você acompanhar ainda não traz nenhuma entrada do Kitesurf, e a linha mais recente é de 28 de julho.
A pergunta de segurança que o isolate não responde
A história de segurança da Cloudflare é o isolamento, e é uma boa história. Cada carregamento de página é tratado como não confiável, cada sessão começa limpa e o acesso à rede passa por um único worker SandboxOutbound, que aplica CORS, injeta cabeçalhos no formato de navegador, mantém os cookies de cada página em seu próprio recipiente e responde 403 a tudo que falha na política. Nada mais toca a rede, em absoluto. Como postura, é mais forte do que a maior parte do que leio ao auditar fornecedores em questões de SOC 2 e GDPR, ou na lista de verificação de privacidade de dados que todo comprador corporativo envia.
A crítica mais afiada do tópico foi que isso protege a direção errada:
"The V8 isolate guards the wrong half of this imo. It stops the agent's code from escaping the sandbox, but the risky part of a browser agent isn't code escaping, it's that it reads untrusted pages and then acts on them."
Uma resposta foi além:
"Hidden instructions in product descriptions will become the new blackhat SEO: instead of keyword-stuffing for crawlers, stores get prompt-stuffed for agents."
É justo, e também não é realmente um problema do Kitesurf. Para crédito da Cloudflare, o post de lançamento cita injeção de prompt e segurança de ferramentas como prioridades máximas na seção de modelo de ameaças; ele só nunca afirma que o isolate as resolve. Nada na camada do navegador consegue. O isolate limita o que o agente pode executar, não aquilo a que ele pode ser convencido, então a correção precisa estar no que o agente tem permissão de fazer depois: ferramentas restritas, limiares de confiança e um humano em tudo que for irreversível. A mesma arquitetura que impede um bot de suporte de inventar com confiança uma política de reembolso, que as notas da eesel sobre prevenção de alucinações e boas práticas de transferência de agentes detalham.
Ele passa pela proteção anti-bot da própria Cloudflare?
Essa foi a principal pergunta do tópico, e a especulação em torno dela ficou alta o bastante para merecer uma resposta direta. Celso Martinho, que escreveu o post de lançamento, respondeu pessoalmente:
"Browser Run requests coming from Chromium or Kitesurf are always identified as bot traffic by Cloudflare."
As requisições trazem um user agent documentado e são assinadas com Web Bot Auth. O Kitesurf também não consegue negociar um handshake de desafio anti-bot com impressões digitais TLS reais, e isso consta como limitação, não como recurso. Se o seu plano dependia de parecer humano, esta não é a ferramenta. Para isso o mercado já tem scrapers com proxies residenciais, que é o eixo em torno do qual gira a comparação Firecrawl vs Bright Data da eesel.
O desconforto estratégico no tópico foi um ponto à parte e não teve resposta:
"It's pretty bizarre to see them going from being the bot protection platform to differentiating on the kinds of bots they'll block, because now they're facilitating the exact kind of bot automation they made their name protecting against."
As duas coisas podem ser verdade ao mesmo tempo. O Kitesurf se identifica com honestidade, e a Cloudflare agora vende para os dois lados de uma cerca que ela mesma construiu.
O playground é a forma mais rápida de descobrir
Não existe uma matriz de compatibilidade. A resposta da própria Cloudflare para saber se um site funciona é ir testar. O playground público aceita qualquer URL e entrega os botões Inspect, Screenshot, PDF e HTML, com exemplos pré-carregados que cobrem Wikipedia, Hacker News, MDN, alguns jornais e Doom. O mesmo instinto de testar por conta própria por trás das demos do Chrome auto-browse.
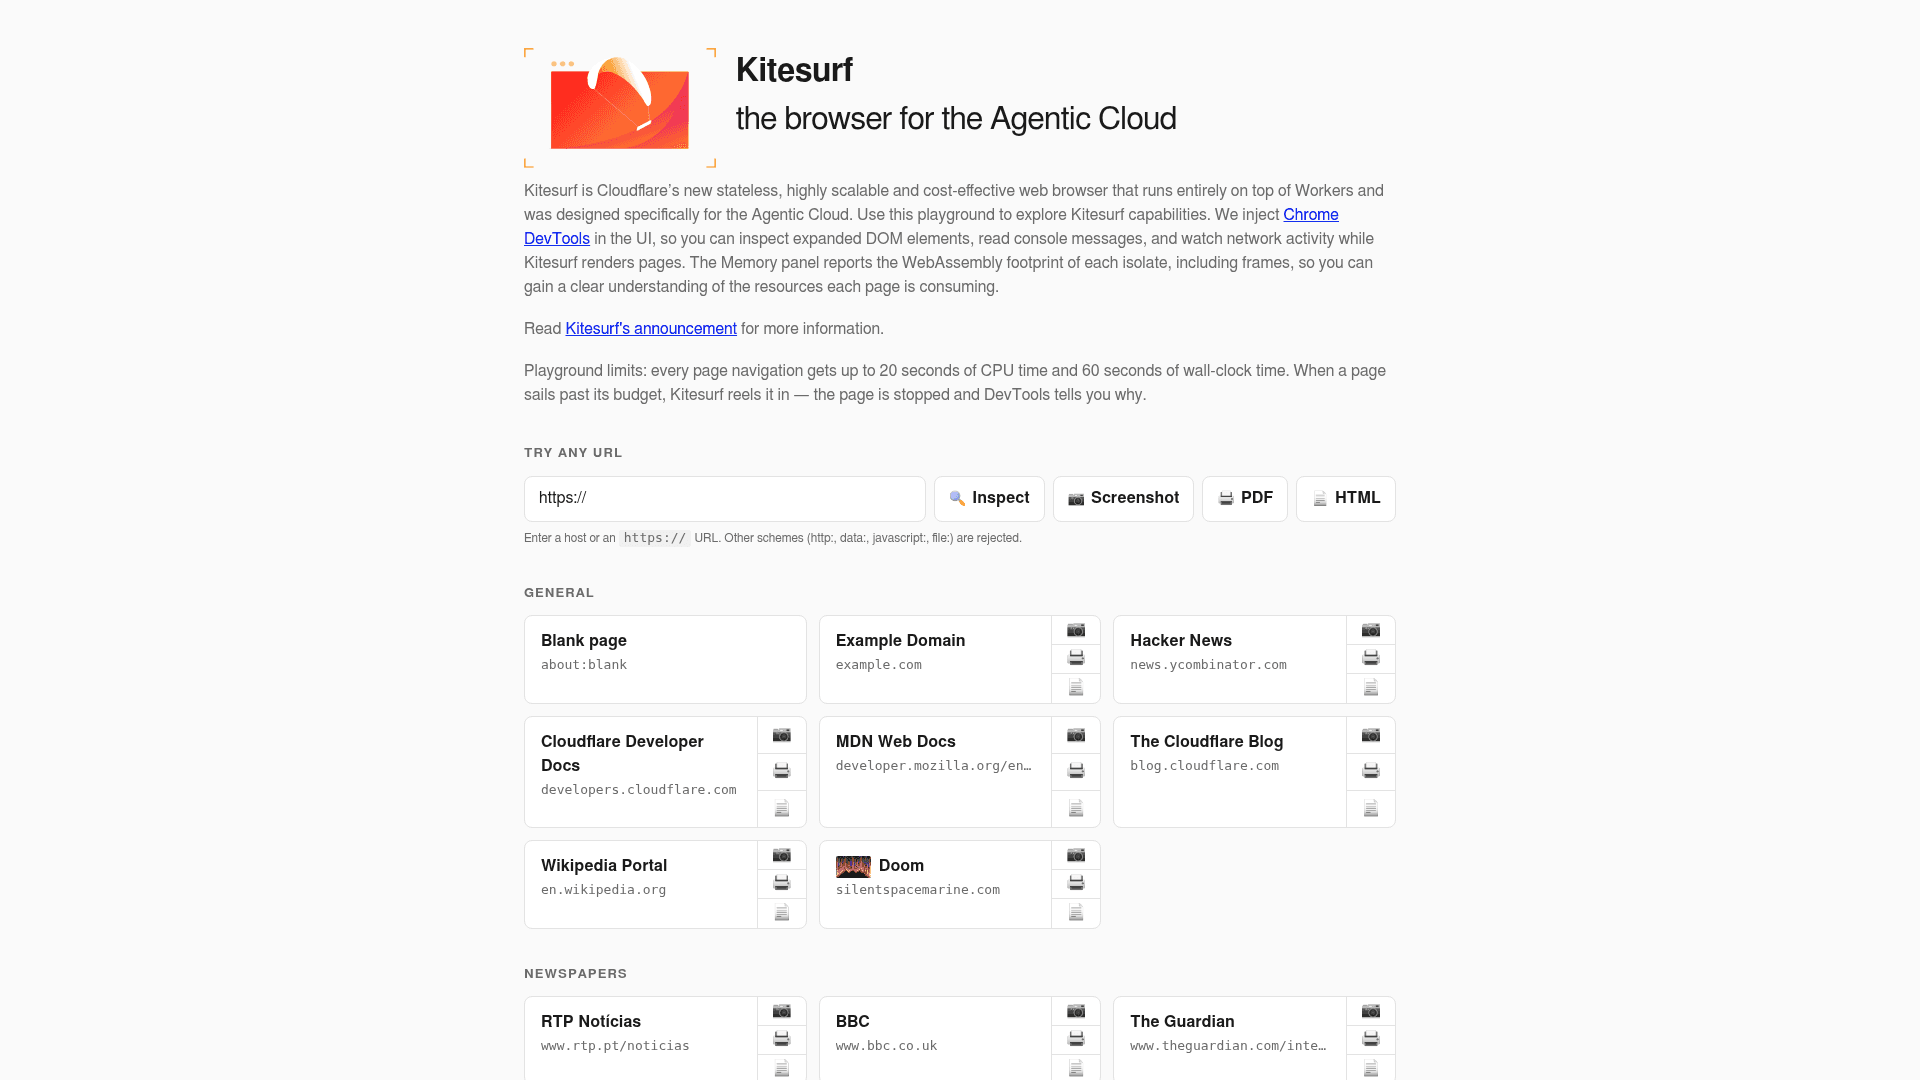
https:, uma pequena pista sobre o modelo de ameaças, capturado de kitesurf.cloudflare.app.O melhor recurso é o Chrome DevTools injetado. A Cloudflare implementou CDP o bastante para que o painel Memory informe a pegada de WebAssembly de cada isolate individualmente, então dá para ver para onde o custo de uma página realmente vai.
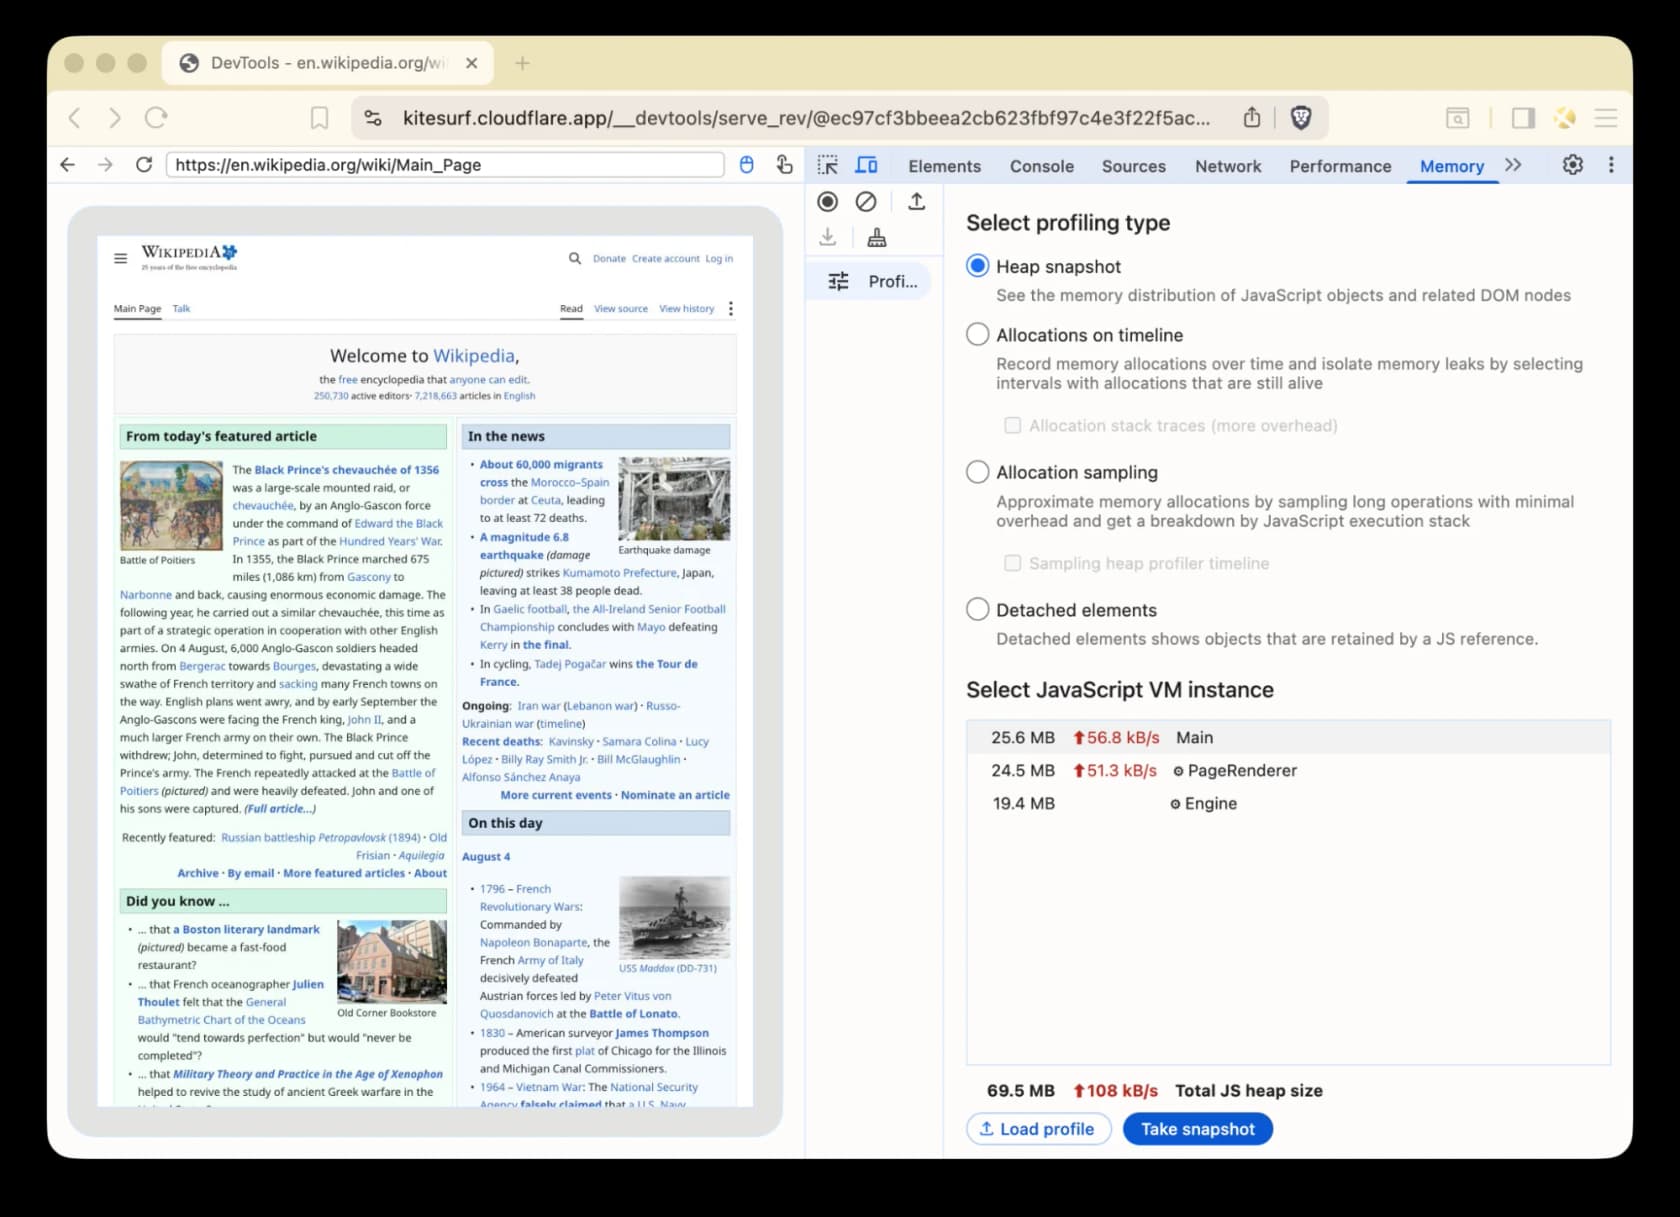
Nessa captura, uma sessão de inspeção ao vivo na página principal da Wikipedia informa Main com 25,6 MB, PageRenderer com 24,5 MB e Engine com 19,4 MB, ou seja, 69,5 MB de heap de JS no total. Vale destacar que isso fica acima do valor de 57,8 MiB do benchmark, e o motivo é que uma captura de benchmark é um único disparo, enquanto aqui são três isolates mantidos abertos com o DevTools conectado. Uma atribuição por componente assim é uma instrumentação incomumente boa para uma beta e, sinceramente, é para isso que eu o usaria primeiro. Se essas capturas depois vão para um modelo, o trabalho de Gemini agentic vision é a outra metade do pipeline.
O que isso significa se você está construindo um agente de suporte
Eu entrego integrações para viver, então minha leitura honesta é esta: o Kitesurf é uma primitiva muito boa e não um produto. A Cloudflare também o apresenta assim.
Se você constrói agentes que leem a web pública em volume, tirando capturas de páginas, extraindo texto de artigos, gerando PDFs, pré-renderizando para crawlers, vale testar um browser=kitesurf em um endpoint esta tarde. Esse é o teste inteiro. O padrão é o mesmo por trás de toda ferramenta de scraping como serviço.
Se você está avaliando opções nessa área, os textos sobre alternativas ao Firecrawl e Firecrawl vs Scrapy cobrem, respectivamente, o lado de comprar e o lado de construir por conta própria.
A pré-renderização é o caso discretamente útil. O Browser Run já traz um tutorial para devolver HTML pronto para crawlers a partir de um Worker, e se esse é o motivo de você estar lendo isto, então o que você está construindo na verdade é um agente de IA para SEO. Ligar a saída a um modelo também é um problema resolvido, seja por function calling ou por uma integração com o Claude.
Agora, se você está construindo um agente de IA para trabalhar uma fila de suporte, um navegador é quase a parte menos interessante de toda a pilha. Isto é o que mais de três anos nesse problema dizem que decide se funciona:
- Recuperação, não renderização. O agente precisa responder a partir da sua central de ajuda, das suas macros e dos seus tickets passados. Nada em um navegador faz isso, e é para isso que serve uma base de conhecimento com IA, e por isso treinar no seu próprio conteúdo vence um renderizador melhor sempre. O lado da recuperação é o jogo inteiro aqui, que é mais ou menos o argumento de RAG vs LLM.
- Identidade, exatamente como disse o tópico. Verificar o pedido de um cliente exige uma visão autenticada dos seus sistemas, e sessões autenticadas de longa duração são justamente o que o Kitesurf adia explicitamente. Uma integração por API resolve isso no primeiro dia, e é por isso que as ferramentas de automação de suporte são construídas em torno do helpdesk e não em torno do navegador.
- Saber a hora de parar. A maior objeção que a eesel ouve dos compradores nunca é a precisão em abstrato, é o controle. Um líder de CX de uma marca DTC de suplementos disse exatamente assim em uma ligação: "I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone." Isso é um problema de roteamento, e o motivo para priorizar a deflexão de nível 1 com um caminho de escalonamento limpo em vez de autonomia em todo lugar. É também a diferença prática entre agentes de IA e chatbots.
- Prova antes de entrar no ar. A Cloudflare testou o Kitesurf contra 235.000 subtestes antes de lançá-lo. O equivalente para um agente de suporte é reproduzi-lo sobre os seus próprios tickets históricos, e essa é a diferença entre uma demo e um rollout.
Esse último ponto também é a versão honesta de construir versus comprar. Vários clientes técnicos saíram da eesel para construir diretamente sobre a API do Claude, entre eles uma empresa de tecnologia de construção com AR e uma marca DTC de beleza. Um líder de engenharia de uma empresa de hardware de caixas eletrônicos de bitcoin que foi na direção oposta disse melhor: "We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain." O Kitesurf reduz o custo de um tijolo. A parede continua sendo sua, e os tijolos de que você realmente precisa são um pipeline de RAG, uma escolha de modelo para suporte e um lugar para colocar a automação de tickets.
Se o que você quer é a parede, a eesel se conecta ao Zendesk, Freshdesk, Gorgias, HubSpot ou Front em poucos minutos, lê a sua central de ajuda e os seus tickets passados, e depois deixa você ensaiar tudo sobre o histórico real antes que um único cliente veja. Ela também funciona como copiloto, se você preferir manter um humano no envio. Experimente a eesel, grátis, e veja o que um agente de suporte com IA realmente precisa acertar.
Conclusão
O Kitesurf é a coisa mais interessante que alguém lançou em automação de navegadores este ano, e os números por trás dele são publicados com detalhe suficiente para você discutir com eles, o que é mais raro do que deveria. Um motor de três meses com 235.000 subtestes, funcionando na Wikipedia, no Hacker News e no Doom, rodando em isolates, é uma conquista real. É também uma aposta bem diferente da categoria de consumo dos navegadores com IA, em que o produto é a interface e não o ambiente de execução.
Só seja preciso sobre o que ele entrega hoje. Ele entrega de 3 a 7 vezes menos uso de recursos em troca de 1,7 a 1,8 vez mais tempo de relógio, em uma tabela que cobra o tempo de relógio. Entrega uma migração de um parâmetro e uma lista honesta de quatro coisas que não consegue fazer. O que ele não entrega é uma forma de passar por um desafio anti-bot, e também não resolve a injeção de prompt. A Cloudflare diz as duas coisas em voz alta.
A economia é real. Ela só fica do lado da Cloudflare no balanço até existir um preço do Kitesurf para conferi-la. Para uma carga que lê a web pública em escala, teste esta semana. Para um agente que precisa realmente resolver o problema de um cliente, o navegador nunca foi a parte difícil. A conta que importa ali é o custo de um agente humano, não as horas de navegador.
Fontes
- Introducing Kitesurf - blog da Cloudflare, Celso Martinho, 7 de agosto de 2026, o anúncio do navegador voltado a agentes
- Kitesurf - documentação do Cloudflare Browser Run
- Browser Run pricing - documentação da Cloudflare
- Browser Run limits - documentação da Cloudflare
- Browser Run changelog - documentação da Cloudflare
- Automatic request headers - documentação da Cloudflare
- WebMCP - documentação da Cloudflare
- Kitesurf playground and benchmark corpus - Cloudflare
- Kitesurf on Hacker News - discussão do lançamento, 221 pontos, 63 comentários
- Blitz e obscura - repositórios de código-fonte