Resumo
Plantei 5 bugs de segurança em um pequeno app de tickets em Flask e rodei o scanner Codex Security da OpenAI, o mesmo que alimenta o Codex Security Cloud. Ele achou os 5, sem nenhum falso positivo, e escreveu um relatório de 55 KB com um modelo de ameaças e uma correção para cada um. A análise foi melhor do que a da maioria dos scanners estáticos que já usei.
Os problemas são o custo e o atrito. Esse app de 60 linhas levou quase 9 minutos e custou de US$ 3,75 a US$ 6,77 em tokens de API, e minha primeira tentativa falhou durante a configuração depois de gastar cerca de um dólar. O acesso por plano também é confuso. O post de lançamento da OpenAI diz Pro, Business, Enterprise e Edu, enquanto a própria matriz de preços diz só Enterprise e Edu.
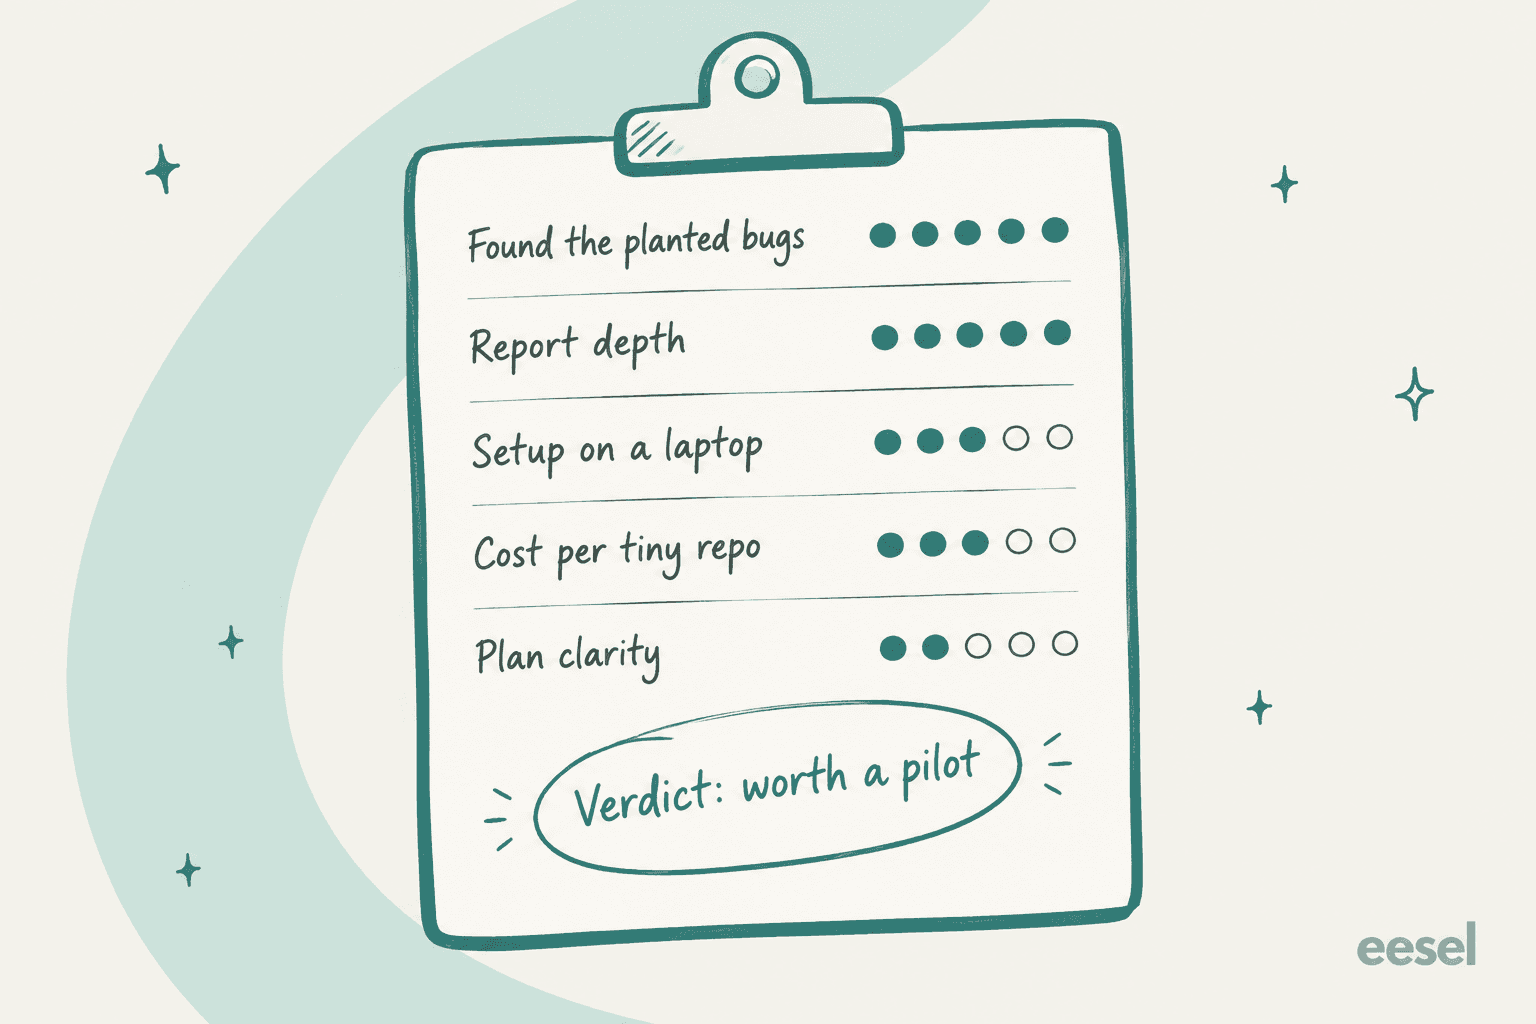
Meu veredito é 3,5 de 5. Vale um piloto em um repositório importante se você já paga ChatGPT Pro, Business ou Enterprise, mas não deixe que ele substitua o seu scanner baseado em regras. Eu construo integrações na eesel, que há mais de três anos coloca agentes de IA em filas de suporte reais, e a lição vale aqui. Prove o agente em trabalho antigo antes de confiar a ele trabalho novo.
O que é o Codex Security Cloud?
O Codex Security é o agente de segurança de aplicações da OpenAI dentro do OpenAI Codex. Ele lê o seu código e monta um modelo de ameaças, procura vulnerabilidades, verifica cada uma e ainda propõe uma correção. A versão Cloud foi lançada no DevDay em 29 de setembro de 2026 como um plugin que roda no Codex cloud contra repositórios do GitHub conectados. Segundo o resumo do DevDay da OpenAI, ele pode varrer repositórios inteiros "on demand or on a schedule, with ongoing checks of new commits," mesmo com o notebook fechado, o que é prático.
O principal avanço é o acesso ao Daybreak Blue, o modelo da OpenAI com menos recusas para trabalho de segurança defensiva, "without a separate Daybreak application." Isso importa porque, do que as pessoas reclamavam antes do Cloud, a queixa mais comum não eram achados ruins. Eram varreduras que rodavam por meia hora e depois eram recusadas. Meu post sobre o GPT-5.6-Cyber explica como funcionam os níveis Blue e Red.
Se você quer o tour completo de recursos, minha explicação do Codex Security Cloud percorre a configuração, as quatro superfícies e a história desde o Aardvark. Este post é o veredito.
Como testei
Não tenho um workspace de equipe com o plugin do Cloud ativado, então usei a coisa mais próxima. É a CLI do Codex Security de código aberto, que inclui o mesmo plugin do Codex Security e roda o mesmo pipeline a partir do terminal. Usei a versão 0.1.31 com os padrões dela: modelo gpt-5.6-sol com esforço de raciocínio xhigh no modo de varredura padrão, autenticado com uma chave de API da OpenAI.
O alvo do teste foi uma API interna de tickets minúscula que escrevi para isso. É um único arquivo Flask, com cerca de 60 linhas, mais um README de uma linha dizendo que roda em uma rede corporativa. Plantei cinco bugs clássicos:
- SQL injection em uma busca de tickets que concatena o e-mail do cliente na consulta.
- Path traversal no download de anexos, que junta um nome de arquivo fornecido pelo usuário a uma pasta.
- Command injection em uma rota de exportação de admin que passa um valor
formatao shell. - Falta de autorização em uma rota de exclusão, com um comentário
# TODO: only admins should do this. - Modo debug em todas as interfaces, com
app.run(host="0.0.0.0", debug=True).
São bugs fáceis, e esse é o ponto do teste. Se um agente de segurança deixa passar bugs de manual em 60 linhas, o resto nem importa. Se ele os pega, a pergunta interessante passa a ser quão bem ele os explica e quanto custa chegar lá.
Sobre o meu teste, vale registrar dois limites antes dos resultados. Primeiro, uma chave de API não dá acesso ao Daybreak Blue, então rodei com as proteções padrão, uma configuração mais dura quanto a recusas do que a do Cloud. Segundo, a varredura padrão da CLI validou os achados rastreando o código-fonte, e o relatório dela diz "no runtime query was executed." A documentação do Cloud descreve reproduzir os achados em um contêiner isolado, algo que não pude exercitar aqui.
O que o Codex Security encontrou
A segunda execução terminou em 8m 56s com cobertura completa. Este é o resumo que ele imprimiu:
FINDINGS  5 (5 confirmed this scan; 0 previously found; 2 high, 2 medium, 1 low)
COVERAGE  complete
ELAPSED   8m 56s
TOKENS    18,684 uncached input, 3,357,854 cache reads, 173,804 cache writes, 73,204 output, 3,623,546 total
COST      $3.7509776–$6.7699152 (standard, context unknown)
E assim os achados dele se alinham com o que plantei:
| O que plantei | Ele achou? | Severidade atribuída | Raciocínio dele |
|---|---|---|---|
Command injection em /admin/export | Sim | Alta | Uma única requisição sem autenticação dá execução de comandos; não chega a crítica porque o app é interno |
| Falta de autenticação na exclusão | Sim, ampliado para todas as rotas | Alta | Nenhuma rota verifica identidade, então qualquer cliente da rede pode ler, alterar e excluir tickets |
| Path traversal em anexos | Sim | Média | A fuga de caminho é direta, mas o impacto depende de quais arquivos a conta de serviço consegue ler |
| SQL injection na busca | Sim | Média | O SQLite do Python executa uma instrução por vez, então não há escritas empilhadas, só leitura de dados |
debug=True em 0.0.0.0 | Sim | Baixa | Expõe páginas de erro de depuração, e o console ainda exige um PIN para desbloquear |
Cinco de cinco, todos com confiança alta e nada inventado. Em um app de brinquedo, isso é o mínimo, não um troféu. O que mais me impressionou foi o raciocínio de severidade. A maioria dos scanners marcaria a SQL injection como crítica por reflexo, que é o hábito comum. Este notou que o sqlite3 do Python não executa instruções empilhadas, então o dano fica limitado a ler dados, e classificou como média, com uma nota sobre o que a elevaria. É o tipo de decisão que um bom revisor humano tomaria.
Ele também não parou no meu comentário TODO. Percebeu que a rota de atualização de status tinha a mesma verificação ausente e juntou as duas em um achado mais amplo: o app não tem autenticação nenhuma. É um enquadramento mais útil, já que corrigir uma rota só deixaria o resto aberto.
Como é o relatório
A pasta de saída tinha um report.md, um findings.json, um coverage.json e uma exportação SARIF que você pode enviar para a visualização de code scanning do GitHub. O relatório tem 55 KB para um app de 60 linhas, então não é uma ferramenta que economiza em detalhe.
Antes de qualquer achado, ele escreve um modelo de ameaças do seu app. Lista os ativos (o banco de tickets, a pasta de anexos, o acesso ao shell do processo), as fronteiras de confiança e o que um atacante realista consegue fazer. Chegou a apontar o que não conseguia ver. Minha rota de exportação chama um export.py que não existe no repositório, e o relatório diz isso em vez de chutar.
Cada achado recebe então uma justificativa de severidade, a evidência rastreada linha a linha, a "contraevidência" que reduziria o risco e uma seção de remediação com testes a escrever. Para a command injection, a correção diz:
"Require administrator authorization, remove
shell=True, invoke a fixed interpreter and script with an argument vector, and allowlist the supported export formats."
Isso está correto e também é específico. Ele sugeriu ainda dois testes: um verificando que metacaracteres de shell em format nunca iniciam um segundo processo, e outro verificando que quem não é admin não alcança a rota. Não passei --patch, então ele não escreveu código. No Cloud, o equivalente é o botão Fix with Codex, que redige um patch para você revisar antes de selecionar Create draft pull request, segundo o guia de configuração do Cloud.
Se você já usou o /security-review do Claude Code, isto é bem mais estruturado. O relatório se lê como um documento de auditoria, não como um comentário de código.
Onde ele tropeçou
Minha primeira execução falhou. A varredura passou dois minutos e meio na etapa de preparação e então saiu com "Scan agent did not create required draft artifacts" e uma pasta de saída vazia. Os logs mostraram que o agente não enxergava as configurações de ambiente de que precisava, incluindo o caminho do Python. Ele já havia usado 527.000 tokens de entrada, cerca de US$ 0,74 a US$ 1,40, para não produzir nada. A segunda execução funcionou depois que passei o caminho do Python explicitamente e deixei que herdasse o ambiente do meu shell.
Não fui o único a bater nisso. Uma issue aberta no repositório, a #73, descreve o mesmo padrão no Windows e no Linux: a varredura roda, os tokens são cobrados, depois o salvamento falha e "the 'partial output' directory is completely empty." A opção --max-cost da CLI não te salva aqui, e o FAQ da CLI da OpenAI diz que o limite é "an estimate, not a hard spending cap." Configurei em $4, e o extremo alto da minha estimativa final foi US$ 6,77.
Este é o argumento mais forte a favor do Cloud em relação à CLI. No Cloud, a OpenAI cuida do contêiner, do ambiente e da configuração do Python, então toda essa classe de falha de configuração local não deveria chegar até você.
O custo é razoável?
O custo foi o que me fez baixar a nota. Minha varredura usou 3,6 milhões de tokens em 60 linhas de código. O detalhamento explica por quê:
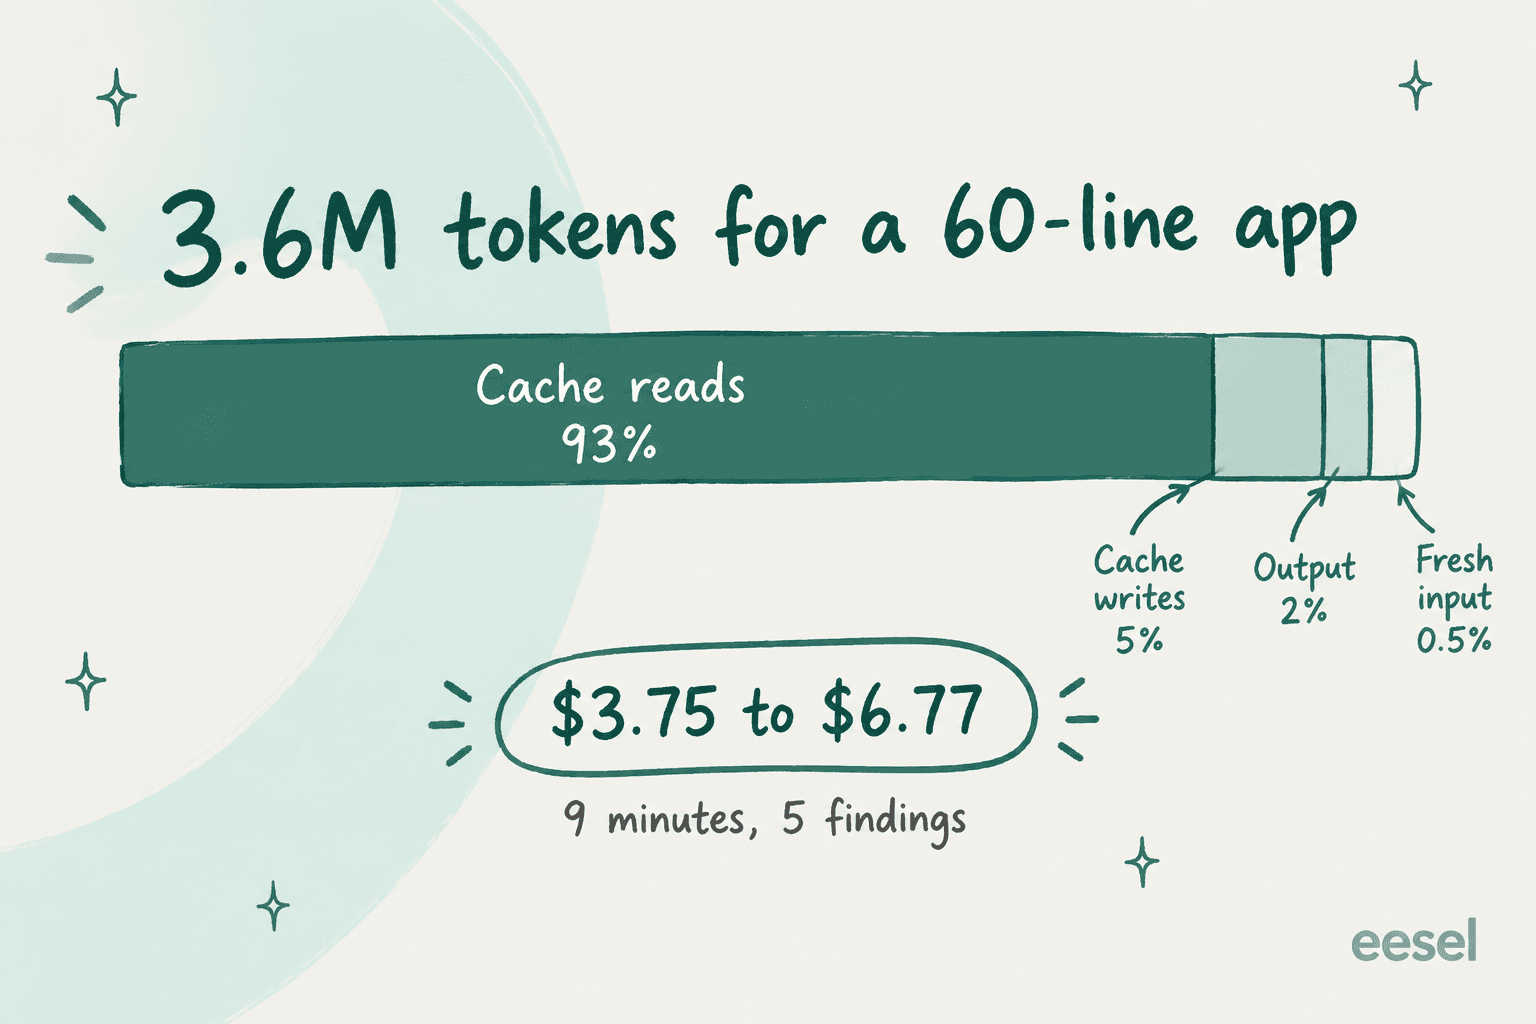
93% dos tokens foram leituras de cache. O agente relê as próprias instruções, o modelo de ameaças e o código repetidamente enquanto avança pela modelagem de ameaças, descoberta, validação, análise de caminhos de ataque e relatório. Boa parte é custo fixo, então um repositório maior não deveria custar proporcionalmente mais por linha. Mas significa que até uma varredura trivial custa alguns dólares, e o monitoramento de commits repete parte desse trabalho a cada push.
Na própria tabela de preços da CLI para o gpt-5.6-sol, as leituras de cache custam US$ 0,40 por milhão de tokens e a saída US$ 20 por milhão. A saída foi só 2% dos tokens, mas US$ 1,46 da estimativa baixa.
No Cloud, você não verá dólares. As varreduras consomem o uso de Codex incluído no seu plano e depois créditos. A página de preços da OpenAI diz "Daybreak Blue uses GPT-5.6 Sol credit rates," que são 100 créditos por milhão de tokens de entrada, 10 por milhão de entrada em cache e 500 por milhão de saída. É o dobro da tarifa do GPT-6 Sol.
Estes são os planos que podem ter o Cloud, segundo o resumo do DevDay e a mesma página de preços:
| Plano | Preço | Acesso ao Cloud | Caminho de excedente |
|---|---|---|---|
| Plus | US$ 20/mês | Não incluído | Não se aplica |
| Pro | US$ 100, 200 ou 500/mês | Sim, segundo o DevDay | Créditos do ChatGPT |
| Business | US$ 20/usuário/mês anual, US$ 25 mensal | Sim, segundo o DevDay | Créditos do workspace |
| Enterprise e Edu | Fale com vendas | Sim | Créditos do workspace ou pagamento por uso |
| Somente chave de API | Tarifas de API | Sem recursos na nuvem | Cobrado por token |
O quadro dos planos tem uma ruga. A matriz de recursos da mesma página de preços ainda marca "Codex Security for connected GitHub repositories" como só Enterprise e Edu. Eu confiaria no post mais novo do DevDay, mas também verificaria se o plugin aparece no seu próprio workspace antes de fazer upgrade por causa dele. Meu guia de preços do Codex explica mais sobre como os créditos são consumidos.
Para dar perspectiva à minha varredura, alguns dólares por varredura de repositório é barato comparado a uma hora de um engenheiro de segurança. É caro ao lado de um scanner baseado em regras que roda de graça em cada pull request. Por isso o modelo certo é usar os dois, não um ou outro.
A pegadinha do Daybreak Blue que a maioria vai perder
O Daybreak Blue é a melhor razão para escolher o Cloud, e vem com uma condição que não está no post de lançamento. Ele só vale quando você entra com o ChatGPT.
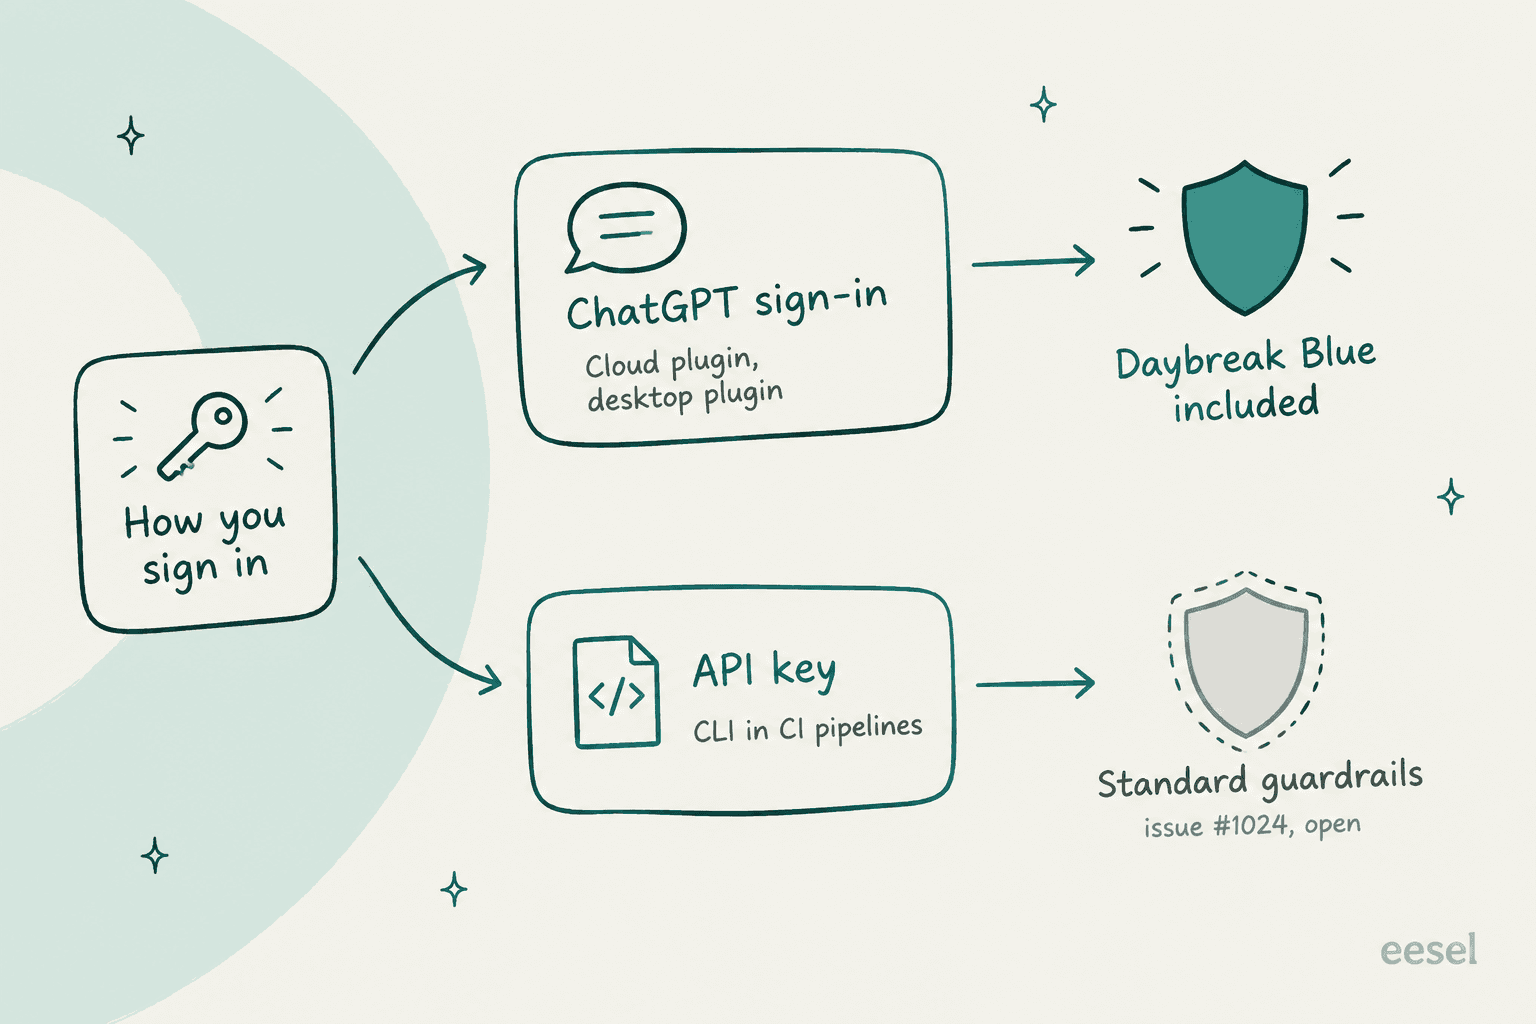
Uma issue aberta, a #1024, registrada por uma equipe que já está aprovada para o Daybreak Blue, relata que a versão fixada do Codex na CLI "filters out the cyber access program unless authentication is through ChatGPT." Ou seja, a seleção do Blue é descartada quando você usa uma chave de API, que é exatamente como a maioria dos pipelines de CI roda. O changelog do plugin confirma isso por outro ângulo: "Sessions that use only an API key can't verify account access."
Por que isso importa? Porque o problema das recusas é real. Quando a OpenAI abriu o código da CLI em julho, o tópico no Hacker News se encheu de gente que esbarrou nisso:
"Thing is, you WILL encounter refusals with Sol doing anything remotely adjacent to security work. Which for Codex Security is kinda... problematic."

Outro usuário viu uma varredura de uma pequena biblioteca de código aberto rodar por mais de 40 minutos e terminar com "This content was flagged for possible cybersecurity risk":
"it ran for over 40 minutes and during that time I had no idea what was happening, thought it was frozen or in a bad state. Also, it ate through 25% of my weekly credits :("
Para ser justo, não tive nenhuma recusa no meu app de teste, nem com as proteções padrão. Isso pode ser porque meus bugs são de manual e meu app é minúsculo. O tópico da issue desse erro, a #56, continua aberto. Minha leitura prática é usar o Cloud ou um plugin logado no ChatGPT para qualquer coisa séria, e tratar varreduras de CI com chave de API como uma barreira mais leve até a #1024 ser corrigida.
O que outros usuários dizem
Relatos práticos sobre o Cloud especificamente ainda são escassos, já que ele tem só dois dias. O tópico de lançamento no Hacker News não tinha comentários quando olhei. As vozes até agora vêm em sua maioria da CLI e da prévia anterior do plugin, que rodam o mesmo scanner.
A opinião positiva vem de Simon Willison, que o testou em prévia em abril:
"I've been previewing this in Codex for a few weeks - it's very good! Had some great results from it having it run security reviews against code written using other models"
As opiniões céticas se dividem em dois grupos. Alguns acham que é basicamente uma estrutura em volta dos modelos da OpenAI. A análise de um engenheiro no X resumiu a CLI como "just JS calling Codex in a loop." Eu discordaria um pouco. Depois de ler meu relatório de 55 KB, a estrutura claramente acrescenta organização que um prompt cru não teria. Mas é verdade que a qualidade vem do modelo.
O outro grupo se preocupa com a cobertura. Um comentarista do Hacker News, repassando publicações do mantenedor do curl, Daniel Stenberg, disse que tanto o Codex Security quanto o Claude Mythos não reportaram nenhum problema no curl antes que a varredura de outra ferramenta levasse a seis CVEs. É de segunda mão, mas ainda é um aviso justo. O melhor número que a OpenAI publica é da época do Aardvark, quando ele achou 92% das vulnerabilidades conhecidas nos próprios repositórios de teste "golden" dela, e ainda não há um comparativo público contra ferramentas baseadas em regras. Meu cinco de cinco foi em bugs que eu sabia que estavam lá. Um código maduro vai esconder os mais difíceis.
Como ele se compara às alternativas
O próprio FAQ do Cloud da OpenAI responde à pergunta da substituição em uma linha: "Codex Security complements SAST." Veja como as ferramentas mais próximas se comparam, segundo o que cada fornecedor publica:
| Ferramenta | Preço publicado | Verifica seus achados? | Propõe correções? | Melhor para |
|---|---|---|---|---|
| Codex Security Cloud | Uso de Codex incluído, depois créditos | Sim, reproduz em um ambiente isolado | Sim, você abre o PR em rascunho | Bugs que exigem raciocínio, em equipes com plano do ChatGPT |
| Claude Code Security | Sem preço público, prévia limitada | Reexamina cada achado | Sim, com aprovação humana | Equipes padronizadas no Claude Code |
| GitHub Code Security | US$ 30 por committer ativo/mês | Análise CodeQL baseada em regras | Sim, Copilot Autofix | Uma base determinística em cada PR |
| Snyk | Plano gratuito, Team a partir de US$ 25/mês | Reescaneia candidatos de correção | Sim, Snyk Agent Fix | Risco de dependências e de código aberto |
| Semgrep | Grátis até 10 contribuidores, Teams a partir de US$ 30/contribuidor/mês | Não informado | Orientação de remediação | Regras personalizadas que você mesmo escreve |
A configuração que eu rodaria é um scanner baseado em regras em cada pull request como base, pelos planos pagos do GitHub, Snyk ou Semgrep. Depois, adicionar o Codex Security Cloud em uma agenda para os bugs que uma regra não consegue expressar, como uma verificação de autenticação ausente que só faz sentido quando você entende o app inteiro.
Se sua equipe trabalha com o Claude Code, a integração com o GitHub dele dá o equivalente mais próximo no lado do PR. Para o panorama mais amplo, veja minha lista de alternativas ao OpenAI Codex. Equipes de segurança avaliando os modelos cibernéticos especializados devem começar pelo resumo de alternativas ao GPT-5.6-Cyber.
Prós e contras
| Prós | Contras |
|---|---|
| Achou os 5 bugs plantados sem falsos positivos | Um app de 60 linhas custou de US$ 3,75 a US$ 6,77 e levou 9 minutos |
| Decisões de severidade com raciocínio real, não por reflexo | Minha primeira execução falhou na configuração e ainda cobrou cerca de US$ 1 |
| Modelo de ameaças, evidência e testes para cada achado | O acesso por plano é contraditório entre as próprias páginas da OpenAI |
| Exportação SARIF para o code scanning do GitHub | O Daybreak Blue ainda não vale para varreduras de CI com chave de API |
| Nunca aplica um patch sem uma pessoa | Sem benchmark público contra ferramentas SAST, só números da própria OpenAI |
Mais uma coisa a observar é que o repositório avança rápido. Um commit mesclado há dois dias, visível no repositório do GitHub, troca o modelo padrão da CLI para o GPT-6 Sol em xhigh. A versão do npm que instalei ainda usava gpt-5.6-sol por padrão. Se isso chegar, as varreduras devem ficar mais baratas, já que a tarifa de créditos do GPT-6 Sol é metade da do GPT-5.6 Sol.
Quem deve usar o Codex Security Cloud?
Use se você está no ChatGPT Pro, Business, Enterprise ou Edu, seu código está no GitHub e você não tem um engenheiro de segurança revisando cada mudança. É uma segunda opinião forte sobre os bugs de lógica que ferramentas baseadas em regras deixam passar, e os relatórios são bons o bastante para entregar a um desenvolvedor do jeito que estão. Comece com a varredura de um repositório no seu serviço mais sensível, confira seu painel de uso antes e depois, e só então ative o monitoramento de commits.
Pule se a sua política diz que o código-fonte não pode sair do seu ambiente. Não é um scanner offline, e como um membro da equipe da OpenAI explicou no Hacker News, código e contexto vão para o modelo hospedado da OpenAI. Pule também se você está no Plus, ou se precisa de uma barreira barata e determinística em cada pull request. Isso é trabalho para CodeQL ou Semgrep.
Espere se você planejava rodá-lo sem interface a partir do CI com uma chave de API. Até o problema do Daybreak Blue ser corrigido e as falhas de salvamento se acalmarem, a CLI no CI é a forma mais fraca de usá-lo.
Comparado a outros lançamentos recentes da OpenAI, como o sempre ativo OpenAI Dots e o GPT-6.1 Sol, este é o que parece mais perto de estar pronto para produção. Ainda está rotulado como prévia de pesquisa, então ajuste suas expectativas à versão que você tem na frente.
Experimente a eesel para a fila que nunca para
O Codex Security faz um único trabalho, encontrar e explicar bugs de segurança, e ganha confiança mostrando suas evidências antes que uma pessoa aja. É a mesma forma dos colegas que construo na eesel. A eesel é uma plataforma de colegas de IA com dois perfis prontos para trabalhar hoje: um colega de IA para helpdesk que entra no Zendesk, Freshdesk, Gorgias ou Front, e um redator de blog com IA para conteúdo e SEO.
Em suporte, a lição da minha varredura se aplica direto. Confiança não é o mesmo que estar certo. Uma equipe B2B de telemática veicular no Zendesk viu um bot responder "sim, damos suporte ao modelo do seu carro" para marcas que não estavam no banco de dados deles, só porque a base de conhecimento dizia "damos suporte a todos os modelos". Por isso a eesel roda primeiro o colega de helpdesk contra centenas dos seus tickets antigos em uma simulação, para você ver cada resposta que ele teria enviado antes que ele toque em um cliente real. Ações fora das regras dele esperam aprovação humana, como um PR em rascunho esperando a sua revisão.

Se o lado de CLI do Codex Security te atraiu, a eesel também tem uma. A CLI da eesel opera o mesmo colega e workspace que você vê no painel, a partir de um terminal ou de um script. eesel approvals list mostra o que está esperando uma pessoa, e eesel activity lista cada execução para você auditar o que o colega fez. Agentes de programação como o Codex e o Claude Code também podem controlá-la, porque cada workspace funciona também como um servidor MCP. Meu guia de CLI para agentes de IA explica por que isso importa.
Os preços são públicos: um plano gratuito com 100 créditos, depois planos a partir de US$ 299/mês por 500 créditos, em que um ticket ou chat é um crédito, segundo a página de preços. Experimente a eesel e rode o colega de helpdesk nos seus próprios tickets antigos na mesma tarde. Minha explicação sobre os colegas de IA cobre o modelo com mais profundidade.
Perguntas frequentes
O Codex Security Cloud vale a pena?
Qual é a precisão do Codex Security Cloud?
Quanto custa uma varredura do Codex Security Cloud?
Quais planos do ChatGPT incluem o Codex Security Cloud?
Posso usar o Codex Security Cloud com uma chave de API?
O Codex Security Cloud corrige os bugs que encontra?
Quais são as melhores alternativas ao Codex Security Cloud?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.