

Groq 3 LPXは、Vera Rubinプラットフォーム向けにNVIDIAが提供する、ラックスケールの低遅延推論アクセラレータです。実に見事な製品ですが、ほとんどのチームがそのまま買えるものではありません。Vera Rubinの導入の一部として出荷され、ラックスケールのインフラであり、これまでに本番稼働させているのはNebiusのようなクラウドだけです。そのため代替を探しているなら、ほぼ間違いなく次の2つの現実的な問いのどちらかを抱えているはずです。今すぐ実際に使える高速推論の選択肢はどれか、あるいは、自社のプラットフォームはどのシリコンに賭けるべきか、です。
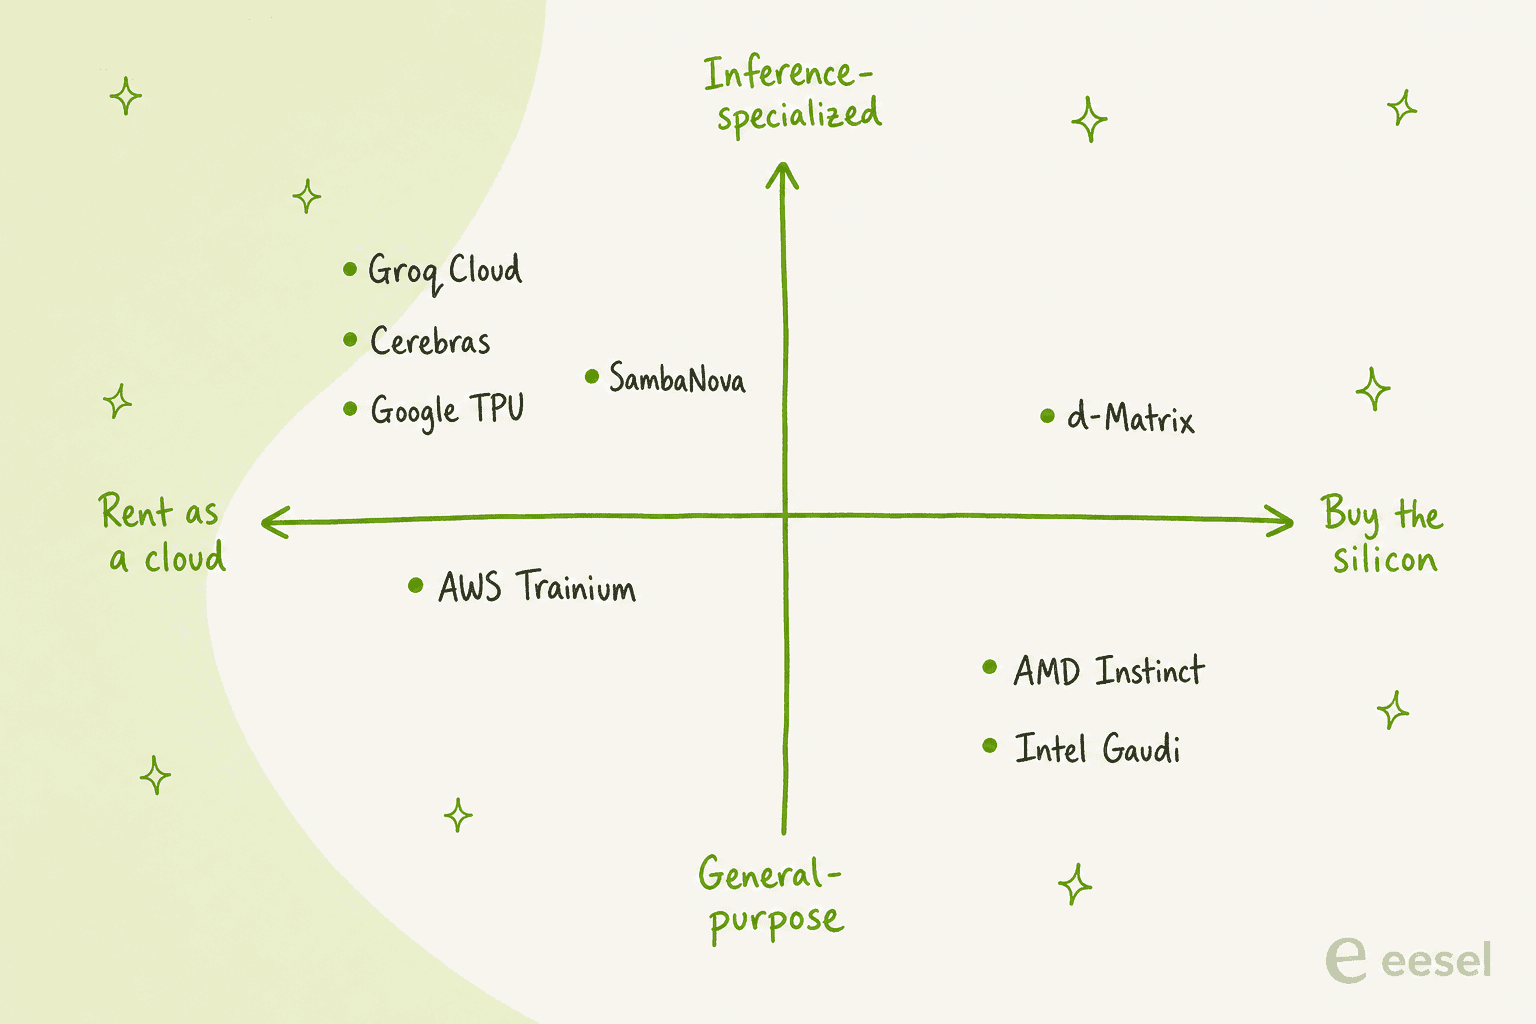
入手方法ごとに分けた、検討したい8つを紹介します。
- 今日からAPIで使う: Cerebras(単一ストリームの純粋な速度)、SambaNova(最大級のオープンモデルとエージェント処理)、独立したGroqクラウド(NVIDIAのラックを待たずに使えるGroqのLPU)。
- ハイパースケーラーのシリコンを借りる: Google TPU Ironwood(Google Cloud、推論重視)とAWS Trainium(AWS内で最高のトークン単価)。
- ハードウェアを所有する: AMD Instinct(GPUあたりのメモリが大きく、ソフトウェアはオープン)とIntel Gaudi(コストパフォーマンスと標準Ethernet)。
- 専業メーカーに早めに賭ける: d-Matrix Corsair(低遅延のために作られたインメモリコンピュート)。
正直な捉え直しであり、最も持ち帰ってほしい点はこれです。自分でクラウドを運営しない限り、これらのどれも買うことはありません。すでに使っているAPIの中で、より速く安いトークンとして体感することになり、実際に導入するのはその上で働く担い手、たとえばAIヘルプデスクエージェントです。そこにeeselがあります。
なぜGroq 3 LPXの先を見るのか
まず、現行の本命に公平であるべきです。これは本格的なエンジニアリングの成果です。Groq 3 LPXは、Vera Rubin向けのNVIDIAの推論アクセラレータで、GroqのLPU設計を非独占ライセンスのもとで採用しています。各ラックにはRubin GPUと並んで動く256個のLPUチップが載り、NVIDIAは100KコンテキストのGemma 4 31Bで毎秒3,400トークンというベンチマークを示しています。速く、アーキテクチャも巧みです。
それでも他を見る理由は、ごく実務的なものです。
- 気軽には買えません。 LPXはVera Rubin NVL72のラックスケール拡張であり、サーバーに挿すカードではありません。ほとんどのチームにとって購入判断ではなく、データセンターへのコミットメントです。
- 入手性が乏しいです。 NVIDIAは2026年8月に量産開始を発表しましたが、導入した最初のクラウドがNebiusというだけです。今すぐ容量が欲しいなら、待ち行列は短く、提供事業者の一覧はさらに短いのが現状です。
- 数字はNVIDIA自身のものです。 目玉である1メガワットあたり35倍のスループットは、NVIDIAの前世代との比較です。筋の通った主張ですが、ベンダーの主張であり、第三者のテストはまだ出揃っていません。
- ロックインです。 LPXはVera Rubin構成の中でしか意味を持ちません。スタックやクラウド、予算が別の方向を向いているなら、それは強い依存になります。
これらはLPXが悪いという意味ではありません。ただ、多くの人にとって「Groq 3 LPXを使うべきか?」は問いが間違っているということです。より良い問いは「高速推論をどこから調達するか」で、これには良い答えがたくさんあります。
選び方と、このリストの読み方
私はプロダクト側の人間なので、スライド上のベンチマークが良いものより、実際に導入できるものに重きを置いています。各ベンダーのドキュメント、料金、仕様書を読み、速度の数字がある場合はベンダーの公表値を使い、その旨を明記しました。ランキングを形作った要素は3つです。
- 今すぐ使えるか? 今日の午後に叩けるAPIは、順番待ちするラックに勝ります。アクセスのしやすさを重く見ています。
- 実際のワークロードは何か? 高速な単一ストリームのチャット、巨大なオープンモデル、安価なバッチ処理は別々の仕事で、向くチップも異なります。
- 付き合うコストはどれくらいか? 借りるか買うか、縛られるソフトウェア、そして総所有コストは、ピークのFLOPSより重要です。
はっきり述べておくべき注意点があります。この世代のハードウェアについてコミュニティの声はまだ薄く、実運用の期間がほとんどないからです。以下の見解は、一次情報の仕様と数少ない実際のベンチマークに基づいており、長年のユーザーレビューに基づくものではありません。実際の声があるところは引用しています。
詳しく見る前に、全体像を一覧で示します。
| 代替 | 種類 | 入手方法 | 推論性能の目玉(ベンダー公表値) | コストの目安 | 向いている用途 |
|---|---|---|---|---|---|
| Groq (GroqCloud) | LPU推論クラウド + チップ | 今日からAPI、トークン従量 | 小〜中規模モデルで最速 | トークン従量、公開 | NVIDIAのラックを待たずにGroq LPUの速度を使いたい |
| Cerebras | ウェハースケール (WSE-3) | API + CS-4/CS-3の購入 | 約3,000 tok/s (GPT OSS 120B) | 100万あたり入力$0.35 / 出力$0.75 | 単一ストリームの純粋な速度 |
| SambaNova | RDU、3階層メモリ | API + オンプレラック | 約850 tok/s (MiniMax M2.7) | 100万あたり入力$0.22 / 出力$0.59 (gpt-oss-120b) | 最大級のオープンモデル、エージェント、オンプレ |
| Google TPU (Ironwood) | 独自ASIC | Google Cloudのみでレンタル | 4,614 FP8 TFLOPs/チップ | チップ時間あたり$12.00から | すでにGCPを使うチーム、ハイパースケール配信 |
| AWS Trainium | 独自ASIC | AWSのみでレンタル | Trn2: H200比で価格性能30〜40%向上 | Inf2は$0.76/時から | AWS内でより安いトークン |
| AMD Instinct | GPU (CDNA) | 購入、またはクラウドパートナー経由 | MI355X: 288 GB HBM3E、8 TB/s | 設備投資 / 見積もり | シリコン所有、メモリを多く使うモデル、ロックインなし |
| Intel Gaudi 3 | AIアクセラレータ | 購入、またはIBM Cloud経由 | 128 GB HBM、1,200 GB/s Ethernet | 「半分のコスト」という位置づけ | コスト重視の購入者、Ethernetネイティブの環境 |
| d-Matrix Corsair | インメモリコンピュート (DIMC) | ハードウェアの購入のみ | 60,000 tok/s (Llama3 8B、サーバー) | 設備投資 | 遅延にこだわり早めに賭けたい人 |
| Groq 3 LPX (現行の本命) | LPU + GPUラック | クラウド経由 (Nebius) | 3,400 tok/s (Gemma 4 31B) | データセンター規模 | ハイパースケールのエージェント推論 |
どの行が自分か分からない場合は、このピッカーでワンクリックで候補を絞れます。
1. Groq (GroqCloud): 今日から実際に使えるGroqのLPU
向いている用途: NVIDIAのラックが自社クラウドに届くのを待たず、GroqのLPUの低遅延な速度を今すぐAPIで使いたいチーム。
多くの人がつまずく意外な展開があります。Groqという会社は今も存在し、GroqCloudを運営し、同社を有名にした同じLPUの速度を今も販売しています。NVIDIAがGroqの技術をライセンスしたのは、非独占の契約とチームの移籍であって、事業の閉鎖ではありません。Groqは新CEOのもとで独立を保ち、GroqCloudは中断なく稼働し続けました。Xのある反応が、この混乱を的確に捉えていました。
"so groq the company is now also an nvidia product line, that's going to confuse people for months"
つまり、LPXに惹かれた理由がLPUの速度なら、最も直接的な「代替」はしばしば元祖のGroqCloudそのものです。OpenAI互換のAPI、決定論的な低遅延のトークン生成が手に入り、身近にVera Rubinの導入が来るのを待たず、今日から始められます。Hacker Newsでは、鋭い意見の一つがLPXのベンチマークをGroqの既知の強みの延長として読んでいました。
"Gemma 31B dense at 3k TPS seems like a pretty big deal. Groq has always been more efficient than Cerebras at running very small models and this release seems to be no exception."

長所: 今日使える、使い慣れたAPI、小〜中規模モデルに強い、NVIDIAがライセンスしたのと同じLPUの系譜。短所: ブランドの混乱は現実にあり、最大級のモデルは他のほうが適しています。コストの全体像は、Groqの料金と、より広いGroqの代替を別記事で解説しています。
料金とアクセス: セルフサービス、GroqCloudでトークン従量課金。評価: LPUが理由で「Groq 3 LPX」に目が留まったなら、他の何よりも先にここから始めてください。本物への最短ルートです。
2. Cerebras: 純粋な速度で最も近いライバル
向いている用途: APIでも自社システムでも、小〜中規模モデルでの単一ストリームの純粋なトークン速度。
Cerebrasは「最速の推論」の話になると必ず出てくるもう一つの名前で、それには十分な理由があります。Wafer-Scale Engineはディナープレートほどの大きさの単一チップで、4兆個のトランジスタ、90万コア、1枚のシリコンで125ペタフロップスを備えます。CerebrasはNVIDIA B200の19倍のトランジスタ数だと述べています。設計思想の全体は、小さなチップをネットワークでつなぐクラスターの正反対です。
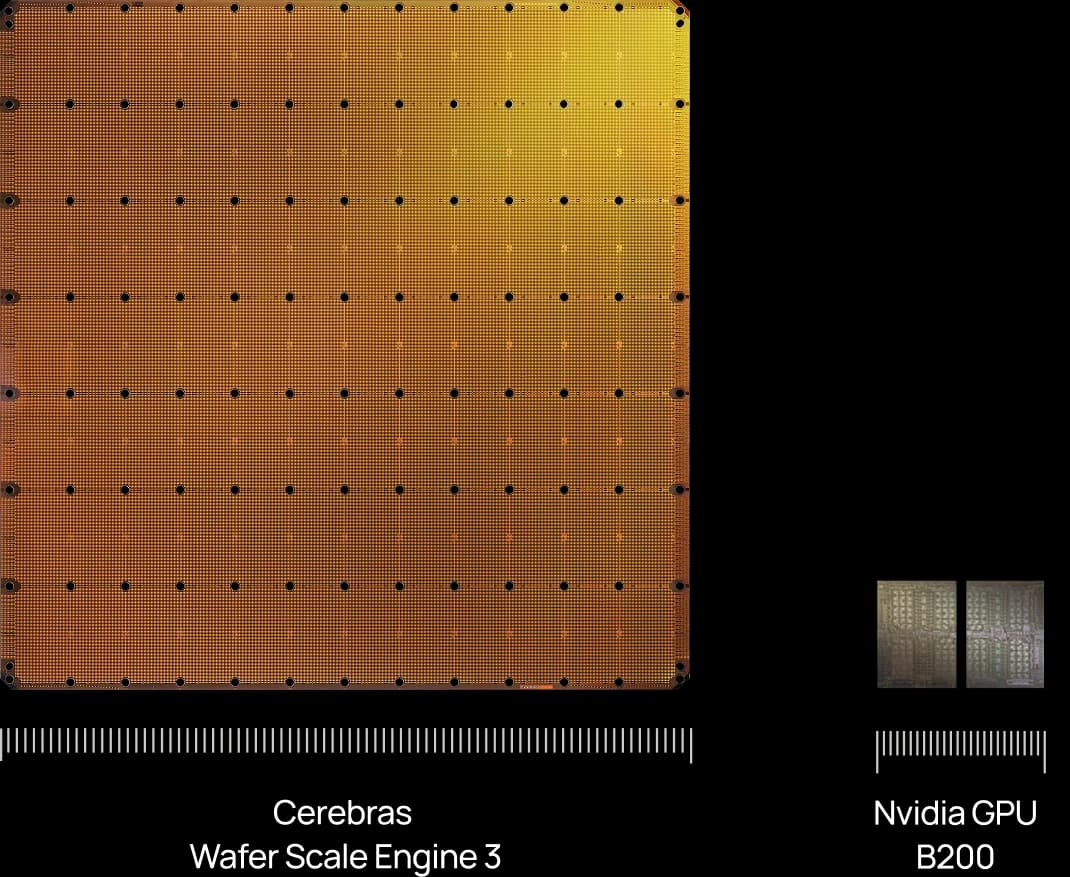
実際に使う部分はCerebras Inferenceで、速度に強く振り切ったOpenAI互換のクラウドです。料金ページはOpenAIやAnthropicより20倍速いと謳い、新しいCS-4システムは「GPUと比べて最大30倍高速な推論」をうたいます。具体的には、CerebrasはGPT OSS 120Bで毎秒約3,000トークン、Gemma 4 31Bで約1,800トークンとしています。
長所: カテゴリ首位級の単一ストリーム速度、すっきりしたトークン従量のAPI、OpenAI、Meta、Perplexityといった導入事例。短所: オンプレで導入するならウェハースケールのシステムは大きな買い物で、公開の料金表には数モデルしか載っていないため、特定のワークロードの予算組みには営業との相談が必要です。
料金とアクセス: 開始時に$5分の無料クレジット、その後は$10からのDeveloperティアでトークン単価を公開(GPT OSS 120Bは100万トークンあたり入力$0.35 / 出力$0.75)。さらにEnterpriseと、販売されるCS-4/CS-3システム。評価: 重視するのがCerebrasの提供モデルでの毎秒トークン数だけなら、このリストで最も強力な代替で、Groqと真っ向から競合します。
3. SambaNova: 大きなオープンモデルとエージェント向けに設計
向いている用途: 最大級のオープンモデルを高速に動かす、エージェント処理のために多数のモデルを常駐させる、あるいは自社データセンター内で推論を提供する場合。
SambaNovaの2026年の売り文句は「プレミアム推論」で、差別化要因はメモリです。Groqの設計がチップあたりの容量は小さいがSRAM帯域は巨大という賭けなのに対し、SN50 RDUは3階層を使います。オンチップSRAM 432 MB、HBM2E 64 GB、最大512 GBのDDR5です。これにより複数の大規模モデルを読み込んだまま、最小限の遅延で切り替えられます。共同創業者のKunle Olukotunは、これをエージェントにとっての「ゴルディロックス・ゾーン」と呼んでいます。
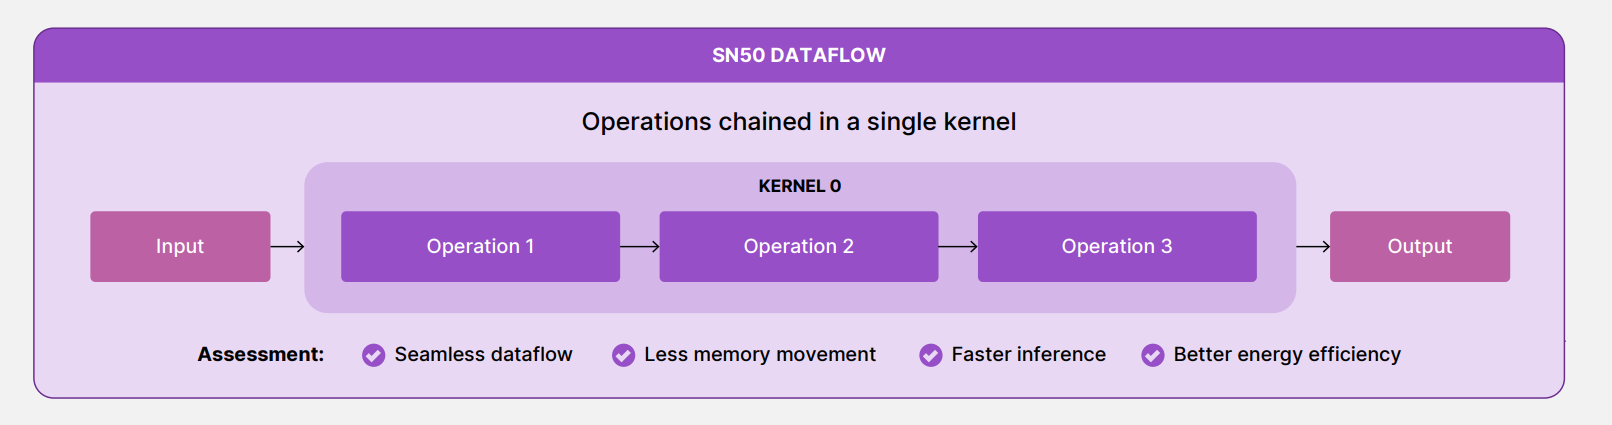
最も信頼している速度の裏付けは第三者のものです。Artificial AnalysisがSN50を計測したところ、MiniMax M2.7が短いコンテキストで最大毎秒850トークン、長いコンテキストでも450トークン超で動き、世界最速のMiniMaxと評されました。巧みな点もあります。SambaNovaはNVIDIAと競うより組み合わせる方向に進んでおり、計算負荷の高いprefillにGPUを、メモリ律速のdecodeにRDUを使っています。
長所: 3階層メモリが巨大モデルや複数モデルのエージェント処理に合う、オープンモデルの料金公開、ソブリンや企業向けの確かなオンプレの選択肢、評価額110億ドルでの最近の10億ドルの調達。短所: GroqやCerebrasほど「小さなモデルで最速」に特化しておらず、最大規模の導入は営業への問い合わせが必要です。
料金とアクセス: SambaNova Cloudはトークン従量のAPI(gpt-oss-120bは100万トークンあたり入力$0.22 / 出力$0.59、DeepSeek-V3.1は$3.00 / $4.50)で、オンプレ向けにはSambaRackシステムがあります。評価: ワークロードが大きなオープンモデル、または複数モデルを同時に使いこなすエージェントなら最適で、自社データセンターで必要ならなおさらです。
4. Google TPU (Ironwood): ハイパースケーラーの答え
向いている用途: すでにGoogle Cloudを使っているチームと、単一の低遅延マシンではなくハイパースケールの配信容量が必要な人。
Groq 3 LPXが「NVIDIAの推論ファーストのチップ」を表すなら、Ironwoodは同じ発想のGoogle版です。GoogleはIronwoodを第7世代のTPUであり「推論のために特別に設計された初めてのもの」と呼び、「推論の時代」と推論モデルのために作られたとしています。各チップは4,614 FP8 TFLOPsと約7.37 TB/sの192 GB HBMを備え、フルのスーパーポッドは水冷の9,216チップを結び、42.5 ExaFLOPsと1.77ペタバイトの共有HBMを実現します。
Groqとの最も鮮明な違いは購入モデルです。TPUは買えません。レンタル専用で、Google Cloud専用で、チップ時間単位の課金です。ただしスケールの話は本物です。Googleの代表的な顧客はAnthropicで、Claudeの学習と提供のために最大100万基のTPUを利用する計画です。
長所: 推論ファーストの設計、巨大なポッド規模、大規模時の高い価格性能、移植性の道筋(TPU上のvLLMにより、軽微な設定変更でGPUとTPUを行き来できる)。短所: Google Cloudへの完全なロックイン、買えるカードがない、オンデマンドのIronwoodは安くない。
料金とアクセス: チップ時間単位でレンタル、us-central1のオンデマンドで$12.00から、3年コミットなら$5.40まで下がります。評価: すでにGoogle Cloudにいる、または高速な単体マシンではなく配信フリートが必要なら、Ironwoodは自然な代替です。自分で管理できるシリコンが欲しいなら、その正反対です。
5. AWS Trainium: AWS内で最高のトークン単価
向いている用途: AWS上でより安いトークンが欲しく、ピーク速度を追うよりBedrockやEC2経由で提供することに満足しているチーム。
AWSの売りは「最速」ではなく「トークンあたり最安」で、これは本当に別の軸です。Trainiumは今や学習だけでなく推論向けにも位置づけられています。AWSは、Trn2インスタンスがNVIDIA H200ベースのP5e・P5enインスタンスより価格性能で30〜40%優れると主張し、発表済みのTrainium3(初の3nm AIチップ)はTrn2 UltraServerの最大4.4倍の性能をうたいます。旧来のInferentia2系列は、Inf2インスタンスで価格性能40%向上、ワットあたり性能50%向上を主張しています。
目玉の実績はAnthropicで、Trainiumのページに直接引用されています。レイテンシ最適化されたClaude 3.5 Haikuが、Bedrock経由でTrainium2上で60%高速に動作し、Project Rainierは数十万のTrainium2チップのクラスターです。
長所: AWS内での確かなコスト削減、BedrockとSageMakerとの深い統合、最大規模の処理向けのラックスケールUltraServer(Trn2は64チップ、Trn3は144チップ)。短所: AWS専用でレンタル専用であり、CUDAではなくNeuron SDKで動くため、一般的なPyTorchやvLLMの処理は簡単に移せますが、手書きのCUDAカーネルは移植が必要です。
料金とアクセス: EC2でレンタル、またはBedrock経由で利用。Inf2はオンデマンドで時間あたり$0.76〜$12.98の公開料金があり、Trn2とTrn3のUltraServerは見積もり制です。評価: インフラがすでにAWSにあるなら、これが価格性能の一手です。特に、最後の数ミリ秒よりトークン単価が重要な安定的な配信に向きます。
6. AMD Instinct: シリコンを所有し、メモリを多く保つ
向いている用途: 汎用のシリコンを購入し、大きなモデルをメモリに常駐させ、NVIDIA一辺倒のスタックを避けたいチーム。
自分で所有できる本物のGPUが欲しいなら、AMDがNVIDIAに対する主な代替であり、推論に関する主張はすべてメモリです。出荷中のMI355Xは8 TB/sの288 GB HBM3Eと10.1 PFLOPsのMXFP4を備え、発表済みのMI400シリーズは23.3 TB/sで最大432 GBのHBM4に達します。AMDは、MI455XとMI430XがNVIDIAのVera Rubin GPUより50%多くのメモリ容量を持つと主張しており、より大きなモデルや長いKVキャッシュを分割せず1チップに載せられる点で重要です。
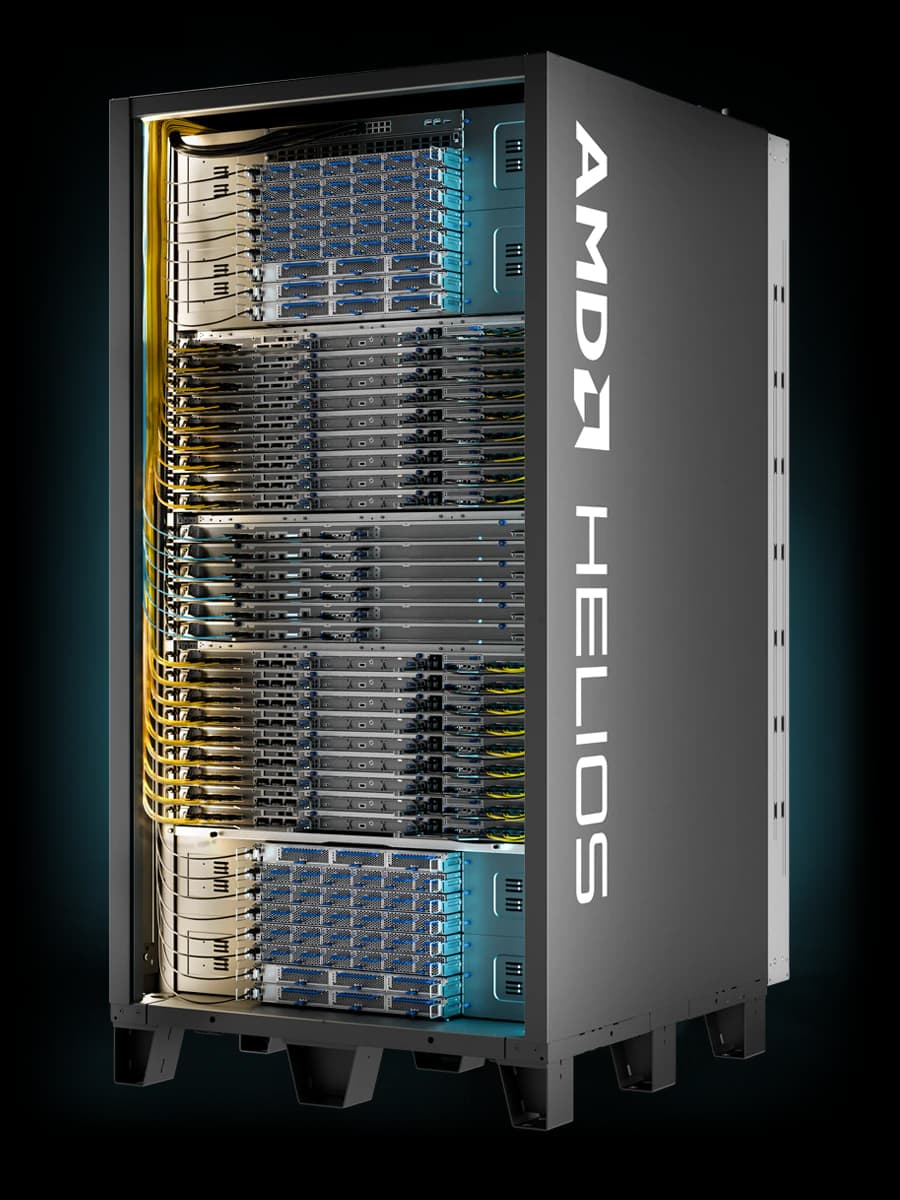
ラックスケールでは、AMD Heliosシステムが72基のMI455X GPUを搭載し、最大2.9 exaFLOPSのMXFP4と31 TBのHBM4を実現します。ソフトウェアはオープンなROCmスタック(現在はROCm 10.0)で動き、配信にはvLLMとSGLangを使います。
長所: NVIDIAの同等品よりGPUあたりのHBMが大きい、オープンなソフトウェアスタック、本物のラックスケールの選択肢、独自ファブリックへのロックインがない。短所: ROCmは大きく追い上げましたが、CUDAと比べたエコシステムの成熟度が正直な弱点であり、最も強い仕様の一部はまだ出荷されていないMI400世代のものです。
料金とアクセス: OEM経由で購入するか、DigitalOceanやVultrなどのパートナー経由でAMD Developer CloudのMI300Xを試せます。評価: 推論用シリコンを所有し、メモリを大量に使うモデルを動かし、ソフトウェアの選択肢を開いておきたいなら定番の選択です。競うのは容量とオープンさであり、最速の単一ストリームではありません。
7. Intel Gaudi 3: コストパフォーマンスと標準Ethernet
向いている用途: 有能なアクセラレータが欲しく、独自ファブリックではなく標準Ethernetでスケールさせたいコスト重視の購入者。
IntelのGaudi 3はコストパフォーマンスで勝負し、その特徴はネットワークへの賭けです。すべてのGaudi 3アクセラレータには、カード上に200 GbE RoCEが24ポート組み込まれ、標準Ethernetで双方向1,200 GB/sの帯域を実現します。Intelの打ち出しは、あなたに選んでほしい取引について率直です。「NVLink、NVSwitch、InfiniBandのようなロックされた独自技術」を避け、すでに持っているネットワーク機器を使うというものです。計算面では、3.7 TB/sの128 GB HBMと1.8 PFLOPSのFP8を備えます。
ロードマップについて知っておくべき点があります。Gaudi 3は系列の終盤にあります。Intelが示す今後の推論チップは新しいGPU「Crescent Island」で、Xe3Pアーキテクチャに160 GBのLPDDR5Xと空冷を組み合わせ、顧客向けサンプリングは2026年下半期の予定です。つまり今Gaudi 3を買うなら、長いロードマップではなく、今のコストパフォーマンスのために買ってください。
長所: 積極的な価格設定、カードあたりの大容量HBM、独自インターコネクトへのロックインを避ける標準Ethernet。短所: 純粋な速度ではなくコストで競う製品であり、ロードマップは明らかに別のチップ系列へ移るため、長期の賭けではなくコスト重視の買い物です。
料金とアクセス: Dell、HPE、SupermicroなどのOEM経由で購入するか、「半分のコスト」を打ち出すIBM Cloudで利用できます。評価: 予算が厳しく、データセンターがEthernetネイティブなら賢明な選択です。ただしCrescent IslandがIntelの本当の推論の未来だと理解したうえで導入してください。
8. d-Matrix Corsair: メモリに賭ける専業メーカー
向いている用途: 自社でハードウェアを導入でき、専用設計の推論アーキテクチャに早めに賭けたい、遅延にこだわるチーム。
d-Matrixは伏兵であり、LPXが狙うのとまさに同じ課題、つまりエージェント型や推論型のワークロード向けの超低遅延・小バッチのトークン生成を狙っています。CorsairカードはDigital In-Memory Computeを使い、計算をオンチップSRAMのすぐ隣に置いてメモリの壁を避けます。目を引く数字があります。Llama3 8Bは単一サーバーでトークンあたり1 msの毎秒60,000トークン、Llama3 70Bはラックで2 msの毎秒30,000トークンで、d-MatrixはH100に対し対話速度が約10倍、エネルギー効率は最大5倍だと主張しています(自社の予測値)。
Corsairは2026年6月に量産に入り、同社は2025年11月に2億7,500万ドルのシリーズCを調達しました(評価額は約20億ドルと報じられています)。出資者にはMicrosoftのM12やTemasekが含まれます。
長所: 低遅延推論のためにゼロから設計されたアーキテクチャ、強い効率の主張、後ろ盾となる本格的な資金。短所: 公開APIのないハードウェアのみの提供で、数字は独立したテストではなくベンダーの予測であり、スタートアップのシリコンに賭けることはハイパースケーラーから借りるのとは別種のリスクです。
料金とアクセス: カード、サーバー、SquadRackシステムを購入します。セルフサービスのクラウドエンドポイントはありません。評価: このリストで最も興味深い大穴です。シリコンを立ち上げるチームがあり、インメモリコンピュートで先駆けたいなら、真剣に検討する価値があります。それ以外の人にとっては、注目しておくべき一社です。
これらのチップの本当の違いは、メモリへの賭け方
マーケティングから一歩引いて見ると、8つの代替は、メモリの扱い方というただ一つの決断で3つの陣営に分かれます。この一つの選択が、今読んだ仕様書の違いのほとんどを説明します。
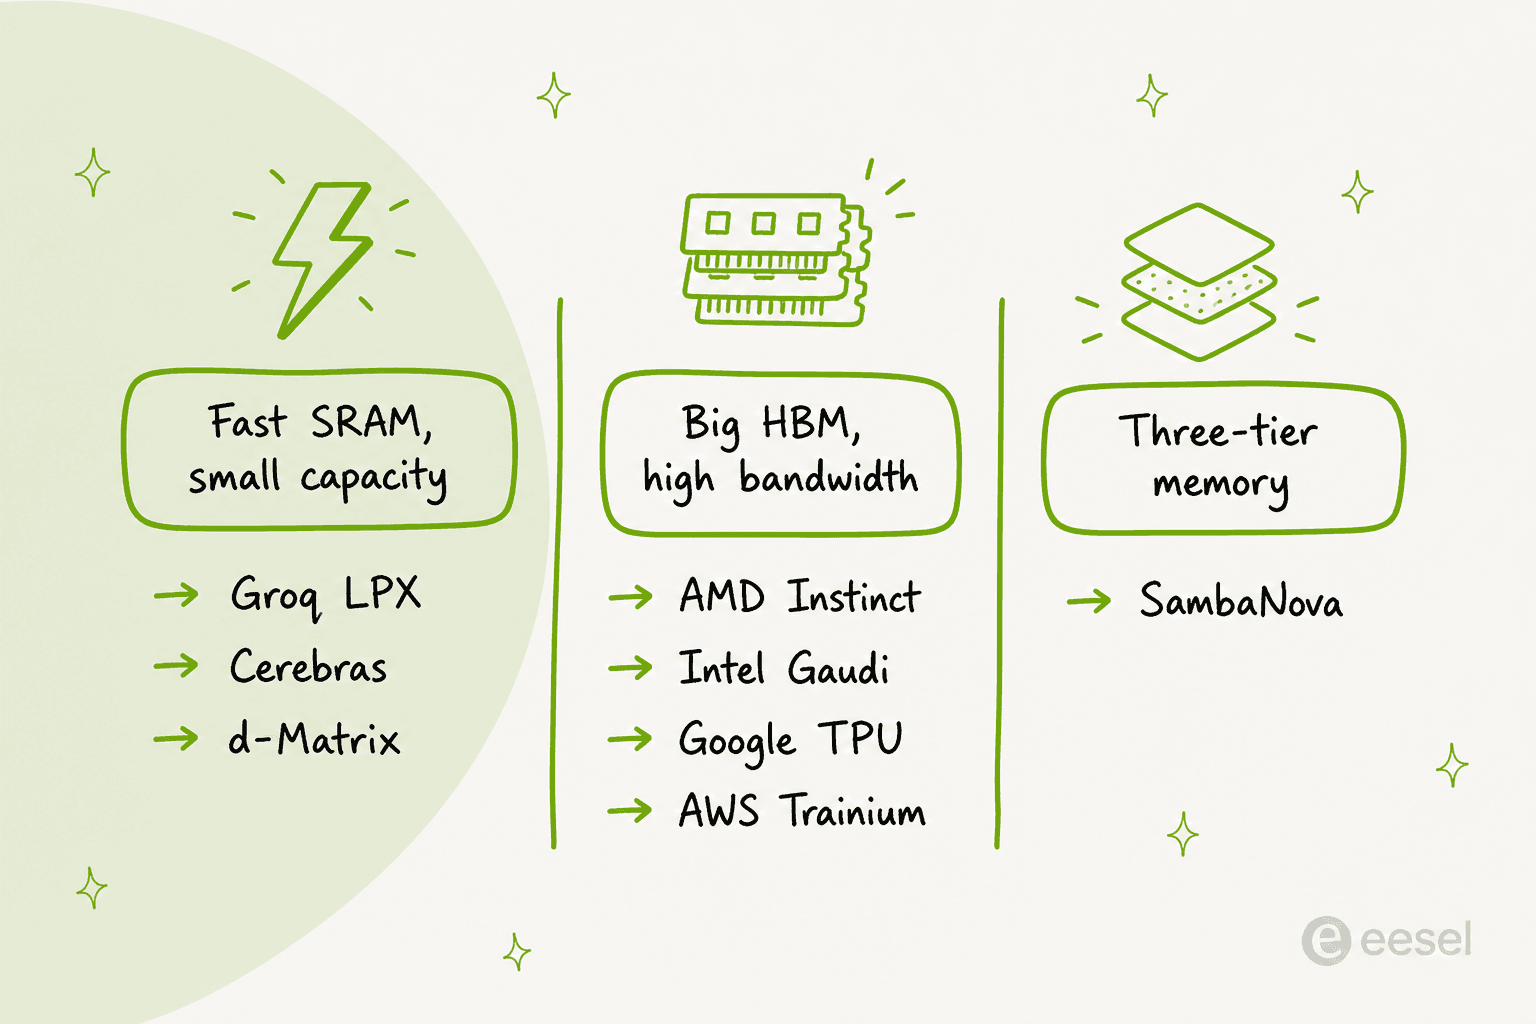
- 高速SRAM、小容量。 Groq、Cerebras、d-Matrixは、作業データを超高速なオンチップSRAMに置きます。これでトークン生成が瞬時に感じられますが、チップあたりの容量はごくわずかで、大きなモデルを載せるには多数のチップが必要です。
- 大容量HBM、高帯域。 AMD、Intel、Google、AWSは、アクセラレータあたりに高帯域メモリを大量に積みます。これにより大きなモデルと長いKVキャッシュをより少ないチップに載せられ、AMDがGPUあたりのメモリの優位性を強く打ち出す理由です。
- 3階層メモリ。 SambaNovaはSRAM、HBM、DDR5でその中間を取り、多数の大規模モデルを常駐させて素早く切り替えられます。これはエージェント処理が評価する特性です。
ここに万人にとっての正解はありません。小さなモデルでの高速チャットならSRAM陣営が勝ちます。巨大なモデルや複数モデルのエージェントなら容量が勝ちます。自分がどの陣営かを言葉にすれば、どのベンチマークよりも早く、8つのうちどれを候補にすべきかが分かります。
より大きな問い: おそらくラックは買わない
ここが最も率直に伝えたい部分です。ペタフロップスの話に迷い込みやすいからです。クラウドや非常に大きなAIプラットフォームを運営していない限り、Groq 3 LPXも、その代替のほとんども購入しません。これは、実際に仕事が行われる場所よりいくつも下の層にあるインフラです。すでに使っているモデルAPIやクラウドの中で、より速く安いトークンとして体感することになります。AIエージェントを使うためにGPUを買ったことがないのと同じです。
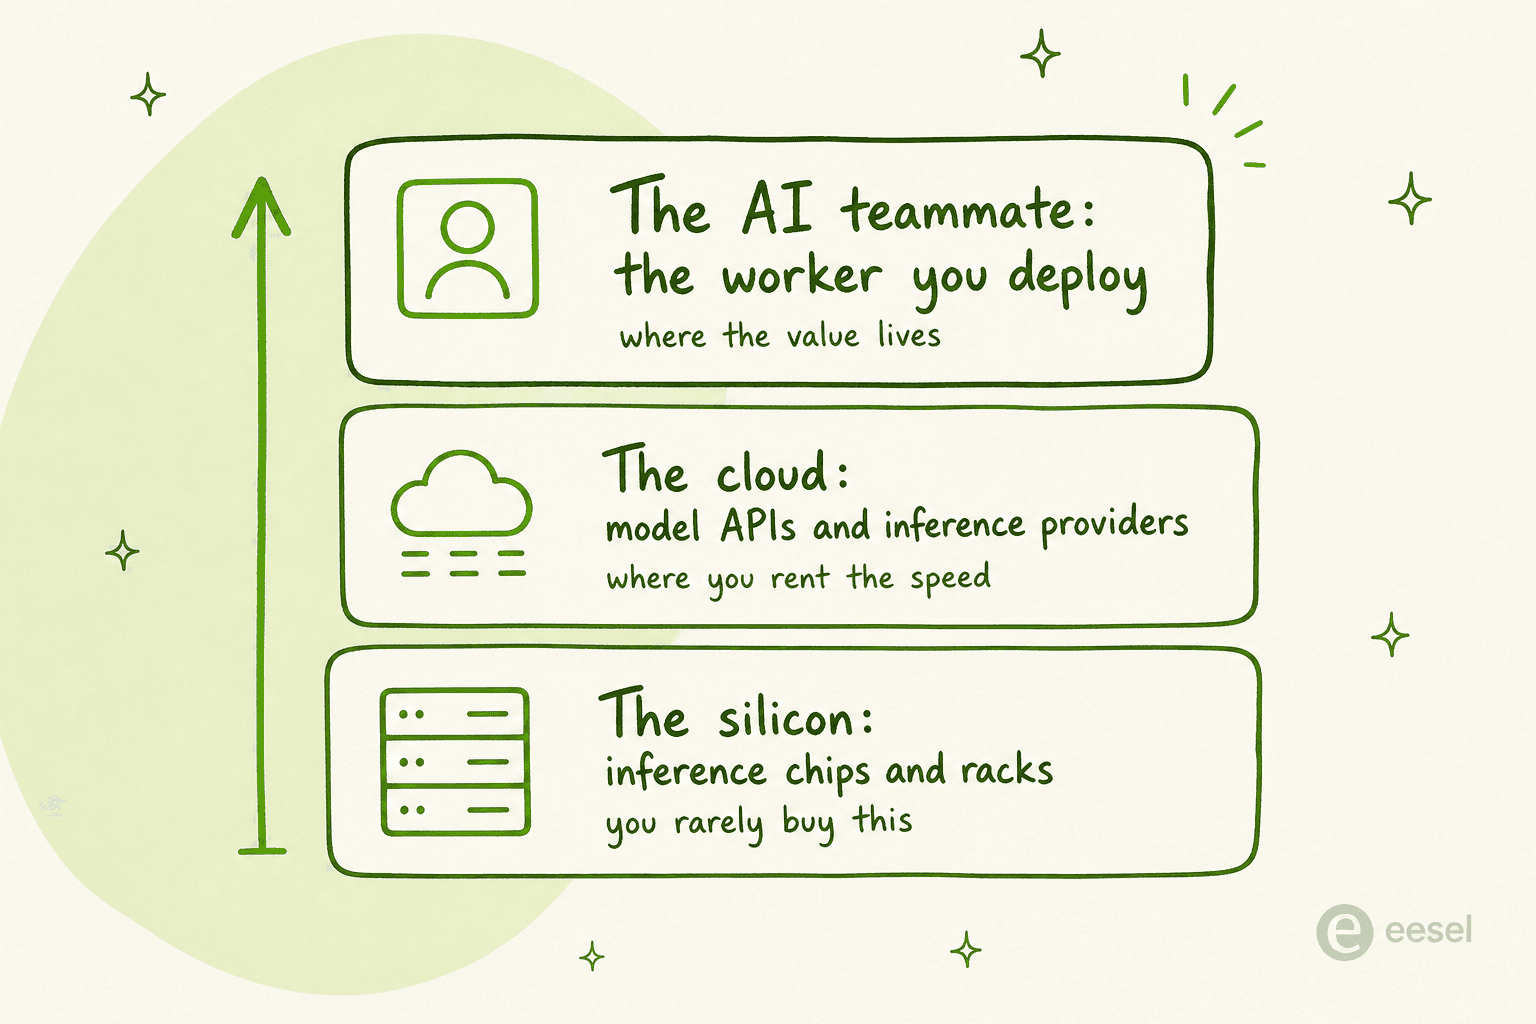
そして、このワークロードの変化こそが、これほどのシリコンが存在する理由です。あるアナリストはXでこう述べました。
"Nvidia moving its Groq 3 LPX inference accelerator into full production signals a key shift from model training to continuous agentic AI workloads."
有益な捉え直しは、チップがエンジンであり、実際に導入するのはその上に乗る担い手だということです。推論が速くなればエージェントは機敏になり、運用も安くなります。それが本物の自動化を本番に載せるハードルを下げ、手作業で行う場合に対するコストの計算を傾けます。それがコーディングエージェントでも、リサーチエージェントでも、サポートキューを担当するAIヘルプデスクエージェントでも同じです。ハードウェア競争は、そのレイヤーを大規模に成り立たせるためのものです。価値は依然としてそのレイヤーにあります。遅延がなぜそこまで重要なのかを理解したいなら、別記事でLLMの推論コストを掘り下げています。
eeselの立ち位置と、なぜどのチップを選んでも関係ないのか
このリストのチップはすべて配管です。eeselは、その上で仕事をしてもらうために雇う存在です。eeselはAIチームメイトのプラットフォームで、推論を用意したりパイプラインを組んだりする代わりに、特定の役割ですぐ働けるチームメイトを迎え入れ、アプリにつなぎます。現在の顔ぶれは、単なるサポートチャットボットをはるかに超える存在としてサポートキューに加わるAIヘルプデスクのチームメイトと、この記事のようなコンテンツを作るAIブログライターです。

チップの選択が実際には影響しない理由は、eeselが下にどんな推論基盤があっても動くこと、そして良し悪しを決めるのが毎秒トークン数ではないことです。決めるのは正確さです。実際のサポートキューでAIを運用してきた長年の経験から、地味な側面を学びました。8秒ではなく1秒で答えるサポートのチームメイトは、待っているお客様にとっての体験のすべてですが、速度は答えが正しい場合にしか役に立ちません。それが、実際にティア1のチケットを減らすエージェントと、人をいら立たせるだけのエージェントの違いであり、だからこそeeselは、ライブのお客様に返信する前に、過去のチケットでロールアウトをシミュレーションします。世界中のシリコンを集めても、自信満々の誤答は直せません。ラックを探すより、チームメイトを導入したいなら、eeselを無料で試せます。