

MiniCPM5-2BはOpenBMBの新しい2Bオープンウェイトモデルで、サイズを考えると本当に目を引きます。2.52Bパラメータの密なテキスト専用モデルで、128Kのコンテキストウィンドウと Apache-2.0 の重みを備え、データセンターではなく、スマートフォン、ノートPC、ミニPCといったデバイス上で動かすことを前提に作られています。OpenBMB独自のスイートでは34のベンチマークで平均53.9を記録しました。OpenBMBはこれを2Bクラスのオープンソース最高水準と位置づけ、自社の比較セットの中ではより大きなQwen3.5-4B(51.1)を上回るとしています。
先に知っておくべき注意点があります。テキスト専用(画像認識なし)であること、目を引くスコアはベンダー報告であること、そして注目の数値のひとつが情報源によって食い違っていることです。独立系のトラッカーは、Artificial Analysis Intelligence Indexを15とし、4B以下のオープンウェイトモデルでは最高としています。一方、OpenBMB自身のローンチ投稿は23を主張しています。どちらも以下に記載します。
ものづくりをする方にとって、MiniCPM5-2Bはローカルで推論とツール利用を担う優れたエンジンです。カスタマーチケットに答えたい場合は、モデルはエンジンにすぎないことを思い出してください。動作するサポートエージェントには、その上に自社ナレッジ、連携、ガードレール、テストが必要で、それがeeselのようなプラットフォームが提供する層です。
MiniCPM5-2Bとは実際に何か
MiniCPM5-2Bは、OpenBMB(ModelBestとしても知られるオープンモデルのグループ)のMiniCPM5シリーズの2番目のモデルで、5月のMiniCPM5-1Bに続き、2026年9月6日から7日ごろに公開されました。狙いは絞られていて明快です。推論、コーディング、ツール利用で役に立つ程度に優れ、データがすでにある場所で動かせるほど小さい、密な小型モデルです。
この「データがある場所で」という部分が興味深い点です。今年話題になるモデルの多くは、トークン単位で借りるクラウドAPIです。MiniCPM5-2Bはその逆を行きます。重みをダウンロードして、ノートPCや携帯電話、工場のフロアにあるRockchipボード上で動かします。HuggingFaceのモデルカードは、これを「built for on-device, local deployment, and resource-constrained scenarios」の密な2Bモデルと説明し、「local assistants, coding agents, tool-use workflows, and reasoning scenarios where a compact model is preferred」を想定しています。
以下はモデル自身のページで、ダウンロードしたいなら実際にここから始めます。
期待値を合わせるための正直な制約として、これはテキスト専用モデルです。このチェックポイントには画像も音声もなく、コミュニティのテスターは英語と中国語のみに対応すると指摘しています。マルチモーダルが必要な場合、OpenBMBは別ラインのMiniCPM-Vで提供しており、「画像認識がない」という反応はローンチ時に最も声が大きかったもののひとつです(詳しくは後述します)。
重要なスペック
2Bモデルでは、驚きはスペック表にあります。素直なLlamaForCausalLMアーキテクチャで動作し、128Kのフルコンテキストを備え、本当に寛容なライセンスで公開されています。
| 項目 | 値 |
|---|---|
| 総パラメータ数 | 2,516,756,480(約2.52B) |
| 埋め込みを除くパラメータ数 | 1,981,982,720 |
| アーキテクチャ | 標準のLlamaForCausalLM(カスタムカーネルなし) |
| レイヤー数 | 42 |
| アテンション | GQA、クエリヘッド16、KVヘッド2 |
| コンテキスト長 | 131,072トークン(128K) |
| モダリティ | テキストのみ(英語 / 中国語) |
| ライセンス | Apache-2.0(重みとリポジトリ) |
| テンソル型 | BF16(ほかにGGUF、MLX-4bit、GPTQ-4bit版) |
ここにある数値はすべてモデルカードの「Model Information」ブロックから取っています。そのうち2つは、ほかより大きな意味を持ちます。
1つ目は標準アーキテクチャです。OpenBMBは、MiniCPM5-2Bを素のLlamaForCausalLMの上に作ることにこだわりました。その理由は、彼らの言葉で「mainstream inference engines can load it directly: no custom kernels, no model-code fork.」です。脚注のように聞こえますが、初日のランタイム対応(後述)がこれほど幅広い理由はここにあります。専用カーネルが必要なモデルは公開日に2つのランタイムにしか出ませんが、標準アーキテクチャのモデルはあらゆるところに同時に現れます。
2つ目は、リポジトリと重みの両方に付いているApache-2.0ライセンスです。商用利用が許可され、それを制限する別個のコミュニティライセンスもありません。これはすべての「オープン」公開が言えることではありません。この上に製品を作るなら、ベンチマークの1、2ポイントより重要です。
本格的な深い推論モードもあります。transformersの例ではenable_thinking=Trueを渡し、OpenBMBはタスクのトークン予算をおよそ21Kトークン(思考14Kと回答7K)とし、推奨サンプリングはtemperature=1.0, top_p=0.95としています。
スコアはどうか
MiniCPM5-2Bが注目された見出しはこれです。OpenBMBの評価では34のベンチマークで平均53.9を記録し、彼らはこれを2Bクラスのオープンソース最高水準、そして比較セットの中では4Bクラスの最上位モデルであるQwen3.5-4B(51.1)を上回ると示しています。2Bモデルが4Bモデルをわずかに上回るという主張は、改めて見る価値があります。
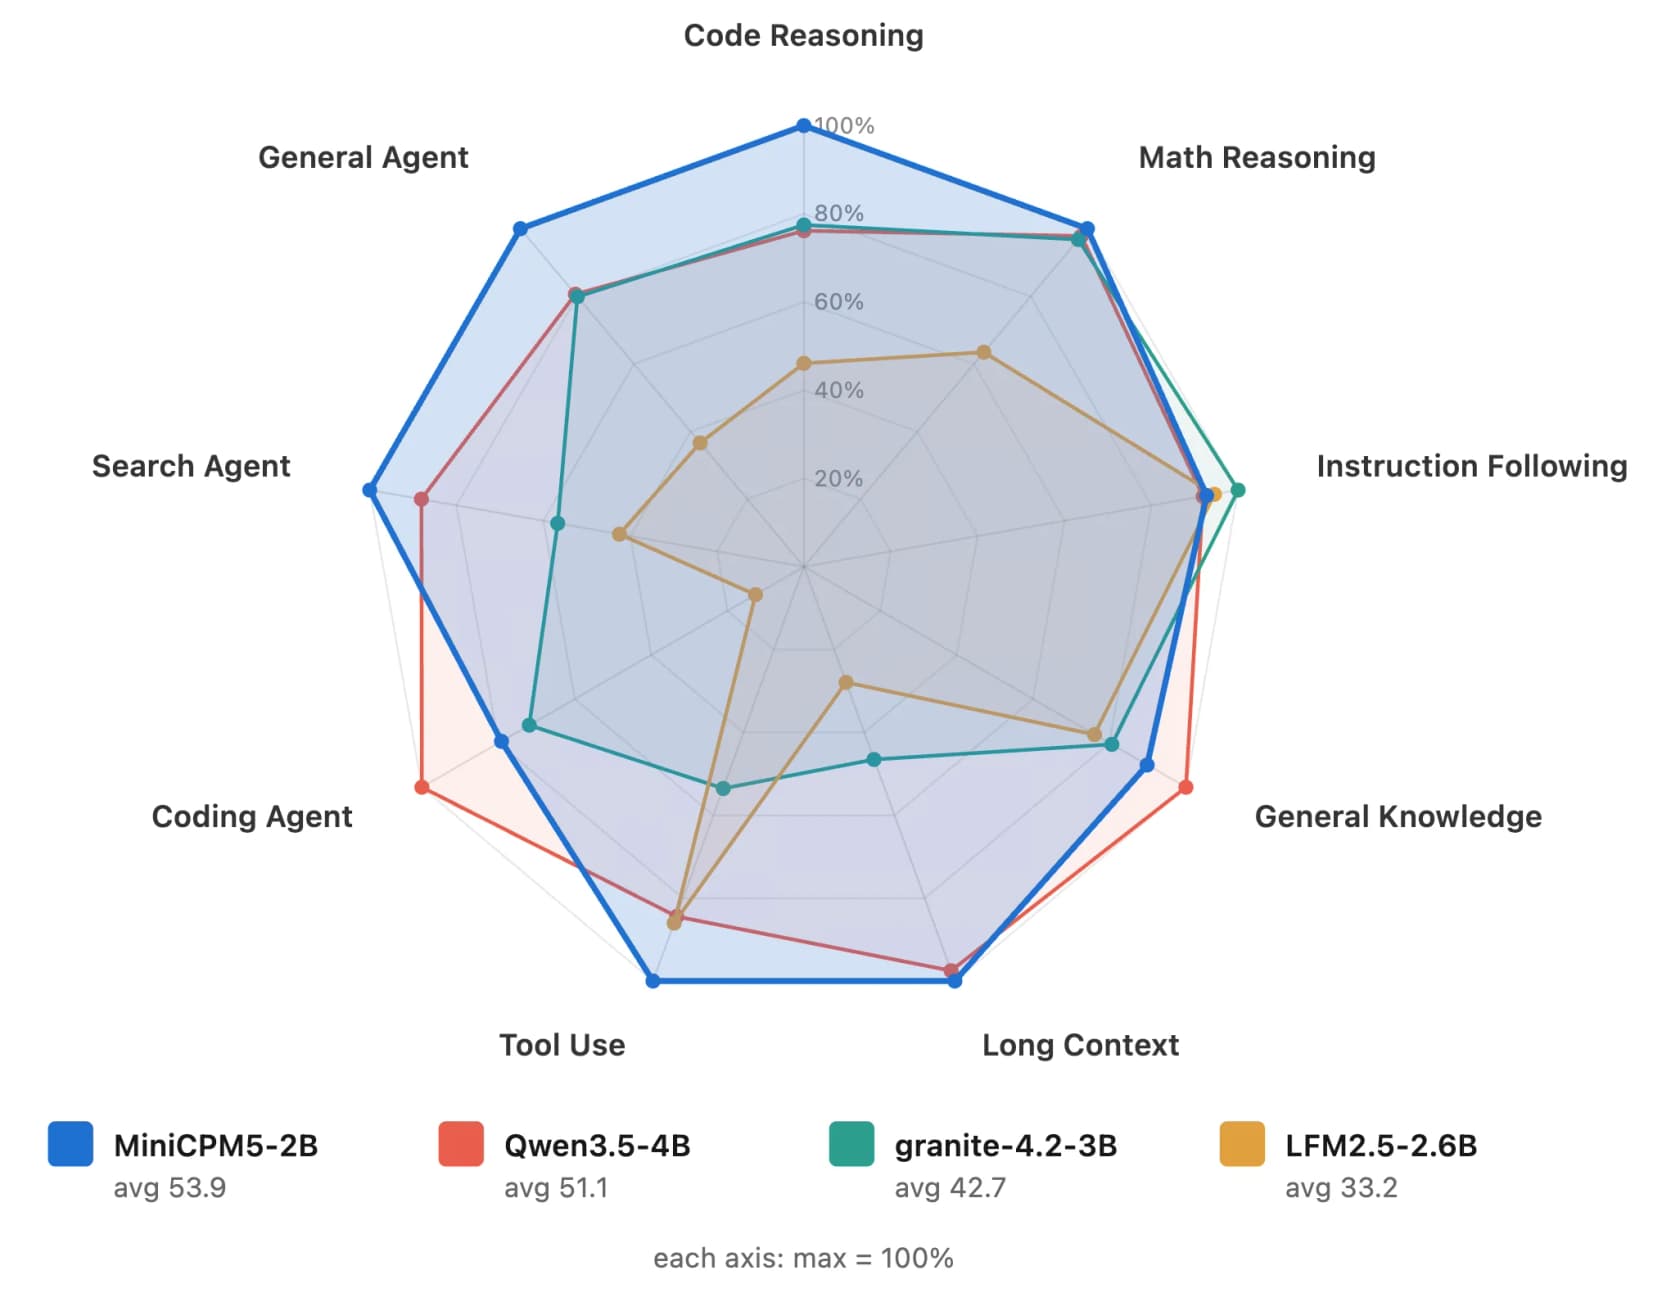
レーダーチャートは、サイズ対スコアの話が成り立つ場所と成り立たない場所を示します。MiniCPM5-2Bはエージェントや検索のタスクで先行し、数学や長いコンテキストでも互角ですが、純粋なコーディングエージェントの作業では4BのQwenモデルがまだ優位です。均一なリードではなく、凹凸のあるプロファイルであり、それが正直な読み方です。
完全な表はじっくり見る価値があります。「平均53.9」は、個別のかなり大きな数値を隠しているからです。
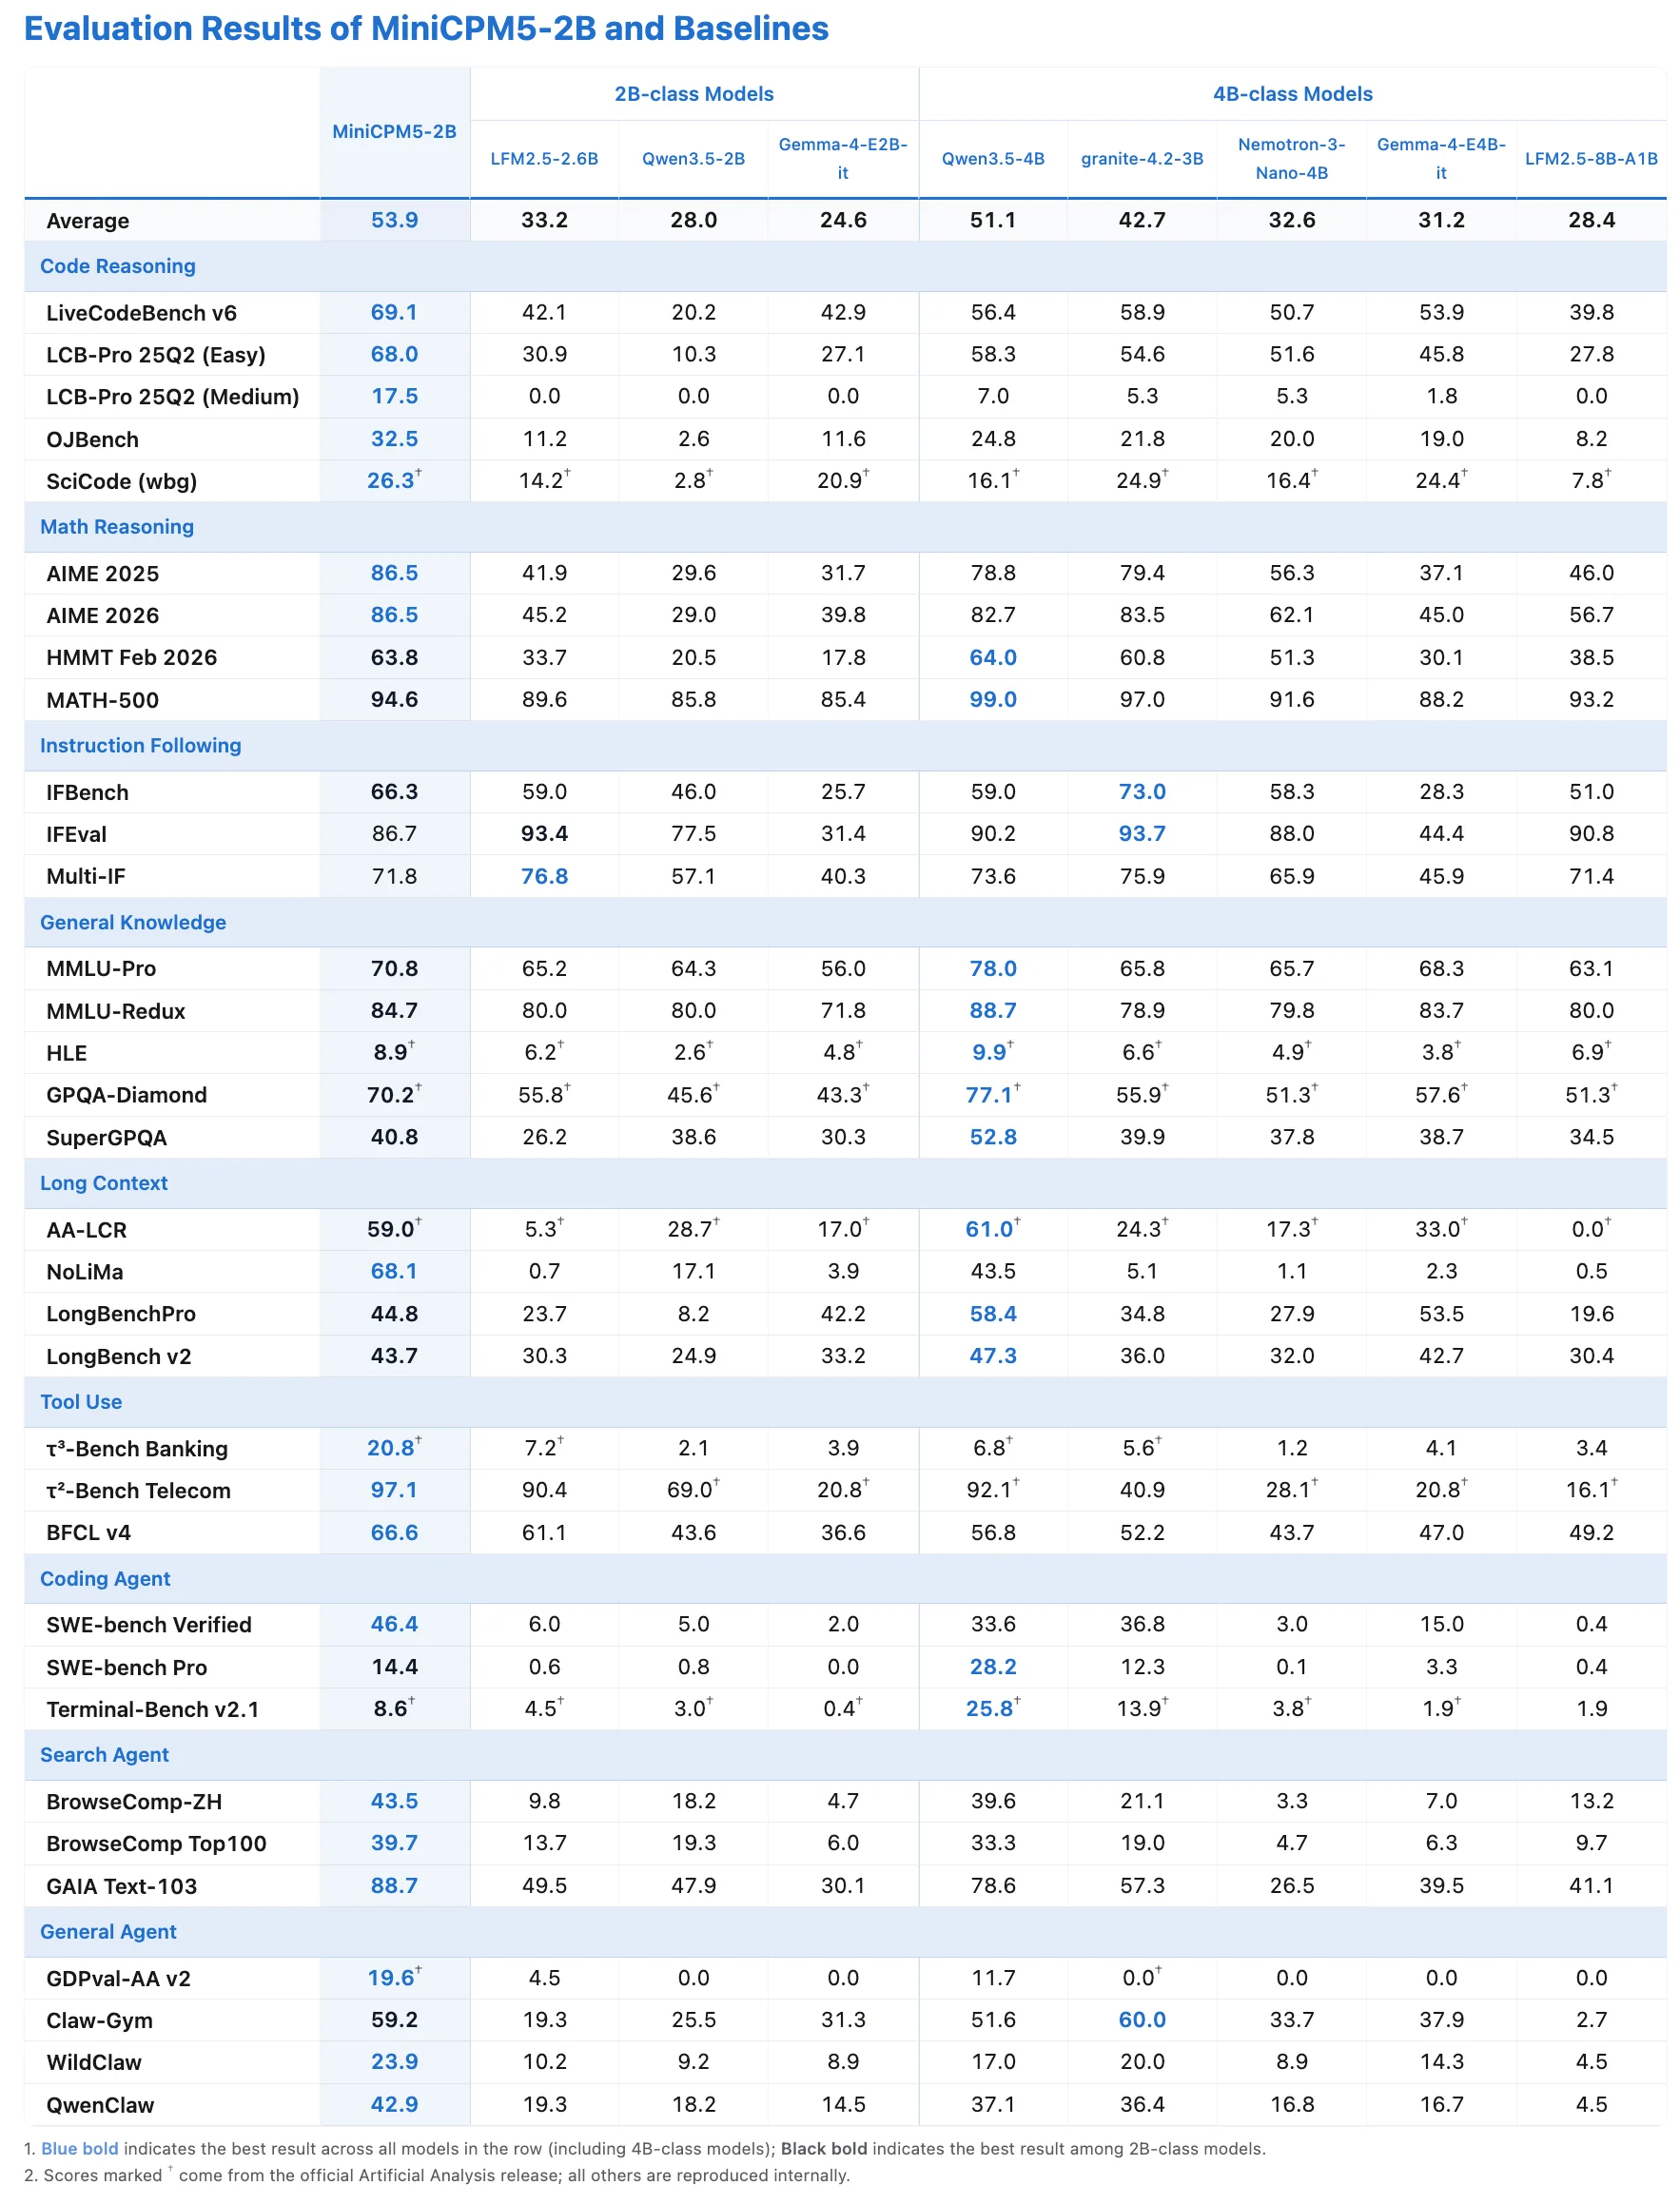
目立つ数値はすべてその表からで、MATH-500が94.6、AIME 2026が86.5、LiveCodeBench v6が69.1、SWE-bench Verifiedが46.4、τ²-Bench Telecomが97.1、GAIA Text-103が88.7です。一般知識ではMMLU-Pro 70.8を記録しています。ノートPCで動かせるモデルとして、これらのコーディングとツール利用の数値は、ビルダーが身を乗り出すものです。
2つの注意点でこれを公平に保ちます。第一に、これらはOpenBMB自身が報告した数値です(一部の行は社内で再現され、一部はArtificial Analysisの公式リリースから取られています)。独立した評価ではなく、強力な出発点として扱い、ご自身のタスクで試してください。第二に、注目の数値のひとつが情報源間で食い違っています。r/LocalLLaMAのリリーススレッドとdataconomyはどちらもArtificial Analysis Intelligence Indexを15とし、「the highest of any open weights model at 4B parameters or below」と報じていますが、OpenBMB自身のローンチ投稿は23、さらにAgentic Indexで20を主張しています。この2つは両立させられないため、両方を記録に残します。また、欠けているものにも注意してください。OpenBMBはこのモデルについて、従来のMMLU、GSM8K、HumanEvalを公表していません。古いリーダーボードと並べたかった場合、それらの数値は公式情報源には存在しません。
OpenBMBはどう訓練したか
MiniCPM5-2Bが興味深いもうひとつの理由は、OpenBMBが重みだけでなく、レシピの大半をオープンソース化したことです。小さなモデルがどうやってここまで高性能になるのかを知りたいなら、答えはパイプラインにあります。
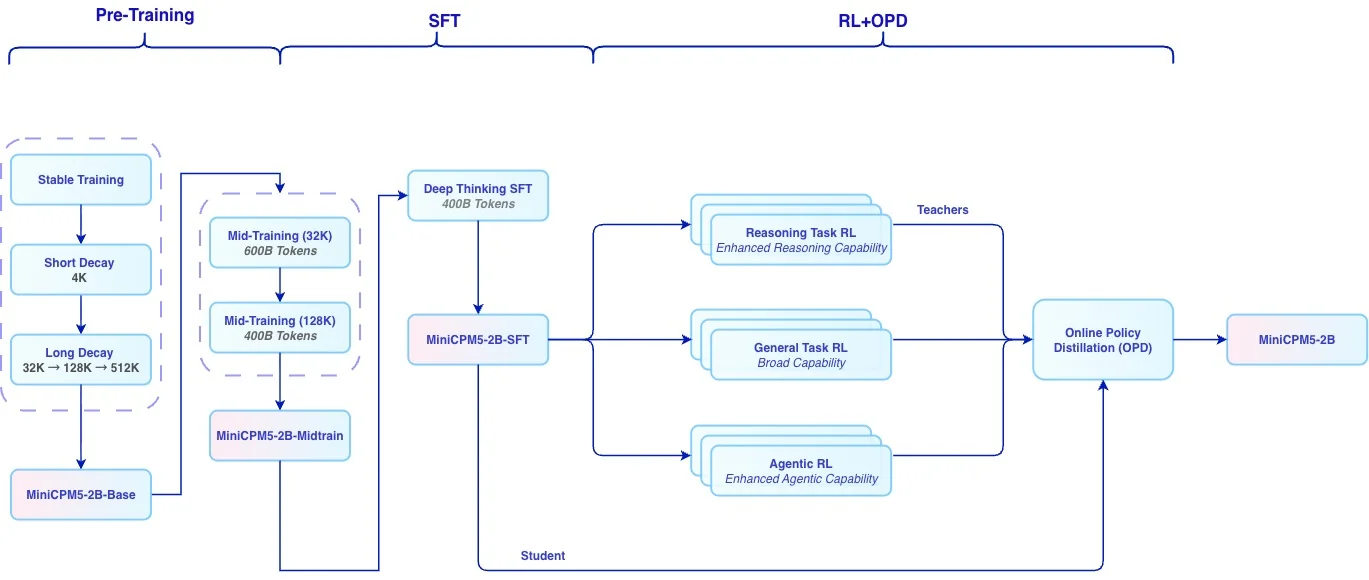
モデルカードに記載された3つの段階で進みます。基礎訓練ではOpenBMBのUltra-FineWebと関連するUltraDataデータセットを使います。中間訓練でモデルを目標とする能力に適応させます。そのあとポストトレーニングが大仕事をします。深い思考のSFT 400Bトークン、数学、コード、エージェント、文章作成のタスク向けに専門の教師を使った強化学習(クリティックベースのJustRL IIアルゴリズムを使用)、そして最後に16のエキスパートモデルを単一のリリースチェックポイントに統合するOn-Policy Distillationです。
OpenBMBは、RLとOPDの段階だけで、推論と一般ベンチマークで10.96ポイント、エージェントタスクで6.96ポイント向上したと報告しています。その向上を再現できるかどうかにかかわらず、データセットとRLフレームワークを公開することは、ブラックボックスではなく再現可能であるため、オープンモデルのコミュニティの注目を集める動きです。
エッジで動かす
2Bモデルが存在する理由は、200Bモデルには動かせない場所で動くことです。だからMiniCPM5-2Bについての問いは、「どれだけ賢いか」というより、「ローカルで動かすと実際に何が得られるか」です。
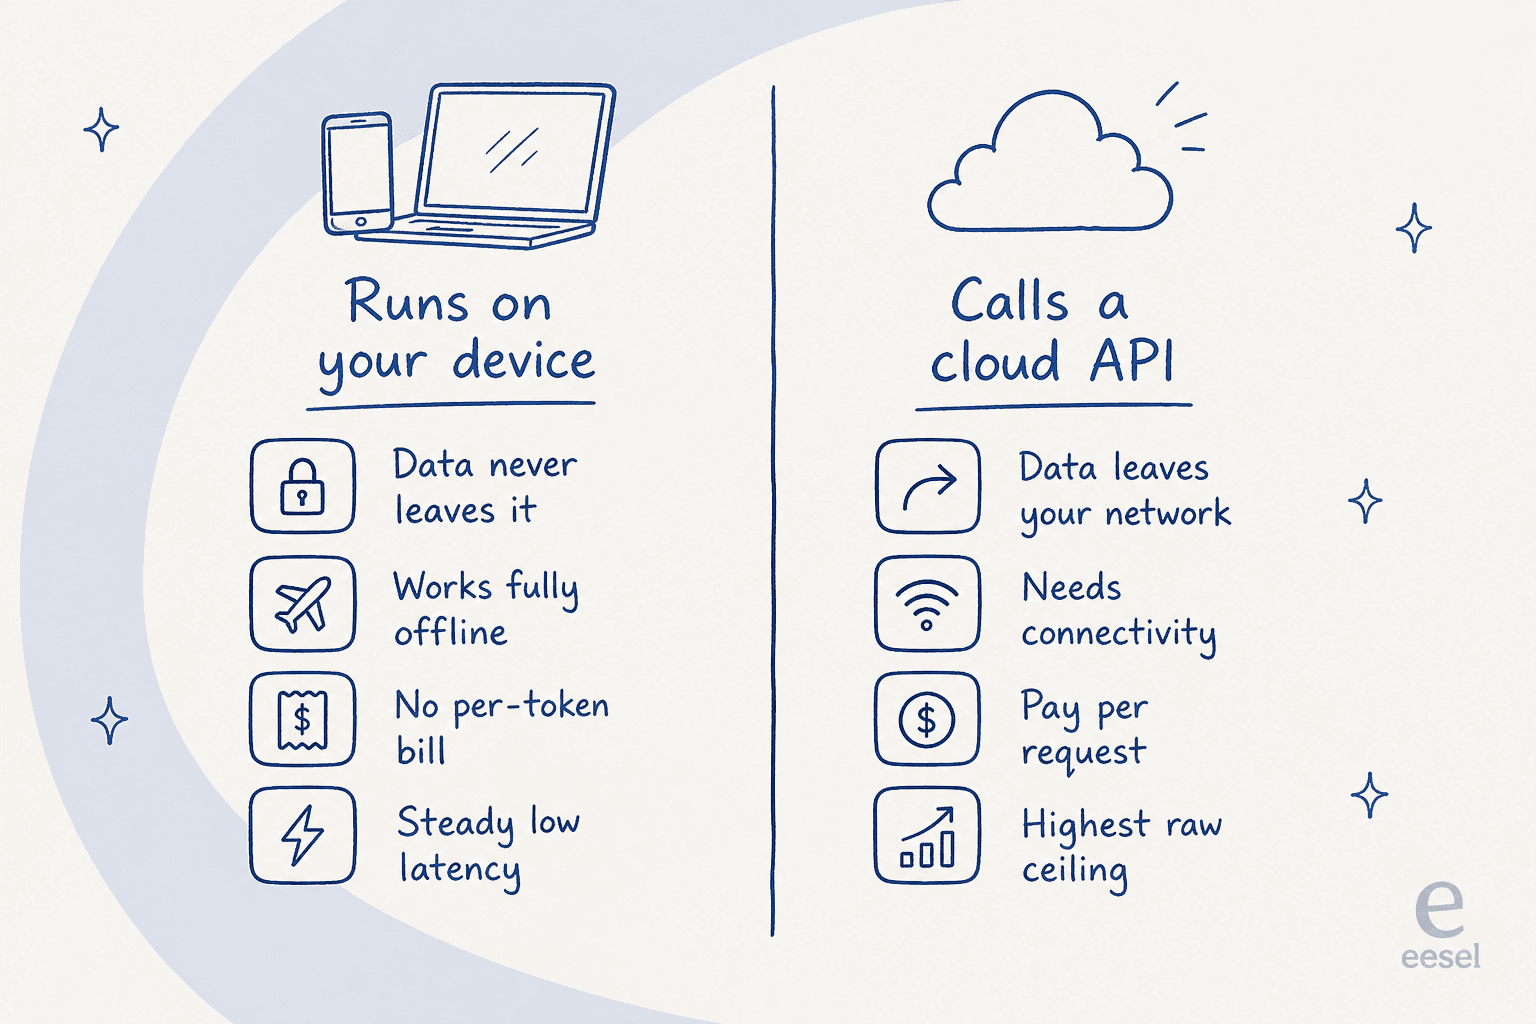
トレードは両方向で現実です。デバイス上で動かせば、データはマシンの外に出ず、接続なしで動き、トークン単位の課金もありません。プライバシーに敏感な作業やオフライン作業では、この組み合わせは負けにくいものです。クラウドを手放せば、フロンティアモデルの能力の上限も手放すことになります。MiniCPM5-2Bは、増え続けるタスクにおいて、「十分に良い」プライベートな小型ローカルモデルが、データを預けなければならない巨大なリモートモデルに勝つほうに賭けています。
実用面は成り立っています。コミュニティの一覧ではGGUF版は約1.6GB(公式ではなくサードパーティの数値)とされ、OpenBMBは16GBのMacBookでデバイス上のWeb検索を行うデモを再共有しています。また、OpenVINOを使ったIntel Core Ultra、SME2を備えたArm v9(プリフィルが約1.7倍、デコードが約1.2倍高速と報告)、RockchipのRK3588とRK1828ボード向けに、初日から対応しました。
先ほどの標準アーキテクチャという判断が、ここで効いてきます。同じチェックポイントが、1つか2つのランタイムに少しずつ出ていくのではなく、公開日に幅広いランタイムに読み込めます。
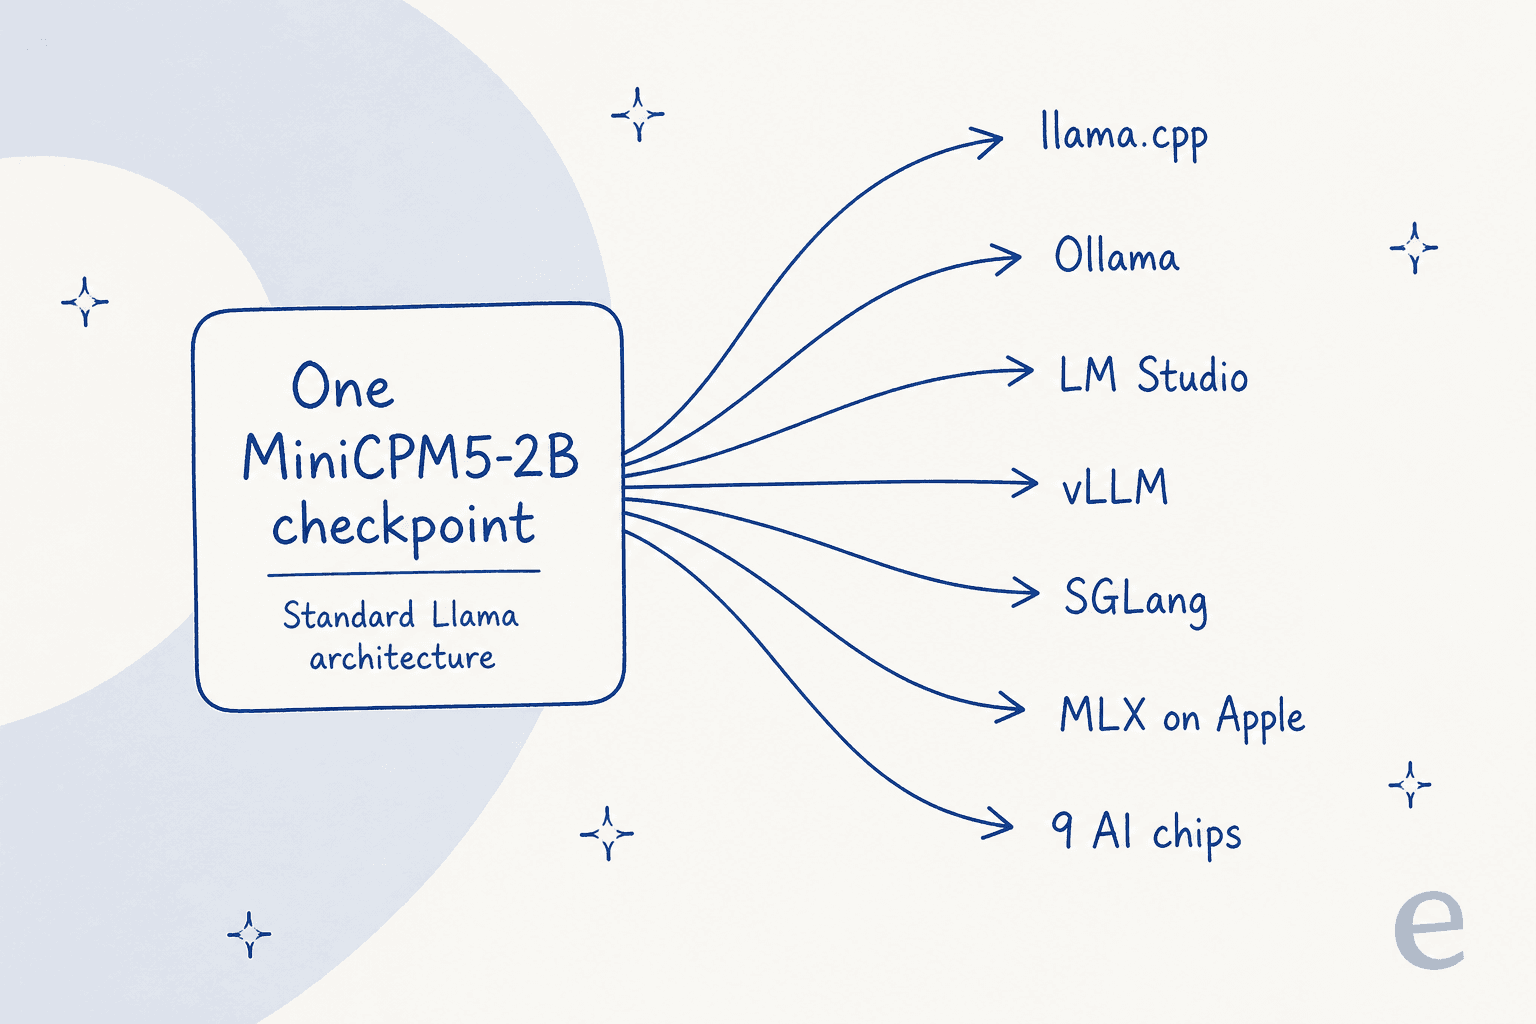
モデルカードのデプロイ表によると、transformers、vLLM、SGLang、llama.cpp、Ollama、LM Studio、Apple Silicon向けのMLX、そして9種類のAIチップに適応させるFlagOSで動作します。ツール呼び出しにはSGLangが推奨バックエンドです。モデルはXML形式のツール呼び出しを出力し、SGLang組み込みのminicpm5パーサーがそれをOpenAI互換のtool_callsに変換します。出力を変えずに速度をさらに引き出したい場合のために、投機的デコーディング用のDSpark ドラフトモデルまであります。
コミュニティの声
ローンチ時の反応は2つの陣営に分かれ、どちらも有益なシグナルです。
1つ目は、サイズ対能力比への素直な熱狂です。公式ローンチ投稿は1日で2,200以上のいいねを集め、あるテスターは、1台のDGX Sparkで32の並列サブエージェントを平均931トークン/秒、ピーク1,364で動かしたと報告しました。ローカルでホストされた2Bモデルとして、このスループットは、それで作ってみたいと思わせるものです。
2つ目の陣営はより懐疑的で、マーケティングではないからこそ耳を傾ける価値があります。最も多かった不満は、画像認識がないことでした。
"Sad that there is no vision though."

また、ベンチマークのスコアが、特にコーディングハーネスで実際の作業に結びつくのかを疑う開発者もいました。
"you get some likes here, but useful code? I don't think so"
強いベンチマークの行と、実際のエージェントループの中での振る舞いとのあいだの隔たりは、スペック表から読み取れないものです。そして、どんなモデルでも実際のタスクに働かせようとした瞬間に、最も重要になるものでもあります。
オープンモデルはエンジンであり、従業員ではない
持ち帰る価値のある捉え直しがこれで、ビルダーも購入者も最も飛ばしがちな部分です。MiniCPM5-2Bは優れたエンジンです。それ自体は働き手ではありません。強力なオープンウェイトモデルをダウンロードするのはプロジェクトの終わりではなく始まりで、両者の隔たりはモデルより大きいのです。
私はeeselのAIに携わっており、これは私たちが毎日向き合っている区別です。私たちは何年も、ライブのサポートキューにAIエージェントを置いてきました。繰り返し得た教訓は、導入が成功するかどうかを決めるのが、生のモデル品質であることはまれだということです。決めるのは、モデルを取り巻くすべてです。
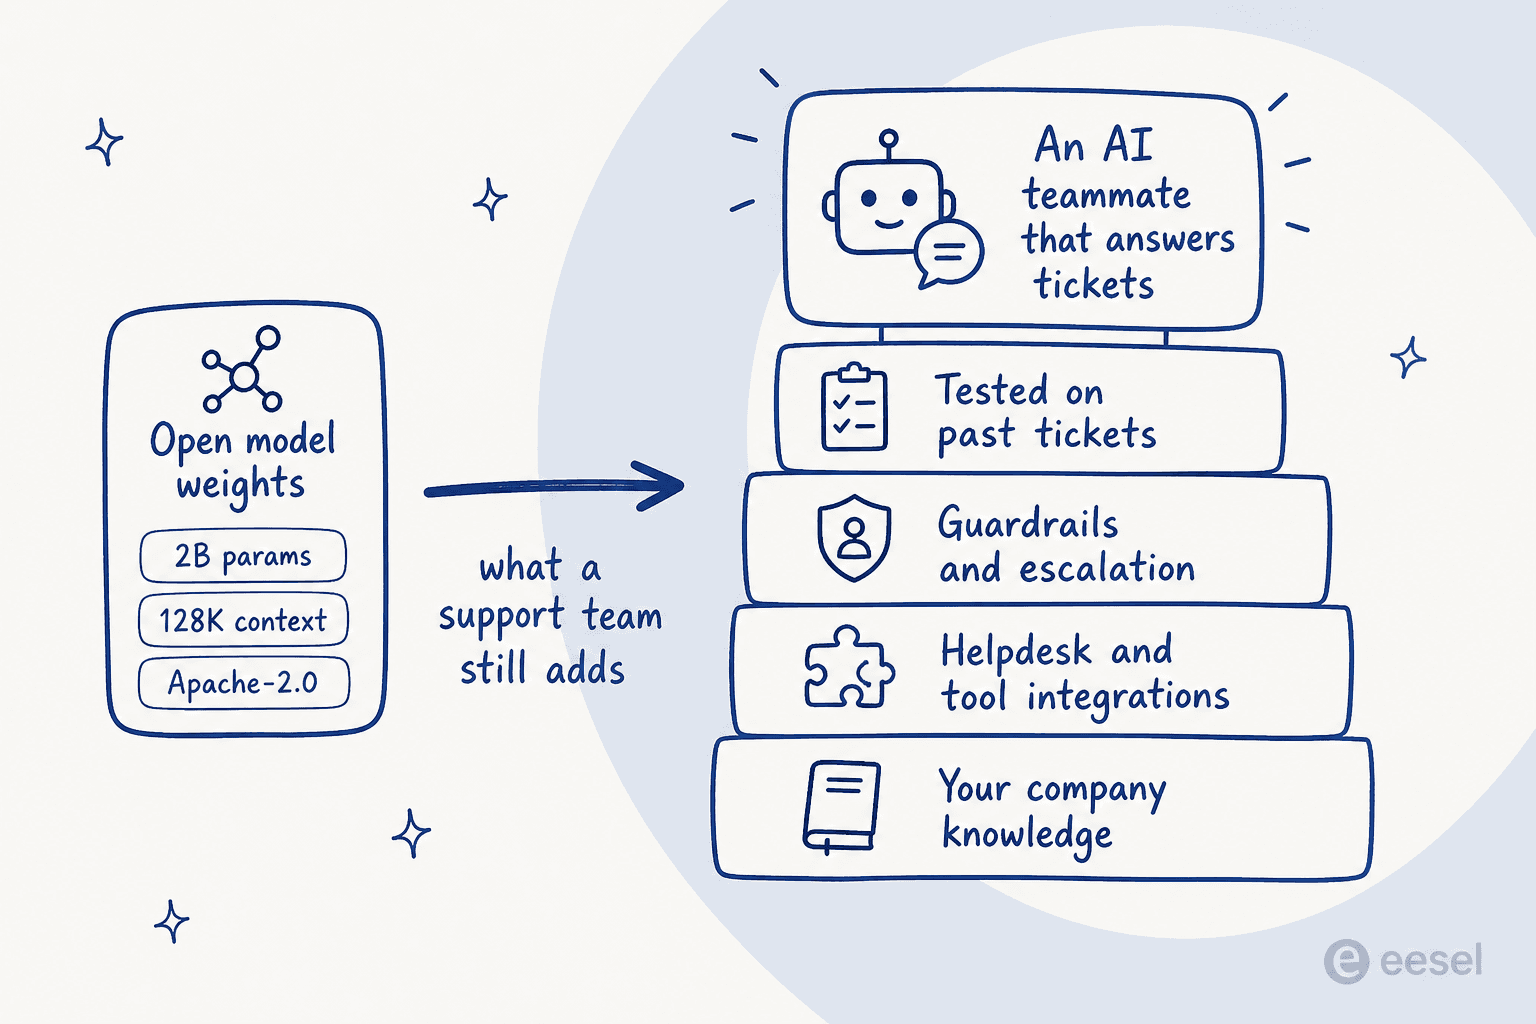
具体例としてカスタマーサポートを取り上げましょう。MiniCPM5-2Bのようなモデルを、実際のチケットに答えられるものにするには、自社の実際のナレッジを与え、ヘルプデスクと、動くために必要なツールにつなぎ、推測せずにエスカレーションするようガードレールを追加し、実際の顧客に触れる前に、過去の実際の会話でテストしなければなりません。この最後の部分で、自信ありげに聞こえるボットが静かに誤った回答をするのを私たちは見てきました。だからこそ今では、すべての導入を本番前に過去のチケットでシミュレーションしています。モデルはそのうち、おそらく20%です。残りの80%は、地味で不可欠な足場であり、ダウンロードには含まれていません。
これはオープンモデルに反対する議論ではありません。手にしているものが何かを明確にするための議論です。MiniCPM5-2Bは、何かを作るための本当に良いコンパクトなエンジンです。ただし、作りたいものがサポートエージェントなら、その80%をすべて自分で組み立てるか、完成したものを迎え入れるかのどちらかです。
eeselを試す
本当の目的がモデルを動かすことではなく、顧客の質問に答えることなら、まさにそれがeeselが解決するために存在する問題です。eeselは、すぐに働けるAIヘルプデスクのチームメイトを既存のキューに迎え入れます。過去のチケットとヘルプセンターから学び、Zendesk、Freshdesk、Slackなどのツールに数分でつながり、そして何より、実際の過去のチケットでシミュレーションするので、誰かにライブで答える前に、どう振る舞うかを確認できます。

ローカルモデルのときのように、ハードウェアに近いところで操作するのが好きな方のために、eeselには公開CLIとMCPサーバーがあります。ダッシュボードで設定した同じチームメイトを、ターミナルから動かしたり、スクリプトで自動化したり、Claude CodeやCursorのようなコーディングエージェントに渡したりできます。完成した働き手とプログラム可能な操作面の両方が手に入り、80%を自分で作る必要はありません。無料で試せます。