

1分でわかる結論
私はここ数年、ライブのサポートキューにAIを投入してきたので、どのモデル発表も同じ見方で読みます。「ベンチマークがきれいか」ではなく、「明日、実際の仕事を任せられるか」です。そのテストでは、Step 5は強力なプレビューであり、弱い購入対象という結果になり、この2つの差こそがレビュー全体です。
詳細の前にスコアカードを示します。
| 見たポイント | 私の評価 | スコア |
|---|---|---|
| 価格あたりの知能 | 低価格帯でトップクラス | 9/10 |
| 長いコンテキスト(1M) | 実際に使える確かな強み | 9/10 |
| コーディング品質 | オープンモデルと同等、クローズドなフロンティアには及ばず | 7/10 |
| ベンチマークの信頼性 | 自社採点、論文なし、自作テストが1つ | 4/10 |
| 提供状況 | APIのみ、ウェイトは未公開 | 5/10 |
| 実際の仕事への準備度 | エンジンであり、即戦力の人材ではない | 4/10 |
1行だけ持ち帰るなら、価格の話は正当で、ベンチマークの話は第三者による検証が必要で、「安いモデル」と「完成した製品」は別の買い物だということです。
StepFun Step 5 Previewとは何か
StepFun(阶跃星辰)は上海のラボで、数年にわたりテキスト、ビジョン、音声にまたがる「Step」ファミリーを公開しており、Hugging Face上のオープンウェイトも充実しています。Step 5 Previewは新しいフラッグシップで、製品ページでは「for complex work and agentic tasks」のフロンティアモデルと説明され、ソフトウェアエンジニアリングと金融に強く寄せています。
StepFunが繰り返し持ち出す枠組みは「advancing the Pareto frontier」、つまりお金に対する知能の最良のトレードオフの線です。自社の発表チャートもはっきり述べています。知能では低価格のオープン勢に並び、コストではそれを下回る、という内容です。
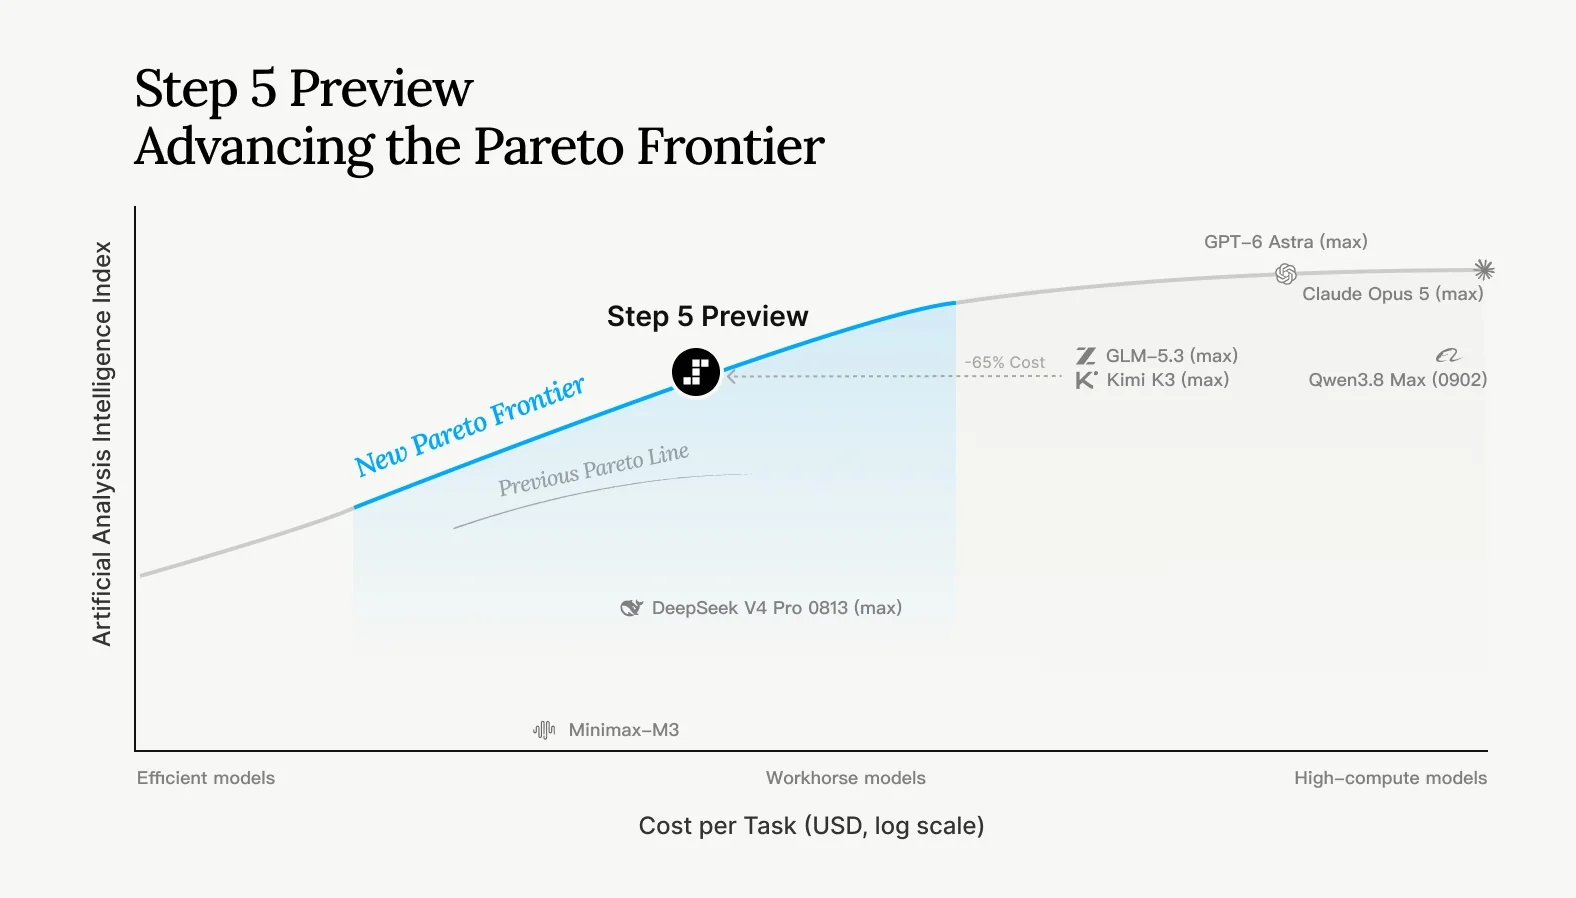
このチャートに込められた主張に注目してください。同程度の知能レベルで、GLM-5.3やKimi K3よりコストが65%低いというものです。ベンダーのチャートなので、結論ではなく売り文句として読みますが、少なくとも筋の通った売り文句です。
アーキテクチャ:総計600B、アクティブ27B
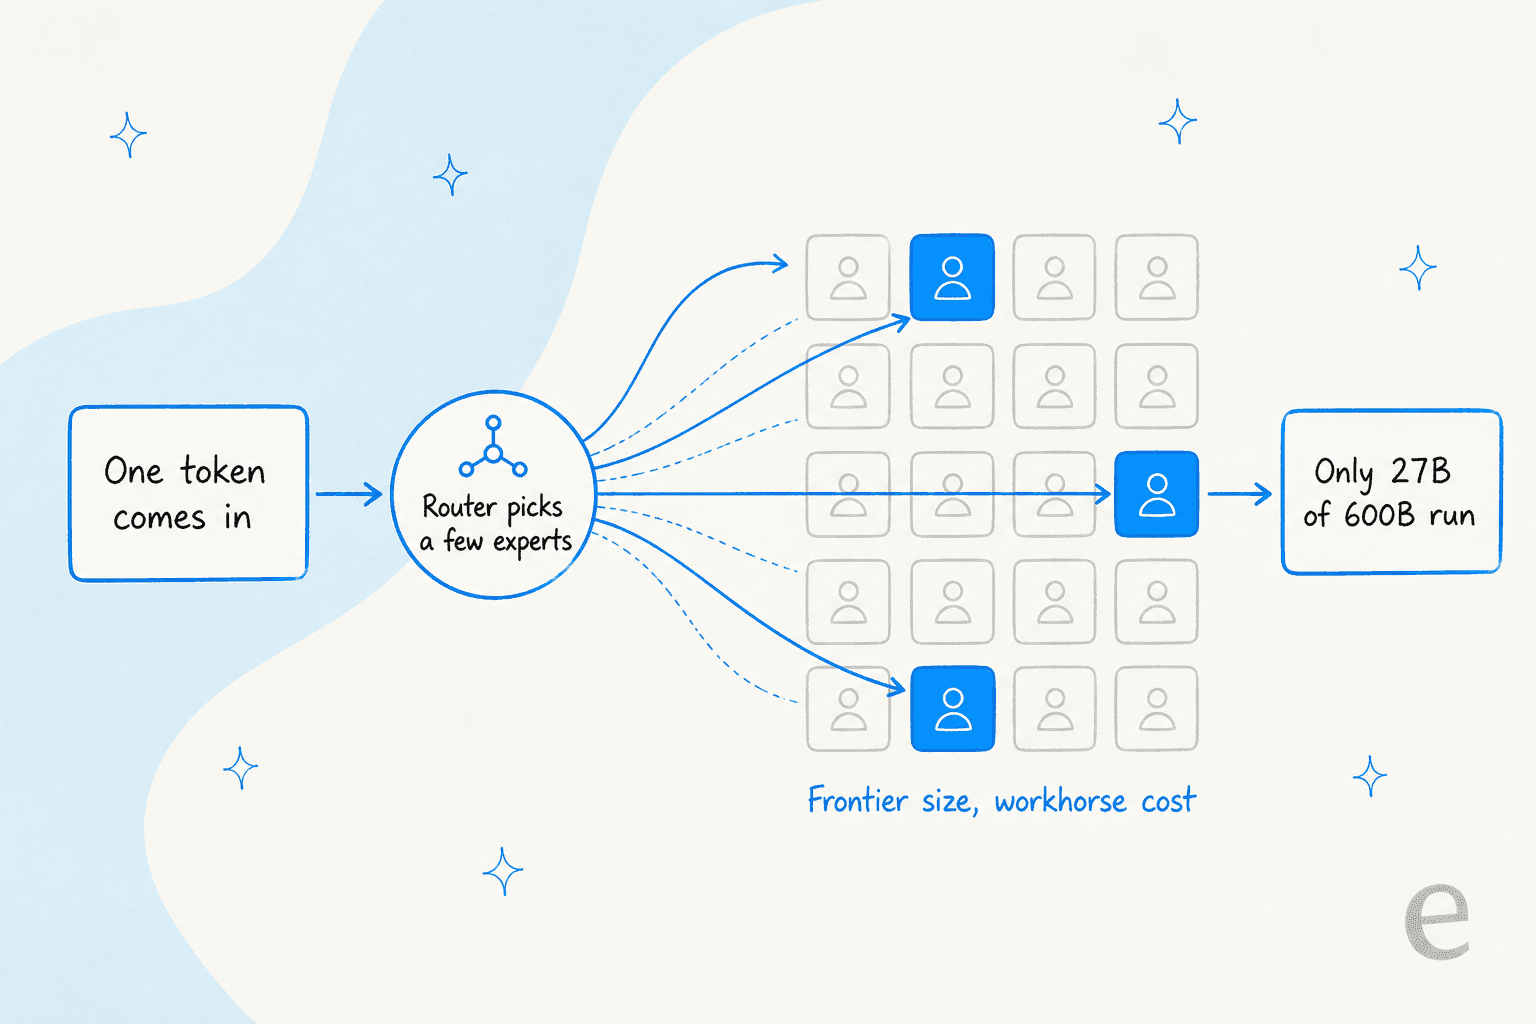
誰もが飛びついた目玉スペックは、モデルの形です。製品ページによれば、総パラメータ600B、トークンあたりアクティブ27Bです。これはスパースなMixture-of-Expertsの設計で、コストの話はこの1つの数字に集約されます。
密なモデルでは、すべてのトークンですべてのパラメータが動きます。Mixture-of-Expertsでは、小さなルーターがトークンごとに数個の「エキスパート」サブネットワークを選ぶため、モデルの一部だけが動作します。Step 5はフロンティア級の600Bをメモリに保持しつつ、一度に27Bだけを動かすので、StepFunは中価格帯のモデルのように値付けできます。
この計算がStep 5に有利に収まると誰もが納得しているわけではありません。アクティブパラメータ数はHacker Newsですぐに話題になりました。
"600b-a27b doesn't sound enticing. Also with the higher number of active parameters compared to GLM 5.3 flash and DeepSeek V4/4.1 flash, I don't see how they want to be more efficient at inference."

これは妥当な指摘です。27Bのアクティブ数は競合の一部の「flash」ティアより重いため、効率面の優位はアクティブ数そのものではなく、アクティブパラメータあたりの知能にあります。これはまさに第三者による推論ベンチマークが決着をつける種類の問題で、StepFun自身のチャートでは決まりません。
これは推論モデルで、reasoning_effortコントロールをlow、medium、highに設定できます。effortを上げると内部の思考トレースが長くなり、出力トークンはそのトレースを含めて課金されるため、effortは直接コストを調整するダイヤルになります。この点は価格のセクションで重要になるので覚えておいてください。
価格:実際に気に入った部分
価格は、今回の発表で最も好印象を持ちやすい点です。StepFunの料金ページから、100万トークンあたりの料金です。
| 課金単位 | 入力(キャッシュミス) | 入力(キャッシュヒット) | 出力 |
|---|---|---|---|
step-5-preview | $1.00 | $0.05 | $2.70 |
step-3.7-flash(参考) | $0.20 | $0.04 | $1.15 |
入力のキャッシュヒット95%割引が目玉で、大部分が変わらない大きなシステムプロンプトをステップごとに再送信するエージェント型ワークロードにとって大きな意味があります。出力の$2.70は推論トレースと最終回答の両方をカバーするので、高effortで饒舌な実行は実際にお金がかかります。
この出力と推論のコストは過小評価しやすいため、ご自身の数値を入れられる簡単な見積もりツールを用意しました。
試用向けの無料V0ティア(同時実行5、毎分10リクエスト)もあり、レート制限はチャージ額に応じて拡大します。トークンあたりの純粋な価格では、現在の推論モデルのクラスで最も良い条件の1つです。プレミアム層ではなくDeepSeek V4 Flashと同じ低予算帯で競合し、その大半を下回ります。
ベンチマークと、このレビューを左右する注意点
StepFunは、オープンな同等モデル(Kimi K3、GLM-5.3)とクローズドなフロンティア(GPT-6 Astra、Claude Opus 5)との完全な比較を公開しました。その概要を示します。数値はすべてStepFun自身の製品ページによるものです。
| ベンチマーク | Step 5 Preview | Kimi K3 | GLM-5.3 | GPT-6 Astra | Claude Opus 5 |
|---|---|---|---|---|---|
| DeepSWE v1.1 | 67.7 | 67.5 | 66.9 | 74.1 | 74.0 |
| StepCodeBench | 49.0 | 43.9 | 40.2 | 61.0 | 63.9 |
| ProgramBench | 80.5 | 77.8 | 72.0 | 85.4 | 82.3 |
| Terminal-Bench v4 | 33.3 | 12.6 | 41.9 | 57.9 | 52.3 |
| FrontierFinance | 66.4 | 62.6 | 64.1 | 55.0 | 69.7 |
読み取れる傾向は一貫しています。Step 5は他の主要なオープンモデルと同等で、純粋なコーディング品質ではトップのクローズドモデルに及ばず、コストでは勝っています。難しいコーディングテストではClaude Opus 5との差が最も大きくなります。金融が目立った強みで、オープンな同等モデルをわずかに上回り、GPT-6 Astraにも勝っています。自社のStepCodeBenchレーダーも、オープン勢に対して同じ話を示しています。
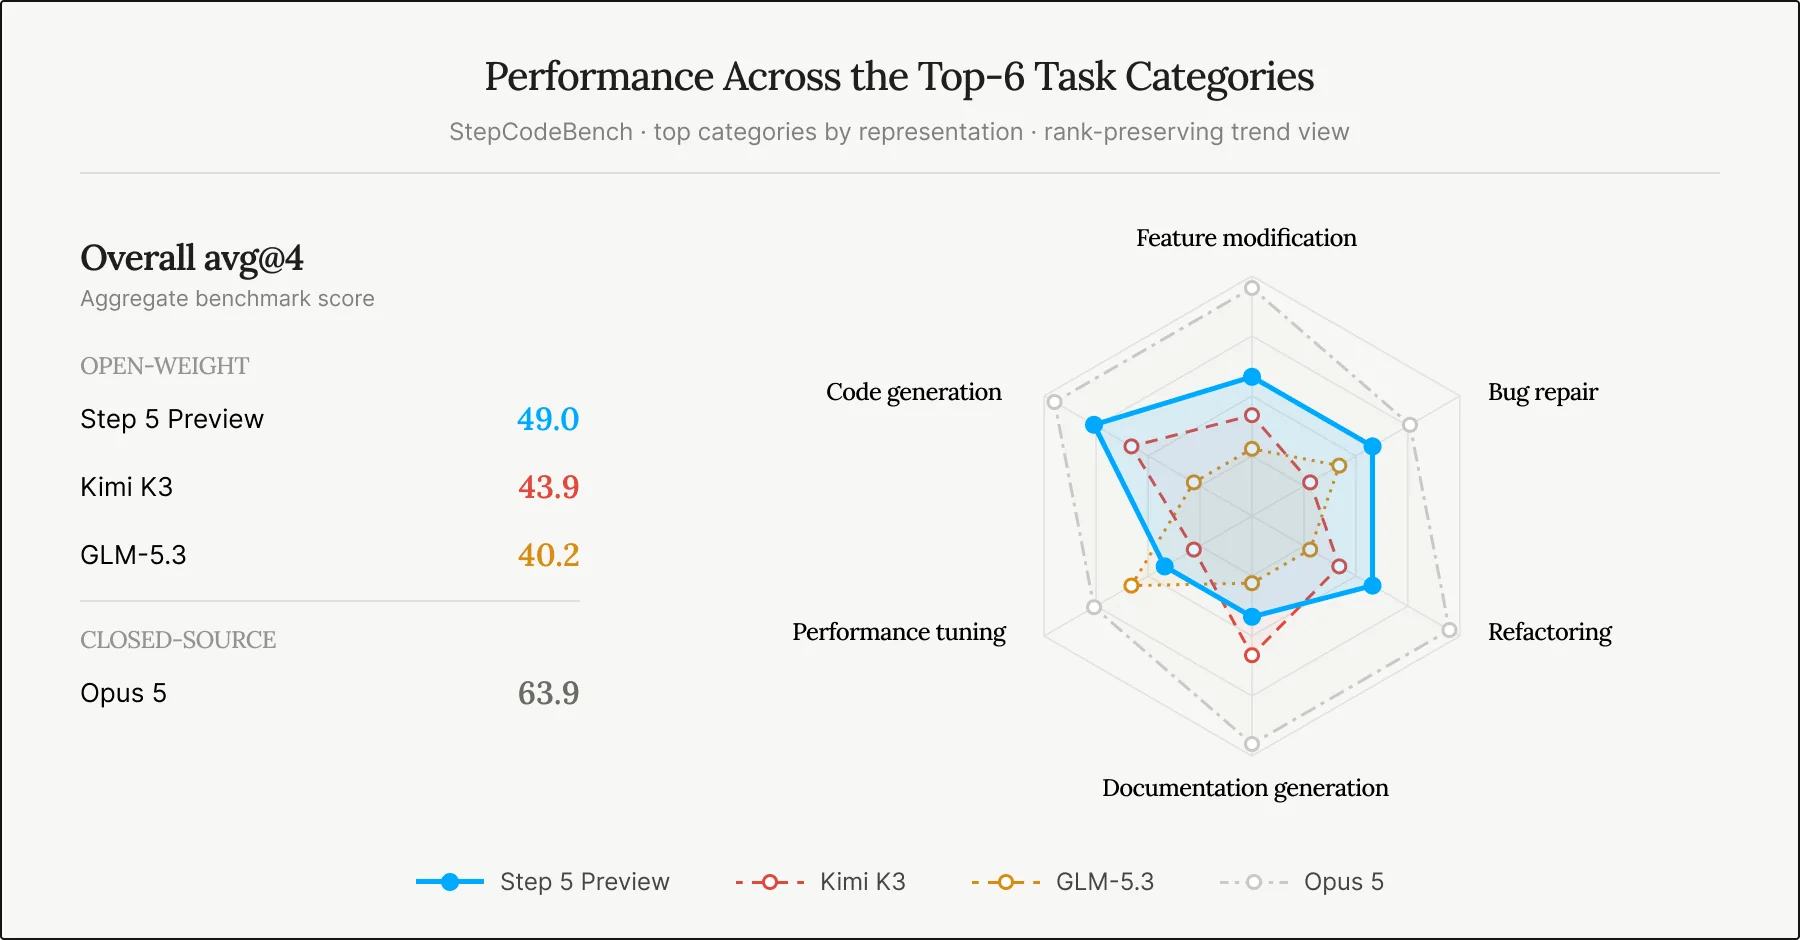
ここで注意点です。これが、私のベンチマーク信頼性スコアが4である理由です。上記の数値はすべて自己申告で、技術レポートも論文もまだなく、StepCodeBenchはStepFun自身のベンチマーク(553リポジトリ、33言語)です。モデルは、自分のチームが設計したテストでは良く見えがちです。コミュニティは、特に冗長さという弱い部分をすぐに指摘しました。
"Based on the examples, it's like the thing took a writing class from Claude, but isn't quite as smart, kind of worst of both worlds. The 'Interactive Reporting' one is particularly terrible. A huge amount of waffly padding around a thesis that may or may not exist."
また、ある投稿者は、発表時のデモが自らボロを出していることに気づきました。発表時のチャートを信用する前に自分で評価を回したくなる、まさにそういう点です。
"In their first demo video, to make a 3D render of the photo, the thinking trace gives away the game [...] I'm always astounded how little effort is put into checking the AI answers displayed in these announcements."
こうした点があっても、Step 5が悪いモデルだということにはなりません。未検証のモデルだということで、これは別の話です。正しい対応は、発表時のチャートを額面どおり受け取るのではなく、ご自身のワークロードでシミュレーションすることで、この考え方はカスタマーサポートでどのAIを信頼するかにもそのまま当てはまります。
強み:長いコンテキストと金融
私が読んだすべての情報で裏づけられた強みが2つあります。100万トークンのコンテキストは、私が最も頼りにしたいスペックです。コードベース全体、四半期分のサポート履歴、PDFの山を1回の呼び出しに入れて、文書をまたいだ推論を依頼するのに十分な量です。マルチモーダル面では、1リクエストあたり最大60枚の画像と短い動画を渡せますが、出力はテキストのみです。
StepFunはコーディングの話にも強く力を入れています。Step 5は「from software engineering and visual applications to programmable hardware」に対応できると主張し、専門家による評価では、参加者の約70%が、やや高い複雑さのコーディングタスクを自律的に解決できると判断したと、製品ページで述べています。「Step Plan」を通じたClaude Code連携があり、100万のコンテキストをフルに使えるため、開発者に届く賢い入口です。FrontierFinanceでの金融の結果は、クローズドモデルを含めて明確にトップに立つ唯一のベンチマークです。
長所と短所
何かを試すか判断するときに実際に使う2つのリストに、レビューをまとめます。
良い点
- 低価格帯で最高の価格あたり知能。100万トークンあたり$1.00 / $2.70。
- 実運用で128kに制限されるマーケティング上の数字ではなく、本物の100万トークンのコンテキスト。
- 繰り返しプロンプトのエージェント型ワークロードに報いる95%のキャッシュヒット割引。
- 誠実な位置づけ。「フロンティアを上回る」ではなく「低価格帯で最高」と言っている。
- ロードマップ上にオープンウェイト公開があり、FlashラインにはApache 2.0の前例がある。
気になる点
- ベンチマークはすべて自己申告で、技術レポートがなく、自作テストが1つ。
- コミュニティの評価は出力が冗長で、出力トークンの請求額をひそかに押し上げる。
- 27Bのアクティブ数は競合の一部のflashティアより重く、効率面の優位は未確定。
- 現時点ではAPIのみ。「オープン」という売りを面白くするウェイトはまだ公開されていない。
- 素のモデルなので、製品に仕上げる作業はすべてご自身の責任になる。
Step 5が向いている人、待つべき人
私の結論はこうです。能力が高く、安価で、長いコンテキストを扱えるモデルを土台にしたい開発者やラボ、特にコーディング、金融、大量の文書を扱うリサーチ用途なら、Step 5 Previewは実際に試す価値があります。価格あたりの知能の話は本当に優れており、オープンウェイトの約束がさらに興味を引きます。
確立された実績あるモデルを待っているなら、待ってください。これはプレビューで、ベンチマークは自社採点であり、コミュニティの第一印象は「有望だが冗長で未検証」です。好意的なコメントでさえ、この傾向を穏やかに指摘していました。
"The previous Step models were pretty decent, but unfortunately for them, their model reasons too much and too long [...] Hopefully this doesn't reason too long to get to the answer. I welcome any open model, the more the merrier."
多くの発表が失敗する点、つまり自分が何者かを理解している点は、StepFunを評価します。
"Their posisitoning is nice. Instead of saying they are cheaper and a bit less performant (in terms of intelligence), they say they are best among the cheaper and a bit less performant ones."
素のモデルが終わり、チームメイトが始まる場所
反論しておきたい捉え方が1つあります。これはStepFunのせいではなく、すべてのモデル発表に当てはまります。モデルはソリューションではありません。Step 5 Previewはエンジンです。API、トークンの請求、素の能力を提供します。それをお客様に応答できるものに変えるには、アプリを作り、データをつなぎ、ガードレールを書き、保守を担う必要があります。
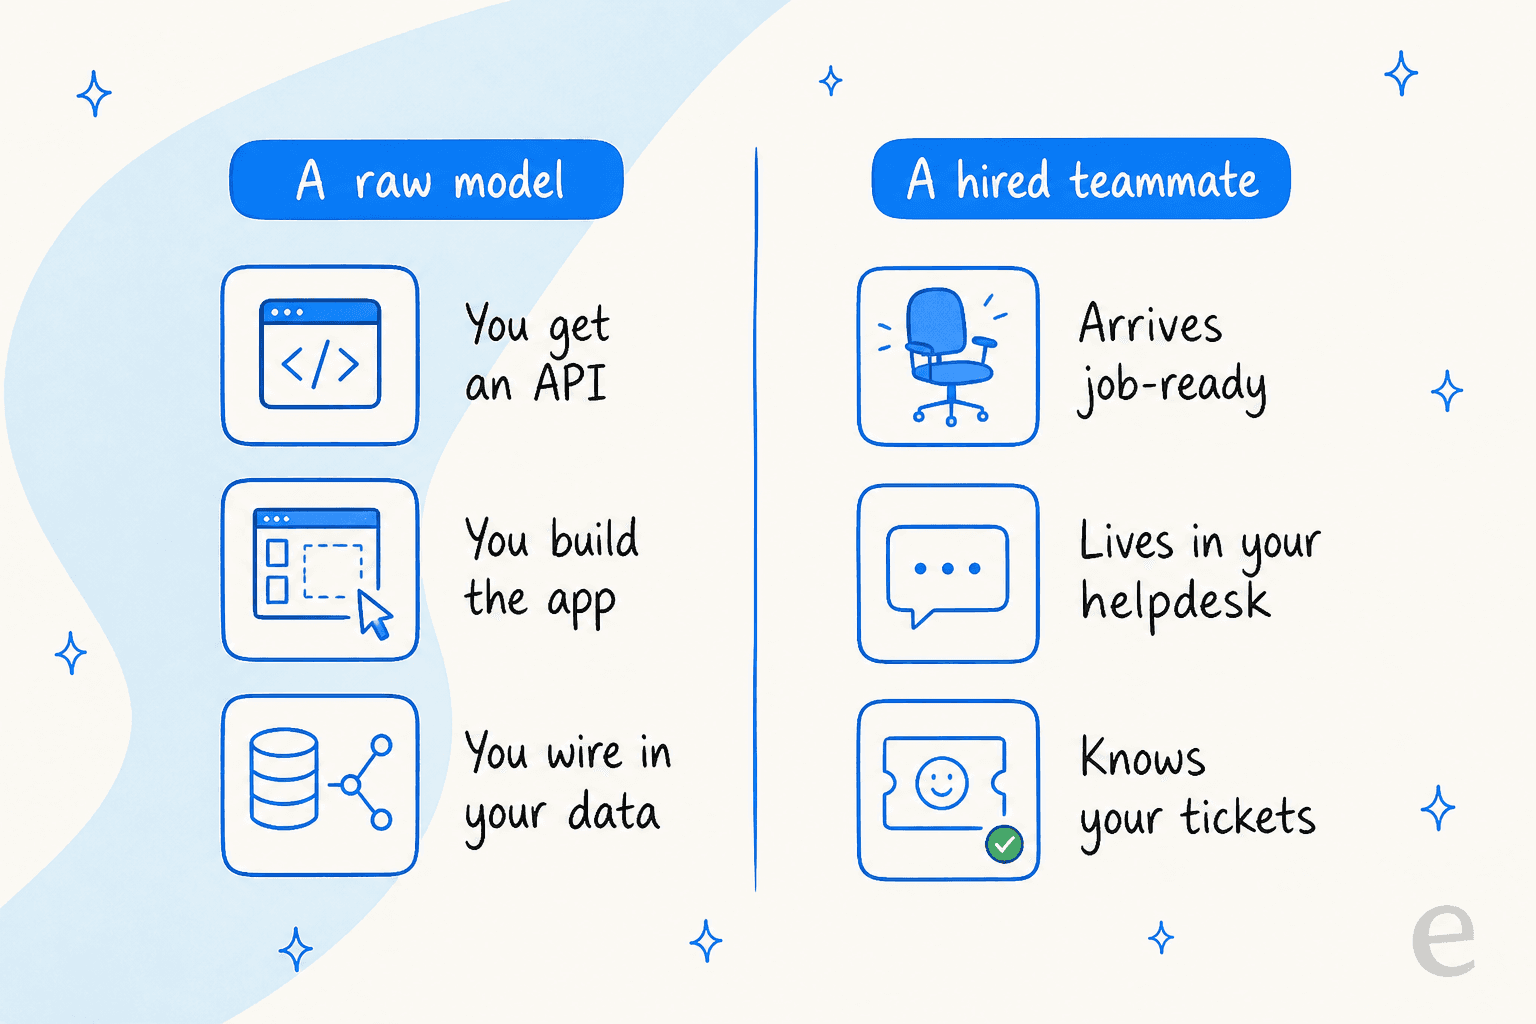
このギャップこそが、eeselが存在する理由です。素のモデルの代わりに、特定の仕事のためにすぐに働けるチームメイトを採用します。AIヘルプデスクチームメイトは既存のキューに参加し、過去のチケットとヘルプセンターで学習し、すでにお使いのヘルプデスク内で返信を下書きまたは送信します。Zendesk、Freshdesk、Gorgiasのいずれでも対応します。料金は解決あたりの定額で、席ごとの料金はありません。そのため、コストは消費したトークンではなく、完了した仕事に連動します。

自己申告ベンチマークの問題を考えると、私が最も重視するのは、実際のお客様に触れる前に、何千件もの過去のチケットでチームメイトをシミュレーションできる点です。ベンダーのチャートではなく、ご自身のワークロードでの本当の解決率が見えます。また、ダッシュボードよりターミナルから操作したい場合は、eeselが本物のCLIとMCPサーバーを提供しているため、Claude Codeのようなコーディングエージェントが同じチームメイトを直接操作できます。Step 5のような新しいモデルは、刺激的なインフラです。シフトに実際に現れるのはチームメイトです。eeselは無料でお試しいただけます。