

StepFun Step 5 Previewの正体
私はここ数年、実際のサポートキューにAIを投入してきたので、どのモデル発表も同じ見方で読みます。「ベンチマークがきれいか」ではなく、「明日、本物の仕事を任せられるか」です。Step 5は本当に面白いモデルであり、その第二の問いがなぜ重要かを示す好例でもあります。
StepFun(阶跃星辰)は、数年前からテキスト、ビジョン、音声にわたる「Step」ファミリーを出してきた上海のラボで、Hugging Faceでのオープンウェイトの実績も豊富です。Step 5 Previewはその新しいフラッグシップで、製品ページでは「複雑な作業とエージェント型タスク向け」のフロンティアモデルとされ、特にソフトウェア開発と金融に重点を置いています。
StepFunが繰り返し掲げる枠組みは「パレートフロンティアを押し広げる」ことで、これは知能とコストの最良のトレードオフを結んだ線のことです。自社の発表チャートもはっきり述べています。知能では安価なオープン層に並び、コストでそれを下回る、ということです。
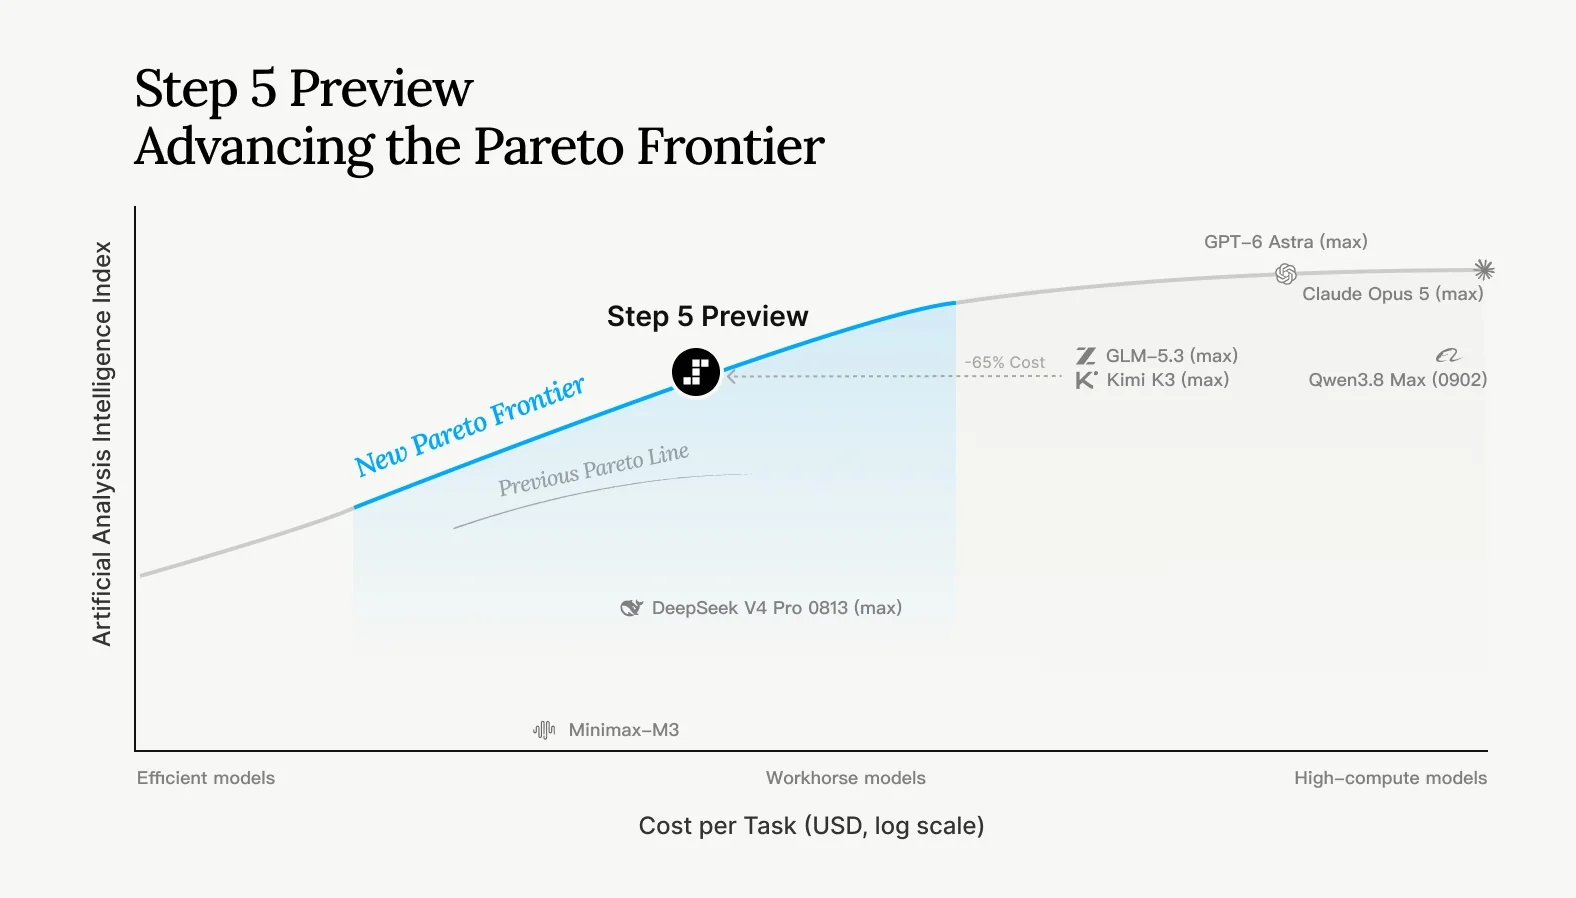
このチャートに織り込まれた主張に注目してください。同程度の知能水準で、GLM-5.3やKimi K3よりコストが65%低いというものです。ベンダー自身のチャートなので、評決ではなく売り文句として読むべきですが、少なくとも筋の通った売り文句です。
スパースMoEの仕組み:総計600B、アクティブ27B
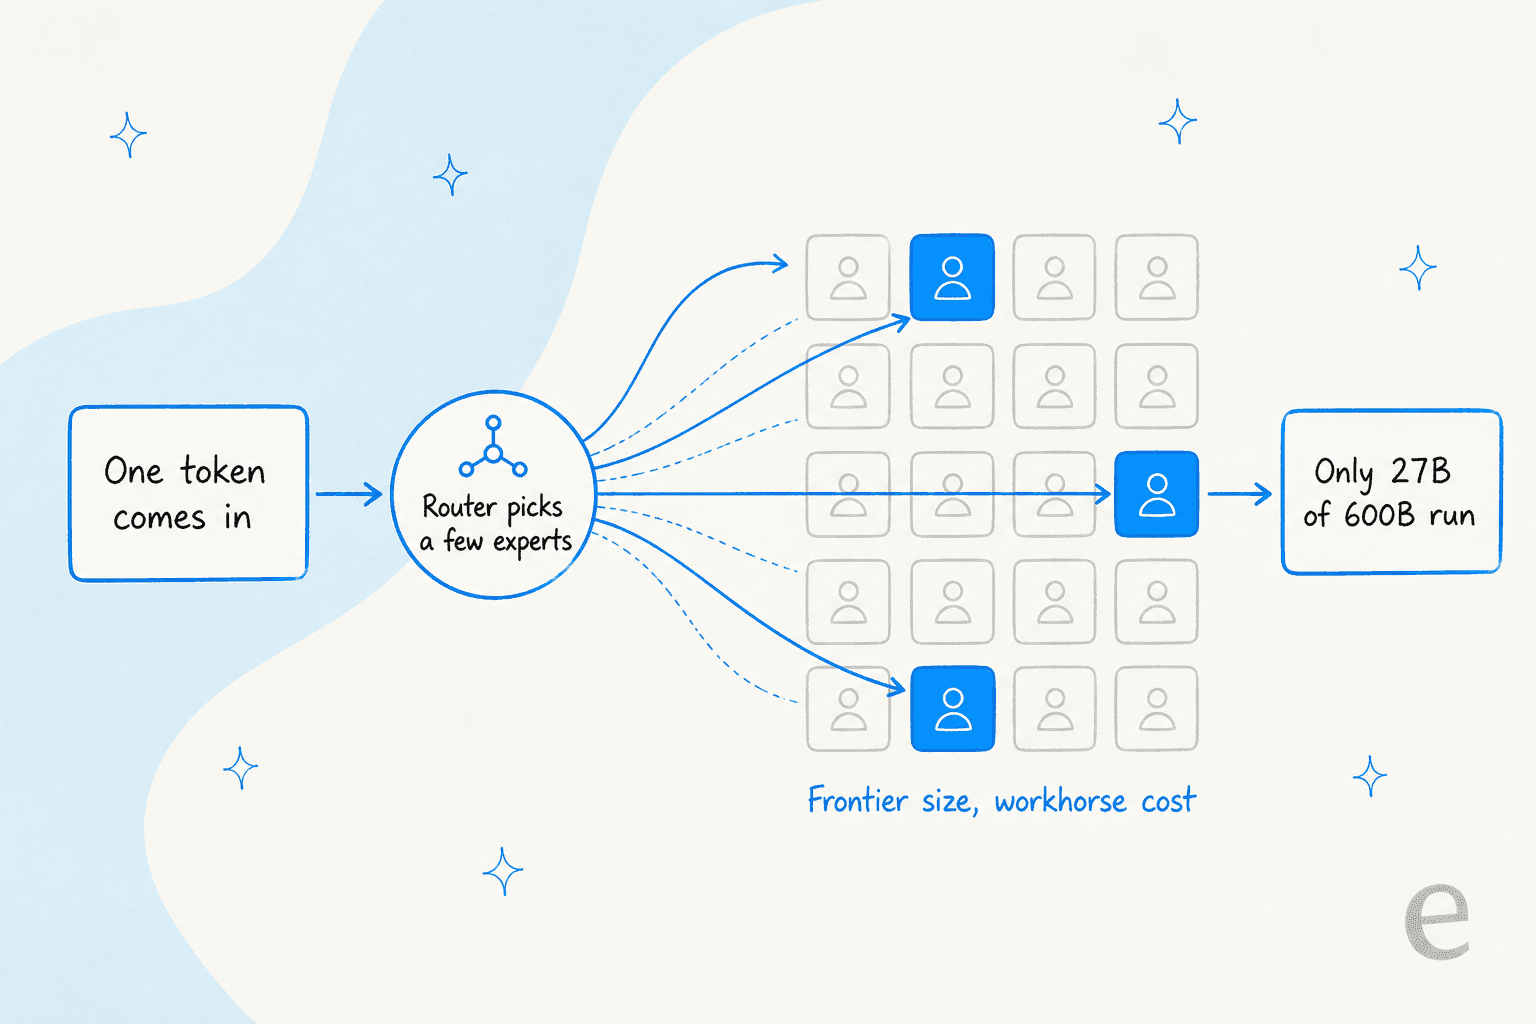
誰もが飛びついた目玉のスペックは、モデルの形です。総パラメータ600B、トークンあたりアクティブ27B。これはスパース混合エキスパート型の設計で、コストの話のすべてが一つの数字に凝縮されています。
密なモデルでは、すべてのトークンに対してすべてのパラメータが動きます。混合エキスパート型のモデルでは、小さなルーターがトークンごとに少数の「エキスパート」サブネットワークを選ぶため、モデルのごく一部だけが実際に発火します。Step 5はフロンティア級の600Bをメモリに保持しつつ、一度に点灯するのは27Bだけなので、StepFunは中堅モデル並みの価格をつけられます。
この計算がStep 5に有利に働くとは、誰もが思っているわけではありません。アクティブパラメータ数は、Hacker Newsですぐに話題になりました。
"600b-a27b doesn't sound enticing. Also with the higher number of active parameters compared to GLM 5.3 flash and DeepSeek V4/4.1 flash, I don't see how they want to be more efficient at inference."

もっともな指摘です。27Bのアクティブは、競合の一部の「flash」層より重いので、効率面の利点は、アクティブ数そのものではなく、アクティブパラメータあたりに得られる知能の話です。これこそ、StepFun自身のチャートではなく、独立した推論ベンチマークが決着をつける類の問題です。
推論モデルでもあり、reasoning_effortをlow、medium、highで指定するコントロールがあります。努力度を上げると内部の思考トレースが長くなり、出力トークンはそのトレースを含めて課金されるため、努力度はそのままコストのダイヤルになります。
できること:コンテキスト、モダリティ、機能
こちらはStepFun自身のプラットフォームドキュメントにあるスペック表で、実際にこの上に構築することを考えているなら最も関係の深い部分です。
| スペック | Step 5 Preview |
|---|---|
| モデルID | step-5-preview |
| アーキテクチャ | スパースMoE、総計600B / アクティブ27B |
| コンテキストウィンドウ | 100万トークン |
| 最大出力 | 64kトークン |
| 入力タイプ | テキスト、画像、動画 |
| 出力タイプ | テキスト |
| 推論 | reasoning_effort: low / medium / high |
100万トークンのコンテキストは、私が最も重視したいスペックです。コードベース全体、四半期分のサポート履歴、PDFの束を一度の呼び出しに入れ、ドキュメントをまたいだ推論を求めるのに十分です。マルチモーダル面では、1リクエストあたり最大60枚の画像と短い動画クリップを渡せますが、出力はテキストのみです。
StepFunはコーディングの訴求に力を入れています。Step 5は「ソフトウェア開発やビジュアルアプリケーションからプログラマブルハードウェアまで」こなせるとし、専門家による評価では参加者の約70%が、やや高い複雑さのコーディングタスクを自律的に解決できると判断したと主張しています。さらに、フルの100万コンテキストを公開する「Step Plan」経由のClaude Code連携もあり、開発者と出会う場として賢い選択です。
ベンチマークと正直な注意点
StepFunは、オープンの競合(Kimi K3、GLM-5.3)とクローズドの最先端(GPT-6 Astra、Claude Opus 5)の両方との比較表を公開しました。以下がその概観で、数値はすべてStepFun自身の製品ページによるものです。
| ベンチマーク | Step 5 Preview | Kimi K3 | GLM-5.3 | GPT-6 Astra | Claude Opus 5 |
|---|---|---|---|---|---|
| DeepSWE v1.1 | 67.7 | 67.5 | 66.9 | 74.1 | 74.0 |
| StepCodeBench | 49.0 | 43.9 | 40.2 | 61.0 | 63.9 |
| ProgramBench | 80.5 | 77.8 | 72.0 | 85.4 | 82.3 |
| Terminal-Bench v4 | 33.3 | 12.6 | 41.9 | 57.9 | 52.3 |
| FrontierFinance | 66.4 | 62.6 | 64.1 | 55.0 | 69.7 |
読み取れる傾向は一貫しています。Step 5 Previewは、他の有力なオープンモデルと同等水準で、純粋なコーディング品質では最上位のクローズドモデルに及ばない一方、コストで勝っています。金融は突出した強みで、他のオープンモデルをわずかに上回り、GPT-6 Astraにも勝っています。自社のStepCodeBenchレーダーも、オープン層に対して同じ状況を示しています。
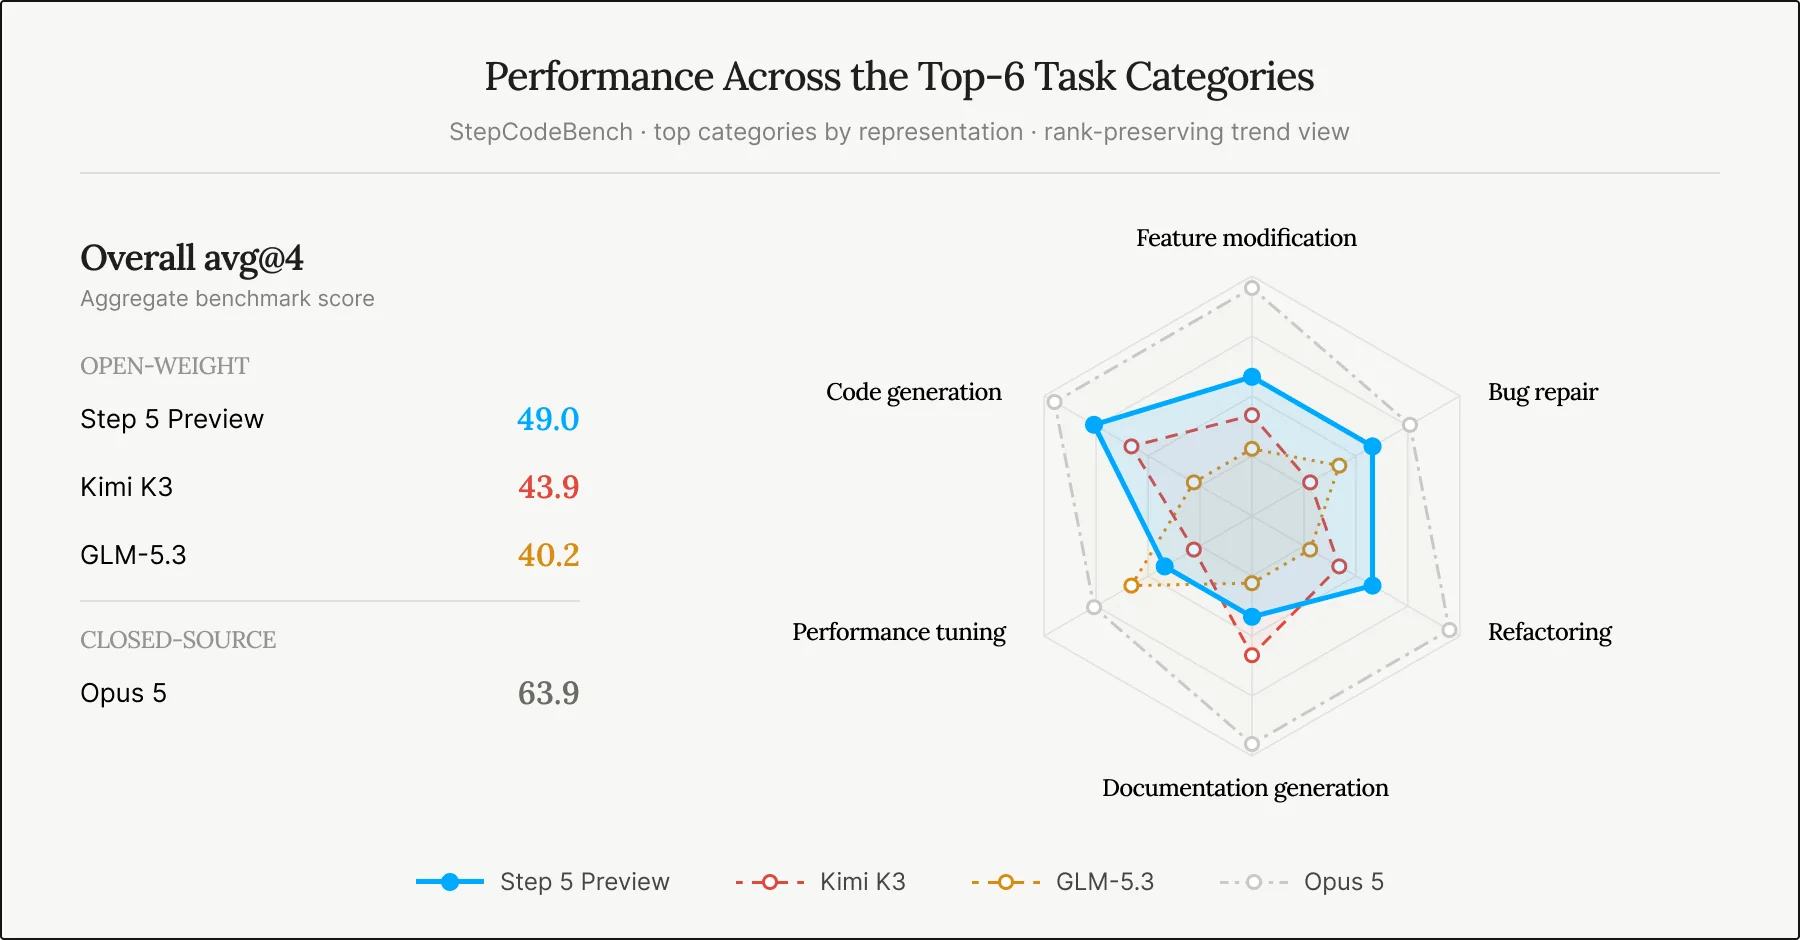
さて、大きな注意点があります。上の数値はすべて自己申告で、技術レポートも論文もまだなく、StepCodeBenchはStepFun自身のベンチマークです(553リポジトリ、33言語)。モデルは、自チームが設計したテストでは良く見えがちです。コミュニティも、特に冗長さなど弱い部分をすぐ指摘しました。
"Based on the examples, it's like the thing took a writing class from Claude, but isn't quite as smart, kind of worst of both worlds. The 'Interactive Reporting' one is particularly terrible. A huge amount of waffly padding around a thesis that may or may not exist."
また、あるコメント投稿者は発表時のデモが自らボロを出していると指摘しており、何かを信じる前に自分で評価を回したくなる類の話です。
"In their first demo video, to make a 3D render of the photo, the thinking trace gives away the game [...] I'm always astounded how little effort is put into checking the AI answers displayed in these announcements."
これらはStep 5が悪いモデルだという意味ではありません。未検証のモデルだという意味で、それは別のことです。正しい対応は、発表時のチャートを額面どおり受け取るのではなく、自分のワークロードでシミュレーションすることです。
料金と入手方法
この発表の中で、素直に好きになれるのが料金です。StepFunの料金ページより、100万トークンあたり:
| 課金単位 | 入力(キャッシュミス) | 入力(キャッシュヒット) | 出力 |
|---|---|---|---|
step-5-preview | $1.00 | $0.05 | $2.70 |
step-3.7-flash(参考) | $0.20 | $0.04 | $1.15 |
入力のキャッシュヒット時95%割引は目玉で、大きくほぼ固定のシステムプロンプトをステップごとに再送信するエージェント型ワークロードでは大きな意味を持ちます。$2.70の出力は推論トレースと最終回答の両方を含むため、おしゃべりな高努力度の実行は実際にお金がかかります。試用向けの無料V0ティア(同時実行5、毎分10リクエスト)もあり、レート制限はチャージ額に応じて上がります。
アクセスの面では、「Preview」というラベルが意味を持ちます。現時点ではAPIのみで、StepFunはオープンウェイトまでの公開カウントダウンを実施しています。
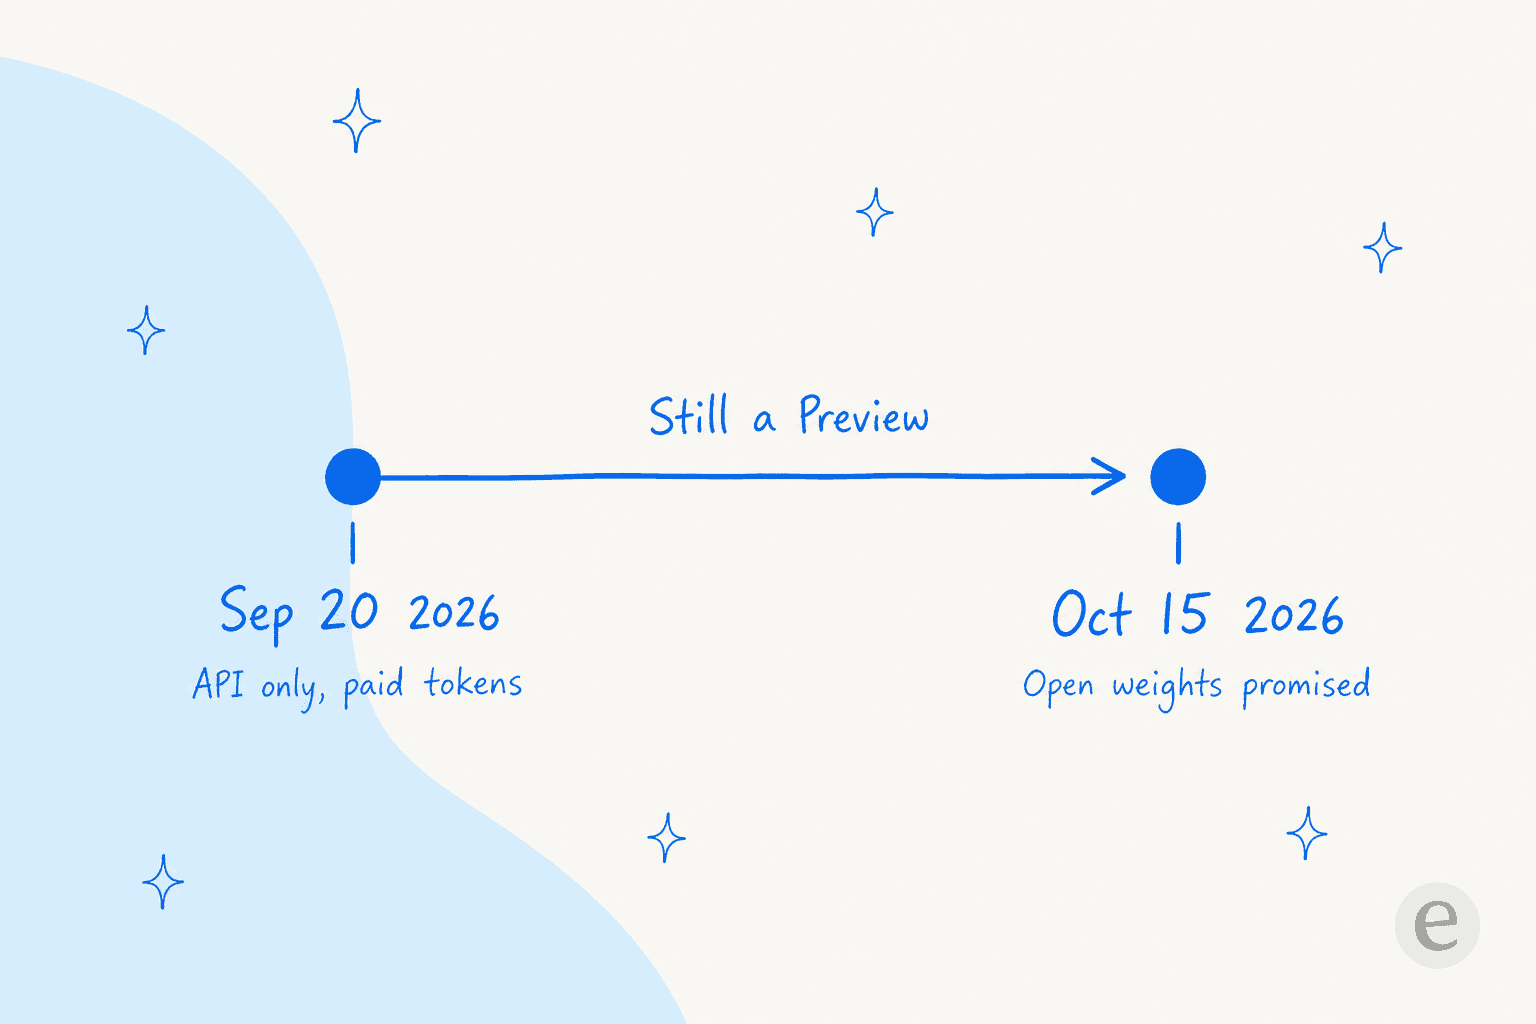
Hugging Faceのリポジトリはすでにありますが、執筆時点ではモデルカードもウェイトもライセンスもない空のプレースホルダーです。StepFunのFlashシリーズはApache 2.0で公開されたので、寛容なオープン公開の可能性は高いものの、まだ公開されていないウェイトを前提にオンプレミスの計画を立てることはお勧めしません。
Step 5が向いている人、待つべき人
私の結論はこうです。有能で安価な長コンテキストのモデルを土台にしたい開発者やラボ、特にコーディング、金融、大量ドキュメントにわたる調査の用途であれば、Step 5 Previewは実際に試す価値があります。価格あたり知能の話は本当に良く、オープンウェイトの約束がさらに興味深くしています。
落ち着いた実績あるモデルを待っているなら、待ってください。これはプレビューで、ベンチマークは自己採点であり、コミュニティの第一印象は「有望だが冗長で未検証」です。好意的なコメント投稿者でさえ、この傾向を穏やかに指摘しました。
"The previous Step models were pretty decent, but unfortunately for them, their model reasons too much and too long [...] Hopefully this doesn't reason too long to get to the answer. I welcome any open model, the more the merrier."
多くの発表が間違えるある一点について、StepFunは評価に値します。自分が何者かを分かっていることです。あるコメント投稿者が述べたように、そのポジショニングは、ランキングの頂点に立つふりをするのではなく、安価な層でのベストであると正直に語っています。
"Their posisitoning is nice. Instead of saying they are cheaper and a bit less performant (in terms of intelligence), they say they are best among the cheaper and a bit less performant ones."
素のモデルが終わり、チームメイトが始まるところ
一つ、私が異議を唱えたい枠組みがあります。これはStepFunのせいではなく、すべてのモデル発表に当てはまります。モデルは解決策ではありません。Step 5 Previewはエンジンです。APIとトークンの請求書と素の能力を与えてくれます。それをお客様に回答できるものに変えるには、アプリを作り、データをつなぎ、ガードレールを書き、保守を担う必要があります。
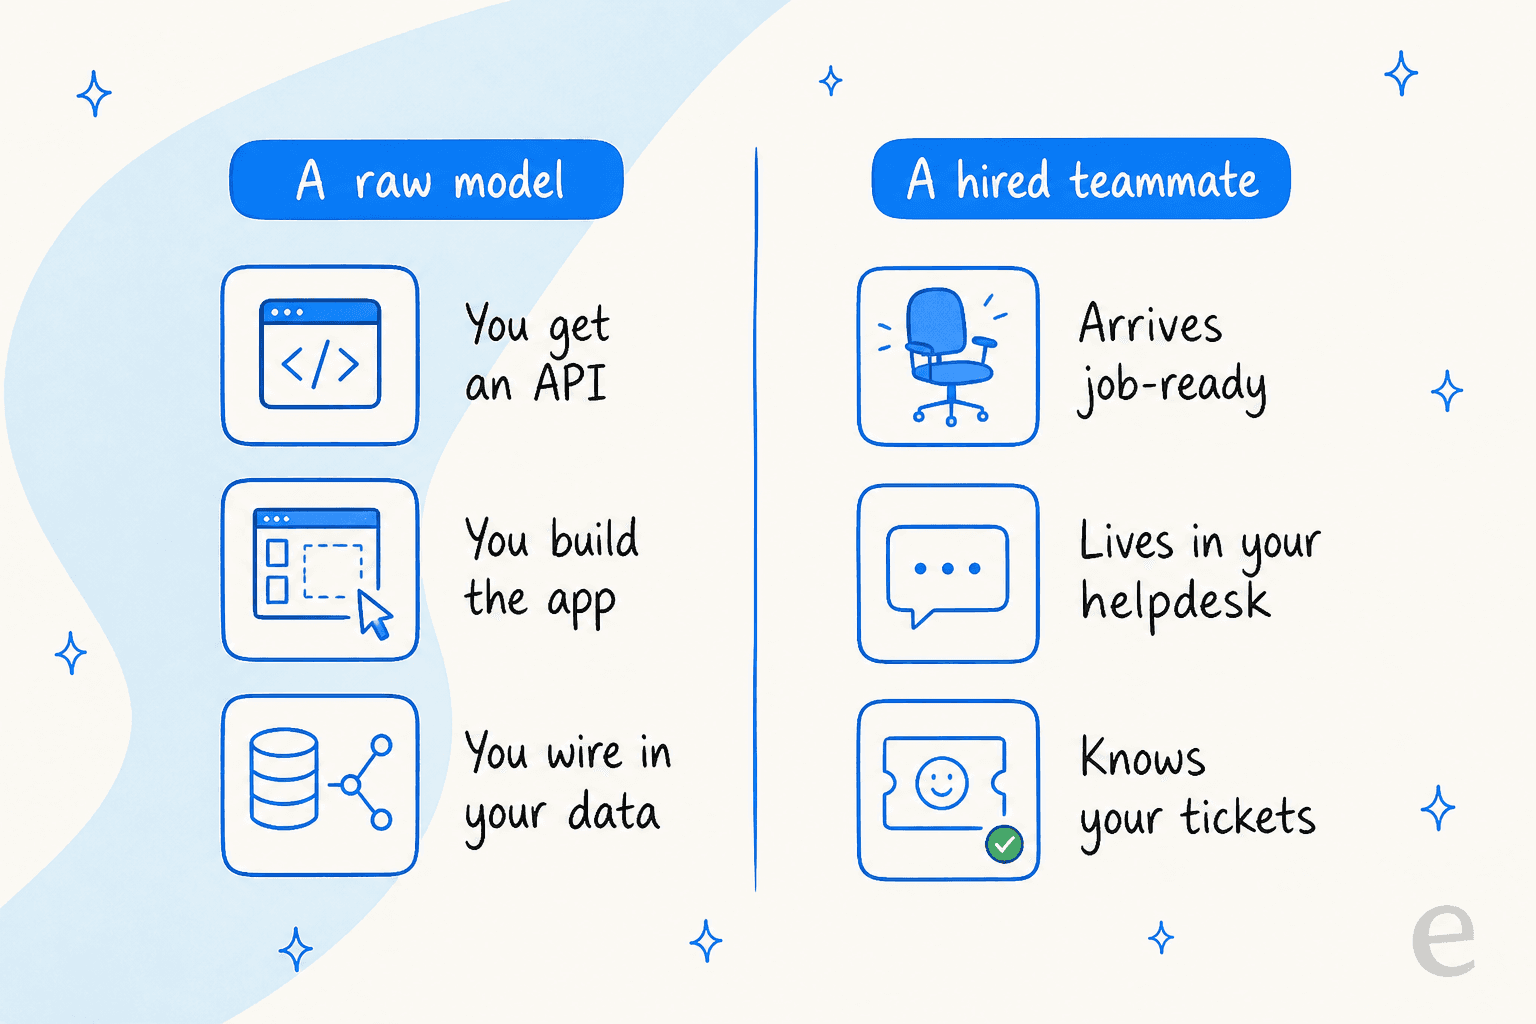
このギャップこそがeeselの存在理由です。素のモデルの代わりに、特定の仕事に向けたすぐ働けるチームメイトを迎えます。AIヘルプデスクのチームメイトは既存のキューに加わり、過去のチケットやヘルプセンターで学習し、すでに使っているヘルプデスク(Zendesk、Freshdesk、Gorgiasなど)の中で返信を下書きまたは送信します。料金は解決あたりの定額で、席ごとの料金はありません。そのため、コストは消費したトークンではなく、完了した仕事に対応します。

上で述べた「自己申告ベンチマーク」の問題を踏まえて私が最も重視しているのは、チームメイトが実際のお客様に触れる前に、自社の過去チケット数千件でシミュレーションできることです。ベンダーのチャートではなく、自社のワークロードでの本当の解決率が分かります。ダッシュボードよりターミナルやスクリプトから操作したい場合は、eeselが本物のCLIとMCPサーバーを提供しており、Claude Codeのようなコーディングエージェントが同じチームメイトを直接操作できます。Step 5のような新しいモデルは、わくわくするインフラです。チームメイトは、実際にシフトに現れる存在です。eeselを無料でお試しいただけます。