

Groq 3 LPX は、Vera Rubin プラットフォーム向けの NVIDIA の新しいラックスケール推論アクセラレータで、2026 年 8 月 24 日に本格量産に入りました。1 ラックに 256 個の Groq 3 LPU チップを束ね、Vera Rubin NVL72 GPU と並んで動作します。GPU はメモリを多く使うコンテキスト処理を担当し、LPU はトークンを素早く生成するというレイテンシに敏感な処理を担当します。この分担の狙いは、スループットを犠牲にせずにエージェント型 AI を速く感じさせることです。
名前がややこしいのは意図的です。NVIDIA は Groq の LPU 技術のライセンスを取得(非独占)し、創業者と主要メンバーを迎え入れました。つまりこれは、Groq の設計をもとにした NVIDIA の製品で、Groq の名前はライセンスのもとで使われています。企業としての Groq は独立を保ち、GroqCloud も引き続き稼働しています。
目玉の数字については、NVIDIA は Gemma 4 31B、100K コンテキストで毎秒 3,400 トークンを挙げ、さらに前世代比で 1 メガワットあたり 35 倍のスループット、1 ワットあたり 10 倍の収益を見込んでいます。これらは NVIDIA 自身のベースラインに対して測ったベンダーの主張なので、独立してテストされた結果ではなく目標値として読んでください。エージェントを作る人やサポート自動化に取り組む人にとっての実践的な結論はもっとシンプルです。このラックを自分で買うことはまずなく、それが可能にする速さをモデルやクラウド経由で利用することになり、実際に導入するのはその上に載る eesel のようなチームメイトです。
Groq 3 LPX とは実際に何か
NVIDIA は Groq 3 LPX を「NVIDIA Vera Rubin 向けのインタラクティブ AI 推論アクセラレータ」と説明しています。もっと平易に言えば、トークンを速く生成することだけを目的とした専用チップを満載したラックで、汎用 GPU と並んで NVIDIA の最新データセンタープラットフォームに組み込まれます。
NVIDIA が使う枠組みは、典型的な三つ巴のトレードオフです。長年、推論ハードウェアは三つのうち二つの特性しか同時に満たせませんでした。知性とスループット、あるいは知性とインタラクティブ性は両立しても、三つすべてを低コストで満たすことはできませんでした。大きなモデルは応答が遅く、速いモデルは小さいのです。Groq 3 LPX は、各トークンのうちレイテンシに敏感な部分を、まさにそのために作られたチップに任せることで、大きなモデルでも応答性を保てるようにする部品として位置づけられています。
何ではないかを正確に押さえておくことも大切です。どのサーバーにも差し込める単体製品ではなく、GPU の代替でもありません。Vera Rubin NVL72 を拡張するために共同設計されたもので、Rubin GPU の隣で動作し、両者が出力トークンごとにモデルのすべての層を共同で計算します。NVIDIA は LPU を Vera Rubin プラットフォームの「7 番目のチップ」とまで呼んでいます。
ちょっと待って、これはスタートアップの Groq なの?
これは私が最もよく見かけた反応で、もっともな疑問です。Groq は長年、「GPU を増やせばいい」という考えへの反例だった LPU を持つ、野心的な推論スタートアップでした。それが今や「Groq 3 LPX」は NVIDIA の製品ラインです。X のある投稿が、その空気をうまくまとめています。
"so groq the company is now also an nvidia product line, that's going to confuse people for months"
一次情報に基づく正確な説明は次のとおりです。Groq は推論技術について NVIDIA と非独占のライセンス契約を締結しました。これは GroqCloud の料金や Groq の代替サービスの裏にある技術と同じものです。この一環として、創業者の Jonathan Ross をはじめ Groq のチームメンバーが NVIDIA に移り、ライセンスされた設計の拡大を支援しています。Groq は新 CEO の Simon Edwards のもとで独立を維持し、GroqCloud も運営を続けます。NVIDIA 自身のプレスページには、「Groq and LPU are used under license from Groq, Inc.」という脚注があります。
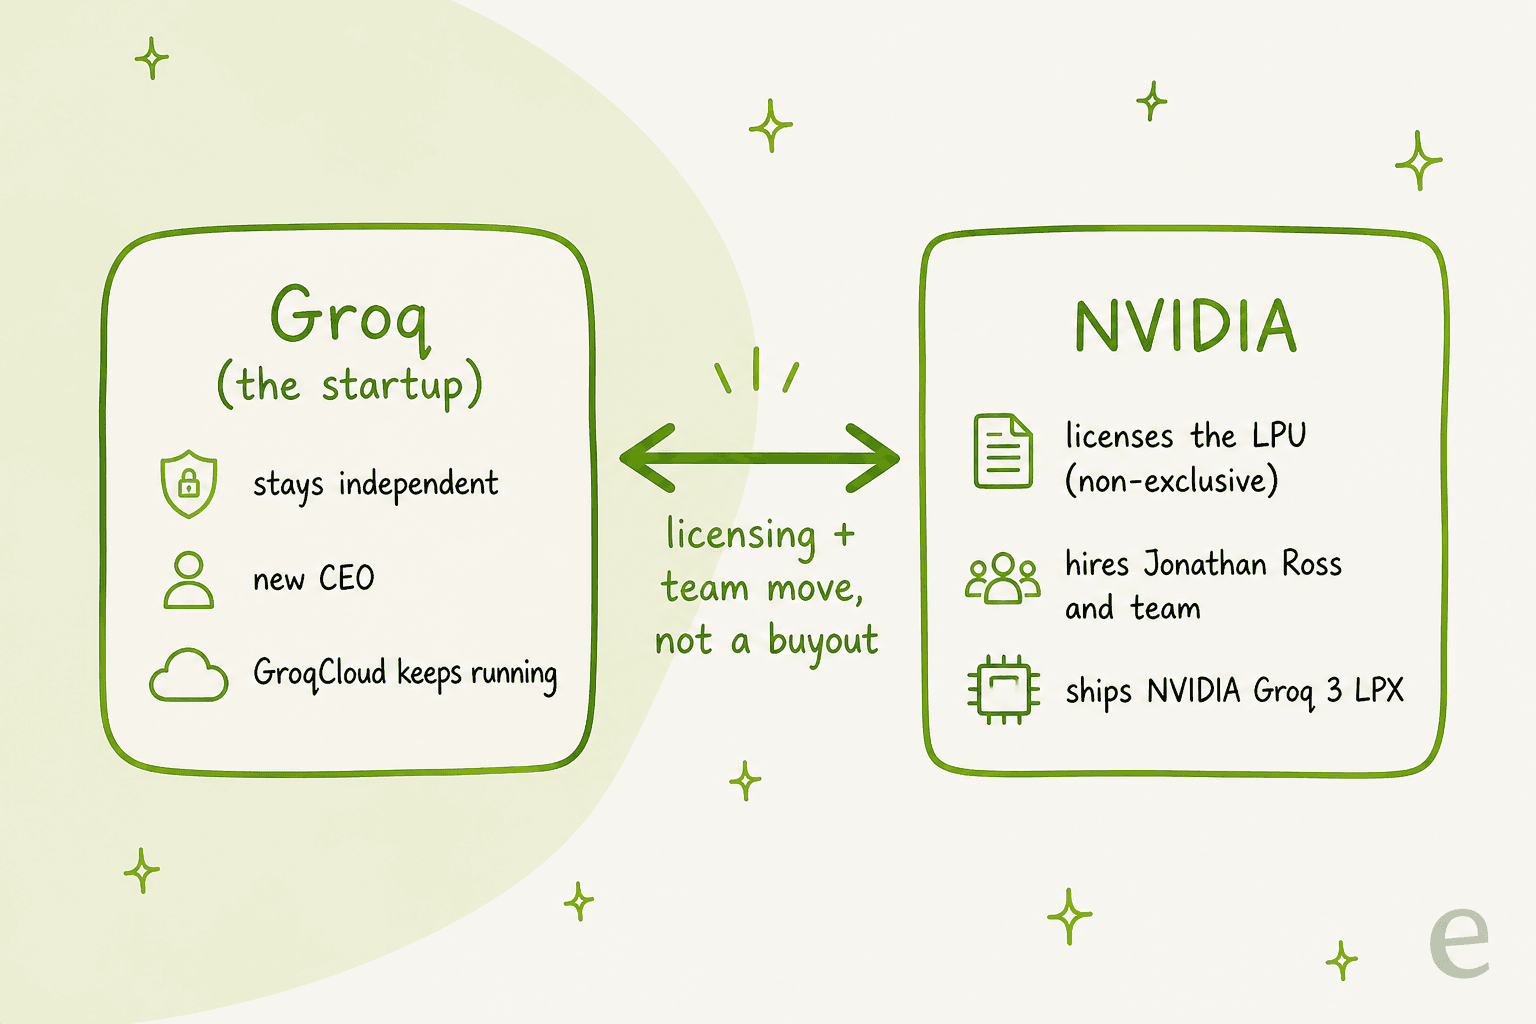
つまり「NVIDIA Groq 3 LPX」を見たら、きれいな買収ではなく、ライセンスとチームの採用を思い浮かべてください。この契約について報道では大きな金額が飛び交っていますが、どちらの企業の公式発表にもその数字は出てこないため、ここでは触れません。一次情報が裏づけるのは上記の構造であり、製品を理解するうえで本当に重要なのはそこです。
1 つのラックにすべてを
スペックは本当に独特なので、ここが一番面白いところです。NVIDIA が挙げる Groq 3 LPX 1 ラックの仕様は次のとおりです。
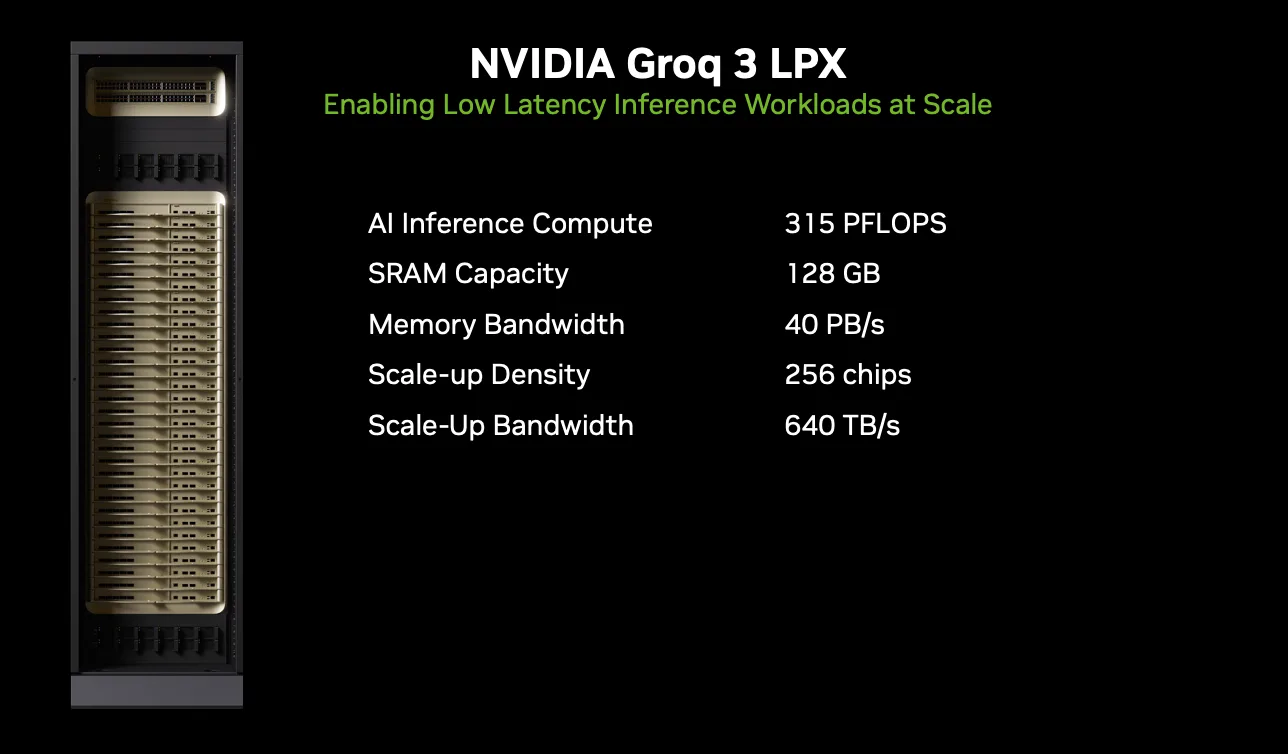
| ラックレベルの仕様 | NVIDIA Groq 3 LPX |
|---|---|
| ラックあたりのチップ数 | Groq 3 LPU アクセラレータ 256 基 |
| AI 推論演算性能 | 315 PFLOPS(FP8) |
| SRAM 総容量 | 128 GB |
| オンチップ SRAM 帯域幅 | 40 PB/s |
| スケールアップ帯域幅 | 640 TB/s |
| 構成 | 液冷 1U コンピュートトレイ 32 枚、各 LPU 8 基 |
目を引く数字はオンチップ SRAM 帯域幅の毎秒 40 ペタバイトです。誤植ではなく、これが設計思想のすべてを 1 つの数字で表しています。低速な外部メモリからチップにデータを供給するのではなく、LPU は作業データをチップ上に保持し、従来のメモリ構成では到達できない帯域幅で移動させます。代償は容量です。ラック全体で 128 GB の SRAM は、GPU ラックが備える数テラバイトの HBM に比べればごくわずかで、だからこそ LPU には隣に GPU が必要なのです。
なぜまったく新しいチップを作るのか?
NVIDIA がなぜここまでやったのかを理解するには、2 つのチップを並べて比べるのが役立ちます。NVIDIA 自身の図がそれをわかりやすく示しています。
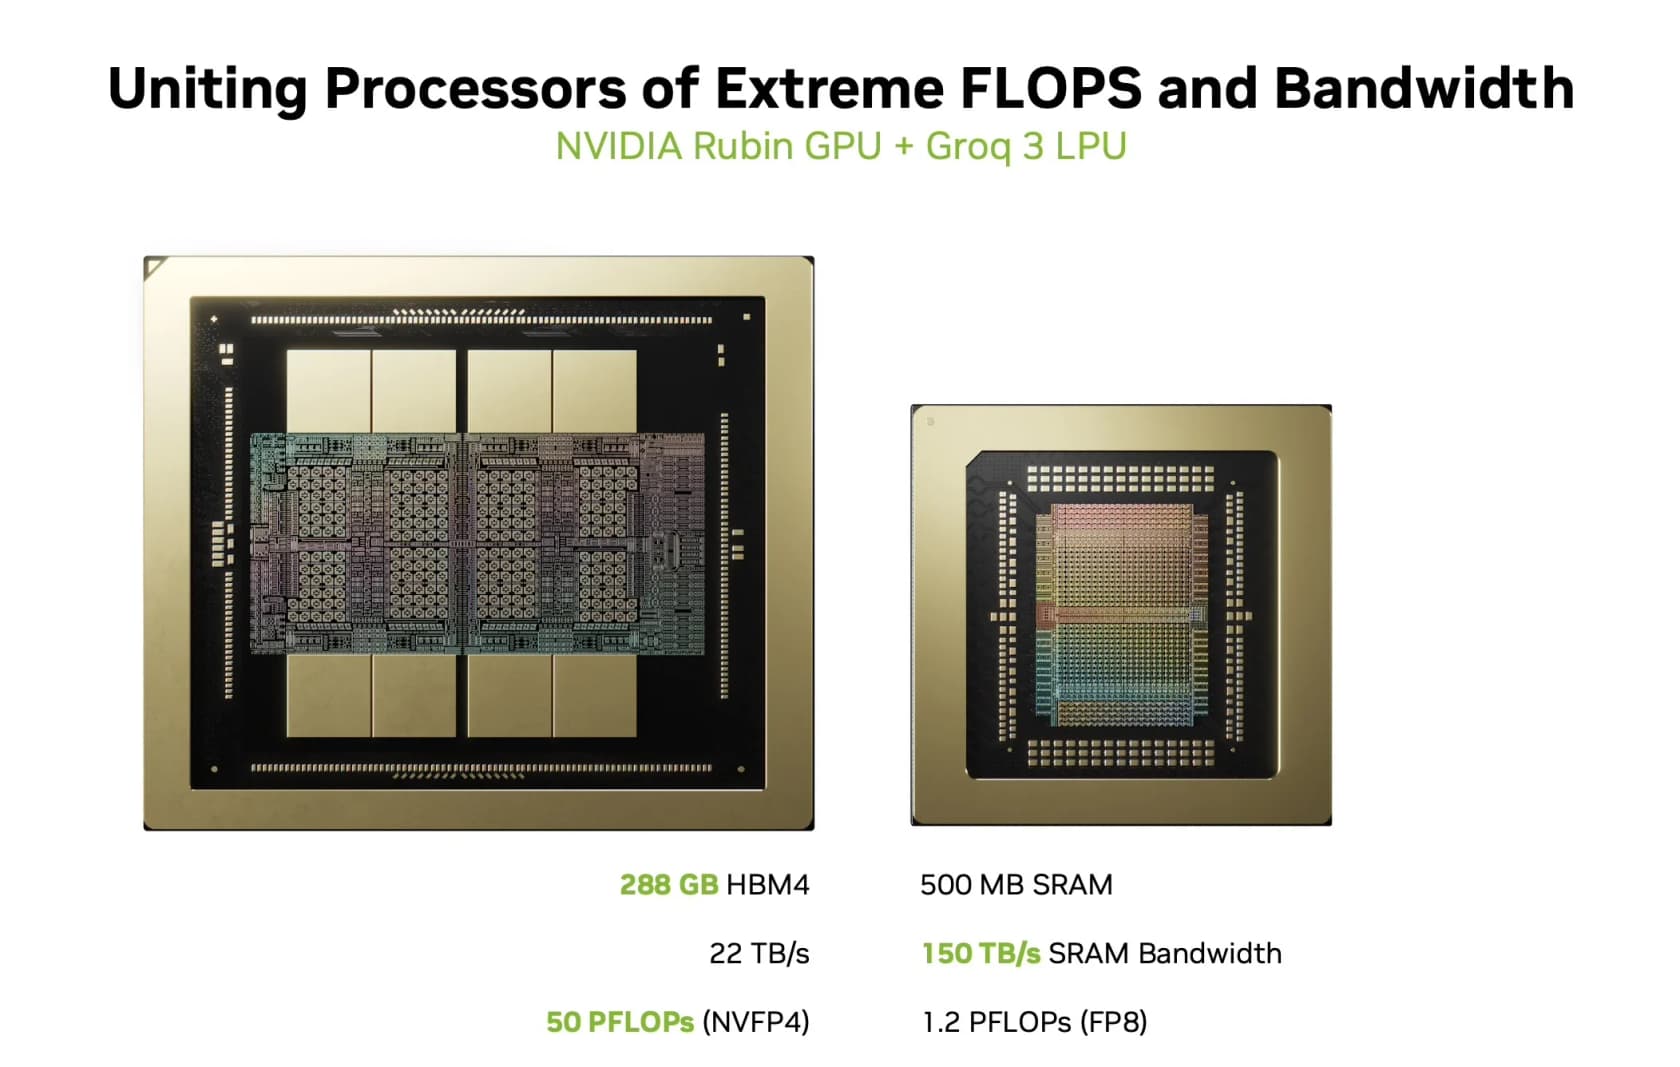
Rubin GPU は約 288 GB の HBM4、約 22 TB/s のメモリ帯域幅、約 50 PFLOPs の演算性能を備えます。Groq 3 LPU 1 基は 500 MB の SRAM を持ちますが、帯域幅は 150 TB/s で、FP8 演算性能は 1.2 PFLOPs です。GPU はピークスループットと大容量メモリに最適化された主力です。LPU は 1 つのことに最適化されています。予測可能で低いレイテンシでトークンの流れを保ち続けることです。
内部の設計上の選択が LPU を GPU と違うものにしており、GPU プログラマーが当然視していることをひっくり返す点が実に興味深いと思います。
- SRAM はキャッシュではなく主記憶です。 LPU 1 基あたり 500 MB のオンチップ SRAM があり、アクティブな重み、活性化、KV 状態を直接保持します。チップ上に HBM は一切ありません。
- ハードウェア管理のキャッシュがありません。 コンパイラとランタイムが、キャッシュのヒューリスティクスに頼らず、データを明示的に配置し移動させます。これにより予測不能なストールが減り、レイテンシが安定します。
- コンパイラがスケジュールする決定論的な実行。 このチップは Groq の空間的実行モデルを土台とし、演算、データ移動、同期があらかじめスケジュールされます。NVIDIA は、数百基の LPU が 1 つの協調したシステムとして動くよう、クロックのずれを打ち消すハードウェアプロトコルを説明しています。
- テンソル中心の明示的なデータ移動。 すべてが 320 バイト固定のベクトルを単位に、専用の行列・ベクトル・スイッチユニットを通じて動くため、スケジューリングが予測可能なままです。
LLM の推論コストがなぜレイテンシにこれほど敏感なのかを考えたことがあれば、これがハードウェア側の答えです。タイミングが予測できるチップを作り、その性質を失わずに数百基をつなぎ合わせるのです。
実際の仕組み:2 つのエンジンのループ
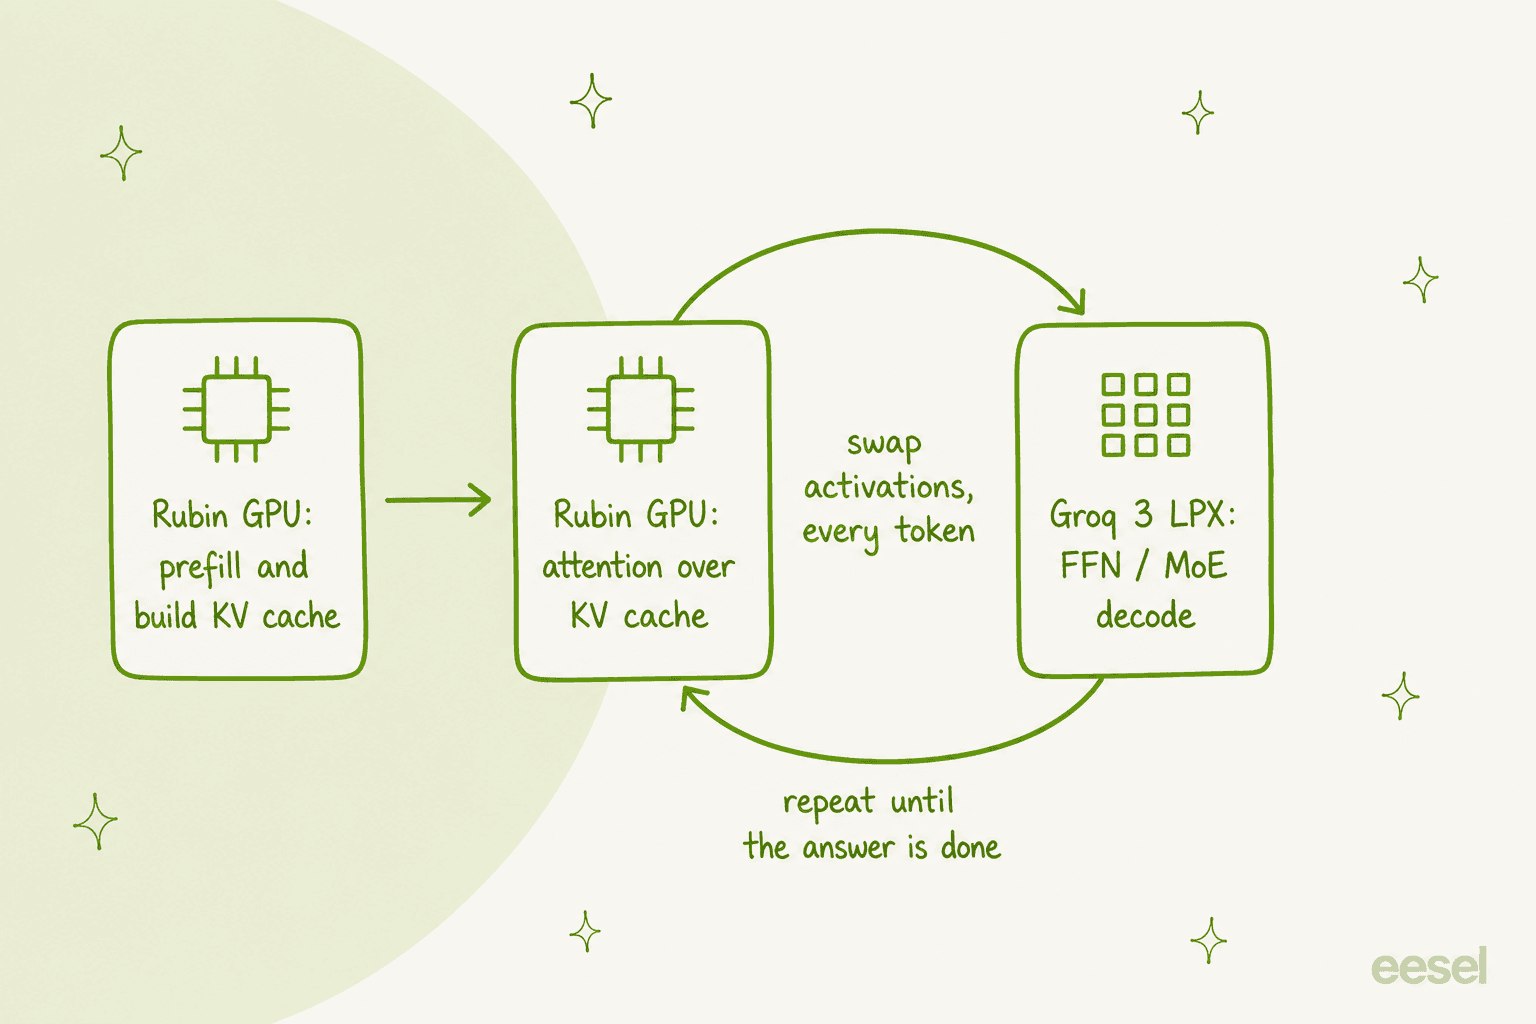
ここで腑に落ちます。NVIDIA の洞察は、推論が均一なワークロードではないという点です。1 つのリクエストには 2 つのまったく異なるフェーズがあり、それぞれ違うハードウェアを求めます。
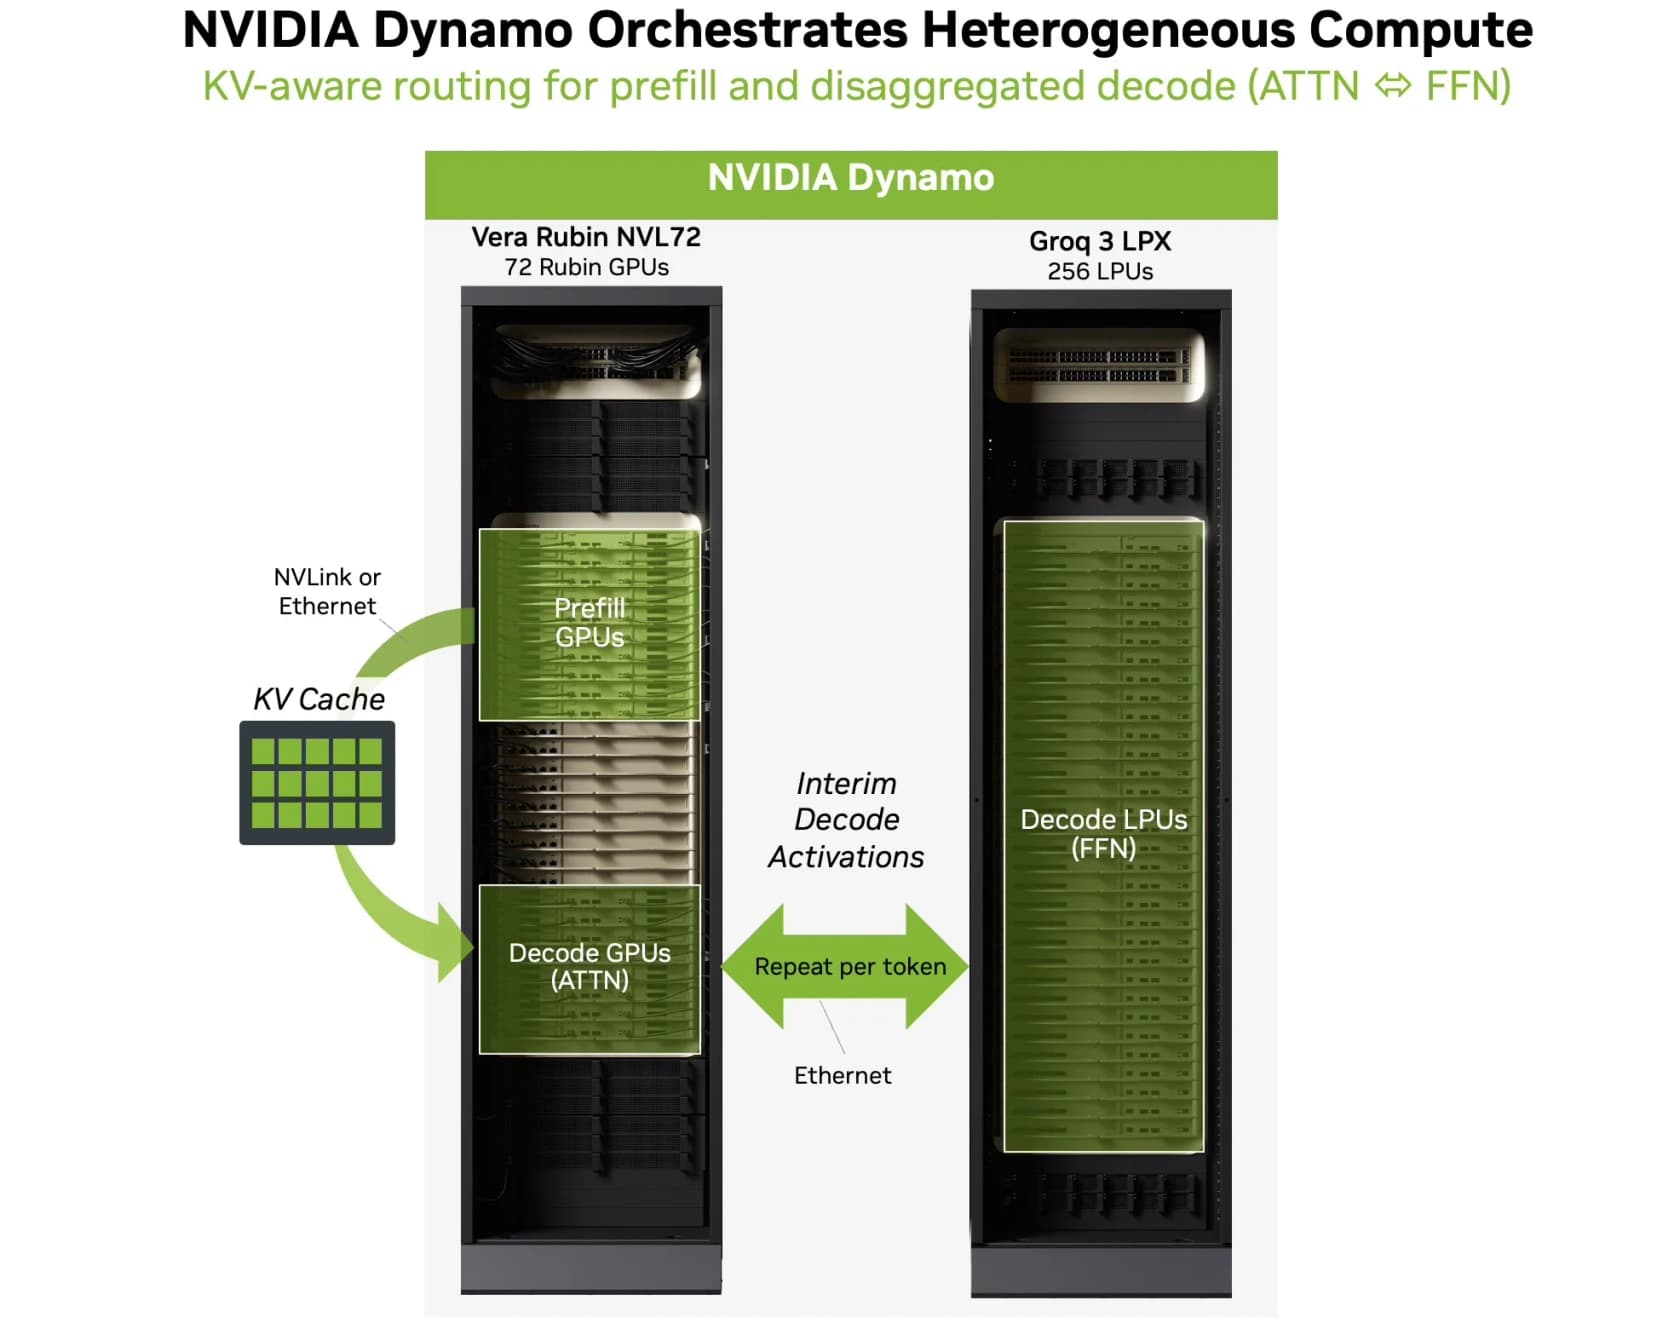
最初のフェーズ プリフィルでは、プロンプトを取り込んで KV キャッシュを構築します。これは密で並列的、かつメモリを大量に使う処理で、GPU に向いています。2 番目のフェーズ デコードでは、ループの中で回答を 1 トークンずつ生成します。NVIDIA はこのループを、アテンション-FFN 分離と呼ぶ手法で 2 つのチップに分担させます。Rubin GPU が蓄積されたコンテキスト上でアテンションを実行し、Groq 3 LPX が最もレイテンシに敏感なフィードフォワードとエキスパート混合の計算を担当します。トークンごとに、両者は中間の活性化をやり取りします。
これらすべての交通整理をするのが NVIDIA Dynamo というオーケストレーション層です。プリフィルを GPU ワーカーに振り分け、トークンごとの活性化をエンジン間で移動させ、レイテンシ目標に照らして全体をスケジュールするため、インタラクティブなセッションがバッチジョブの後ろで詰まることはありません。
LPX にはもう 1 つ知っておくべき役割があります。投機的デコードのドラフトエンジンとして働くのです。決定論的な実行と巨大な SRAM 帯域幅のおかげで、GPU の先を走ってドラフトトークンを素早く生成し、GPU がそれを検証します。これも、2 つのチップが作業を重複させずに分担する方法の 1 つです。
ラックの内部
部品が物理的にどこにあるかを見たいなら、NVIDIA のコンピュートトレイの図が最もわかりやすい見取り図です。1 ラックはこの液冷 1U トレイ 32 枚で構成され、各トレイには LPU が 8 基載っています。
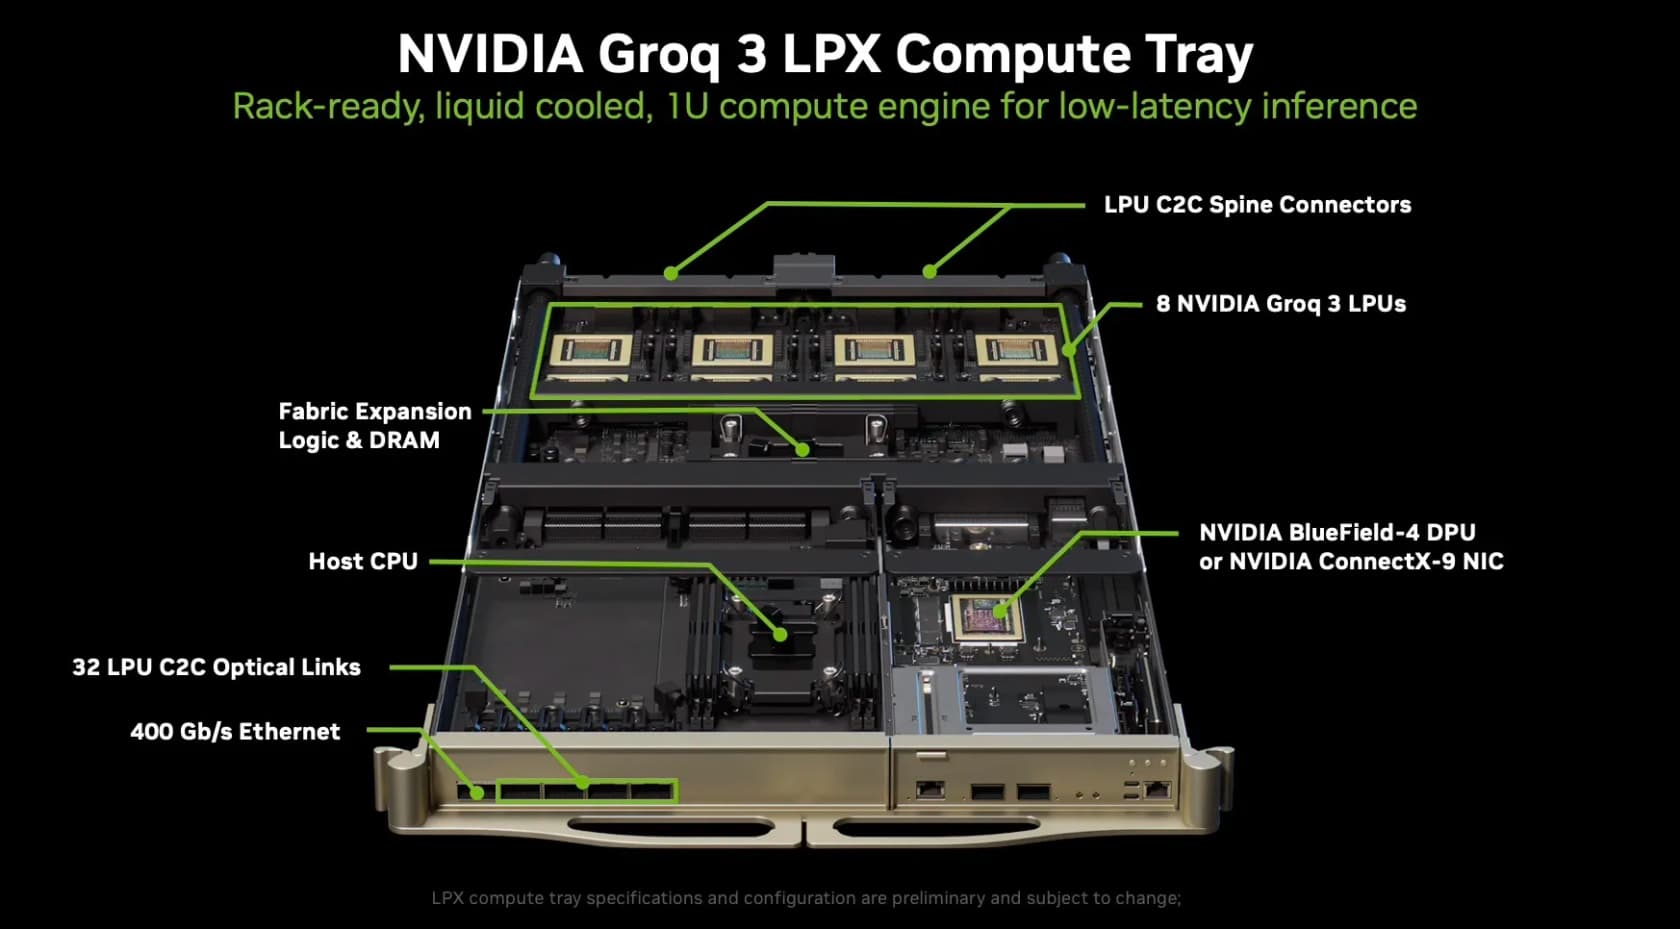
この配置にはいくつか目を引く点があります。各 LPU は 112 Gbps のチップ間リンク 96 本で接続され、チップあたり合計 2.5 TB/s のスケールアップ帯域幅となり、256 基が 1 台のマシンのように振る舞います。各トレイには BlueField-4 DPU とホスト CPU も載り、全体がケーブルレスで液冷です。NVIDIA の MGX ラックアーキテクチャに乗っているため、データセンターは推論経路のために専用の構成を用意するのではなく、Vera Rubin の導入全体で共通のラック設計を計画できます。
性能に関する主張と、その読み方
では、誰もが引用する数字です。NVIDIA の見出しは、Vera Rubin NVL72 と LPX を組み合わせると、1 ユーザーあたり毎秒 400 トークンの条件で、1 兆パラメータ級モデルについて前世代の GB200 比で 1 メガワットあたり最大 35 倍のスループットというものです。また、最もレイテンシに敏感なワークロードでは 1 ワットあたり最大 10 倍の収益も見込んでいます。最もわかりやすいのは NVIDIA 自身のパレート図です。
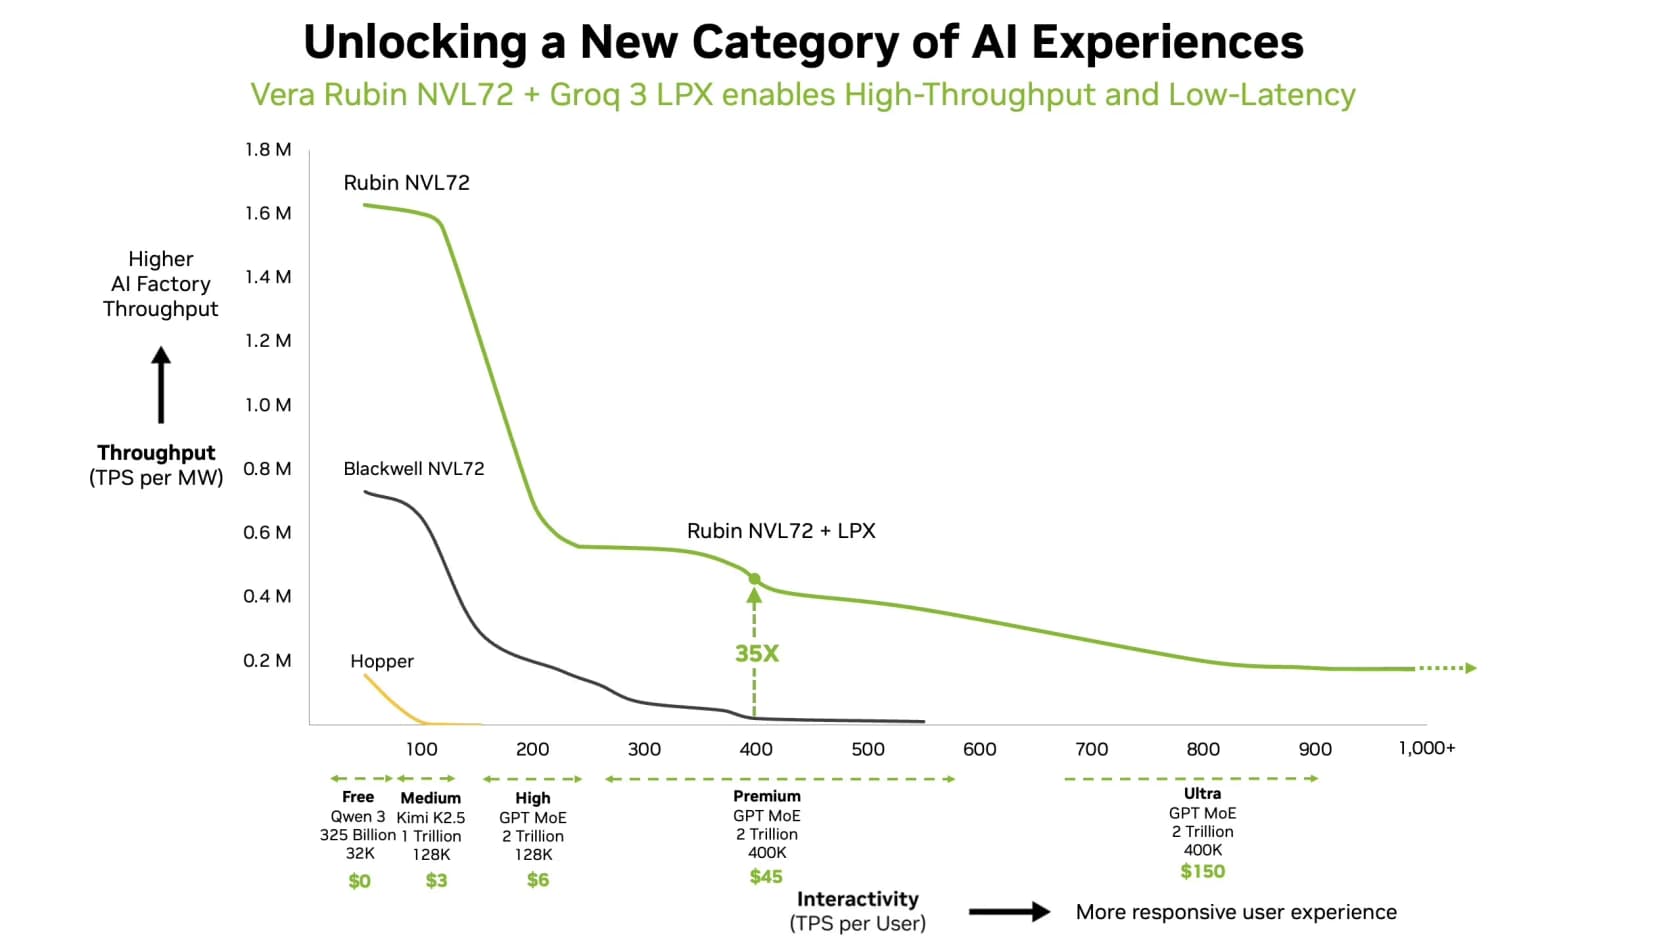
グラフを正直に読むと、確かな内容が見えてきます。緑の線(Rubin + LPX)と旧システムの差は、各ユーザーがトークンを速く受け取る右側で劇的に開きます。インタラクティブ性が低いところではどれも似たようなものですが、高いところでは LPX 経路が高い水準を保つ一方、GPU のみの線は急降下します。これが実際の主張であり、筋が通っています。
正直な留保は、誰が測ったのかという点です。これは NVIDIA 自身のベースラインに対する NVIDIA の数値で、モデル化された「プレミアム」シナリオは、400K コンテキストの特定の 2 兆パラメータモデルです。私が見つけた、独立性を感じさせる唯一のデータは、NVIDIA が引用する Artificial Analysis のベンチマークで、Gemma 4 31B、100K コンテキストで毎秒 3,400 トークンというものです。強力な数字ですが、Nebius が導入した最初のクラウドにすぎないため、これまでの公の議論のほとんどは、ハードウェアを検証するのではなく NVIDIA のスライドを繰り返しているだけです。Hacker News では、数少ない中身のある意見の 1 つが、マーケティングではなく Groq の実績に照らしてこれを読んでいました。
"Gemma 31B dense at 3k TPS seems like a pretty big deal. Groq has always been more efficient than Cerebras at running very small models and this release seems to be no exception."

私の見立てはこうです。アーキテクチャは本当に巧妙で、ベンチマークも有望ですが、35 倍という数字は最良ケースのマーケティング値であり、第三者が検証するまでは割り引いて受け止めるべきです。
なぜ今か:推論が高コスト部分になった
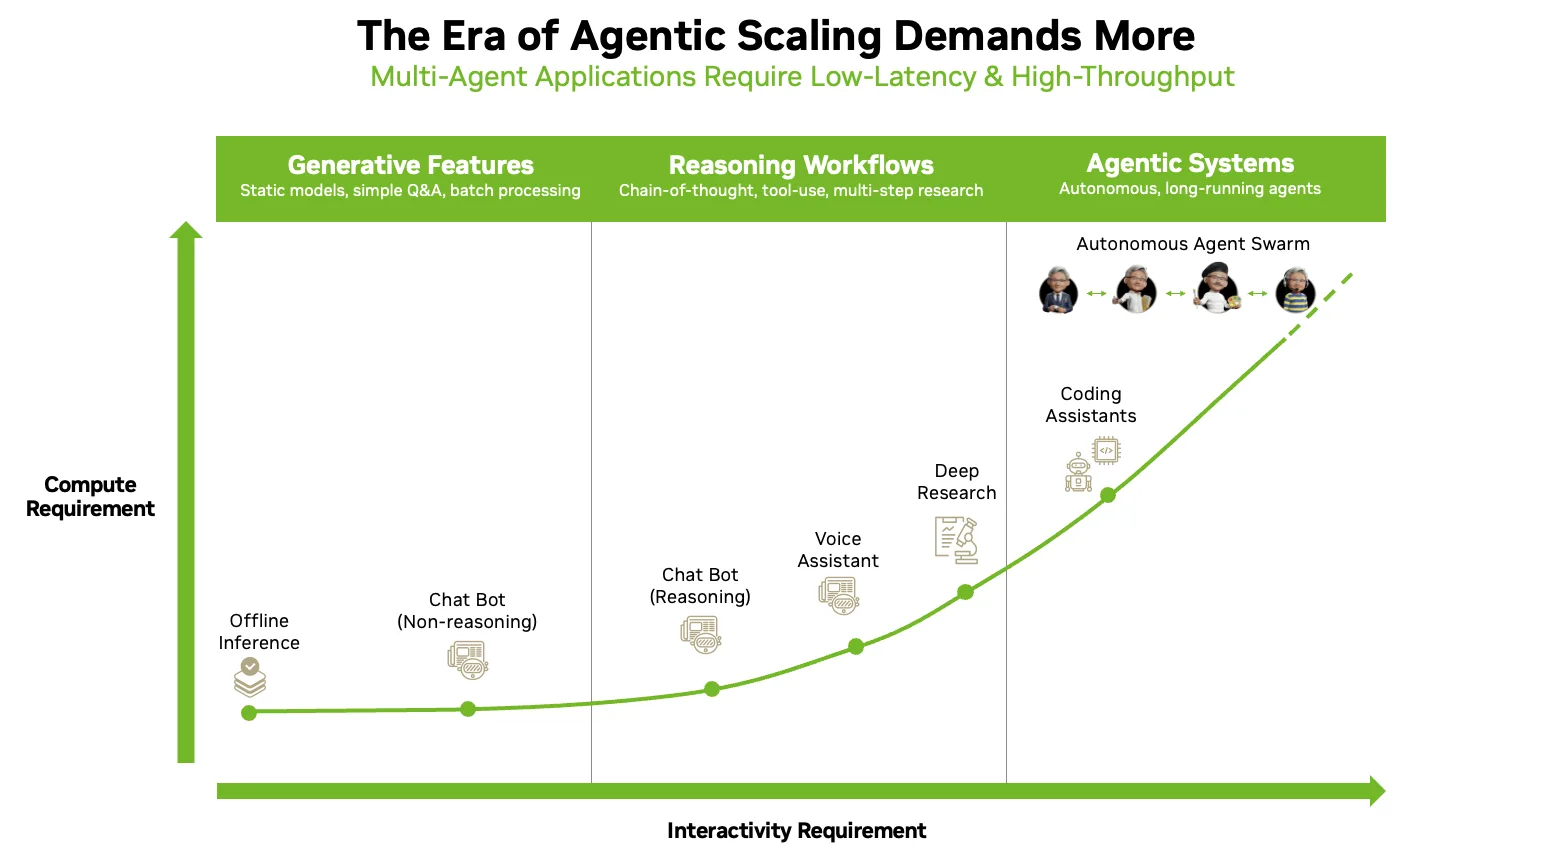
このようなチップが存在する理由は、AI ワークロードの形が変わったことにあります。推論のほとんどがチャットボットの 1 回の返信だった頃は、デコードのレイテンシはほとんど問題になりませんでした。エージェント型システムがそれを覆しました。何百、何千というステップにわたってトークンを生成し、NVIDIA は、エージェント型ワークロードが単純なチャットリクエストの約 15 倍のトークンを消費するというデータを挙げています。トークンごとのわずかな遅延が、長い連鎖の中で積み重なるようになったのです。
同じ変化は、市場の資金がどこへ向かっているかにも表れています。NVIDIA のデータセンター事業はこの波に力強く乗っており、2026 年 7 月下旬に終わる四半期の売上高は 962 億ドルで、前年同期比 106% 増と報告しました。今や成長のエンジンは学習ではなく推論であり、低レイテンシで多段階の生成のために作られたチップは、そこへの直接的な賭けです。X のあるアナリストは、戦略的な側面を端的に表現していました。
"Nvidia moving its Groq 3 LPX inference accelerator into full production signals a key shift from model training to continuous agentic AI workloads."
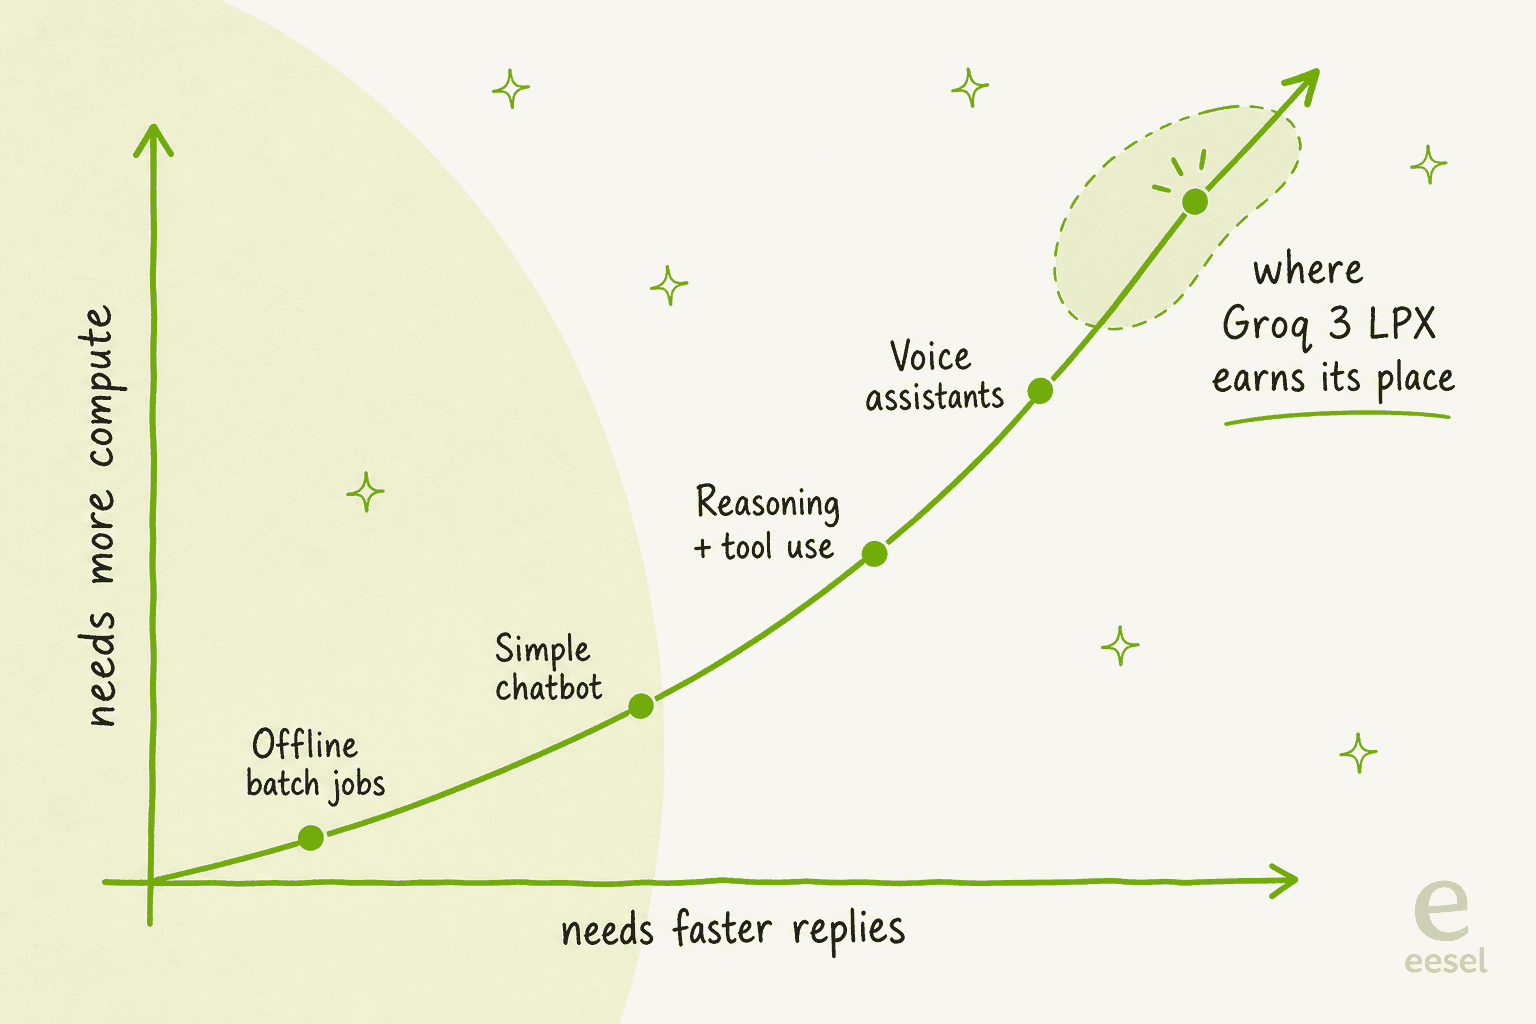
役立つ考え方はこうです。ワークロードが「短いやり取りを何度も繰り返す」方向に寄るほど、専用の低レイテンシエンジンの重要性が増します。バッチジョブは気にしません。コーディングアシスタント、エージェント群、音声は大いに気にします。
AI で開発する人にとっての意味
ここは正直に言いたい部分です。スペック表に心を奪われがちですが、クラウドや非常に大規模な AI プラットフォームを運営していない限り、Groq 3 LPX のラックを買うことはありません。これは、ほとんどのチームが作業している場所より数層下にあるインフラです。すでに使っているモデル API やクラウドに、より速く安いトークンとして現れるのを感じることになります。AI エージェントを使うのに GPU を買ったことがないのと同じです。
そして、それが有益な捉え直しです。チップはエンジンであり、実際に導入するのはその上に乗る働き手です。推論が速くなればエージェントはより機敏になり、運用コストも下がります。本番環境に本格的な自動化を入れるハードルが下がり、コスト計算も人間のエージェントに対して変わります。それがコーディングエージェントでも、リサーチエージェントでも、サポートキューを処理する AI ヘルプデスクエージェントでも同じです。ハードウェア競争は、その層を大規模に成り立たせるためのものです。価値は今もその層にあります。
eesel の立ち位置
Groq 3 LPX のようなチップは配管です。eesel は、その上で仕事をしてもらうために迎える存在です。eesel は AI チームメイトのプラットフォームで、推論基盤を用意したりパイプラインを組んだりする必要はありません。特定の役割をすぐにこなせるチームメイトを迎え、アプリにつなぐだけです。現在のラインナップは、単なるサポートチャットボットにとどまらずサポートキューに加わる AI ヘルプデスクチームメイトと、この記事のようなコンテンツを作る AI ブログライターです。

具体的な違いは、速いトークンがどこに届くかです。8 秒ではなく 1 秒で答えるサポートチームメイトは、待っている人にとってはそれがすべての体験です。そして、実際のサポートキューで AI を運用してきた年月は、地味な半分を教えてくれました。速さは答えが正しいときにしか役に立たない、ということです。だから eesel は、実際の顧客に返信する前に、過去のチケットに対して展開をシミュレーションします。世界中のシリコンを集めても、自信満々の誤った回答は直せません。ラックではなくチームメイトを見てみたい方は、eesel を無料でお試しください。