

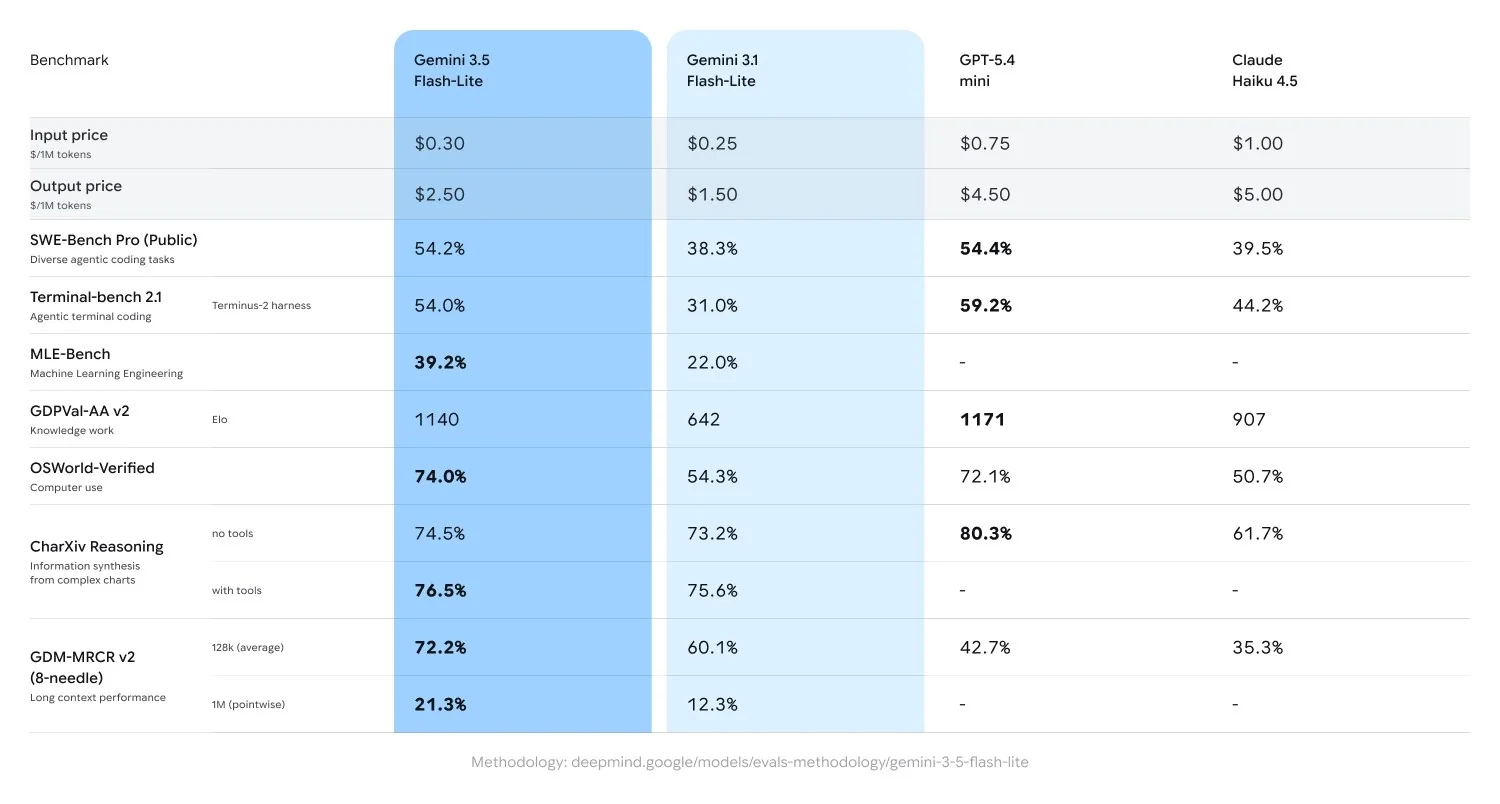
2026年7月21日、GoogleはGemini 3.5 Flash-Liteを投入した。3.5系列の中で最速・最安のモデルだ。より強力なGemini 3.6 Flashと同日に登場したため、この二つは混同されやすい。要点はこうだ。Flash-Liteは入力$0.30・出力$2.50(1Mトークンあたり)で、出力速度はおよそ毎秒490トークン。つまり、個々のタスクは単純だが実行回数が膨大になる場面で選ぶべきモデルということだ。
Googleが出す中で最も賢いモデルではないし、そもそもそれを狙っていない。それでもArtificial Analysis Indexでは知能スコア36(152モデル中12位)という立派な成績を収めており、おもちゃではない。この記事をカスタマーサポートの自動化を組み立てるために読んでいるなら、先に一つだけ言っておきたい。モデル選びは簡単な部分にすぎない。私はインテグレーションやAPIを組む仕事をしているが、サポートボットを壊すのはたいてい生のモデルそのものではなく、その周りに巻きついているすべてのものだ。詳しくは後述する。
Gemini 3.5 Flash-Liteの正体
GoogleはGeminiファミリーを大きく二つの系統に分けている。Proモデルは難しい推論のためのトップティアだ。Flashモデルは働き者で、より安く、より速く、1日に何千回も呼び出すアプリ向けに調整されている。Flash-Liteはその働き者の中でも最も軽量な存在で、Googleは大量のエージェント的タスク、翻訳、単純なデータ処理向けに位置づけている。
個々のタスクは簡単だが量が容赦ないような仕事に向けるモデルだと考えるといい。サポートチケットの分類、PDFからのフィールド抽出、チャットメッセージの翻訳、一次検索の実行などだ。テキスト、画像、動画、音声、PDF入力を扱え、ファンクションコーリング、構造化出力、コード実行、キャッシュ、検索グラウンディングをサポートし、上位モデルと同じ約100万トークンのコンテキストウィンドウ(入力でA4用紙およそ1,500ページ相当)を備えている。
意図的に省かれている機能を見ると、誰のためのモデルかがわかる。Flash-Liteはコンピュータ操作、画像生成、音声生成、Live APIをサポートしない。エージェントにブラウザを操作させたりメディアを生成させたりする必要があるなら、それはGemini 3.6 FlashかProモデルの仕事であり、これではない。Flash-Liteは意図的に狭い範囲にとどまっている。テキストを読み、判断し、テキストを書く、それを速く安くやる、というだけだ。
Gemini 3.5 Flash-Liteの料金
全体像はこうだ。このモデルが存在する理由そのものなので、スプレッドシートに数字を入れる前によく読んでおく価値がある。
| 利用モード | 入力(100万トークンあたり) | 出力(thinking含む) | コンテキストキャッシュ |
|---|---|---|---|
| Standard | $0.30 | $2.50 | $0.03 |
| Batch(50%オフ) | $0.15 | $1.25 | $0.02 |
| Flex | $0.15 | $1.25 | $0.02 |
| Priority | $0.54 | $4.50 | $0.05 |
| 無料プラン | 無料 | 無料 | 無料 |
いくつか注意しておきたい点がある。
- 無料プランには落とし穴がある。 無料プランではGoogleがコンテンツを使用してプロダクトを改善する。有料プランではそれがない。顧客データに触れる用途であれば、この一点だけで無料プランは選択肢から外れる。
- バッチモードは一律50%オフで、実際には大量処理のジョブの大半がここで動くべきだ。フレックス推論も同じ割引だ。作業がリアルタイムでなくてよいなら、支払いは$0.15/$1.25になる。
- キャッシュヒットは安い。 キャッシュされた入力トークンは100万あたり$0.03で、90%の削減だ。繰り返し使うコンテキスト(システムプロンプトやナレッジの断片)はほとんどコストに乗らない。
- 検索グラウンディングは別途課金される。 Gemini 3ファミリー全体で月5,000件のグラウンディング済みプロンプトまで無料で、それを超えると検索クエリ1,000件あたり$14だ。
Artificial Analysisからの一つ正直な補足を挙げておく。$0.30/$2.50という価格は152モデル中87位で、単純な価格の安さでは「市場最安」ではない。「Lite」が意味するのはGemini 3.5系列の中で最安でありながら、トップクラスの知能スコアを保っているということだ。これがコンシューマー向けGeminiプランや他のAPIティアとどう比較されるかについては、Geminiの料金ガイドに全体の内訳があり、Gemini Workspaceの料金ではビジネスプランを扱っている。
速度こそが最大の売り
価格がFlash-Liteを候補に入れる理由なら、速度は使い続ける理由だ。Artificial Analysisの計測では約毎秒490トークンで、テストした152モデル中2位。Google自身のベンチマークでは毎秒350トークンとしている。どちらの数字でも、業界トップ級であることは変わらない。
プロダクトマネージャーに「1秒未満の返信」を約束する前に知っておくべき注意点が一つある。最初のトークンが出るまでの時間(TTFT)は中央値でおよそ6秒と、このクラスの中では高めだ。モデルの思考ステップが最初に見えるトークンより前に走るためだ。つまり、いったんストリームが始まれば猛烈に速いが、開始自体は難しいプロンプトだと遅れることがある。ほとんどのサポート業務(短い回答、単純な分類)では思考にかける予算は小さく、その遅れは無視できるレベルだ。ミリ秒単位で計測するような用途なら、まず自分のプロンプトで試してみてほしい。
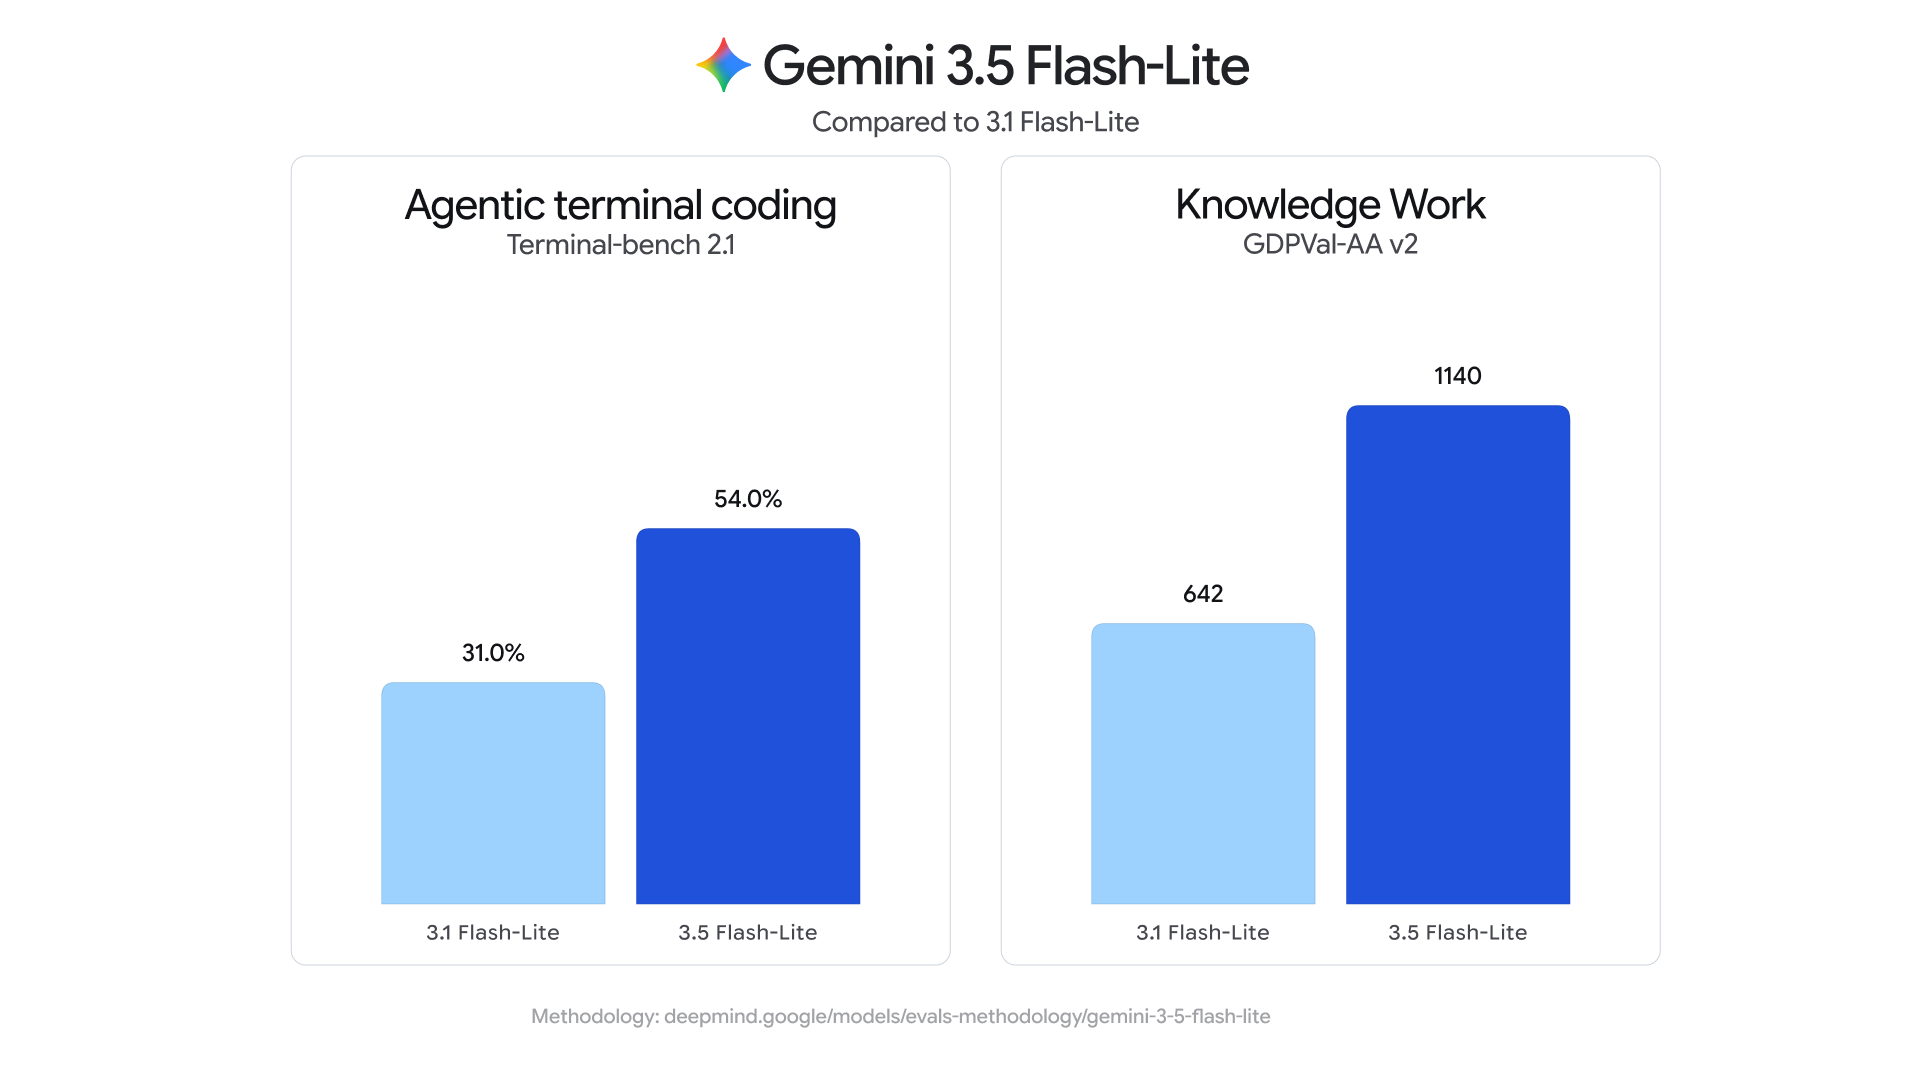
先代モデルと比べると、エージェント型コーディングとナレッジワークのベンチマークで世代間の伸びは明確だ。
Flash-Liteか3.6 Flashか?正しい方を選ぶ
これはほとんどのチームが間違える判断だ。二つが同日に登場し、名前もほとんど変わらないからだ。この二つは同じ仕事の正反対の端のために作られている。下のセレクターを試してみてほしい。
基本的な目安はこうだ。個々の項目が単純で、量そのものが課題になっている場合、たとえば一次チケットトリアージ、ティア1の振り分け、日常的なライブチャットの振り分けなどにはFlash-Liteを選ぶ。複数のシステムをまたいで本当に推論が必要な仕事には3.6 Flashを選ぶ。本物のAIエージェントを作るかスクリプト型のボットにするかは、モデル選びとは別の判断だ。
同じ日に登場したその他のモデル
Flash-Liteは単独で登場したわけではない。Googleは7月21日に3つのモデルを出荷し、1つを保留した。このラインアップを知っておくと、間違ったティアを選ぶのを避けられる。
Gemini 3.6 Flashは新しい看板の働き者で、入力$1.50・出力$7.50、コンピュータ操作を内蔵し、3.5 Flashより出力トークン数がおよそ17%少ない。Gemini 3.5 Flash Cyberはセキュリティ専門モデルで、GoogleのCodeMenderエージェント内で脆弱性を見つけて修正するようにファインチューニングされており、政府機関と信頼されたパートナー限定の限定パイロットとしてのみ利用できる。
目立って欠けているのは、フラッグシップのGemini 3.5 Proだ。Bloombergの報道によれば、社内の性能目標に届かず遅延が発生しており、DeepMindのLogan Kilpatrickも述べている通り、まだパートナーとテスト中だという。つまりGoogleの動き方は分かりやすい。フラッグシップを仕込んでいる間、安価で大量処理向けのティアは新しい状態を保つ、というものだ。もし今すぐトップティアのモデルが必要なら、Geminiの代替ツールのまとめが正直な出発点になるし、Gemini対ClaudeとGemini対ChatGPTでは正面対決を扱っており、AIカスタマーサービス企業ではこれらのモデルの上に構築しているベンダーをまとめている。
サポート向けにAIを構築するならこれが意味すること
ここは率直に言わせてほしい。モデルのローンチ記事のほとんどが、サポートチームにとって一番重要なこの部分を素通りしてしまうからだ。
より速く、より安いモデルが出るのは良いニュースだ。しかしFlash-Liteに切り替えただけで動くサポートエージェントが手に入るわけではない。速いCPUを積んだだけでアプリが完成するわけではないのと同じだ。私はeeselにインテグレーションやAPIを組み込む仕事を日々しており、3年以上にわたって実際のサポートキューにAIを載せてきた中で、何度も目にしてきた失敗はモデルが頭が悪いということではなく、モデルの周りに必要な層を誰も作らなかったせいで、自信満々に振る舞うボットが実際の顧客に間違った答えを返してしまうことだった。モデルはスタック全体ではなく、その一番下の層にすぎない。
その層こそが本当の作業だ。検索(リトリーバル)があれば、モデルは推測ではなくナレッジベースや過去のチケットから答えるようになる。ガードレールとスコープがあれば、返金ポリシーを勝手に作り出す代わりに、きれいにエスカレーションできる。インテグレーションがあれば、チケッティングシステムの中で実際に行動できる。そしてテストがあれば、顧客に触れる前にどう振る舞うかがわかる、後になってからではない。これが生のAPIと本物のAIカスタマーサービスソフトウェアとの差であり、AIチャットボットの問題がほぼ常にモデルではなく配管部分に起因する理由でもある。
だからこそ、生のGemini APIを自分でヘルプデスクに組み込むことには異を唱えたい。検索、ハルシネーション対策のガードレール、シミュレーション、そしてすべてのヘルプデスク連携をゼロから組み直すことになり、しかもGoogleが数週おきに新モデルを出す(今回は1日で3つだ)たびに保守し続けることになる。この入れ替わりの速さこそ、自作のスタックより専用に作られたヘルプデスク向けAIを選ぶべき理由そのものだ。モデルのティアは差し替え可能な一項目にすぎず、周りのシステムこそが製品なのだ。
eeselを試す
これこそが、eeselが作られている理由そのものの層だ。既存のヘルプデスクに組み込むだけで、導入初日から過去のチケットとナレッジベースから学習し、Geminiのようなフロンティアモデルの上で動く。だからFlash-Liteのようなモデルの速さとコスト削減を、自分でAPIを組まずに得られる。

ここで一番重要な違いは、Flash-Lite単体では得られないものだ。eeselなら実際の顧客に応答する前に、過去のチケットに対してエージェントをシミュレーションでき、解決率や実際に送信されたであろう返信をそのまま確認できる。そして成果に応じた価格設定であり、トークン単位の課金ではないので、チケットごとにトークンの計算をする必要もない。サポート自動化のためにモデルを検討しているなら、まず達成したい成果から考え、配管部分の選定はプラットフォームに任せてほしい。無料で試せる。