

2026年7月21日、GoogleはGemini 3.5 Flash Cyberをリリースした。これはGemini 3.5 Flashをベースに、たった1つの仕事、つまりソフトウェアのセキュリティ脆弱性を発見して修正することのためにファインチューニングされたバージョンだ。単体では動作しない。GoogleのCodeMenderエージェント内で動作し、複数のCyberエージェントが協調して1つの統合レポートを返す。
興奮する前に知っておくべきことが2つある。1つ目は、あなたはほぼ確実に使えないということだ。悪用可能なバグを見つけるツールはデュアルユースであるため、Googleは小規模な試験プログラムとして政府機関と信頼できるパートナーに限定している。2つ目は、これがAIエージェントを構築する中で私が常に直面していることの、わかりやすいケーススタディになっている点だ。モデルは簡単で安価な部分にすぎない。実際に仕事をこなすのは、その周りに構築されたシステムだ。CodeMenderに組み込まれたCyberは、私たちがライブのサポートキューにAIを導入する中で学んだのと同じ教訓の、セキュリティ版と言える。
Gemini 3.5 Flash Cyberの正体
GoogleのGeminiファミリーは2つの系統に分かれている。最も難しい推論向けのProモデルと、高速で安価な働き手であるFlashモデルだ。Flash Cyberは3つ目の存在、いわば専門特化型だ。Googleは汎用のGemini 3.5 Flashベースを取り、大型のフロンティアモデルよりも低いトークン単価で、コードセキュリティの問題を大規模に検出・検証・修正するという、狭く重要度の高いタスク1つに絞ってファインチューニングした。
ProではなくFlashをベースに構築する理由は、そもそもFlashが存在する理由と同じだ。セキュリティスキャンは量がものを言う作業であり、巨大なコードベース全体に対してモデルを何度も繰り返し実行し、針を探すような作業になる。より安く、より速いベースであれば、それを大量に実行する余裕が生まれる。これはまさに、稀にしか見つからないバグを発見するために必要なことだ。それが、Flashライン全体を支える効率性の論理を1つの領域に絞って適用した形だ。
ほとんどのローンチ報道が省いている率直な整理をしておこう。Flash Cyberは会話をするチャットボットではない。1つのコンポーネントだ。バッファオーバーフローを見つけられるモデル単体は、ただの余興にすぎない。価値が生まれるのは、バグを見つけ、そのバグが本物であることを証明し、修正コードを書き、その修正が何も壊していないことを確認するシステムに組み込んだときだけだ。そのシステムがCodeMenderだ。
CodeMender: モデルを実用的にするシステム
CodeMenderは、コードセキュリティのためのGoogle DeepMindのAIエージェントであり、Flash Cyberが実際に稼働している場所だ。注目すべき設計上の選択は、モデルを1回呼び出すだけでは済ませていない点だ。Googleは複数のGemini 3.5 Flash Cyberエージェントを並行して実行し、それぞれがコードを調べたうえで、その結果を1つのレポートにまとめている。
この「複数エージェント、1つのレポート」というパターンは、実際に大きな役割を果たしている。モデルによるコードベースへの1回のパスにはノイズが多く、バグではないものをバグとして検出したり、逆に本物のバグを見逃したりする。複数の安価なエージェントを実行し、その出力をすり合わせることで、毎回フロンティアモデルの価格を払うことなく、ノイズの多い信号を人間のセキュリティチームが実際に対応できるものへと変えられる。これはエージェントのオーケストレーション問題のセキュリティ版であり、モデルが安価であることがこれほど重要な理由でもある。1回だけ実行するのに十分な高価さより、5回実行できるのに十分な安さのほうが勝るのだ。
Googleはこの目標を防御的なものとして位置づけている。攻撃者が悪用する前に重大な脆弱性を発見・修正する上で、現場の防御側に先手を与えながら、より広範な悪用は抑制したいという狙いだ。
どれほど優れているのか: CyberGymの数字
Googleは、セキュリティベンチマークであるCyberGym上で、CodeMender+Cyberの構成を競合ラボのフロンティア構成と比較評価した。ここで重要になるのが次のチャートだ。
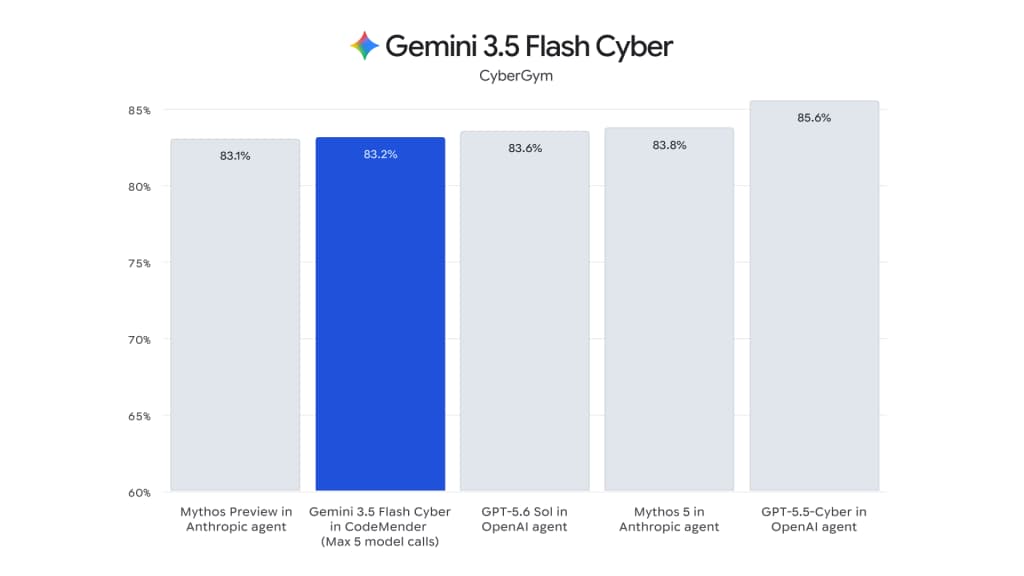
ここから読み取れることは、単なる勝敗の数字より興味深い。CodeMender内のCyberは、はるかに大きく高価なフロンティアエージェント群(83%〜85.6%のあたりに集中している)とほぼ横並びの83.2%に着地している。チャートの最上位ではない。しかし、それこそがまさにポイントだと言える。小さく安価な専門特化モデルが、難しいタスクにおいて競争力のあるフロンティア水準の性能に、本来ならパラメータ数が担うはずの重みをファインチューニングとエージェント設計が肩代わりすることで、コストのごく一部で到達しているのだ。
これは、Flashライン全体が勝つために設計されているのと同じトレードオフだ。「リーダーボードで最も賢いモデル」ではなく、「大量にこなす作業において、1ドルあたり最も高い能力」を狙っている。
落とし穴: おそらくあなたは使えない
ここで、多くの読者の期待が止まってしまう部分に触れよう。Gemini 3.5 Flash Cyberは、CodeMender経由の限定アクセス試験として、政府機関と信頼できるパートナーのみに提供されている。公開APIもなく、AI Studioでの切り替えもなく、セルフサーブの料金プランもない。
理由は、その懸念の名前そのものにある。*デュアルユース(軍民両用)*だ。コード内の悪用可能な脆弱性を見つけるのに優れたモデルは、定義上、攻撃者にとっても喜ばしいツールになる。そのためGoogleは、防御側と攻撃側の双方を等しく助けてしまう能力に対して行うのと同じやり方で、まず厳選された少人数のユーザーへ限定的に展開するという形でゲート(制限)をかけている。今日の午後にでも自分のリポジトリに向けて使ってみたいと思っていたなら、それは選択肢にない。
同時にリリースされた他の2つのモデルは、今日実際に使えるものだ。Gemini 3.6 FlashとGemini 3.5 Flash-LiteはGeminiアプリおよびアプリ内で利用可能であり、Gemini 3.6 Flashの解説記事では、これらの料金や対象ユーザーについて詳しく説明している。
なぜこのローンチにGemini 3.5 Proが含まれていないのか
7月21日のローンチ全体について最も物語っているのは、そこに含まれていなかったものだ。GoogleはFlash Cyberを含む3つのFlashクラスのモデルをリリースしたが、フラッグシップのGemini 3.5 Proは含まれていなかった。同モデルは2026年2月を最後に更新が止まっており、5月には「すでに社内で使用されている」と予告されていた。Bloombergの報道によれば、Proは自社の性能目標を達成できず、社内で遅延が生じているという。
これは、OpenAIがGPT-5.6を展開し、AnthropicがClaude Sonnet 5をリリースしたのと同じタイミングで起きている。好意的に見れば、Googleの動きには理にかなった面がある。フラッグシップが仕上がるのを待つ間、大量のトラフィックと収益をもたらすFlash階層を新鮮かつ安価に保ちながら、Cyberのような専門特化型の成果をリリースするという考え方だ。DeepMindのローガン・キルパトリック氏は、3.5 Proは現在パートナーとテスト中で、まもなく「登場する」はずだと述べ、チームはGemini 4に向けて「これまでで最も野心的な事前学習ラン」を開始したとも述べている。
Flash Cyberが教えてくれる、あらゆるAIエージェント構築の教訓
このモデルに一生触れることがなかったとしても、なぜこのローンチが重要だと私が考えるのか。ここが私にとって本当に気になる部分だ。なぜなら、私はAIエージェントを構築することを生業にしているからだ。
Flash Cyberは、私がすべてのプロジェクトで直面するあるパターンの証明だ。モデルは全体ではなく、最下層のレイヤーにすぎないということだ。Googleは「セキュリティモデル」をリリースして終わりにはしなかった。ファインチューニング済みのモデルに加えてCodeMender、つまり検出・検証・修正・報告を行うシステムをリリースしたのだ。その知性は、生のウェイトと同じくらい、複数のエージェントを実行してすり合わせるというそのラッパーの中にも宿っている。
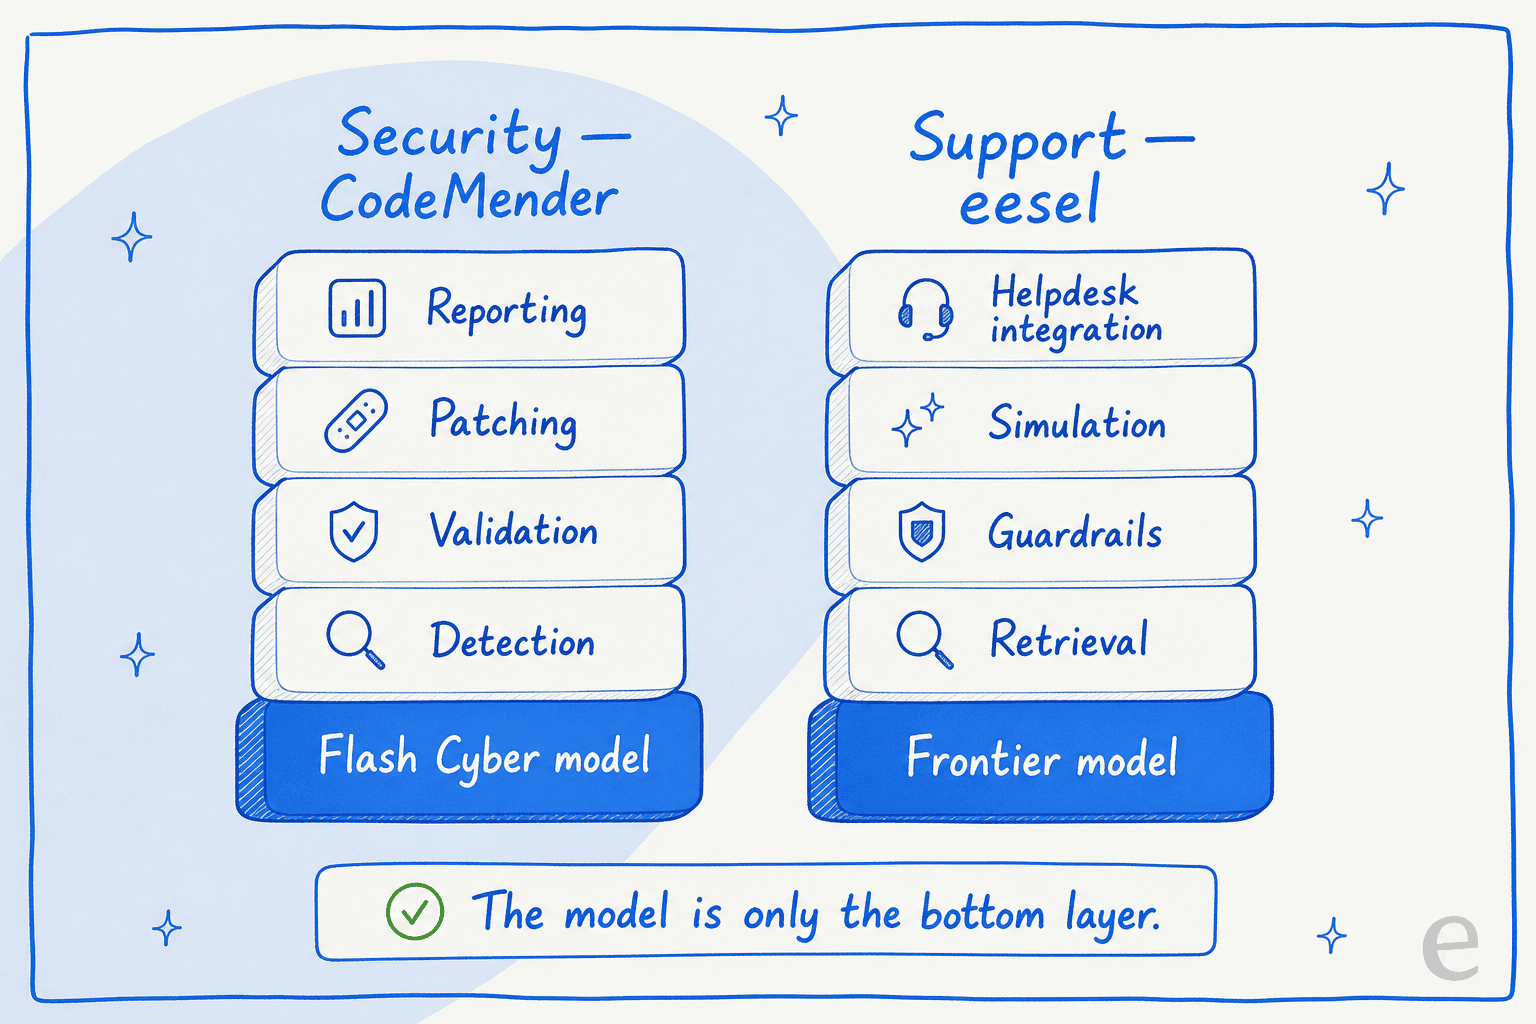
私は何年もの間、ライブのサポートキューにAIを導入する仕事をしてきたが、そこで繰り返し目にしてきた失敗は、CodeMenderがまさに回避するよう設計されているものと同じだ。周りにレイヤーが構築されていないために、自信満々に聞こえるモデルが間違った答えを出すという失敗だ。セキュリティの世界では、検証されていない「修正」がビルドを壊すことが失敗モードになる。カスタマーサポートの世界では、自信満々のボットが返金ポリシーをでっち上げることがそれにあたる。病気は同じで、領域が違うだけだ。どちらの場合も治療法はシステムにある。モデルが推測ではなく実際の情報源から答えるためのリトリーバル、きれいにハンドオフするためのガードレール、そして実際の顧客に触れる前にその挙動を把握しておくためのテストだ。
だから、Cyberのような(あるいはGemini 3.6 Flashのような、次に登場する何かのような)新しいモデルが出てきたとき、サポートチームが問うべき正しい問いは「そのモデルは十分に優れているか」ではない。たいていの仕事において、それはすでに十分だ。本当に問うべきは、「その周りにリトリーバル、ガードレール、シミュレーション、ヘルプデスク連携を誰が構築するのか」だ。それこそが実際の仕事であり、生のAPIを自分でヘルプデスクに組み込むことが罠である理由でもある。それをやってしまうと、CodeMenderに相当するものをゼロから再構築したうえで、モデルが数週間ごとに変わるたびに保守し続けることになる。
eeselを試す
サポートにおいて、CodeMenderがセキュリティに対して果たしているのと同じ役割を、eeselはあなたのヘルプデスクに対して果たす。既存のツールに接続するだけで、導入時点から過去のチケットとナレッジベースから学習し、フロンティアモデルの上で動作するため、自分でAPIを組み込むことなく効率化の恩恵を得られる。

CodeMenderの「出荷前に検証する」という設計に直接対応するのがシミュレーションだ。eeselでは、エージェントが実際の顧客に応答する前に、過去のチケットに対してそれを実行できるため、解決率や、実際に送信されていたであろう返信内容をそのまま確認できる。またトークン単価ではなく実際にこなした仕事に対して課金されるため、チケットごとにトークン計算をする必要もない。サポート自動化を構築するためにモデルを検討しているなら、達成したい成果から出発し、その裏側の仕組み選びはプラットフォームに任せるとよい。無料で試すことができる。