

Fish Audio Drama 3 とは?
私は eesel で AI エージェントを作っているので、音声モデルの発表を読むときはいつも一つの問いを持ちます。これはチームが出荷できるものを変えるのか、それともデモの聞こえ方を変えるだけなのか。Drama 3 は前者に近い興味深いタイプで、変化がインターフェースにあるからです。メニューから決まった感情を選ぶ代わりに、演出の指示を書きます。
Fish Audio は、演出のために作られたモデルだと説明しています。台本に加えて、セリフをどう演じるかを説明し、音や間を足し、効果を特定の語だけに限定できます。技術レポートには仕組みが載っています。土台はトークンごとに約3Bのパラメータを動作させる350億パラメータのMixture-of-Experts(専門家混合)モデルで、Qwen3.5-35B-A3B から初期化されています(このモデル群が初めてなら私の Qwen の概要 をどうぞ)。さらに、1フレームあたり10個のコードブックを予測する新しい音声デコーダーが加わっています。
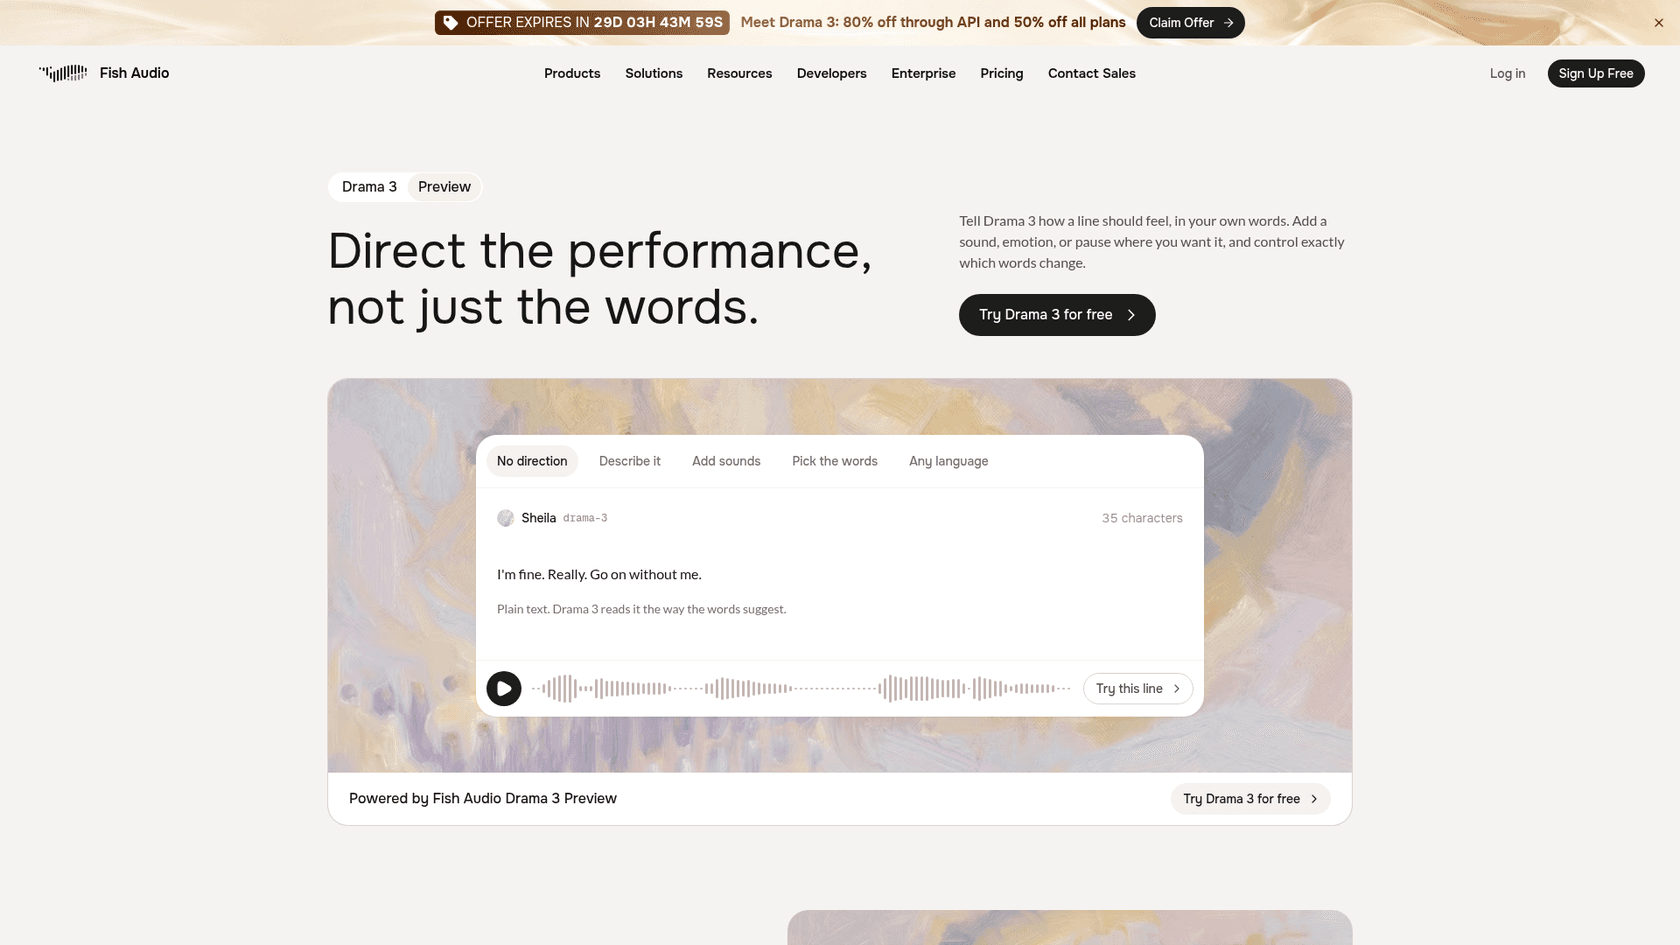
簡単な経緯もあります。Fish Audio は9月23日にプレビューを発表し、drama-3-preview というモデル文字列で提供したのち、10月13日に最終モデルを出荷しました。ランディングページにはまだ「Preview」バッジが付いているので、公開後にも仕上げが入ると考えてください。Fish Audio は小さなラボではありません。発売時のプレスリリースでは、1,500万ユーザーと年間経常収益2,100万ドルが挙げられています。
S2.1 Pro と比べて何が新しい?
正直にまとめると、インターフェースは変わらず、演技が変わりました。どちらのモデルも角かっこの演出指示を受け付け、どちらも83言語を話し、どちらも同じ POST /v1/tts エンドポイントの背後にあります。Drama 3 が加えたのは、指示へのより忠実な追従、個々の語に使える範囲指定タグ、そして異なる学習目標です。
| S2.1 Pro | Drama 3 | |
|---|---|---|
[角かっこ] での演出指示 | あり | あり。Fish Audio によれば感情表現が豊か |
範囲指定タグ(<whisper>、<emphasis>、<slow> など) | モデル概要には記載なし | あり、7種類 |
| 言語 | 83 | 83 |
| Pronunciation Robustness(Artificial Analysis) | 88.1% | 93.2% |
| API 価格(100万文字あたり) | $15 | 定価 $50、11月12日まで $10 |
| ウェイト | ホスト型 API | オープンウェイト、Community License |
出典:S2.1 Pro は Fish Audio のモデル概要、その他は Drama 3 の発表記事。
学習の変更が、私にはいちばん信頼できる部分に思えます。Fish Audio によると、自社の S2 を含む多くの音声モデルは、文字起こししやすいことと参照クリップに似ていることへの報酬で調整されており、それらのスコアは笑い声やささやきを低く評価してしまいます。Drama 3 は、人々がどのテイクを好んだかを学習した単一のモデルで調整されるため、頼んだ笑い声が減点されません。言葉の精度を落とさずに表現力を高められる理由として、納得できる説明です。
セリフにどう演出をつける?
演出は台本の中のプレーンテキストで、自由に組み合わせられる3つの層があります。セリフの前の角かっこは、声優に指示を出すように書いて、どう演じるかを決めます。角かっこには、音や間を入れたい位置にそのまま書くこともできます(例:[shaky breath])。対になったタグは、効果を数語に限定します。<whisper>、<emphasis>、<soft>、<fast>、<slow>、<stress>、<forceful> です。
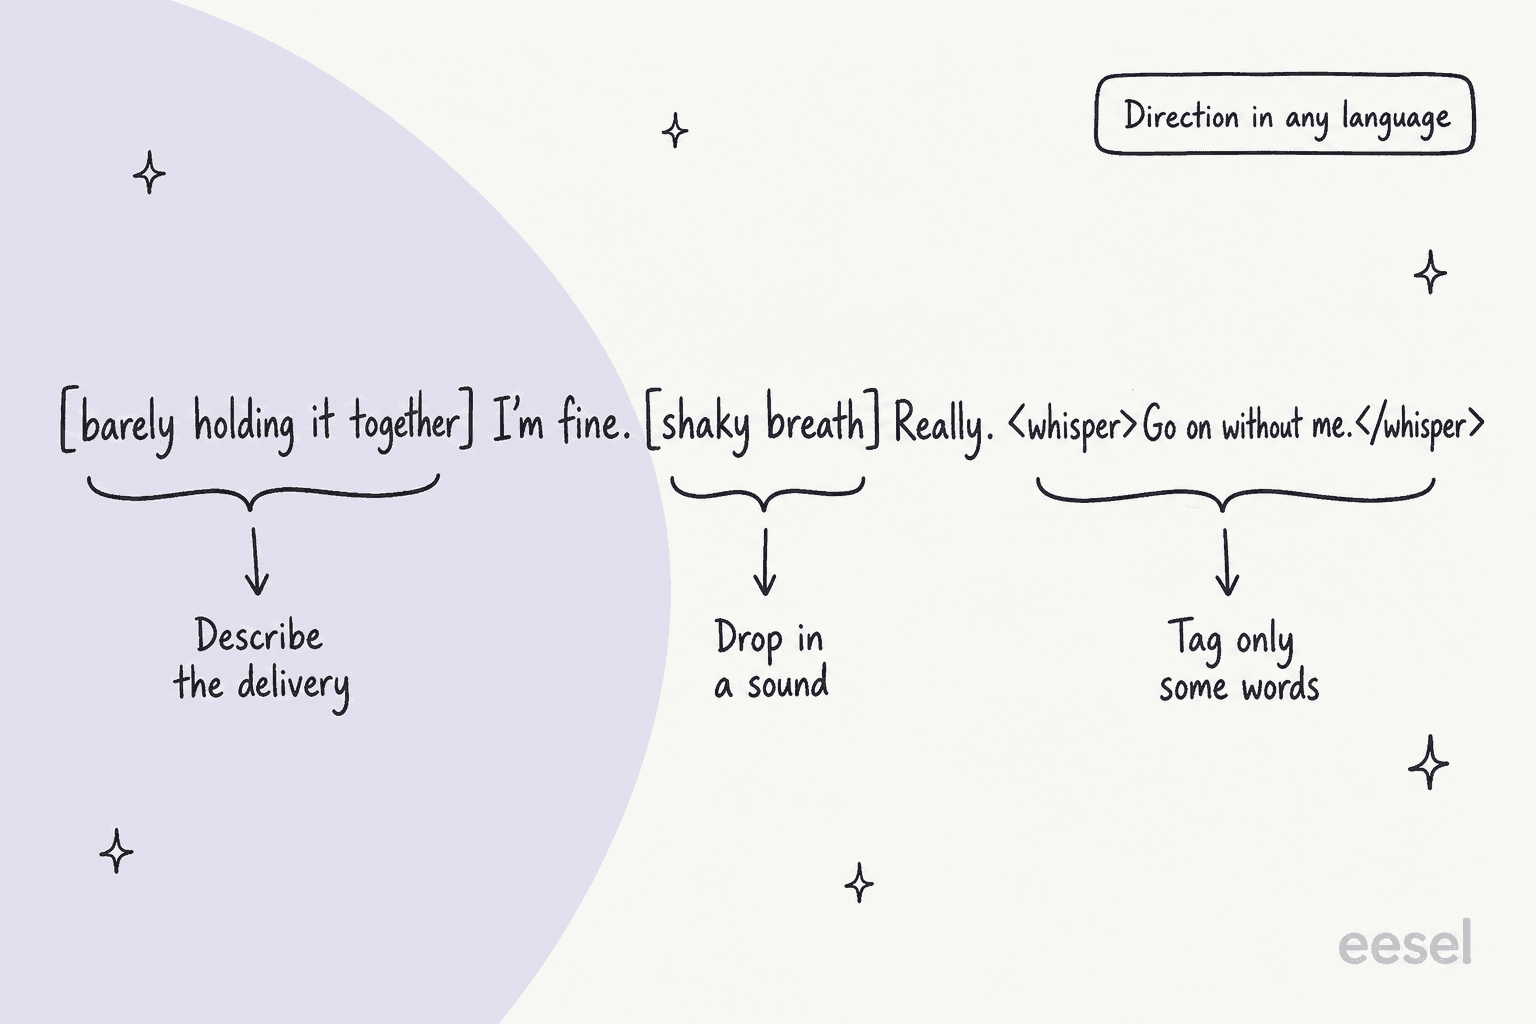
演出指示は英語である必要はありません。Drama 3 のドキュメントには、同じ英語のセリフに対して中国語、スペイン語、日本語の角かっこを付けた例があり、Fish Audio は、指示がどの言語で書かれていても演技はそれに従うと述べています。<french>...</french> のようにセリフの途中で言語を切り替えるタグもありますが、実験的とされ、精度は言語や声によって異なります。
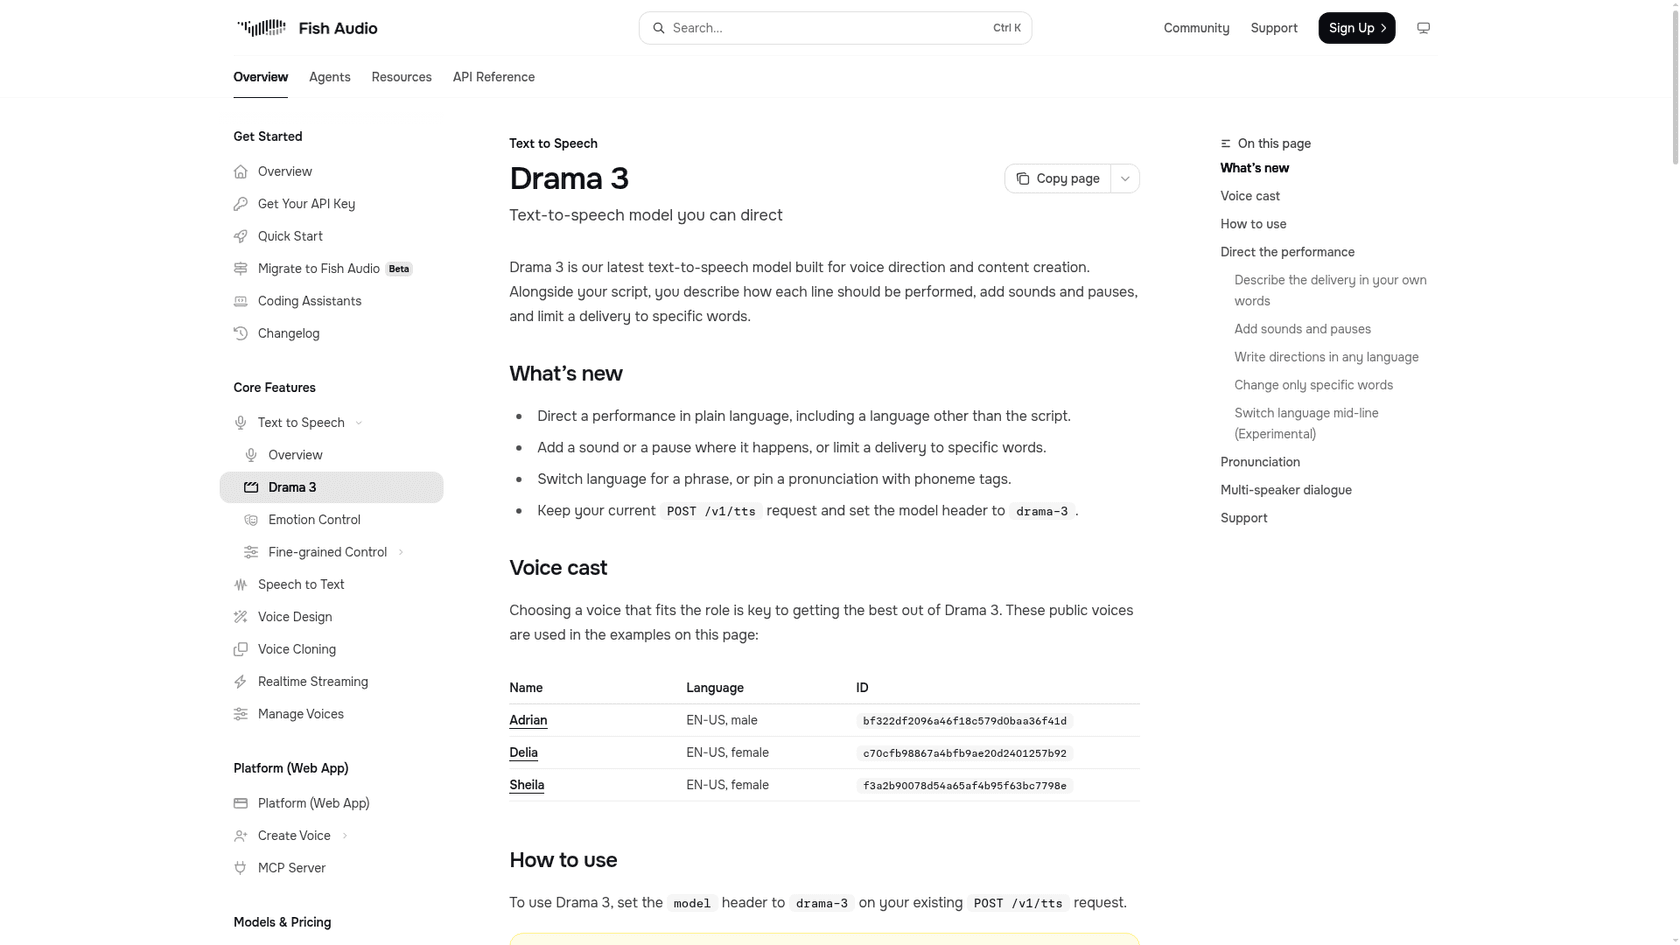
スクリプトで使うなら、2点が重要です。1点目、複数話者のシーンでは <|speaker:0|> 形式のタグを使い、話者ごとに1つの音声 ID を配列にして reference_id に渡します。Hugging Face のモデルカードによると、1つのテキストに最大16人の登場人物を含められます。2点目、model ヘッダーがない、またはつづりが違っても失敗せず、リクエストは黙って s2.1-pro に切り替わります。音声がデモより急に平板に聞こえたら、モデルを疑う前にヘッダーを確認してください。
ドキュメントから真似する価値のある例が、[barely holding it together, forcing a smile] I'm fine. [shaky breath] Really. [small laugh] Go on without me. です。1行に3つの異なる役割があり、あなたの声でモデルが演出に従うかを確かめる最速の方法です。
独立したテストでの Drama 3 の実力は?
Fish Audio 自身のブログは、Drama 3 が Pronunciation Robustness で Artificial Analysis の1位だと述べています。Artificial Analysis もそれを認めていますが、その数字はこの主張の限界も示しています。
"Drama 3 Preview is the #1 open weights model on all three of our Text to Speech leaderboards."
| Artificial Analysis の指標 | Drama 3 Preview | 参考値 |
|---|---|---|
| Pronunciation Robustness | 93.2%、1位 | Eleven v4 91.7%、Eleven v4 Turbo 90.1%、S2.1 Pro 88.1% |
| Provider Voice アリーナ(Elo) | 1,243、10位 | S2.1 Pro 1,142(101ポイント向上) |
| Controlled Voice アリーナ(Elo) | 1,058、14位 | 該当なし |
| 発音で最も強いオープンウェイトの競合 | 該当なし | Mistral の Voxtral TTS 78.1% |
出典:Artificial Analysis のスレッド、2026年10月13日。
この表は、購入者が読むべき読み方で読んでください。発音でのリードは本物で、どのオープンウェイトモデルに対しても15ポイントの差があり、台本がブランド名、コード、数字だらけなら重要です。Eleven v4 に対する差は1.5ポイントです。一方、ブラインド試聴では Drama 3 は Provider Voice アリーナで10位なので、「世界で最も感情豊か」というのは Fish Audio の表現であり、他の誰かが出したランキングではありません。S2.1 Pro からの伸びのほうが有用な数字で、同じラボの2つのモデルの間で101 Elo ポイントです。
最初の1日のコミュニティの反応も、この二面性に合っています。自分のマシンでウェイトを動かしたユーザーはこう書きました。
"It's fast and sounds great."

別のユーザーは、サイズとのトレードオフについてもっと率直でした。
"barely better than breeze with nearly 10x the size"
このコメントは Drama 3 を Breeze TTS 2 と比べています。Breeze TTS 2 は、Artificial Analysis が Provider Voice アリーナですぐ後ろに位置づけるオープンモデルです(1,221 対 1,243)。どちらも事実です。リードは小さく、オープンモデル同士の差も小さいのです。
Drama 3 にどうアクセスする?
経路は4つあり、向いている人が異なります。
- ウェブアプリとモバイルアプリ。 fish.audio の Text to Speech を
?version=drama-3付きで開くか、iOS と Android アプリを使います。ランディングページでは Drama 3 を無料で試せ、ライセンスされた Uncle Roger の声も毒舌用に使えます。 - API。
POST /v1/ttsリクエストはそのままに、ヘッダーmodel: drama-3を追加します。Fish Audio の発表スレッドには、ComfyUI、Runway、Pika、OpenRouter、Vercel などの当日パートナーが挙がっていますが、私が確認したのは ComfyUI の告知だけで、Partner Node として動くとのことです。すでに Runway を使っているなら、そのノードが同じ演出構文に対応しているか確認してください。 - オープンウェイト。 モデルは Hugging Face にあり、初日から SGLang-Omni での提供に対応しています。
- エンタープライズ。 Fish Audio のプレスリリースによると、他の音声プロバイダーから乗り換える企業は最初の3か月が無料です。これは営業との相談になります。
すでに複数の音声ベンダーを使い分けているサポートや運用チームには、音声エージェントのまとめと私の AI音声企業の一覧が、このようなモデルがフルのエージェントプラットフォームの横でどこに位置するかを示しています。
Drama 3 の料金はいくら?
まず API から始めましょう。今回の発表で最も紛らわしいのが価格だからです。Fish Audio の発表記事によると、Drama 3 の定価は100万文字あたり50ドルで、10月13日から11月12日までは80%オフの10ドルです。Fish Audio 自身の料金ドキュメントと開発者ページには、10月14日時点でまだ S2.1 Pro の15ドルしか載っておらず、Drama 3 の行はありません。また、ドキュメントでは文字数ではなく UTF-8 バイト数で課金されます。単純な英語のテキストなら両者は近いですが、予算を組む前にダッシュボードで確認してください。
"Drama 3 Preview is available via the Fish Audio API at $15/1M characters, the same as S2.1 Pro, compared to Eleven v4 at $80/1M characters and Eleven v4 Turbo at $40/1M characters."
これはプレビュー版の発売当日の掲載なので、過去のものとして扱うのがよいでしょう。50ドルの定価で予算を組み、10ドルは1か月限定の割引と考えてください。ElevenLabs の API 料金ページでは、v4 が1,000文字あたり0.08ドル、v4 Turbo が0.04ドルで、100万文字あたりでは80ドルと40ドルです。
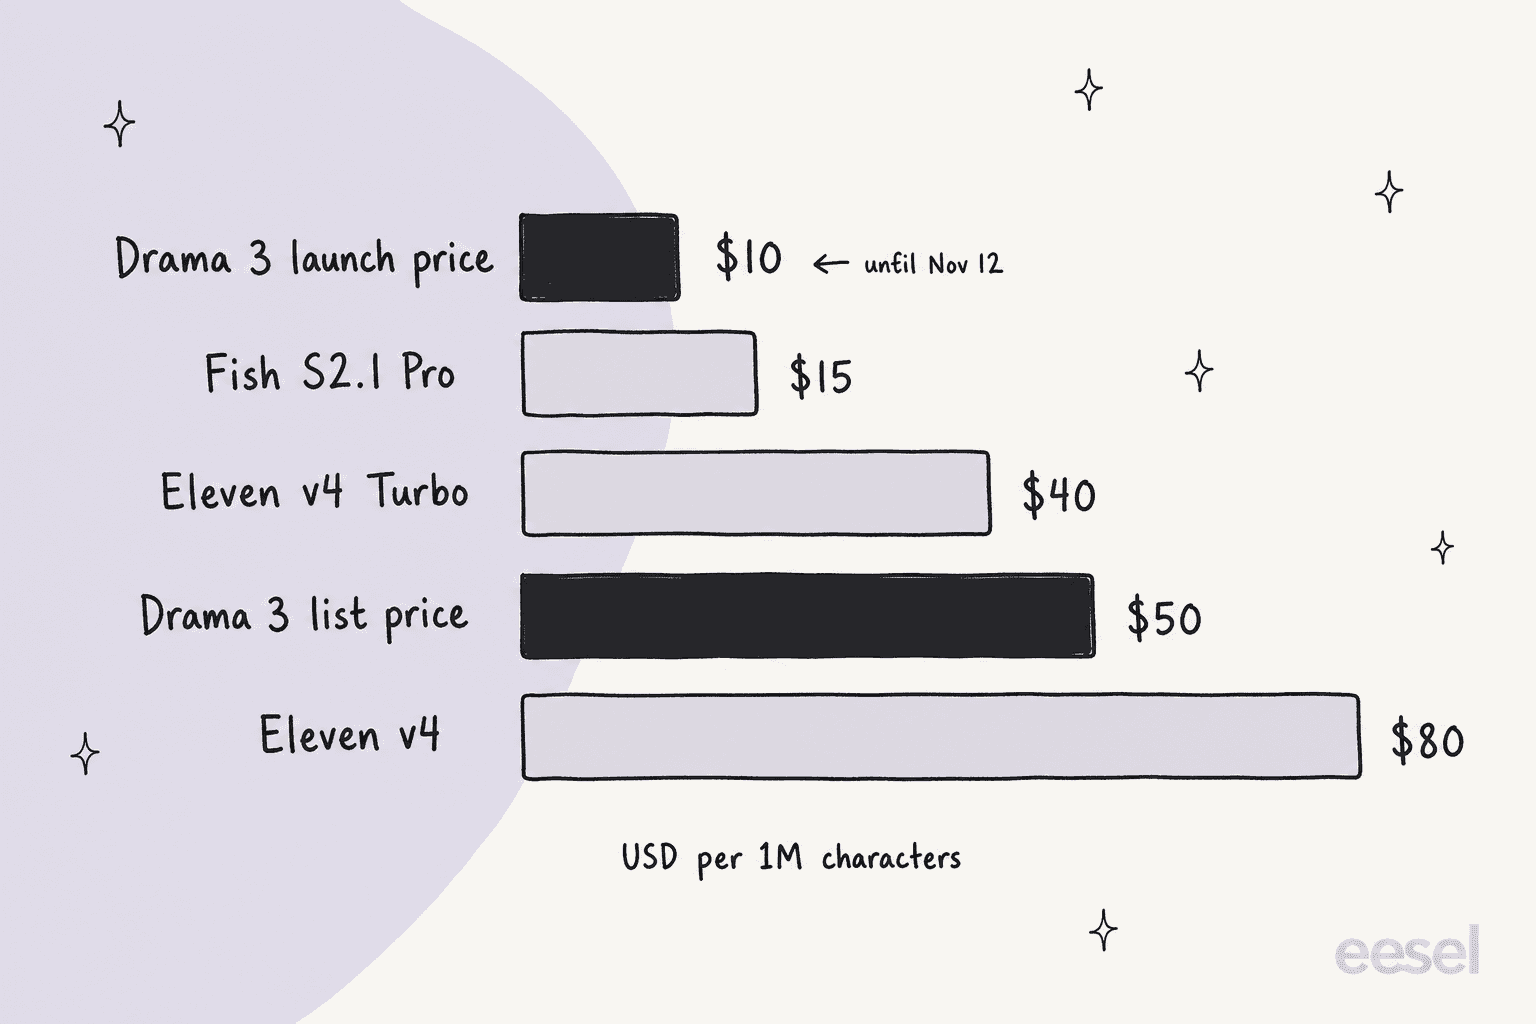
450,000文字(約8万語の小説1冊ぶん)の作業にかかる費用は次のとおりです。すべての行で同じ文字数を使っています。
| 経路 | 100万文字あたりの料金 | 450,000文字の費用 |
|---|---|---|
| Drama 3、発売価格(11月12日まで) | $10 | $4.50 |
| Drama 3、定価 | $50 | $22.50 |
| Eleven v4 Turbo | $40 | $18.00 |
| Eleven v4 | $80 | $36.00 |
| セルフホストの Drama 3 | GPU 時間のみ | 売上50万米ドル未満なら無料 |
定価では、Drama 3 は Eleven v4 より安く、Turbo より高いので、選ぶ基準は請求額ではなく声です。より詳しい内訳は、Eleven v4 の料金と ElevenLabs の料金のガイド、Google を検討しているなら Gemini 3.8 Flash TTS の料金をご覧ください。
アプリでは仕組みが異なります。Drama 3 は S2.1 Pro と同じクレジットを消費し、11月12日までは、新規の Plus、Pro、Max プランが、月払いなら最初の1か月、年払いなら最初の1年が50%オフです。
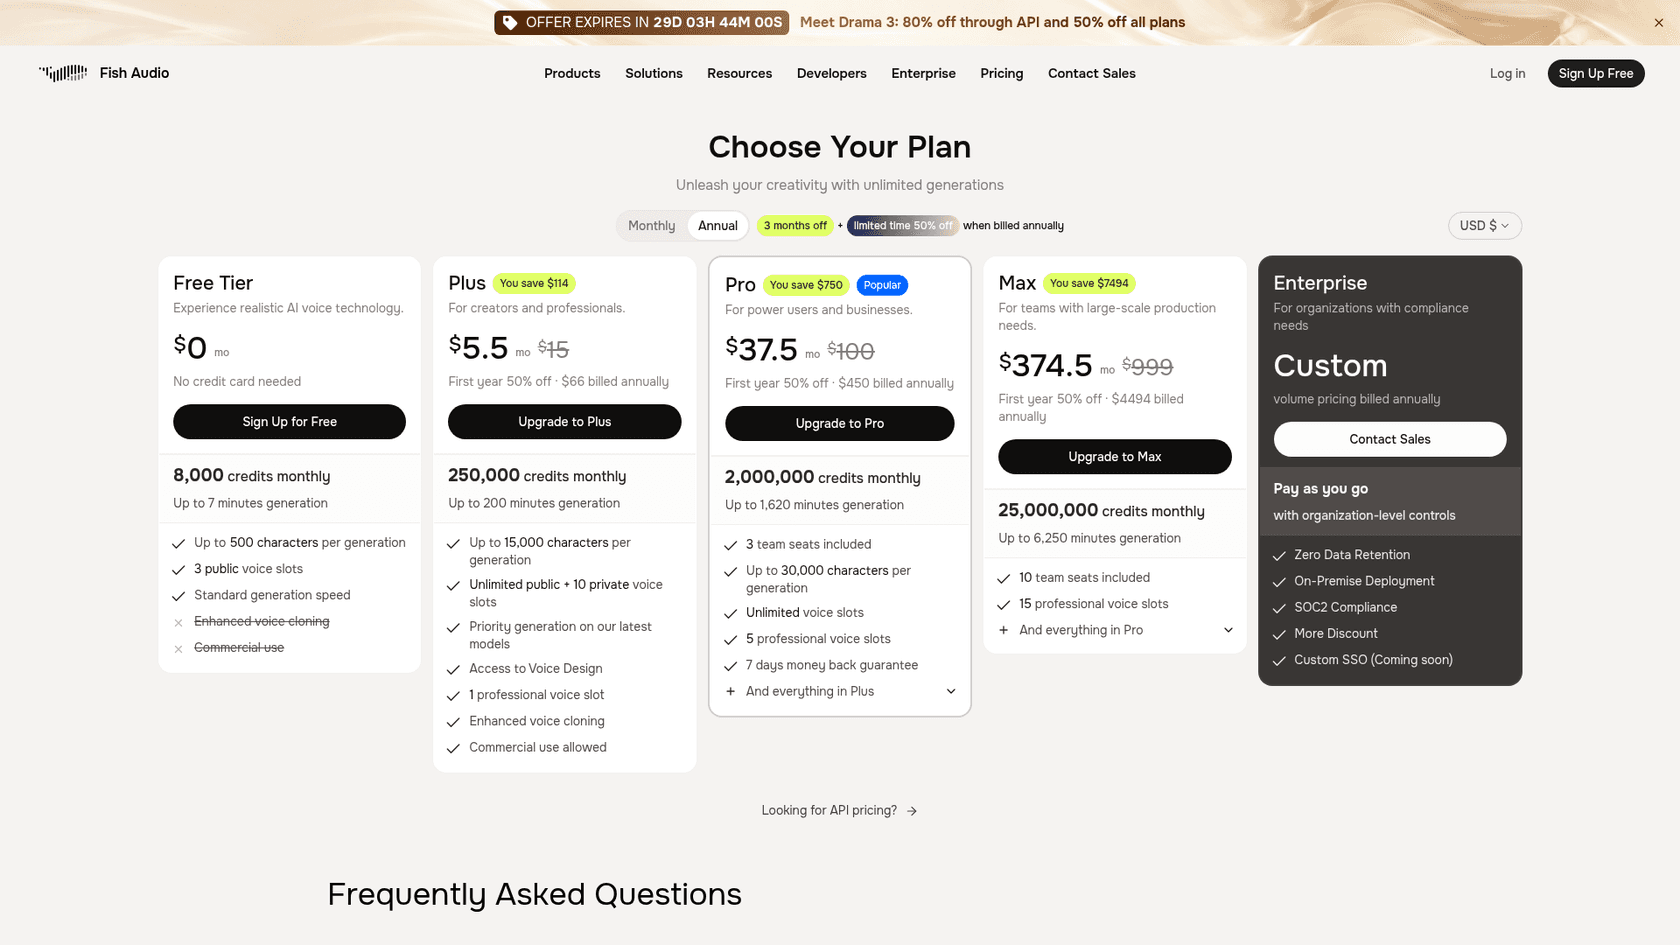
| プラン | 表示価格(年払い、初年度) | 月間クレジット |
|---|---|---|
| Free | $0 | 8,000、1回の生成で最大500文字、商用利用不可 |
| Plus | 月 $5.50、$15 は取り消し線 | 250,000 |
| Pro | 月 $37.50、$100 は取り消し線 | 2,000,000、チーム席3 |
| Max | 月 $374.50、$999 は取り消し線 | 25,000,000、チーム席10 |
| Enterprise | 個別見積もり | 従量課金、SOC 2、データ保持ゼロ |
出典:Fish Audio のプランページ、2026年10月14日に取得。取り消し線の価格はオファー後の料金です。
Drama 3 を自分で動かせる?
はい、ただし条件があります。ウェイトは Hugging Face で Fish Audio Community License v1.0 のもとに公開されています。研究と非商用なら無料で、あなたと関連会社の年間売上が50万米ドル未満であれば商用利用も無料です。それを超える場合、または Drama 3 を他者に TTS、音声クローン、推論サービスとして提供する場合は、Fish Audio からのライセンスが必要です。本人の同意なく実在の人物の声をクローンすることも禁止されています。Fish Audio はこの公開を、オープンソースではなくオープンウェイトと呼んでおり、それが正確な言い方です。
もう一つの制約はハードウェアです。モデルカードには FP8 と bf16 で360億パラメータと書かれており、公開当日のコミュニティの報告は、「needs a 48gb Cuda card」から、一般向けの GPU 2枚での動作まで幅がありました。
"Opus 5.5 was able to get it running on my two RTX 3090s at ~39gb of VRAM."
Fish Audio 自身の数値は NVIDIA H200 によるものです。H200 1基で1ストリームの場合、Hugging Face のカードは最初の音声が出るまでの時間の中央値を88.9ミリ秒と報告し、16の同時ストリームでは中央値は210.1ミリ秒です。ライセンスには不満の声も出ましたが、あるコメント投稿者は公平に答えました。
"License is a bit lame but I understand they need to make money too lol"
セルフホストとマネージドの経路を比べているなら、私のオープンソースAIエージェントのまとめが、エージェントソフトウェアについて同じトレードオフを扱っています。
Drama 3 の制限は?
プロジェクトを任せる前に知っておくべき6点です。
- レンダリング済みのセリフ向けです。 Fish Audio 自身の発表記事は、Drama 3 が最も力を発揮するのは、オーディオブック、オーディオドラマ、ゲーム、短い動画など、一度レンダリングして保存する台本付きのセリフだと述べています。ライブ会話は別の仕事で、それには Eleven v4 Turbo や Cartesia Sonic 3 を比べてください。
- テイクにばらつきがあります。 Fish Audio は、いくつかレンダリングして、うまくいったものを残すよう勧めています。
- 編集機能はまだ公開されていません。 インタラクティブな編集と音声のインペインティングは、招待制の小規模テスト中で、編集 API は「coming soon」です。
- 言語切り替えは実験的です。
<french>形式のタグは、すべての言語や声で保証されていません。 - ライセンスには条件があります。 売上の上限とサービス提供禁止のルールは、この上に音声プロダクトを作る人には重要です。
- 価格の行がまだドキュメントにありません。 上記を参照してください。
また、83言語という数字を、83の同等に優れた言語と読むことはお勧めしません。Fish Audio の発音スコアは英語のみなので、本当に必要な言語を自分で試してください。公開当日にもドイツ語について尋ねる Reddit ユーザーがいましたが、まだ回答はありません。顧客向けの多言語対応には、私の多言語サポートのQAガイドが、各言語を個別に確認する方法を紹介しています。
Drama 3 は誰に向いていて、誰は見送るべき?
使うべき人は、オーディオブック、フィクションのポッドキャスト、ゲームの台詞、短い動画など、1行ずつレンダリングして確認し、残す用途の人です。範囲指定タグはアップグレードに値する機能です。セリフの1語を直すほうが章全体を再生成するより安く、これを Fish Audio の CEO Rissa Cao は長尺の仕事の要点として語っています。動画やポッドキャストの台本を書くなら、AIポッドキャスト台本ジェネレーターや AI動画台本ツールとの相性がよいでしょう。
代替を検討すべき人は、ブラインド試聴で最も実績のある声が欲しい人です。その場合、ElevenLabs と Cartesia が当然の比較対象で、Hume AI のような感情レイヤーも候補です。私の ElevenLabs の代替の記事で各社を並べています。
今は見送るべき人は、すぐ使えるライブの電話エージェントが必要な人です。Drama 3 は声であってエージェントではないので、何を言うか、いつ人に引き継ぐかを決める仕組みがまだ必要です。それには Retell AI、Vapi、Decagon Voice 3、Grok Voice Think Fast 2 をご覧ください。コストとシンプルさだけで音声 API を比べるなら、OpenAI の音声 API と Whisper と TTS API の比較がより素直な基準です。
音声モデルはサポートチームにとって何を意味する?
音声モデルが変えるのは答えの聞こえ方であって、答えが正しいかどうかではありません。温かく、ほどよい間で読み上げられた返金ポリシーを聞いた顧客も、裏のエージェントが推測で答えていれば、間違った返金期間を受け取ります。表現力豊かな声はミスをより説得力のあるものにするので、私は土台の層を重視しています。
実際のキューで私が繰り返し見るパターンは、チームは音声を求めながら、まずチケットから始めるということです。eesel を使うあるサポートチームは、音声録音のサポートがないため、エージェントが AI のために通話を手作業で要約しなければならず、それが加われば "would significantly increase our usage" と書きました。これは機能要望であり、私は誇張しません。eesel は現在テキスト中心で、電話の音声ではなくチケットとチャットを扱います。有効な構成は、まずテキストで答えを正しくし、それから合う音声モデルに渡すことです。
サポートでの音声を検討しているなら、音声カスタマーサポートツールと Zendesk の音声AIエージェントが良い出発点で、カスタマーサービス向け会話型AIは声の手前の層を扱います。声をブランドと一貫させることも忘れずに。演出に従うモデルは、誰かがその演出を書き留めて初めて役に立ちます。
eesel を試す
チケットとチャットが積み上がっているために音声を検討しているなら、答えが作られる場所から始めましょう。eesel の AIヘルプデスクチームメイトは、すでに使っているヘルプデスクに参加し、過去のチケットとヘルプセンターから学び、あなたのトーンで返信します。実際の顧客に触れる前に、過去のチケットで実行して、何と答えたかを確認できます。私ならどの音声レイヤーの台本も、そのようにテストします。

ターミナルがお好みなら、eesel CLI を使って、あなた、スクリプト、あるいは Claude Code のようなコーディングエージェントが、同じチームメイトの指示を読み書きし、アクティビティを確認できます。ほかのサービスを管理するのと同じ感覚です。無料プランにはカード不要で100クレジットが含まれ、有料プランは料金ページにあります。音声について何かを決める前に、先月のチケットで eesel を試してみてください。
よくある質問
Fish Audio Drama 3 とは何ですか?
Fish Audio Drama 3 の料金はいくらですか?
Drama 3 はオープンソースで、商用利用は無料ですか?
API で Drama 3 を使うにはどうすればいいですか?
POST /v1/tts リクエストはそのままに、ヘッダー model: drama-3 を設定します。ヘッダーがない、またはつづりが違う場合はエラーなしで s2.1-pro に切り替わるため、音声が平板に聞こえたらまずここを確認してください。同じ呼び出しはスクリプトやコーディングエージェントからも使え、eesel CLI がサポートチームメイトに対して行うのと似ています。