

Gemini Omni 1.2 Flash es la actualización del 5 de noviembre de 2026 de Google DeepMind para su modelo de vídeo Omni. Los cambios principales son clips de 15 segundos (antes 10), unos $0,07 por segundo de vídeo en 720p (antes unos $0,10) y una consistencia más estrecha de personajes y productos entre imágenes de referencia. Sigue siendo un modelo sobre el que construyes, no un trabajador que hace un trabajo. Yo lo usaría para pipelines de vídeo publicitario y de producto. Para tickets de soporte o publicaciones de blog, un compañero de equipo listo para usar como eesel encaja mejor, y la eesel CLI permite que un agente de código suba conocimiento aprobado y pruebe las respuestas de un compañero de equipo antes de que salga en vivo.
¿Qué es Gemini Omni 1.2 Flash?
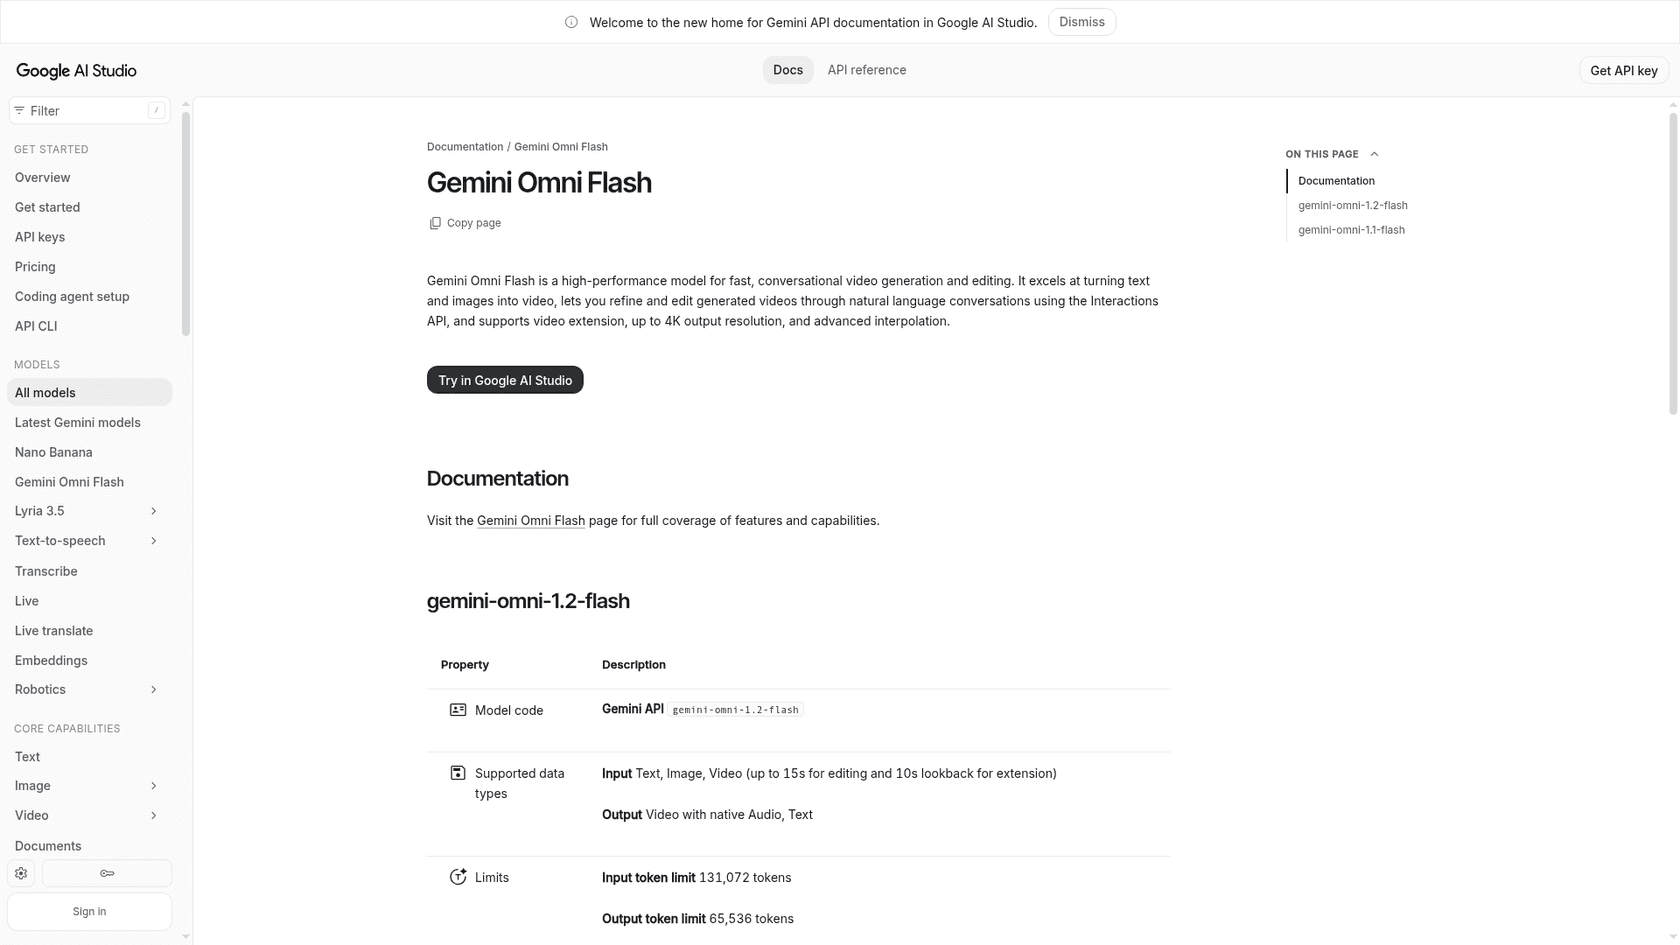
Es el tercer lanzamiento en la línea de vídeo Omni de Google, tras el Gemini Omni Flash original y la actualización de agosto, Gemini Omni 1.1 Flash. La ficha del modelo de Google enumera texto, imágenes, audio y vídeo como entradas, y "vídeo de alta calidad y alta resolución con audio" como salida. El ID del modelo en la API de Gemini es gemini-omni-1.2-flash, y el registro de cambios de la API de Gemini lo marca como disponible de forma general el 5 de noviembre de 2026.
La idea se mantiene de los lanzamientos anteriores: describes una toma y luego la refinas charlando en lugar de volver a renderizar desde cero. Si quieres la historia del modelo original, mi análisis de Gemini Omni Flash la cubre.
¿Qué cambió respecto a 1.1?
La versión corta es clips más largos, un precio más bajo y referencias más sólidas. Un detalle va en la dirección contraria, y lo señalo más abajo.
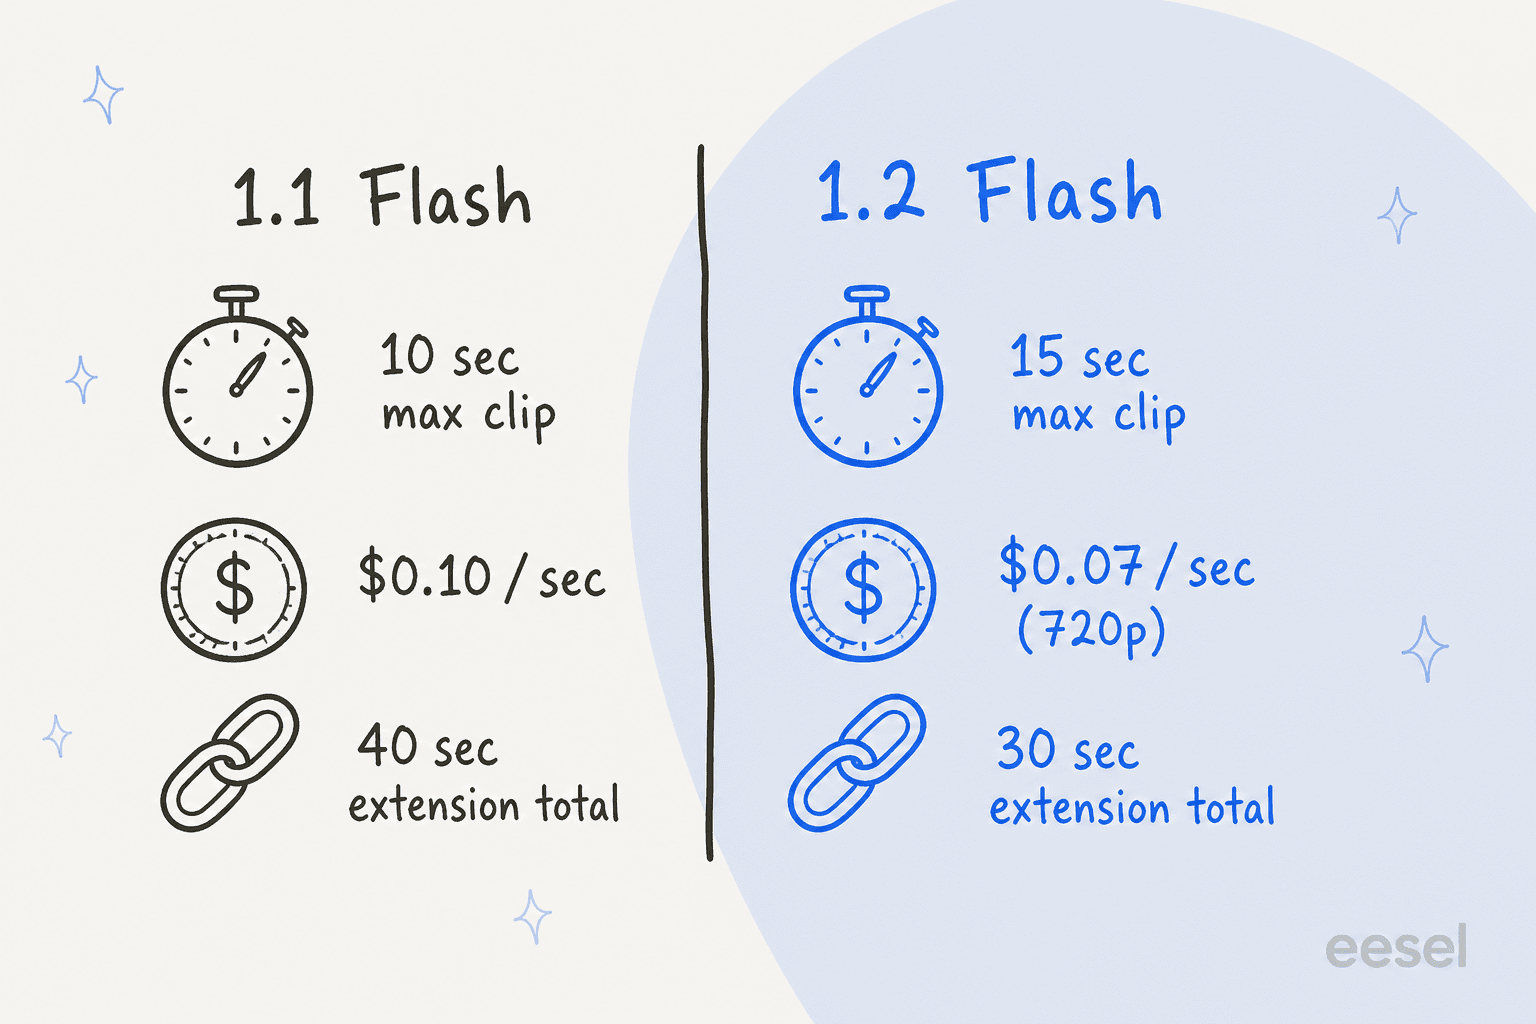
- Duración del clip: de 3 a 15 segundos por generación, en pasos de un segundo, según la documentación de Google AI Studio. La versión 1.1 limitaba una generación a 10 segundos.
- Precio: la salida de vídeo baja a
$12,00por 1 M de tokens desde$17,50, lo que la página de precios sitúa en unos$0,07por segundo de vídeo en 720p. - Referencias: el registro de cambios dice que el modelo mantiene a los personajes y sujetos más consistentes a través de hasta seis imágenes de referencia. Las referencias de audio están detrás de una lista de acceso en Google Cloud.
- Voz: la publicación de lanzamiento de Google Cloud menciona sincronización de labios más clara y condicionamiento multihablante.
- Límites: los límites de tasa del nivel de pago se duplicaron, según la misma entrada del registro de cambios.
Un detalle va contra la tendencia. En el lanzamiento, 1.1 anunciaba una extensión de escena de hasta 40 segundos en total. La documentación de 1.2 lista la extensión en 3 a 10 segundos por turno, hasta 30 segundos en total. Las páginas de Google no explican la diferencia, así que si planeabas cadenas de 40 segundos, pruébalo antes de comprometerte.
¿Qué tan bueno es, según las propias cifras de Google?
La página de Gemini Omni de Google publica tasas de victoria lado a lado de 1.2 frente a 1.1. Son evaluaciones propias de Google, no un benchmark independiente, y tus indicaciones e imágenes de referencia no estaban en esa muestra.
| Prueba | Tasa de victoria 1.2 | Tasa de victoria 1.1 |
|---|---|---|
| Texto a vídeo, consistencia visual | 62% | 38% |
| Referencia a vídeo, preferencia general | 63% | 37% |
| Referencia a vídeo, consistencia de identidad | 63% | 37% |
| Imagen a vídeo, preferencia general | 59% | n/a |
| Edición por instrucciones | 57% | n/a |
Lee esto como "un avance claro pero moderado". Una tasa de victoria del 62% significa que aproximadamente una de cada tres comparaciones todavía preferían el modelo anterior. Para trabajo publicitario, las filas de consistencia de referencia son las que más importan, porque los colores de producto que se desvían son lo que suele hacer que se rechace una generación.
¿Cuánto cuesta?
La página de precios de la API de Gemini lista el modelo solo en el nivel estándar. No hay nivel gratuito ni nivel por lotes. La entrada cuesta $1,50 por 1 M de tokens, la salida de texto $9,00 y la salida de vídeo $12,00.
| Resolución | Por segundo | Tokens por segundo |
|---|---|---|
| 360p | $0,023 | 1.931 |
| 720p | unos $0,07 | 5.792 |
| 1080p (con sobremuestreo) | $0,104 | 8.688 |
| 4K (con sobremuestreo) | $0,209 | 17.376 |
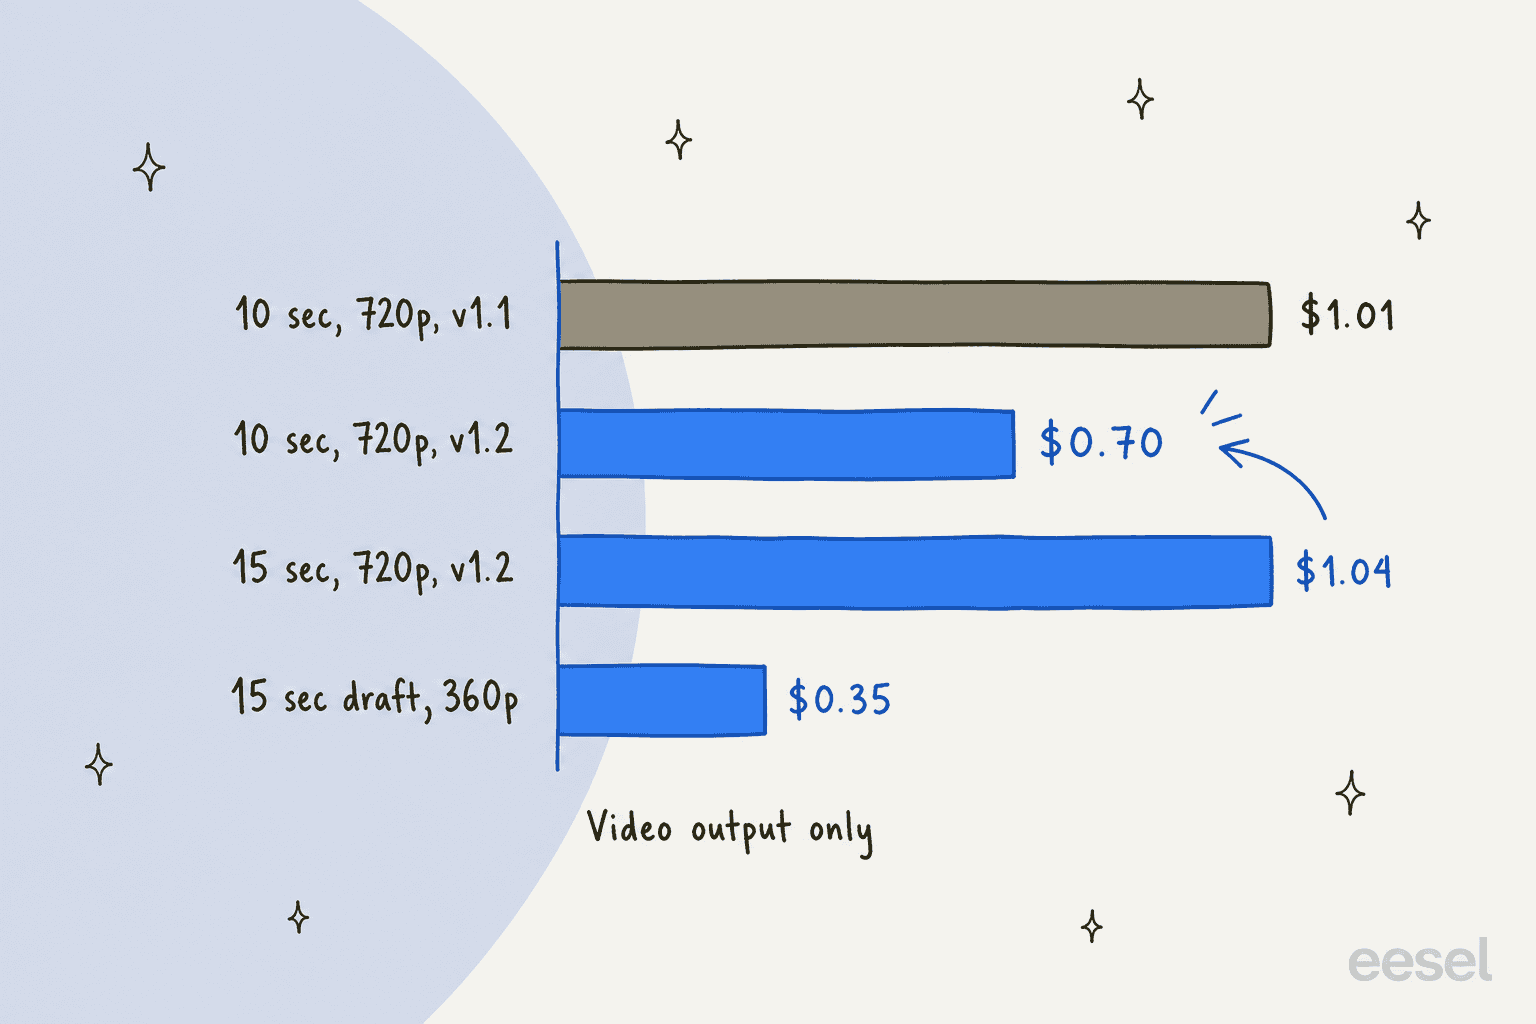
Los 5.792 tokens por segundo en 720p vienen de la misma tarifa usada en mi guía de precios de Omni 1.1. Multiplicando, un clip completo de 15 segundos en 720p cuesta unos $1,04 y uno de 10 segundos unos $0,70, frente a unos $1,01 por 10 segundos en 1.1. Para más contexto, mira mi desglose de precios de Gemini Omni Flash y la guía general de precios de Gemini.
La página de precios de Google dice que, a partir del 3 de diciembre de 2026, las solicitudes al ID del modelo 1.1 se redirigen automáticamente a 1.2 y se facturan a las tarifas de 1.2. Si tienes llamadas a 1.1 en producción, tus costos bajan sin un cambio de código, y tu salida también cambia sin uno.
¿Cómo funciona el flujo de borrador y luego escalado?
La publicación de lanzamiento de Google describe hacer borradores en 360p o 720p y luego escalar la mejor toma a 1080p o 4K. En la práctica, iteras de forma económica, corriges problemas con un mensaje de seguimiento en el chat y solo pagas una vez por el renderizado de alta resolución.
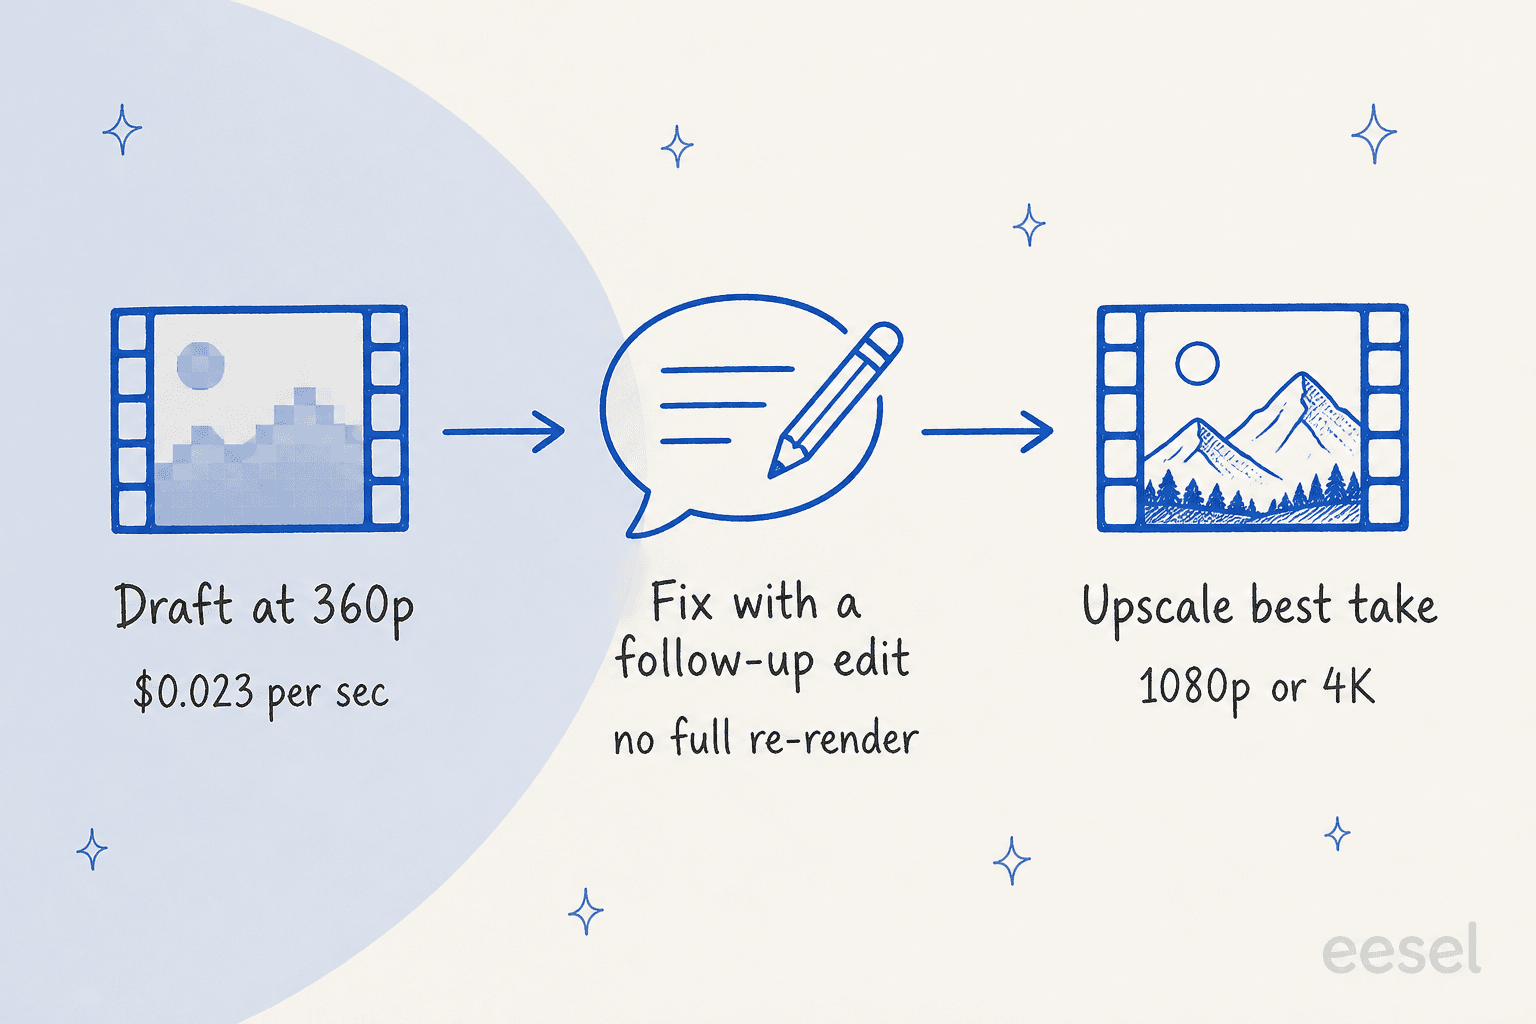
Dos detalles sobre los que la documentación no dice nada. No especifica si un borrador se factura además de su escalado posterior, así que un flujo de trabajo con muchos borradores debería presupuestarse primero con una pequeña prueba. Y como señaló un comentarista de Hacker News sobre 1.1, los borradores y los renderizados finales no son deterministas, así que un borrador es una vista previa de la dirección y no una garantía del fotograma final.
¿Dónde puedes usarlo?
Google enumera una amplia variedad de superficies en la ficha del modelo: la app de Gemini, la app de Gemini Enterprise, Google AI Studio, YouTube, Flow, Google Cloud, la API de Gemini y Workspace. Detalles que vale la pena conocer:
- Google Vids: la publicación de Workspace Updates dice que el despliegue comenzó el 5 de noviembre, con un control deslizante de 3 a 15 segundos y sin control de administrador. Cubre los planes Business, Enterprise y Education, además de cuentas personales con Google AI Pro o Ultra.
- Google Cloud: disponible de forma general a través de la API y la consola, con Provisioned Throughput para cargas de trabajo en producción. La creación de vídeo en Gemini para empresas aparece como "próximamente".
- Límites de contexto: 131.072 tokens de entrada y 65.536 tokens de salida, salida a 24 FPS y de 360p hasta 4K.
El acceso no es igual en todos los planes. En el hilo de lanzamiento en Hacker News, un comentarista describió la friccion:
"There have been months where we've paid 1500€ for my AI models, but I can't bother with Google's models because I literally don't know how to get them."

¿Qué hay de la seguridad y la procedencia?
Cada salida lleva una marca de agua imperceptible SynthID, y la página de producto de Google añade C2PA Content Credentials. La ficha del modelo dice que el modelo puede cambiar el habla de las personas durante la edición de vídeo, una capacidad que actualmente está restringida. También informa que, según evaluaciones de Gemini 3.1 Pro y Gemini 3.7 Flash, es poco probable que el modelo alcance ningún nivel de capacidad vigilado o crítico.
¿Quién ya está construyendo sobre él?
La publicación de lanzamiento de Google Cloud cita a una serie de equipos de productos de vídeo: invideo dice que 15 segundos permiten que una escena completa quepa en una sola generación, QuickFrame AI dice que la salida de 15 segundos en 1080p permite a los usuarios construir un anuncio completo de TV conectada en una sola pasada, y Picsart señala el modo borrador para una iteración rápida de conceptos. Son socios de lanzamiento que Google eligió destacar, así que léelos como enfoque de lanzamiento, no como reseñas neutrales. Aun así, el patrón es claro: anuncios, animación de producto y herramientas creativas.
Si estás comparando modelos de vídeo, mi guía de precios de Sora 2 y la lista de alternativas a Sora 2 cubren el lado de OpenAI, y la publicación de alternativas a Omni 1.1 cubre el campo más amplio.
¿Dónde encaja Gemini Omni 1.2 Flash?
Soy Rama, y lanzo integraciones y APIs en eesel, así que leo el lanzamiento de un modelo como lo haría un ingeniero: ¿cuál es el contrato, y qué me falta construir todavía? Omni 1.2 te da un buen contrato para vídeo: un ID de modelo, un precio por segundo, límites documentados. Tú sigues construyendo la app, el paso de revisión y la conexión con tus propias herramientas.
Esa es la línea que veo entre infraestructura y un empleado. Un modelo de vídeo es infraestructura; eesel es el empleado. eesel es una plataforma de compañeros de equipo con IA, y los clientes contratan compañeros de equipo listos para trabajar en un puesto definido. La alineación de hoy es un escritor de blog con IA y un agente de helpdesk con IA, cada uno llegando con las habilidades, integraciones y contexto de empresa para su rol.
Una prueba con nombre vence a los adjetivos aquí. SE Ranking, la empresa de software de SEO, opera un agente de eesel separado para cada uno de sus tres productos en el chat y los tickets de Zendesk. En un mes, del 8 de agosto al 8 de septiembre de 2026, esos agentes gestionaron 4.650 conversaciones, 2.100 de ellas chats en vivo respondidos primero por eesel. Ningún modelo de vídeo hace ese trabajo, y ningún agente de helpdesk renderiza un anuncio. Elige la herramienta para el trabajo que realmente tienes.
Una nota práctica para desarrolladores: la eesel CLI permite que un agente de código como Claude Code o Codex suba conocimiento aprobado, ajuste las instrucciones de un compañero de equipo y haga preguntas de prueba para revisar las respuestas antes de que algo salga en vivo. Conectar un helpdesk en sí todavía necesita que alguien con acceso de administrador lo apruebe.
Si estás construyendo el lado de contenido alrededor del vídeo, aplica la misma lógica. Mis guías sobre el escritor de blog con IA, la automatización de blog con IA y el pipeline de contenido de blog con IA muestran cómo delegar ese trabajo. Para guiones que alimenten un modelo de vídeo, mira los generadores de guiones de vídeo con IA y si la IA puede escribir guiones de vídeo. Para la gama más amplia de Google, lee alternativas a Gemini, Gemini 3.8 Flash, Nano Banana 2, Nano Banana Pro, Gemini Lyria 3 y Gemini vs ChatGPT. Para la idea del compañero de equipo con IA, mira compañeros de equipo con IA y empleados de IA.
Prueba eesel para el trabajo que un modelo de vídeo no puede hacer
Si tu equipo hace vídeo con Omni, alguien todavía tiene que escribir las publicaciones alrededor y responder las preguntas que genera. El escritor de blog con IA investiga y redacta contenido a partir de tu propio conocimiento, y el agente de helpdesk con IA se une a tu cola de soporte existente y trabaja desde tus tickets pasados y tu centro de ayuda. Puedes probar eesel gratis y simular a un compañero de equipo con datos históricos reales antes de que salga en vivo.
Preguntas frecuentes
¿Qué es Gemini Omni 1.2 Flash?
¿Cuánto cuesta Gemini Omni 1.2 Flash?
¿Cuánto puede durar un vídeo de Gemini Omni 1.2 Flash?
¿Cuál es el ID del modelo Gemini Omni 1.2 Flash?
gemini-omni-1.2-flash. A partir del 3 de diciembre de 2026, las solicitudes a gemini-omni-1.1-flash se redirigen a 1.2 y se facturan a las tarifas de 1.2, según el registro de cambios de la API de Gemini.