

Was ist eine Wissenslücken-Analyse im Support?
Eine Wissenslücken-Analyse im Support vergleicht zwei Listen: was Kunden dein Support-Team tatsächlich fragen und was deine Wissensdatenbank tatsächlich beantwortet. Die Differenz ist deine Lückenliste. Gut gemacht, endet sie in einem kurzen, priorisierten Backlog von Artikeln, die du schreiben oder überarbeiten solltest, und nicht in einer Tabelle mit 300 Zeilen, die niemand öffnet.
Ich baue bei eesel KI-Agenten, und diese Arbeit hat meinen Blick auf Lücken verändert. Ein KI-Agent liest dein Help Center genauer als jeder Kunde. Das Erste, was er zutage fördert, ist deshalb keine clevere Antwort. Es ist jedes Thema, zu dem deine Dokumente nichts oder das Falsche enthielten. Das ist nützlich, denn eine Lücke sieht selten wie eine leere Seite aus. Meist zeigt sie sich in einer von drei Formen.
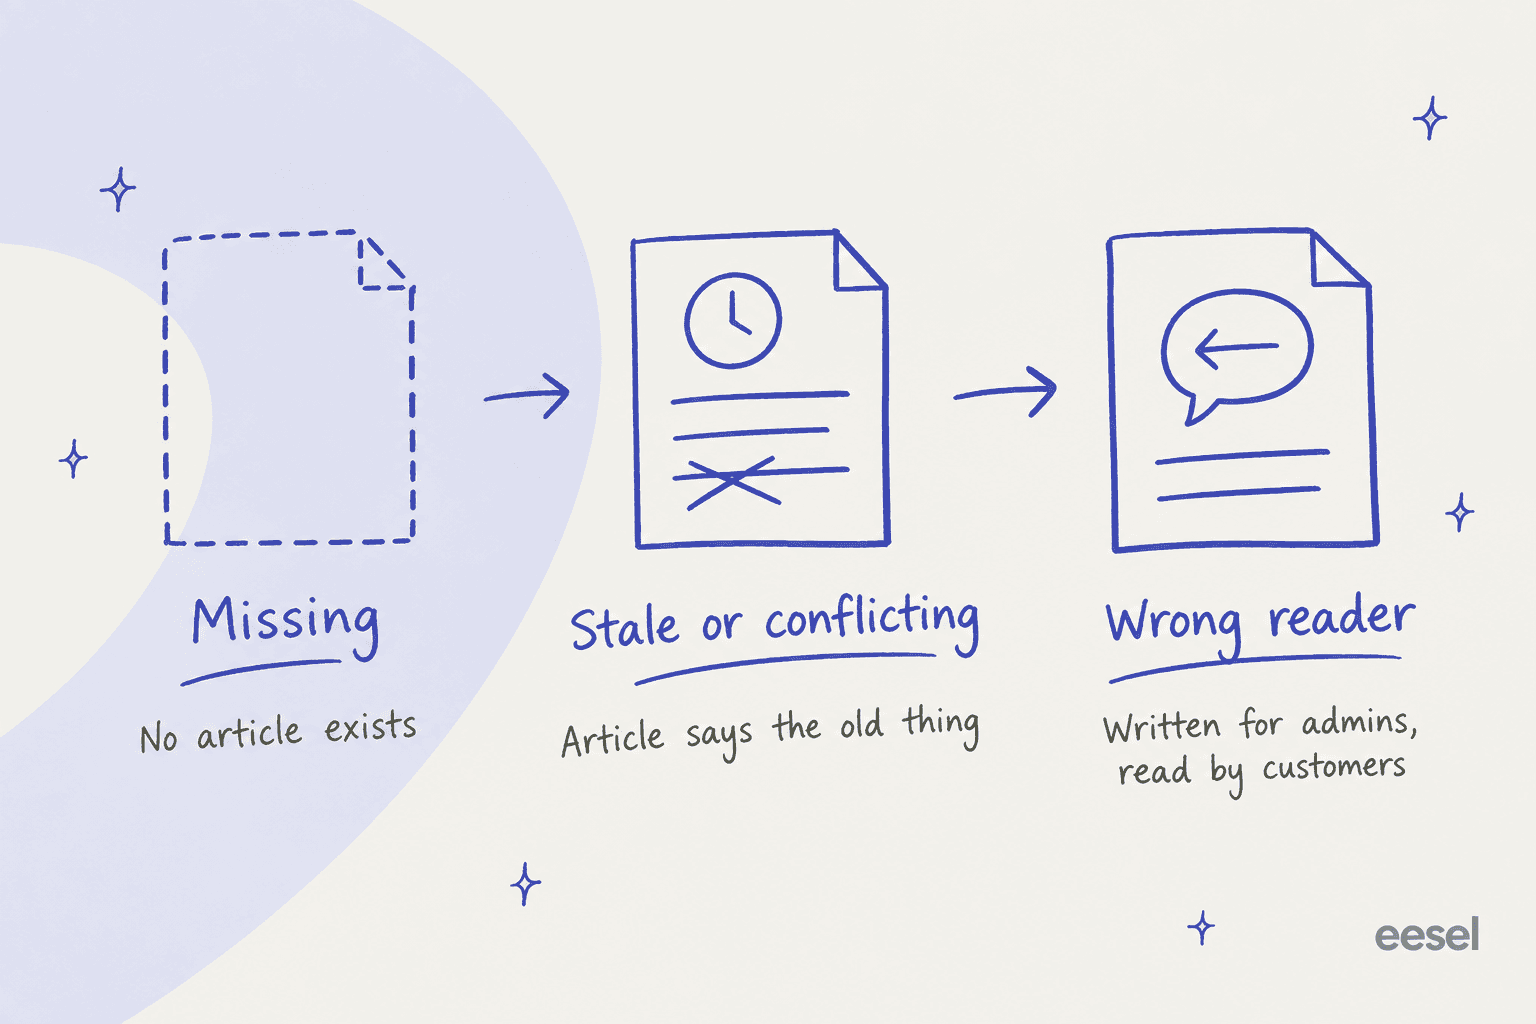
- Fehlend. Kein Artikel deckt das Thema ab. Diese Lücken erkennt man am leichtesten, und sie sind am einfachsten zu schließen.
- Veraltet oder widersprüchlich. Ein Artikel existiert, nennt aber die alte Erstattungsfrist, oder zwei Artikel widersprechen sich. Gorgias führt das sogar als eigenen Typ, "Resolve knowledge conflict", in seinem Opportunities-Feed.
- Für die falsche Zielgruppe geschrieben. Der Artikel ist korrekt, beantwortet aber die Frage einer anderen Person. Ein Support-Manager, der von einem Bus-Tracking-Dienst mit 200 bis 250 Zendesk-Tickets im Monat zu eesel kam, stellte fest: Seine gesamte Wissensdatenbank war für Admins geschrieben, während die Tickets von Fahrgästen kamen. Jede Antwort war technisch vorhanden, und nichts davon half.
Die dritte Art zeigt dir ein Suchbericht nie, denn die Suche des Kunden liefert ein Ergebnis. Es ist nur das falsche. Deshalb muss eine Lückenanalyse auf Tickets schauen und nicht nur auf Suchen. Den reinen Suchansatz habe ich in meinem Leitfaden zum Abgleich von Suchanfragen mit Lücken behandelt, und er ist ein guter Anfang. Das ganze Bild liefert er nicht.
Warum erfolglose Suchen deine Lücken unterschätzen
Erfolglose Suchen sind das klassische Lückensignal, und jeder Leitfaden beginnt dort. Das Problem ist, wen sie zählen. Eine erfolglose Suche gibt es nur, wenn ein Kunde dein Help Center öffnet, eine Anfrage eintippt und nichts zurückbekommt. Der Kunde, der direkt zum Kontaktformular geht, auf eine Bestell-E-Mail antwortet oder den Chat öffnet, taucht in diesem Bericht nie auf.
Help Scout ist bei einem weiteren blinden Fleck erfrischend offen. Sein Docs-Bericht schließt Suchen aus der Docs-Suchleiste im Antwort-Editor und Suchen über die API aus, sodass auch die erfolglosen Suchen deiner eigenen Agenten nicht zählen. Wenn Agenten mitten im Ticket das Help Center durchsuchen und nichts finden, ist das eines der stärksten Lückensignale, das du hast. Im Standardbericht ist es unsichtbar.
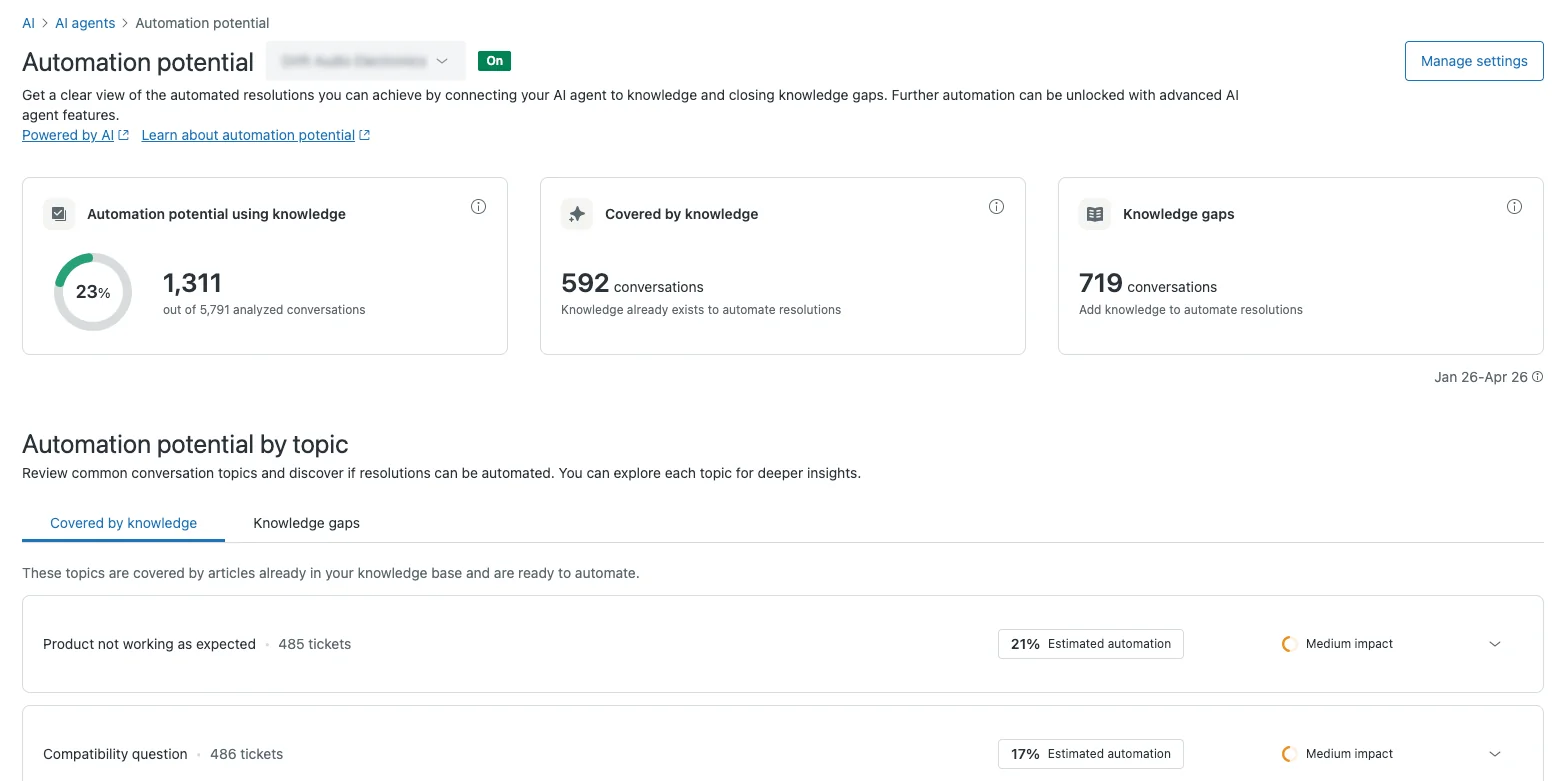
Tickets erzählen eine größere Geschichte. Im Beispielbericht auf der Hilfeseite zum Automatisierungspotenzial von Zendesk analysierte das Konto 5.791 Konversationen und markierte 719 davon als Wissenslücken, mehr als die 592, die seine bestehenden Artikel bereits abdeckten. Das ist ein Demo-Konto und kein Benchmark, aber das Muster entspricht dem, was ich sehe: Die Ticketschlange enthält mehr unbeantwortete Themen als das Suchprotokoll.
Erfolglose Suchen bleiben also Teil der Analyse. Sie werden nur zu einem von vier Inputs, jeder mit seinem eigenen blinden Fleck.
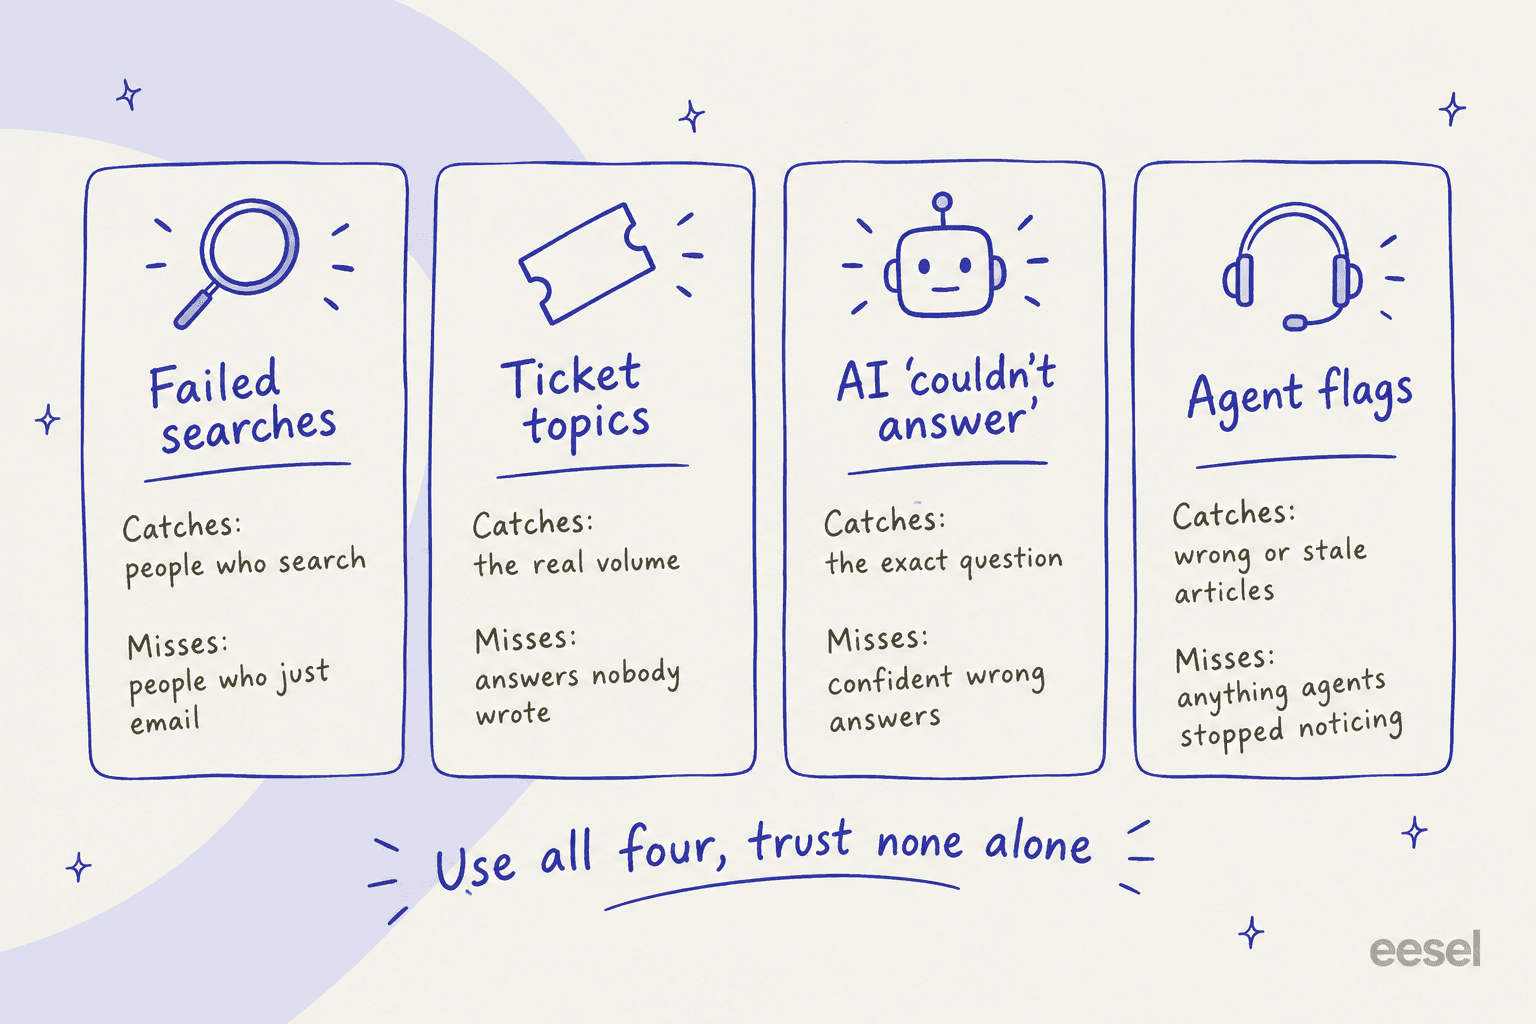
Die vier Signale, die du auswerten solltest
Zu jedem Signal unten steht, was es erfasst, was es übersieht und wo du es findest. Du brauchst nicht gleich am ersten Tag alle vier. Zwei reichen für einen ersten Durchlauf, solange eines davon aus Tickets stammt.
1. Suchen ohne Ergebnis
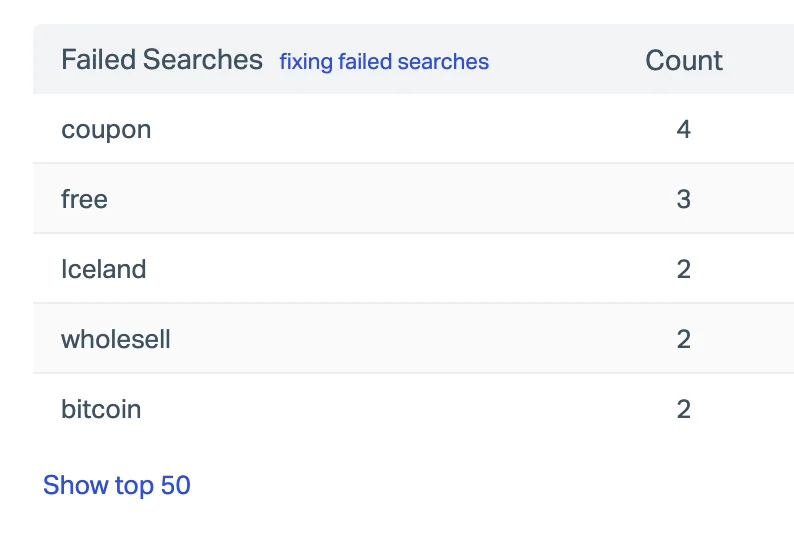
Hier sagt dir der Kunde in seinen eigenen Worten, was er zu finden erwartet hat. Das ist großartig für das Vokabular: Kunden suchen "kündigen", während dein Artikel "Abonnement verwalten" heißt. Help Scouts Leitfaden zum Beheben erfolgloser Suchen schlägt genau diese Lösung vor: alternative Wörter im Feld Keywords eines Artikels ergänzen oder einen neuen Artikel schreiben, wenn das Thema nicht abgedeckt ist.
Wo du es findest:
- Zendesk: Das vorgefertigte Search-Dashboard hat einen KPI "Searches with no results" und ein Top-5-Diagramm, mit Daten für bis zu 390 Tage, laut seinem Leitfaden zu Suchergebnissen. Es braucht einen Suite-Tarif oder Support mit Knowledge Professional oder Enterprise.
- Help Scout: Reports, dann Docs, dann die Tabelle Failed searches. Standard-Tarife speichern Daten für 2 Jahre, Plus und Pro für die Lebensdauer des Kontos.
- HubSpot: Die Analytics der Wissensdatenbank zeigen "Search terms with no results" in Service Hub Professional und Enterprise, laut HubSpots Leitfaden zur Analyse der Wissensdatenbank.
- Gorgias: Der Help-Center-Bericht hat einen KPI "No-result searches". Wenn du die Tabelle Search terms nach "Has results is false" filterst, erhältst du ein Backlog. Gorgias weist außerdem darauf hin, dass viele Suchen ohne Ergebnis in einer Sprache meist bedeuten, dass Artikel nie übersetzt wurden.
- Zoho Desk und Front: Zohos Dashboard der Wissensdatenbank teilt Keywords in Popular und Failed auf. Fronts Bericht zur Wissensdatenbank hat kein Label "failed". Suche dort nach Keywords mit vielen Suchen und einer niedrigen durchschnittlichen Ergebniszahl.
Freshdesk ist die Ausnahme. Ich konnte in den Analytics seiner Wissensdatenbank keinen Bericht zu erfolglosen Suchen finden. Bei Freshdesk heißt dieses Signal also, eigene Analytics ins Help Center einzubauen oder sich stärker auf die anderen drei zu stützen. Mein Beitrag zu Freshdesk-Beispielen für Wissensdatenbanken behandelt, was seine Berichte tatsächlich zeigen.
2. Ticketthemen ohne Artikel
Das ist das größte Signal, und die meisten Teams überspringen es, weil es früher hieß, Tickets zu exportieren und von Hand zu taggen. Wenn dein Team schon konsequent Ticket-Tagging nutzt, kannst du es immer noch so machen: Gruppiere die Tickets des letzten Quartals nach Tag und prüfe, ob jeder Top-Tag einen Artikel hat. Tags driften aber, daher würde ich einen von Hand gebauten Tag-Bericht als Ausgangspunkt behandeln. Mein Leitfaden zum Arbeiten mit Ticket-Tags zeigt, wie du sie vorher aufräumst.
Die Helpdesks haben hier aufgeholt. Der Bericht zum Automatisierungspotenzial von Zendesk, am 30. April 2026 gestartet, liest jede Woche die gelösten Tickets der letzten 90 Tage und sortiert sie in "Covered by knowledge" und "Knowledge gaps", wobei jedes Thema mit hoher, mittlerer oder niedriger Wirkung markiert ist. Fahre über eine Lücke und klicke auf Generate article draft. Er ist in allen Suite- und Support-Tarifen enthalten, nur für Admins.
HubSpots Knowledge Base Agent, in der Beta für Service Hub Professional und Enterprise, scannt geschlossene Tickets und schlägt Entwürfe sowohl für "Create article" als auch für "Update article" vor. Er braucht mindestens fünf geschlossene Tickets und kostet 200 HubSpot Credits pro generiertem Artikel, was relevant ist, wenn Professional 3.000 Credits pro Monat enthält. Gorgias hat eine langsamere Version namens AI Library, die alle 3 bis 6 Monate auf Basis des Ticketvolumens Artikel vorschlägt, nur auf Englisch. Zohos Zia Ticket to Article macht aus 1 bis 10 Konversationen eines einzelnen Tickets einen Entwurf. Das ist Erfassung und keine Erkennung.
Was dieses Signal übersieht: Antworten, die in den Köpfen deiner erfahrenen Agenten stecken. Wenn ein erfahrener Agent dieselbe knifflige Frage zweimal pro Woche aus dem Gedächtnis löst, sehen die Tickets gelöst aus, und das Thema kann "abgedeckt" wirken. Ein Support-Leiter bei einem IT-Dienstleister im öffentlichen Sektor erzählte dem eesel-Team, dass sie in diesem Jahr zwei Senior-Agenten verlieren würden und dieses Wissen aufschreiben wollten, bevor sie gingen. Kein Ticketbericht hätte das markiert. Mehr zu diesem Problem habe ich in Wissenstransfer im Offshore-Support geschrieben.
3. Fragen, die dein KI-Agent nicht beantworten konnte
Wenn ein KI-Agent einen Teil deiner Warteschlange beantwortet, ist das das präziseste Signal, das du hast. Eine Kundensuche verrät dir, welche Wörter getippt wurden. Ein Ticket-Tag verrät dir ein Thema. Ein KI-Agent, der es versucht hat und gescheitert ist, verrät dir die genaue Frage, die Dokumente, die er durchsucht hat, und dass keines davon die Antwort enthielt.
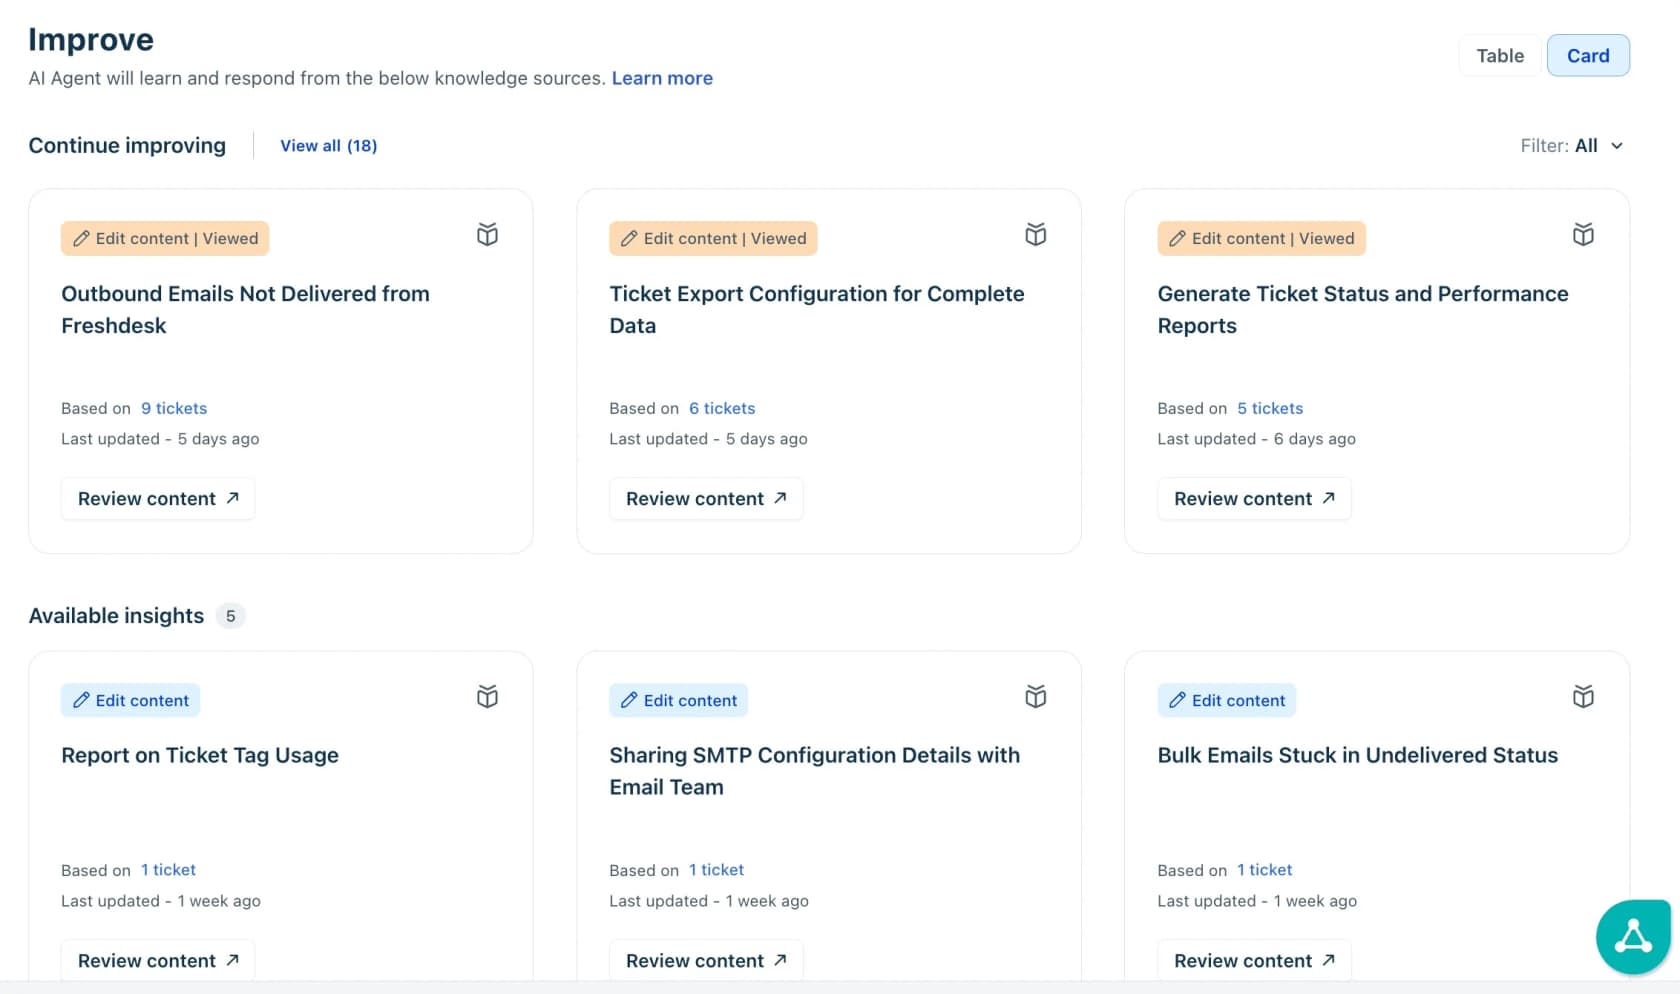
Der Tab Improve in Freshdesks AI Agent Studio ist ein gutes Beispiel. Laut seinem Hilfeartikel erzeugt er zwei Arten von Erkenntnissen aus Konversationen, die die KI nicht gelöst hat: "New content", wenn kein Artikel das Thema abdeckt, und "Edit content", wenn einer existiert, aber veraltet oder irreführend ist. Jede Karte zeigt, auf wie vielen Tickets sie beruht, sodass du zuerst die größten abarbeiten kannst. Freshdesk bot Improve allen Kunden bis zum 30. September 2026 an. Auf der Preisseite steht es jetzt unter Freddy AI Agent, mit den ersten 500 Sitzungen inklusive und danach 49 $ pro 100.
Die anderen:
- Gorgias Opportunities (Beta, alle Tarife mit AI Agent) meldet "Fill knowledge gap", wenn AI Agent ein Thema immer wieder abgibt, mit der Ticketanzahl und einem CSV-Export der zugehörigen Tickets.
- Der HubSpot Customer Agent listet "Coaching opportunities" mit dem Grund Knowledge und Typen wie "Knowledge gap" und "Knowledge conflict", laut seinem Leistungsleitfaden.
- Zoho Desks Support-Specialist-Agent hinterlässt einen privaten Kommentar, "Stepped away from ticket due to lack of available help article", wenn er keinen findet, laut Zohos Seite zu Digital Agents. Es gibt dazu keinen Bericht, aber du kannst Tickets nach genau dieser Phrase durchsuchen.
- Help Scout hat keinen Lückenbericht für AI Answers. Seine Best-Practices-Seite verweist dich auf den Tab Beacon Sessions und die Insights-Aufteilung in "Contact helped" und "Contact not helped", die du von Hand prüfst.
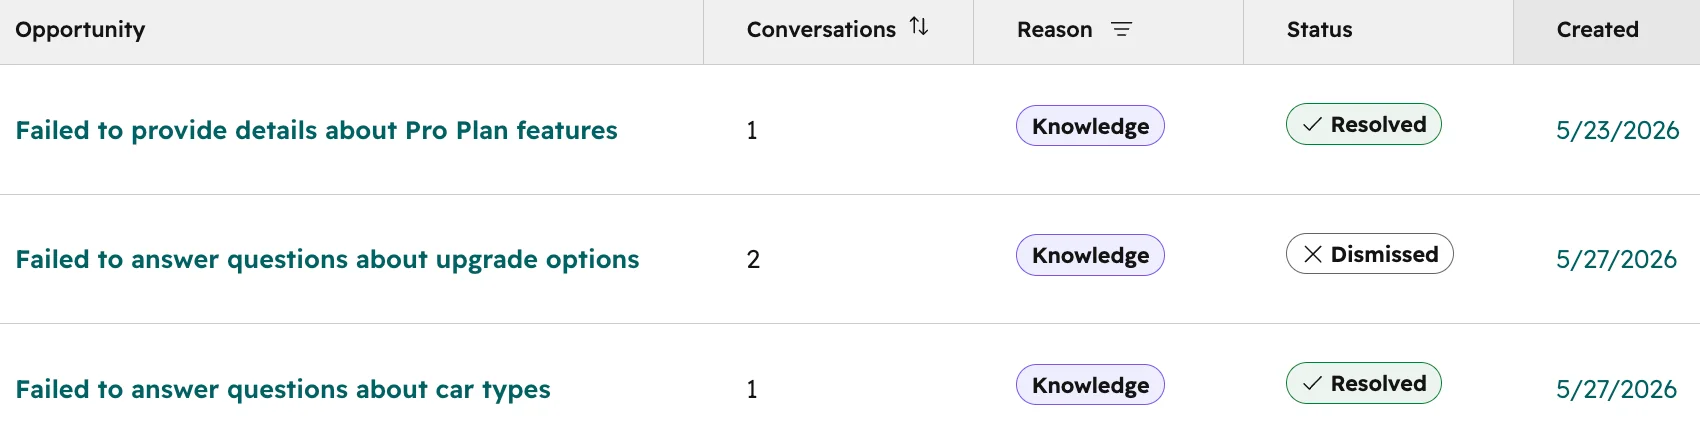
Was dieses Signal übersieht: selbstsichere falsche Antworten. Ein KI-Agent markiert nur dann eine Lücke, wenn er weiß, dass er etwas nicht weiß. Ist ein Artikel vage, kann er trotzdem antworten. Ein Fahrzeug-Telematik-Team auf Zendesk sorgte sich genau darum: Ihr Help Center behauptete, "alle Modelle" zu unterstützen, also würde ein Bot gern Automodelle bestätigen, die sie nicht unterstützten. Das ist eine veraltete oder falsche Lücke, und du fängst sie mit Signal vier oder einer Simulation anhand vergangener Tickets ab, nicht mit einer Zahl für "unbeantwortet". Die allgemeinere Version dieses Risikos ist die KI-Halluzination.
4. Agenten-Flags für falsche oder veraltete Artikel
Deine Agenten lesen den ganzen Tag Help-Center-Artikel und wissen, welche falsch sind. Der Trick ist, es ihnen mit einem Klick möglich zu machen, das zu sagen. In Zendesk können Agenten das Knowledge-Panel in einem Ticket öffnen, einen Absatz markieren und Feedback hinzufügen. Das erzeugt ein Ticket mit dem Artikellink und dem Quellticket, laut seinem Leitfaden zum Markieren von Artikeln. Dafür braucht es Suite Growth oder höher. Fronts AI-Replies-Hub zeigt die Quellen hinter jeder KI-Antwort, mit Inline-Aktionen, um veraltete oder falsche Inhalte Antwort für Antwort zu beheben.
Wenn dein Helpdesk keines von beiden hat, funktioniert ein gemeinsamer Slack-Kanal oder ein Ticket-Tag "KB fix" genauso gut. Das Format ist weniger wichtig als die Gewohnheit. Die Schwäche dieses Signals ist, dass Agenten Artikel nicht mehr bemerken, um die sie gelernt haben herumzuarbeiten. Deshalb sind neue Mitarbeitende deine besten Melder. Mein Leitfaden zum Onboarding von Support-Agenten schlägt vor, "drei Artikel markieren" zum Teil der ersten Woche zu machen.
Wo jedes Helpdesk Wissenslücken zeigt
Hier der direkte Vergleich. Tarifpreise gelten pro Agent oder Seat und Monat bei jährlicher Abrechnung, laut Preisseite des jeweiligen Anbieters.
| Helpdesk | Erfolglose Suchen | Ticketthemen ohne Artikel | KI "konnte nicht antworten" | Entwirft den fehlenden Artikel? | Einstiegspreis für die Lückenfunktionen |
|---|---|---|---|---|---|
| Zendesk | Search-Dashboard, 390 Tage | Automation potential, Tab Knowledge gaps (90 Tage) | AI-Agent-Reporting (Tab Unresolved) | Ja, Generate article draft | Alle Suite- und Support-Tarife; Suite Team 55 $ |
| Freshdesk | Keine | Nur über AI Agent | Tab Improve (New content, Edit content) und Tab Test Unanswered | Ja, Entwurf pro Erkenntnis vorgeschlagen | Growth 19 $ plus AI-Agent-Sitzungen |
| Gorgias | Help-Center-Bericht, No-result searches | AI Library, alle 3 bis 6 Monate | Opportunities, Fill knowledge gap | AI-Library-Entwürfe (nur Englisch) | Alle Tarife; KI ab 0,85 $ pro automatisierter Interaktion |
| HubSpot Service Hub | Search terms with no results | Knowledge Base Agent (Beta) | Coaching opportunities, Typ Knowledge gap | Ja, 200 Credits pro Artikel | Professional 90 $ |
| Help Scout | Docs-Bericht, Failed searches | Keine | Manuelle Prüfung der Beacon Sessions | Nein | Standard 25 $; AI Answers 0,75 $ pro Lösung |
| Zoho Desk | KB-Dashboard, Failed keywords | Zia Ticket to Article (ein Ticket nach dem anderen) | Privater Kommentar "Stepped away", kein Bericht | Entwürfe für einzelne Tickets | Standard 14 $ |
| Front | Detail der Suchbegriffe (kein Label für erfolglos) | Keine gefunden | AI-Replies-Hub, eine Antwort nach der anderen | Nein | Professional 65 $ |
Zwei Dinge fallen auf. Erstens ist die Spalte mit den KI-Flags neu: Fast alles davon kam 2026 heraus. Wenn du die Berichte deines Helpdesks zuletzt vor einem Jahr angesehen hast, schau noch einmal hin. Zendesks altes Feature Content Cues, das Artikel vorschlug, wurde am 1. Mai 2025 entfernt, und der Bericht zum Automatisierungspotenzial ist sein Ersatz. Zweitens folgen die Lückenfunktionen der KI. Freshdesk und Gorgias finden ticketbasierte Lücken nur über ihre KI-Agenten, ein Team ohne einen solchen bekommt also deutlich weniger.
Zendesk hat außerdem einen Knowledge Copilot im Early Access für Suite Professional und höher, mit Scores für Coverage, Freshness und AI readability. Die Freshness sinkt bei Artikeln, die sechs Monate nicht aktualisiert wurden, was ein praktischer eingebauter Check für veraltete Inhalte ist. Wenn du speziell auf Zendesk bist, gehen meine Beiträge zur Zendesk-Wissenslücken-Analyse und zum Finden fehlender Zendesk-Artikel tiefer in die Details.
So führst du eine Wissenslücken-Analyse im Support an einem Nachmittag durch
Das ist die Version, die ich mit einem Team von fünf bis fünfzig Agenten durchführen würde. Beim ersten Mal dauert sie etwa drei Stunden, danach jeden Monat unter einer Stunde.
Schritt 1: 90 Tage aller vier Signale ziehen
Neunzig Tage sind lang genug, um eine schlechte Woche auszugleichen, und kurz genug, dass sich die Antworten nicht geändert haben. Exportiere erfolglose Suchen, deine Top 30 Ticket-Tags oder -Themen, die Lücken- oder Unanswered-Liste des KI-Agenten und alle Agenten-Flags. Packe sie in eine Tabelle mit einer Spalte für die Quelle.
Schritt 2: Nach Thema gruppieren, nicht nach Wortlaut
"Abo kündigen", "meinen Tarif beenden" und "wie steige ich aus" sind eine Lücke. Gruppiere die Zeilen zu Themen und addiere die Zahlen über alle Quellen. Ein Thema, das in drei der vier Signale auftaucht, ist echt. Ein Thema, das nur als zwei erfolglose Suchen nach "bitcoin" auftaucht, wahrscheinlich nicht. Bei Hunderten Zeilen eignet sich ein LLM gut für diesen Clustering-Schritt, solange du seine Gruppierungen prüfst.
Schritt 3: Nach Volumen und nach Festigkeit der Antwort sortieren
Hier laufen die meisten Lückenlisten schief. Teams sortieren nur nach Volumen und schreiben dann einen Artikel zu "Wo ist meine Bestellung", den kein Artikel beantworten kann, weil die Antwort für jeden Kunden anders ist.
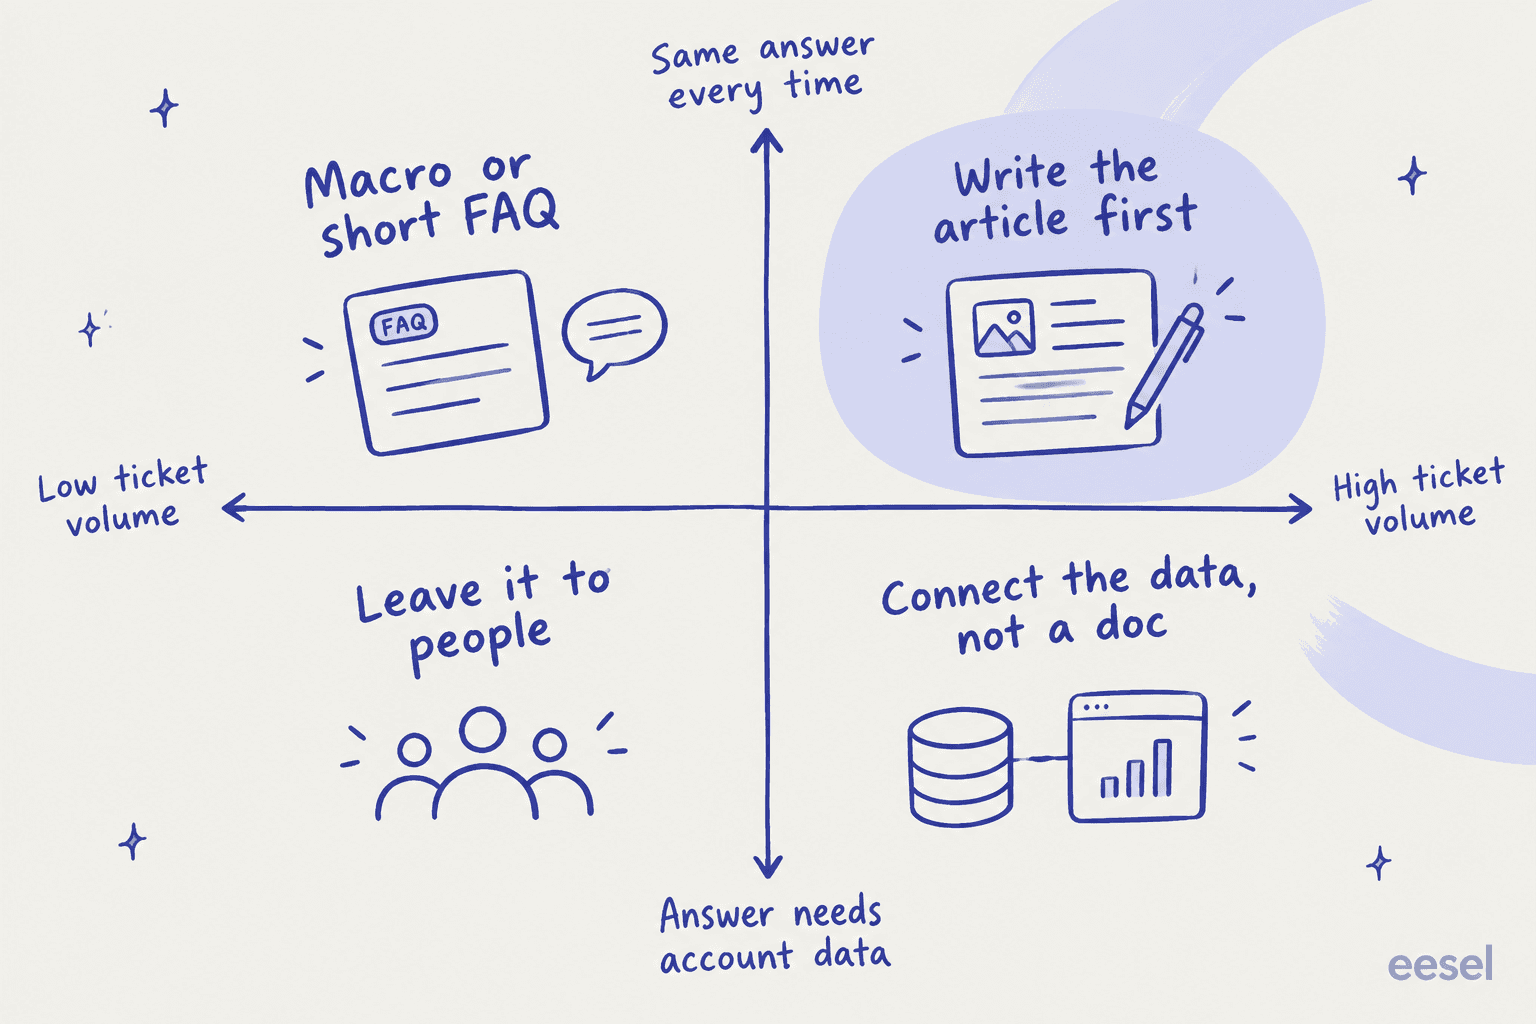
- Hohes Volumen, immer dieselbe Antwort: Schreibe den Artikel zuerst. Erstattungsfristen, Tariflimits, Einrichtungsschritte. Ein Artikel kann hier pro Quartal Hunderte Tickets schließen.
- Hohes Volumen, braucht Kontodaten: Schreibe kein Dokument. Bestellstatus, Abrechnungsdaten und Kontoänderungen brauchen eine Datenanbindung oder eine Aktion, keinen Artikel. Gorgias' eigener Leitfaden zur Optimierung von Wissen macht dieselbe Unterscheidung: ein Skill, wenn Kunden den Agenten bitten, etwas zu tun, ein Artikel, wenn sie nach Informationen fragen.
- Niedriges Volumen, dieselbe Antwort: Ein Makro oder ein kurzer FAQ-Eintrag reicht. Mein Leitfaden zum Erstellen von Makros aus vergangenen Tickets behandelt das.
- Niedriges Volumen, fallspezifisch: Überlasse es den Menschen. Nicht jedes Ticket sollte zu Content werden.
Schritt 4: Für die fragende Person schreiben
Öffne vor dem Schreiben fünf echte Tickets zum Thema und lies, wie Kunden es formulieren. Nutze ihre Wörter im Titel. Prüfe dann, wer fragt: der Fahrgast oder der Admin, der Endnutzer oder der Kontoinhaber. Das Bus-Tracking-Team oben brauchte nicht mehr Artikel. Es brauchte dieselben Antworten, für eine andere Zielgruppe umgeschrieben.
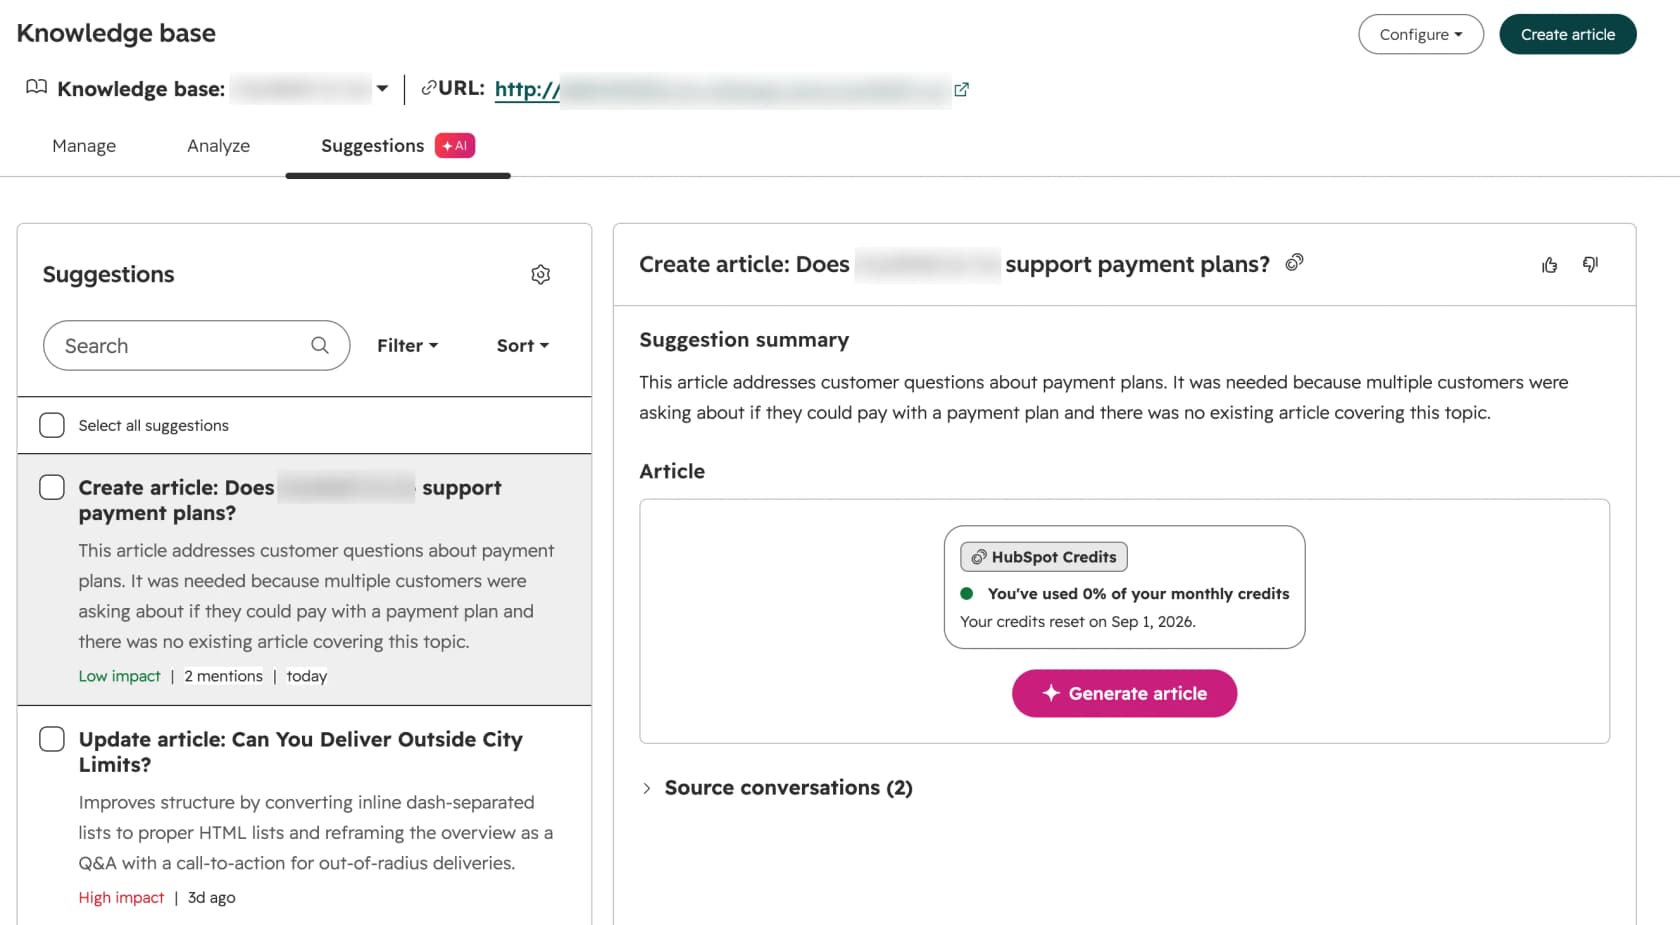
HubSpots Knowledge Base Agent macht eine Version davon automatisch und hängt die "Source conversations" hinter jedem Vorschlag an. Egal welches Tool den Artikel entwirft: Halte die Quelltickets beim Bearbeiten neben dem Entwurf bereit.
Schritt 5: Veraltete und widersprüchliche Artikel im selben Durchgang beheben
Neue Artikel bekommen die Aufmerksamkeit, aber ein falscher Artikel richtet mehr Schaden an als ein fehlender, besonders sobald ihn ein KI-Agent liest. Nimm dir, solange du in der Tabelle bist, jeden Eintrag "Edit content" oder "knowledge conflict" vor und behebe oder lösche die alte Version. Wenn zwei Artikel dieselbe Frage beantworten, führe sie zusammen. Mein Leitfaden zum Erkennen veralteter Help-Center-Inhalte hat dafür eine Checkliste.
Schritt 6: Dieselben Themen nach 30 Tagen erneut prüfen
Schließe den Kreis. Prüfe einen Monat nach der Veröffentlichung, ob die Ticketzahl des Themas, die erfolglosen Suchen oder die KI-Lücken-Flags gesunken sind. Wenn nicht, existiert der Artikel, wird aber nicht gefunden oder beantwortet die eigentliche Frage nicht. Zendesks Bericht aktualisiert sich wöchentlich, und Gorgias-Opportunities aktualisieren sich nicht, wenn du Wissen änderst. Vergleiche also frische Daten, statt darauf zu warten, dass sich ein alter Eintrag von selbst erledigt.
Ein gutes Erfolgsmaß hier ist deine Deflection-Rate bei diesem Thema oder die Lösungsrate der KI dafür. Mein Leitfaden zur Ticket-Deflection behandelt, wie du sie misst, ohne dich selbst zu täuschen.
Was Support-Teams über das Finden von Lücken sagen
Die Low-Tech-Version dieser Analyse ist immer noch eine der besten, die ich gesehen habe. Ein IT-Manager auf Reddit fügte jedem geschlossenen Ticket ein Pflichtfeld hinzu und machte daraus einen wöchentlichen Lückenbericht:
"I have two fields in my ticket resolutions that I draw from: Self Service Possible? Drop down menu with three options. Mandatory. Yes - KB Exists Yes - KB Needed No ... I run a report every Friday for any tickets that have either of the "Yes" answers selected and use that list to either make documentation tickets or notify Line Managers that their staff are raising tickets for well documented issues. Takes me about 15 minutes all in."

Dieses Feld erfasst Signal zwei und Signal vier mit einem Klick und funktioniert in jedem Helpdesk, das benutzerdefinierte Ticketfelder unterstützt. Dass Suchanalysen nicht reichen, ist älter als die meisten heutigen Tools. Jemand, der am Help Center von Dropbox arbeitete, sagte es 2011 auf Hacker News:
"Improving it is a bit more complicated than just getting analytics around how many hits on /help end up searching, reading help articles, and maybe filing tickets. There is a lot more needed to understand which areas of the help center aren't getting enough prominence, which topics are just missing..."

Manche Teams haben die KI-Version schon selbst gebaut. Ein Zendesk-Admin baute eine Automatisierung, die jedes neue Ticket aus der Wissensdatenbank zu beantworten versucht und, wenn das nicht klappt, den fehlenden Artikel entwirft:
"If it can't it drafts me an article that would cover it, as well as tells me why."
Und die veraltete Seite des Problems ist meist die schwierigere. Ein Team auf r/startups beschrieb, wie sein Help Center über iOS, Android und Web hinweg ins Hintertreffen geriet:
"I feel that a big part of the challenge is to track which legacy articles are broken by a new feature."
Das spricht dafür, nach jedem Release einen kurzen Lückencheck zu machen und nicht nur einmal im Quartal.
Fehler, die eine Wissenslücken-Analyse entwerten
- Erfolglose Suchen als gesamte Liste behandeln. Sie zählen Suchende, nicht Kunden. Kombiniere sie immer mit einem ticketbasierten Signal.
- Artikel für kontospezifische Fragen schreiben. "Wo ist meine Bestellung" braucht eine Abfrage, keine Seite. Als Artikel geschrieben, entsteht nur eine weitere Seite, auf der "Kontaktiere uns" steht.
- Nur hinzufügen, nie beheben. Ein veralteter Artikel, den ein KI-Agent selbstsicher zitiert, ist schlimmer als gar kein Artikel. Behebe Widersprüche im selben Durchgang.
- KI-Entwürfe ungelesen veröffentlichen. Jedes Tool in der Tabelle oben speichert Entwürfe, und keines kennt deine Richtlinien besser als dein Team. Lies jeden Entwurf gegen seine Quelltickets, bevor er live geht.
- Es nur einmal durchführen. Lücken öffnen sich jedes Mal neu, wenn sich Preise, Richtlinien oder das Produkt ändern. Ein monatlicher Check der zehn wichtigsten Themen fängt sie früh ab.
- Das Wissen außerhalb des Help Centers ignorieren. Antworten in Confluence, Google Docs, Slack-Threads und alten Makros zählen auch als Wissen. Wenn deine KI oder deine Agenten sie nicht erreichen, sind sie für den Kunden eine Lücke. Mein Leitfaden zu KI-Wissensmanagement für Support-Teams behandelt, wie du sie anbindest.
eesel für die Wissenslücken-Analyse im Support
Wenn die Lückenliste sich von selbst aufbauen soll, ist der einfachste Weg, ein KI-Teammitglied die Warteschlange bearbeiten zu lassen und dir sagen zu lassen, wo es hängen blieb. Das KI-Helpdesk-Teammitglied von eesel arbeitet in Zendesk, Freshdesk, Gorgias, Front, Help Scout und den übrigen Systemen, lernt aus deinem Help Center, deinen Makros, vergangenen Tickets und Dokumenten in Confluence, Notion oder Google Drive und entwirft oder sendet Antworten. Jede Aufgabe, die es nicht aus deinen Dokumenten beantworten kann, wird als Wissenslücke protokolliert.
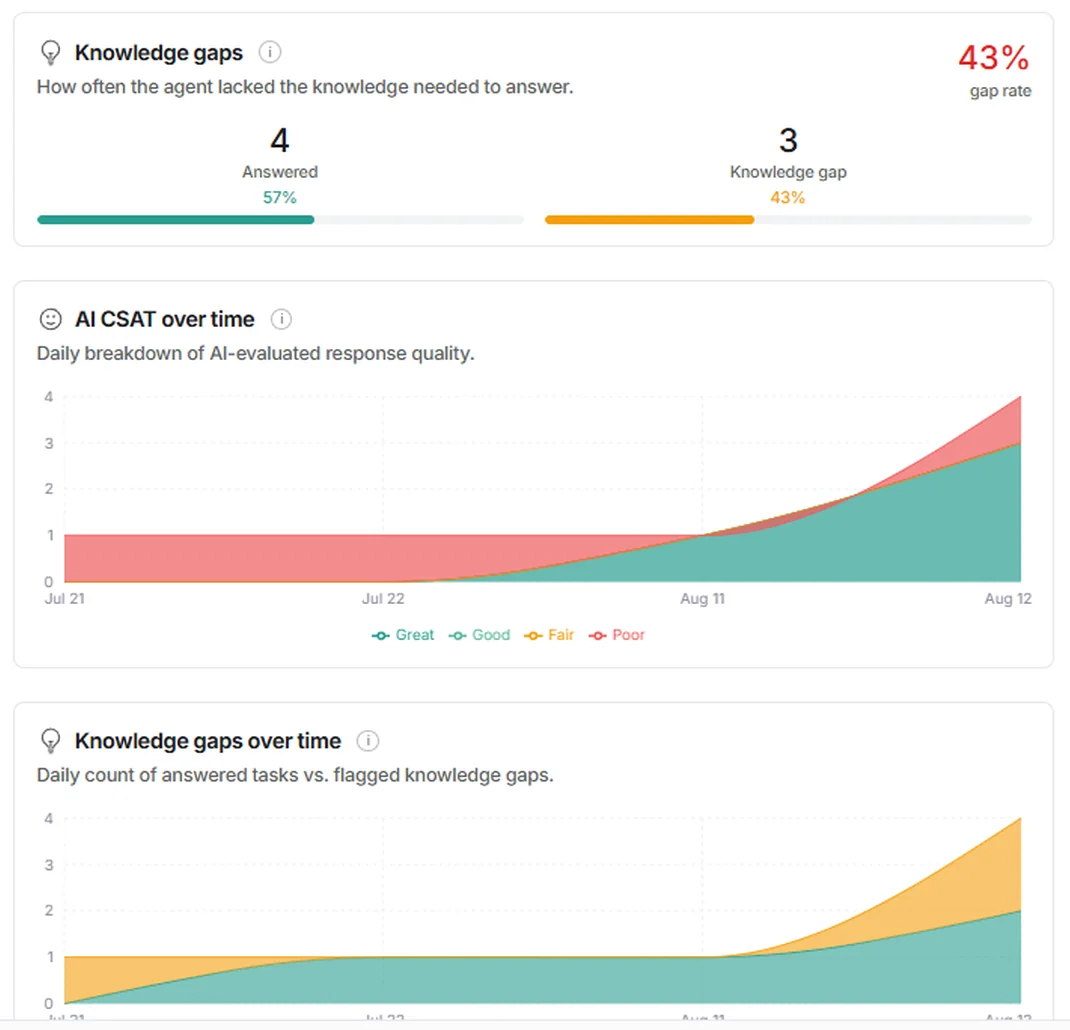
Die Reports-Seite zeigt, wie oft dem Agenten das Wissen zum Antworten fehlte und wie sich das Tag für Tag verändert. Die Docs sagen es einfach: "A knowledge gap is your agent telling you something is missing from your documentation." Öffne eine beliebige Aufgabe auf der Activity-Seite, und du siehst, was sie durchsucht hat, was sie gefunden hat und ob sie auf eine Lücke gestoßen ist. So kannst du eine falsche Antwort zu dem Dokument zurückverfolgen, das sie verursacht hat.
Von dort aus findet der Skill Update knowledge base (auf der Skills-Seite als KB Auto-updater aufgeführt) die Fragen, die dein Help Center nicht beantwortet, und entwirft die fehlenden Artikel, die dein Team prüft. Er wird pro Workspace eingeschaltet. Steht auf der Kachel "Contact us", schaltet das eesel-Team ihn für dich frei. Du kannst außerdem vor dem Livegang eine Simulation über deine vergangenen Tickets laufen lassen. Sie bewertet jede Antwort gegen das, was dein Team tatsächlich gesendet hat, und listet die Lücken nach Ticketthema auf.

Ein B2B-SaaS-Team auf Front mit etwa 200 bis 300 Tickets im Monat auf Englisch und Französisch bat eesel um genau diese Kombination: Antworten aus ihrem Benutzerhandbuch, Slack, ihrer internen Wissensdatenbank und vergangenen Tickets, dazu Lückenerkennung und entworfene Artikel für alles, was fehlte. Damit klar ist, wo die Grenze liegt: eesel ist kein Editor für Help Centers und kein Tool für Suchanalysen, behalte also den Bericht zu erfolglosen Suchen deines Helpdesks für Signal eins. Was eesel hinzufügt, ist Signal drei, bei jedem Ticket, ohne dass jemand etwas taggen muss. Die Tarife beginnen bei 299 $ im Monat für 500 Credits auf der Preisseite, und du kannst eesel kostenlos mit 100 Credits an deinen eigenen Tickets ausprobieren.