

Tencent Hunyuan Hy4 (die „Hy4 preview“) ist ein großes Open-Weight-Modell, das dafür gebaut wurde, Arbeit zu erledigen, nicht zum Chatten. Es ist ein Mixture-of-Experts-Modell mit 770B Parametern, 49B aktiv pro Token, 1M-Token-Kontext und Apache-2.0-Lizenz, veröffentlicht am 28. August 2026 für Coding, Büroproduktivität, Spieleentwicklung und wissenschaftliche Forschung.
Zu den Zahlen: Tencents eigener Blindtest sieht es knapp vor Kimi K3 und GLM-5.3, aber bei öffentlichen Benchmarks wechseln sich die Siege mit diesen beiden ab, und meist liegt es hinter Claude Opus 5 und GPT-5.6. Das ehrliche Fazit lautet „etwa gleichauf mit den anderen chinesischen Flaggschiffen“, mit zwei echten Vorteilen: Es ist das günstigste der offenen Flaggschiff-Modelle mit 0,834 $ Input / 2,501 $ Output pro Million Tokens, und die Gewichte sind wirklich offen.
Der Haken, der jede Diskussion dominiert: Es ist zu groß, um lokal zu laufen. Allein die Gewichte brauchen selbst quantisiert etwa 924 GB, es ist also ein Rechenzentrums- oder API-Modell, kein Laptop-Modell. Und weil es ein reines Modell ist, begegnen die meisten Teams Hy4 über die API oder ein darauf aufbauendes Produkt, nicht über den Download. Wenn Sie eigentlich eine KI wollen, die einen bestimmten Job von Anfang bis Ende erledigt, passt ein einsatzbereiter Teamkollege wie eesel besser als jedes Basismodell, Hy4 eingeschlossen.
Was Tencent Hy4 eigentlich ist
Tencent hat Hy4 preview am 28. August 2026 veröffentlicht und als Open Source freigegeben und nennt es ein Modell „built for real-world productivity tasks, delivering outstanding performance across coding, office work, and scientific research.“ Es ist das neueste Modell von Tencents Hunyuan-Team und folgt auf die Hy3-Reihe, und es kam am ersten Tag mit offenen Gewichten.
Die Positionierung ist wichtig. Es wird nicht als freundlicher Assistent verkauft, der mit einem allgemeinen KI-Chatbot konkurriert. Tencent hat es gemeinsam mit den eigenen Produkten CodeBuddy und WorkBuddy entworfen und mit Arbeitsdaten von Softwareentwicklern, Spieleentwicklern, Finanzanalysten und Sicherheitsexperten trainiert. Zu den Kernfähigkeiten zählen Dinge wie Debugging über lange Zeithorizonte, das Umwandeln unordentlichen Multi-Datei-Kontexts in Dokumente und Tabellen, das Erzeugen eines spielbaren Spielprototyps aus einem einzigen Prompt und das Schlussfolgern bei Forschungsproblemen in Molekulardynamik oder reiner Mathematik.
Die wichtigsten Spezifikationen laut Hugging-Face-Modellkarte:
| Eigenschaft | Wert |
|---|---|
| Architektur | Mixture-of-Experts (MoE) |
| Gesamtparameter | 770B |
| Aktive Parameter pro Token | 49B |
| Schichten | 78 (1 dicht + 77 MoE) |
| Geroutete / geteilte Experten | 256 geroutet + 1 geteilt, Top-8 aktiviert |
| Kontextlänge | 1M Tokens |
| Attention | Gated DeepSeek Sparse Attention (Gated DSA) |
| Lizenz | Apache 2.0 |
| Varianten | BF16 Instruct + offizieller FP8-Build |
Ein ehrliches Signal: Tencent nennt das Modell eine „Preview“ und listet offen seine Schwächen auf. Die Modellkarte räumt ein, dass Hy4 bei komplexen Aufgaben länger als nötig nachdenkt und „a tendency to over-verify its own work“ hat. Dieser Ansatz, früh zu veröffentlichen und zu iterieren, hat auch Hy3 zwischen Preview und finalem Build deutlich stärker gemacht.
Wie das Mixture-of-Experts-Design funktioniert
Die beiden Zahlen, auf die sich alle fixieren, 770B und 49B, beschreiben den Kerntrick eines Mixture-of-Experts-Modells. Es lohnt sich, ihn zu verstehen, denn er erklärt, warum Hy4 schnell ist und zugleich ein Albtraum im Betrieb.
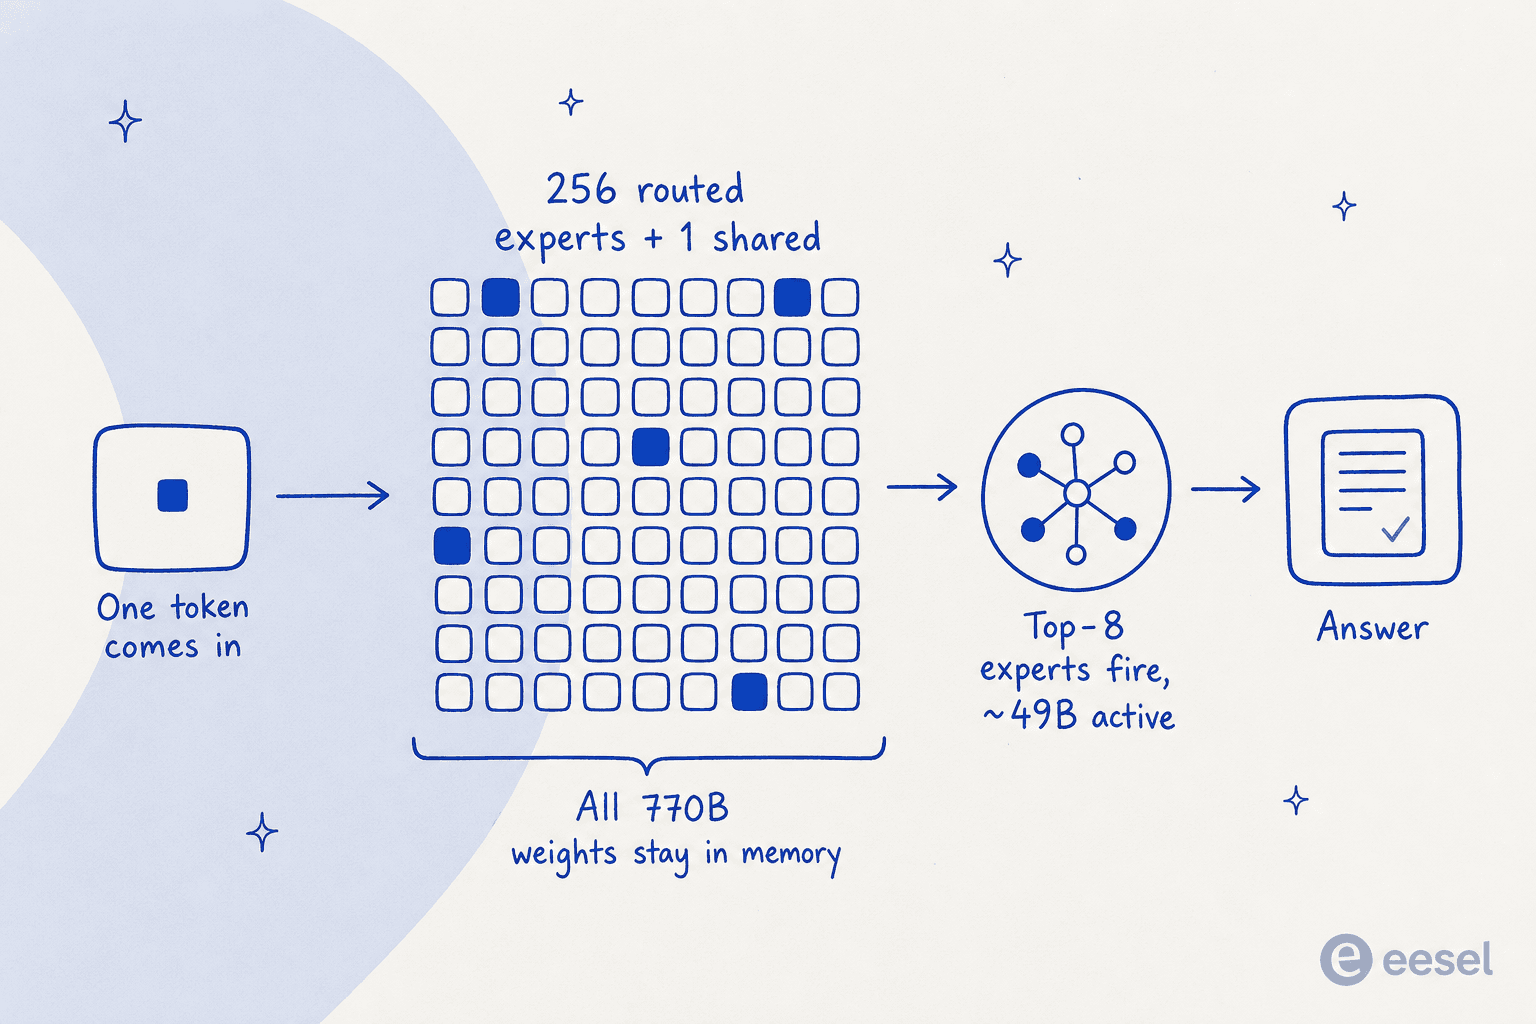
Das Rückgrat besteht aus 78 Schichten. Die erste ist eine normale dichte Schicht; die anderen 77 enthalten jeweils 256 geroutete Experten plus 1 geteilten Experten. Kommt ein Token herein, wählt ein Router die 8 relevantesten Experten aus, und nur diese (plus der geteilte) rechnen tatsächlich. Obwohl das Modell 770B Parameter hat, feuern also etwa 49B pro Token. Das hält den Inferenzdurchsatz tragfähig: Sie zahlen nicht bei jedem Token die Rechenkosten eines dichten 770B-Modells.
Unter der Haube hat Tencent Ideen von DeepSeek und GLM übernommen: Die Attention nutzt Gated Sparse Attention mit wiederverwendbarem Index-Cache, und eine native Multi-Token-Prediction-Schicht ermöglicht spekulatives Decoding, das die Generierung bei kleinen Batch-Größen beschleunigt. Wichtig ist der Haken im nächsten Abschnitt: MoE spart Rechenleistung, nicht Speicher. Alle 770B Gewichte müssen gleichzeitig im GPU-Speicher liegen.
Die Benchmarks, ehrlich gelesen
Tencents Launch-Material behauptet „schlägt GLM-5.3 und Kimi K3“. Das stimmt technisch, ist aber weit weicher, als es klingt. Die Aussage stammt aus einer internen Blindbewertung: 163 hauseigene Experten bewerteten Modellausgaben bei 203 Engineering-Aufgaben, jeweils mit einer Note von maximal 4,00.
| Modell | Blindbewertung, Durchschnitt (/4,00) | Paarweises Ergebnis von Hy4 |
|---|---|---|
| Hy4 preview | 2,99 | - |
| Kimi K3 (Moonshot) | 2,94 | Hy4 gewinnt 51,2 % / Unentschieden 7,9 % / verliert 40,9 % |
| GLM-5.3 (Z.AI) | 2,92 | Hy4 gewinnt 46,8 % / Unentschieden 12,8 % / verliert 40,4 % |
Ein Abstand von 0,05 Punkten auf der vierstufigen Skala eines Herstellers ist statistisch ein Achselzucken. Tencent selbst weist darauf hin, dass die Bewertung "bounded by its tasks, model versions, raters, and procedure... not an independent public benchmark" ist. Gegen GLM-5.3 übertreffen Hy4s Siege seine Niederlagen nur mit 47 zu 40. Das ist ein Beinahe-Unentschieden im Gewand einer Führung.
Das Diagramm mit den öffentlichen Benchmarks erzählt die ganze Geschichte, und das ist die ehrliche Sicht:
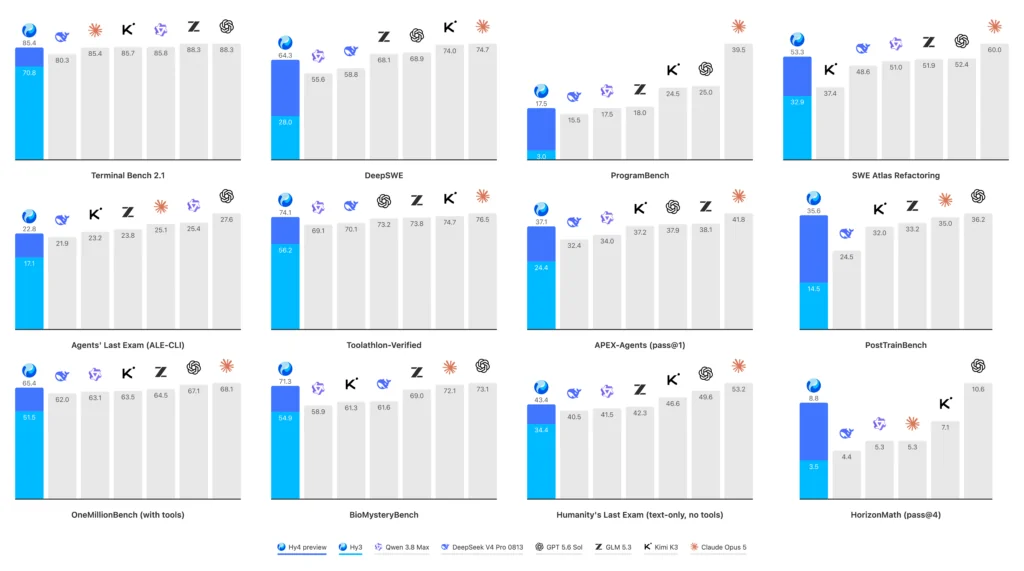
Hy4 erzielt einige starke Werte: 92,3 bei GPQA Diamond, 85,4 bei Terminal Bench, 82,9 bei SWE-bench Multilingual, und es führt das offene Feld bei HorizonMath und BioMysteryBench an. Aber über die zwölf Felder hinweg steht meist Claude Opus 5 oder GPT-5.6 an der Spitze, und Hy4 liegt im Mittelfeld neben Kimi K3, GLM-5.3 und Qwen 3.8 Max. Die Community hat die Darstellung schnell durchschaut:
Why do they always highlight benchmarks where it scored less than other models the same as the ones where it scored better? It's so misleading. I can't even tell which benchmarks it actually beat other models.

Zur unabhängigen Einordnung: Hy4 steht noch nicht im Intelligence Index von Artificial Analysis, es gibt also keinen neutralen Gesamtwert, den man zitieren könnte (zur Einordnung: Der aktuelle Spitzenreiter dieser Rangliste, Claude Opus 5, liegt bei 63). Das einzige Drittsignal bisher kommt aus der Coding-Rangliste von LMArena:
Hy4 preview by @TencentHunyuan just landed ~#5 in the Code Arena: WebDev with 1633 pts (AutoEval)... Among open models, Hy4 preview is ~#3, compared to Hy3 at #7.
Das ist ein echter Sprung gegenüber Hy3, aber beachten Sie den Zusatz „AutoEval“: Arena sagt, dass ein Reward-Modell automatische Stimmen statt Live-Stimmen von Menschen abgegeben hat, also behandeln Sie es als vorläufig. Meine Einschätzung: Hy4 ist ein wirklich starkes offenes Modell, das in etwa auf einer Höhe mit den anderen chinesischen Flaggschiffen liegt, und das „schlägt“ ist Marketing bei einem Beinahe-Unentschieden. Wenn Sie einen genaueren Direktvergleich wollen: Der Vergleich Qwen 3.8 Max vs. Kimi K3 deckt dieselbe Klasse ab.
Kann man es überhaupt betreiben?
Diese Frage dominierte jeden Launch-Thread, und die Antwort ist ernüchternd. MoE spart Rechenleistung, aber alle 770B Gewichte müssen im GPU-Speicher liegen.
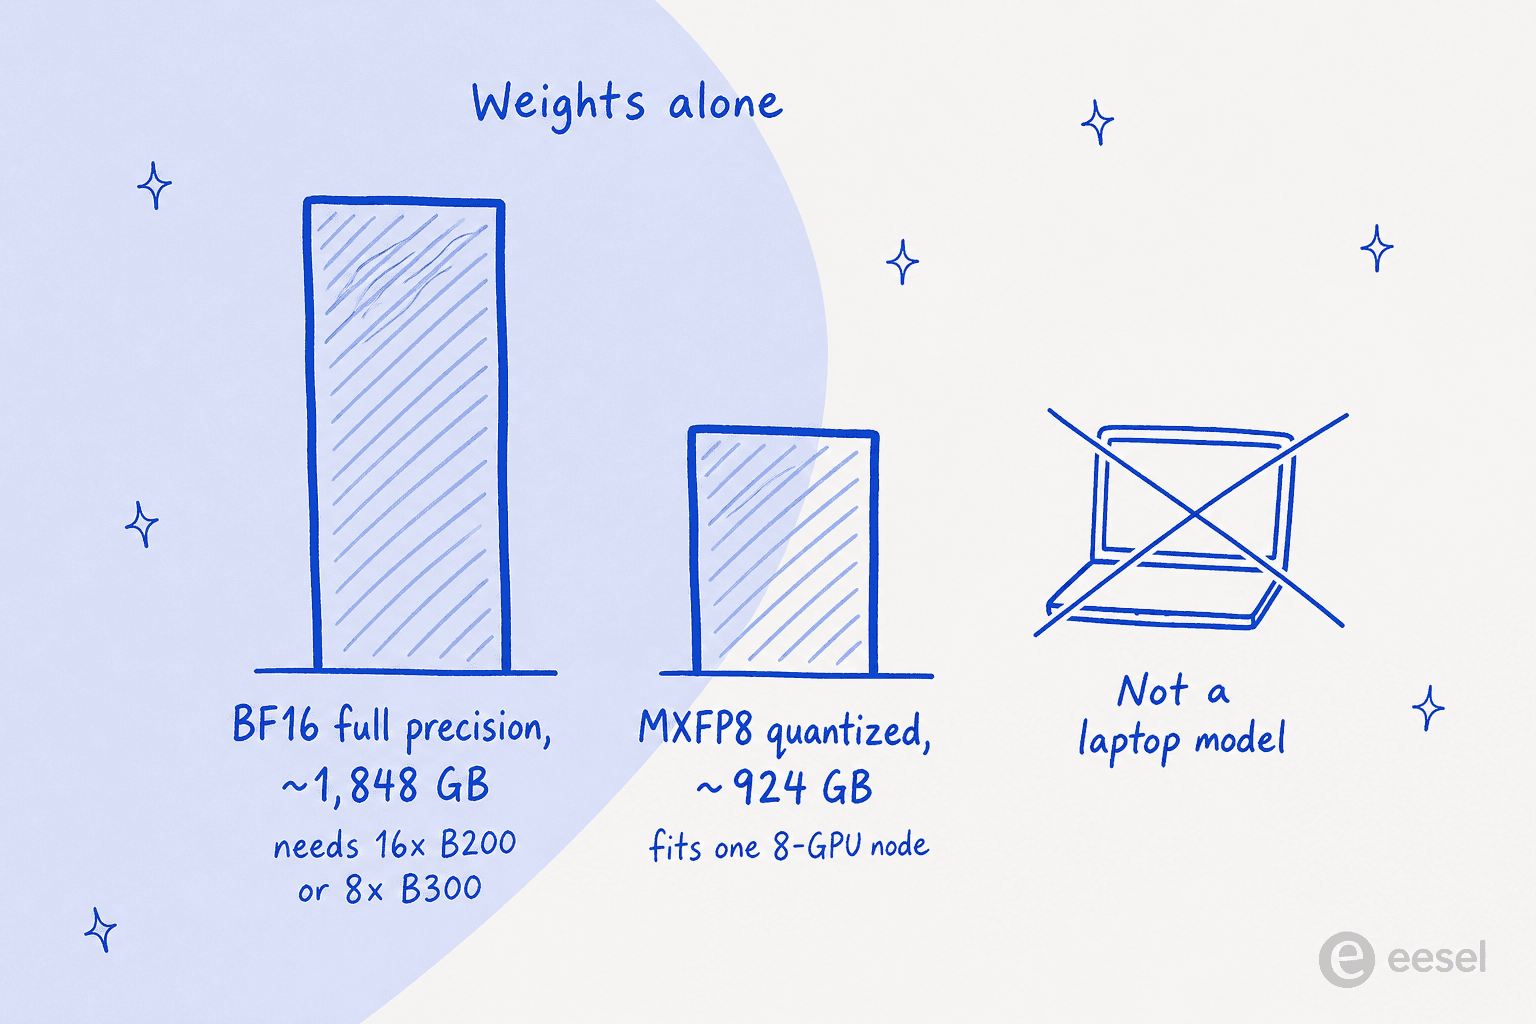
Laut dem offiziellen vLLM-Rezept kommen die vollen BF16-Gewichte auf etwa 1.848 GB. Das Fazit dort ist deutlich: Sie brauchen „16x B200 or 8x B300 minimum for weights + KV cache.“ Der quantisierte MXFP8-Build halbiert das auf etwa 924 GB, was auf einen 8-GPU-Knoten der neuesten Beschleuniger mit viel VRAM passt, und deshalb nutzt das Standard-Serving-Beispiel eine Tensor-Parallel-Größe von 8. Es gibt einen offiziellen FP8-Checkpoint und ein Quantisierungs-Toolkit namens AngelSlim, um es weiter zu verkleinern, aber nichts davon bringt es in Reichweite eines Heim-Rechners. Die r/LocalLLaMA-Community, die große Modelle als Hobby betreibt, hat größtenteils aufgegeben:
I don't know who around here runs 780b models, but I am happy for them :)
Selbst die Quantisierungsrechnung der Community ist düster: Ein Q4-Build landet bei etwa 450-512 GB, und auf einen 256-GB-Rechner passen nur 1-2-Bit-Quants. Wie ein Kommentator sagte: Wenn Sie 256 GB haben, "you'll probably be much better off with GLM-5.3-Flash Q4". Für die meisten Menschen sind „offene Gewichte“ also eine Lizenzfrage, keine praktische. Sie werden Hy4 über eine API nutzen.
Preise und Vergleich
Die API-Preise von Hy4 liegen bei 0,834 $ pro Million Input-Tokens, 2,501 $ pro Million Output-Tokens und 0,042 $ für Cache-Treffer. Unter den offenen Modellen der Flaggschiff-Klasse ist das das günstigste.
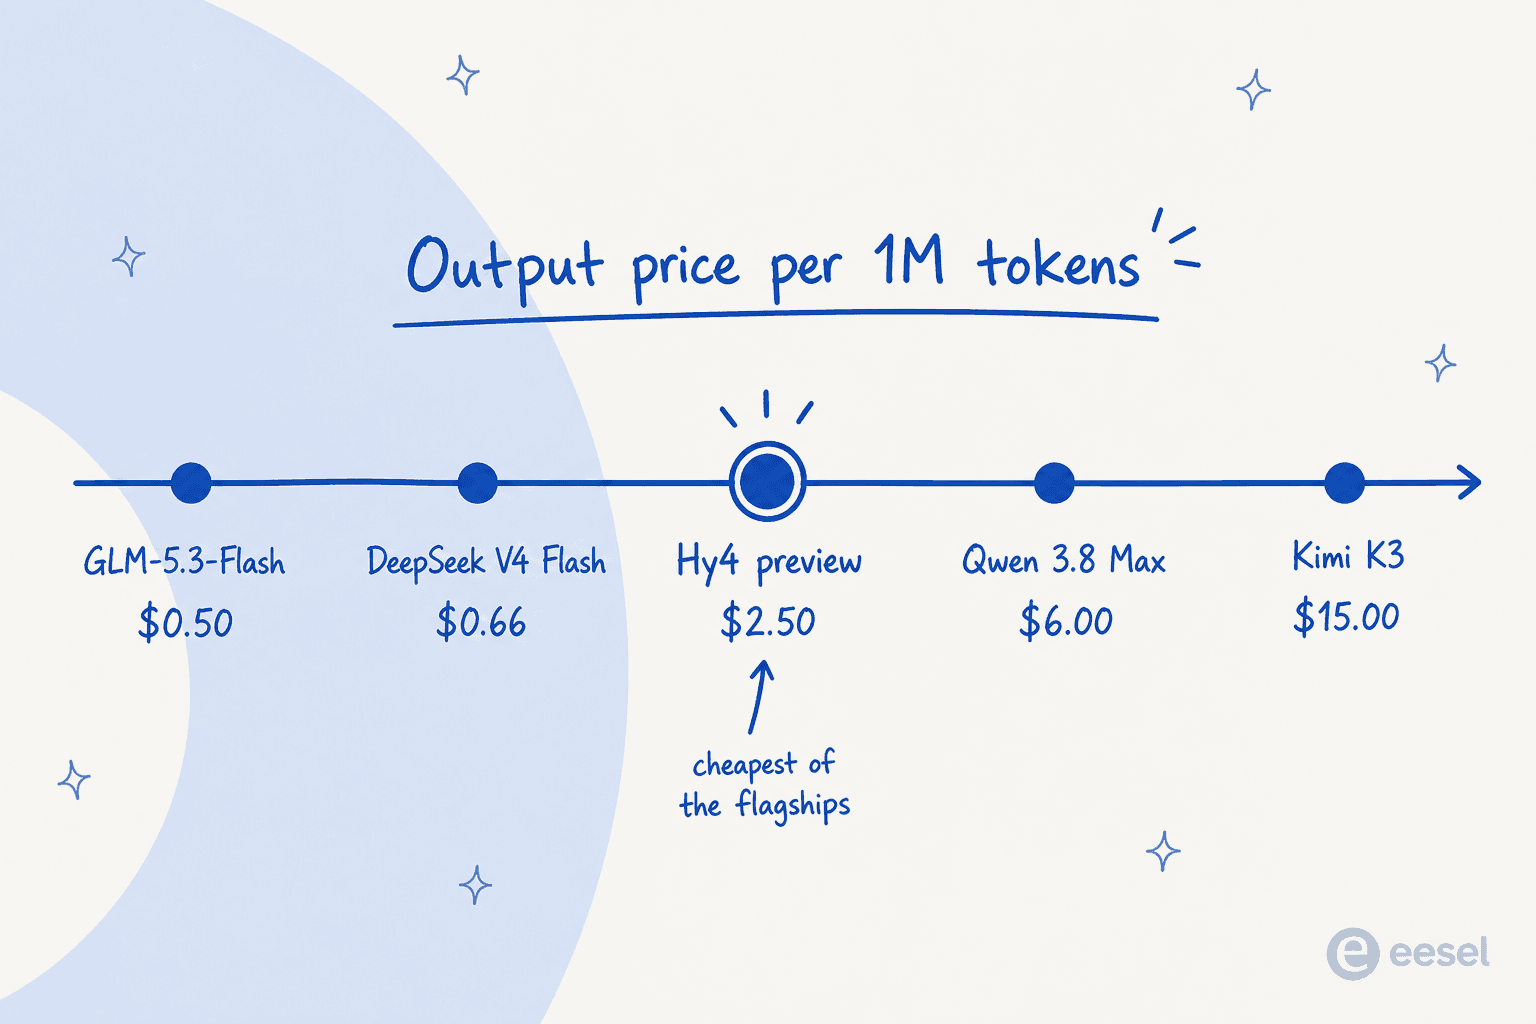
Das ganze Bild im Vergleich zum aktuellen Open-Weight-Feld (alles pro Million Tokens, geprüft am 30. August 2026):
| Modell | Input | Output | Cache-Treffer (Input) | Gewichte |
|---|---|---|---|---|
| Hy4 preview (Tencent) | 0,834 $ | 2,501 $ | 0,042 $ | Apache 2.0 |
| GLM-5.3-Flash (Z.AI) | 0,15 $ | 0,50 $ | 0,03 $ | Offen |
| DeepSeek V4 Flash | 0,22 $ / 0,44 $ | 0,66 $ / 1,32 $ | 0,007 $ | MIT |
| GLM-5.3 (Z.AI) | 1,40 $ | 4,40 $ | 0,26 $ | Offen |
| Qwen 3.8 Max | 2,00 $ | 6,00 $ | 0,25 $ | Benutzerdefiniert |
| Kimi K3 (Moonshot) | 3,00 $ | 15,00 $ | 0,30 $ | Offen |
Hy4 unterbietet also GLM-5.3, Qwen 3.8 Max und Kimi K3 deutlich (dessen Output-Preis fast 6-mal so hoch ist wie bei Hy4). Es ist aber nicht der Preisboden. DeepSeek V4 Flash und GLM-5.3-Flash sind beide weit günstiger, und DeepSeeks Off-Peak-Tarif macht es zu einem Bruchteil der Hy4-Kosten. Und es gibt einen Haken für alle, die schon Hunyuan nutzen:
But the new HY4 pricing is roughly 5-6x higher than HY3, so you're looking at about a 400-500% increase in input/output cost.
Das einzige echte Schnäppchen in der Preisliste ist das Context Caching mit 0,042 $ pro Million, das laut einem Nutzer deutlich niedriger als bei GLM-5.3 liegt. Wenn Ihre Workloads über viele Aufrufe hinweg einen großen festen Kontext erneut lesen (eine Codebasis, ein langes Dokument), wird Hy4 mit diesem Cache-Tarif interessant. Für eine ausführlichere Kostenaufschlüsselung der Nachbarn sind der DeepSeek-V4-Flash-Preisleitfaden und der Kimi-K3-Preisleitfaden gute Begleiter.
So kommen Sie heute an Hy4
Wenn Sie keinen 8-GPU-Knoten aufsetzen, hier die Wege, es tatsächlich zu nutzen:
- API: Die Modell-ID lautet
hy4-preview, bereitgestellt über Tencent Cloud TokenHub und OpenRouter. Beide APIs im OpenAI- und Anthropic-Format werden unterstützt, und OpenRouter liefert es mit einer Zero-Retention-Datenrichtlinie, ein schöner Vorteil gegenüber manchen chinesischen First-Party-APIs, deren Bedingungen zur Trainingsnutzung vage sind. - Zwei Wochen kostenlos: Hy4 ist ab Launch kostenlos in WorkBuddy und CodeBuddy, und der kostenlose Hy3-Zugang wurde in beiden bis zum 30. September verlängert. Es ist außerdem in Tencents Apps Yuanbao und ima nutzbar.
- Offene Gewichte: Verfügbar auf Hugging Face, GitHub, ModelScope und GitCode, jeweils mit BF16- und FP8-Build.
Zur Klarstellung, weil es zum Launch kursierte: Coding-CLIs von Drittanbietern haben Hy4 schnell über OpenRouter übernommen, aber das sind keine offiziellen kostenlosen Tencent-Kanäle. Die einzigen kostenlosen First-Party-Angebote sind WorkBuddy und CodeBuddy.
Der Selbstverbesserungs-Aspekt
Die futuristischste Behauptung des Launchs geht leicht unter. Tencent sagt, Hy4 habe zu seiner eigenen Entwicklung beigetragen und an der „automated optimization of training methods, data strategies, evaluation frameworks, and low-level operators“ teilgenommen, was das Unternehmen eine „early-stage recursive self-improvement loop“ nennt. Die konkrete, überprüfbare Version davon: Hy4 analysierte Engpässe in seinem eigenen Inferenz-Stack, und die daraus folgenden Optimierungen steigerten den End-to-End-Durchsatz um 31,8 %.
Ich würde den größeren Rahmen „Selbstverbesserung“ mit einer Prise Salz nehmen (ein Modell, das Operator-Fusionen vorschlägt, ist weit davon entfernt, sich selbst neu zu entwerfen), aber die 31,8 % Durchsatz sind eine konkrete, reale Zahl und die Art von Ingenieursleistung, die tendenziell gut altert. Sie nährt auch die wiederkehrende Hoffnung der Community, dass die spätere GA-Version deutlich stärker wird als diese Preview:
And this is a PREVIEW? The actual release must actually be fable level or higher then?
Wer sollte Hy4 also tatsächlich nutzen?
Nach all dem hier mein ehrliches Urteil. Hy4 ist ein ernstzunehmendes Open-Weight-Flaggschiff mit echtem Preisvorteil gegenüber Kimi K3 und Qwen 3.8 Max, starken Coding- und Wissenschafts-Benchmarks und einer freizügigen Apache-2.0-Lizenz. Wenn Sie einen KI-Agenten auf Infrastruktur bauen, die Sie kontrollieren, eine wirklich offene Lizenz wollen und das API-Budget oder die Hardware haben, ist es eine legitime Wahl, besonders für Coding mit langem Kontext und viel Caching.
Aber seien Sie bei zwei Dingen nüchtern. Es ist nicht die günstigste Option (hier gewinnen DeepSeek und die Flash-Modelle), und es ist kein enteilter Spitzenreiter (es liegt gleichauf mit seinen chinesischen Pendants und hinter der geschlossenen Spitze). Und entscheidend: Hy4 ist Infrastruktur. Es ist ein reines Modell, das Prompts beantwortet. Es kennt Ihr Geschäft nicht, lebt nicht in Ihren Tools und erledigt keinen Job von allein. Diese Lücke zwischen einem leistungsstarken Modell und etwas, das tatsächlich Arbeit erledigt, ist der Kern des nächsten Abschnitts.
eesel ausprobieren
Hier der entscheidende Unterschied: Hy4 ist ein Modell; eesel ist der Teamkollege, den Sie einstellen. Ein Basismodell wie Hy4 liefert rohe Intelligenz, die Sie erst verkabeln, mit Prompts versehen, an Ihre Daten anbinden und beaufsichtigen müssen. eesel ist eine Plattform für KI-Teamkollegen, auf der Sie einsatzbereite Teamkollegen für bestimmte Aufgaben einstellen, jeder mit den Fähigkeiten, Integrationen und dem Unternehmenskontext für seine Rolle.
Das aktuelle Angebot besteht aus einem KI-Helpdesk-Teamkollegen, der in Ihre bestehende Support-Warteschlange einsteigt, Bestellungen nachschlägt, Tickets taggt und Antworten in dem Helpdesk entwirft oder sendet, den Sie bereits nutzen, sowie einem KI-Blogautor, der Recherche, Schreiben und SEO in einem Durchgang erledigt. Beide trainieren mit Ihren früheren Tickets, Ihrem Help Center und Ihren Dokumenten und gehen in Minuten live, ganz ohne ML-Team. Wo ein Modell Ihnen ein Prompt-Feld hinterlässt, kommt ein Teamkollege schon mit dem Wissen über den Job.
Was rohe Modelle außerdem nicht können: Bevor ein eesel-Teamkollege live geht, können Sie ihn gegen Ihre historischen Tickets simulieren, sodass Sie wissen, wie er sich tatsächlich schlagen wird, statt den Schalter umzulegen und zu hoffen. Es ist kostenlos zu testen, ohne Kreditkarte und ohne Verkaufsgespräch. Wenn Ihr Ziel ist, echte Arbeit zu erledigen, statt einen Inferenz-Cluster zu betreiben, starten Sie mit eesel.