

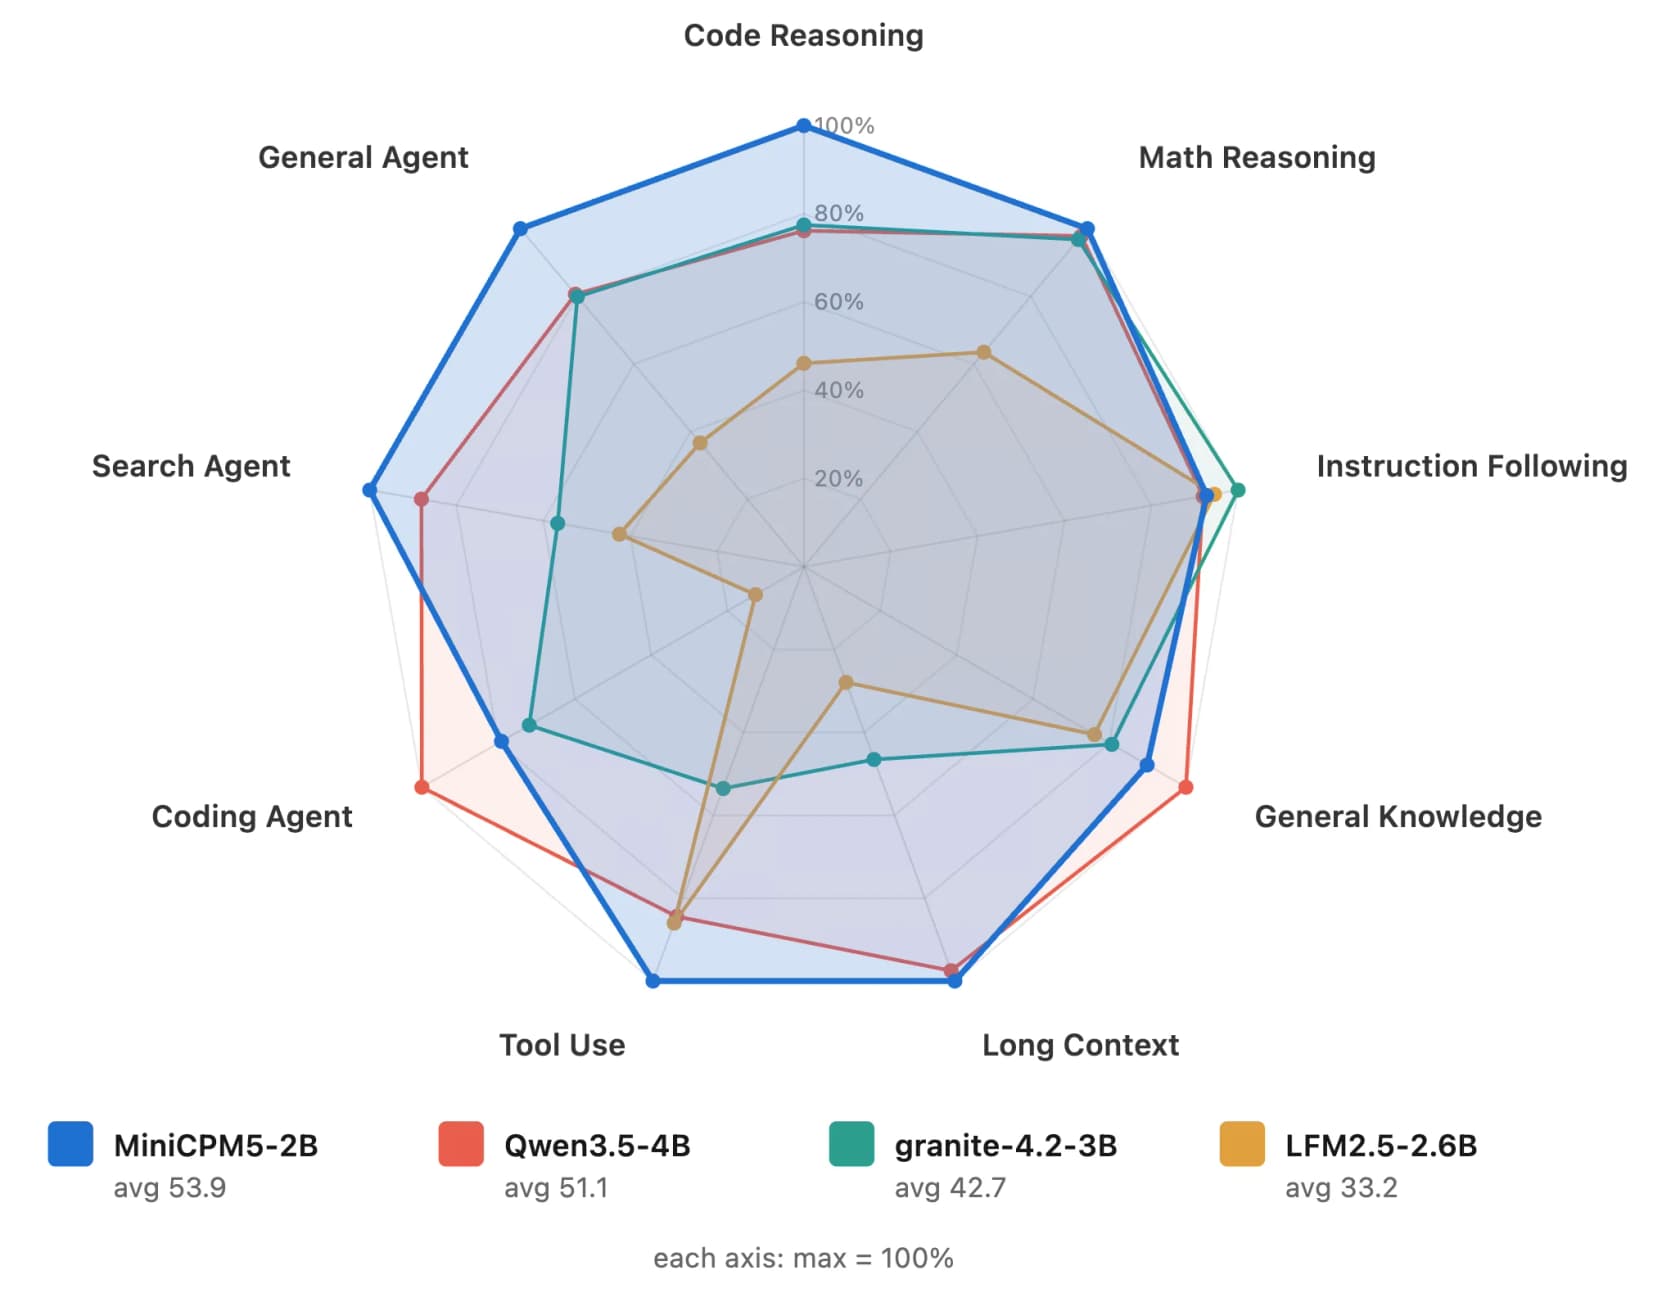
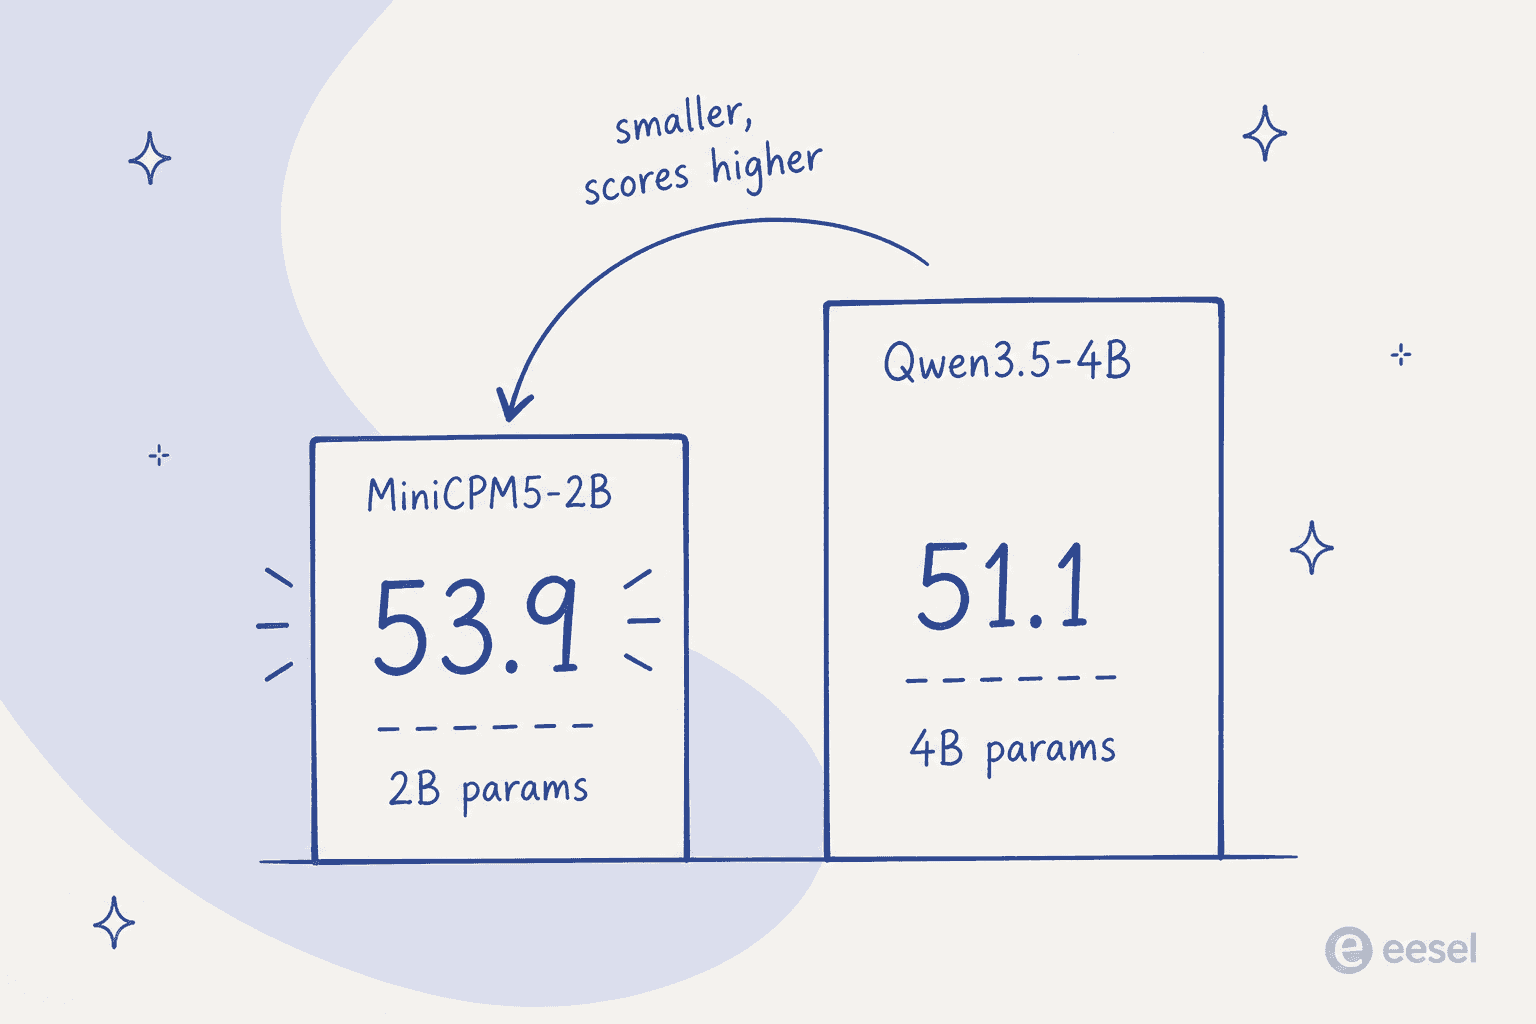
MiniCPM5-2B ist ein neues reines Textmodell mit 2,5 Milliarden Parametern von OpenBMB, das auf deiner eigenen Hardware laufen soll. Die Schlagzeile stimmt: Es erreicht im Schnitt 53,9 über 34 Benchmarks, was OpenBMB als Open-Source-Bestwert der 2B-Klasse darstellt, und innerhalb ihres Vergleichssets überholt es knapp das beste 4B-Modell, Qwen3.5-4B mit 51,1. Es steht unter der Apache-2.0-Lizenz, bringt nativ 128K Kontext mit und läuft auf Smartphones, Laptops und Mini-PCs über Ollama, llama.cpp, MLX und Co.
Die ehrlichen Einschränkungen: Es ist nur Text, keine Vision, nur Englisch und Chinesisch, und ein Teil der Community bezweifelt, dass die Benchmark-Siege den Kontakt mit echten Coding-Harnesses überstehen. Außerdem gibt es eine öffentliche Diskrepanz beim Artificial-Analysis-Index-Wert (unabhängige Tracker sagen 15, OpenBMBs eigener Tweet sagt 23).
Für wen es interessant ist: Wenn du lokale Assistenten, On-Device-Tools oder einen schlanken Agenten baust und etwas Kleines mit freizügiger Lizenz willst, ist MiniCPM5-2B derzeit eines der interessantesten Modelle unter 4B. Wenn du dagegen eine KI brauchst, die Support-Tickets in der Produktion löst, ist ein rohes Modell die falsche Ebene, und warum, erkläre ich gegen Ende.
Was MiniCPM5-2B eigentlich ist
MiniCPM5-2B erschien etwa am 6. und 7. September 2026 als zweites Modell in OpenBMBs MiniCPM5-Reihe, nach dem kleineren MiniCPM5-1B. OpenBMB (auch bekannt als ModelBest) veröffentlicht seit ein paar Jahren kleine, effiziente Modelle, und diese Reihe dreht sich um genau eine Sache: echte Leistungsfähigkeit auf Edge-Hardware zu bringen statt auf eine Rechenzentrums-GPU.
Das sind die wichtigen Eckdaten, alle aus der Modellkarte:
| Feld | Wert |
|---|---|
| Parameter | 2.516.756.480 (etwa 2,52B) |
| Architektur | Standard-LlamaForCausalLM, 42 Schichten |
| Attention | Grouped-Query, 16 Query-Heads, 2 KV-Heads |
| Kontextlänge | 131.072 Tokens (128K) |
| Lizenz | Apache-2.0 (Gewichte und Repo) |
| Modalität | Nur Text, Englisch und Chinesisch |
| Formate | BF16, dazu GGUF, MLX 4-Bit, GPTQ 4-Bit |
Eine Designentscheidung leistet hier im Stillen viel. MiniCPM5-2B nutzt die schlichte LlamaForCausalLM-Architektur, sodass gängige Engines es laut OpenBMB direkt laden können, „no custom kernels, no model-code fork." Deshalb kam es mit Day-0-Unterstützung für vLLM, SGLang, llama.cpp, Ollama, LM Studio und MLX heraus, statt mit der üblichen zweiwöchigen Wartezeit, bis das Ökosystem nachzieht. Wenn du je versucht hast, ein frisches offenes Modell am Tag seiner Veröffentlichung zu betreiben, weißt du: Diese Day-0-Breite ist keine Selbstverständlichkeit.
Die andere Schlagzeilenzahl sind die 128K Kontext, für ein so kleines Modell wirklich viel, und die Long-Context-Benchmarks (dazu unten mehr) deuten darauf hin, dass es keine Zahl auf dem Datenblatt ist, die in der Praxis zusammenbricht.
Die Benchmarks: Kann ein 2B-Modell wirklich ein 4B-Modell schlagen?
Das ist die Behauptung, auf die sich alle gestürzt haben, also zeige ich dir die echte Tabelle. Über OpenBMBs 34-Benchmark-Suite erreicht MiniCPM5-2B im Schnitt 53,9, vor Qwen3.5-4B mit 51,1 und deutlich vor den anderen Modellen der 2B-Klasse, gegen die es getestet wurde.
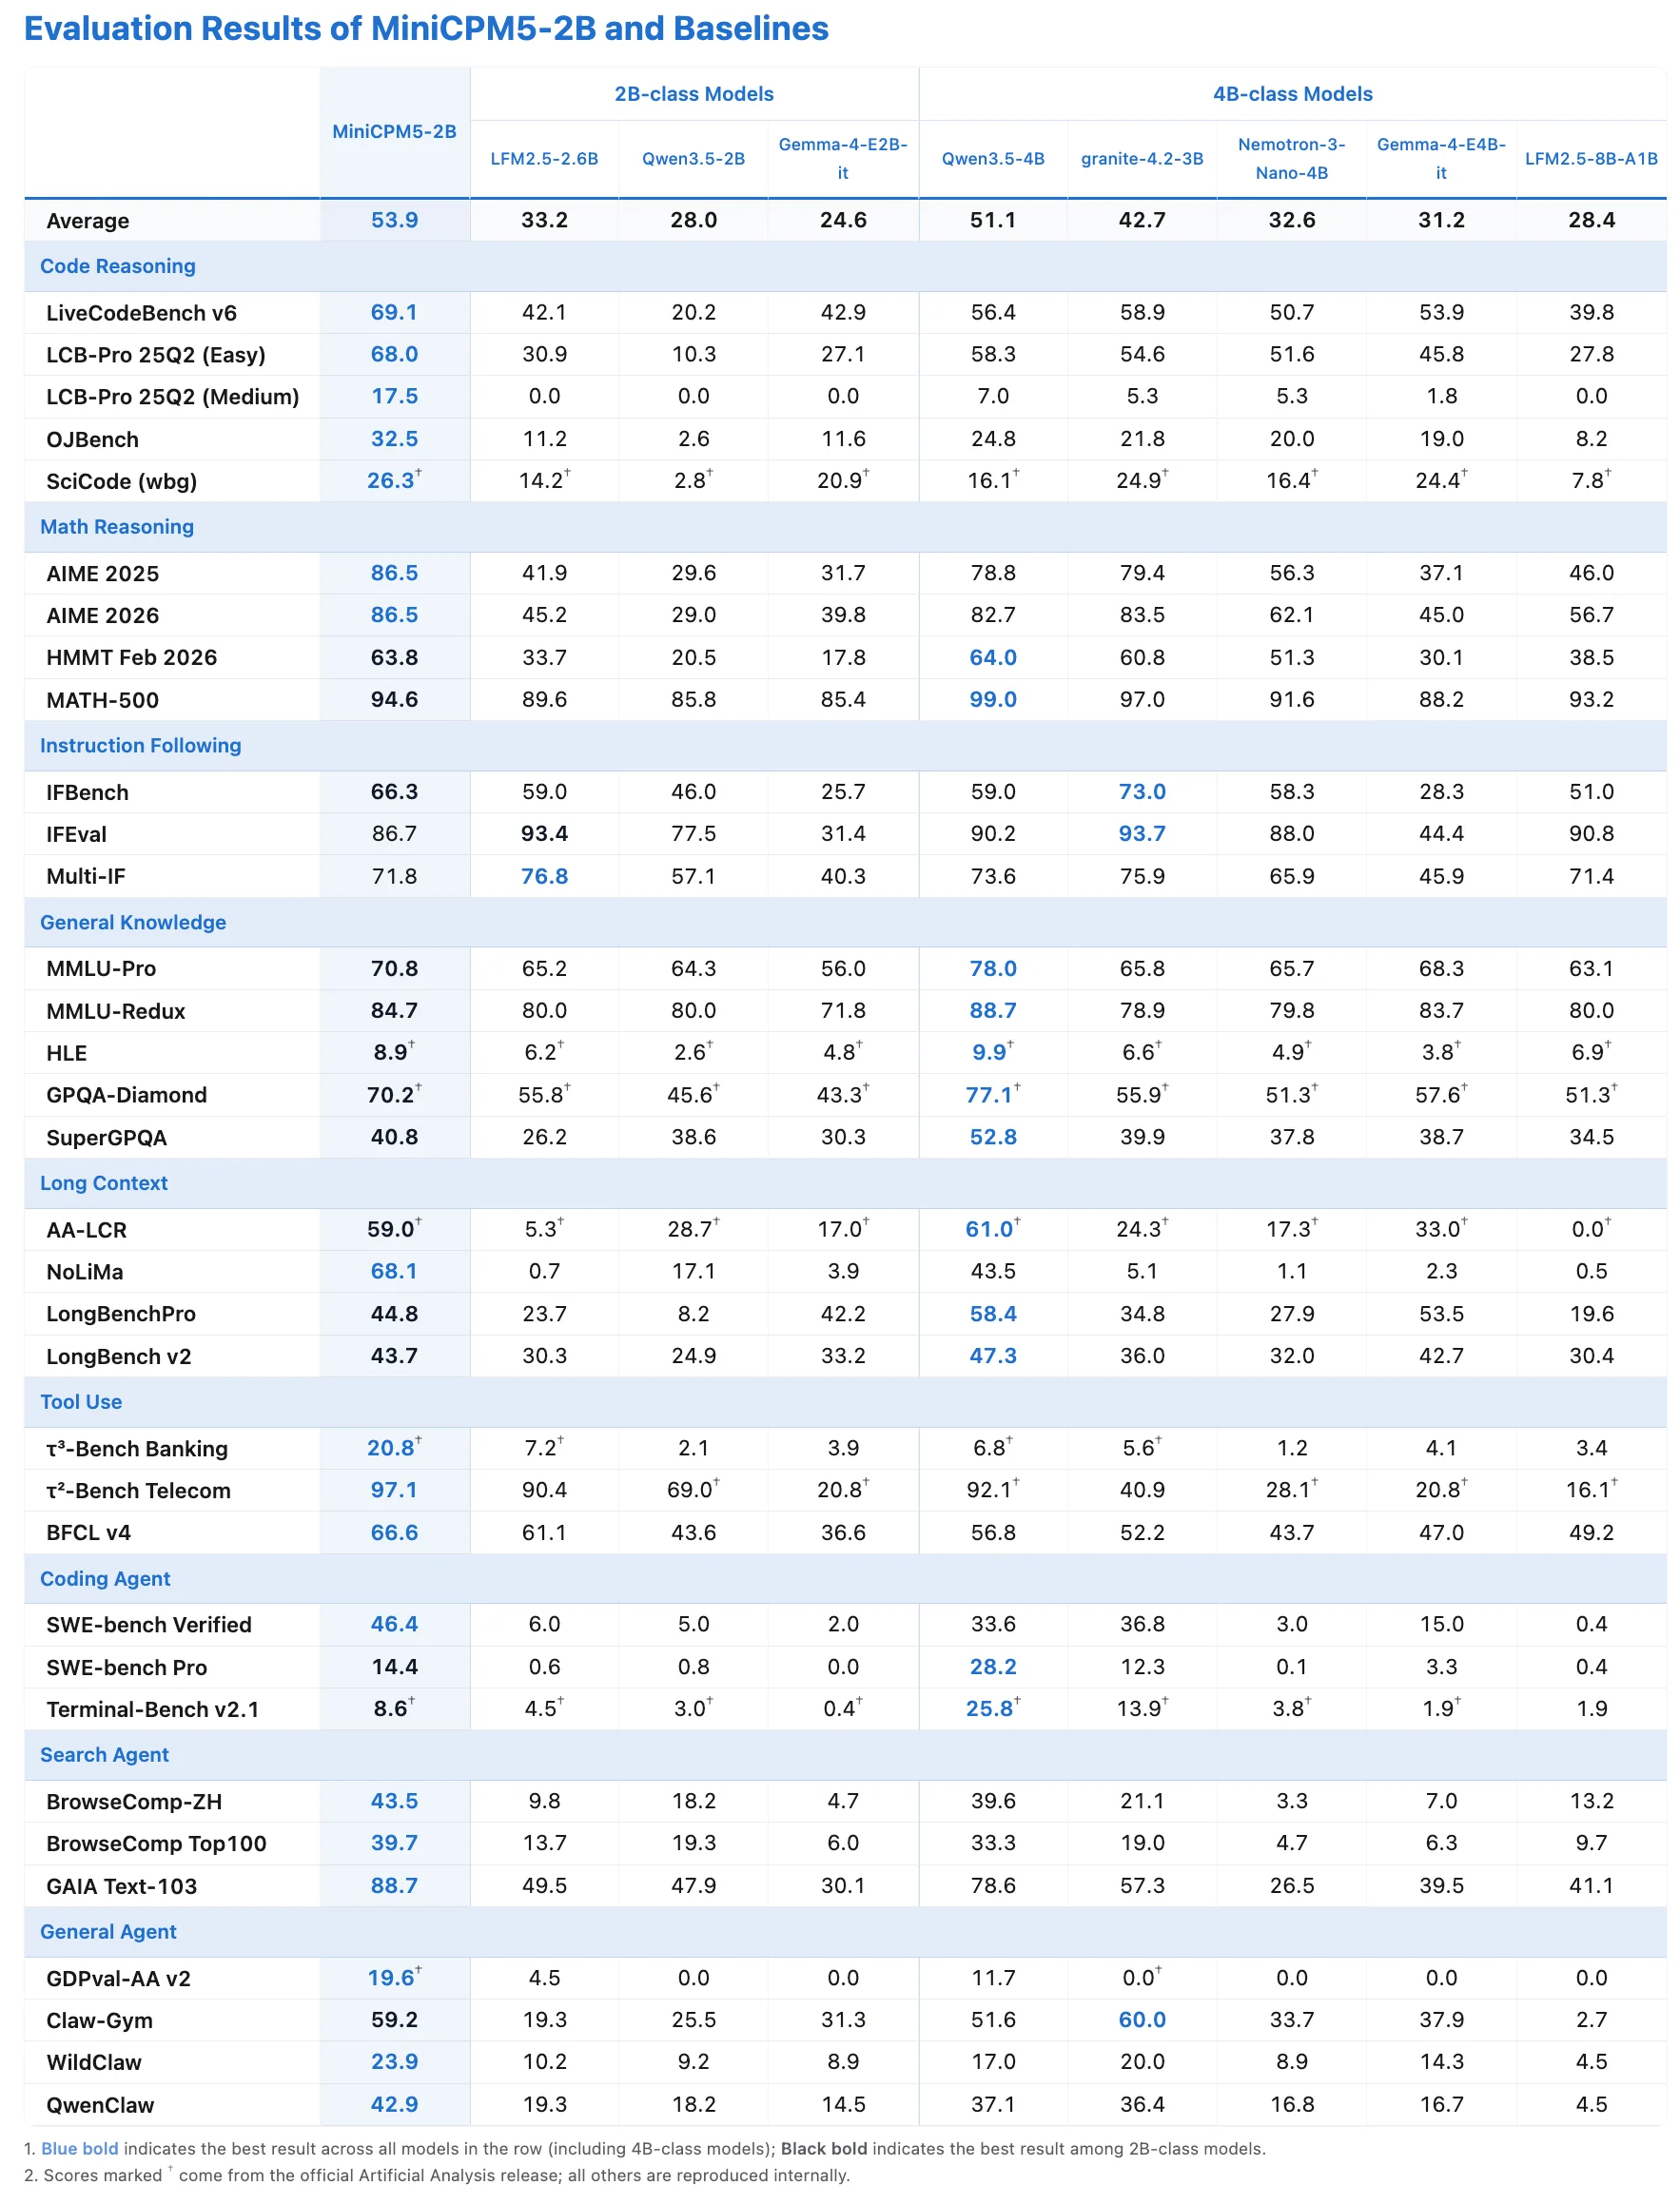
Die herausragenden Zeilen sind die interessanten. Bei Mathematik erreicht es MATH-500 94,6 und AIME 2026 86,5. Beim Code-Reasoning führt es die Tabelle an mit LiveCodeBench v6 69,1 und SWE-bench Verified 46,4, beides über dem 4B-Qwen. Bei Tool-Nutzung kommt es auf τ²-Bench Telecom 97,1 und BFCL v4 66,6, und auf der Seite der Such-Agenten liegt GAIA Text-103 bei 88,7. Für ein Modell, das du auf einem Laptop laufen lassen kannst, sind diese Agenten- und Tool-Use-Werte das Überraschende.
Zwei Dinge sollte man ehrlich festhalten. Erstens ist das OpenBMBs eigenes Vergleichsset, die Aussage „schlägt 4B" gilt also innerhalb der von ihnen gewählten Modelle und Benchmarks, nicht universell. Das 4B-Qwen gewinnt weiterhin mehrere Zeilen bei Wissen und Long-Context (MMLU-Pro 78,0, GPQA-Diamond 77,1). Zweitens gibt es eine echte Diskrepanz bei der Drittanbieter-Zahl. Der r/LocalLLaMA-Release-Thread und die Hacker-News-Einreichung berichten beide von einem Artificial Analysis Intelligence Index von 15, „the highest of any open weights model at 4B parameters or below." OpenBMBs eigener Launch-Tweet behauptet dagegen 23 plus 20 beim Agentic Index. Das lässt sich in den Quellen, die ich prüfen konnte, nicht in Einklang bringen, wahrscheinlich ein Versions- oder Rundungsunterschied. Ich würde die unabhängigen 15 als konservative Zahl nehmen und die 23 als Herstellerangabe behandeln.
Noch eine Nuance: OpenBMB veröffentlicht nicht die klassischen MMLU-, GSM8K- oder HumanEval-Werte, nach denen man instinktiv sucht. Die Karte nutzt eine neuere Suite (MMLU-Pro, LiveCodeBench, SWE-bench und so weiter). Wenn du gegen das Datenblatt eines älteren Modells vergleichst, findest du keine saubere Zeile zum direkten Vergleich.
Wie ein 2B-Modell so gut wurde
Am interessantesten finde ich nicht den Score, sondern das Trainingsrezept dahinter, denn es erklärt, warum ein 2B-Modell über seiner Gewichtsklasse boxt, statt wie Marketing zu klingen.
Das finale Release ist kein einzelner Trainingslauf. Nach Base- und Mid-Training auf OpenBMBs UltraData-Datensätzen läuft in der Post-Training-Phase erst Supervised Fine-Tuning, dann Reinforcement Learning mit spezialisierten Lehrern für Mathe, Code, agentische Aufgaben und Schreiben, mit ihrem JustRL-II-Algorithmus. Der clevere Teil ist der letzte Schritt: On-Policy-Distillation führt 16 einzelne Expertenmodelle (darunter 5 agentische Experten) über Full-Vocabulary-Reverse-KL zwischen Student und Teacher in das eine 2B-Release zusammen. Einfach gesagt: Sie haben eine Bank von Spezialisten trainiert und deren Fähigkeiten dann in ein einziges kleines Modell zurückverdichtet.
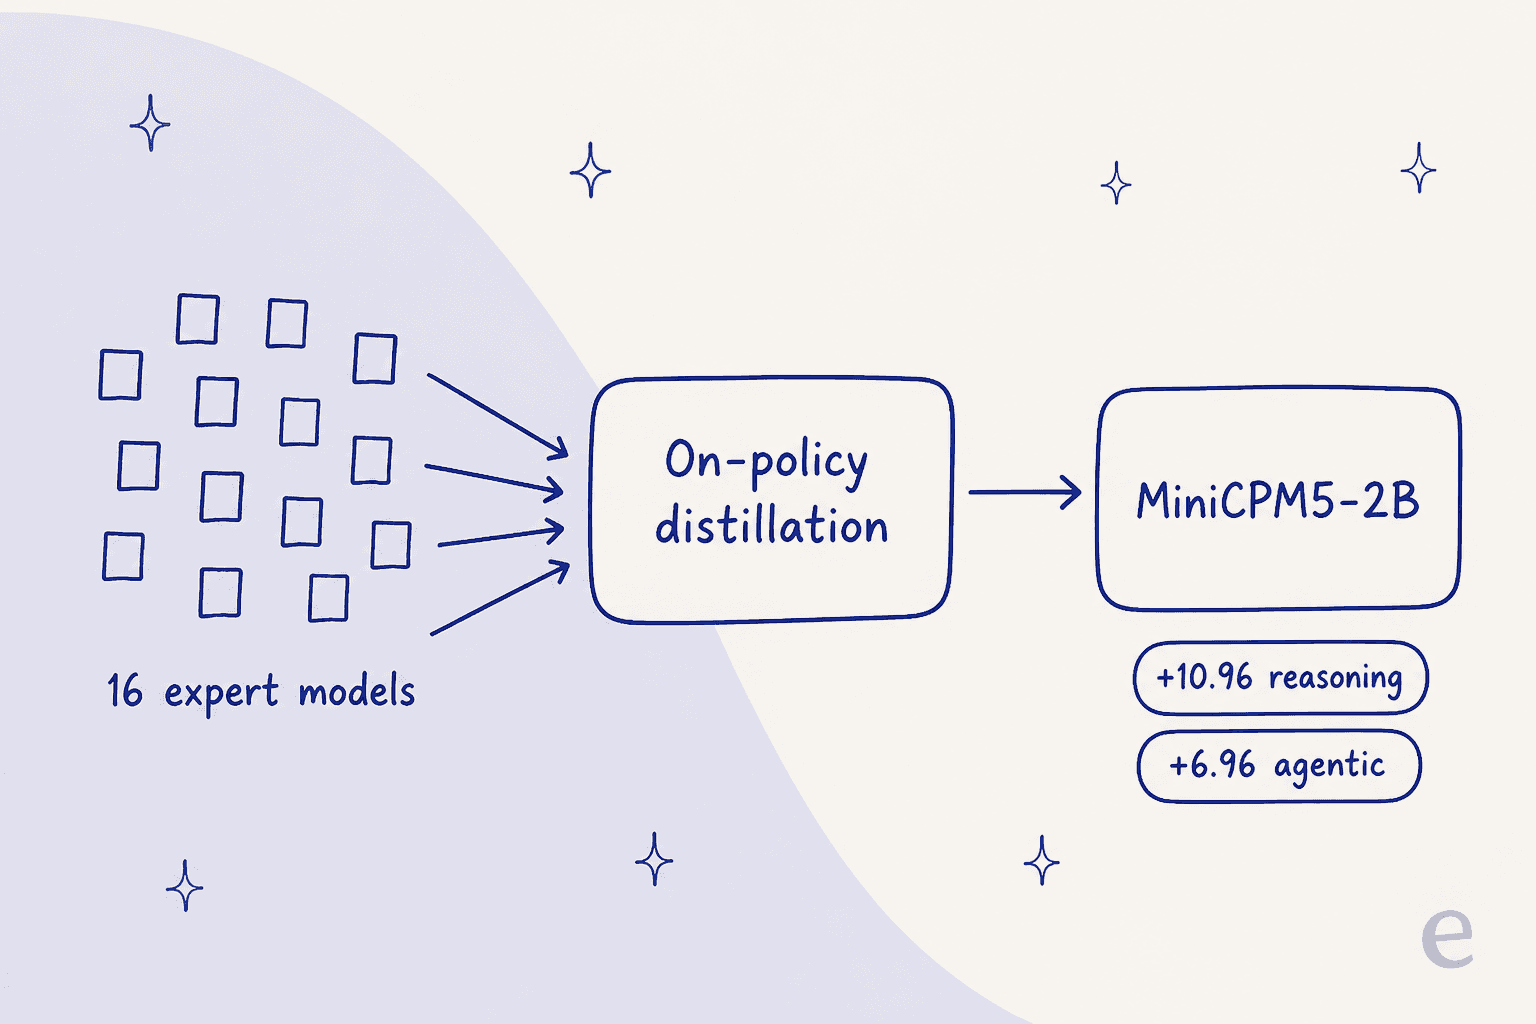
Laut Modellkarte hob diese RL-plus-Distillation-Phase Reasoning- und allgemeine Benchmarks im Schnitt um 10,96 Punkte und agentische Aufgaben um 6,96 Punkte gegenüber dem reinen SFT-Checkpoint. Das ist ein großer Sprung für einen Post-Training-Durchlauf und der Mechanismus hinter der Geschichte „kleines Modell, großer Score". Wenn du verstehen willst, wie moderne kleine Modelle gebaut werden, lohnt sich dieses Rezept für genaues Lesen.
Betrieb: Wo MiniCPM5-2B passt
Weil es eine Standardarchitektur nutzt, ist der Start von MiniCPM5-2B erfrischend unspektakulär, das ist als Kompliment gemeint. Die Modellkarte nennt einen vLLM-Einzeiler:
pip install "vllm>=0.21"
vllm serve openbmb/MiniCPM5-2B --port 8000
Wenn dir Tool Calling wichtig ist, ist SGLang das empfohlene Backend: Das Modell gibt Tool-Aufrufe im XML-Stil aus, und SGLangs eingebauter minicpm5-Parser wandelt sie in OpenAI-kompatible tool_calls um. Es gibt außerdem ein DSpark-Draft-Modell für Speculative Decoding, wenn du schnellere Ausgabe ohne geänderte Ergebnisse willst. Für Laptop und Smartphone laufen die GGUF- und 4-Bit-MLX-Builds über Ollama, LM Studio, llama.cpp und MLX, und OpenBMB nennt außerdem Day-0-Anpassung an Intel-, Arm- und Rockchip-Chips, mit etwa 1,7-fachem Prefill- und 1,2-fachem Decode-Gewinn auf Arm-SME2-Mobilhardware.
Die On-Device-Durchsatz-Demos zeigen, wo es vom Datenblatt in die Praxis geht. Ein Tester ließ 32 parallele Subagenten auf einem einzelnen DGX Spark laufen, mit durchschnittlich 931 Tokens pro Sekunde und 1.364 im Peak, alles auf dem 2B-Modell. OpenBMB teilte einen weiteren Lauf, in dem es auf einem 16-GB-MacBook arbeitet, Websuche aufruft und Ergebnisse komplett auf dem Gerät zusammenfasst. Das sind die Workloads, die ein kompaktes, schnelles Modell ermöglicht und die ein riesiges Cloud-Modell bei Latenz oder Kosten nicht leisten kann.
Was die Leute tatsächlich sagen
Die Reaktion auf r/LocalLLaMA, der natürlichen Heimat für solche Modelle, war überwiegend begeistert:
"Hot damn. Very promising."

Aber zwei Kritikpunkte tauchten immer wieder auf, und beide sind berechtigt. Der erste ist die fehlende Vision-Unterstützung, die die lokale Community sichtlich geärgert hat:
"Sad that there is no vision though. Having to switch to Lfm2.5-vl-3b for it is a bummer"
Der zweite ist gesunde Skepsis, ob Leaderboard-Scores sich in nützliche Arbeit übersetzen. Zur Durchsatz-Demo fiel eine Antwort deutlich aus:
"you get some likes here, but useful code? I don't think so"
Und ein Praxistester berichtete, dass es in einem echten Coding-Harness scheitert, was er auf den quantisierten 2B-Build plus den Drafter zurückführte. Das ist die wiederkehrende Lehre bei kleinen Modellen: Ein Benchmark-Sieg ist nicht dasselbe wie ein zuverlässiger Agent, und die Lücke zeigt sich genau dann, wenn du es in eine echte Tool-Schleife einbindest.
Die ehrlichen Einschränkungen
Hier die Vorbehalte an einem Ort, denn ein fairer Test nennt sie klar:
- Keine Vision oder Audio. Dieser Checkpoint ist reiner Text. Multimodales steckt in der separaten MiniCPM-V-Reihe, für Bildaufgaben brauchst du also ein zweites Modell.
- Nur Englisch und Chinesisch. Community-Tester haben den Sprachumfang bestätigt, es ist also kein breit mehrsprachiges Modell.
- Benchmarks eilen den Praxisberichten voraus. Die oben genannten Harness-Ausfälle solltest du selbst testen, bevor du darauf aufbaust.
- Eine öffentliche Score-Diskrepanz. Die Lücke von 15 zu 23 beim Intelligence Index ist ungeklärt, und vom Hersteller selbst erhobene Zahlen verdienen immer eine hochgezogene Augenbraue.
- Die Nutzung in der ersten Woche ist noch klein. Die Modellkarte zeigte in der ersten Woche 2.879 Downloads, das Stresstesten durch die Community fängt also gerade erst an.
Nichts davon versenkt es. Es ordnet es nur ein: MiniCPM5-2B ist ein exzellentes Edge-Modell für Forschung und Hobby und eine vielversprechende Basis für On-Device-Tools, aber kein Drop-in-Gehirn für die Produktion.
Modell versus Teammate: Was ein 2B-Modell im Support kann und was nicht
Hier ist die Neubetrachtung, die mir wichtig ist, denn viele, die ein Modell-Review lesen, fragen sich insgeheim, ob sie so etwas auf ihre Support-Warteschlange ansetzen könnten.
Ein rohes Modell ist eine Zutat, keine Mahlzeit. MiniCPM5-2B liefert dir Gewichte und eine starke Benchmark-Karte. Damit daraus etwas wird, das ein Kunde berührt, musst du es noch hosten, promoten, an dein Helpdesk anbinden, mit deinem Wissen füttern, mit Tools ausstatten, Leitplanken einbauen und es testen, damit es nicht selbstsicher eine falsche Antwort gibt. Das ist ein echtes Engineering-Projekt, näher an einen KI-Agenten bauen als an die Wahl eines guten Modells. Dieselbe Lücke würde ich auch aufzeigen, wenn du MiniCPM5-2B, ein Qwen-Modell oder einen OpenAI-Endpunkt ansiehst: Das Modell ist Infrastruktur, und der eigentliche Arbeiter ist alles, was du darauf aufbaust.
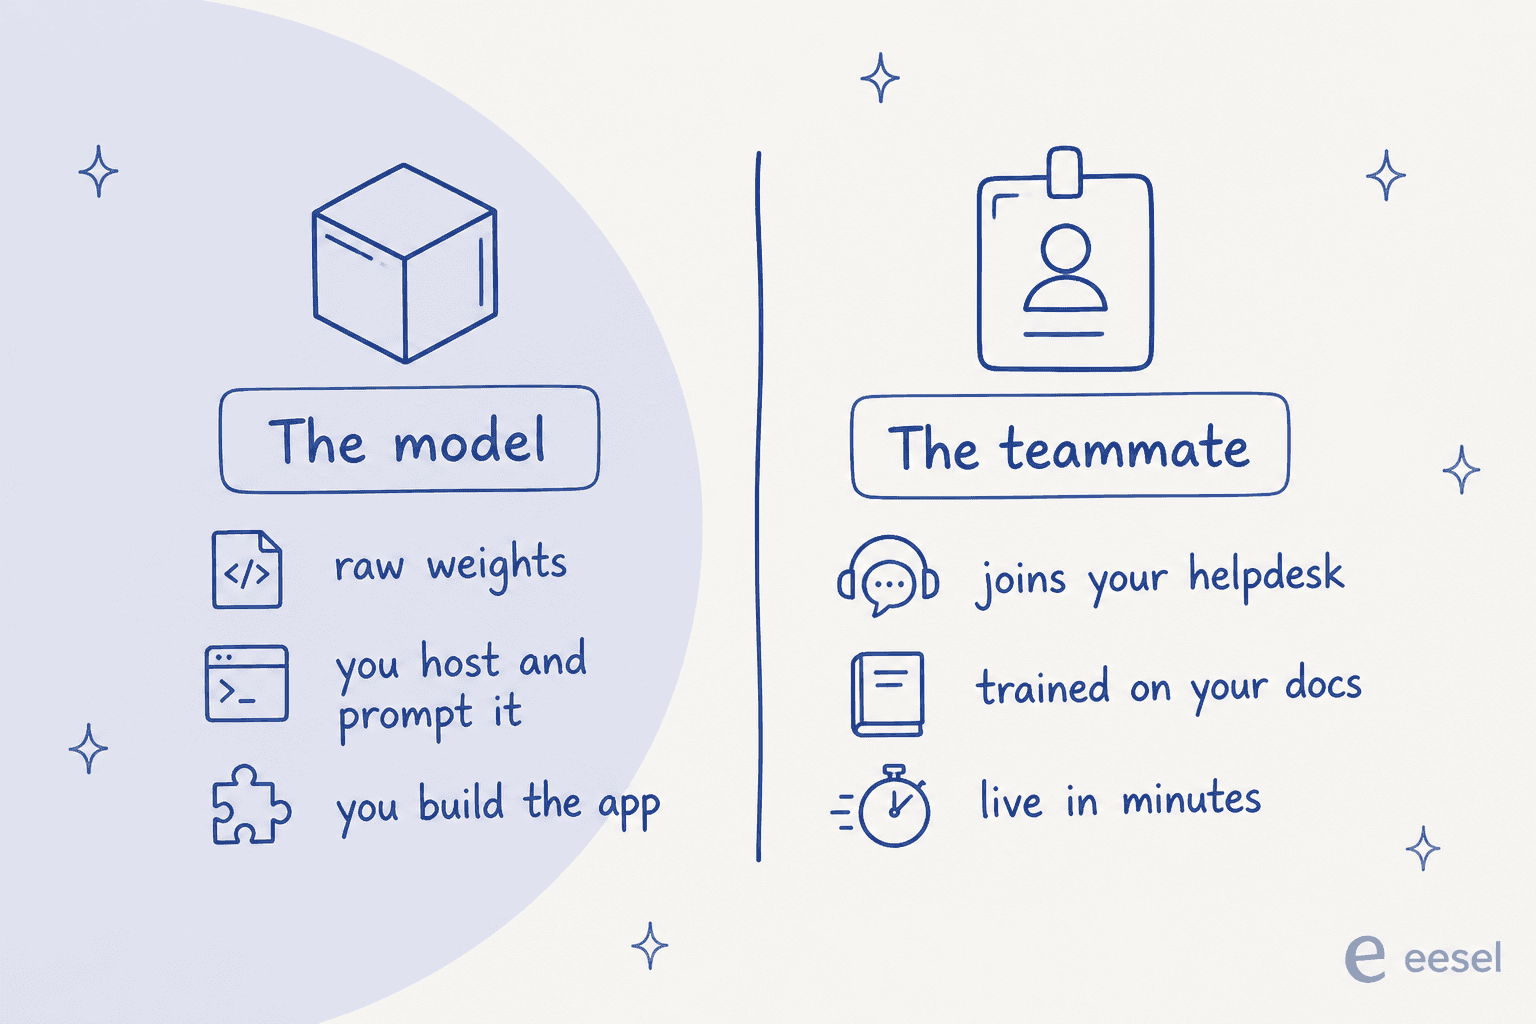
Genau diese Unterscheidung ist der Grund, warum es eesel gibt. Statt dir ein Modell zum Verdrahten zu geben, liefert es dir einen einsatzbereiten KI-Teammate für eine bestimmte Aufgabe, und der KI-Helpdesk-Teammate bringt Integrationen, Unternehmenskontext und Support-Tooling bereits mit. Der Kompromiss ist real und sollte klar benannt werden: Du kannst nicht deine eigenen Gewichte auf deinem eigenen Laptop betreiben wie bei MiniCPM5-2B. Dafür bekommst du etwas, das in Minuten statt Monaten echte Tickets beantwortet.
eesel für KI-Support testen
Wenn du ein 2B-Modell-Review gelesen hast, weil du dich gefragt hast, ob das deinem Support-Team helfen könnte, lautet die ehrliche Antwort: Ein Modell allein tut es nicht, aber der darauf aufbauende KI-Teammate kann es.
eesel verbindet sich mit dem Helpdesk, den du schon nutzt (Zendesk, Freshdesk, Gorgias, Help Scout und mehr), trainiert auf deinen vergangenen Tickets und Dokumenten und kann in Minuten live gehen. Den Teil würde ich nicht überspringen: Es lässt sich an deinen historischen Tickets simulieren, bevor es je ein Live-Gespräch berührt, sodass du genau siehst, wie es echten Kunden geantwortet hätte. Das ist die Disziplin „erst testen, dann vertrauen", die die Modell-Skeptiker oben fordern, direkt ins Produkt eingebaut. Und für alle Terminal-und-Skript-Fans, denen der On-Device-Ansatz von MiniCPM5-2B gefiel: eesel liefert auch ein CLI und MCP-Support, sodass ein Mensch, ein Skript oder ein Coding-Agent wie Claude Code oder Cursor denselben Teammate steuern kann, ohne das Dashboard zu öffnen.
Du kannst eesel kostenlos testen, ohne Kreditkarte und ohne Verkaufsgespräch, und hast einen Teammate, der Tickets beantwortet, bevor du deinen eigenen Inferenz-Stack fertig aufgesetzt hättest.