Die 8 besten Tencent-Hy4-Alternativen 2026

Rama Adi

Katelin Teen
Zuletzt bearbeitet August 30, 2026
Kurzfassung
Tencent Hy4 Preview ist ein wirklich starkes Open-Weight-Modell: ein Mixture-of-Experts-Release mit 770B Parametern, das die anderen chinesischen Flaggschiffe im Preis unterbietet und in der WebDev-Coding-Arena nahe an die Spitze der offenen Modelle kommt. Der Haken: Sie können es vermutlich nicht betreiben. Es ist ein Mixture-of-Experts-Modell, daher werden pro Token nur 49B Parameter aktiv, aber alle 770B müssen gleichzeitig im GPU-Speicher liegen, was einen Server mit acht GPUs bedeutet. Außerdem ist es etwa fünf- bis sechsmal teurer als Hy3 und noch eine Preview.
Die eigentliche Frage ist also nicht „Ist Hy4 gut?“ (ja, ist es), sondern „Welches Modell liefert mir Hy4-Ergebnisse auf Hardware und mit einem Budget, das ich wirklich habe?“ Meine Empfehlungen:
- GLM-5.3-Flash - die beste Alternative für alle Fälle: 320B, nativ multimodal und günstig.
- DeepSeek V4 Flash - die Preisuntergrenze, MIT-lizenziert, klein genug zum Selbsthosten.
- GLM-5.3 - die größte Nähe zur Qualität von Hy4 (das Modell, gegen das sich Tencent selbst vergleicht).
- Kimi K3 - das stärkste Modell für lange agentische Coding-Läufe.
- Qwen 3.8 Max, DeepSeek V4 Pro, Claude Opus 5 und GPT-5.6 runden die Liste für Multimodalität, langen Kontext und Setups ohne Infrastruktur ab.
Noch etwas: Wenn Sie ein Modell wollen, um Kundentickets zu beantworten, müssen Sie nichts selbst zusammenbauen. eesel ist ein KI-Helpdesk-Teammitglied, das bereits auf Frontier-Modellen läuft, sich in Ihre bestehenden Tools einklinkt und Sie vor dem Livegang auf vergangenen Tickets testen lässt.
Warum Leute über Hy4 hinausschauen
Zuerst muss ich fair zu Hy4 sein, denn es verdient es. Tencents Hunyuan-Team hat ein echtes offenes Frontier-Modell veröffentlicht: 770B Parameter gesamt, 49B aktiv, ein Kontextfenster von 1M Token, offene Gewichte auf Hugging Face und ein Preis, der unter GLM-5.3, Qwen 3.8 Max und Kimi K3 liegt. Im Code Arena WebDev Leaderboard landete es auf Platz 5, grob Platz 3 unter den offenen Modellen, ein Sprung von +115 Punkten gegenüber Hy3. Wenn Sie die Hardware haben, ist es eine starke Wahl.
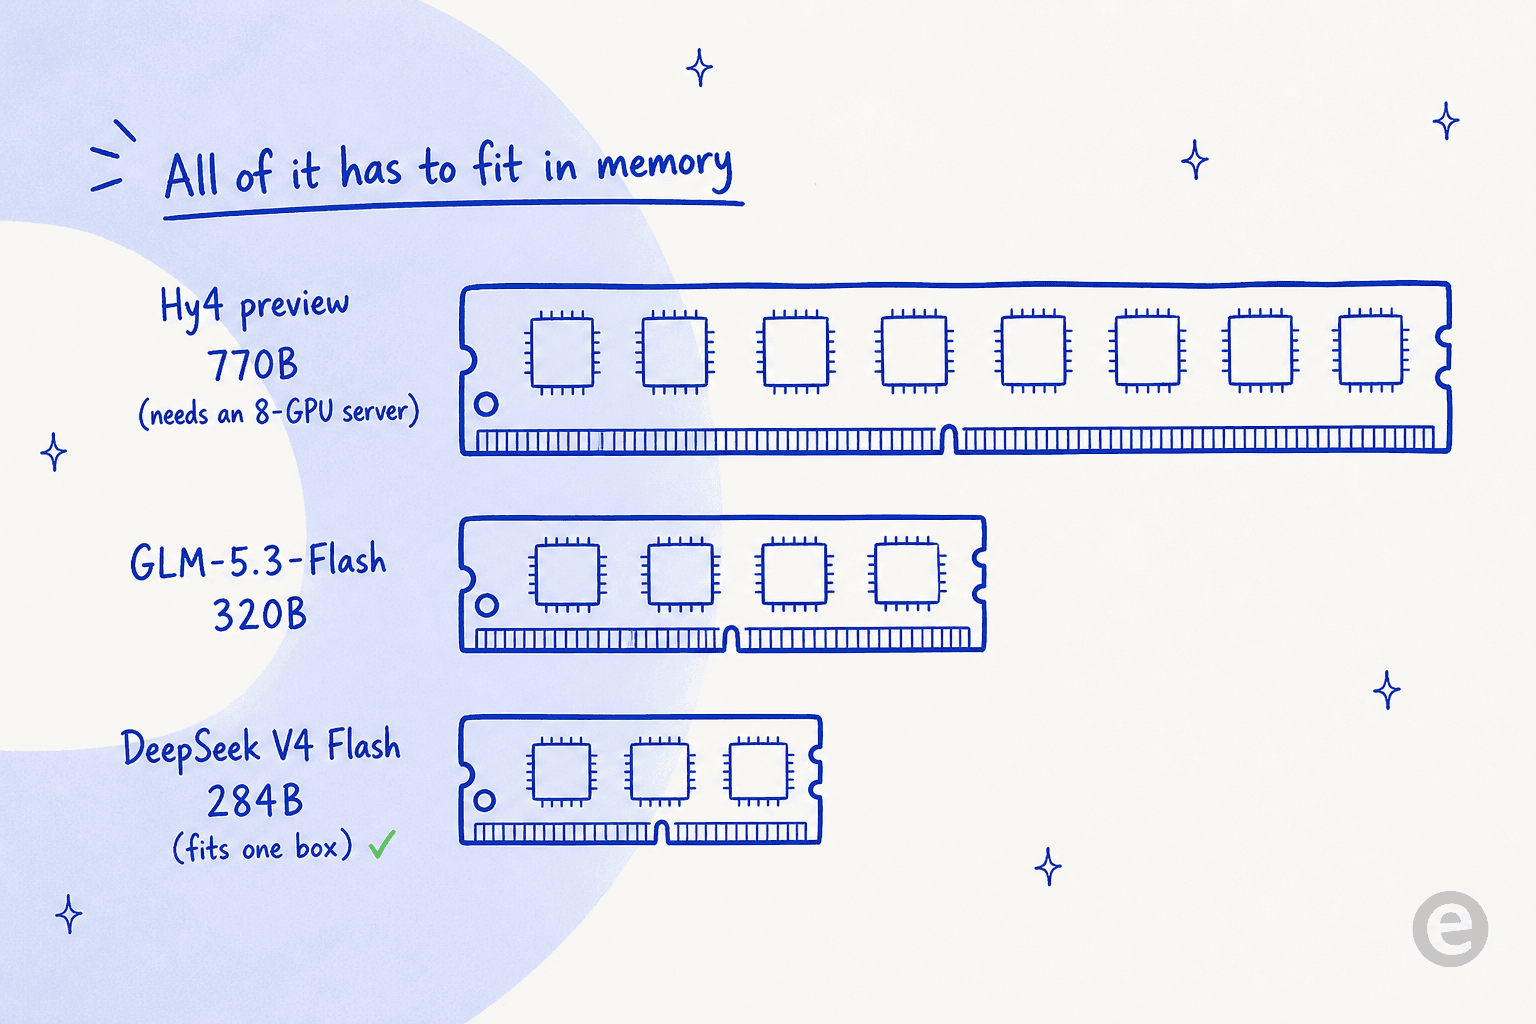
Jetzt wird es kompliziert, und genau das begegnet mir jede Woche beim Arbeiten mit diesen Modellen. Ein Mixture-of-Experts-Modell spart pro Token Rechenleistung, nicht Speicher. Der Router aktiviert für jeden Token nur 49B der 770B Parameter, also ist es schnell, aber die gesamten 770B müssen trotzdem geladen und resident sein. In der Praxis sind das etwa 924GB Gewichte im MXFP8-Build, also ein Acht-GPU-Knoten der B300-Klasse. Eine Box mit acht H100 (640GB) reicht nicht. Die Community auf r/LocalLLaMA kam zum selben Ergebnis: tolles Modell, zu Hause nicht lauffähig.
Das zweite Problem sind die Kosten. Hy4 unterbietet seine Flaggschiff-Konkurrenten, ist aber ein großer Sprung gegenüber dem Modell, das es ersetzt. Bestehende Hy3-Nutzer sehen also eine spürbar höhere Rechnung, auch wenn es neben Kimi günstig wirkt. Und das dritte ist die Reife: Es ist eine Preview, und Tencent selbst merkt an, dass das Modell zu übermäßigem Nachdenken und Überprüfen neigt.
Nichts davon macht Hy4 zu einem schlechten Modell. Es macht es zu einem Modell mit einem engen Kreis von Leuten, die es tatsächlich einsetzen können. Für alle anderen bringen Sie die folgenden Alternativen auf Hardware, die Sie sich leisten können, ein gutes Stück weit dorthin.
Wie Hy4 im Vergleich zu diesen Alternativen tatsächlich abschneidet
Bevor ich zu den Empfehlungen komme, lohnt sich der direkte Vergleich. Das ist Tencents eigenes Benchmark-Raster vom Launch, und das Nützliche daran: Die Konkurrenten darin sind genau die Modelle dieser Übersicht: Qwen 3.8 Max, DeepSeek V4 Pro, GPT-5.6 Sol, GLM-5.3, Kimi K3 und Claude Opus 5.
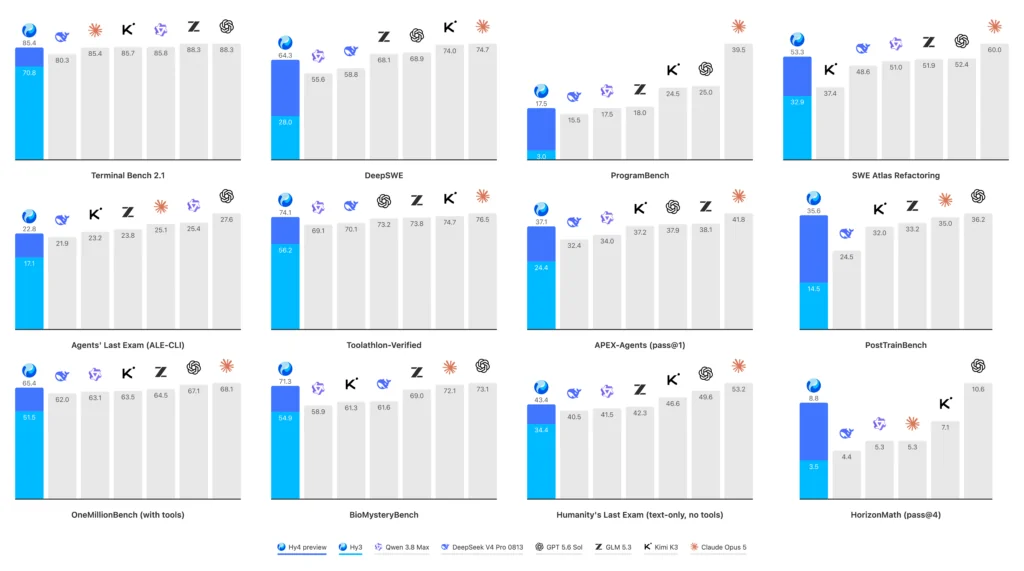
Zwei ehrliche Einschränkungen. Erstens ist das die Grafik eines Anbieters über sich selbst, also ein Ausgangspunkt und kein Urteil. Zweitens steht Hy4 noch nicht im unabhängigen Artificial-Analysis-Index, es gibt also keinen neutralen Intelligenzwert, den ich nennen könnte. Tencents eigene interne Blindbewertung sah Hy4 bei 2,99/4,00 gegenüber Kimi K3 (2,94) und GLM-5.3 (2,92). Das ist so nah beieinander, dass die Coding-CLI-Community es als grob dreifaches Unentschieden las, mit dem Preis als echtem Vorteil von Hy4.
Wie ich ausgewählt habe
Ich baue bei eesel die Integrationen und die Modell-Infrastruktur, die Entscheidung, welches Modell tatsächlich in Produktion läuft, ist also ein großer Teil meiner Woche. Ein Leaderboard-Wert ist der einfache Teil. In der Praxis entscheiden diese Fragen: Passen die Gewichte in meinen Speicher, was kostet ein echter Monat an Tokens, ist die Lizenz eine, mit der ich ausliefern darf, und hält das Modell einen langen agentischen Lauf durch statt nur eine clevere Einzelantwort? Ich habe deshalb so gewichtet:
- Einsetzbarkeit - kann ein normales Team das Modell realistisch betreiben oder bezahlen, nicht nur ein Hyperscaler.
- Preis pro 1M Tokens - aus der Preisliste des Anbieters, mit Hinweisen auf Aktionen und Spitzen-/Nebenzeit-Eigenheiten.
- Lizenz und offene Gewichte - ob Sie selbst hosten können und was Sie damit tun dürfen.
- Tatsächliche Leistung - Coding- und agentische Stärke, nicht nur ein Schlagzeilenwert.
Jeder Preis und jede Spezifikation unten stammt von den eigenen Seiten des Anbieters, geprüft am 30. August 2026. Wo eine Zahl ein interner Benchmark des Anbieters statt eines unabhängigen ist, sage ich das.
Die Alternativen im Überblick
| Modell | Am besten für | Parameter gesamt / aktiv | Kontext | Input $/1M | Output $/1M | Offene Gewichte | Lizenz |
|---|---|---|---|---|---|---|---|
| GLM-5.3-Flash | Bester Allrounder | 320B / 18B | 1M | $0.075* | $0.25* | Ja | Offen (HF) |
| DeepSeek V4 Flash | Niedrigster Preis | 284B / 13B | 1M | $0.22-0.44 | $0.66-1.32 | Ja | MIT |
| GLM-5.3 | Am nächsten an Hy4 | Nicht angegeben | 1M | $1.40 | $4.40 | Ja | Offen (HF) |
| Kimi K3 | Agentisches Coding | 2.8T / 104B | 1M | $3.00 | $15.00 | Ja | "other" |
| Qwen 3.8 Max | Multimodal + Ökosystem | 2.4T / 95B | 1M | $2.00 | $6.00 | Ja (Basis) | qwen3.8-max |
| DeepSeek V4 Pro | Recall bei langem Kontext | 49B-Klasse aktiv | 1M | $0.66-1.32 | $1.98-3.96 | Ja | Offen |
| Claude Opus 5 | Keine Infrastruktur | Nicht angegeben | 1M | $5.00 | $25.00 | Nein | Proprietär |
| GPT-5.6 | Verwaltete API-Stufen | Nicht angegeben | Langkontext-Stufen | $0.20-5.00 | $1.20-30.00 | Nein | Proprietär |
*GLM-5.3-Flash läuft mit einer Launch-Aktion von 50 % ($0.15 / $0.50 Listenpreis), die am 9. September 2026 endet. DeepSeek zeigt Nebenzeit bis Spitzenzeit; ein US-/EU-Zeitplan fällt meist in den günstigeren Nebenzeit-Tarif. Alle Preise laut der Preisseite des jeweiligen Anbieters, geprüft am 30. August 2026.
Das Muster fällt auf, sobald man es nebeneinanderlegt: Die beiden „Flash“-Modelle sind um eine Größenordnung günstiger als die Frontier-Klasse, und die geschlossenen APIs (Opus 5, GPT-5.6) liegen beim Preis oben, verlangen dafür aber sonst nichts von Ihnen. Hier dasselbe Bild als Output-Preis, was bei einem gesprächigen Agenten meist die Rechnung ist, die wirklich weh tut:
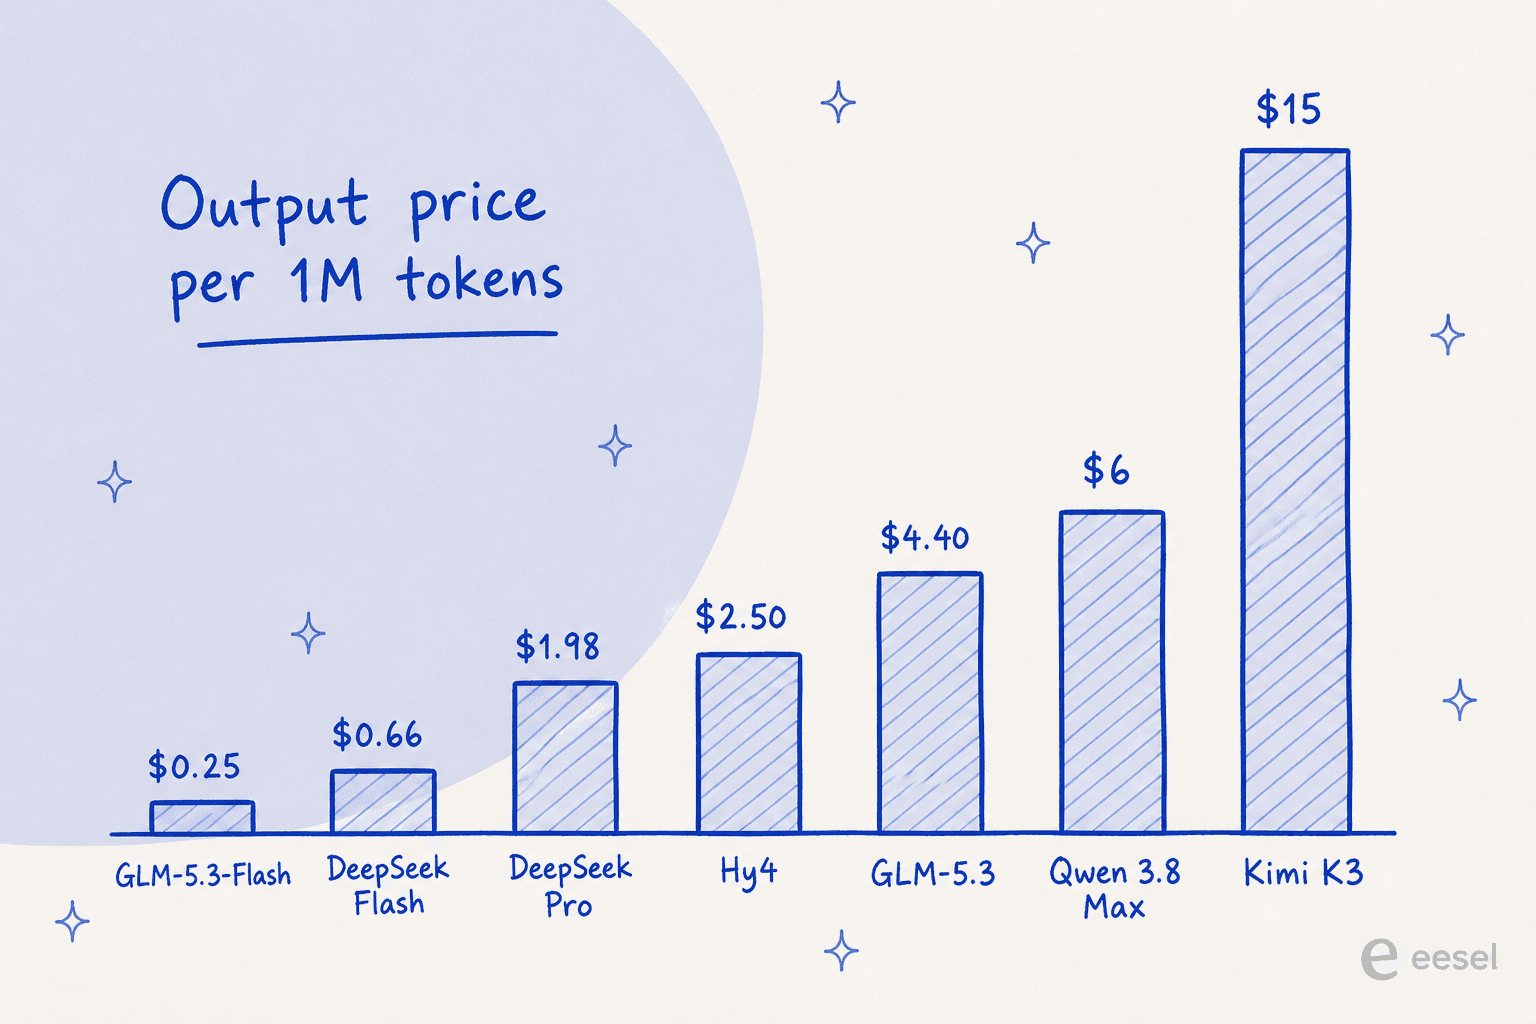
Wenn Sie nicht sicher sind, in welche Ecke der Karte Sie gehören, führt Sie dieses kleine Tool zu einer Wahl.
1. GLM-5.3-Flash
Am besten für: Teams, die Hy4-Qualität auf Hardware wollen, die sie tatsächlich betreiben können, zum niedrigsten realistischen Preis.
Dieses Modell würde ich als Erstes nehmen. GLM-5.3-Flash von Z.ai (früher Zhipu AI) ist ein Mixture-of-Experts-Modell mit 320B Parametern und nur 18B aktiven, und es ist das erste nativ multimodale Modell der GLM-5-Reihe, das Text, Bild und Video verarbeitet. Z.ais Versprechen lautet „Frontier-Intelligenz, Flash-Kosten“, und die Zahlen stützen die zweite Hälfte: Es erreicht 57 im Artificial-Analysis-Intelligenzindex bei etwa $0.045 pro Aufgabe im Rabatt, ein Niveau, das früher etwa das Zehnfache kostete.
Der Grund, warum es für die meisten besser ist als Hy4, ist einfach: Mit 320B gesamt ist es weniger als halb so groß wie Hy4, also deutlich einfacher zu betreiben, und es wurde unauffällig als „ox-alpha“ auf OpenRouter getestet, wo es das meistgenutzte Modell der Woche wurde, komplett auf chinesischen Chips betrieben. Im eigenen Code Bench von Z.ai kommt es auf 29,0 gegenüber 29,5 von Claude Opus 4.8, fast gleichauf.
Vorteile: nativ multimodal (Text, Bild, Video), offene Gewichte auf Hugging Face und mit Abstand das beste Preis-Leistungs-Verhältnis dieser Liste.
Nachteile: Die Benchmark-Vergleiche stammen von Z.ai selbst, und der Schlagzeilenpreis ist eine Launch-Aktion. Z.ai hat kein vollständiges Datenblatt zu Parametern und Kontext so sauber veröffentlicht wie manche Konkurrenten.
Preis: $0.075 Input / $0.25 Output pro 1M während der 50-%-Launch-Aktion (Liste $0.15 / $0.50), Aktion endet am 9. September 2026. Gecachter Input kostet $0.015. Auch im GLM Coding Plan ab $18/Monat enthalten.
Fazit: Wenn Sie nur eine Hy4-Alternative ausprobieren können, nehmen Sie diese. Es ist das seltene Modell, das günstiger und kleiner und multimodal ist, und das Modell, das ich einem Team geben würde, dem Hy4 gefiel, das den Acht-GPU-Server aber nicht rechtfertigen konnte.
2. DeepSeek V4 Flash
Am besten für: die absolut niedrigsten Kosten pro Token und die selbsthosting-freundlichste Lizenz der Gruppe.
DeepSeek V4 Flash ist die Preisuntergrenze, und zwar mit Abstand. Es ist ein Mixture-of-Experts-Modell mit 284B und 13B aktiven Parametern, unter einer echten MIT-Lizenz veröffentlicht, und mit rund 167GB Gewichten ist es das eine Modell der Frontier-Klasse auf dieser Liste, das ein gut ausgestattetes Team tatsächlich zu Hause betreiben kann, für unter 10.000 $. Außerhalb der Spitzenzeit kostet es etwa $0.22 Input / $0.66 Output pro 1M, grob ein Viertel des Output-Preises von Hy4.
Eine Eigenheit sollten Sie kennen: DeepSeeks Preisliste ist nach Tageszeit gestaffelt, mit Spitzenzeiten entlang chinesischer Geschäftszeiten (01:00-04:00 und 06:00-10:00 UTC). Eine US- oder EU-Support-Warteschlange läuft meist in DeepSeeks Nebenzeit, sodass Sie standardmäßig die günstigere Hälfte der Preisliste zahlen. Der einzige ehrliche Kritikpunkt ist die Wortreichheit: Unabhängige Tests zeigen, dass es spürbar mehr Output-Tokens als die Konkurrenz braucht, um zu einer Antwort zu kommen, sodass die Ersparnis pro Token pro Aufgabe etwas schrumpft.
Vorteile: mit großem Abstand am günstigsten, MIT-lizenziert und klein genug zum Selbsthosten.
Nachteile: wortreich (höhere Output-Token-Zahl als die Konkurrenz), und die Bedingungen der kostenpflichtigen DeepSeek-API schweigen zur Nutzung für Training, statt es ausdrücklich auszuschließen, mit Datenhaltung in der VR China. Das ist wichtig, wenn Sie Kundendaten über die First-Party-API leiten.
Preis: Input ohne Cache-Treffer $0.22 in der Nebenzeit / $0.44 in der Spitzenzeit; Output $0.66 / $1.32; Input mit Cache-Treffer ab $0.007, laut der DeepSeek-Preisseite.
Fazit: Wenn die Rechnung den Ausschlag gibt, ist das Ihr Modell. Planen Sie nur seine Geschwätzigkeit ein und halten Sie personenbezogene Kundendaten vom First-Party-Endpunkt fern, solange Sie die Bedingungen nicht sorgfältig gelesen haben.
3. GLM-5.3
Am besten für: das, was Hy4 in der tatsächlichen Qualität am nächsten kommt, vom Modell, gegen das Tencent sich selbst vergleicht.
Als Tencent zeigen wollte, dass Hy4 Frontier-Klasse ist, war GLM-5.3 eines der beiden Modelle, gegen die es antrat, und Hy4 schlug es in Tencents eigener Blindbewertung nur knapp mit 2,99 zu 2,92. Anders gesagt: Wer das Modell sucht, das der realen Qualität von Hy4 am nächsten kommt, findet hier den naheliegenden Kandidaten, und es stammt aus einer Linie mit ernstzunehmender Bilanz beim Langzeit-Coding (der Vorgänger GLM-5.2 war das erste Open-Weights-Modell, das 80 % in Terminal-Bench überschritt).
Beim Input ist es außerdem günstiger als Hy4 und beim Output ungefähr gleichauf, Sie zahlen für ein fast gleichwertiges Modell also keinen Aufschlag. Z.ai veröffentlicht die genaue Parameterzahl von GLM-5.3 nicht so sauber wie manche Konkurrenten, deshalb lasse ich diese Zahl weg, statt einen Aggregator zu zitieren.
Vorteile: der am nächsten gebenchmarkte Konkurrent von Hy4, offene Gewichte, starke Herkunft beim Langzeit-Coding, 1M Kontext sowie OpenAI- und Anthropic-kompatible Endpunkte, sodass es in bestehendes Tooling passt.
Nachteile: Z.ais öffentliches Datenblatt speziell für 5.3 ist bei Gesamt-/aktiven Parametern dünn, und wie Hy4 ist es ein großes Modell zum Selbsthosten.
Preis: $1.40 Input / $4.40 Output pro 1M, gecachter Input $0.26, laut den Z.ai-Preisdokumenten. Auch über den GLM Coding Plan verfügbar.
Fazit: Wenn Ihr Ziel „gib mir Hy4, aber so, dass ich es ohne die Preview-Vorbehalte betreiben kann“ ist, ist GLM-5.3 der sicherste Tausch. Es ist die Eins-zu-eins-Alternative.
4. Kimi K3
Am besten für: lange, werkzeugintensive agentische Coding-Läufe, bei denen Tiefe wichtiger ist als der Preis.
Kimi K3 von Moonshot AI ist hier das größte Modell: 2.8T gesamt, 104B aktiv, mit 1M Token Kontext und offenen Gewichten, die pünktlich erschienen. Im Artificial-Analysis-Intelligenzindex liegt es bei 57, zum Launch im Bereich Platz 4, und es ist das Modell, das Hy4 in Tencents eigenen Paarvergleichen am wenigsten überzeugend schlägt (Hy4 gewinnt nur in 51,2 % der Fälle). Bei langen agentischen Sitzungen ist es wirklich gut.
Wichtig ist: Kimi K3 ist teuer und legt Sie fest. Das Reasoning lässt sich auf keiner Stufe abschalten, und eine niedrigere Stufe macht es nicht günstiger (die Stufen werden zum selben Satz abgerechnet). Mit $3 Input / $15 Output pro 1M liegt es im Bereich von Claude Sonnet, bei einem Cache-Miss grob das 23-Fache des Output-Preises von Hy4. Bei schwierigen, mehrstufigen Aufgaben verdient es das; für einfache Aufrufe ist es übertrieben.
Vorteile: agentische und Coding-Fähigkeiten auf Frontier-Niveau, native Bildverarbeitung, riesiger Kontext von 1M und offene Gewichte auf Hugging Face.
Nachteile: das teuerste Modell dieser Übersicht, keine Möglichkeit, Reasoning abzuschalten, und öffentliche Bild-URLs werden nicht akzeptiert (nur base64 oder Datei-IDs).
Preis: $3.00 Input / $0.30 bei Cache-Treffer / $15.00 Output pro 1M, laut Moonshot. Die Tarife der Consumer-App reichen von kostenlos bis $199/Monat.
Fazit: Greifen Sie zu Kimi K3, wenn die Aufgabe ein wirklich schwieriger, langer Agentenlauf ist und es nur auf Qualität ankommt. Für alles Routinemäßige erledigt eines der günstigeren Modelle oben denselben Job für ein Zehntel der Rechnung.
5. Qwen 3.8 Max
Am besten für: Multimodalität plus das tiefste Ökosystem unter den chinesischen Laboren.
Qwen 3.8 Max von Alibaba ist ein Mixture-of-Experts-Modell mit 2.4T / 95B, das Anfang August allgemein verfügbar wurde, mit 1M Kontext und nativer Bild- und Videoeingabe. Es steht auf dem Artificial-Analysis-Board auf Rang 6 (Index ~58) und ist auch in den WebDev- und Vision-Boards von LMArena stark. Was es von der Masse abhebt, ist das Ökosystem: Qwen hat eine der größten Open-Model-Familien überhaupt, es gibt also für fast jedes Budget ein kleineres Geschwistermodell, und das gehostete Max ergänzt die offene Basis um Vision, einen Nicht-Thinking-Modus und integrierte Tools.
Ein Fairness-Hinweis, den ich immer gebe: Die vollständig offenen Basisgewichte (Qwen3.8-2.4T-A95B) sind erschienen, aber sie sind nicht funktionsgleich mit dem gehosteten Max, das Vision-Eingabe und 1M Standardkontext hinzufügt. Und das freizügige, Apache-lizenzierte Mitglied der Familie ist das kleinere Qwen3.8-27B, nicht Max selbst.
Vorteile: nativ multimodal, riesige und gut unterstützte Modellfamilie, ein echtes Tool-Ökosystem und offene Basisgewichte.
Nachteile: Die Max-Lizenz ist nicht Apache, gehostete und offene Version unterscheiden sich in den Fähigkeiten, und mit $6 Output ist es teurer als die GLM- und DeepSeek-Optionen.
Preis: $2.00 Input / $6.00 Output pro 1M, impliziter Cache $0.25, laut QwenCloud.
Fazit: Wählen Sie Qwen 3.8 Max, wenn Ihnen multimodale Eingabe plus eine breite Modellfamilie wichtig ist oder wenn Sie über viele Modellgrößen hinweg auf ein Labor standardisieren wollen. Beim reinen Preis-Leistungs-Verhältnis liegt GLM-5.3-Flash weiterhin vorn.
6. DeepSeek V4 Pro
Am besten für: Recall bei langem Kontext und Nadel-im-Heuhaufen-Suche, wo das kleinere Flash-Modell an Grenzen stößt.
Wenn DeepSeek V4 Flash die Budget-Wahl ist, dann ist DeepSeek V4 Pro die Recall-Wahl. Es hat mehr aktive Parameter (49B-Klasse) als Flash, und das zeigt sich dort, wo es zählt: In DeepSeeks eigener Tabelle über beide Modi liegt Pro vor Flash bei SimpleQA-Verified (57,9 gegenüber 34,1) und beim Finden von Nadeln im 1M-Kontext. Auch das Ranking nach menschlicher Präferenz bei LMArena setzt Pro weiter über Flash. Das ist das Modell für den Fall, dass die Aufgabe darin besteht, ein sehr langes Dokument zu lesen und einen präzisen Fakt zurückzubekommen.
Eine Falle nenne ich allen, die Effort-Stufen routen: DeepSeeks veröffentlichte Zuordnung bedient eine low-Anfrage bei Pro mit high, einen günstigen Pro-Lauf gibt es also nicht, Sie zahlen den vollen Satz und können das Reasoning nicht herunterregeln. Wenn Kostenkontrolle wichtig ist, ist das ein Grund, bei Flash zu bleiben, außer Sie brauchen gezielt den Recall von Pro.
Vorteile: stärkerer Recall und bessere Retrieval-Leistung bei langem Kontext als Flash, weiterhin offene Gewichte, weiterhin dieselbe tageszeitabhängige Preisgestaltung, die nicht-chinesische Zeitpläne begünstigt.
Nachteile: Sie können keine günstige Pro-Anfrage mit niedrigem Effort fahren, und es kostet bei Cache-Miss etwa das Dreifache von Flash.
Preis: Input ohne Cache-Treffer $0.66 in der Nebenzeit / $1.32 in der Spitzenzeit; Output $1.98 / $3.96, laut der DeepSeek-Preisseite.
Fazit: Die meisten Teams sollten mit Flash starten und nur für die konkreten Workloads auf Pro wechseln (Fragen zu langen Dokumenten, präziser Recall), bei denen Flash sichtbar zu kurz greift. Zahlen Sie nicht pauschal für Pro.
7. Claude Opus 5
Am besten für: Teams, die erstklassige Qualität wollen und null Infrastruktur betreiben möchten.
Hier die ehrliche Neubetrachtung: Für viele Teams ist die echte Alternative zu einem Open-Weight-Modell mit 770B nicht ein anderes Open-Weight-Modell, sondern gar keins zu betreiben. Claude Opus 5 ist Anthropics Flaggschiff, es liegt auf Platz 1 des Intelligenzindex (knapp, bei 61-63 je nach Stand), und es gibt nichts, was Sie in den Speicher laden müssten. Sie rufen eine API auf und bekommen eine Frontier-Antwort.
Der Kompromiss sind Preis und Offenheit. Mit $5 Input / $25 Output pro 1M ist es um eine Größenordnung teurer als die Open-Weight-Optionen, und es gibt keine Gewichte zum Selbsthosten. Die Community weist außerdem darauf hin, dass Opus 5 bei gleichem Effort tendenziell mehr Output-Tokens verbraucht als sein Vorgänger, die Kosten pro Aufgabe sind also trotz gleichem Listenpreis gestiegen, auch wenn das Gegenargument die Kosten pro erfolgreicher Aufgabe ist. Es ist nicht die günstige Wahl, sondern die unkomplizierte Wahl an der Spitze des Leaderboards.
Vorteile: führende Frontier-Qualität, 1M Kontext ohne Langkontext-Aufschlag und keine Infrastruktur, die Sie betreiben müssen.
Nachteile: pro Token deutlich teurer als die offenen Modelle, geschlossene Gewichte, und bei hohem Effort kann es wortreich sein.
Preis: $5 Input / $25 Output pro 1M (unverändert gegenüber Opus 4.8), Batch mit 50 % Rabatt und Cache-Lesezugriffe mit 0,1x, laut Anthropic.
Fazit: Wenn Ihr Engpass Engineering-Zeit statt Token-Budget ist, ist Opus 5 die saubere Antwort. Sie tauschen Geld gegen den Vorteil, nie wieder an GPUs denken zu müssen.
8. GPT-5.6
Am besten für: eine verwaltete API mit gestaffeltem Angebot, damit Sie pro Aufruf Kosten gegen Leistung abwägen können.
Die andere Antwort per verwalteter API ist GPT-5.6, und seine Stärke ist die Bandbreite. Statt eines Preises liefert OpenAI eine Leiter: gpt-5.6-luna zu $0.20 Input / $1.20 Output pro 1M für günstige Arbeit mit hohem Volumen, gpt-5.6-terra zu $2 / $12 in der Mitte und gpt-5.6-sol zu $5 / $30 an der Spitze. So können Sie das Modell zur Aufgabe passen lassen, statt für jeden Aufruf Flaggschiff-Preise zu zahlen, was ein wirklich nützlicher Hebel ist, wenn Ihr Traffic aus einer Mischung leichter und schwerer Anfragen besteht.
Die eine strukturelle Falle, die Sie einpreisen sollten: OpenAI berechnet eine Langkontext-Stufe mit Faktor 2, sobald Sie die Kontextschwelle überschreiten, dasselbe Muster wie bei xAI (und eines, das Anthropic und Google nicht nutzen). Wenn Ihre Workload viel langen Kontext enthält, liegt der effektive Satz also über dem Schlagzeilenpreis. GPT-5.6 Sol liegt im Intelligenzindex außerdem knapp hinter Opus 5, es ist also eine echte Frontier-Option und kein Budget-Ersatz.
Vorteile: ein gestaffeltes Angebot, mit dem Sie die Kosten pro Aufruf steuern, ein ausgereiftes API- und Tooling-Ökosystem und keine Infrastruktur, die Sie betreiben müssen.
Nachteile: geschlossene Gewichte, und die Langkontext-Stufe verdoppelt den Satz bei Aufrufen mit großem Kontext grob.
Preis: von $0.20 / $1.20 (luna) bis $5 / $30 (sol) pro 1M, mit Langkontext-Multiplikator, laut OpenAI.
Fazit: Wenn Ihnen die Idee einer verwalteten API gefällt, der Pauschalpreis von Opus 5 aber für Ihren einfachen Traffic zu schwer wirkt, sind die Stufen von GPT-5.6 die flexiblere Wahl. Rechnen Sie nur den Langkontext-Aufschlag durch, bevor Sie sich festlegen.
Die zwei Familien in einem Bild
Wenn Sie einen Schritt zurücktreten, fällt jede Option hier in eines von zwei Lagern: offene Gewichte, die Sie betreiben oder günstig mieten können, und verwaltete APIs, bei denen Sie nichts betreiben. Mit dieser Karte würde ich einem Kollegen die Wahl in zehn Sekunden erklären.
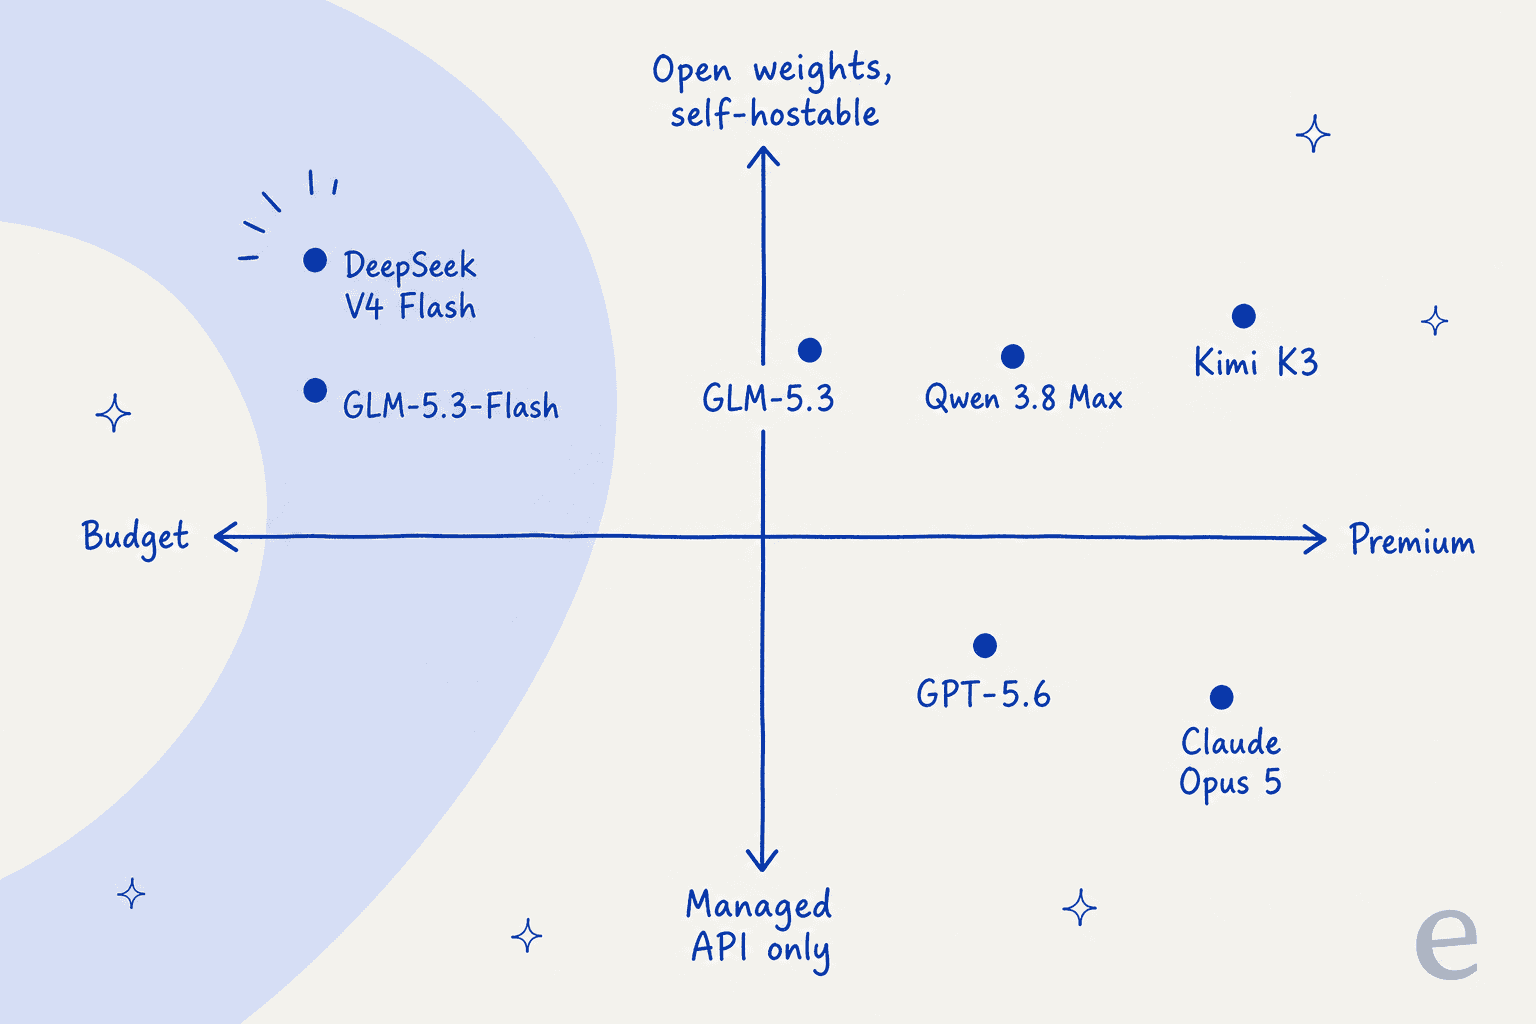
Wenn Kontrolle und Kosten Sie von Hy4 weggetrieben haben, bleiben Sie in der oberen Open-Weight-Reihe und starten Sie mit GLM-5.3-Flash oder DeepSeek V4 Flash. Wenn es der schiere Aufwand war, ein Modell mit 770B zu betreiben, wechseln Sie in die verwaltete Reihe und lassen Anthropic oder OpenAI die Infrastruktur tragen.
eesel ausprobieren
Eines haben alle Modelle auf dieser Liste gemeinsam: Sie sind reine Infrastruktur. Hy4 oder eine Alternative zu wählen heißt, einen Motor zu wählen. Das Auto drumherum müssen Sie noch bauen: die Anbindung an Ihr Help Center, die Guardrails, die Integrationen und eine Möglichkeit zum Testen, bevor es einem echten Kunden antwortet.
Wenn Sie Modelle wegen des Kundensupports vergleichen, spart eesel diesen ganzen Aufbau. Es ist ein KI-Helpdesk-Teammitglied, das bereits auf Frontier-Modellen läuft, Sie erben die Modellqualität also, ohne je eines auszuwählen, zu hosten oder in VRAM unterzubringen. Es verbindet sich mit Tools wie Zendesk, Freshdesk und Slack, lernt aus Ihren vergangenen Tickets und Ihrem Help Center und, das ist mir als jemandem, der selbstsichere Bots mit selbstsicher falschen Antworten gesehen hat, am wichtigsten, es lässt Sie auf Tausenden Ihrer echten historischen Tickets simulieren, bevor es jemandem live antwortet.

Wenn Sie also beim Vergleich von Modellen für einen Support-Agenten hier gelandet sind, lohnt sich die Frage, ob Sie überhaupt das Modell brauchen oder das fertige Teammitglied. Sie können eesel kostenlos testen, und es verbindet sich in wenigen Minuten mit Ihrem bestehenden Helpdesk.