

Tencent Hy4 preview hat zwei Preise, und der, den alle nennen, ist der kleinere. Über die API kostet es $0.834 pro Million Input-Tokens und $2.501 pro Million Output-Tokens, gecachter Input kostet $0.042 (offizielle Ankündigung). Unter den Flaggschiff-Open-Weight-Modellen, mit denen es sich vergleicht, ist das der günstige Platz.
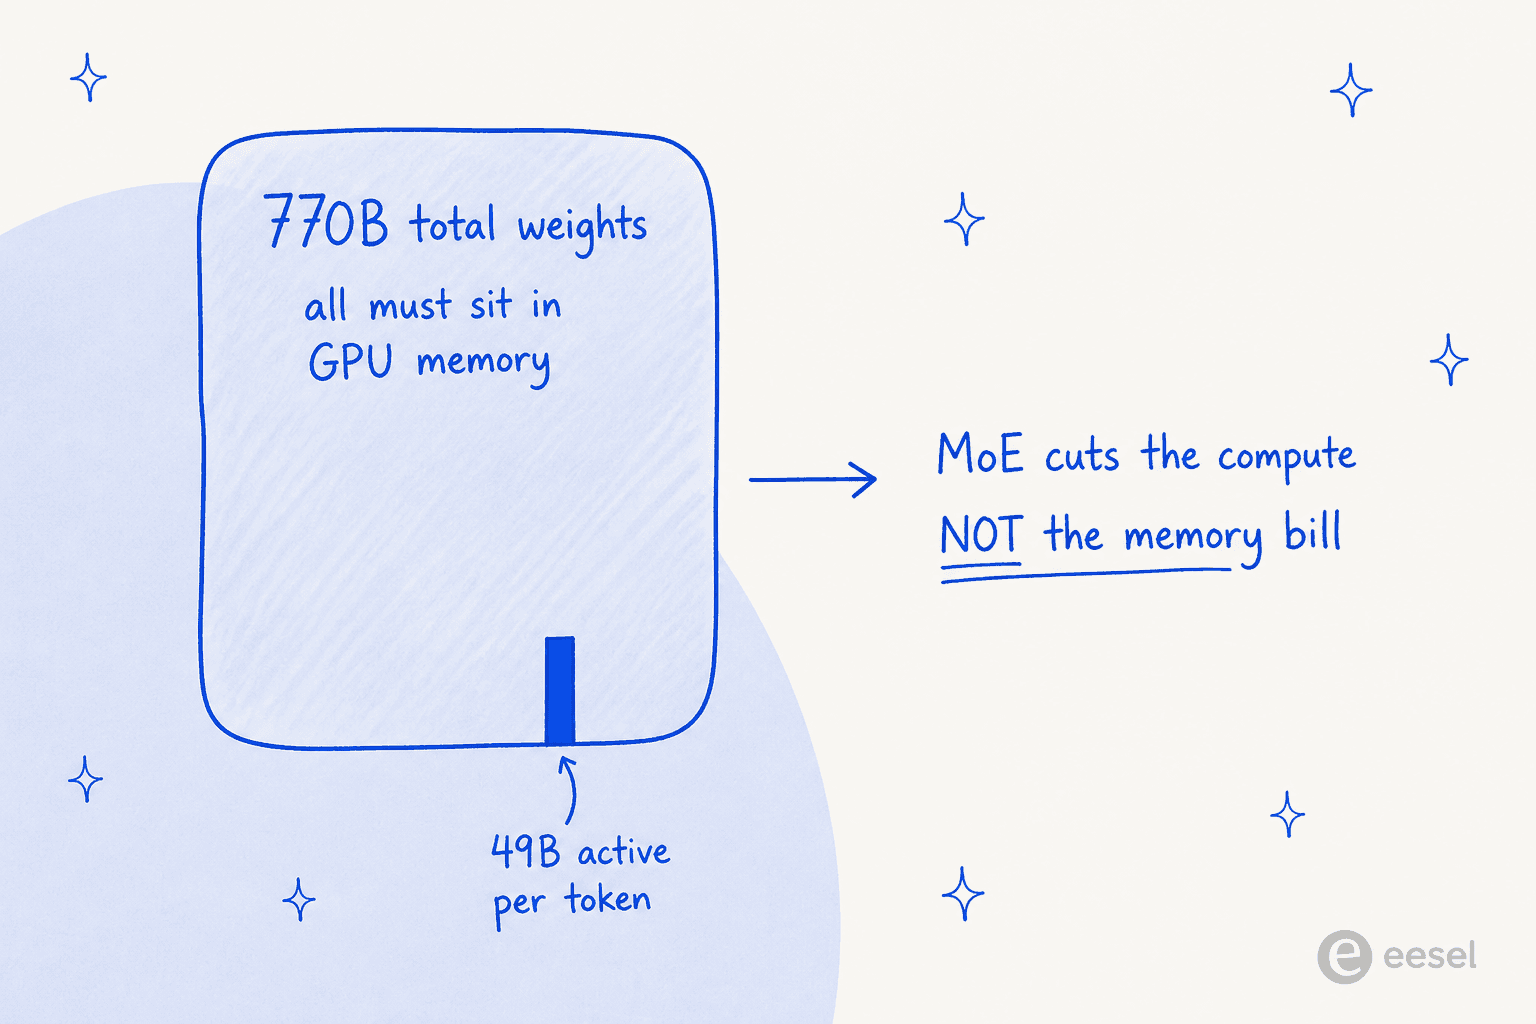
Die größere Zahl ist die Hardware. Hy4 ist ein Mixture-of-Experts-Modell mit 770B Parametern, und MoE senkt die Rechenlast pro Token, nicht die Speicherrechnung. Alle 770B Gewichte müssen also gleichzeitig im GPU-Speicher liegen. Der Eigenbetrieb bedeutet 16x B200 oder 8x B300, ein Rechenzentrumsknoten, keine Workstation.
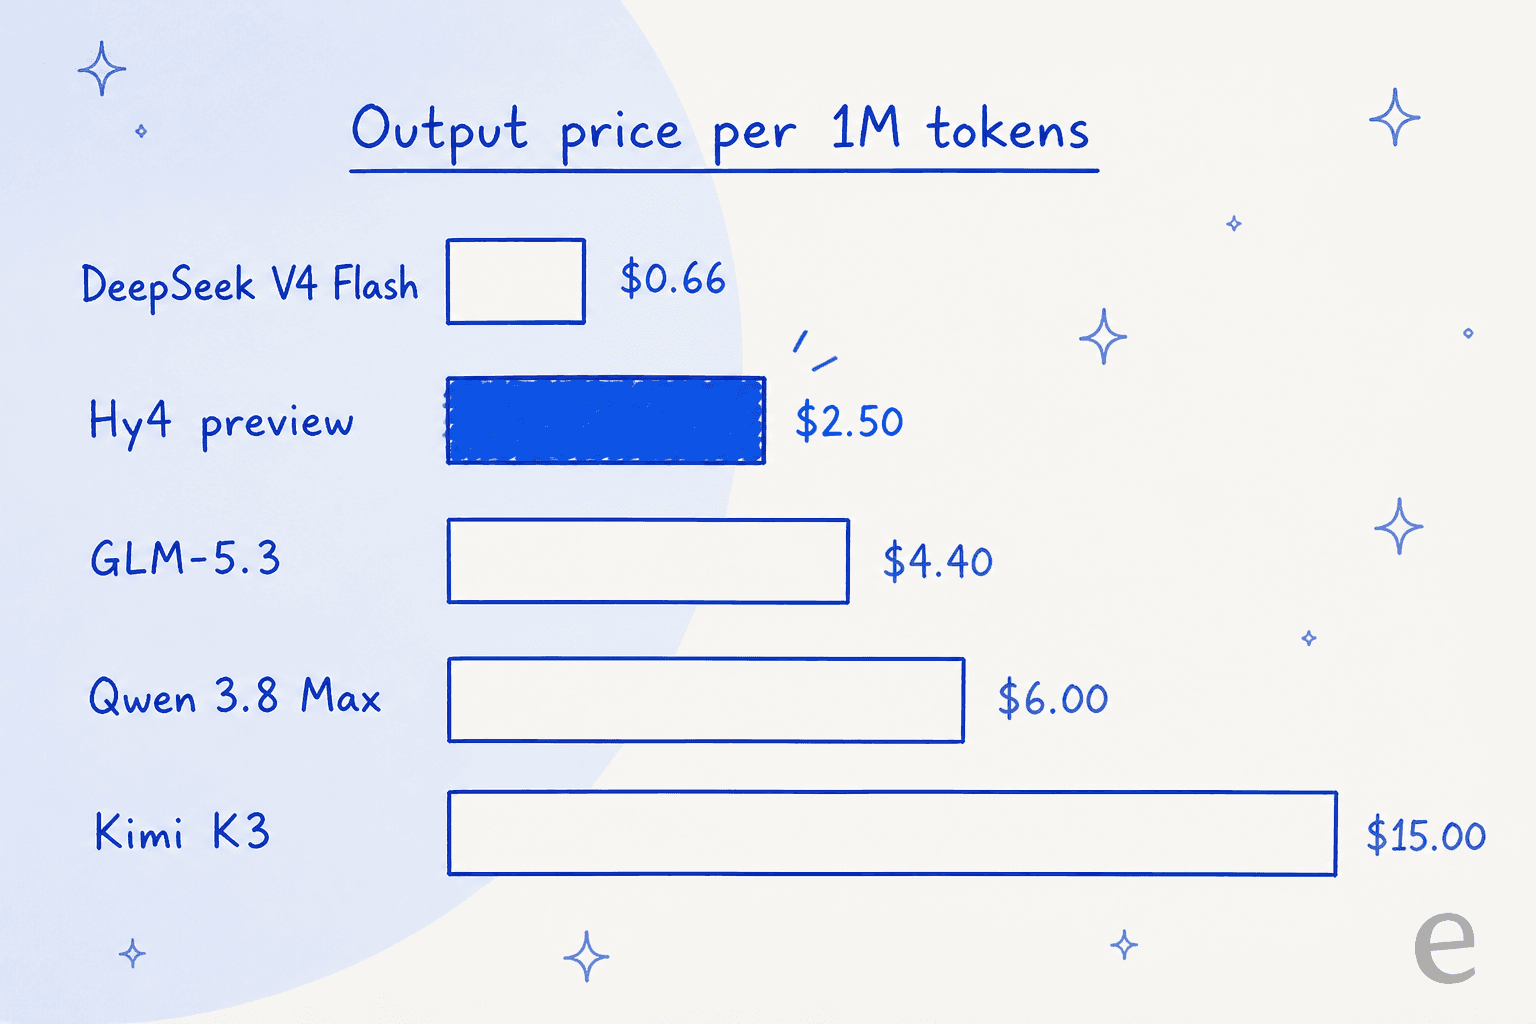
Das ehrliche Fazit zu den Tencent Hy4 Preisen: Über die API gemietet ist es wettbewerbsfähig bepreist, günstiger als Kimi K3 oder Qwen 3.8 Max, auch wenn DeepSeek V4 Flash noch deutlich günstiger ist. Wer es besitzen will, steht vor einem ernsten Investitionsposten. Und es ist 5-6x teurer als das Hy3, das es ablöst, also sollten Bestandsnutzer kein kostenloses Upgrade erwarten.
Wenn Sie eigentlich eine erledigte Aufgabe wollen statt eines bereitgestellten Modells, ist ein fertiger KI-Teamkollege ein kürzerer und oft günstigerer Weg als alles hier.
Tencent Hy4 API-Preise auf einen Blick
Ich verbringe den Großteil meiner Woche damit, darüber nachzudenken, wie Käufer tatsächlich nach Tools wie diesem suchen, und "Tencent Hy4 Preise" sind fast immer zwei Fragen in einer: Was kostet ein Token, und was kostet das Ganze im Betrieb? Nehmen wir zuerst die Token-Frage, denn sie ist die einfache.
Hier sind die veröffentlichten API-Tarife direkt aus Tencents Launch-Ankündigung, alle pro Million Tokens:
| Zähler | Preis pro 1M Tokens | Was er abdeckt |
|---|---|---|
| Input | $0.834 | Jedes Token, das Sie senden (Prompt, Kontext, abgerufene Dokumente) |
| Output | $2.501 | Jedes Token, das das Modell zurückgibt |
| Gecachter Input | $0.042 | Input-Tokens, die bei einem wiederholten Prompt aus dem Cache kommen |
Drei Dinge aus dieser Tabelle sind hervorzuheben.
Erstens liegt das Verhältnis von Output zu Input bei etwa 3:1, was für ein Modell mit viel Reasoning normal ist. Da Hy4 ein starker Reasoner ist (mehr dazu unten), neigen Ihre Rechnungen zum Output-Zähler, also ist die Zahl $2.501 diejenige, mit der Sie planen sollten, nicht die Schlagzeile $0.834.
Zweitens ist der Cache-Tarif mit $0.042 sehr günstig. Wenn Ihr Workload einen großen System-Prompt oder eine feste Wissensbasis über viele Aufrufe wiederholt, was bei den meisten agentischen Workloads der Fall ist, senken Cache-Treffer den effektiven Input-Preis um etwa das 20-Fache. Das ist ein echter Hebel, und er unterscheidet einen gut gebauten KI-Agenten von einem regelbasierten Chatbot oder einem naiven Wrapper, der für jedes Token den vollen Preis zahlt.
Drittens gibt es keinen dauerhaften kostenlosen Tarif. Die Testphase ist befristet (zwei Wochen in Tencents eigenen Apps), danach wird jedes Token abgerechnet.
Ihre monatliche Tencent Hy4 Rechnung schätzen
Tarife pro Million Tokens sind schwer greifbar. Geben Sie ein grobes monatliches Volumen ein und sehen Sie, was Hy4 im Vergleich zu den anderen Flaggschiff-Open-Modellen kostet. Der Rechner nimmt für jedes Modell die Standardtarife ohne Cache an.
Der Preis, den niemand nennt: der Eigenbetrieb
Hier wird "Open Weights" teuer, und es ist das Wichtigste, was Sie verstehen sollten, bevor Sie sich über Hy4 als Open Source freuen. Die Apache-2.0-Lizenz bedeutet, dass Sie es überall betreiben dürfen. Die Hardware entscheidet, ob Sie es können, und was es kostet.
Das vLLM-Rezept ist deutlich bei der Untergrenze. Die vollen BF16-Gewichte umfassen etwa 1.848 GB. Selbst die quantisierten MXFP8-Gewichte sind ~924 GB. Das eigene Minimum des Rezepts: "16xB200 or 8xB300 minimum for weights + KV cache." Ein einzelner 8x-H100-Knoten (640 GB) kann es nicht aufnehmen.
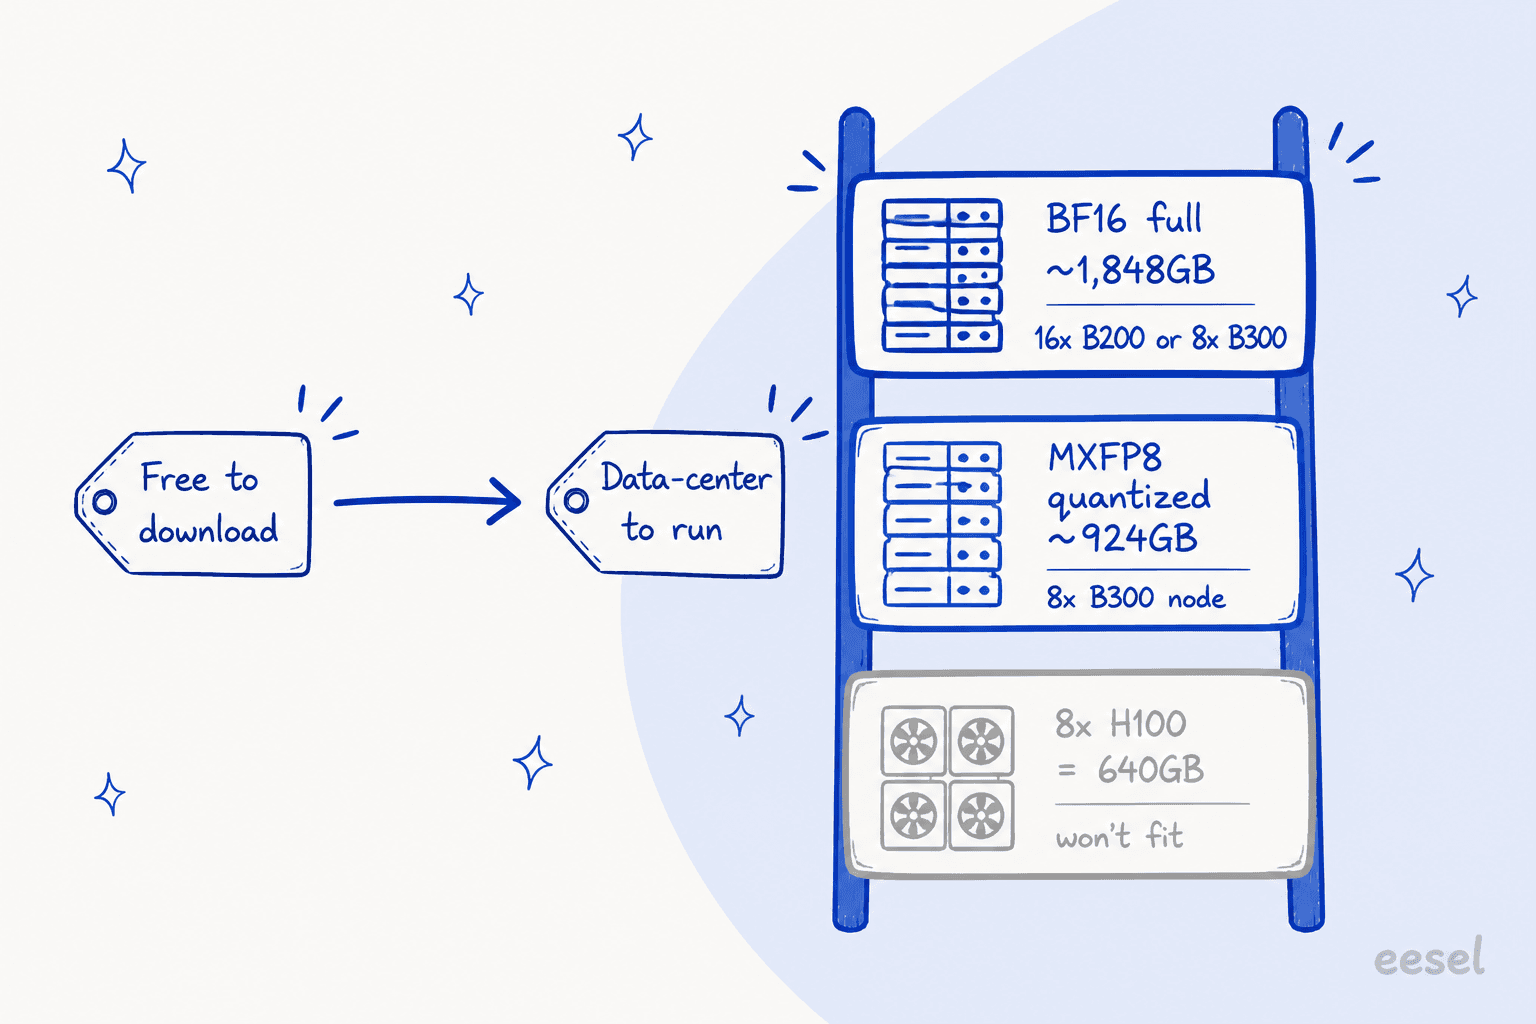
Setzen wir grobe Zahlen darauf. Einen 8x-B200-Knoten bei einem Cloud-GPU-Anbieter zu mieten kostet in der Größenordnung von zehntausenden Dollar im Monat, und das volle BF16-Rezept braucht zwei davon. Das Silizium direkt zu kaufen ist eine sechsstellige Investition, noch bevor Sie es einschalten. Das ist der echte Tencent Hy4 Preis für jeden, der seine Inferenz selbst besitzen will, und er übersteigt den Token-Tarif bei Weitem, es sei denn, Sie fahren die Maschine mit sehr hoher Auslastung.
Die Community von r/LocalLLaMA, die große Modelle als Hobby zu Hause betreibt, reagierte mit gleichen Teilen Bewunderung und Resignation:
The amount of people who can drop $5-10k to run these locally is vanishingly small.

Die Quantisierungsrechnung, die sie angestellt haben, ist nützlich, falls Sie in Versuchung geraten. Ein Q4-GGUF liegt bei etwa 450 GB, also sind 512 GB Speicher das realistische Minimum, und eine Maschine mit 256 GB passt nur zu den 1-2-Bit-Quantisierungen. Eine ausführliche Aufschlüsselung sagt es klar: Wenn Sie 256 GB haben, sind Sie mit GLM-5.3-Flash deutlich besser bedient. Für die lokale Nutzung gewinnt weiterhin ein kleineres, gut nachtrainiertes Modell das Kostenargument.
Die Erkenntnis zu den Preisen: Für fast alle bedeutet "Hy4 nutzen" die API. Self-Hosting ist ein Rechenzentrumsprojekt, kein Budgetposten.
Tencent Hy4 Preise im Vergleich zu den anderen Open-Weight-Flaggschiffen
So steht Hy4 gegenüber seinen Konkurrenten da, alles pro Million Tokens, geprüft am 30. August 2026.
| Modell | Parameter gesamt / aktiv | Kontext | Input | Output | Input bei Cache-Treffer |
|---|---|---|---|---|---|
| Hy4 preview (Tencent) | 770B / 49B | 1M | $0.834 | $2.501 | $0.042 |
| DeepSeek V4 Flash | 284B / 13B | 1M | $0.22 / $0.44 | $0.66 / $1.32 | $0.007 |
| DeepSeek V4 Pro | 49B-class active | 1M | $0.66 / $1.32 | $1.98 / $3.96 | $0.022 |
| Qwen 3.8 Max | 2.4T / 95B | 1M | $2.00 | $6.00 | $0.25 |
| Kimi K3 | 2.8T / 104B | 1M | $3.00 | $15.00 | $0.30 |
| GLM-5.3 | nicht offengelegt | k. A. | $1.40 | $4.40 | $0.26 |
Das Diagramm erzählt dieselbe Geschichte schneller. Beim Zähler, der die meisten Rechnungen dominiert, dem Output, ist Hy4 die zweitgünstigste Option dieser Gruppe, nur hinter DeepSeek V4 Flash.
Zwei ehrliche Einschränkungen gehören zu dieser Preisgestaltung.
Erstens ist Hy4 etwa 5-6x teurer als Hy3, wie im Community-Preis-Thread angemerkt. Wenn Sie bereits Hy3 nutzen, ist das ein echter Kostensprung, kein Rabatt, und Sie sollten entscheiden, ob die zusätzliche Leistung Ihr Ergebnis verändert.
Zweitens ist DeepSeek V4 Flash bei beiden Zählern dramatisch günstiger, und bei vielen agentischen Aufgaben gewinnt "günstig und gut genug". Ein Entwickler sagte es nach einem echten Test unverblümt:
even mimo 2.5 was same good and on 1/20 of the costs... the model is interesting if the price is lower but not for 2.5 USD per million output.
Das ist der Kern der Preisposition von Hy4: Es ist nicht das günstigste und will es auch nicht sein. Es ist die Option im mittleren Preisbereich, die Ihnen Coding-Werte auf Frontier-Niveau und 1M Kontext bietet. Ob das den Aufpreis gegenüber DeepSeek oder einem Flash-Modell wert ist, hängt ganz davon ab, wie stark die zusätzliche Qualität Ihre Zahlen bewegt.
Hy4 günstig (oder kostenlos) ausprobieren
Wenn Sie das Modell testen wollen, bevor Sie ein Budget binden, gibt es ein paar günstige Wege:
- Zwei Wochen kostenlos ab Start in Tencents Apps WorkBuddy und CodeBuddy. Keine Token-Kosten im Zeitfenster.
- OpenRouter, das Hy4 preview mit einer Zero-Retention-Datenrichtlinie listet. Praktisch, wenn Sie einen einzigen API-Schlüssel für viele Modelle möchten und auf Datenschutz achten.
- Tencent Cloud TokenHub, der Erstanbieter-Weg, wenn Sie bereits in Tencents Cloud sind.
Für die meisten Käufer ist es klug, einen kleinen Pilot im kostenlosen Zeitfenster zu fahren, die tatsächliche Aufteilung zwischen Input und Output zu messen (nutzen Sie dafür den Rechner oben mit diesen Zahlen) und erst dann zu entscheiden, ob der Tarif von Hy4 für Ihren konkreten Workload ein günstigeres Modell schlägt.
Was der Preis von Hy4 tatsächlich bringt, und wo er verpufft
Noch eine Preisnuance, die auf der Preisliste nicht auftaucht. Tencent gibt offen zu, dass diese Preview länger als nötig nachdenkt und ihre eigene Arbeit zu stark verifiziert. Bei einem Modell mit Token-Abrechnung bläht ein Over-Reasoner Ihre Rechnung unbemerkt auf, denn Sie zahlen für jedes dieser zusätzlichen Output-Tokens. Die effektiven Kosten von Hy4 für eine gesprächige, verifikationslastige Aufgabe können also höher ausfallen, als der Listenpreis vermuten lässt, und genau das zeigt sich erst im Live-Betrieb.
Diese Lücke beschäftigt mich immer wieder. Ein roher Modelltarif sagt Ihnen, was ein Token kostet. Er sagt nicht, wie viele Tokens die Aufgabe braucht, ob Ihre Prompts den Cache treffen, wie viel Sie für Wiederholungen ausgeben oder was die Entwicklungszeit für die gesamte Anbindung wert ist. Diese Zahlen entscheiden über die echte Rechnung, und sie zeigt weder ein Benchmark noch eine Preistabelle.
Wenn Sie den tieferen Spezifikations- und Benchmark-Kontext hinter diesen Preisen möchten, behandeln der vollständige Tencent Hy4 Test und die Hy4-Übersicht, wofür Sie bezahlen.
Und wenn Sie rein nach Kosten abwägen, sind diese Aufschlüsselungen die natürlichen nächsten Lektüren:
- Qwen 3.8 Max Preise
- Kimi K3 Preise und der Kimi K3 Test
- Gemini Preise
- Mistral Preise
- DeepSeek V4, die aktuelle Preisuntergrenze
eesel testen: den Teamkollegen einstellen, die Token-Rechnerei überspringen
So sehe ich es nach Jahren, in denen ich Teams beim Modelleinkauf beobachtet habe. Ein Modell wie Hy4 ist Infrastruktur, ein Motor ohne Auto drumherum. eesel AI ist der Mitarbeiter. Statt ein Modell auszuwählen, GPUs bereitzustellen, Tokens zu messen und Retrieval, Guardrails, Integrationen und Evals selbst zu bauen, stellen Sie einen einsatzbereiten KI-Teamkollegen für eine bestimmte Aufgabe ein, und er kommt schon mit dem Wissen, wie sie geht.

Derzeit besteht das Team aus zwei Teamkollegen. Der KI-Helpdesk-Teamkollege tritt Ihrer bestehenden Warteschlange in Zendesk, Freshdesk oder einem gemeinsamen Posteingang bei, trainiert auf Ihren bisherigen Tickets und Ihrem Help Center und entwirft oder sendet Antworten. Sie können ihn gegen historische Tickets simulieren, bevor er auch nur einem Kunden antwortet, sodass Sie Kosten und Verhalten vorab kennen, statt einen Schalter umzulegen und zu hoffen. Der KI-Blog-Autor übernimmt Recherche, Schreiben und SEO für einen langen Beitrag in einem Durchlauf.
Beide laufen unter der Haube auf Frontier-Modellen, Sie bekommen also die Leistung, ohne eine einzige GPU bereitzustellen oder einen Tarifzettel zu lesen. eesels eigene feste monatliche Preise (ab $299/Monat für 500 Credits) sind eine planbare Zahl statt eines rohen Token-Zählers, den Sie prognostizieren müssen. Sie können kostenlos starten, ohne Kreditkarte und ohne Verkaufsgespräch.
Möchten Sie die Ende-zu-Ende-Rechnung statt eines Tarifs pro Token? Diese Artikel machen es konkret: