

Tencent Hy4 Preview ist ein beeindruckendes Open-Weight-Modell, das man für die meisten Menschen eher mietet als selbst betreibt. Es ist ein Mixture-of-Experts-Modell mit 770B Gesamtparametern, 49B aktiven pro Token und einem Kontextfenster von 1M Tokens, am 28. August 2026 als Open-Weight-Modell unter Apache 2.0 auf Hugging Face veröffentlicht.
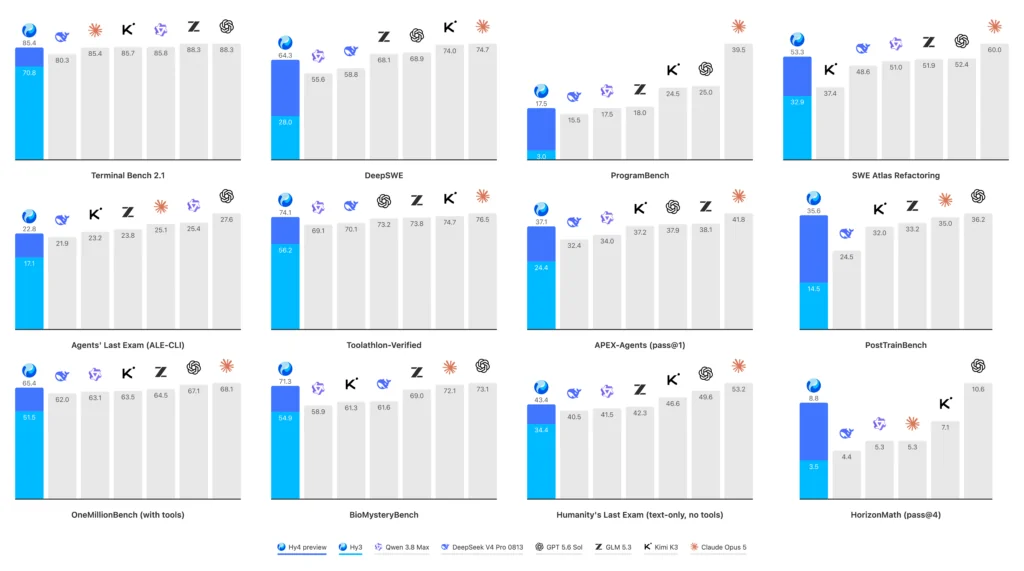
Bei den Benchmarks landet es in der Spitzengruppe der offenen Modelle: 92,3 bei GPQA Diamond, 82,9 % bei SWE-bench Multilingual und in Tencents eigener Blindbewertung knapp vor Kimi K3 und GLM-5.3. Aber das eigene veröffentlichte Diagramm zeigt, dass es sich Siege und Niederlagen mit diesen Konkurrenten teilt, also ist „auf Augenhöhe mit den besten offenen Modellen" die ehrliche Lesart, nicht „schlägt alle".
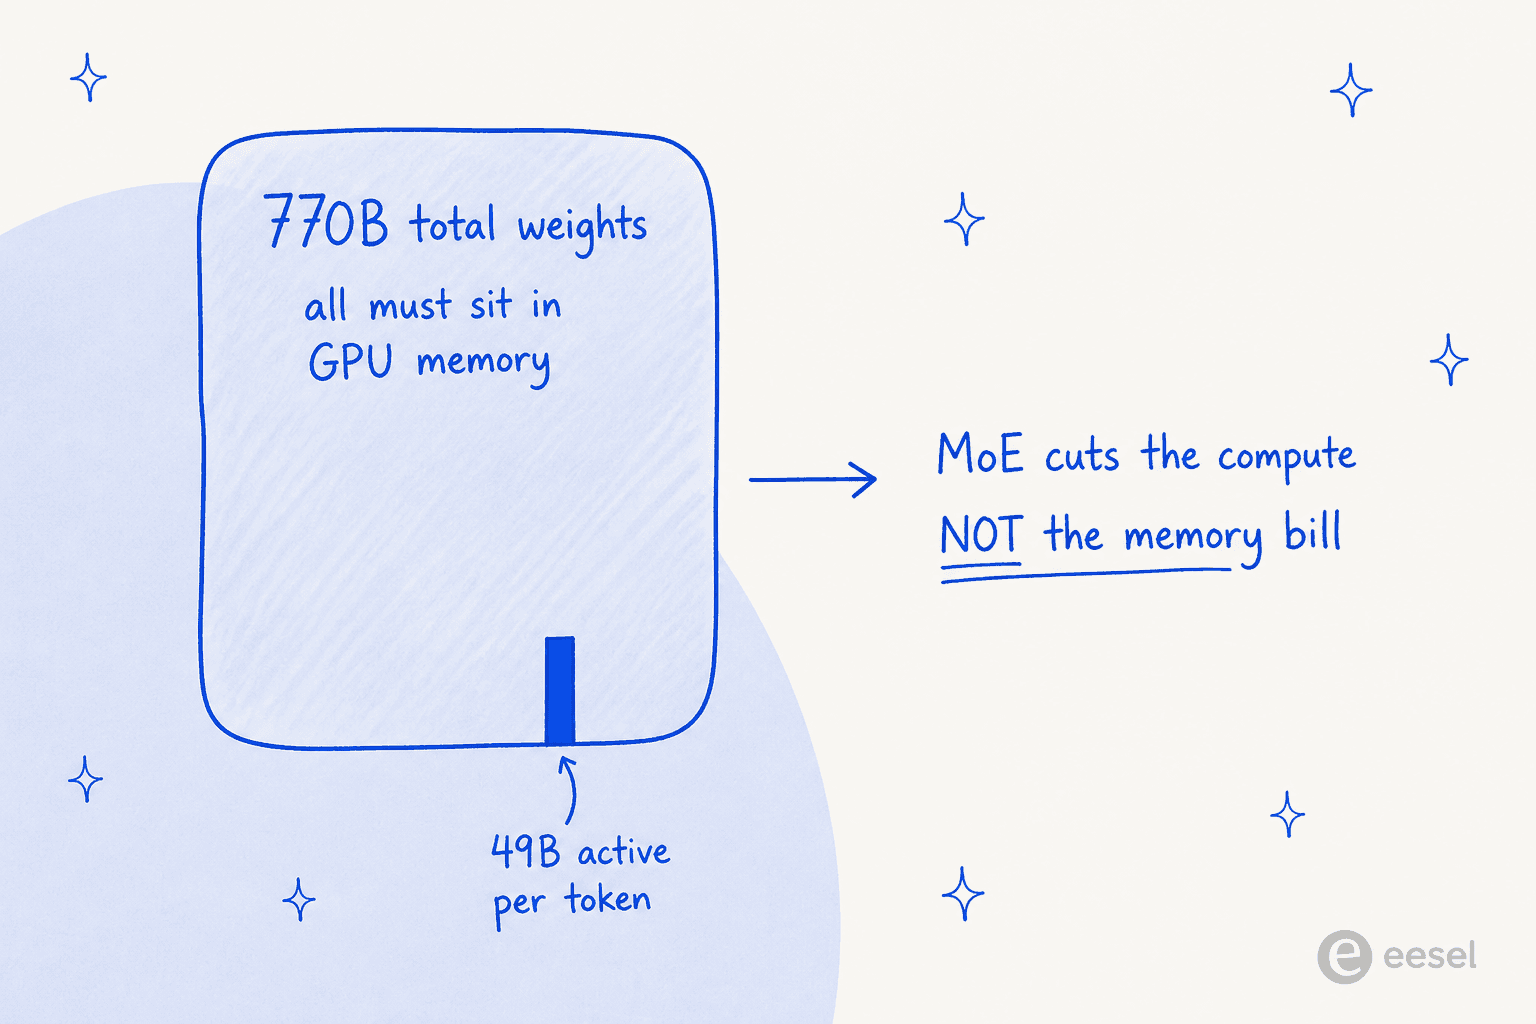
Der Haken ist der Betrieb. MoE senkt den Rechenaufwand pro Token, nicht die Speicherrechnung: Alle 770B Gewichte müssen im GPU-Speicher liegen, für das volle Modell brauchen Sie also 16x B200 oder 8x B300. Über die API kostet es $0,834 Input / $2,501 Output pro Million Tokens, das unterbietet Qwen 3.8 Max und Kimi K3, ist aber 5-6x teurer als das ersetzte Hy3, und DeepSeek V4 Flash ist weiterhin deutlich günstiger.
Für wen ist es? Für Teams, die agentische Coding- oder Recherche-Tools bauen, offene Gewichte und eine freizügige Lizenz wollen und die Hardware haben (oder mieten). Wenn Sie nur das Ergebnis wollen, ein beantwortetes Support-Ticket oder einen geschriebenen Blogbeitrag, ist ein fertiges KI-Teammitglied der kürzere Weg, als selbst ein 770B-Modell aufzusetzen.
Was Tencent tatsächlich veröffentlicht hat
Ich baue beruflich die KI-Agenten, die auf solchen Modellen aufsetzen, daher ist ein neues Open-Weight-Flaggschiff der Teil meiner Woche, auf den ich mich wirklich freue. Ich habe in den letzten Jahren beobachtet, was ein Modell, das in Demos glänzt, von einem unterscheidet, das eine echte Produktions-Warteschlange übersteht, und Hy4 ist ein guter Test für diese Lücke.
Hier die Kurzfassung. Tencents Hunyuan-Team hat Hy4 Preview am 28. August 2026 veröffentlicht und als Open Source freigegeben und positioniert es als „built for real-world productivity tasks... across coding, office work, and scientific research." Es ist der Nachfolger der Hy3-Reihe vom Juli, und Tencent liefert es nach dem Muster „erst Preview, später offizielles Release" aus, wie schon zuvor.
Die wichtigsten Specs, direkt von der Modellkarte:
- 770B Gesamtparameter, 49B aktiv pro Token (ein Mixture-of-Experts-Design).
- 78 Layer, mit 256 geroutetem Experten plus 1 geteiltem Experten; jedes Token aktiviert die Top-8 der gerouteten Experten.
- Kontextfenster von 1M Tokens.
- Apache-2.0-Lizenz, mit einem BF16-Modell und einem offiziellen FP8-quantisierten Build, die zusammen ausgeliefert werden.
Ein Detail fand ich interessant: Tencent sagt, Hy4 habe an der eigenen Entwicklung mitgewirkt, indem es Experimente zu Trainingsmethoden und Low-Level-Operatoren vorgeschlagen und durchgeführt hat, und dass es seinen eigenen Inferenz-Stack autonom optimiert hat, was einen Durchsatzgewinn von 31,8 % brachte. Tencent nennt das „an early-stage recursive self-improvement loop." Das ist Marketing-Rahmung auf einem echten Ergebnis, aber so eine Aussage lohnt sich zu notieren.
Wie die Rechnung 770B / 49B tatsächlich funktioniert
Wenn Mixture-of-Experts neu für Sie ist, wirken die beiden großen Zahlen widersprüchlich: Wie kann ein 770B-Modell nur „49B" von irgendetwas sein? Die Antwort: MoE teilt das Netzwerk in viele Experten-Subnetze auf, und für jedes Token wählt ein Router eine kleine Handvoll aus, die tatsächlich laufen. Der Rechenaufwand pro Token verhält sich also wie bei einem ~49B-Modell, und genau das hält Hy4 schnell genug zum Betrieb.
Die Falle ist die Annahme, dass eine kleinere aktive Zahl kleinere Hardware bedeutet. Tut sie nicht. Jedes einzelne der 770B Gewichte muss im GPU-Speicher liegen, weil der Router für das nächste Token jeden Experten wählen könnte. MoE bringt Ihnen günstigere Mathematik, keine günstigere Maschine.
Unter der Haube steckt mehr Engineering, als das Datenblatt verrät: Die Attention nutzt Gated DeepSeek Sparse Attention mit einem IndexCache, der Sparse-Indizes über Layer hinweg wiederverwendet, und es gibt eine native Multi-Token-Prediction-Schicht für spekulatives Decoding. Wenn Sie die Architektur-Paper von DeepSeek und GLM verfolgt haben, wirkt vieles davon vertraut, was selbst ein Zeichen dafür ist, wie schnell die Open-Weight-Spitze auf dieselben Tricks zusammenläuft.
Die Benchmarks, ehrlich gelesen
Hy4 schneidet bei Benchmarks gut ab. Bei den verifizierten Werten, die Hugging Face anzeigt, erreicht es 92,3 bei GPQA Diamond, 82,9 % gelöst bei SWE-bench Multilingual, 65,7 bei SWE-bench Pro und 64,3 bei Deep SWE. Für ein Open-Weight-Modell sind das starke Coding- und Reasoning-Zahlen, und die Community hat es bemerkt. Ein Kommentator im Thread zu den vollständigen Benchmarks fasste die Stimmung zusammen:
For a 770B parameters model, it's impressive.

Der Vergleich, mit dem Tencent wirbt, ist eine interne Blindbewertung: 163 Experten bewerteten Ergebnisse bei 203 Engineering-Aufgaben, Skala bis 4,00. Hy4 kam auf 2,99, vor Kimi K3 (2,94) und GLM-5.3 (2,92). Das ist ein echtes Ergebnis, aber es ist Tencents eigener Test, und ein Abstand von 0,05 Punkten auf einer 4-Punkte-Skala ist ein knappes Unentschieden, kein K.o.
Ihr eigenes öffentliches Diagramm erzählt die ganze Geschichte, und man sollte es sich tatsächlich ansehen, statt der Zusammenfassung blind zu glauben. Gegenüber Claude Opus 5 und GPT-5.6 Sol liegt Hy4 (dunkelblau) meist zurück; gegenüber Kimi K3 und GLM-5.3 wechseln sich die Siege Benchmark für Benchmark ab.
Der aufmerksamste Leser im r/LocalLLaMA-Thread hat nachgezählt, was das Marketing nicht getan hat:
I don't think their own chart backs the beats glm and kimi line. Against kimi k3 it's behind on 7 of the 12 benchmarks... The beats claim comes from the internal blind test where wins only beat losses 47 to 40 against glm.
Unabhängig davon meldete der offizielle Arena-Account Hy4 auf etwa Platz 5 im WebDev-Leaderboard der Code Arena mit 1.633 Punkten, grob Platz 3 unter den offenen Modellen, wies aber darauf hin, dass es sich um eine frühe AutoEval-Platzierung handelt (ein Reward-Modell stimmt anstelle von Live-Stimmen von Menschen ab), nicht um einen gefestigten Rang. Und es steht noch gar nicht im Artificial-Analysis-Index, es gibt also keinen unabhängigen Intelligenzwert, den man zitieren könnte. Mein Fazit: ein starkes Top-Modell unter den offenen, nicht der neue Platz 1, und die Rahmung „schlägt alle" ist der Teil, den ich abziehen würde.
Eine weitere Sache, die Tencent offen sagt und die ich respektiere: Diese Preview denkt länger als nötig und überprüft ihre eigene Arbeit zu oft. Sie liefern bewusst früh aus, genauso wie die Hy3 Preview, bevor deren finale Version Berichten zufolge um 50-100 % zulegte.
Kann man es tatsächlich betreiben?
Hier wird das Label „Open Weight" kompliziert, und es ist das Wichtigste, was man verstehen sollte, bevor man sich begeistert. Offene Gewichte und eine Apache-2.0-Lizenz bedeuten, dass Sie Hy4 überall betreiben dürfen. Die Hardware entscheidet, ob Sie es können.
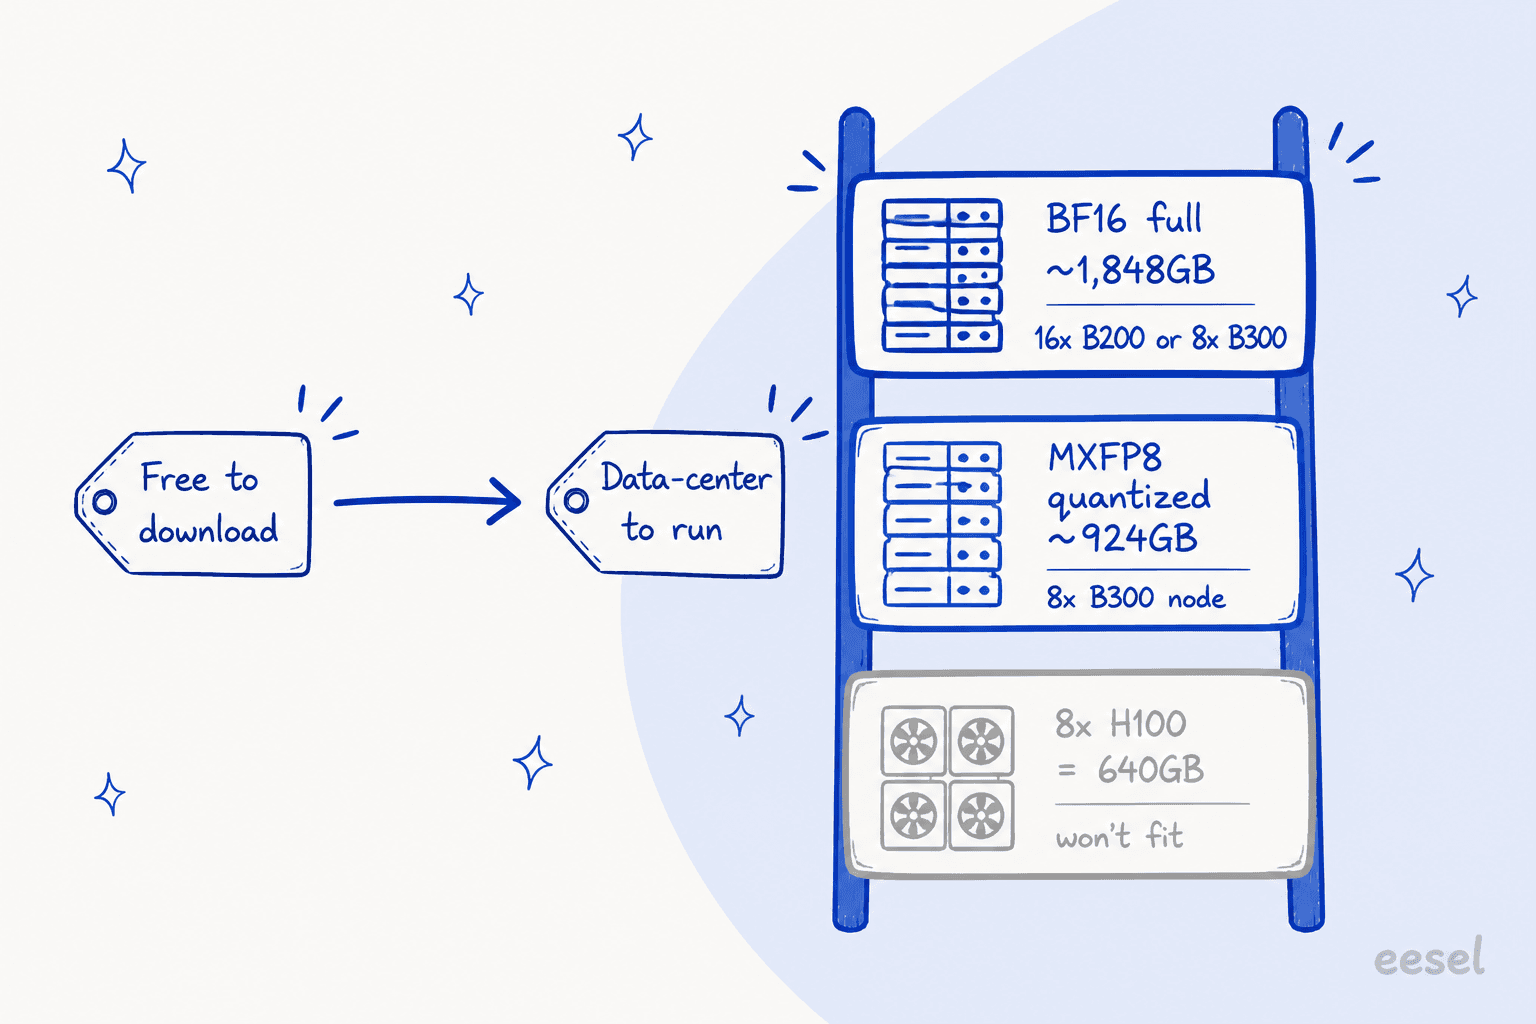
Das vLLM-Rezept ist da unverblümt. Die vollen BF16-Gewichte umfassen etwa 1.848 GB. Selbst die quantisierten MXFP8-Gewichte sind ~924 GB. Die Untergrenze laut Rezept: „16xB200 or 8xB300 minimum for weights + KV cache." Ein einzelner 8x-H100-Knoten (640 GB) kann es nicht halten. Das ist ein Rechenzentrumsmodell, Punkt.
Die r/LocalLLaMA-Leute, die große Modelle als Hobby zu Hause betreiben, begegneten dem mit gleichen Teilen Bewunderung und Resignation:
The amount of people who can drop $5-10k to run these locally is vanishingly small.
Die praktische Quant-Rechnung, die sie ausgearbeitet haben, ist nützlich, falls Sie in Versuchung geraten: Ein Q4-GGUF liegt bei etwa 450 GB, 512 GB sind also das realistische Minimum, und eine Maschine mit 256 GB fasst nur die 1-2-Bit-Quants. Wie eine ausführliche Aufschlüsselung es formulierte: „if you have 256GB, you'll probably be much better off with GLM-5.3-Flash Q4." Das ist das wiederkehrende Urteil: Für den lokalen Einsatz ist ein kleineres, gut nachtrainiertes Modell die klügere Wahl, und die Flash-Modelle von Z.AI werden immer wieder als erste Wahl genannt.
Realistisch heißt „Hy4 nutzen" also die API oder eine von Tencents Apps, nicht die eigene Kiste.
Was Tencent Hy4 kostet
Über die API kostet Hy4 Preview $0,834 pro Million Input-Tokens und $2,501 pro Million Output-Tokens, mit gecachtem Input zu $0,042 (offizielle Ankündigung). Unter den Flaggschiff-Modellen, mit denen es sich vergleicht, ist das die günstige Option.
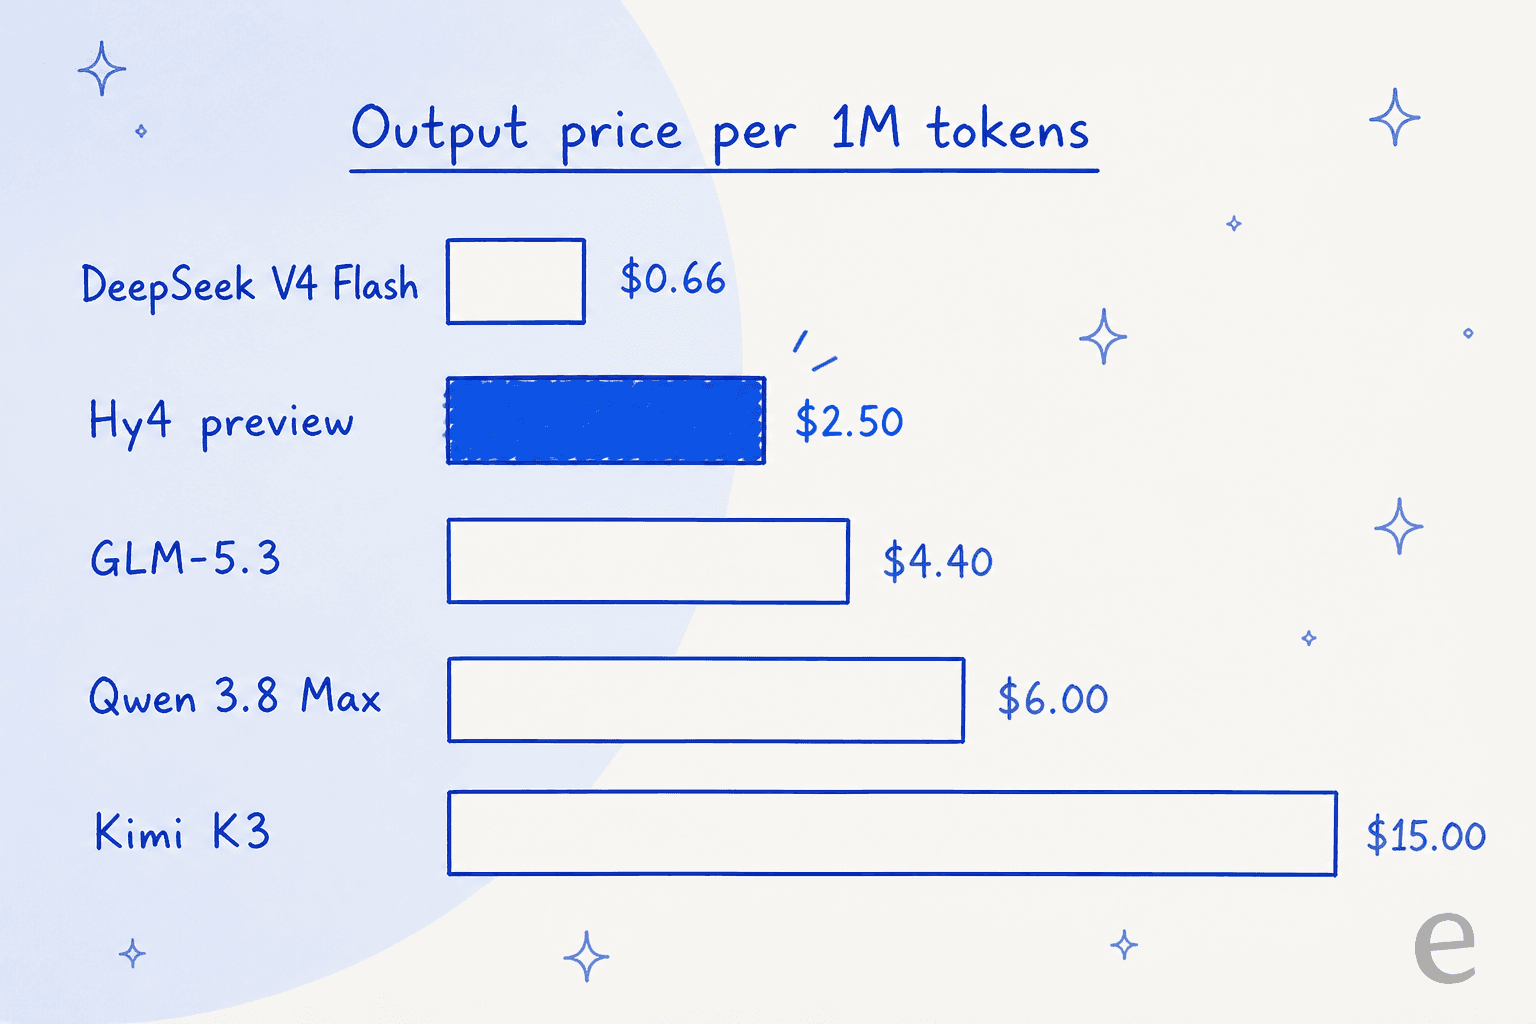
Hier das vollständige Bild gegenüber den Konkurrenten, alles pro Million Tokens:
| Modell | Gesamt- / aktive Parameter | Kontext | Input | Output | Cache-Treffer Input |
|---|---|---|---|---|---|
| Hy4 Preview (Tencent) | 770B / 49B | 1M | $0.834 | $2.501 | $0.042 |
| DeepSeek V4 Flash | 284B / 13B | 1M | $0.22 / $0.44 | $0.66 / $1.32 | $0.007 |
| DeepSeek V4 Pro | 49B-class active | 1M | $0.66 / $1.32 | $1.98 / $3.96 | $0.022 |
| Qwen 3.8 Max | 2.4T / 95B | 1M | $2.00 | $6.00 | $0.25 |
| Kimi K3 | 2.8T / 104B | 1M | $3.00 | $15.00 | $0.30 |
| GLM-5.3 | nicht offengelegt | k. A. | $1.40 | $4.40 | $0.26 |
Zwei ehrliche Einschränkungen kommen hinzu. Erstens ist Hy4 etwa 5-6x teurer als Hy3; wer Hy3 schon nutzt, erlebt also einen echten Kostensprung, keinen Rabatt. Zweitens ist DeepSeek V4 Flash bei beiden Zählern immer noch dramatisch günstiger, und für viel agentische Arbeit gewinnt „günstig und gut genug". Ein Entwickler hat einen echten Test gemacht und sagte es klar:
even mimo 2.5 was same good and on 1/20 of the costs... the model is interesting if the price is lower but not for 2.5 USD per million output.
Wenn Sie es ohne Bezahlung ausprobieren möchten: Hy4 ist zwei Wochen lang kostenlos in WorkBuddy und CodeBuddy nutzbar und auf OpenRouter gelistet (mit einer Zero-Retention-Datenrichtlinie, was ein nettes Plus gegenüber manchen chinesischen First-Party-APIs ist).
Für wen ist Tencent Hy4 also wirklich?
Nach ein paar Tagen damit und den Tests der Community lande ich hier.
Greifen Sie zu Hy4, wenn Sie agentische Coding-, Büroautomatisierungs- oder Recherche-Tools bauen, gezielt offene Gewichte und eine freizügige Apache-2.0-Lizenz wollen und die Hardware (oder das API-Budget) für ein Modell in Frontier-Größe haben. Die Coding- und Mathe-Werte sind real, das Kontextfenster ist riesig, und der Preis unterbietet die anderen offenen Flaggschiffe.
Lassen Sie es aus, wenn Sie Modelle lokal auf einer Workstation betreiben (ein gut nachtrainiertes Modell der Flash-Klasse dient Ihnen für einen Bruchteil des Speichers besser), wenn der reine Preis pro Token Ihr wichtigster Hebel ist (DeepSeek V4 Flash ist weit günstiger) oder wenn Sie einfach eine fertige Aufgabe erledigt haben wollen und es Ihnen egal ist, welches Modell sie erledigt.
Dieser letzte Fall begegnet mir am häufigsten, und man sollte ehrlich damit umgehen: Die meisten, die fragen „Soll ich Hy4 nutzen?", wollen gar kein Modell. Sie wollen eine abgearbeitete Support-Warteschlange, einen geschriebenen Blogbeitrag oder eine erledigte Recherche. Ein rohes 770B-Modell ist ein brillanter Motor ohne Auto drumherum: Sie müssen noch Retrieval, Leitplanken, Integrationen, Evals und Fallback-Logik bauen, bevor es in der Produktion etwas Nützliches tut. Das ist die Lücke zwischen einem beeindruckenden Benchmark und etwas, das echten Traffic übersteht, und genau daran arbeite ich den ganzen Tag.
eesel testen: das Teammitglied einstellen, die Modell-Infrastruktur überspringen
So denke ich darüber: Modelle wie Hy4 sind Infrastruktur. eesel AI ist der Mitarbeiter. Statt ein Modell auszuwählen und alles drumherum zu verdrahten, stellen Sie ein einsatzbereites KI-Teammitglied für eine bestimmte Aufgabe ein, und es kommt schon mit dem Wissen, wie es geht.
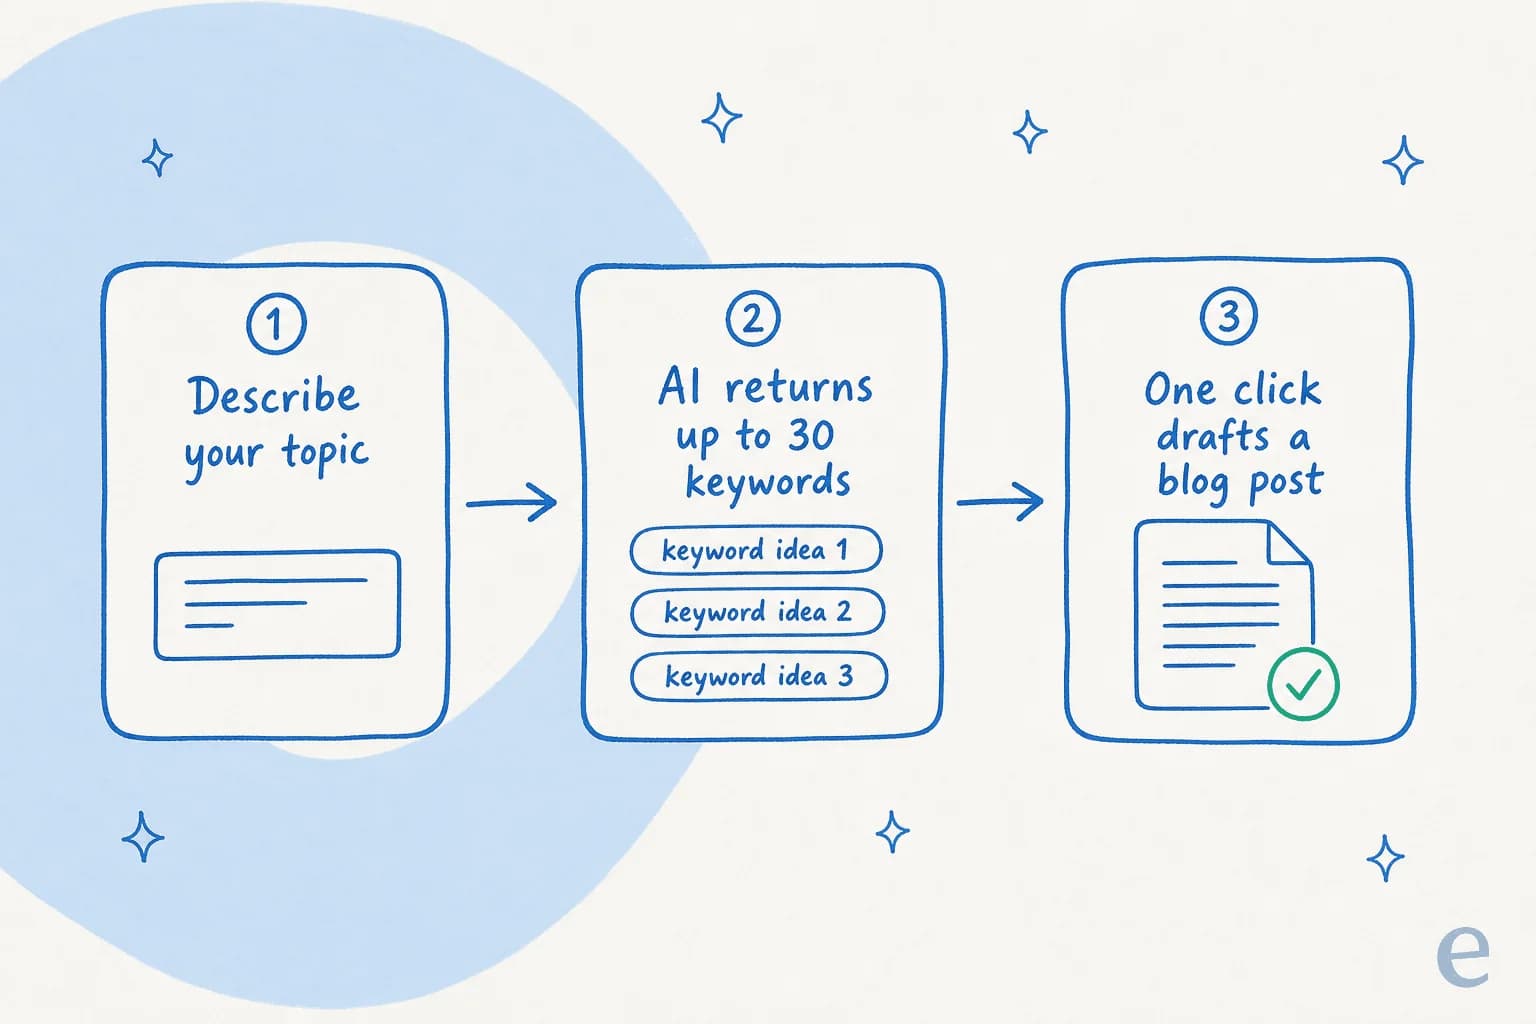
Aktuell besteht das Team aus zwei Teammitgliedern. Das KI-Helpdesk-Teammitglied steigt in Ihre bestehende Warteschlange in Zendesk, Freshdesk, Gorgias oder einem gemeinsamen Postfach ein, trainiert auf Ihren früheren Tickets und Ihrem Help Center und entwirft oder sendet Antworten, und vor allem können Sie es an Ihren historischen Tickets simulieren, bevor es je einem Kunden antwortet, sodass Sie wissen, wie es sich verhält, statt einen Schalter umzulegen und zu hoffen. Der KI-Blog-Writer erledigt Recherche, Schreiben und SEO für einen Longform-Beitrag in einem Durchlauf. Beide laufen unter der Haube auf Frontier-Modellen, sodass Sie die Leistungsfähigkeit von etwas wie Hy4 bekommen, ohne eine einzige GPU bereitzustellen. Sie können kostenlos starten, ohne Kreditkarte und ohne Verkaufsgespräch.