

Gemini Omni 1.2 Flash ist Google DeepMinds Update vom 5. November 2026 für sein Omni-Videomodell. Die wichtigsten Änderungen sind 15-Sekunden-Clips (vorher 10), etwa $0,07 pro Sekunde 720p-Video (vorher etwa $0,10) und eine engere Konsistenz von Figuren und Produkten über Referenzbilder hinweg. Es bleibt ein Modell, auf dem man aufbaut, kein Arbeiter, der einen Job erledigt. Ich würde es für Werbe- und Produktvideo-Pipelines einsetzen. Für Support-Tickets oder Blogbeiträge passt ein einsatzbereites Teammitglied wie eesel besser, und mit der eesel CLI kann ein Coding-Agent freigegebenes Wissen hochladen und die Antworten eines Teammitglieds testen, bevor es live geht.
Was ist Gemini Omni 1.2 Flash?
Es ist die dritte Veröffentlichung in Googles Omni-Videoreihe, nach dem ursprünglichen Gemini Omni Flash und dem August-Update, Gemini Omni 1.1 Flash. Googles Modellkarte nennt Text, Bilder, Audio und Video als Eingaben und „hochwertiges, hochauflösendes Video mit Audio" als Ausgabe. Die Gemini-API-Modell-ID ist gemini-omni-1.2-flash, und das Gemini-API-Changelog markiert es als ab dem 5. November 2026 allgemein verfügbar.
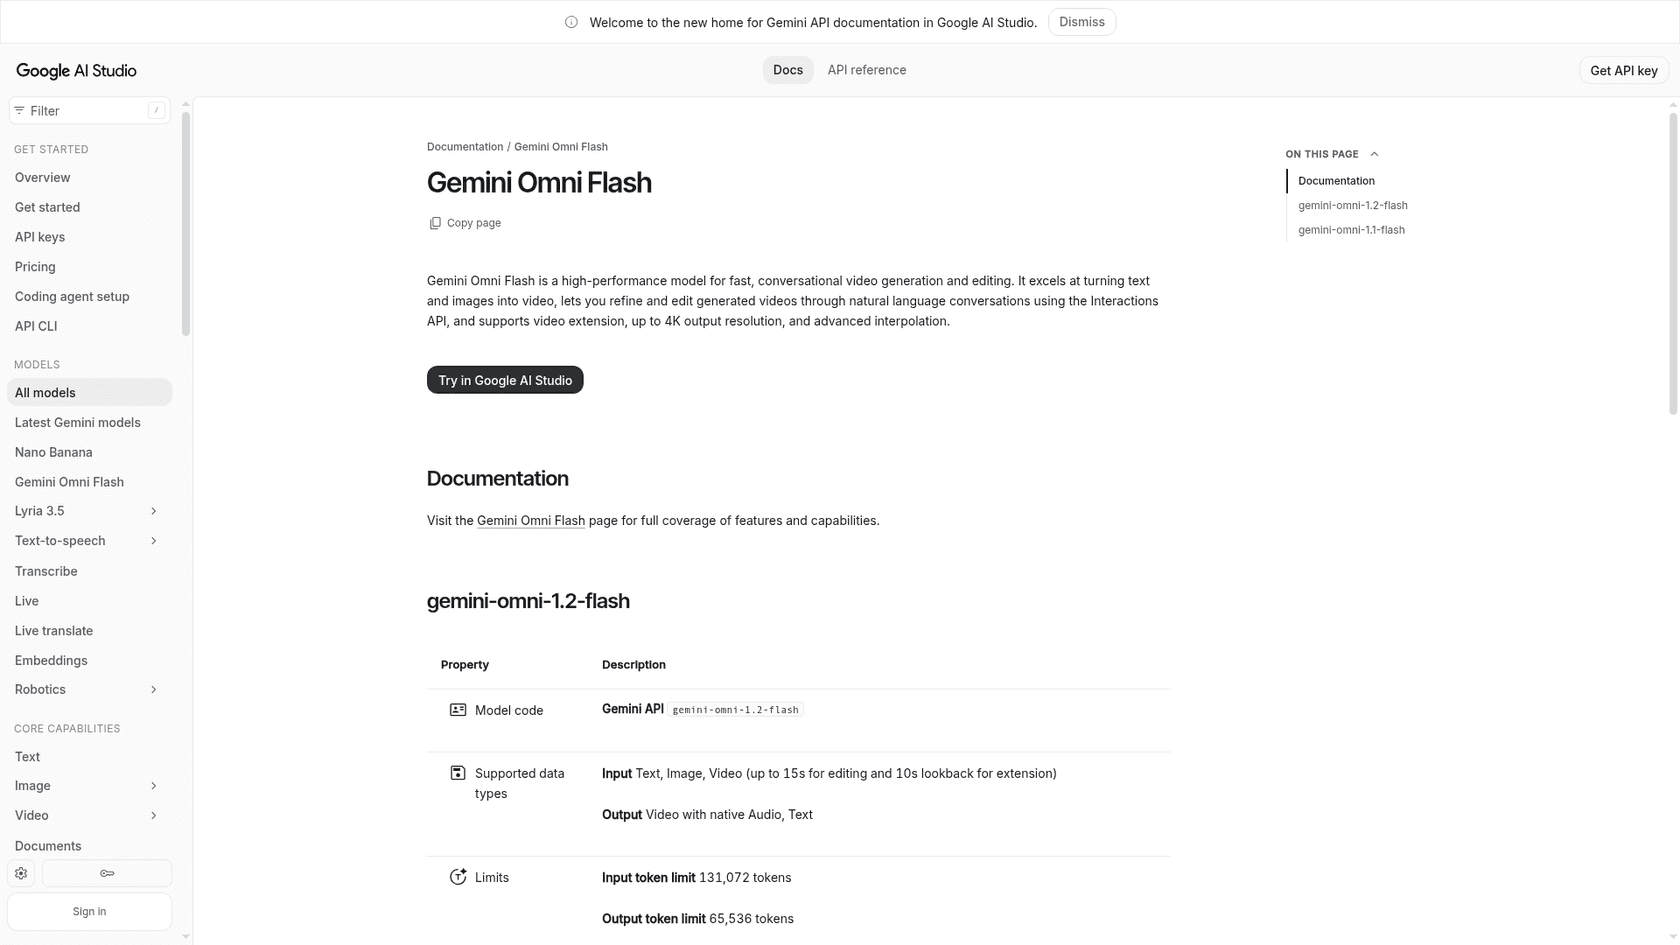
Die Idee bleibt aus den früheren Versionen bestehen: Sie beschreiben eine Einstellung und verfeinern sie dann im Chat, statt von Grund auf neu zu rendern. Wenn Sie die Entstehungsgeschichte des ursprünglichen Modells interessiert, behandelt sie mein Gemini Omni Flash Review.
Was hat sich seit 1.1 geändert?
Kurz gesagt: längere Clips, ein niedrigerer Preis und stärkere Referenzen. Ein Detail läuft in die andere Richtung, das ich weiter unten markiere.
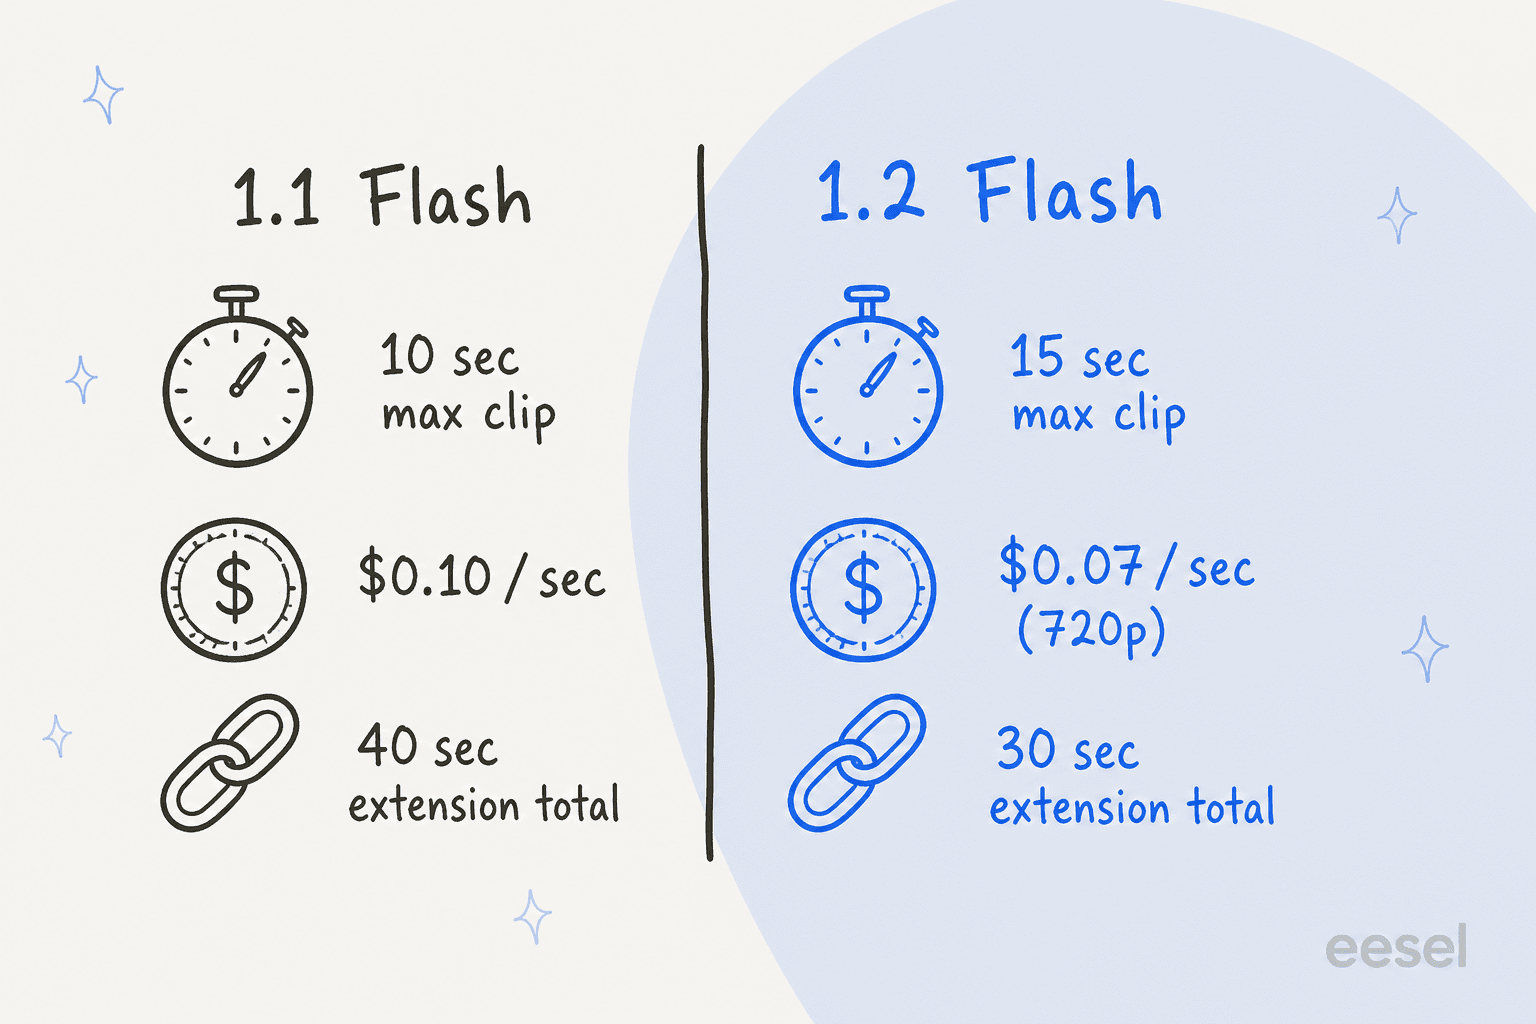
- Cliplänge: 3 bis 15 Sekunden pro Generierung, in Schritten von einer Sekunde, laut den Google AI Studio-Dokumenten. Version 1.1 begrenzte eine Generierung auf 10 Sekunden.
- Preis: die Videoausgabe sinkt auf
$12,00pro 1 Mio. Tokens von$17,50, was die Preisseite mit etwa$0,07pro Sekunde 720p-Video angibt. - Referenzen: laut Changelog hält das Modell Figuren und Motive über bis zu sechs Referenzbilder hinweg konsistenter. Audio-Referenzen stehen bei Google Cloud hinter einer Allowlist.
- Sprache: Google Clouds Launch-Beitrag nennt klareren Lippensynchron und Multi-Speaker-Conditioning.
- Limits: die Rate Limits der kostenpflichtigen Stufe haben sich laut demselben Changelog-Eintrag verdoppelt.
Ein Punkt läuft gegen den Trend. Beim Launch warb 1.1 mit einer Szenenverlängerung von insgesamt bis zu 40 Sekunden. Die 1.2-Dokumentation listet die Verlängerung mit 3 bis 10 Sekunden pro Durchgang, bis zu 30 Sekunden insgesamt. Googles Seiten erklären den Unterschied nicht, also testen Sie es, bevor Sie sich auf 40-Sekunden-Ketten verlassen.
Wie gut ist es, nach Googles eigenen Zahlen?
Googles Gemini Omni-Seite veröffentlicht direkte Vergleichs-Gewinnraten von 1.2 gegen 1.1. Es sind Googles eigene Auswertungen, kein unabhängiger Benchmark, und Ihre Prompts und Referenzbilder waren nicht in dieser Stichprobe.
| Test | Gewinnrate 1.2 | Gewinnrate 1.1 |
|---|---|---|
| Text zu Video, visuelle Konsistenz | 62 % | 38 % |
| Referenz zu Video, Gesamtpräferenz | 63 % | 37 % |
| Referenz zu Video, Identitätskonsistenz | 63 % | 37 % |
| Bild zu Video, Gesamtpräferenz | 59 % | n/a |
| Anweisungsbearbeitung | 57 % | n/a |
Lesen Sie das als „ein klarer, aber moderater Schritt nach vorne". Eine Gewinnrate von 62 % bedeutet, dass bei etwa einem von drei Vergleichen immer noch das ältere Modell bevorzugt wurde. Für Werbearbeiten zählen die Zeilen zur Referenzkonsistenz am meisten, denn abweichende Produktfarben sind meist der Grund, warum eine Generierung abgelehnt wird.
Wie viel kostet es?
Die Gemini-API-Preisseite listet das Modell nur in der Standardstufe. Es gibt keine kostenlose Stufe und keine Batch-Stufe. Input kostet $1,50 pro 1 Mio. Tokens, Textausgabe $9,00 und Videoausgabe $12,00.
| Auflösung | Pro Sekunde | Tokens pro Sekunde |
|---|---|---|
| 360p | $0,023 | 1.931 |
| 720p | etwa $0,07 | 5.792 |
| 1080p (mit Upsampling) | $0,104 | 8.688 |
| 4K (mit Upsampling) | $0,209 | 17.376 |
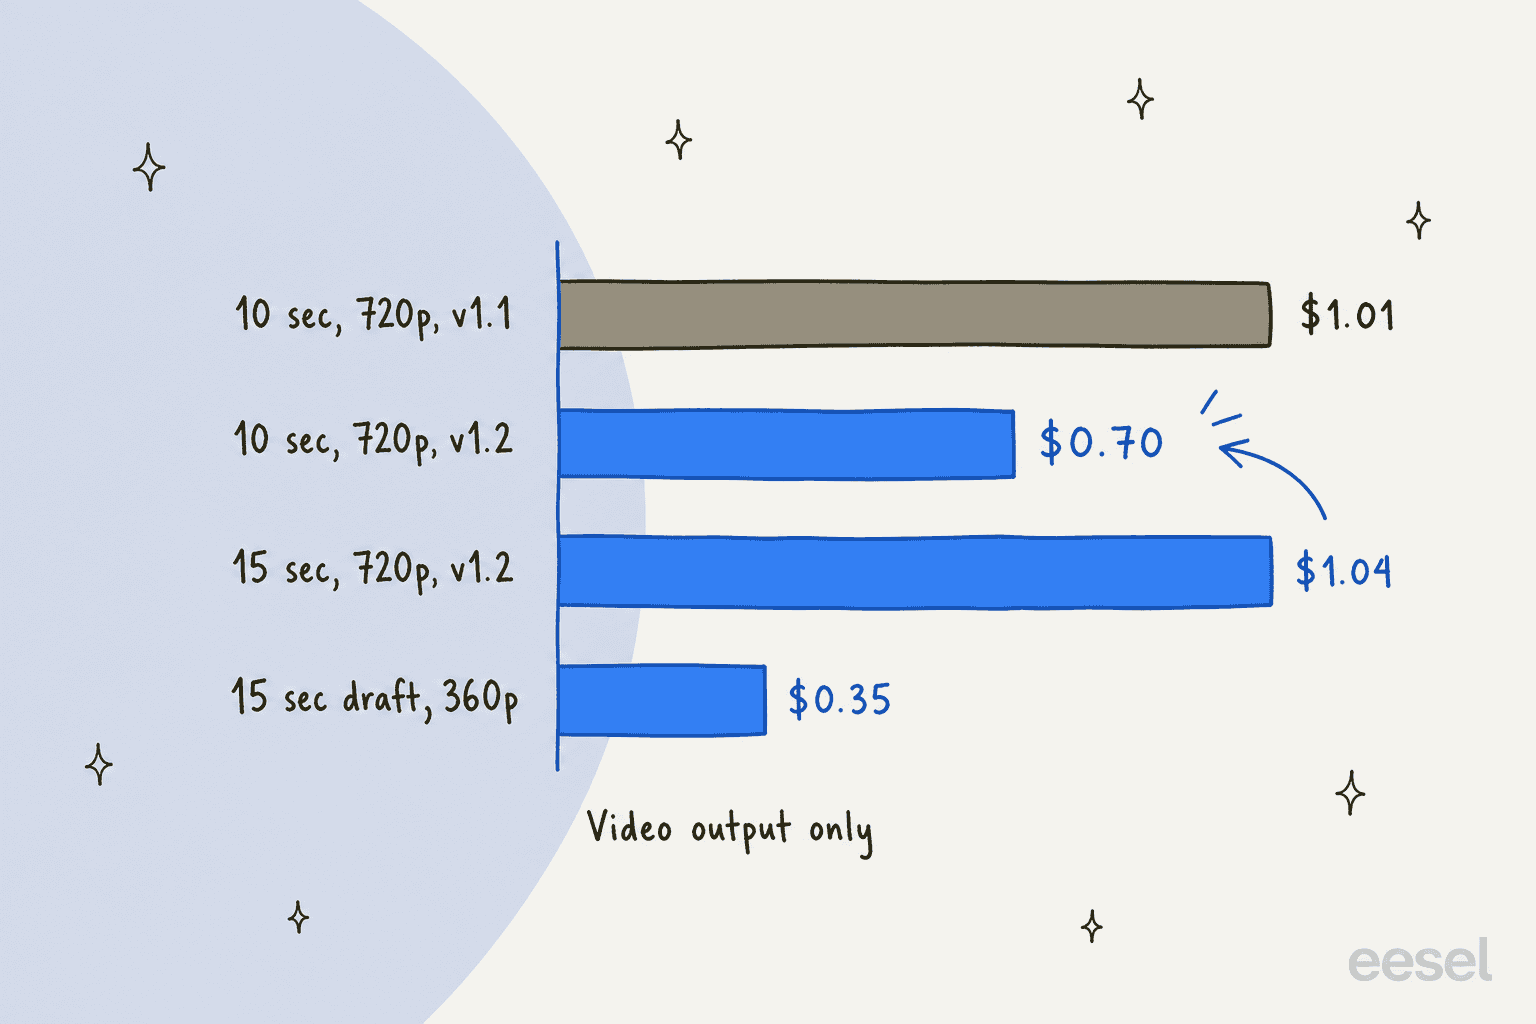
Die 5.792 Tokens pro Sekunde bei 720p stammen aus derselben Rate wie in meinem Omni 1.1-Preisleitfaden. Hochgerechnet kostet ein voller 15-Sekunden-Clip in 720p etwa $1,04 und einer mit 10 Sekunden etwa $0,70, gegenüber etwa $1,01 für 10 Sekunden bei 1.1. Für den breiteren Kontext siehe meine Aufschlüsselung zu Gemini Omni Flash-Preisen und den allgemeinen Gemini-Preise-Leitfaden.
Googles Preisseite sagt, dass ab dem 3. Dezember 2026 Anfragen an die 1.1-Modell-ID automatisch zu 1.2 weitergeleitet und zu 1.2-Raten abgerechnet werden. Wenn Sie 1.1-Aufrufe im Produktivbetrieb haben, sinken Ihre Kosten ohne eine Codeänderung, und auch Ihre Ausgabe ändert sich ohne eine.
Wie funktioniert der Workflow Entwurf-dann-Upscale?
Googles Launch-Beitrag beschreibt das Erstellen von Entwürfen in 360p oder 720p und das anschließende Hochskalieren der besten Aufnahme auf 1080p oder 4K. In der Praxis iterieren Sie günstig, beheben Probleme mit einer Folge-Chat-Nachricht und zahlen nur einmal für das hochauflösende Rendering.
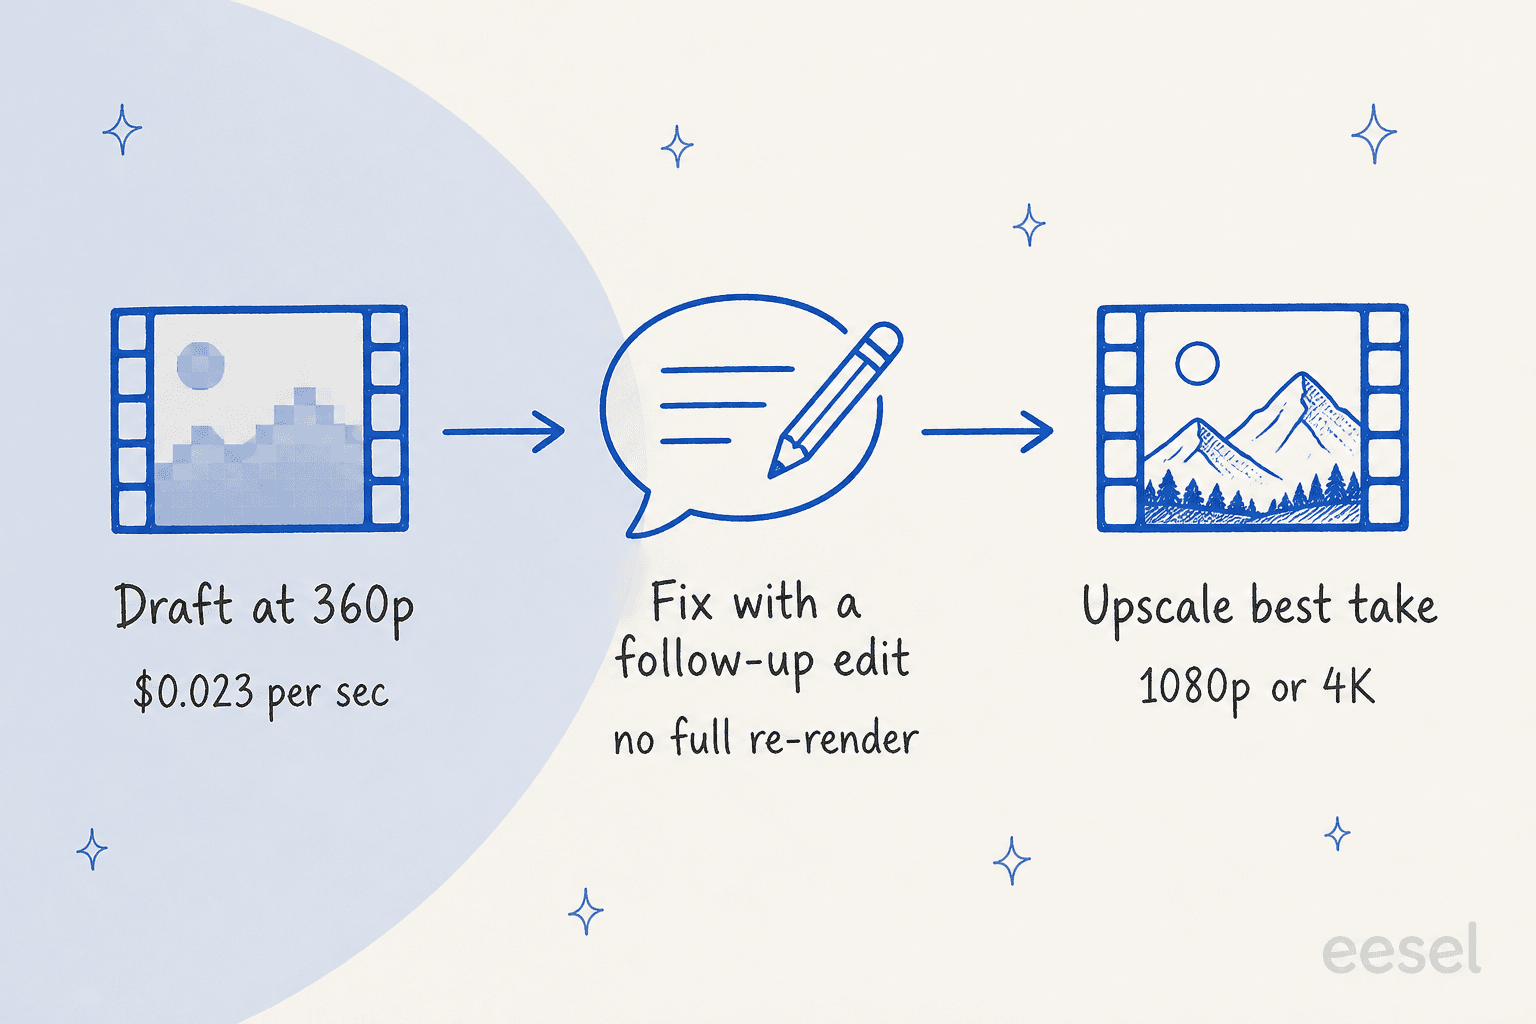
Zwei Details, zu denen die Dokumentation schweigt. Sie sagt nicht, ob ein Entwurf zusätzlich zu seinem späteren Upscale abgerechnet wird, also sollte ein entwurfsintensiver Workflow zuerst mit einem kleinen Testlauf bepreist werden. Und wie ein Hacker-News-Kommentator zu 1.1 anmerkte, sind Entwürfe und finale Renderings nicht deterministisch, ein Entwurf ist also eine Vorschau der Richtung und keine Garantie für das endgültige Bild.
Wo können Sie es nutzen?
Google listet in der Modellkarte eine breite Palette an Oberflächen: die Gemini-App, die Gemini Enterprise-App, Google AI Studio, YouTube, Flow, Google Cloud, die Gemini API und Workspace. Details, die es wert sind, zu wissen:
- Google Vids: der Workspace Updates-Beitrag sagt, dass der Rollout am 5. November begann, mit einem Schieberegler von 3 bis 15 Sekunden und ohne Admin-Kontrolle. Er umfasst Business-, Enterprise- und Education-Pläne sowie persönliche Konten mit Google AI Pro oder Ultra.
- Google Cloud: allgemein verfügbar über die API und die Konsole, mit Provisioned Throughput für Produktions-Workloads. Videoerstellung in Gemini für Unternehmen ist als „bald verfügbar" aufgeführt.
- Kontextgrenzen: 131.072 Input-Tokens und 65.536 Output-Tokens, 24 FPS Ausgabe und 360p bis 4K.
Der Zugang ist nicht über alle Pläne gleich. Im Launch-Thread auf Hacker News beschrieb ein Kommentator die Reibung:
"There have been months where we've paid 1500€ for my AI models, but I can't bother with Google's models because I literally don't know how to get them."

Was ist mit Sicherheit und Herkunftsnachweis?
Jede Ausgabe trägt ein unmerkliches SynthID-Wasserzeichen, und Googles Produktseite fügt C2PA Content Credentials hinzu. Die Modellkarte besagt, dass das Modell die Sprache von Personen bei der Videobearbeitung verändern kann, eine Fähigkeit, die derzeit eingeschränkt ist. Sie berichtet außerdem, dass das Modell basierend auf Auswertungen von Gemini 3.1 Pro und Gemini 3.7 Flash voraussichtlich keine der überwachten oder kritischen Fähigkeitsstufen erreicht.
Wer baut bereits darauf auf?
Google Clouds Launch-Beitrag zitiert eine Reihe von Video-Produktteams: invideo sagt, 15 Sekunden lassen eine ganze Szene in einer Generierung landen, QuickFrame AI sagt, 15-Sekunden-1080p-Ausgabe lässt Nutzer eine komplette Connected-TV-Werbung in einem Durchgang bauen, und Picsart verweist auf den Entwurfsmodus für schnelle Konzept-Iteration. Das sind Launch-Partner, die Google bewusst ausgewählt hat, lesen Sie sie also als Rahmung und nicht als neutrale Rezensionen. Trotzdem ist das Muster klar: Werbung, Produktanimation und kreative Werkzeuge.
Wenn Sie Videomodelle vergleichen, deckt mein Leitfaden zu Sora 2-Preisen und die Liste Sora 2-Alternativen die OpenAI-Seite ab, und der Beitrag Omni 1.1-Alternativen deckt das breitere Feld ab.
Wo passt Gemini Omni 1.2 Flash hin?
Ich bin Rama, und ich bringe Integrationen und APIs bei eesel live, deshalb lese ich einen Modell-Launch wie ein Ingenieur: Was ist der Vertrag, und was muss ich noch selbst bauen? Omni 1.2 gibt Ihnen einen guten Vertrag für Video: eine Modell-ID, einen Preis pro Sekunde, dokumentierte Limits. Die App, den Review-Schritt und die Anbindung an Ihre eigenen Tools bauen Sie weiterhin selbst.
Das ist die Grenze, die ich zwischen Infrastruktur und einem Mitarbeiter sehe. Ein Videomodell ist Infrastruktur; eesel ist der Mitarbeiter. eesel ist eine Plattform für KI-Teammitglieder, und Kunden stellen einsatzbereite Teammitglieder für eine definierte Aufgabe ein. Die heutige Aufstellung ist ein KI-Blog-Autor und ein KI-Helpdesk-Agent, die beide mit den Fähigkeiten, Integrationen und dem Unternehmenskontext für ihre Rolle ankommen.
Ein benannter Beleg schlägt hier Adjektive. SE Ranking, das SEO-Softwareunternehmen, betreibt für jedes seiner drei Produkte einen eigenen eesel-Agenten auf Zendesk-Chat und -Tickets. In einem Monat, vom 8. August bis zum 8. September 2026, bearbeiteten diese Agenten 4.650 Unterhaltungen, 2.100 davon Live-Chats, die zuerst von eesel beantwortet wurden. Kein Videomodell erledigt diesen Job, und kein Helpdesk-Agent rendert eine Werbung. Wählen Sie das Werkzeug für die Aufgabe, die Sie tatsächlich haben.
Eine praktische Anmerkung für Entwickler: Mit der eesel CLI kann ein Coding-Agent wie Claude Code oder Codex freigegebenes Wissen hochladen, die Anweisungen eines Teammitglieds anpassen und Testfragen stellen, um die Antworten zu prüfen, bevor etwas live geht. Das Verbinden eines Helpdesks selbst braucht weiterhin jemanden mit Admin-Zugang, der es freigibt.
Wenn Sie die Content-Seite rund um Video aufbauen, gilt derselbe Gedanke. Meine Leitfäden zum KI-Blog-Autor, zur KI-Blog-Automatisierung und zur KI-Blog-Content-Pipeline zeigen, wie Sie diese Aufgabe abgeben. Für Skripte, die ein Videomodell füttern, siehe KI-Videoskript-Generatoren und ob KI Videoskripte schreiben kann. Für die breitere Google-Palette lesen Sie Gemini-Alternativen, Gemini 3.8 Flash, Nano Banana 2, Nano Banana Pro, Gemini Lyria 3 und Gemini vs ChatGPT. Für die Idee des KI-Teammitglieds siehe KI-Teammitglieder und KI-Mitarbeiter.
Testen Sie eesel für die Arbeit, die ein Videomodell nicht erledigen kann
Wenn Ihr Team Video mit Omni produziert, muss immer noch jemand die Beiträge drumherum schreiben und die Fragen beantworten, die es erzeugt. Der KI-Blog-Autor recherchiert und verfasst Inhalte aus Ihrem eigenen Wissen, und der KI-Helpdesk-Agent tritt Ihrer bestehenden Support-Warteschlange bei und arbeitet mit Ihren vergangenen Tickets und Ihrem Help Center. Sie können eesel kostenlos testen und ein Teammitglied an echten historischen Daten simulieren, bevor es live geht.
Häufig gestellte Fragen
Was ist Gemini Omni 1.2 Flash?
Wie viel kostet Gemini Omni 1.2 Flash?
Wie lang kann ein Gemini Omni 1.2 Flash-Video sein?
Was ist die Modell-ID von Gemini Omni 1.2 Flash?
gemini-omni-1.2-flash. Ab dem 3. Dezember 2026 werden Anfragen an gemini-omni-1.1-flash zu 1.2 weitergeleitet und zu 1.2-Raten abgerechnet, laut dem Gemini-API-Changelog.