

Am 21. Juli 2026 brachte Google Gemini 3.5 Flash-Lite zusammen mit 3.6 Flash und einem Sicherheitsmodell heraus. Flash-Lite ist das Budget-Modell: $0.30 pro 1M Input-Tokens und $2.50 pro 1M Output-Tokens, also rund 5x günstiger bei der Eingabe und 3x günstiger bei der Ausgabe als 3.6 Flash. Es ist schnell (nahe an der Spitze von Artificial Analysis' Geschwindigkeits-Ranking), behält das ~1M-Token-Kontextfenster und ist für hochvolumige, wenig reasoning-intensive Aufgaben wie Suche, Dokumentenverarbeitung und Übersetzung gebaut.
Die ehrliche Einschätzung: Flash-Lite ist die richtige Wahl, wenn jede Aufgabe einfach ist und ihr sie millionenfach ausführt, und die falsche Wahl, wenn die Aufgabe echtes mehrstufiges Reasoning braucht. Und falls ihr hier gelandet seid, weil ihr Kundensupport-Automatisierung darauf aufbauen wollt: Der Token-Preis ist der einfache Teil. Ich stecke seit Jahren KI-Agenten in echte Support-Queues, und das Modell ist die unterste Schicht des Stacks, nicht das Ganze. Mehr zu beidem weiter unten.
Was Gemini 3.5 Flash-Lite eigentlich ist
Google teilt seine Gemini-Familie in zwei Bahnen auf. Pro-Modelle sind die Top-Stufe für schwieriges Reasoning. Flash-Modelle sind die Arbeitspferde: günstiger, schneller, abgestimmt auf Produktionsanwendungen mit Tausenden Aufrufen am Tag. Flash-Lite ist das schlankste davon, von Google positioniert für hochvolumige agentenbasierte Aufgaben, Übersetzung und einfache Datenverarbeitung.
Die Spezifikationen sind für ein Budget-Modell überraschend großzügig. Es verarbeitet Text, Bild, Video, Audio und PDF als Eingabe, hat ein 1.048.576-Token-Kontextfenster (~1M Tokens, oder etwa 1.500 Seiten) und unterstützt Reasoning, Funktionsaufrufe, strukturierte Ausgaben, Codeausführung und Search Grounding. Es unterstützt nicht Computer-Nutzung, Bild- oder Audiogenerierung oder die Live API, ist also eine Text-zu-Text-Engine für hohes Volumen, kein Alleskönner.
Bei Artificial Analysis erreicht es einen Intelligence Index von 36 (#12 von 152 Modellen, deutlich über dem Durchschnitt seiner Klasse) und läuft dabei mit etwa 490 Output-Tokens pro Sekunde, das zweitschnellste Modell, das sie gemessen haben. Für ein so günstiges Modell ist diese Kombination aus Intelligenz pro Dollar das ganze Verkaufsargument.
Gemini 3.5 Flash-Lite Preise
Hier das vollständige Bild. Preise gelten pro 1M Tokens in den Bezahlstufen, und die Ausgabe schließt Reasoning-Tokens mit ein.
| Modus | Input (pro 1M) | Output (inkl. Reasoning) | Context Caching |
|---|---|---|---|
| Standard | $0.30 | $2.50 | $0.03 |
| Batch (50% Rabatt) | $0.15 | $1.25 | $0.02 |
| Flex | $0.15 | $1.25 | $0.02 |
| Priority | $0.54 | $4.50 | $0.05 |
| Kostenlose Stufe | Kostenlos | Kostenlos | Nicht verfügbar |
Ein paar Dinge, die ihr beachten solltet, bevor ihr das in eine Tabellenkalkulation eintragt:
- Die kostenlose Stufe trainiert mit euren Daten. In der kostenlosen Stufe nutzt Google eure Inhalte zur Produktverbesserung; in jeder Bezahlstufe nicht. Für alles, was Kundendaten berührt, disqualifiziert das die kostenlose Stufe schon allein.
- Der Batch-Modus ist ein pauschaler 50%-Rabatt. Wenn die Arbeit nicht in Echtzeit erfolgen muss (nächtliche Dokumentenverarbeitung, Massenübersetzung), senkt Batch die Kosten auf $0.15 / $1.25.
- Search Grounding wird separat abgerechnet. Ihr erhaltet 5.000 grounded Prompts pro Monat kostenlos über die gesamte Gemini-3-Familie hinweg, danach kostet es $14 pro 1.000 Suchanfragen, und eine einzelne Anfrage kann mehrere abrechenbare Suchanfragen auslösen.
Wie sich das gegenüber den Gemini-Consumer-Plänen und dem Rest der API einordnet, zeigt unser Gemini Pricing Guide im vollständigen Überblick, und Gemini Workspace Pricing deckt die Business-Pläne ab.
Was das tatsächlich kostet
Listenpreise sagen nicht viel aus, bis man eine echte Zahl durchrechnet. Angenommen, ihr nutzt Flash-Lite für die erste Ticket-Triage bei 50.000 Tickets im Monat, mit etwa 1.000 Input-Tokens und 200 Output-Tokens pro Ticket.
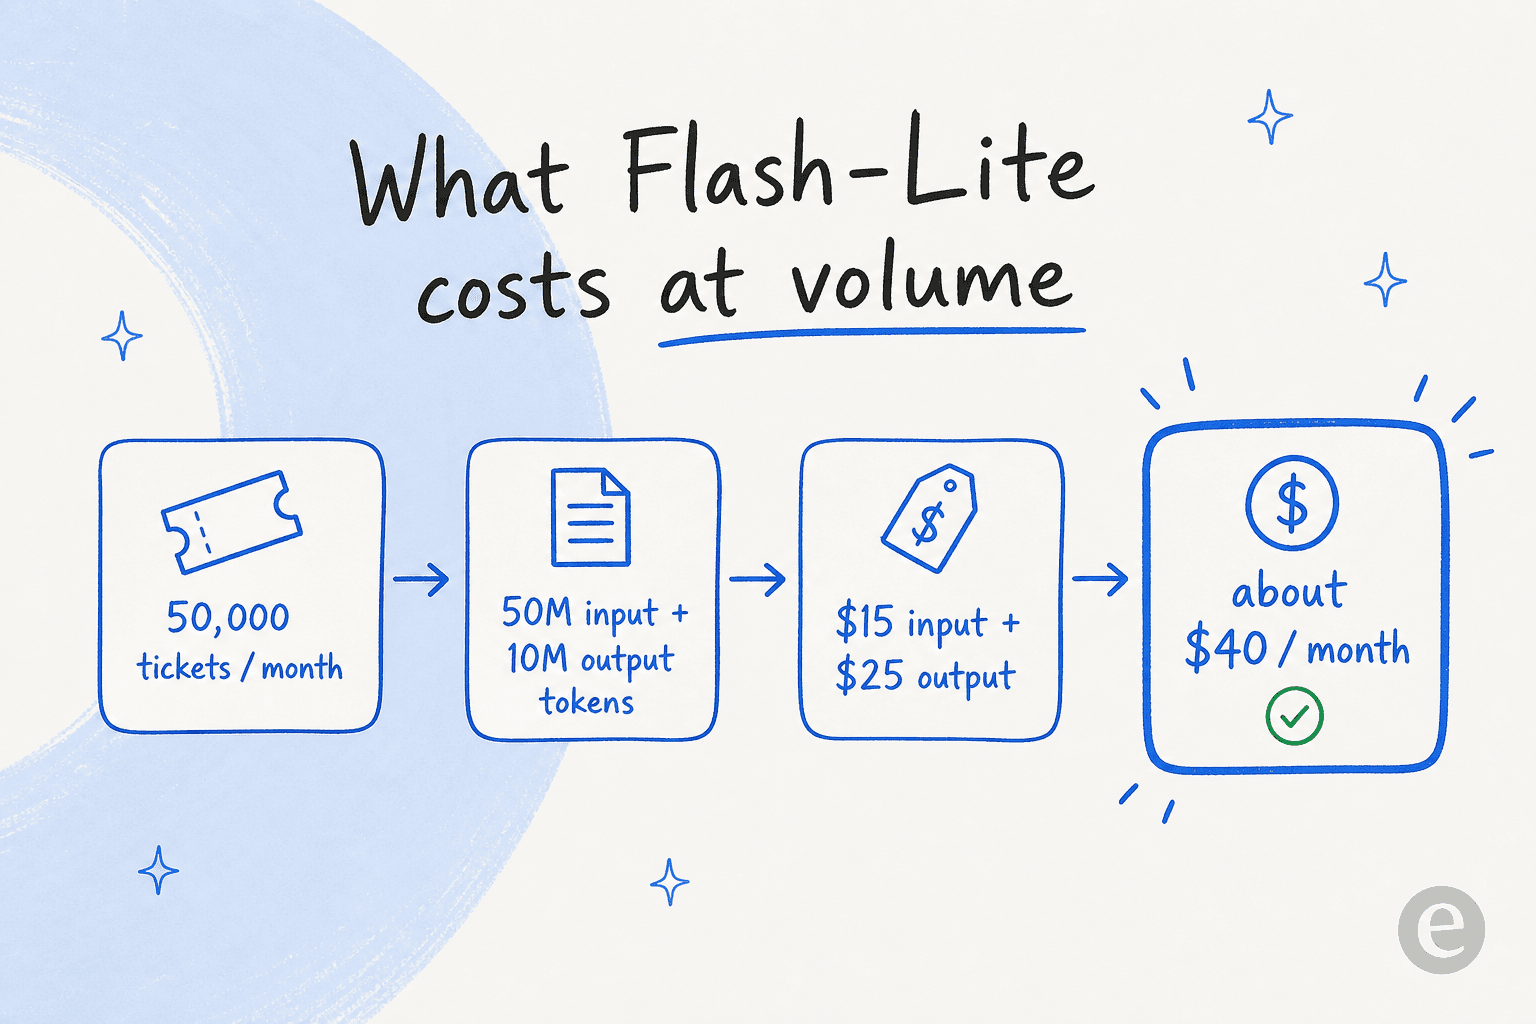
Das sind 50M Input-Tokens ($15) und 10M Output-Tokens ($25), also etwa $40 im Monat an reinen Modellkosten. Fahrt dasselbe Volumen mit 3.6 Flash, und ihr landet näher bei $150. Diese Lücke ist genau der Grund, warum es Flash-Lite gibt, und warum die Wahl der richtigen Modellstufe wichtiger ist, als den meisten Teams bewusst ist, wenn sie KI-Support budgetieren oder versuchen, mit Automatisierung Support-Kosten zu senken.
Wie Flash-Lite im Vergleich abschneidet
Google hat eine Vergleichstabelle veröffentlicht, und die Preiszeile erzählt die eigentliche Geschichte. Mit $0.30 / $2.50 unterbietet Flash-Lite GPT-5.4 mini ($0.75 / $4.50) und Claude Haiku 4.5 ($1.00 / $5.00), während es bei den meisten agentenbasierten Benchmarks im gleichen groben Qualitätsband liegt.
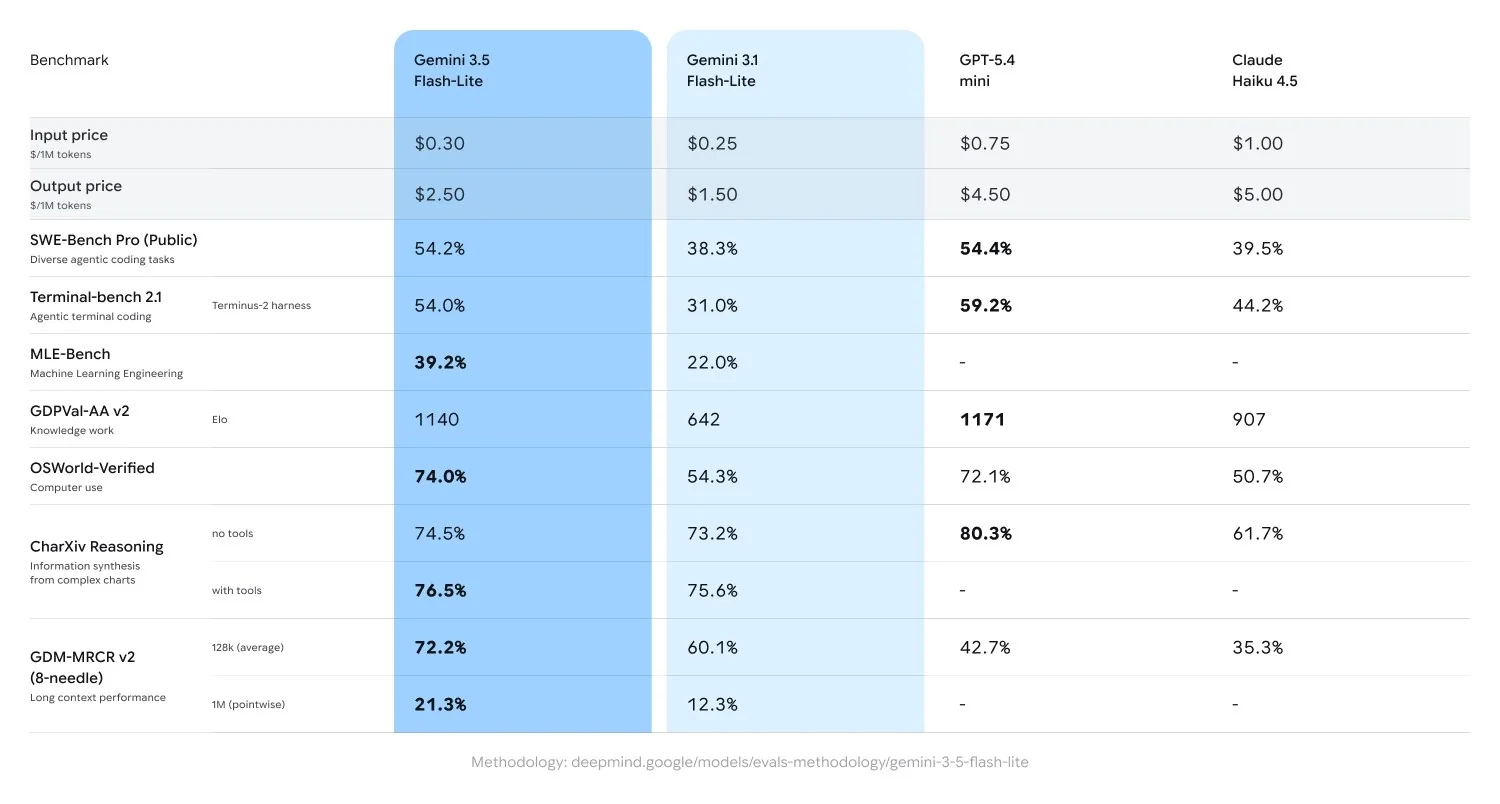
Lest diese Tabelle mit einer Einschränkung: GPT-5.4 mini liegt bei ein paar Coding- und Wissens-Scores knapp vorne. Aber beim Preis pro Leistungsfähigkeit für hochvolumige Arbeit ist Flash-Lite schwer zu schlagen, und beim Long-Context-Recall gewinnt es klar. Die eine Zahl, die nicht schmeichelhaft ist, ist die Latenz: Die Time to First Token liegt bei etwa 6 Sekunden (inklusive Reasoning-Zeit), am oberen Ende für seine Klasse, daher eignet es sich besser für Hintergrundjobs als für flotten Live-Chat.
Gegenüber seinem eigenen Vorgänger ist der Generationssprung deutlich:
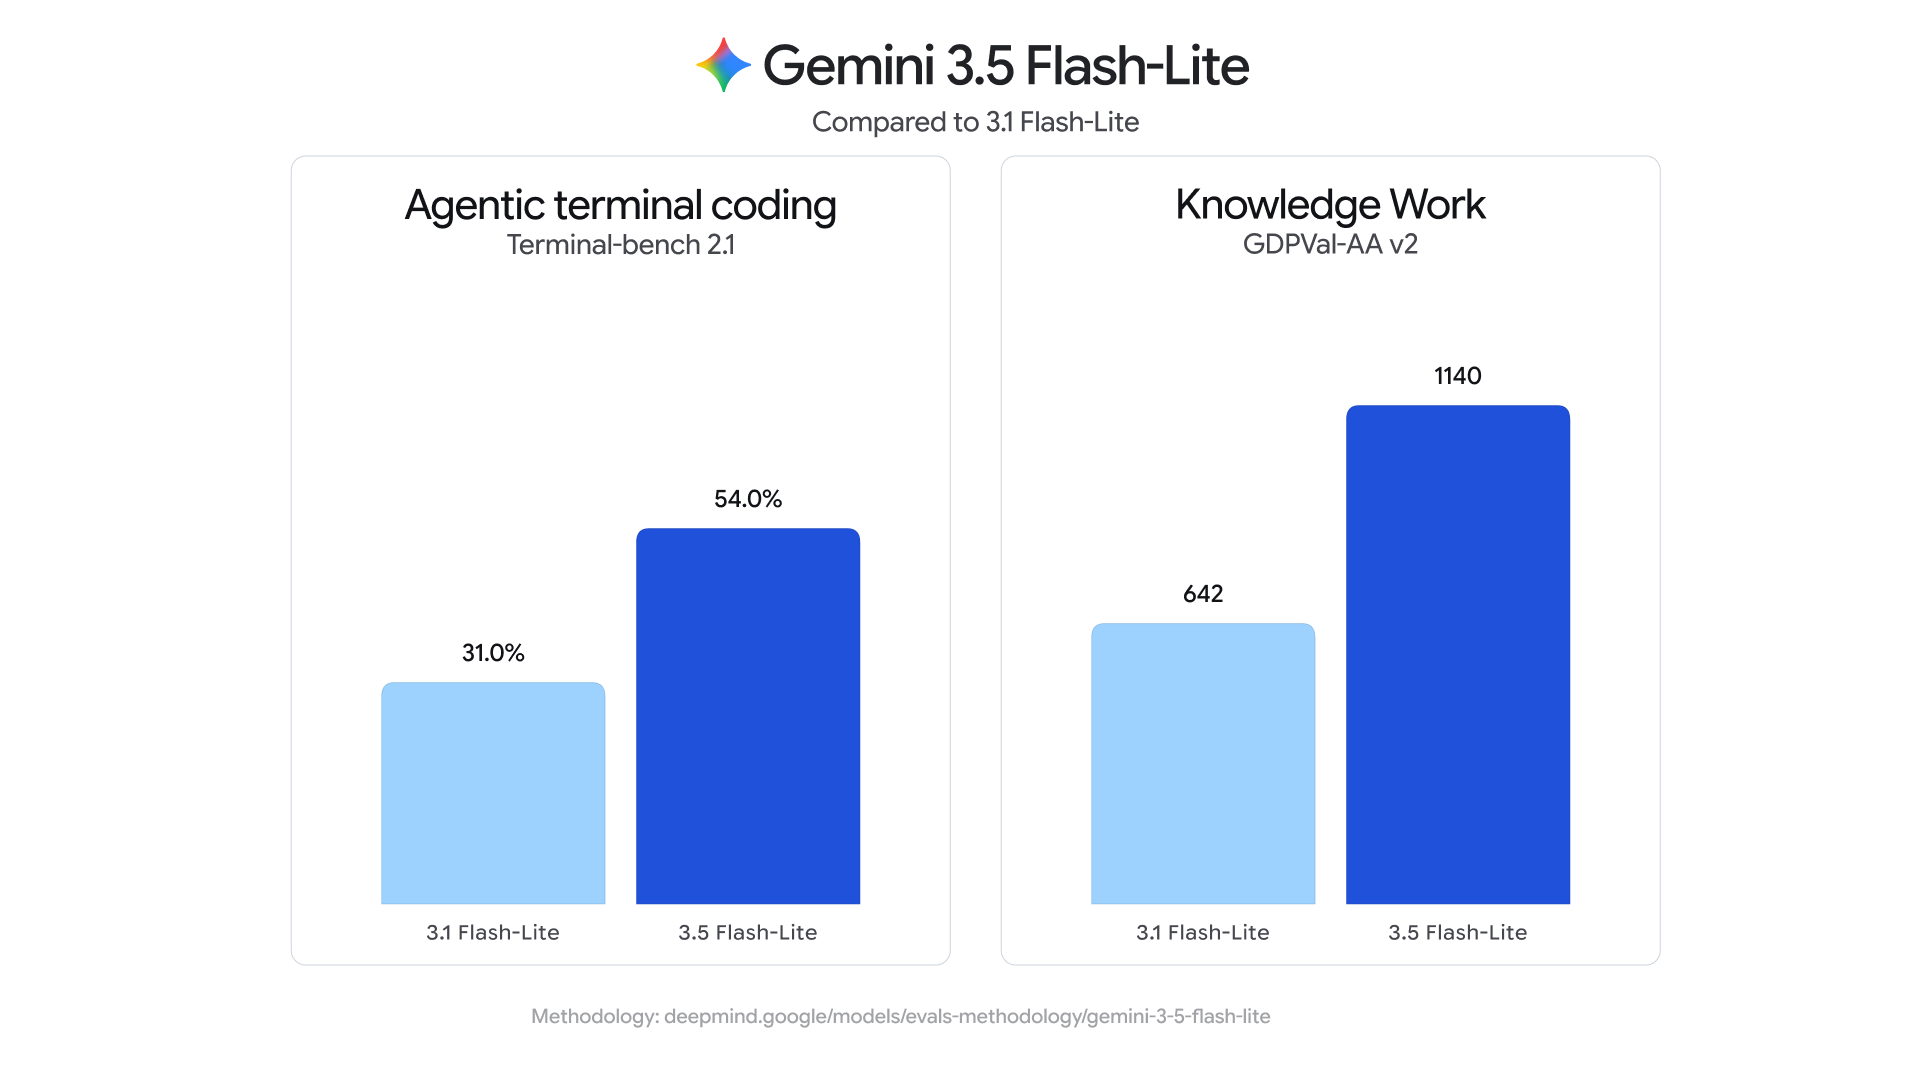
Agentenbasiertes Terminal-Coding springt von 31% auf 54% bei Terminal-Bench 2.1, und Wissensarbeit verdoppelt sich nahezu von 642 auf 1140 bei GDPval-AA v2. Google gibt an, dass es sogar das ältere 3 Flash bei SWE-Bench Pro und Computer-Use-Aufgaben übertrifft, sodass ihr für den niedrigen Preis kaum Qualität einbüßt. Wenn ihr Gemini gegen den Rest des Feldes abwägt, haben wir das in Gemini vs Claude, Gemini vs ChatGPT und der umfassenderen Übersicht zu Gemini-Alternativen aufgeschlüsselt.
Welches Modell wählt ihr tatsächlich?
Flash-Lite kam zusammen mit Gemini 3.6 Flash heraus, und die falsche Wahl verschwendet entweder Geld oder bringt einen Bot live, der überfordert ist. Die Faustregel ist simpel.
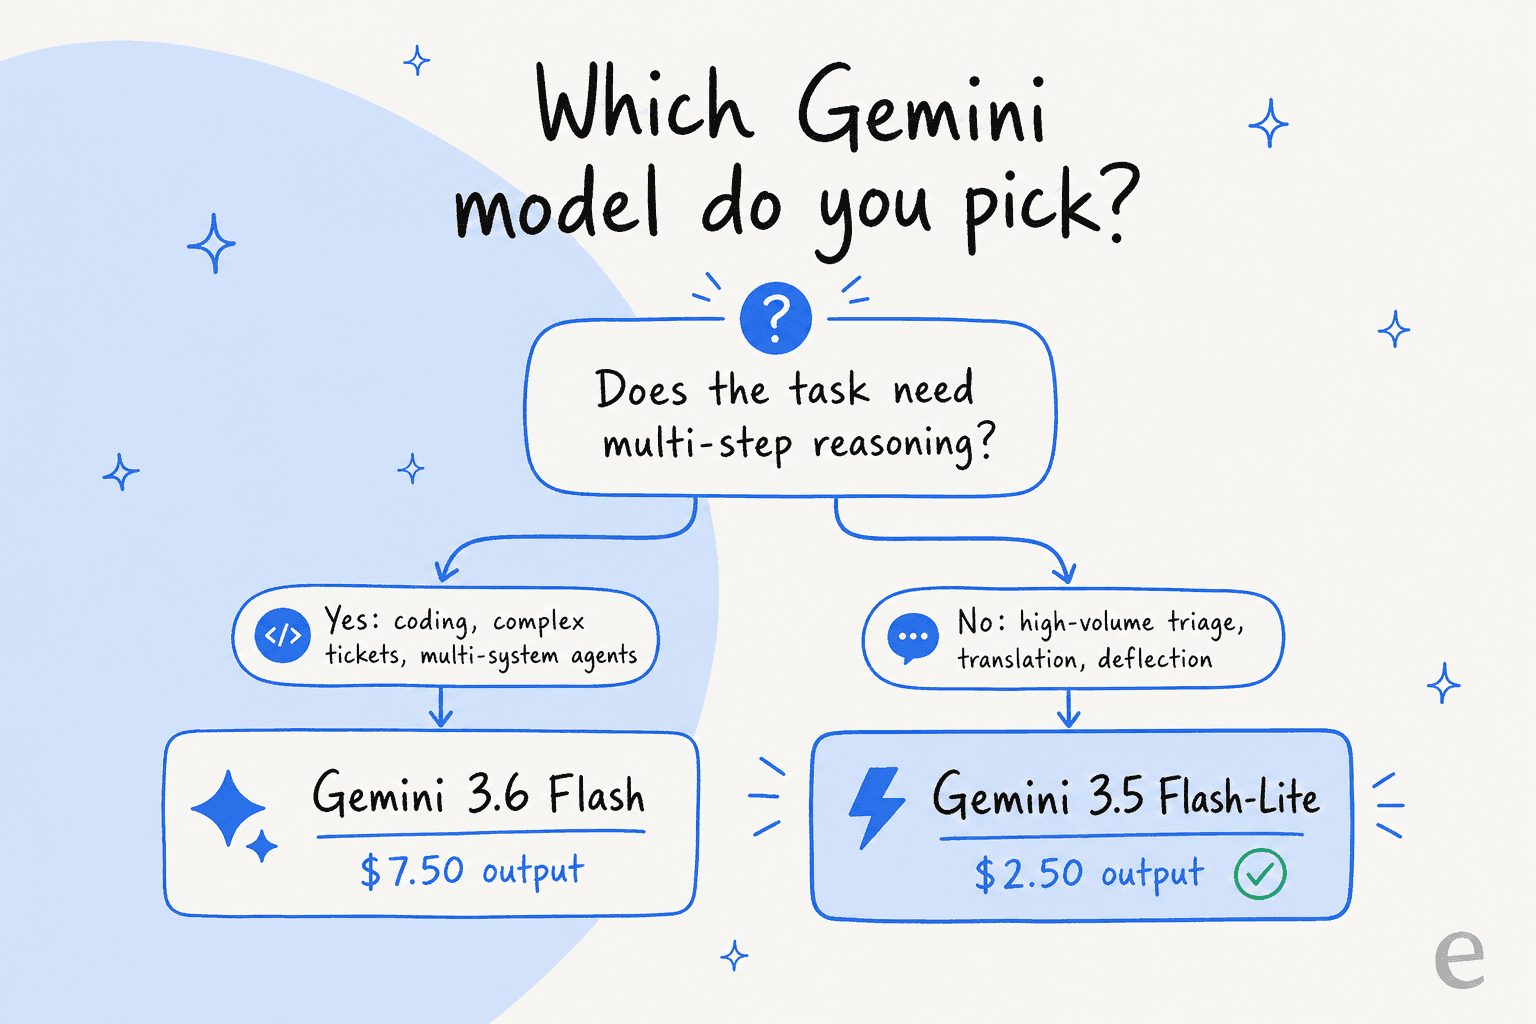
Greift zu 3.6 Flash, wenn die Arbeit echtes Reasoning braucht: mehrstufige Agenten, Coding, komplexe Support-Tickets, die mehrere Systeme berühren. Greift zu Flash-Lite, wenn ihr Volumen verarbeitet, bei dem jedes Element einfach ist, wie erste Triage, Live-Chat-Ablenkung von Routinefragen oder mehrsprachige Antworten im großen Stil. Ob ihr einen echten KI-Agenten oder einen skriptbasierten Bot baut, ist eine von der Modellwahl getrennte Entscheidung, und sie ist normalerweise wichtiger. Wenn ihr ein SaaS-Produkt betreibt, geht unsere Einschätzung zur besten KI für SaaS-Support durch, wo jedes Modell passt.
Was das bedeutet, wenn ihr KI für Support baut
Hier muss ich ehrlich mit euch sein, denn das ist der Teil, den jeder Modell-Preisartikel für Support-Teams auslässt.
Ein günstigeres, schnelleres Modell ist eine gute Nachricht. Aber Flash-Lite einzusetzen gibt euch keinen funktionierenden Support-Agenten, genauso wenig wie ein günstigerer Motor ein Auto ergibt. Ich stecke seit über drei Jahren KI in echte Support-Queues, und das Versagen, das ich immer wieder beobachtet habe, ist nicht, dass das Modell dumm ist, sondern dass ein selbstsicher klingender Bot einem echten Kunden eine falsche Antwort gibt, weil niemand die Schichten um das Modell herum gebaut hat. Das Modell ist die unterste Schicht des Stacks.
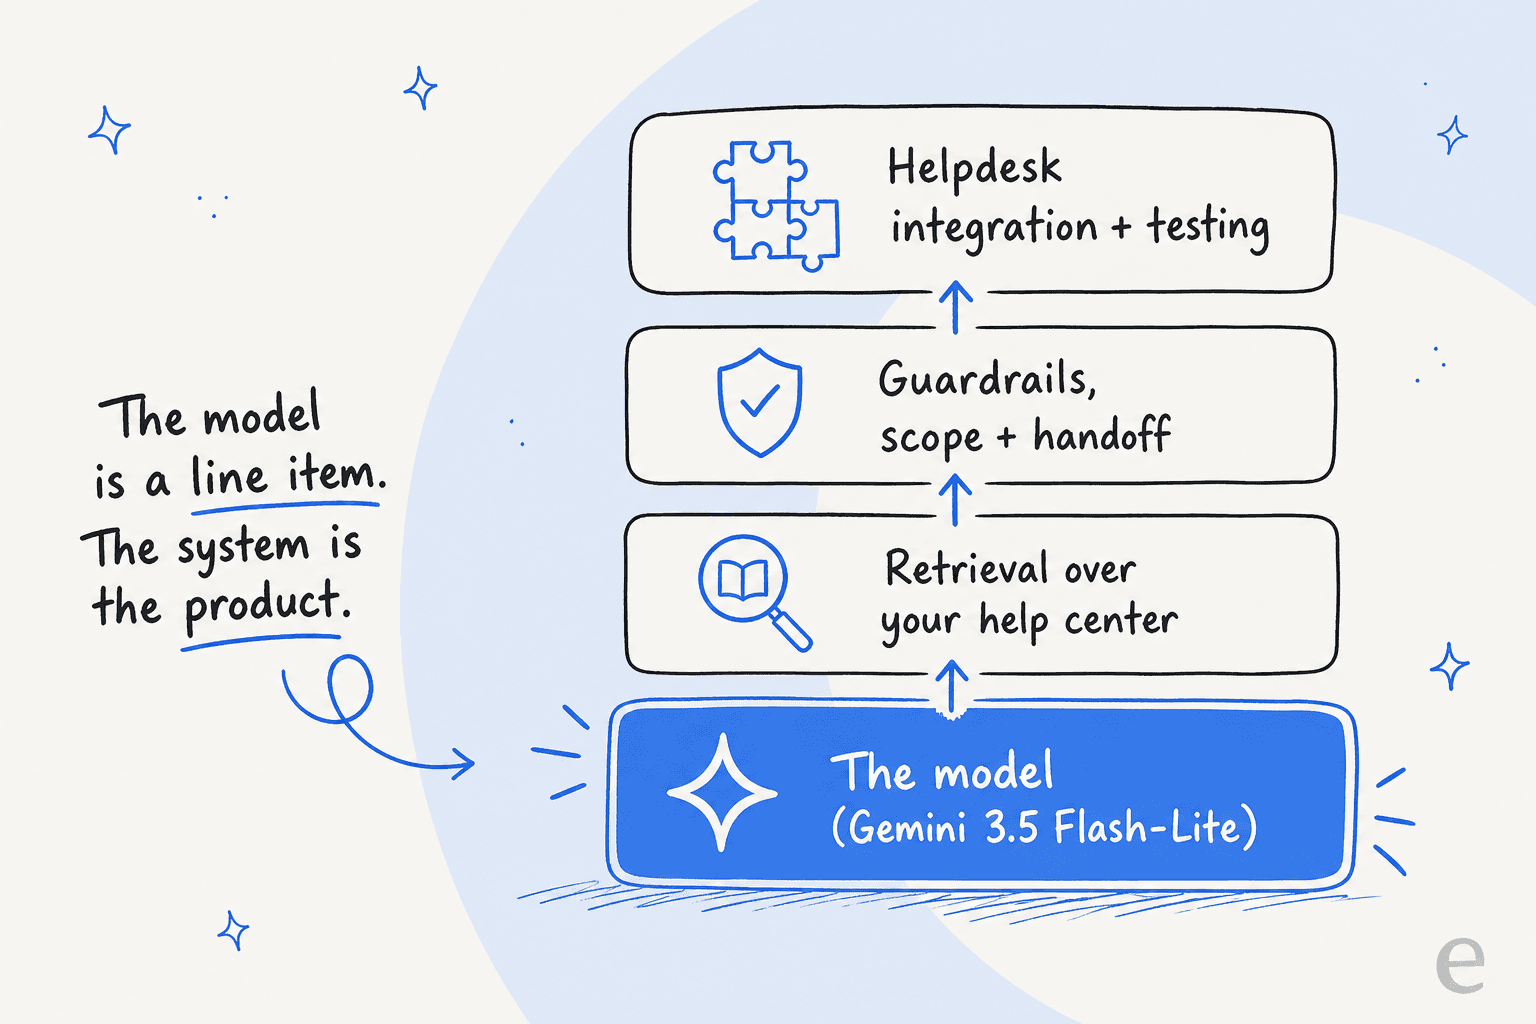
Diese Schichten sind die eigentliche Arbeit. Retrieval, damit das Modell aus eurem Help Center und vergangenen Tickets antwortet, statt zu raten. Guardrails und Scope, damit es sauber übergibt, statt sich eine Rückerstattungsrichtlinie auszudenken. Integration, damit es innerhalb eures Ticketing-Systems handeln kann. Und Tests, damit ihr wisst, wie es sich verhält, bevor es einen Kunden berührt. Das ist genau die Lücke zwischen einer rohen API und echter KI-Kundenservice-Software, und deshalb lassen sich KI-Chatbot-Probleme fast immer auf die Verrohrung zurückführen, nicht auf das Modell.
Deshalb würde ich auch davon abraten, die rohe Gemini-API selbst in euer Helpdesk zu verdrahten. Ihr würdet Retrieval, Guardrails gegen Halluzinationen, Simulation und jede Helpdesk-Integration von Grund auf neu bauen und dann pflegen, während sich die Modelle alle paar Wochen ändern. Dass Flash-Lite günstig ist, ändert an dieser Rechnung nichts. Das ist das ganze Argument für speziell gebaute Helpdesk-KI gegenüber einem DIY-Stack: Die Modellstufe ist ein Posten, das umgebende System ist das Produkt. Und wenn ihr den Agenten richtig trainiert, spielt das darunterliegende Modell für das Ergebnis kaum noch eine Rolle.
eesel ausprobieren
Genau diese Schicht will eesel sein. Ihr bindet es in euer bestehendes Helpdesk ein, es lernt von Anfang an aus euren vergangenen Tickets und eurer Wissensdatenbank, und es läuft auf Frontier-Modellen, sodass ihr die Effizienz bekommt, ohne die API selbst zu verdrahten.

Das Unterscheidungsmerkmal, das euch ein günstiges Modell allein nicht geben kann: Mit eesel könnt ihr den Agenten gegen eure historischen Tickets simulieren, bevor er je einen echten Kunden beantwortet, sodass ihr die Lösungsrate und die genauen Antworten seht, die er gesendet hätte, und das mit echtem ROI für KI-Support verknüpfen könnt. Und weil es nach der geleisteten Arbeit bepreist wird, nicht pro Token, spart ihr euch die Token-Rechnerei bei jedem Ticket. Wenn ihr Flash-Lite für den Aufbau von Support-Automatisierung kalkuliert, startet beim gewünschten Ergebnis und lasst die Plattform die Verrohrung übernehmen. Es ist kostenlos zum Ausprobieren.