

Gemini 3.6 Flash kostet $1.50 pro 1M Eingabe-Tokens und $7.50 pro 1M Ausgabe-Tokens im Standard-Bezahltarif, wobei die Ausgabe auch Thinking-Tokens umfasst. Der Batch-Modus halbiert beide auf $0.75/$3.75, und es gibt einen kostenlosen Tarif mit einem Haken: Google nutzt Ihre Inhalte zur Verbesserung seiner Produkte.
Die entscheidende Zahl gegenüber dem Vorgängermodell liegt auf der Ausgabeseite. Die Eingabe bleibt stabil, aber die Ausgabe sinkt von $9.00 auf $7.50, und weil 3.6 Flash pro Aufgabe außerdem rund 17% weniger Ausgabe-Tokens nutzt, kostet dieselbe agentische Aufgabe gleich doppelt weniger. Das ist das eigentliche Designziel der Flash-Reihe: möglichst viel Leistung pro Dollar für Arbeit, die Sie in großem Volumen ausführen.
Ein ehrlicher Hinweis, bevor Sie darauf aufbauen. Wenn Sie damit Kundensupport kalkulieren, ist $1.50/$7.50 ein Rechnungsposten, nicht die ganze Rechnung. Ich betreibe seit über drei Jahren KI-Agenten in echten Support-Warteschlangen, und der Token-Preis ist so gut wie nie der Ort, an dem das Geld wirklich hingeht. Mehr dazu weiter unten, plus einen Rechner, mit dem Sie Ihre eigenen Zahlen eingeben können.
Die Preise von Gemini 3.6 Flash auf einen Blick
Hier ist die vollständige Tabelle des Standardtarifs, direkt von Googles Preisseite. Der gewählte Verbrauchsmodus verändert den Tarif stärker als alles andere.
| Verbrauchsmodus | Eingabe (pro 1M) | Ausgabe (inkl. Thinking) | Kontext-Caching |
|---|---|---|---|
| Standard | $1.50 | $7.50 | $0.15 |
| Batch (50% Rabatt) | $0.75 | $3.75 | $0.075 |
| Flex | $0.75 | $3.75 | $0.075 |
| Priority | $2.70 | $13.50 | $0.27 |
| Kostenloser Tarif | Kostenlos | Kostenlos | Kostenlos |
Kurz gesagt: Standard ist die Voreinstellung, Batch und Flex haben denselben 50%-Rabatt-Tarif für Arbeit, die nicht in Echtzeit erfolgen muss, und Priority kostet das 1.8-fache für garantiert niedrige Latenz. Kontext-Caching zu $0.15 pro 1M ist der Hebel, den die meisten Teams zu wenig nutzen, er erspart es Ihnen, bei jedem Aufruf erneut für denselben System-Prompt oder Wissensausschnitt zu bezahlen. Es ist das neueste Arbeitspferd der Gemini-Familie und übernimmt die Rolle, für die Sie früher zu 3.5 Flash gegriffen hätten.
Rechnen Sie aus, was es Sie wirklich kostet
Die plakativen Tarife bedeuten erst etwas, wenn Sie sie mit Ihrem tatsächlichen Traffic multiplizieren. Geben Sie Ihr monatliches Volumen und die durchschnittliche Token-Anzahl ein, um die monatlichen Kosten im Standard- und Batch-Tarif sowie die Kosten pro Anfrage zu sehen.
Die Lektion, die die meisten Teams hier lernen: Bei jedem realistischen Volumen dominieren Ausgabe-Tokens die Rechnung, weshalb die Kürzung von $9.00 auf $7.50 bei der Ausgabe die zentrale Änderung ist und ein Modell, das mit weniger Tokens fertig wird, mehr wert ist als eines, das ein paar Cent pro Million günstiger ist.
Was sich seit Gemini 3.5 Flash geändert hat
Der Schritt von einer Generation zur nächsten ist ein reiner Kostenvorteil genau an der Stelle, die am meisten schmerzt. So stehen die beiden Modelle im Standardtarif zueinander, neben der Budget-Option.
| Modell | Eingabe (pro 1M) | Ausgabe (pro 1M) | Positionierung |
|---|---|---|---|
| Gemini 3.6 Flash | $1.50 | $7.50 | Das intelligenteste Flash-Modell, für Geschwindigkeit gebaut |
| Gemini 3.5 Flash | $1.50 | $9.00 | Vorheriges Flaggschiff-Flash |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | Günstigstes GA-Modell, für Arbeit mit hohem Volumen |
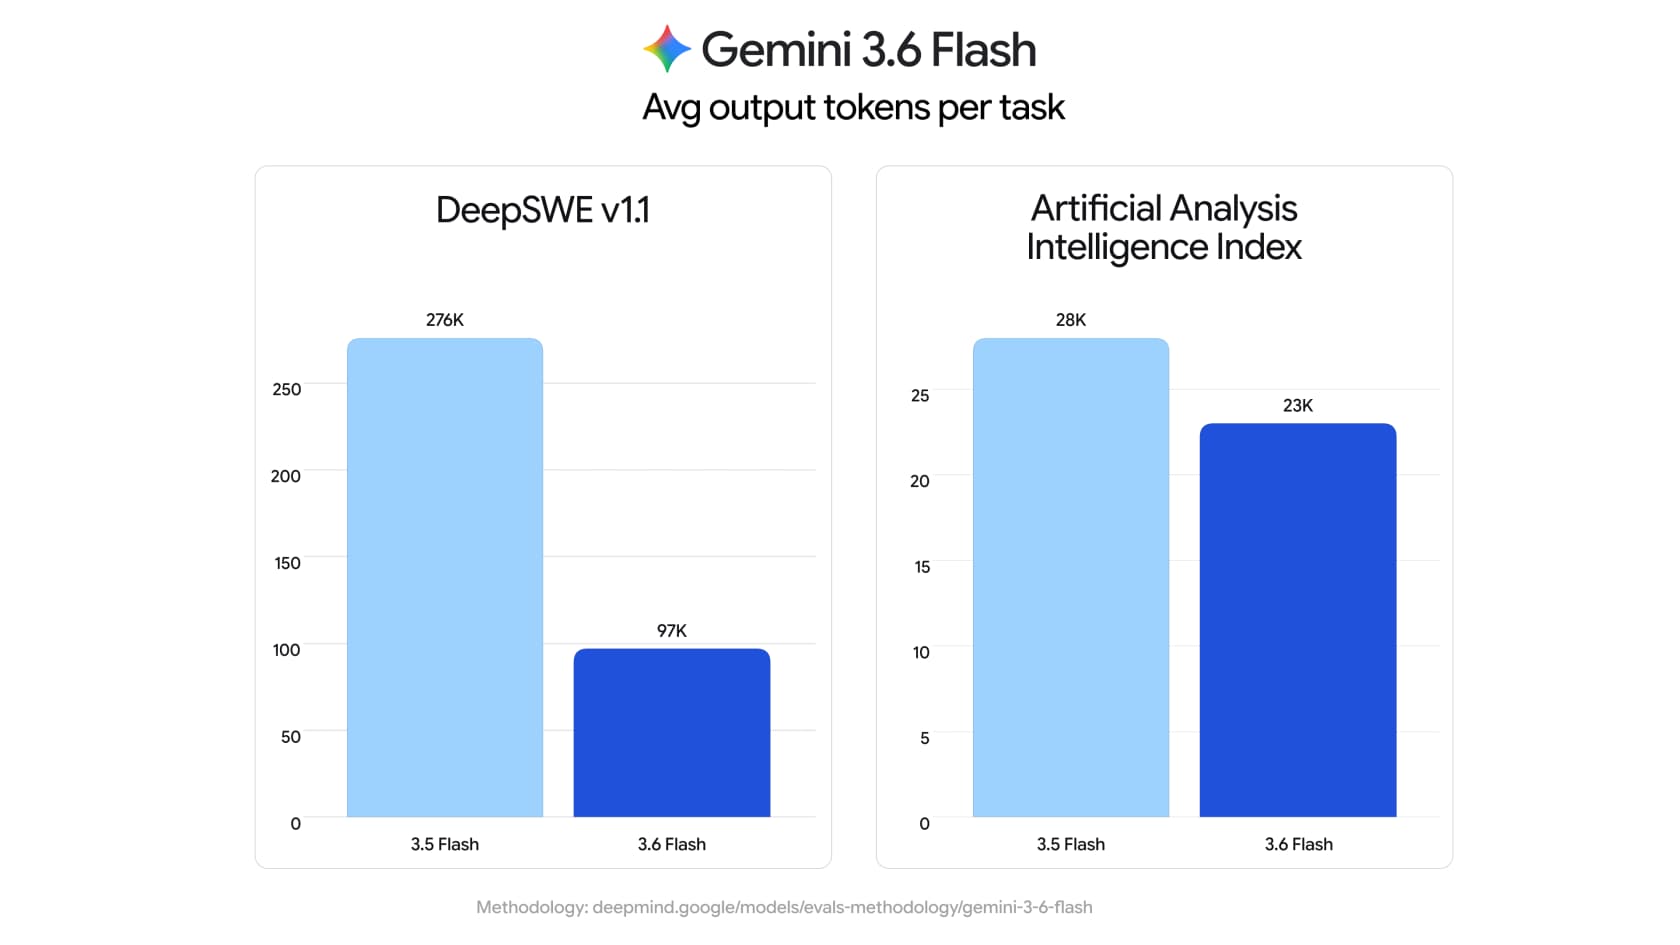
Es gibt eigentlich zwei Einsparungen, die sich übereinanderlegen. Die erste ist der ~17% niedrigere Ausgabe-Tarif. Die zweite ist die Token-Effizienz: Laut dem Artificial Analysis Index nutzt 3.6 Flash 17% weniger Ausgabe-Tokens, um dieselbe Arbeit zu erledigen, und bei agentischen Benchmarks wie DeepSWE erreichte der Unterschied 65% (die durchschnittliche Ausgabe sank von 276K auf 97K Tokens pro Aufgabe). Weniger Tokens bei einem niedrigeren Tarif verstärken sich gegenseitig, sodass die tatsächliche Ersparnis bei einer realen Arbeitslast größer ist, als der Preisnachlass vermuten lässt. Der Batch-Tarif erzählt dieselbe Geschichte: Der Batch von 3.6 Flash liegt bei $0.75/$3.75 gegenüber $0.75/$4.50 bei 3.5 Flash.
Im Anbietervergleich unterbietet dieser Ausgabetarif von $7.50 Claude Sonnet 5 (laut Listenpreis etwa $15 bei der Ausgabe) deutlich, während es bei den meisten agentischen Aufgaben in einer ähnlichen Qualitätsklasse landet. Wenn Sie wirklich das Flaggschiff-Segment suchen, lohnt sich ein Blick auf Googles eigene Gemini-Alternativen, solange sich 3.5 Pro weiter verzögert.
Die versteckten Kosten, die die Preistabelle nicht zeigt
Hier weicht eine echte Rechnung vom plakativen $1.50/$7.50 ab. Vier Posten bringen Teams immer wieder ins Straucheln.
- Thinking-Tokens werden als Ausgabe abgerechnet. 3.6 Flash unterstützt Thinking, und diese Reasoning-Tokens zählen zum $7.50-Ausgabetarif. Die Effizienzgewinne bei den Tokens helfen hier, aber ein Prompt mit viel Reasoning wird trotzdem teurer abgerechnet, als es die sichtbare Antwortlänge vermuten lässt.
- Search Grounding wird separat abgerechnet. Sie erhalten monatlich 5.000 kostenlose gegroundete Prompts über die gesamte Gemini-3-Familie, danach kostet es $14 pro 1.000 Suchanfragen, und eine einzelne Kundenanfrage kann mehrere abrechnungspflichtige Abfragen auslösen.
- Der kostenlose Tarif trainiert mit Ihren Daten. Im kostenlosen Tarif nutzt Google Ihre Inhalte, um seine Produkte zu verbessern. In keinem Bezahltarif geschieht das. Für alles, was Kundendaten betrifft, scheidet der kostenlose Tarif allein deshalb schon aus.
- Der Priority-Modus kostet einen Zuschlag von 1.8-fach. Wenn Sie garantiert niedrige Latenz brauchen, kostet Priority $2.70/$13.50, fast doppelt so viel wie Standard. Die meisten Teams brauchen das nicht, aber es lässt sich leicht aktivieren und vergessen.
Gemini 3.6 Flash vs. 3.5 Flash-Lite: wann das günstigere Modell gewinnt
Der wirksamste Weg, eine Gemini-Rechnung zu senken, ist oft gar nicht 3.6 Flash, sondern einfache Arbeit an Gemini 3.5 Flash-Lite weiterzuleiten. Bei $0.30/$2.50 ist Flash-Lite bei der Eingabe rund 5-mal und bei der Ausgabe rund 3-mal günstiger und läuft mit etwa 350 Ausgabe-Tokens pro Sekunde.
Die Faustregel betrifft die Tiefe des Reasonings, nicht die Treue zu einer Marke. Greifen Sie zu 3.6 Flash, wenn die Arbeit echtes mehrstufiges Reasoning erfordert: Programmierung, Agenten, die mehrere Systeme berühren, komplexe Support-Tickets. Greifen Sie zu Flash-Lite, wenn jeder Fall einfach ist und das Volumen hoch ist, wie bei der ersten Ticket-Triage oder der Live-Chat-Ablenkung von Routinefragen. Viele Produktionsumgebungen betreiben beides und leiten je nach Schwierigkeit weiter, was die günstigste Konfiguration von allen ist. Ob Sie einen echten Agenten oder einen regelbasierten Bot bauen, ist eine eigene Entscheidung, getrennt von der Modellwahl.
Account-Tarife, Ausgabenlimits und Rate Limits
Ihr Gemini-Preis wird auch dadurch bestimmt, in welchem Nutzungstarif sich Ihr Abrechnungskonto laut der Rate-Limits-Seite befindet.
| Nutzungstarif | Voraussetzung | Abrechnungsobergrenze |
|---|---|---|
| Kostenlos | Aktives Projekt oder kostenlose Testphase | Keine |
| Tier 1 | Verknüpftes aktives Abrechnungskonto | $250 |
| Tier 2 | $100 bezahlt + 3 Tage | $2,000 |
| Tier 3 | $1,000 bezahlt + 30 Tage | $20,000+ |
Zwei praktische Hinweise. Erstens laufen ausgabenbasierte Rate Limits auf einem rollierenden 10-Minuten-Fenster (Tier 1 liegt bei $10, Tier 2 und 3 bei $200), und eine Überschreitung liefert einen 429 RESOURCE_EXHAUSTED-Fehler, sodass eine Traffic-Spitze Sie drosseln kann, bevor Sie Ihr Monatsbudget erreichen. Zweitens: Wenn Sie wirklich in großem Maßstab arbeiten, bietet Googles Enterprise-Tarif provisionierten Durchsatz und Mengenrabatte, die nicht in der öffentlichen Tabelle stehen. Wie sich das im Vergleich zu den Consumer-Gemini-Plänen verhält, behandeln unser Gemini-Preise-Leitfaden und die Gemini Workspace Preise.
Was der Betrieb eines Support-Agenten wirklich kostet
Das ist der Teil, den jeder Beitrag über Modellpreise auslässt, und der Grund, warum ich Ihnen sagen würde, den Token-Tarif nicht überzubewerten, wenn Ihr Ziel Kundensupport ist.
Ein günstigeres, schnelleres Modell ist eine gute Nachricht. Aber $1.50/$7.50 sind die Kosten des blanken Motors, nicht des ganzen Autos. Ich betreibe seit über drei Jahren KI in echten Support-Warteschlangen, und das Versagen, das ich immer wieder beobachtet habe, ist nicht, dass das Modell zu teuer ist, sondern dass ein selbstbewusst klingender Bot eine falsche Antwort gibt, weil niemand die Schichten rund um das Modell gebaut und bezahlt hat. Diese Schichten sind die eigentlichen Kosten.

Retrieval über Ihr Help Center, damit aus Ihren Dokumenten geantwortet wird, statt zu raten. Halluzinations-Guardrails, damit saubere Übergaben stattfinden, statt eine Rückerstattungsrichtlinie zu erfinden. Integration, damit innerhalb Ihres Ticketsystems gehandelt werden kann. Und Tests, damit Sie wissen, wie es sich verhält, bevor es mit einem Kunden in Kontakt kommt. Bauen Sie das selbst auf der rohen API auf, zahlen Sie nicht $7.50 pro 1M Tokens, sondern ein Entwicklerteam, das Retrieval, Simulation und jede Helpdesk-Integration von Grund auf neu baut und dann pflegt, während sich Modelle alle paar Wochen ändern. Das ist das Argument für speziell gebaute Helpdesk-KI gegenüber einem selbstgebauten Stack, und deshalb lassen sich Probleme mit KI-Chatbots fast immer auf die Verrohrung zurückführen, nicht auf die Modellstufe.
Probieren Sie eesel aus
Genau diese Schicht soll eesel sein. Sie binden es in Ihren bestehenden Helpdesk ein, es lernt von Anfang an aus Ihren vergangenen Tickets und Ihrer Wissensdatenbank, und es läuft auf Spitzenmodellen wie Gemini, sodass Sie die Effizienz erhalten, ohne die API selbst zu verdrahten oder Token-Mathematik zu betreiben.
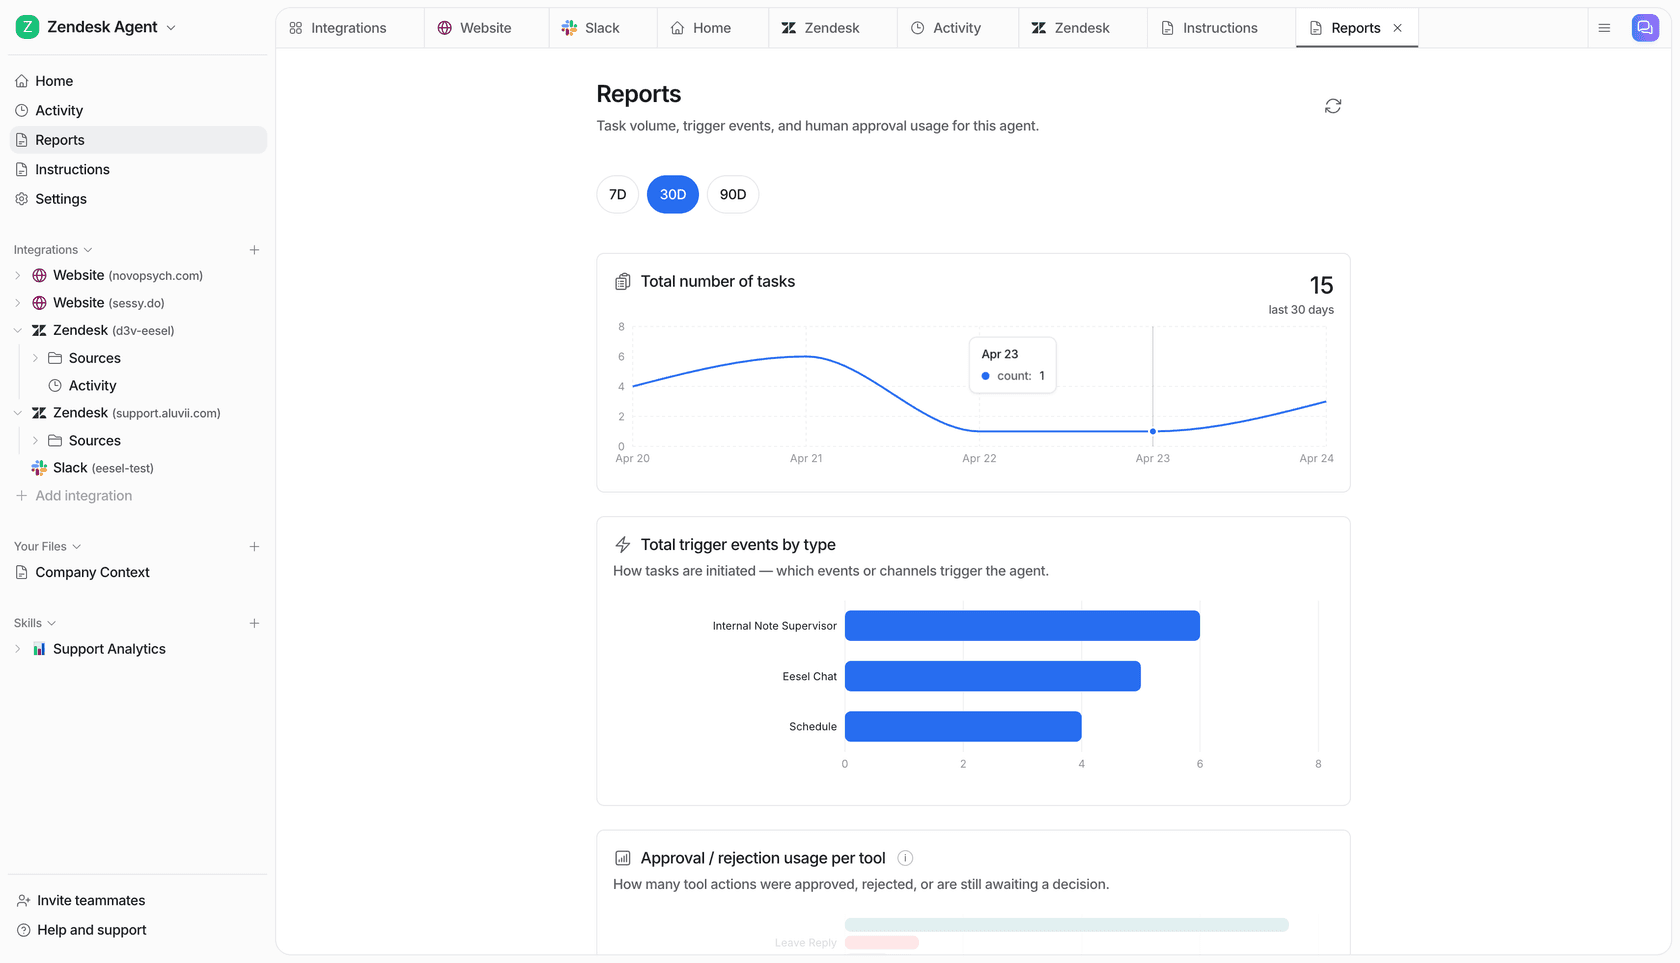
Die zwei Dinge, die für den Preis am wichtigsten sind, sind genau die, die der Token-Tarif nicht liefern kann. Erstens lässt eesel Sie den Agenten simulieren anhand Ihrer historischen Tickets, bevor er einem echten Kunden antwortet, sodass Sie die Lösungsrate und die genauen Antworten sehen, die er gesendet hätte, ohne raten zu müssen, wofür die Ausgaben stehen. Zweitens wird nach der geleisteten Arbeit abgerechnet, pro Lösung statt pro Token, sodass ein arbeitsreicher Monat nicht zu einer überraschenden API-Rechnung wird. Wenn Sie Modelle für den Aufbau von Support-Automatisierung kalkulieren, beginnen Sie mit dem gewünschten Ergebnis und lassen Sie die Plattform sich um die Verrohrung kümmern. Es lässt sich kostenlos testen.