

Am 2. September 2026 hat Google Gemini 3.8 Flash Cyber zusammen mit dem allgemeinen Gemini 3.8 Flash veröffentlicht. Es ist eine Version desselben Modells, getrimmt auf eine einzige Aufgabe: Sicherheitslücken in Software finden und patchen. Es ersetzt das ältere 3.5 Flash Cyber, und laut Google hat gerade das Cyber-Training die Fortschritte beim Coding und Reasoning im allgemeinen Modell vorangetrieben.
Zwei Dinge solltest du wissen, bevor du dir Hoffnungen machst. Erstens: Du kannst es mit ziemlicher Sicherheit nicht nutzen. Es ist über Googles Fairwind Program auf vertrauenswürdige Verteidiger beschränkt, ohne öffentliche API und ohne Self-Service-Zugang. Zweitens: Es ist das dritte große Labor in Folge, das sein stärkstes Cyber-Modell hinter einem Bewerbungsprogramm versteckt. OpenAI macht das mit GPT-5.6-Cyber über Daybreak, und Anthropic hat es bereits im April mit Claude Mythos 5 über Project Glasswing vorgemacht.
Wenn du als Verteidiger in keines dieser Programme kommst, ist die praktische Erkenntnis die, auf die ich beim Bau von KI-Agenten immer wieder komme: Das Modell ist die günstige unterste Schicht, und das System drumherum erledigt die eigentliche Arbeit. Das gilt für einen Sicherheitsagenten genauso wie für einen Support-Agenten.
Was Gemini 3.8 Flash Cyber eigentlich ist
Googles Gemini-Familie teilt sich in Pro-Modelle für das anspruchsvollste Reasoning und Flash-Modelle als schnelle, günstige Arbeitspferde. Flash Cyber ist etwas Drittes: ein Spezialist. Google hat das allgemeine Gemini 3.8 Flash genommen und in einem engen, folgenreichen Bereich stark nachgeschärft: Schwachstellen im Code erkennen, validieren und patchen, und das zu einem niedrigeren Preis pro Token, als ein großes Frontier-Modell kosten würde.
Der interessante Dreh diesmal ist die Richtung, in die der Nutzen floss. Bei Gemini 3.5 Flash Cyber im letzten Jahr war das Cyber-Modell klar ein nachgelagerter Spezialist. Bei 3.8 sagt Google, beide Varianten teilten dieselbe Grundintelligenz, und das Cyber-Training sei ein Teil des Grundes, warum das allgemeine Modell beim Coding und Reasoning besser wurde. Sicherheitsarbeit erweist sich als anspruchsvoller Lehrer: Fremden Code lesen, eine Hypothese aufstellen, wo er bricht, und das beweisen ist eine harte Reasoning-Schleife, und das Training darauf scheint sich auf ganzer Linie auszuzahlen.
Hier die ehrliche Einordnung, die die meiste Launch-Berichterstattung auslässt: Flash Cyber ist kein Chatbot, mit dem du dich unterhältst. Es ist eine Komponente, die immer wieder über riesige Codebasen läuft und nach Nadeln sucht. Genau diese Art von Massenarbeit ist es, wofür die Flash-Reihe da ist, und deshalb hat Google den Sicherheitsspezialisten auf Flash und nicht auf einem schwereren Pro-Modell gebaut. Billig genug, um es hundertmal laufen zu lassen, schlägt schlau genug, um es einmal laufen zu lassen.
Wer es wirklich bekommt: das Fairwind Program
Jetzt kommt der Teil, an dem die meisten Leser stutzen. Gemini 3.8 Flash Cyber ist nur für vertrauenswürdige Verteidiger über das Fairwind Program verfügbar. Es gibt keinen Schalter in AI Studio, keinen API-Schlüssel, keinen Self-Service-Tarif.
Der Grund liegt im Kern der Sorge: Dual-Use. Ein Modell, das hervorragend darin ist, ausnutzbare Bugs zu finden, ist im selben Atemzug ein Werkzeug, das sich ein Angreifer wünschen würde. Deshalb schränkt Google den Zugang so ein, wie man jede Fähigkeit einschränkt, die Verteidigern und Angreifern ungefähr gleich hilft: zunächst ein kontrollierter Rollout an einen geprüften Kreis von Nutzern. Das allgemeine 3.8 Flash wird mit den üblichen Schutzmaßnahmen gegen CBRN- und Cyber-Angriffe ausgeliefert; die Cyber-Variante läuft mit „einem permissiveren Satz an Schutzmaßnahmen“ und ist hinter dem Programm abgeschirmt.
Die genannten Fairwind-Partner zeigen, was „vertrauenswürdiger Verteidiger“ in der Praxis heißt: Sicherheits- und Infrastrukturteams bei Palo Alto Networks (Charlie Sestito), Snowflake (Mayank Upadhyay), Wiz (Gal Nagli) und Armadin (David Slater). Wenn du als Einzelentwickler hoffst, es heute Nachmittag auf deine eigenen Repositories anzusetzen, ist das nicht drin.
Wie gut ist es? Die Benchmarks für Verteidiger
Google hat hier nicht mit dem üblichen synthetischen Leaderboard begonnen. Es hat damit begonnen, was die eigenen Sicherheitsteams und Partner aus dem Modell herausgeholt haben, und das ist ein nützlicheres Signal als ein weiterer gesättigter Benchmark.
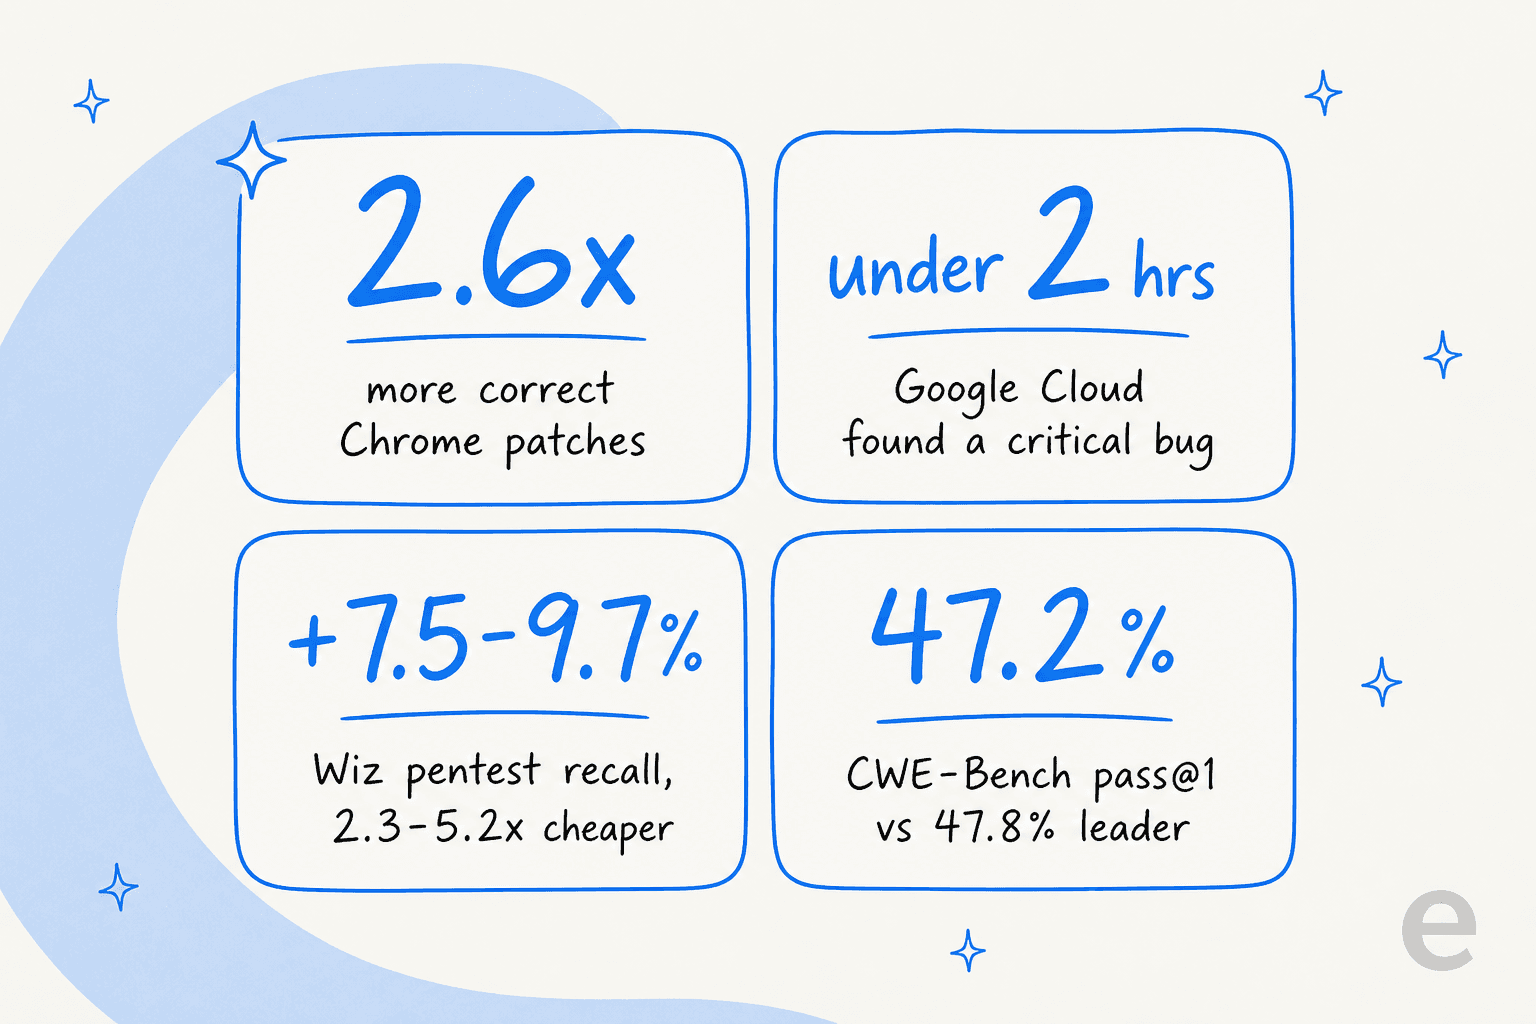
Das Chrome-Security-Team berichtete, das Modell habe 2,6-mal mehr korrekte Patches für Chrome-Schwachstellen erzeugt als die besten kommerziellen Modelle, die deutlich größer sind. Wiz maß 7,5 bis 9,7 % höheren Recall auf seinem internen Pentest-Benchmark bei 2,3- bis 5,2-fach niedrigeren Kosten, ein schönes Beispiel für den Handel „Leistung pro Dollar“, den die Flash-Reihe gewinnen soll. Und das Vulnerability-Research-Team von Google Cloud fand in unter zwei Stunden eine kritische grundlegende Schwachstelle, eine Arbeit, die laut Google normalerweise Monate dauert.
Bei den besser vergleichbaren Zahlen fällt die Geschichte bewusst bescheiden aus. Auf CWE-Bench, einem von Collinear betriebenen Benchmark für automatisches Patchen, erreichte Gemini 3.8 Flash Cyber 47,2 % pass@1 gegenüber 47,8 % bei einem führenden Frontier-Modell, also praktisch gleichauf, aber zu deutlich geringeren Kosten, und genau das ist der Pareto-Punkt, den Google macht. Auf einem internen Benchmark über 20 Programmiersprachen erzielte es eine Erfolgsquote von über 70 %, und laut Google übertrifft es sowohl 3.5 Flash Cyber als auch deutlich größere Frontier-Modelle auf CyberGym, einem Benchmark für autonome Schwachstellensuche.
Die Lesart ist dieselbe, mit der die Flash-Reihe generell gewinnt: nicht „Spitze des Leaderboards“, sondern konkurrenzfähige Frontier-Leistung zu einem Bruchteil der Kosten, weil Feintuning und Harness die Last tragen, die sonst die rohe Parameterzahl tragen müsste.
Das größere Muster: Inzwischen sperrt jeder sein Cyber-Modell
Wenn du nur Googles Beitrag liest, könntest du denken, ein zugangsbeschränktes Cyber-Modell sei eine Google-Eigenheit. Ist es nicht. Es ist inzwischen der Branchenstandard, und Google ist der Letzte, der nachgezogen hat.
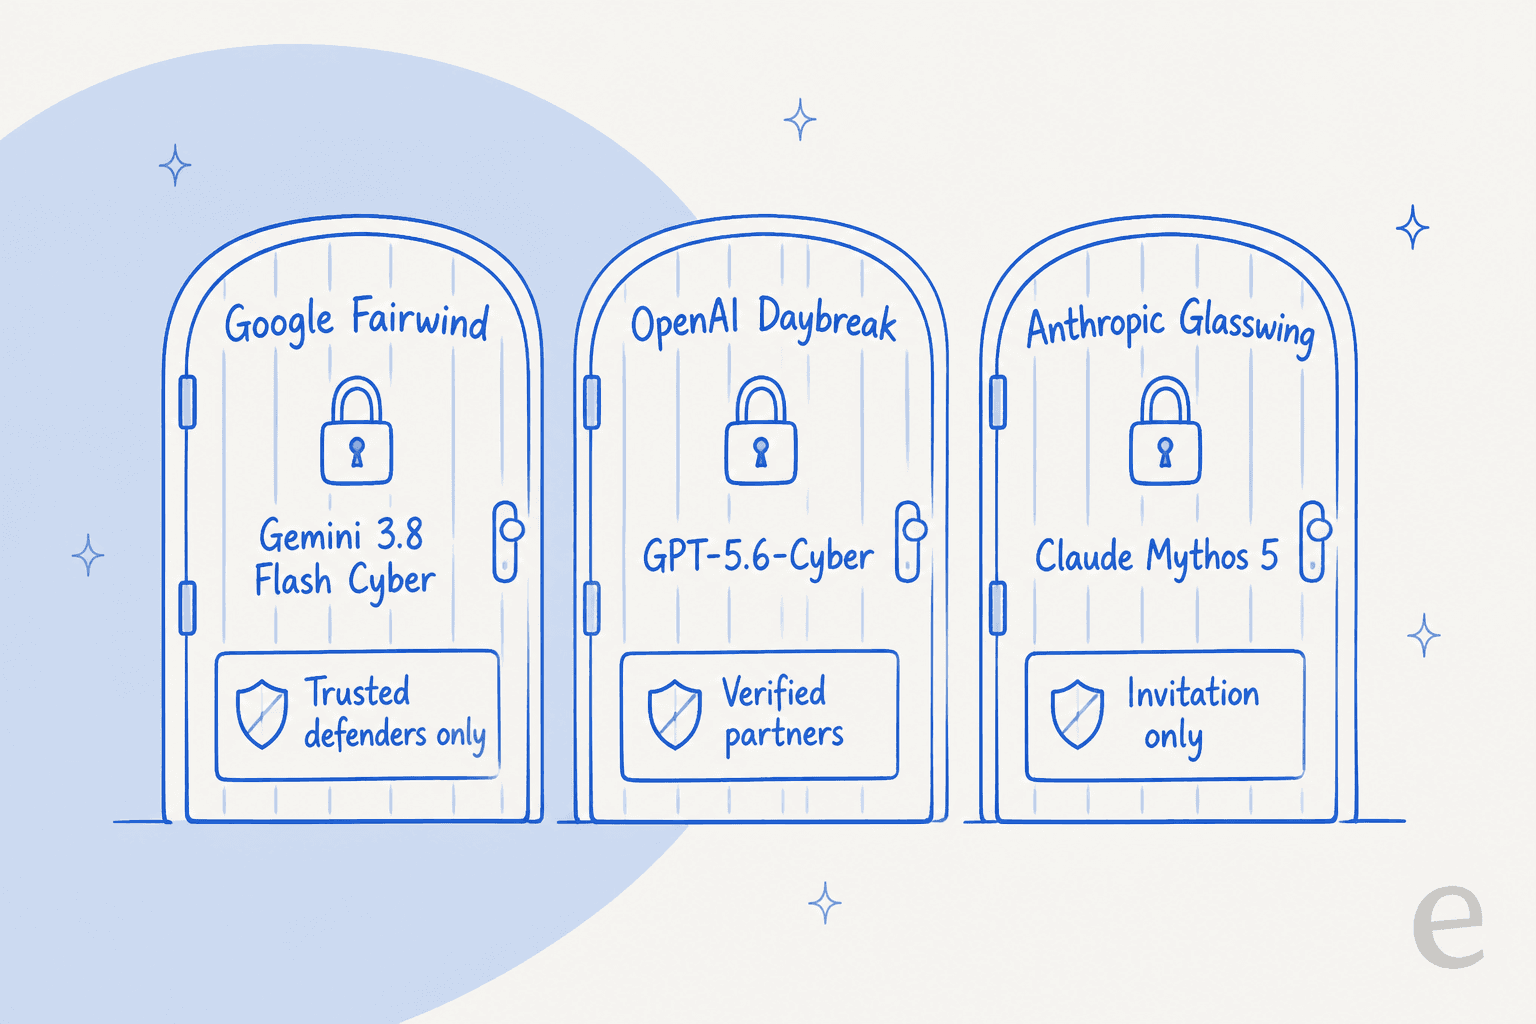
OpenAI schränkt GPT-5.6-Cyber über sein Daybreak-Programm ein. Es ist ein eigenständig trainiertes Modell auf Basis von GPT-5.6 Sol, erreichbar über verifizierte Einzel- und Partnerwege, und OpenAI hat nie einen Preis dafür veröffentlicht, die Cyber-Zeile auf der Preisliste ist buchstäblich leer.
Anthropic war als Erster dran. Project Glasswing startete am 7. April 2026, mehr als zwei Monate vor OpenAIs Programm, mit einer Zusage von 100 Mio. $ an Nutzungsguthaben und einem Dutzend Launch-Partnern. Das zugangsbeschränkte Modell, Claude Mythos 5, geht sauberer vor: Es hat dieselben zugrunde liegenden Gewichte wie das allgemein verfügbare Claude Fable 5, nur mit aufgehobenen Cybersicherheits-Schutzmaßnahmen statt eines Neutrainings von Grund auf. Anthropic veröffentlicht außerdem den Preis (10 $ / 50 $ pro Million Token), was keines der beiden anderen Labore für seine Cyber-Modelle tut.
So stehen die drei Programme zueinander:
| Dimension | Google Fairwind | OpenAI Daybreak | Anthropic Glasswing |
|---|---|---|---|
| Zugangsbeschränktes Modell | Gemini 3.8 Flash Cyber | GPT-5.6-Cyber | Claude Mythos 5 |
| Modelldesign | Gleiche Basis wie das allgemeine 3.8 Flash | Eigenständig auf Sol trainiert | Gleiche Gewichte wie Fable 5, Schutzmaßnahmen aufgehoben |
| Zugang | Vertrauenswürdige Verteidiger, nur auf Antrag | Verifizierte Partner + Einzelweg | Nur auf Einladung, kein Self-Service |
| Öffentlicher Preis | Keiner | Keiner | 10 $ / 50 $ pro 1 Mio. Token |
| Gestartet | 2. Sep 2026 | 10. Aug 2026 | 7. Apr 2026 |
Bemerkenswert ist Folgendes: Eine Regierung hat Anthropics Modelle Anfang des Jahres wegen eines Jailbreak-Streits für 18 Tage komplett abgeschaltet. Wenn eine Fähigkeit so sehr Dual-Use ist, dass ein staatlicher Akteur den Stecker zieht, wirkt die Zugangsbeschränkung nicht mehr wie eine Marketingentscheidung, sondern wie ein strukturelles Merkmal der ganzen Kategorie.
Was, wenn du an keines davon kommst?
Für die meisten Teams lautet die Antwort auf „welches zugangsbeschränkte Cyber-Modell soll ich nutzen“: „keines davon, denn du kannst nicht.“ Die nützliche Frage wird also, was du tun kannst.
Wenn du wirklich Dual-Use-Sicherheitsfähigkeiten brauchst, ist der praktischste Weg heute Anthropics Cyber Verification Program, eine kostenlose Bewerbung mit deiner bestehenden Organisation und etwa zwei Werktagen Bearbeitungszeit, die die Schutzmaßnahmen bei Modellen der Klassen Opus und Sonnet lockert (nicht bei Mythos selbst). Das Finden von Schwachstellen im Quellcode funktioniert bei Claude Opus 5 schon ab Werk, und es ist das Nächste an einer Self-Service-Vertrauensstufe, das irgendein Labor anbietet.
Aber tritt einen Schritt zurück, denn hier ist der Launch relevant, selbst wenn du das Modell nie anfasst. Gemini 3.8 Flash Cyber ist ein sauberes Fallbeispiel für ein Muster, dem ich in jedem KI-Agenten-Projekt begegne: Das Modell ist die unterste Schicht, nicht das Ganze. Google hat kein „Sicherheitsmodell“ ausgeliefert und es dabei belassen, sondern das Modell in ein System verpackt, das einen Bug erkennt, beweist, dass er echt ist, einen Fix schreibt und prüft, dass der Fix den Build nicht kaputt gemacht hat. Die Intelligenz steckt ebenso in dieser Hülle wie in den rohen Gewichten.
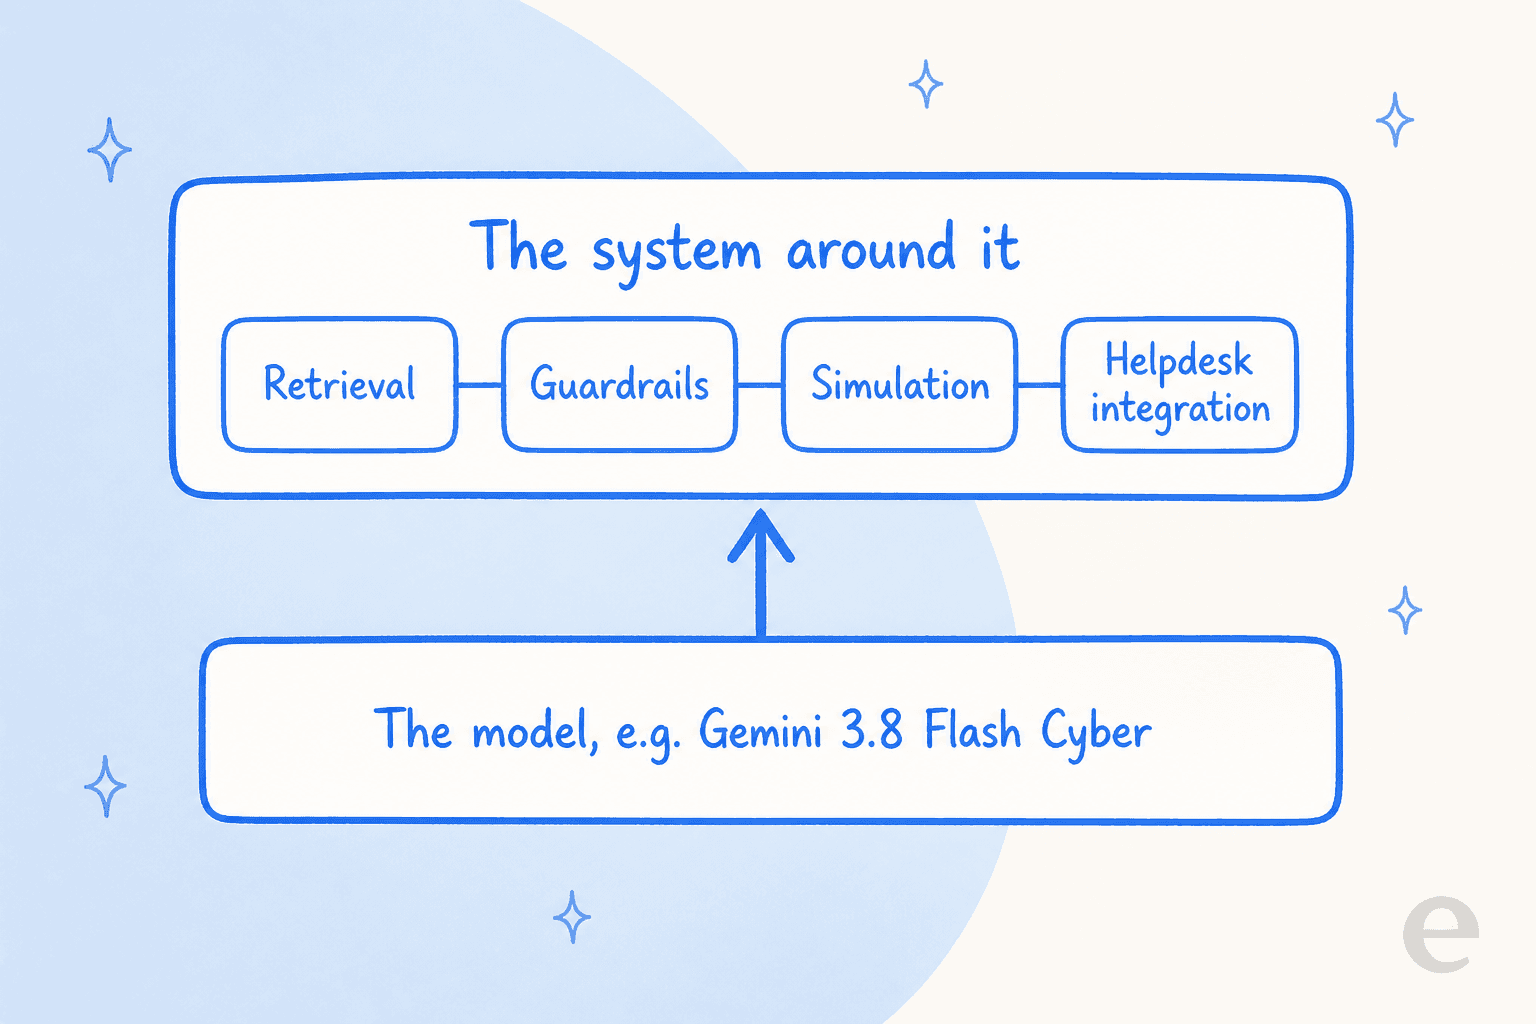
Ich habe Jahre im Team verbracht, das KI auf echte Support-Queues setzt, und der Fehler, den ich immer wieder gesehen habe, ist derselbe, den ein gutes Sicherheits-Harness verhindern soll: ein selbstsicher klingendes Modell gibt eine falsche Antwort, weil niemand die Schichten drumherum gebaut hat. In der Sicherheit ist ein nicht validierter „Fix“, der den Build zerschießt, der Fehlerfall. Im Kundensupport ist es ein selbstsicherer Bot, der eine Rückerstattungsrichtlinie erfindet. Dieselbe Krankheit, andere Domäne. Die Heilung ist auch dieselbe: Retrieval, damit das Modell aus echten Quellen antwortet statt zu raten, Leitplanken, damit es sauber übergibt, und Tests, damit du weißt, wie es sich verhält, bevor es irgendetwas Echtes anfasst.
Wenn also ein neues Modell erscheint, ob Cyber, das allgemeine 3.8 Flash oder das nächste Ding in drei Wochen, lautet die richtige Frage für ein Support-Team nicht „ist das Modell gut genug“. Für die meiste Arbeit ist es das bereits. Die eigentliche Frage ist, wer das Retrieval, die Leitplanken, die Simulation und die Helpdesk-Integration darum herum baut, denn das ist die eigentliche Arbeit, und deshalb ist es eine Falle, eine rohe API selbst an deinen Helpdesk anzubinden.
eesel testen
Ein Frontier-Modell ist Infrastruktur. eesel ist das Teammitglied, das du obendrauf einstellst. Für den Support ist eesel für deinen Helpdesk das, was ein Sicherheits-Harness für ein Cyber-Modell ist: ein KI-Support-Teammitglied, das sich in deine bestehenden Tools einklinkt, von Haus aus aus deinen vergangenen Tickets und deiner Wissensdatenbank lernt und auf Frontier-Modellen läuft, sodass du die Leistungsgewinne bekommst, ohne die API selbst anzubinden.

Der Teil, der direkt zur Idee „validieren, bevor du auslieferst“ passt, ist die Simulation: eesel lässt das Teammitglied gegen deine historischen Tickets laufen, bevor es je einem echten Kunden antwortet, sodass du die Lösungsquote und die genauen Antworten siehst, die es gesendet hätte. Und weil es nach der geleisteten Arbeit abgerechnet wird statt pro Token, sparst du dir die Token-Rechnerei bei jedem Ticket. Wenn du Modelle für den Aufbau von Support-Automatisierung bewertest, starte beim gewünschten Ergebnis und lass die Plattform die Technik darunter wählen. Der Test ist kostenlos.