

Warum überhaupt über Gemini 3.8 Live Avatar hinausschauen
Zuerst möchte ich Google gegenüber fair sein, denn das Produkt hat es verdient. Gemini 3.8 Live Avatar beobachtet Ihre Kamera und Ihren Bildschirm, während es zuhört, löst im Hintergrund asynchrone Tool-Aufrufe aus, sodass es Sie zum Beispiel mitten im Gespräch in einem Hotel einchecken kann, und erkennt Sprachen und wechselt zwischen ihnen, ohne dass das Gesicht aus dem Takt gerät. Es ist eine der vollständigsten Live-Agenten-Demos, die ein Labor bisher geliefert hat.
Der Haken sind Zugang und Lock-in. Es wurde innerhalb von Gemini Enterprise allgemein verfügbar, ist also eine Google-Cloud-Verpflichtung und kein API-Schlüssel fürs Wochenende. Eigene Avatare aus Ihrem eigenen Referenzmaterial sind hinter einer Allowlist plus Verifizierungsschritt gesperrt, Sie können also nicht am ersten Tag einfach ein gebrandetes Gesicht hochziehen. Und sobald Sie darauf aufbauen, lebt Ihr Live-Agent vollständig in Googles Ökosystem.
Es gibt außerdem einen Kostenpunkt, den man vor dem Vergleich kennen sollte. Bei der Live API kommt der Avatar-Video-Zähler auf etwa $0.37 pro Minute Avatar-Sprechzeit (abgerechnet nur, solange er spricht, nicht während er wartet). Das ist nicht überzogen, aber bei Support-Volumen echtes Geld, und es verändert den Vergleich: Sie wählen kein kostenloses Extra, sondern ein Produkt mit Minutenpreis. Damit lohnt sich ein genauer Blick auf die Alternativen.
Wie man über die Alternativen nachdenkt
Die sieben Tools hier gehören nicht wirklich zu einer Kategorie. Sie teilen sich in drei, und wer weiß, in welcher Spur er unterwegs ist, spart sich viele nutzlose Testphasen. Für ein breiteres Feld jenseits von Avataren deckt unsere Übersicht der besten KI-Kundenservice-Tools auch die textbasierten Optionen ab.
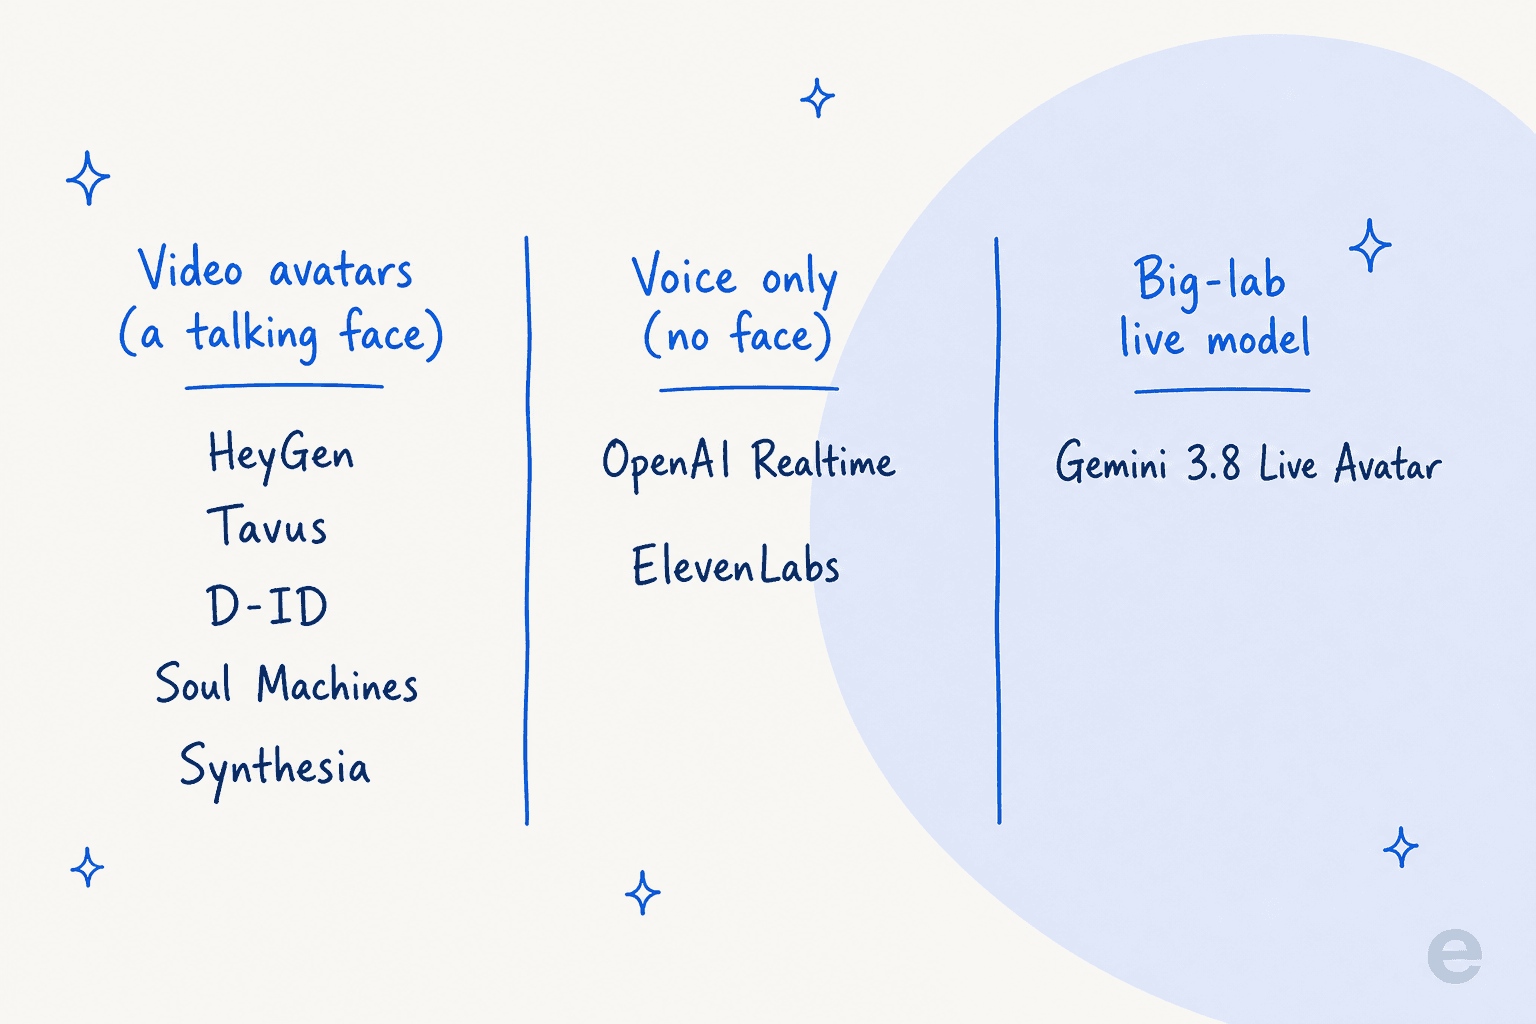
- Video-Avatare (ein sprechendes Gesicht): HeyGen, Tavus, D-ID, Soul Machines und Synthesia. Sie rendern einen animierten Menschen, der seine Antworten lippensynchron spricht. Das ist die engste Entsprechung zu dem, was Gemini 3.8 Live Avatar tut.
- Nur Sprache (ohne Gesicht): die OpenAI Realtime API und ElevenLabs. Dieselbe Echtzeit-Konversation, aber ohne gerendertes Gesicht. Günstiger, einfacher und oft alles, was ein Support- oder Vertriebsfall wirklich braucht. Wenn Sie das ganze Feld abwägen, ist unser Leitfaden zu den Vorteilen von Conversational AI eine gute Einführung.
- Live-Modell eines großen Labors: Gemini 3.8 Live Avatar selbst, neben Dingen wie der OpenAI Realtime API, bei denen Modell und Medienpipeline aus einem einzigen Frontier-Labor stammen.
Hier kommt der Teil, den die meisten Vergleiche auslassen. Jedes Tool in allen drei Spuren konkurriert auf derselben obersten Schicht: Gesicht, Stimme, Sprecherwechsel, Latenz. Nichts davon berührt die Schicht darunter, in der ein Support-Gespräch tatsächlich gelingt oder scheitert.
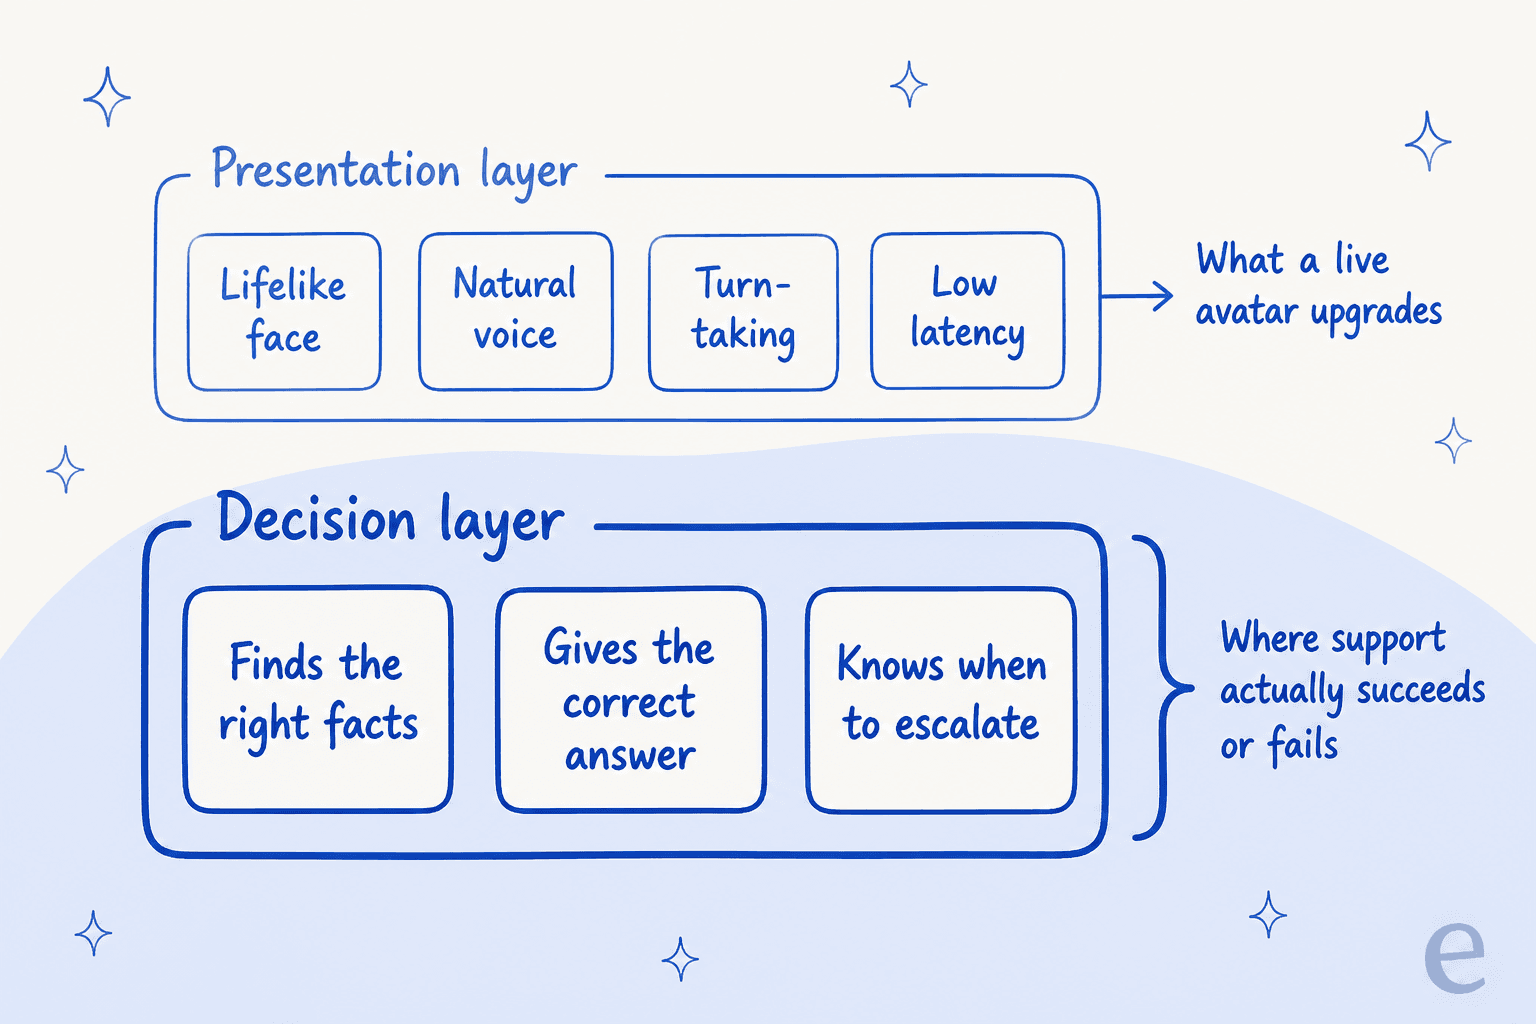
Ich komme darauf zurück, warum diese Entscheidungsschicht der schwierige Teil ist. Zuerst die Tools.
Die Alternativen im Überblick
| Tool | Am besten für | Gesicht oder Stimme | Echtzeit-Latenz (Herstellerangabe) | Abrechnungseinheit | Einstiegspreis | Auffälligste Grenze |
|---|---|---|---|---|---|---|
| HeyGen LiveAvatar | Gebrandete Video-Avatare in großem Maßstab | Video-Avatar | <300ms bis zum ersten Frame | Credits pro Streaming-Minute | Free ($0, 10 Credits); Essential $99 | $0.01/min nur bei Enterprise |
| Tavus | Entwickler, die Live-Videoagenten einbetten | Video-Avatar | ~134ms Rendering, unter 1s Round-Trip | Minute Conversational Video | Free (25 min); Starter $59 | Kritik am Sprecherwechsel; Developer-first-Wende |
| D-ID | No-Code-Streaming-Avatare mit RAG | Video-Avatar | Unter 2 Sekunden | Gemeinsamer monatlicher Minutenpool | 14 Tage Testphase; API Build $14.40 | Pool ohne Übertrag; Abrechnungsbeschwerden |
| Soul Machines | Emotional ausdrucksstarke digitale Menschen | Video-Avatar | Nicht veröffentlicht | Minuten interaktiver Gespräche | Free (nur Bauen); Basic $12.99 | Skaliert steil; wenige Bewertungen |
| Synthesia | Unternehmensvideo in großem Maßstab | Video-Avatar (meist asynchron) | N/A (Kern ist vorgerendert) | Credits, plus pro Minute für Live | Free ($0); Starter $19 | Kernprodukt ist nicht in Echtzeit |
| OpenAI Realtime API | Eigenen Sprachagenten bauen | Nur Stimme | Niedrig (Sprache-zu-Sprache) | Audio-Tokens | $32 / 1M Audio-Eingabe-Tokens | Kein Gesicht; Baukasten, kein fertiger Agent |
| ElevenLabs | Menschlich klingende Sprachagenten | Nur Stimme | Unter einer Sekunde (angegeben) | Gesprächsminuten | Free (15 min); Starter $6 | Kosten summieren sich; Credits verfallen beim Downgrade |
Jetzt die Details zu jedem einzelnen.
1. HeyGen LiveAvatar
Am besten für: Teams, die einen polierten, gebrandeten Talking-Head-Avatar an echte Nutzer streamen wollen, mit minimaler Infrastruktur.
HeyGen hat sein Echtzeitprodukt in LiveAvatar umbenannt, und es ist hier der am schlüsselfertigsten einsetzbare Video-Avatar. Er streamt 1080p-Avatare mit, laut HeyGen, unter 300ms bis zum ersten Frame und unbegrenzter Parallelität, und lässt sich in etwa fünf Minuten einbetten. Es gibt zwei Build-Modi: FULL, bei dem HeyGen den gesamten Sprach- und Rendering-Stack betreibt, und LITE, bei dem Sie Ihr eigenes LLM und Text-to-Speech mitbringen.
Preise. LiveAvatar rechnet in Credits ab, und das Verhältnis hängt vom Modus ab: FULL kostet 2 Credits pro Minute, LITE 1 Credit pro Minute. Die Tarife: Free ($0, 10 Credits, mit Wasserzeichen, 2-Minuten-Sitzungen), Essential ($99 für 1,100 Credits), Business ($475 für 6,000 Credits) und Enterprise. Das Schlagwort „$0.01/min im großen Maßstab“ stimmt, greift aber erst im Enterprise-Tarif, den das Help Center bei Budgets ab etwa $40,000 ansetzt. Beachten Sie, dass dies getrennt von HeyGens Kern-Videotarifen ist.
Die ehrliche Grenze. Der Wert <300ms ist eine Angabe für die neue Plattform, und es gibt ihn zum Teil, weil das ältere HeyGen Streaming Avatar SDK in Entwicklerforen den Ruf hatte, in der Praxis Latenzen von mehreren Sekunden zu haben. Wenn niedrige Latenz entscheidend ist, testen Sie sie mit Ihrem eigenen Traffic, bevor Sie sich festlegen.
Fazit: der einfachste Weg, einen gut aussehenden gebrandeten Avatar vor Nutzer zu bringen. Lesen Sie nur die Credit-Rechnung, denn der FULL-Modus verbraucht doppelt so schnell, wie der LITE-Schlagwortpreis vermuten lässt.
2. Tavus
Am besten für: Ingenieure, die einen Echtzeit-Videoagenten einbetten wollen und Wert auf Realismus und Latenz legen.
Tavus baut das Conversational Video Interface, eine vollständige Echtzeit-Videopipeline, die Sie über eine API steuern. Der Modell-Stack ist ungewöhnlich konkret: Raven für die Wahrnehmung, Sparrow für den Sprecherwechsel und der Phoenix-Renderer, von dem Tavus behauptet, er erreiche rund 134ms Rendering bei einem Konversations-Round-Trip unter einer Sekunde. Eine API ersetzt die fünf oder sechs Anbieter, die Sie sonst verdrahten müssten, denn LLM, Text-to-Speech und WebRTC sind im Minutenpreis enthalten.
Der Realismus kommt bei denen an, die es ausprobieren:
"Felt like talking to a person, I couldn't bring myself to treat it like a piece of code, that's how real it felt."

Preise. Tavus nutzt ein Hybridmodell: eine monatliche Gebühr plus enthaltene Conversational-Video-Minuten mit Pay-as-you-go-Mehrverbrauch. Basic ist kostenlos (25 min/Monat), Starter kostet $59/Monat (100 min, danach $0.37/min), und Growth kostet $397/Monat (1,250 min, danach $0.32/min). Das Training eigener Gesichter ist ein Add-on, für $65 pro Stück nach einigen kostenlosen Trainings im Starter.
Die ehrliche Grenze. Der beständige Kritikpunkt, direkt aus derselben Demo, ist der Sprecherwechsel:
"The AI kept cutting me off, and not leaving time in the conversation to respond. It would cut off utterances before the end."
Sparrow wurde genau dafür gebaut, es sollte also inzwischen besser sein, aber die Unterbrechungsbehandlung ist das, was Sie hart testen sollten. Tavus ist außerdem 2026 zu Developer-first gewechselt und richtet sich damit an Ingenieure, nicht an Marketer.
Fazit: die beste Wahl, wenn Sie Entwickler sind, das realistischste Echtzeit-Gesicht wollen und die Integrationsarbeit selbst übernehmen. Testen Sie die Unterbrechungen, bevor Sie live gehen.
3. D-ID
Am besten für: Teams, die einen Streaming-Avatar mit eingebauter Wissensbasis und einem No-Code-Weg wollen, nicht nur eine API.
D-ID Agents sind per WebRTC gestreamte Konversations-Avatare, die Sie mit dem Client-SDK, der REST-API oder einer Einbettung ohne Backend bauen können. Jeder Agent kombiniert einen Avatar mit einem LLM (auch eigenem), einer RAG-Wissensbasis und Gesprächsgedächtnis, und D-ID bewirbt „über 90 % Genauigkeit in unter zwei Sekunden“. Wer es mag, schätzt die Avatar-Qualität wirklich:
"For me at the moment the best live interactive Avatars on the market. Good lip Sync, really realistic."

Preise. D-ID führt zwei Preislisten, Studio und API, die beide Credits gegen einen gemeinsamen monatlichen Minutenpool abrechnen, der Videos, Agenten und Übersetzung zusammen abdeckt. Auf der API-Seite kostet Build $14.40/Monat (bis zu 32 Streaming-Minuten), Launch $35/Monat (bis zu 90) und Scale $138.60/Monat (bis zu 400). Es gibt eine 14-tägige Testphase, aber keinen dauerhaften kostenlosen Tarif, und ernsthaftes Live-Agenten-Volumen ist ein Enterprise-Gespräch über „individuelle Minuten“.
Die ehrliche Grenze. Zwei Dinge. Der Minutenpool wird nicht übertragen, ungenutzte Minuten verfallen also zu jedem Zyklus. Und die Stimmung ist polarisiert: D-ID liegt bei 3.7/5 auf Trustpilot mit einem starken Schwanz an Abrechnungsbeschwerden (Auto-Verlängerung, verweigerte Erstattungen), obwohl es auf G2 etwa 4.3/5 erreicht. Lesen Sie die Abrechnungsbedingungen sorgfältig.
Fazit: eine starke Mittelklasse-Option, wenn Sie RAG und einen No-Code-Weg fertig eingebaut wollen. Achten Sie auf den gemeinsamen Minutenpool ohne Übertrag und die Auto-Verlängerung.
4. Soul Machines
Am besten für: Marken, die den emotional ausdrucksstärksten, autonom animierten digitalen Menschen wollen und das Budget dafür haben.
Soul Machines verkauft „Digital People“, Avatare, die von seinem patentierten Digital Brain gesteuert werden, das sensorische, motorische und Aufmerksamkeitssysteme simuliert, sodass das Gesicht in Echtzeit reagiert und Emotionen zeigt, statt nur lippensynchron zu sprechen. Es ist LLM-agnostisch, Sie bauen im Soul Machines Studio, und zu den bekannten Einsätzen zählen ANZ, Mercedes-Benz und UCSF. Wenn es auf Ausdruckskraft ankommt, ist dies der Kategorieführer.
Preise. Für einen Anbieter digitaler Menschen ungewöhnlich hat Studio eine öffentliche Preisliste mit einem kostenlosen Tarif nur zum Bauen, dann Basic für $12.99/Monat (40 interaktive Minuten), Plus für $99/Monat (350 Minuten) und Pro für $2,700/Monat (10,000 Minuten). Das Produkt Workforce Connect kostet pauschal $40,000/Jahr und braucht ein separates Zapier-Abonnement.
Die ehrliche Grenze. Der Preis skaliert sehr steil, ein Sprung von etwa dem 27-Fachen von Plus zu Pro, sodass jeder, der echtes Einsatzvolumen braucht, schnell im Bereich mehrerer tausend Dollar pro Monat landet. Auch die unabhängige Bewertungslage ist dünn (G2 zeigt nur ein paar Bewertungen), Sie kaufen also eher nach Demos und bekannten Logos als nach einer breiten Basis an Nutzerfeedback.
Fazit: wählen Sie es, wenn lebensechte emotionale Präsenz wirklich das Produkt ist, etwa bei einem gebrandeten Kiosk oder einem Flaggschiff-Markenerlebnis. Für Routine-Support ist es überdimensioniert und überteuert.
5. Synthesia
Am besten für: Unternehmensvideo in großem Maßstab (Schulung, Onboarding, Kommunikation), nicht für Live-Gespräche.
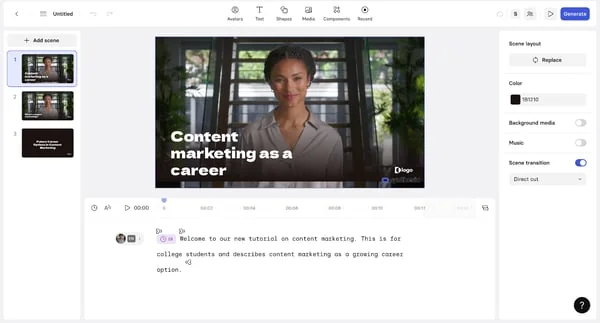
Dieses hier kommt mit einem Vorbehalt, und der ist der springende Punkt. Das Kernprodukt von Synthesia ist asynchrones, vorgerendertes Video: Sie schreiben ein Skript, es rendert ein MP4. Das ist das Gegenteil eines Live-Avatars. Es hält 4.7/5 auf G2 bei rund 2,000 Bewertungen und ist hervorragend in dem, was es tut, nämlich polierte Avatar-Videos in vielen Sprachen.
Es hat tatsächlich ein Echtzeitprodukt, Interactive Avatars, aber das ist eine separate Entwickler-API (auf LiveKit aufgebaut, eigenes LLM mitbringen) und kein Teil der Standard-Videotarife.
Preise. Die Haupttarife sind Free ($0), Starter ($19/Monat), Creator ($89/Monat) und Enterprise, alle über einen gemeinsamen Credit-Pool gemessen, der in Videominuten umgerechnet wird. Free und Starter sind auf etwa 10 Minuten Video pro Monat begrenzt. Das Echtzeitprodukt Interactive Avatars wird separat pro Minute abgerechnet, mit 500 kostenlosen Minuten zum Start.
Die ehrliche Grenze. Wenn Sie wegen eines Live-Konversations-Avatars gekommen sind, hat Synthesias Flaggschiff die falsche Form, und seine Echtzeitschicht ist neuer und weniger erprobt als die von HeyGen oder Tavus. Der häufigste Kritikpunkt neben den niedrigen Minutenlimits ist übertriebene Inhaltsmoderation bei dem, was Sie generieren dürfen.
Fazit: das beste Tool auf dieser Liste für geskriptete Unternehmensvideos und nur dann eine vernünftige Echtzeitoption, wenn Sie gezielt seine Interactive-Avatars-API wollen. Verwechseln Sie die beiden nicht.
6. OpenAI Realtime API
Am besten für: Entwickler, die einen eigenen Sprachagenten bauen, ein Frontier-Modell wollen und kein Gesicht brauchen.
Die OpenAI Realtime API ist das engste Gegenstück eines großen Labors zu Geminis Live-Fähigkeit, nur ohne Avatar. Sie ist Sprache-zu-Sprache-Infrastruktur (Audio rein, Audio raus) mit nativen asynchronen Tool-Aufrufen, Remote-MCP und SIP-Telefonie, alles über WebRTC oder WebSocket. Den Agenten bauen Sie selbst: Anweisungen, Tools, Leitplanken. Entwickler sind mit dem GA-Modell bei Kosten und Qualität warm geworden, behalten aber den Zähler im Blick:
"I'm curious now to see how the costs associated with this would work through the API on some user-facing features."
Preise. Abgerechnet wird nach Audio-Tokens, nicht nach Minuten: gpt-realtime-2.1 kostet $32 pro 1M Audio-Eingabe-Tokens ($0.40 gecacht) und $64 pro 1M Audio-Ausgabe-Tokens, mit einem günstigeren Mini für $10/$20. In der Praxis sind das etwa $0.02 pro gehörter Minute und rund $0.077 pro gesprochener Minute. OpenAI liefert außerdem ein pro Minute abgerechnetes GPT-Live-Modell für $0.05/min, falls Sie eine pauschale Abrechnung bevorzugen.
Die ehrliche Grenze. Es ist ein Baukasten, kein fertiger Agent. Es gibt keine eingebaute Wissensbasis, keine Ticket-Simulation und keine supportspezifischen Leitplanken, und Browser-Apps brauchen einen Proxy mit kurzlebigen Tokens, damit Sie Ihren Schlüssel nicht offenlegen. Ein Entwickler berichtete außerdem, das Modell sei bei längeren Chats mitten in der Sitzung in eine andere Sprache abgedriftet. Sie kaufen einen sehr guten Baustein und bauen den Rest selbst.
Fazit: die richtige Wahl, wenn Sie Ingenieure haben und ein erstklassiges Sprachmodell ohne Gesicht wollen. Wenn Sie einen funktionierenden Support-Agenten statt eines Werkzeugkastens wollen, ist das viel Zusammenbauen.
7. ElevenLabs Conversational AI
Am besten für: menschlich klingende Sprachagenten, besonders am Telefon, ohne den Sprach-Stack von Grund auf zu bauen.
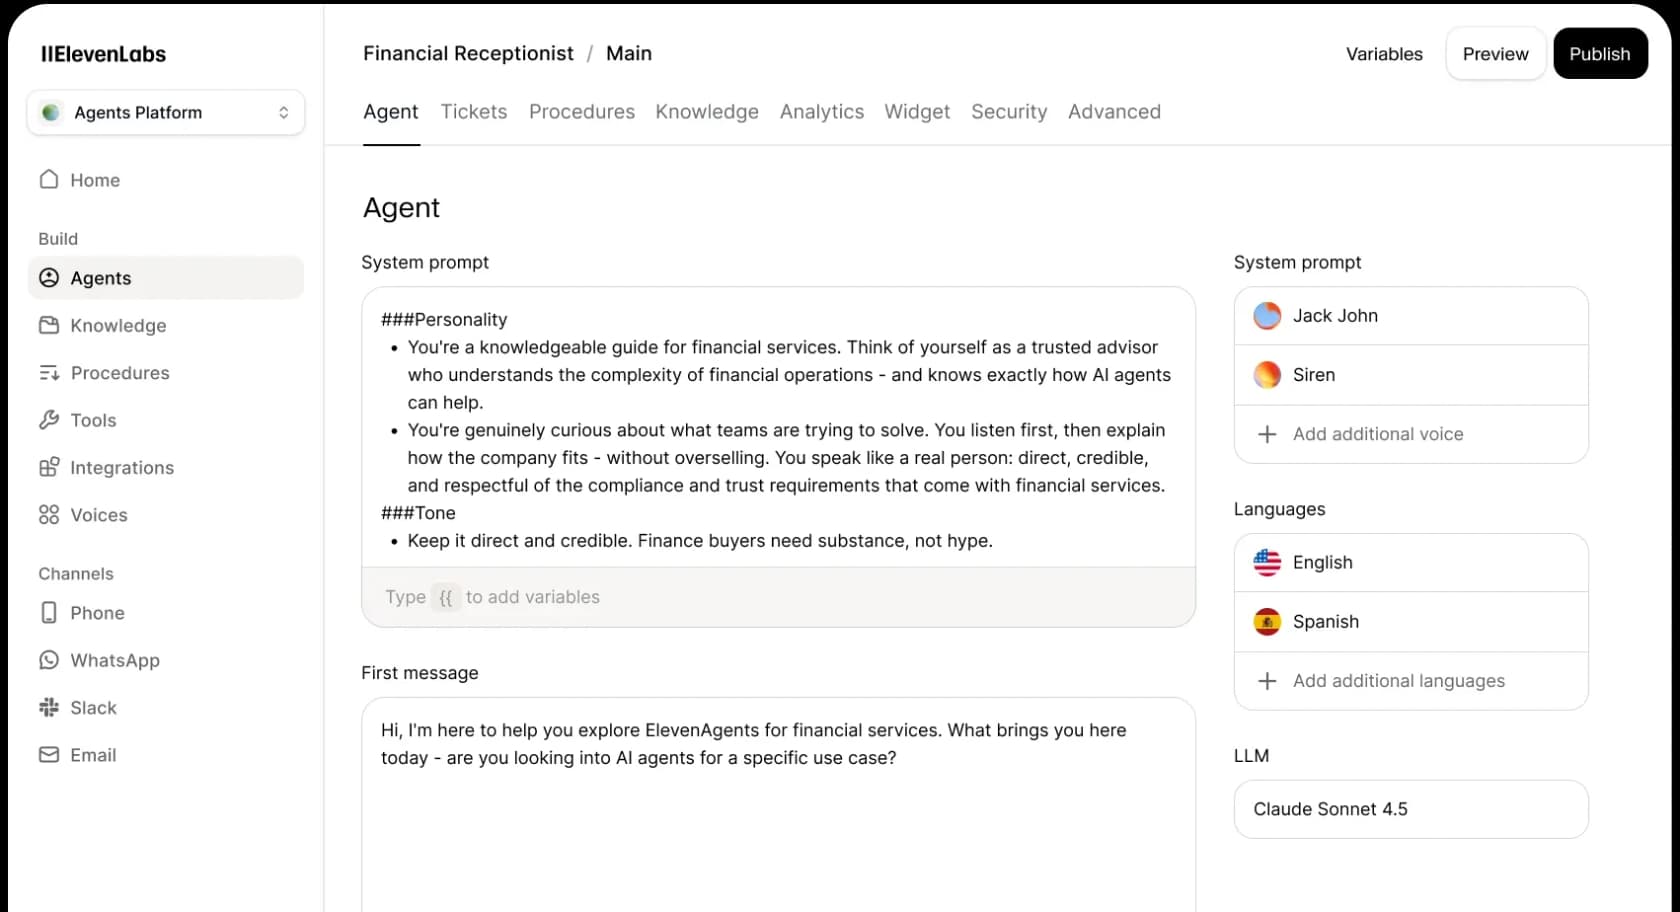
ElevenLabs ist sprachzentriert und bekannt für die natürlichste Sprache der Kategorie. Die Agents Platform kombiniert Spracherkennung, ein LLM Ihrer Wahl, sein latenzarmes Text-to-Speech und ein proprietäres Sprecherwechsel-Modell mit einem No-Code-Builder, SDKs, Twilio/SIP-Telefonie, einer Wissensbasis und Tool-Aufrufen in über 70 Sprachen. Es liegt bei etwa 4.6/5 auf G2 bei rund 584 Bewertungen.
Preise. Agenten werden nach Gesprächsminuten abgerechnet: Free (15 min), Starter $6 (75 min), Creator $22 (275 min), Pro $99 (1,238 min), Scale $299 (3,738 min) und Business $990 (12,375 min). Der Mehrverbrauch kostet $0.08/min, der Burst-Preis $0.16/min. Entscheidend: LLM-Nutzung wird separat abgerechnet, obendrauf, und Telefonie wird zum Selbstkostenpreis weitergegeben.
Die ehrliche Grenze. Die effektiven Kosten summieren sich: Gesprächsminuten plus eine separate LLM-Gebühr plus Telefonie, sodass die $0.08 aus der Schlagzeile die reale Zahl zu niedrig ansetzen. Ungenutzte bezahlte Credits verfallen außerdem beim Downgrade, was eine wiederkehrende Beschwerde ist, und einige Nutzer berichten von Latenzspitzen von bis zu vier Sekunden gegenüber der Angabe unter einer Sekunde.
Fazit: die stärkste reine Sprachoption für kundenorientierte Agenten, besonders für Telefon-Support. Kalkulieren Sie die Gesamtkosten pro Minute, nicht nur den Listenpreis.
Wie ein Live-Avatar tatsächlich funktioniert
Ohne das Branding läuft in jedem der obigen Tools für einen Gesprächszug dieselbe Schleife ab. Es lohnt sich, sie zu sehen, weil sie zeigt, wo die eigentliche Arbeit passiert.
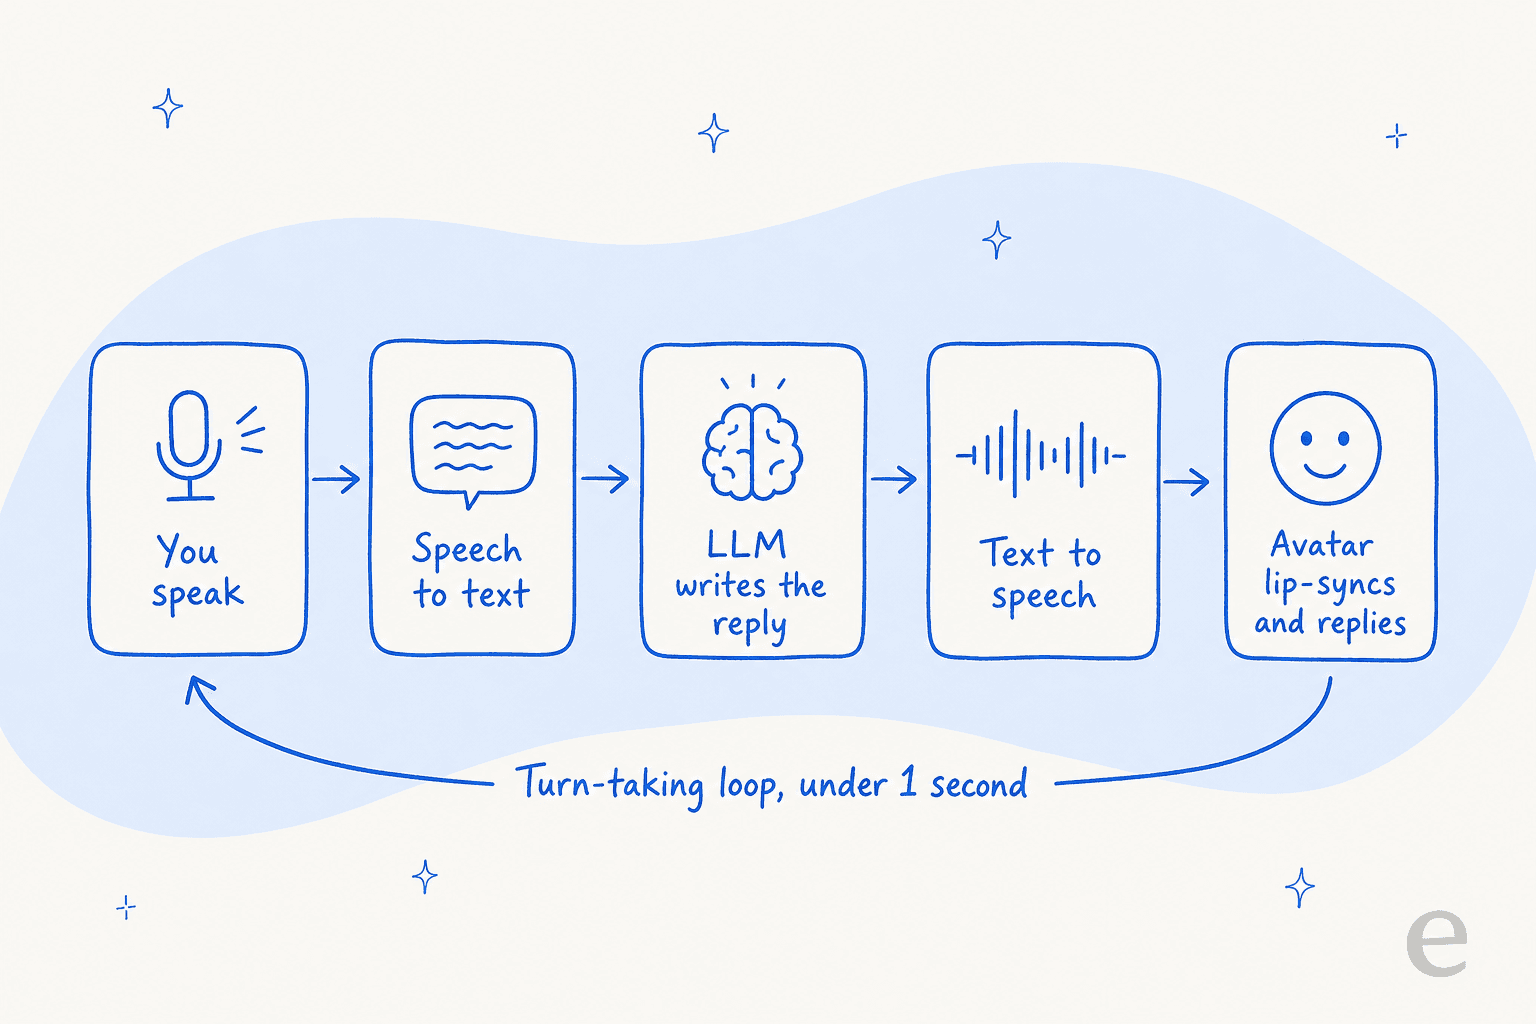
Beachten Sie, dass vier der fünf Schritte (Aufnahme, Transkription, Sprachsynthese, Rendering) die Darstellung betreffen. Genau einer, das LLM, das die Antwort schreibt, entscheidet darüber, ob der Kunde eine korrekte Antwort bekommt. Der Avatar macht die anderen vier schön. Für den einen, der zählt, tut er nichts, und das ist auch der Grund, warum ein KI-Chatbot falsch antwortet, selbst wenn er völlig flüssig klingt.
Was ein Avatar nicht behebt
Hier setze ich das Vertrauen des Lesers aufs Spiel, denn es ist das Nützlichste in diesem Beitrag. Nach Jahren, in denen ich KI an Live-Support-Warteschlangen gebracht habe, ist das Muster, das ich immer wieder sehe: Teams verlieben sich in das Frontend und investieren zu wenig in die Schicht, die das Ticket tatsächlich löst. Wir haben selbstsicher klingende Bots selbstsicher falsche Antworten geben sehen, weshalb jeder eesel-Rollout vorab anhand der eigenen historischen Tickets des Kunden simuliert wird, bevor er je einer echten Person antwortet.
Die Daten bestätigen das. Auf dem τ-bench-Support-Leaderboard zeigen selbst starke Modelle einen brutalen Retrieval-Absturz: Die Leistung kann um etwa 68 Punkte fallen, wenn man von einem einfachen Telekom-Szenario zu einem wissensintensiven Banking-Szenario wechselt, und die besten Support-Modelle sind nur in etwa 35 % der Fälle zuverlässig richtig, wenn man vier korrekte Antworten in Folge verlangt. Diese Lücke ist kein Rendering-Problem. Keine noch so gute Lippensynchronisation schließt sie.
Wenn Sie also einen Live-Avatar suchen, weil Sie den Kundenservice automatisieren wollen, lautet die ehrliche Frage nicht „welches Gesicht wirkt am menschlichsten“, sondern „welches System liefert die richtige Antwort und weiß, wann es eskalieren muss“. Die Kennzahlen, auf die es ankommt, sind Lösungsquote und Eskalationsgenauigkeit, nicht Realismus. Für viele Teams ist die Antwort gar kein sprechendes Gesicht, sondern ein gut fundierter KI-Agent, der in den Kanälen arbeitet, die Kunden ohnehin nutzen: Chat, E-Mail und Tickets.
Wo eesel passt (und wo nicht)
Ich sage es geradeheraus, denn der ganze Sinn dieses Beitrags ist Ehrlichkeit: eesel bietet weder Sprache noch Avatare. Wenn Sie ein gerendertes Gesicht oder eine Telefonstimme brauchen, wählen Sie eines der sieben oben. Was eesel leistet, ist die Entscheidungsschicht, auf Textkanälen.
Stellen Sie es sich so vor. Die OpenAI Realtime API, ElevenLabs und Gemini selbst sind Infrastruktur; eesel ist der KI-Teamkollege, den Sie für eine Aufgabe einstellen. Unser KI-Helpdesk-Agent bindet sich in das Helpdesk ein, das Sie bereits betreiben (Zendesk, Freshdesk, Gorgias, Front und mehr), lernt am ersten Tag aus Ihren vergangenen Tickets und Ihrem Help Center und entwirft Antworten oder sendet sie automatisch, sobald Sie seiner Genauigkeit vertrauen. Statt „einschalten und hoffen“ läuft zuerst eine Simulation über Ihre historischen Tickets, damit Sie die Lösungsquote sehen, bevor ein Kunde ihn je erreicht.
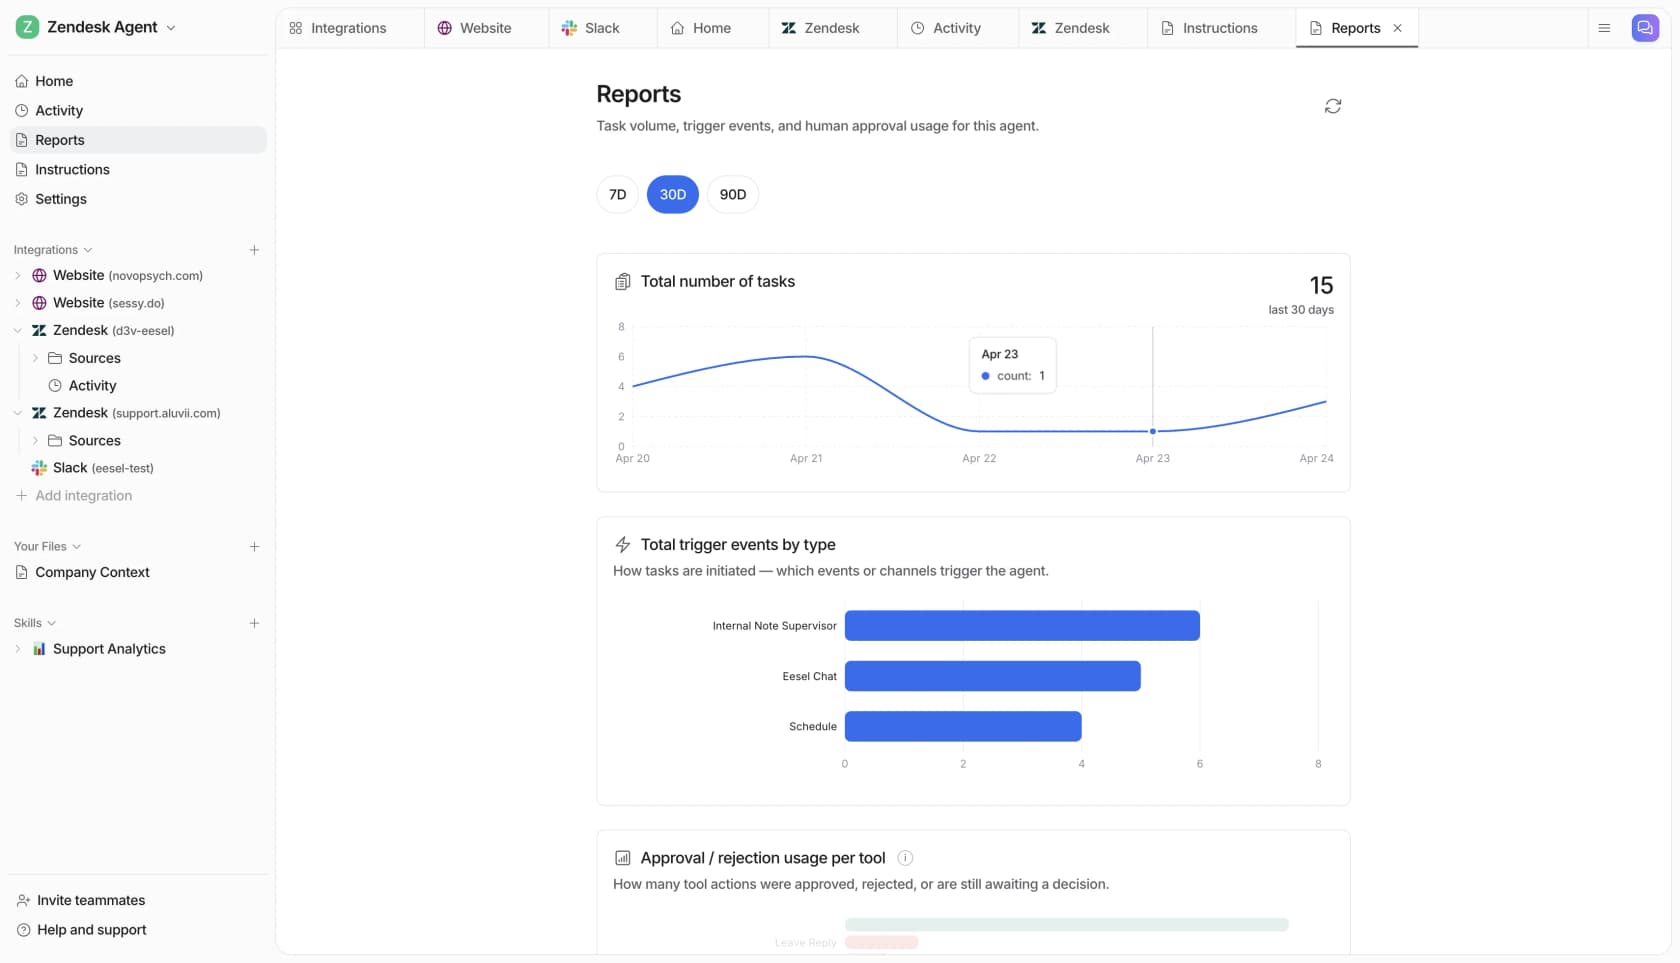
Und weil diese Liste voller APIs und SDKs ist, noch etwas Wissenswertes: eesel lässt sich auch über die eesel CLI steuern. Es ist derselbe Teamkollege wie im Dashboard, für das Terminal, für Skripte und für Coding-Agenten wie Claude Code, Cursor und Codex bereitgestellt. Jeder Befehl gibt JSON mit einem hint-Feld zurück, das einem Agenten sagt, was er als Nächstes ausführen soll, sodass Sie ein Helpdesk verbinden, Wissen hochladen und Automatisierungen einrichten können, ohne je die Oberfläche zu öffnen. Jeder Workspace ist außerdem ein MCP-Server. Es ist der agentenfreundliche Weg, denselben Support-Teamkollegen zu bedienen, wenn Ihr Team so arbeiten möchte.
Wenn die Aufgabe ein lebensechtes Gesicht ist, hat diese Liste Sie abgedeckt. Wenn die Aufgabe ist, Tickets korrekt zu lösen, dafür wurde eesel gebaut, und Sie können es kostenlos testen.