

Em 21 de julho de 2026, o Google lançou o Gemini 3.5 Flash-Lite junto com o 3.6 Flash e um modelo de segurança. O Flash-Lite é o modelo econômico: $0,30 por 1M de tokens de entrada e $2,50 por 1M de tokens de saída, cerca de 5x mais barato na entrada e 3x mais barato na saída que o 3.6 Flash. É rápido (perto do topo do ranking de velocidade da Artificial Analysis), mantém a janela de contexto de ~1M de tokens, e foi construído para trabalho de alto volume e baixo raciocínio, como busca, processamento de documentos e tradução.
A leitura honesta: o Flash-Lite é a escolha certa quando cada tarefa é simples e você a executa milhões de vezes, e a escolha errada quando a tarefa exige raciocínio real de várias etapas. E se você chegou até aqui porque quer construir automação de suporte ao cliente em cima dele: o preço por token é a parte fácil. Já são anos colocando agentes de IA em filas de suporte reais, e o modelo é a camada mais básica da pilha, não a coisa toda. Mais sobre os dois pontos abaixo.
O que o Gemini 3.5 Flash-Lite realmente é
O Google divide sua família Gemini em duas faixas. Os modelos Pro são o nível superior para raciocínio difícil. Os modelos Flash são os cavalos de batalha: mais baratos, mais rápidos, ajustados para aplicações de produção que fazem milhares de chamadas por dia. O Flash-Lite é o mais enxuto entre eles, posicionado pelo Google para tarefas agênticas de alto volume, tradução e processamento simples de dados.
As especificações são surpreendentemente generosas para um modelo econômico. Ele processa texto, imagem, vídeo, áudio e PDF como entrada, tem uma janela de contexto de 1.048.576 tokens (~1M de tokens, ou cerca de 1.500 páginas), e suporta raciocínio, chamadas de função, saídas estruturadas, execução de código e grounding via busca. Ele não suporta uso de computador, geração de imagem ou áudio, nem a Live API, então é um motor de texto para texto voltado a volume, não um modelo que faz tudo.
Na Artificial Analysis, ele alcança um Intelligence Index de 36 (#12 entre 152 modelos, bem acima da média para sua classe), rodando a cerca de 490 tokens de saída por segundo, o segundo modelo mais rápido que já mediram. Para um modelo tão barato, essa combinação de inteligência por dólar é todo o argumento de venda.
Preços do Gemini 3.5 Flash-Lite
Aqui está o quadro completo. Os preços são por 1M de tokens nos níveis pagos, e a saída inclui os tokens de raciocínio.
| Modo | Entrada (por 1M) | Saída (incl. raciocínio) | Cache de contexto |
|---|---|---|---|
| Padrão | $0,30 | $2,50 | $0,03 |
| Batch (50% de desconto) | $0,15 | $1,25 | $0,02 |
| Flex | $0,15 | $1,25 | $0,02 |
| Priority | $0,54 | $4,50 | $0,05 |
| Nível gratuito | Grátis | Grátis | Não disponível |
Alguns pontos a destacar antes de colocar isso numa planilha:
- O nível gratuito treina com seus dados. No nível gratuito, o Google usa seu conteúdo para melhorar seus produtos; em qualquer nível pago, não. Para qualquer coisa que envolva dados de clientes, isso já descarta o nível gratuito por si só.
- O modo batch é 50% de desconto fixo. Se o trabalho não precisa ser em tempo real (processamento de documentos durante a noite, tradução em massa), o Batch reduz o custo para $0,15 / $1,25.
- O grounding via busca é cobrado separadamente. Você tem 5.000 prompts com grounding grátis por mês em toda a família Gemini 3, e depois disso são $14 a cada 1.000 buscas, e uma única requisição pode disparar várias buscas cobráveis.
Para entender como isso se compara aos planos de consumo do Gemini e ao restante da API, nosso guia de preços do Gemini traz o detalhamento completo, e os preços do Gemini Workspace cobrem os planos empresariais.
O que isso custa de verdade
Preços de tabela não dizem muita coisa até você calcular um número real. Digamos que você use o Flash-Lite para a triagem inicial de tickets em 50.000 tickets por mês, com cerca de 1.000 tokens de entrada e 200 de saída por ticket.
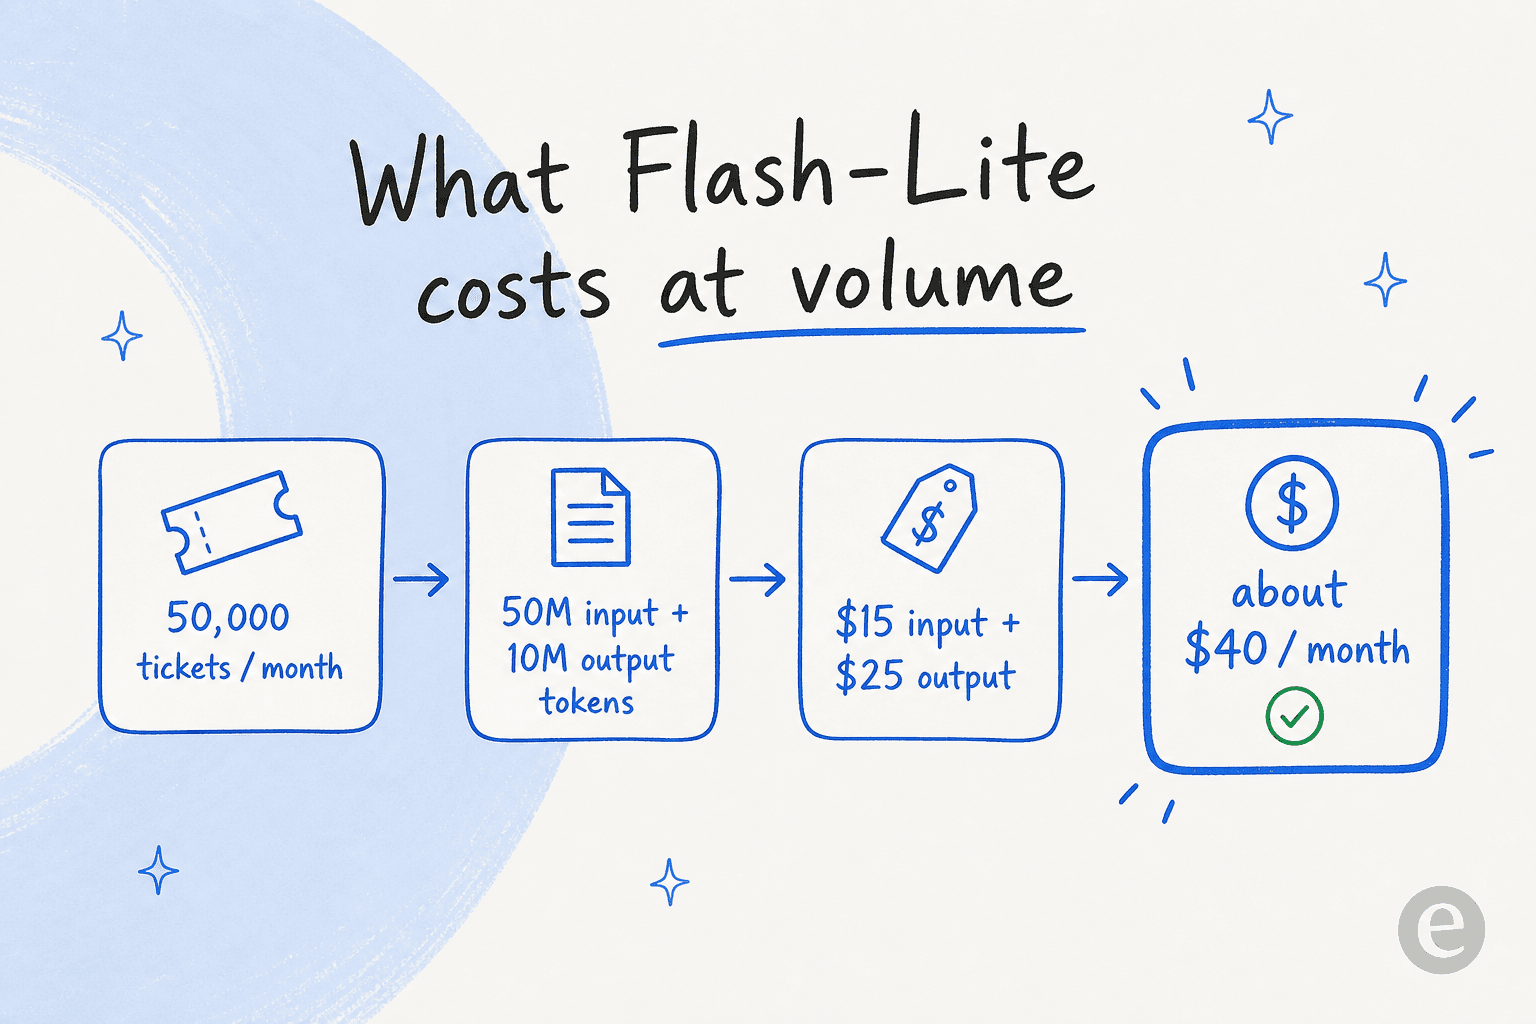
Isso dá 50M de tokens de entrada ($15) e 10M de tokens de saída ($25), então cerca de $40 por mês em custo bruto de modelo. Rode o mesmo volume no 3.6 Flash e você chega perto de $150. Essa diferença é exatamente o motivo de existir o Flash-Lite, e por que escolher o nível certo de modelo importa mais do que a maioria das equipes percebe ao orçar IA de suporte ou tentar reduzir custos de suporte com automação.
Como o Flash-Lite se compara
O Google publicou uma tabela comparativa, e a linha de preços é o que mais conta. A $0,30 / $2,50, o Flash-Lite fica abaixo do GPT-5.4 mini ($0,75 / $4,50) e do Claude Haiku 4.5 ($1,00 / $5,00), enquanto se mantém na mesma faixa geral de qualidade na maioria dos benchmarks agênticos.
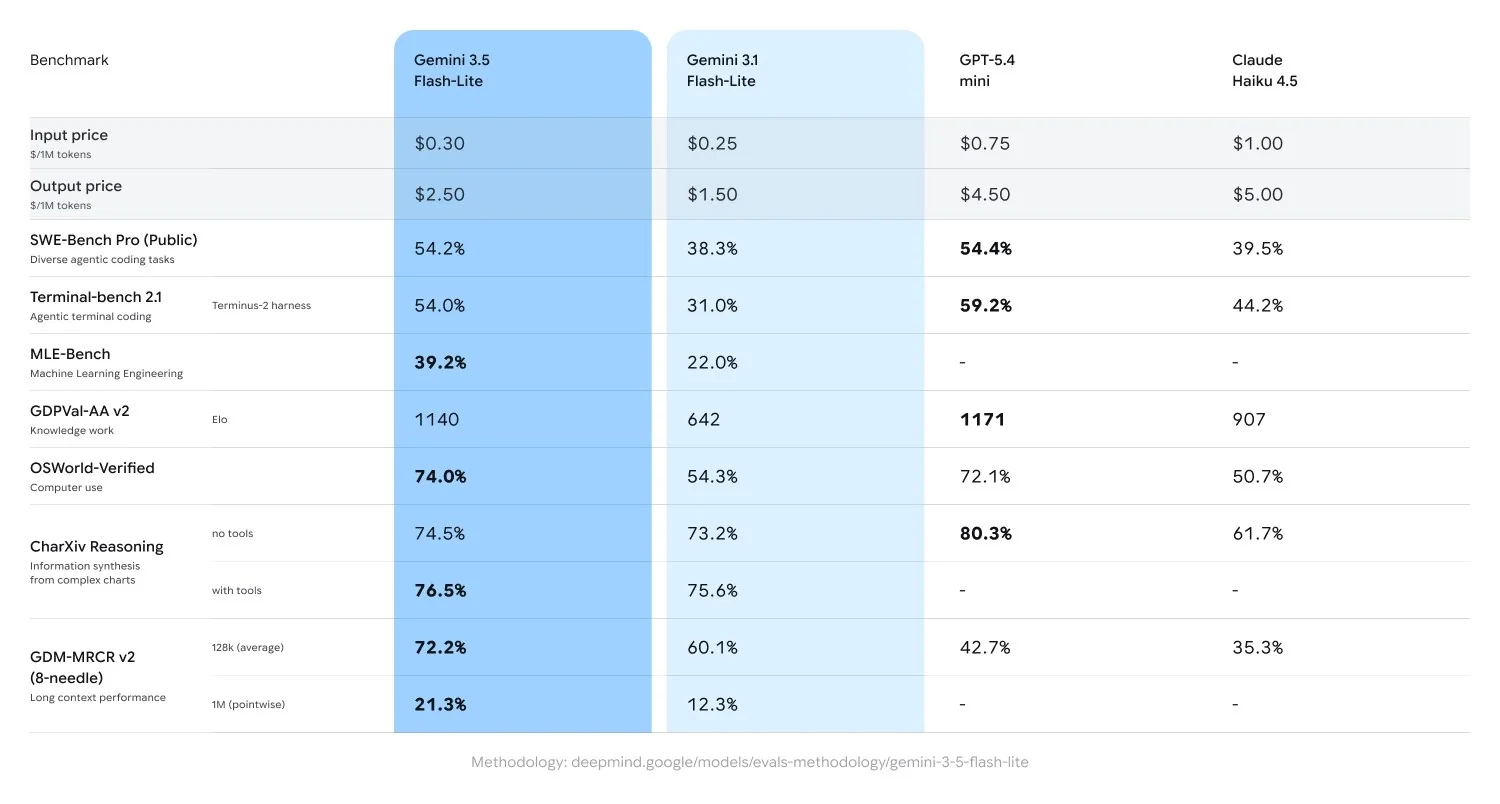
Leia essa tabela com uma ressalva: o GPT-5.4 mini fica um pouco à frente em alguns escores de código e conhecimento. Mas em preço por capacidade para trabalho de alto volume, o Flash-Lite é difícil de superar, e vence de longe em recall de contexto longo. O único número que não é favorável é a latência: o tempo até o primeiro token fica em torno de 6 segundos (incluindo o tempo de raciocínio), no lado alto para sua categoria, então se encaixa melhor em tarefas em segundo plano do que em um chat ao vivo ágil.
Contra seu próprio antecessor, o salto de geração é evidente:
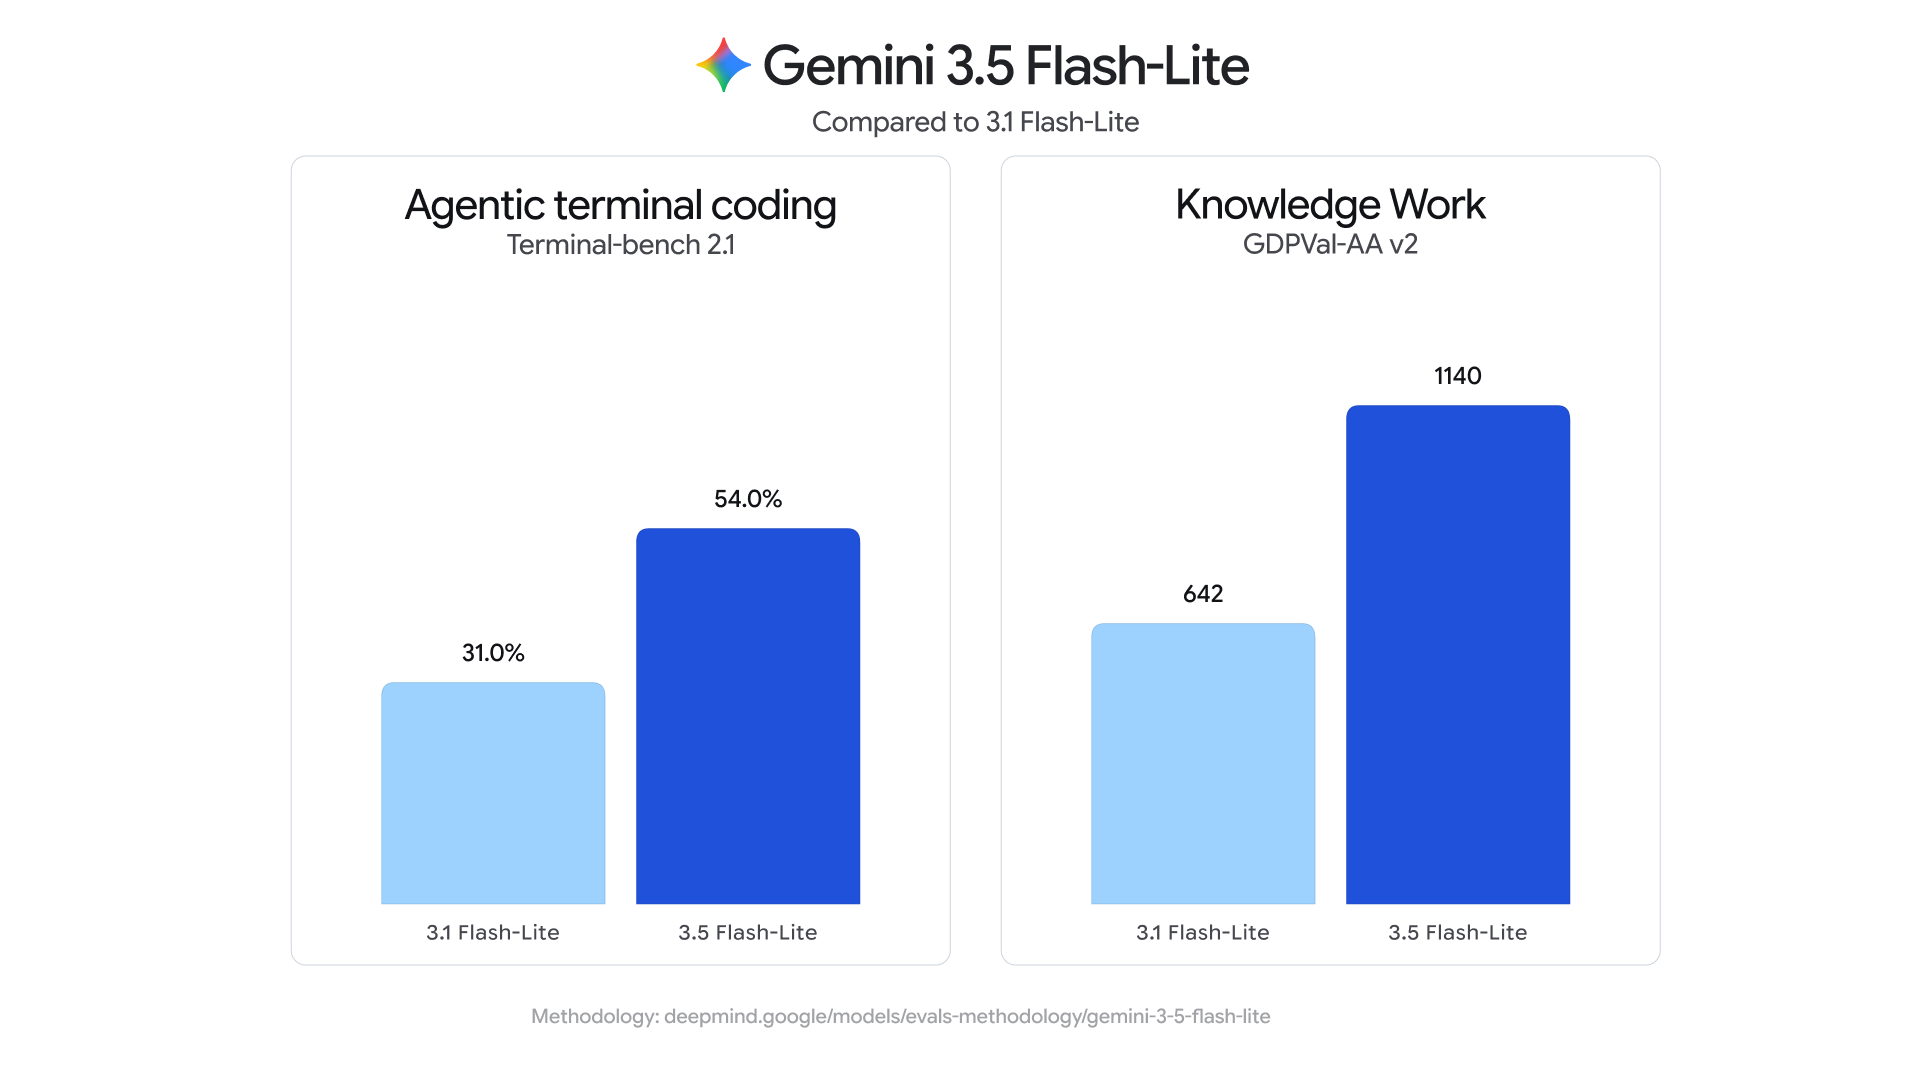
A programação agêntica de terminal salta de 31% para 54% no Terminal-Bench 2.1, e o trabalho de conhecimento quase dobra, de 642 para 1140 no GDPval-AA v2. O Google afirma que ele até supera o antigo 3 Flash em SWE-Bench Pro e tarefas de uso de computador, então você não está sacrificando muita qualidade pelo preço baixo. Se você está pesando o Gemini contra o restante do mercado, detalhamos isso em Gemini vs Claude, Gemini vs ChatGPT e no panorama mais amplo de alternativas ao Gemini.
Qual modelo você realmente deve escolher?
O Flash-Lite foi lançado ao lado do Gemini 3.6 Flash, e escolher o errado tanto desperdiça dinheiro quanto coloca no ar um bot que não dá conta do recado. A regra prática é simples.
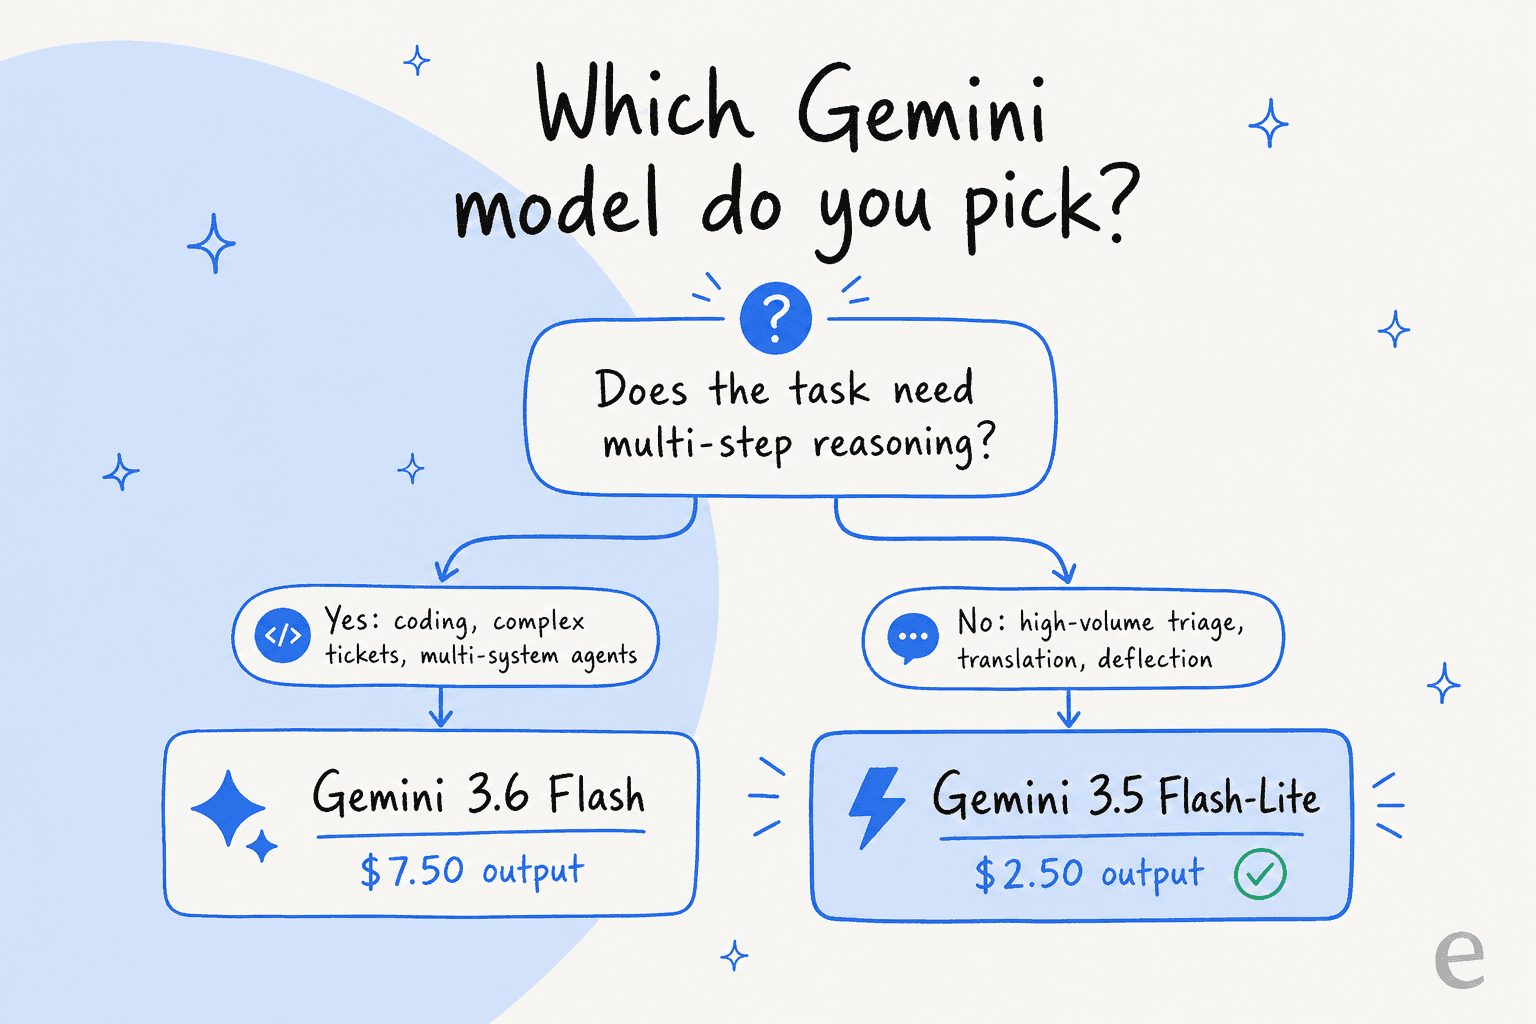
Recorra ao 3.6 Flash quando o trabalho exigir raciocínio de verdade: agentes de várias etapas, programação, tickets de suporte complexos que envolvem vários sistemas. Recorra ao Flash-Lite quando estiver processando volume em que cada item é simples, como a triagem inicial, o desvio de chat ao vivo de perguntas rotineiras, ou respostas multilíngues em massa. Construir um agente de IA de verdade ou um bot com script é uma decisão separada da escolha do modelo, e costuma importar mais. Se você opera um produto SaaS, nossa análise da melhor IA para suporte SaaS mostra onde cada modelo se encaixa.
O que isso significa se você está construindo IA para suporte
Aqui é onde preciso ser direto com você, porque essa é a parte que todo artigo sobre preços de modelo pula quando o assunto é equipes de suporte.
Um modelo mais barato e rápido é uma boa notícia. Mas trocar para o Flash-Lite não te dá um agente de suporte funcional, assim como um motor mais barato não te dá um carro. Já são mais de três anos colocando IA em filas de suporte reais, e a falha que vi repetidamente não é o modelo ser burro, é um bot que soa confiante dando uma resposta errada a um cliente real porque ninguém construiu as camadas ao redor do modelo. O modelo é a camada mais básica da pilha.
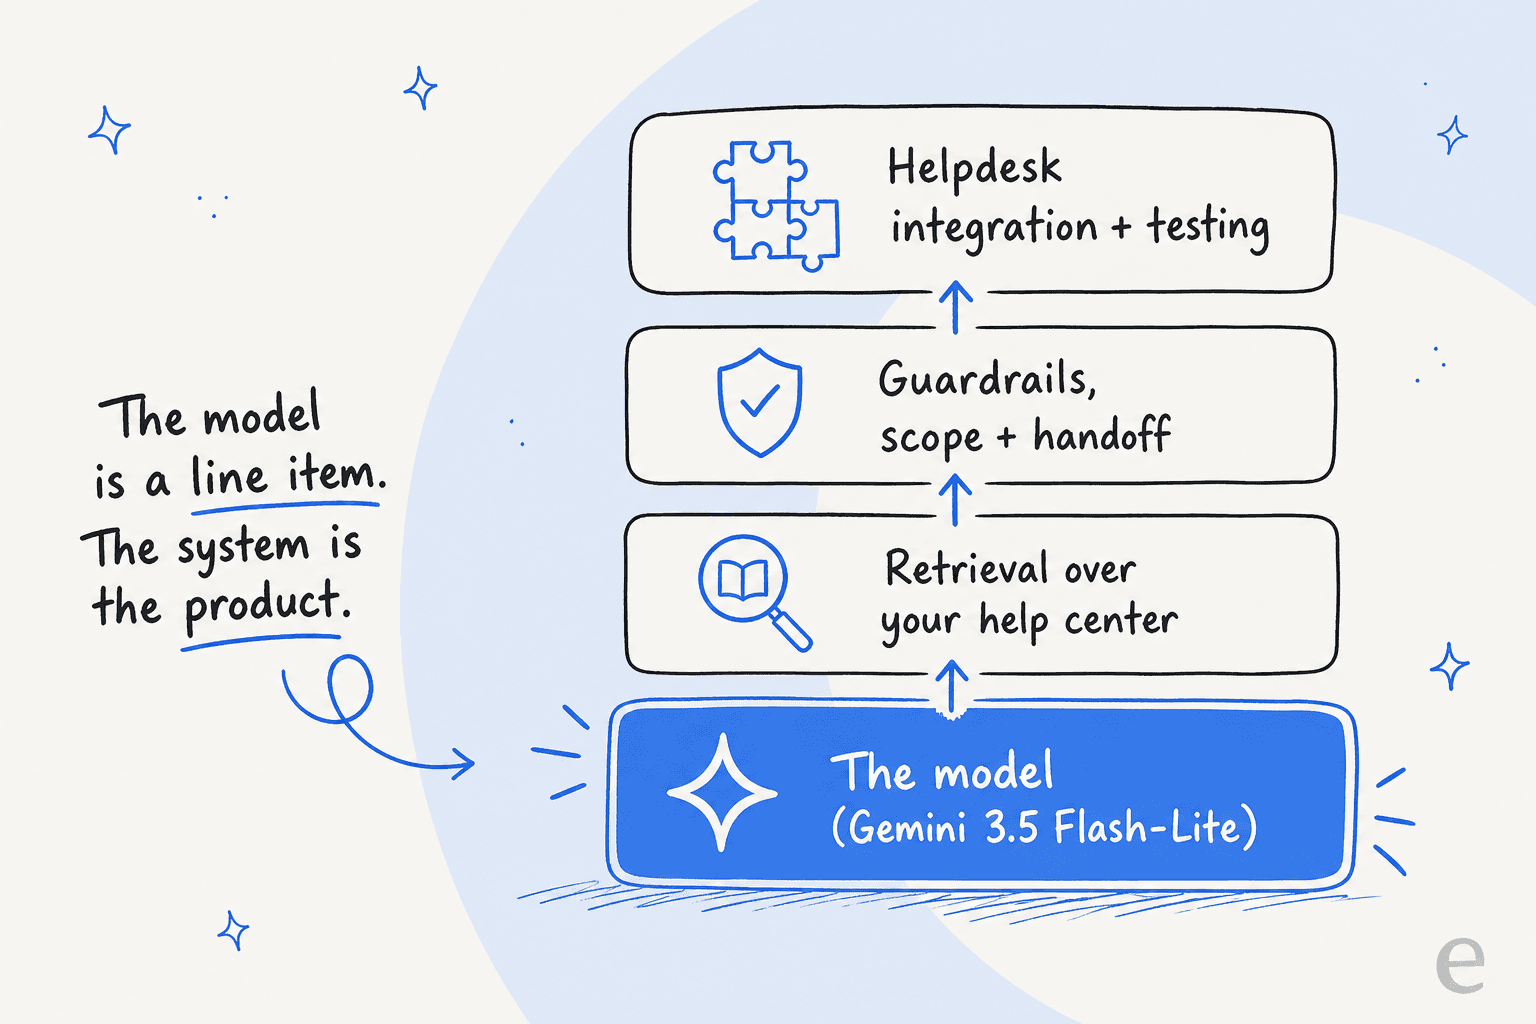
Essas camadas são o trabalho de verdade. Recuperação de informações, para que o modelo responda a partir da sua central de ajuda e tickets anteriores em vez de chutar. Guardrails e escopo, para que ele escale corretamente em vez de inventar uma política de reembolso. Integração, para que possa agir dentro do seu sistema de tickets. E testes, para que você saiba como ele se comporta antes de ele tocar em um cliente. Essa é exatamente a diferença entre uma API bruta e um verdadeiro software de atendimento ao cliente com IA, e é por isso que os problemas de chatbot de IA quase sempre remontam ao encanamento, não ao modelo.
É também por isso que eu recomendaria cautela em conectar você mesmo a API bruta do Gemini ao seu helpdesk. Você estaria reconstruindo recuperação de informações, guardrails contra alucinação, simulação e cada integração de helpdesk do zero, e depois mantendo isso à medida que os modelos mudam a cada poucas semanas. O Flash-Lite ser barato não muda essa conta. Esse é todo o argumento a favor de uma IA de helpdesk construída para isso em vez de uma pilha DIY: o nível do modelo é apenas um item de custo, o sistema ao redor é que é o produto. E quando você treina o agente corretamente, o modelo por baixo pouco importa para o resultado.
Experimente o eesel
É exatamente essa a camada que o eesel foi construído para ser. Você o conecta ao seu helpdesk existente, ele aprende com seus tickets anteriores e base de conhecimento desde o início, e roda em cima de modelos de ponta, então você ganha a eficiência sem precisar conectar a API você mesmo.

O diferencial que um modelo barato não consegue te dar sozinho: o eesel permite simular o agente contra seus tickets históricos antes que ele responda a um cliente real, então você vê a taxa de resolução e as respostas exatas que ele teria enviado, e pode vincular isso ao ROI real da IA de suporte. E como é precificado pelo trabalho que faz, não por token, você evita a conta de tokens em cada ticket. Se você está calculando o preço do Flash-Lite para construir automação de suporte, comece pelo resultado que quer e deixe a plataforma cuidar do encanamento. É grátis para testar.